출처 https://youtu.be/ueA116hO_ho · 채널 AgentOS · 길이 22:52 · 공개 2026-11-15 22:14 (KST) 포맷 2026-08-03-agentos-own-the-outer-loop와 같은 구조다. 뼈대는 Lauren Tan(@poteto, SpaceXSI Grok Bot 팀 Principal Engineer)이 AI Engineer Code Summit 2026에서 한 17분 발표 “All Code Is Slop (Except Mine)“(https://youtu.be/O_zcc6Xl12g )의 원본 클립이고, 그 사이를 AgentOS 채널의 한국어 해설이 잇는다. 장면마다 발표와 해설을 구분했다. 원본 발표 노트 2026-11-15-lauren-tan-all-code-is-slop에 발표 전체 흐름, 성능표 10개 항목, 기여자 분포가 정리돼 있다. 이 노트는 해설 영상이 더한 것(비전공자용 용어 풀이, 숫자에 대한 단서, “오늘 넣을 것 / 아직 아닌 것” 구분)에 무게를 둔다.
표기 주의 yt-dlp가 받아온
ko-orig자막은 해설 구간의 한국어 음성인식이고, 발표 클립 구간은 비어 있거나 영어 ASR만 잡힌다. 발표 인용은 **영상에 입혀진 채널 자막(한국어+영어)**을 화면에서 읽어 옮겼다. 첫 문장의 숫자는 자동자막이약 2만 개, 정확히는 19,26개로 잡았지만 화면 자막과 슬라이드는 10,926개다. 그 밖의 정정:로렌타·로렌탄→ Lauren Tan,피스택→ pstack,Graph Bot(영어 ASR) → Grok Bot,셋 타임아웃→setTimeout,신디 3→ Cindy Sridharan,본 바디→ Bombadil.
한눈에 보는 요약
- 숫자가 출발점이다. Grok Bot 팀은 10월 한 달에 PR 10,926개를 병합했고, 같은 달 되돌린 커밋은 **0.47%**였다. Lauren Tan 개인도 10월에 PR 3,127개를 냈다. 해설은 이 숫자가 발표자 팀이 직접 낸 값이라 따로 확인할 자료가 없다고 짚는다.
- 핵심 장치는 프롬프트가 아니라 코드베이스 쪽에 있다. 거꾸로 선 삼각형 “포테이토 피라미드”(코드베이스 → 정적 분석 → 검증 → 산문 → 사람 리뷰)에서 위가 넓은 이유는, 결정적인 장치일수록 시간을 많이 쓸 가치가 있기 때문이다. 규칙 파일·스킬·AGENTS.md는 판단이 필요한 것만 조금 적는 아래쪽 좁은 칸이다.
- 땜질 하나가 복사돼 패턴이 된다. 깜빡임을 고친
setTimeout한 줄이 5주 만에 타이머 183개가 됐다. 그래서 Grok Bot 팀은 쓰기 까다로운useEffect는 아예 금지하고, 섞이면 안 되는 renderer·main 코드는 폴더와 린트로 갈라 놓고, 주석은 99% 없앴다(65,824개 → 1,227개). - 에이전트를 고칠 때마다 린트나 설계로 옮긴다. 반복하면 리뷰에서 볼 것이 줄고, 결국 에이전트가 PR 대부분을 스스로 병합한다.
- 가장 중요한 칸은 검증이다. 사람이 보는 것은 코드가 아니라 영상·스크린샷·다이어그램 같은 검증의 증거다. 런타임 검증 CLI, TLA+·Lean 형식 검증, UI 속성 기반 테스트를 층층이 쌓는다. Cindy Sridharan은 하루 토큰의 70%를 검증에 쓴다고 했다.
- 나쁜 루프는 자동화하지 마라. 안쪽 루프가 슬롭을 내면 자동화해도 슬롭만 더 나온다. 새 안티패턴을 린트로 먼저 막고, 기존 것은 그다음에 치운다.
- 해설의 결론: 오늘 해 볼 일은 작다. 같은 실수를 고쳤다면 규칙 파일에 한 줄을 보태기 전에 린트·테스트로 만들 수 있는지 먼저 보고, 에이전트가 결과를 직접 실행해 확인할 길을 하나 열어 주는 것이다. 주석 대청소나 PR 자동 병합은 다른 이야기다.
장면별 상세 설명
[00:00] 1. 한 달 PR 10,926개, 되돌림 0.5%
해설 영상은 숫자로 연다. 10월 한 달 동안 한 팀이 병합한 PR이 10,926개였고, 같은 달 되돌린 커밋은 0.5% 안팎이었다. 발표 제목 “모든 코드는 슬롭이다, 내 것만 빼고”의 슬롭(slop)은 AI가 대충 찍어낸 질 낮은 결과물을 가리킨다. 이 영상이 보려는 것은 에이전트가 쓴 코드를 믿을 수 있게 만드는 장치이고, 프롬프트나 규칙 파일이 아니라 코드베이스 쪽에 넣는 것들이라 내 저장소에도 오늘 하나쯤 넣어 볼 수 있다는 점을 강조한다. 발표 뒤쪽에는 Lauren Tan이 직접 만든 플러그인(pstack)과 자기 팀 제품(Grok Bot) 홍보도 섞여 있다고 미리 밝힌다.
[00:58] 2. “남이 쓴 코드는 다 슬롭” — 그리고 누구나 코딩 머신
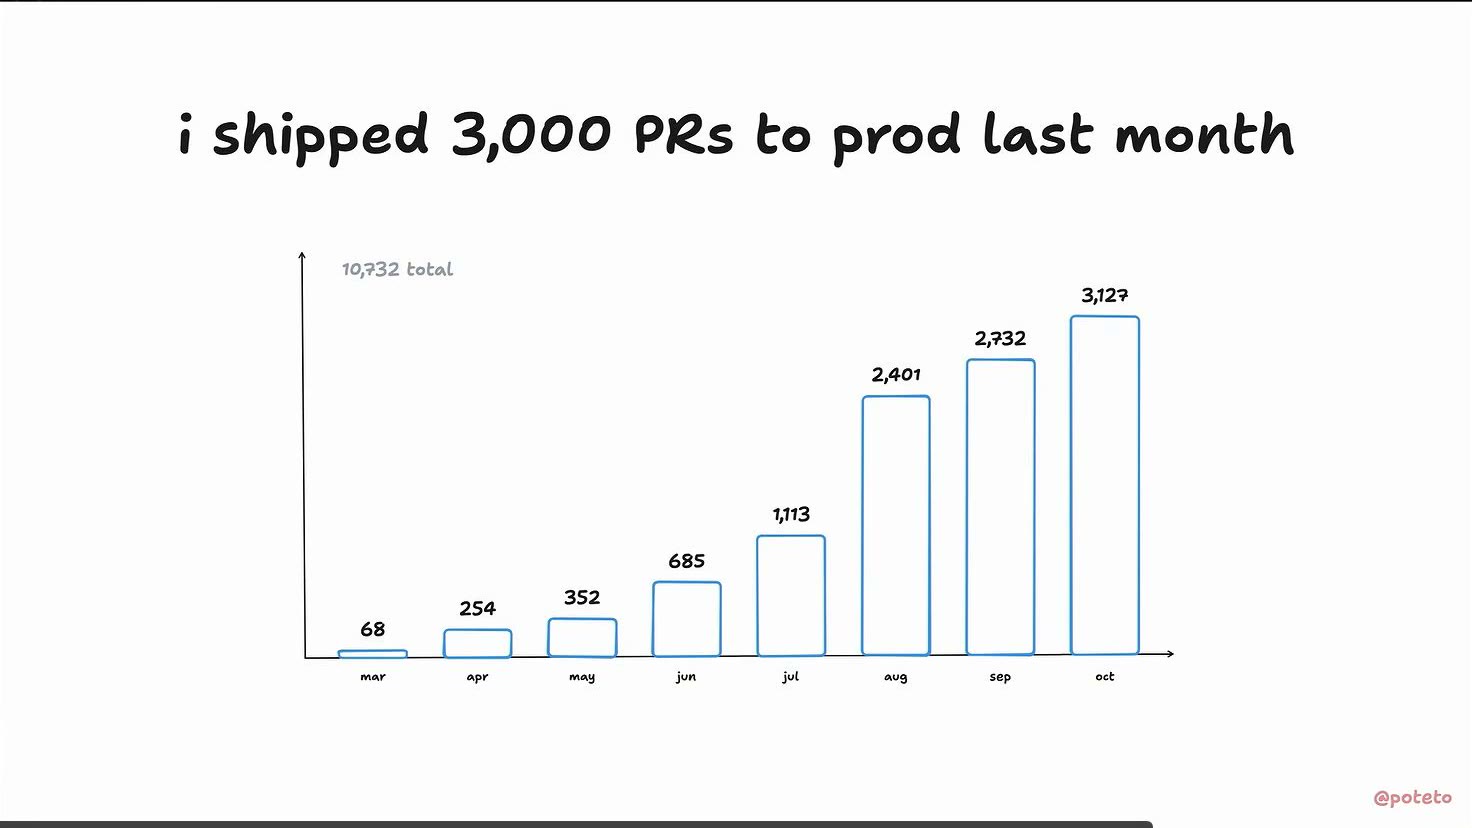
발표 Lauren Tan은 “남이 쓴 코드를 보고 이거 다 슬롭이네 생각해 본 적 있나”라고 손을 들게 한 뒤, 오늘은 그 슬롭을 금으로 바꿀 수 있다고 설득하겠다고 시작한다. 그는 지난달 혼자 PR 3,000개를 프로덕션에 냈다. 슬라이드의 월별 개인 PR 수는 3월 68 → 4월 254 → 5월 352 → 6월 685 → 7월 1,113 → 8월 2,401 → 9월 2,732 → 10월 3,127(누적 10,732)이다.
에이전트 이전에는 생산량에 별로 신경 쓰지 않았고, 주말에 Google 지도를 통째로 다시 짰다는 Bret Taylor 같은 예외만 “코딩 머신”이라 불렀다. 이제는 에이전트 덕분에 누구나 코딩 머신이 될 수 있다. 그래서 지금 소프트웨어 엔지니어의 일은 생산성을 크게 끌어올리면서 코드 품질을 유지하거나 오히려 높이는 방법을 찾는 것이라고 본다(슬라이드: quality & quantity — everyone can be a coding machine).
[01:56] 3. 소프트웨어 공장 대신 “신뢰”
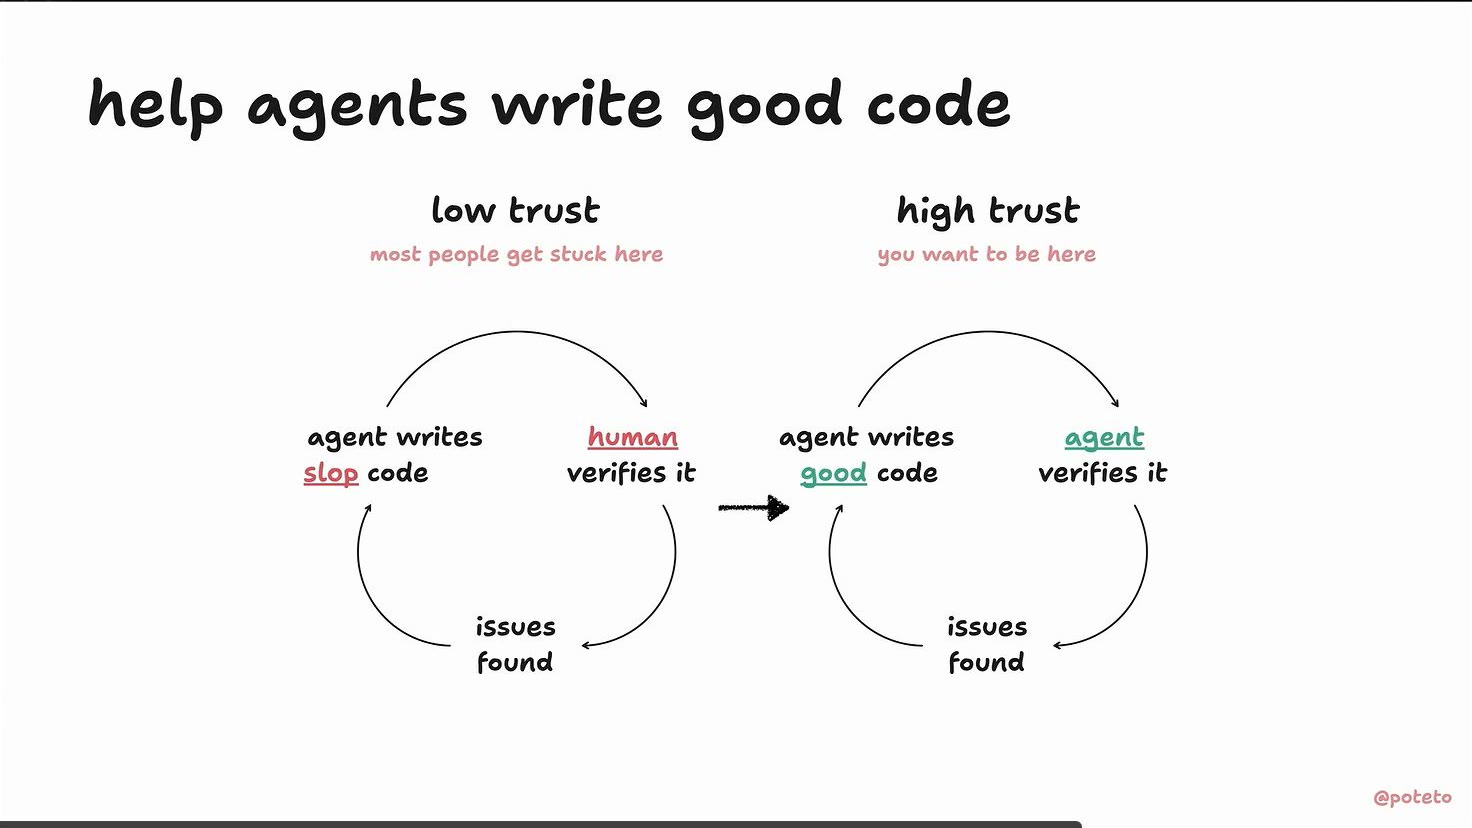
발표 이런 방식을 “소프트웨어 공장”이라고 부르는 사람도 있지만, Lauren Tan은 단순하게 신뢰의 문제로 본다. 맹목적인 신뢰가 아니라, 에이전트가 옳은 일을 할 거라고 믿을 수 있도록 에이전트의 환경에 투자하는 것이다. 대부분은 왼쪽의 낮은 신뢰 루프(에이전트가 슬롭을 쓰고 사람이 검증하다 문제를 찾는다)에 갇혀 있고, 가야 할 곳은 오른쪽의 높은 신뢰 루프(에이전트가 좋은 코드를 쓰고 검증도 에이전트가 한다)다. 그가 잠든 사이에도 PR 수천 개를 낼 수 있게 되기까지 6개월이 걸렸지만, 듣는 사람은 훨씬 빨리 갈 수 있다고 한다.
[02:40] 4. 포테이토 피라미드 — 위가 넓고 아래가 좁은 이유
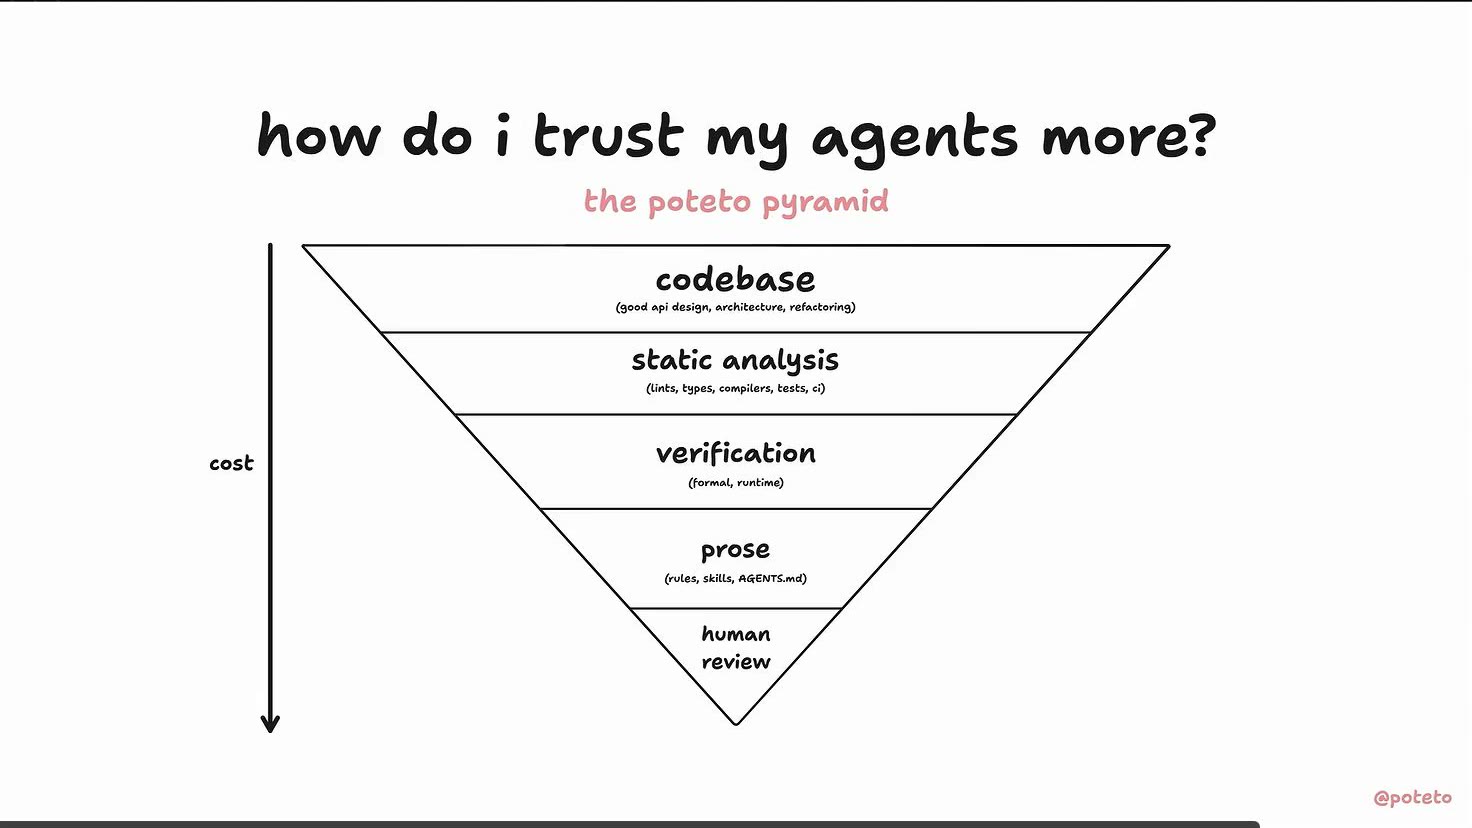
해설 왼쪽에서 오른쪽 루프로 가려면 에이전트 환경의 어디에 시간을 써야 하는가. 답은 거꾸로 선 삼각형 한 장이다. 위에서부터 코드베이스, 정적 분석, 검증, 산문, 사람 리뷰의 다섯 칸이다.
발표 위의 두 칸은 결정적(deterministic)이다. 코드 자체를 쓰는 것으로, 좋은 API 설계·아키텍처·리팩터링, 그리고 린트 규칙·타입 시스템·컴파일러·여러 종류의 테스트가 여기 들어간다. 이 두 층을 함께 써서 에이전트가 할 수 있는 일을 제한하고 기본값으로 옳은 일을 하게 강제한다. 그 위에 런타임·형식 검증을 얹어 버그를 찾고, 시스템이 늘 지켜야 할 속성과 불변식을 확인하고, 에이전트가 목표와 의도를 이해했는지까지 본다. 마지막으로 규칙·스킬·AGENTS.md처럼 판단이 필요한 것만 산문으로 조금 얹는다.
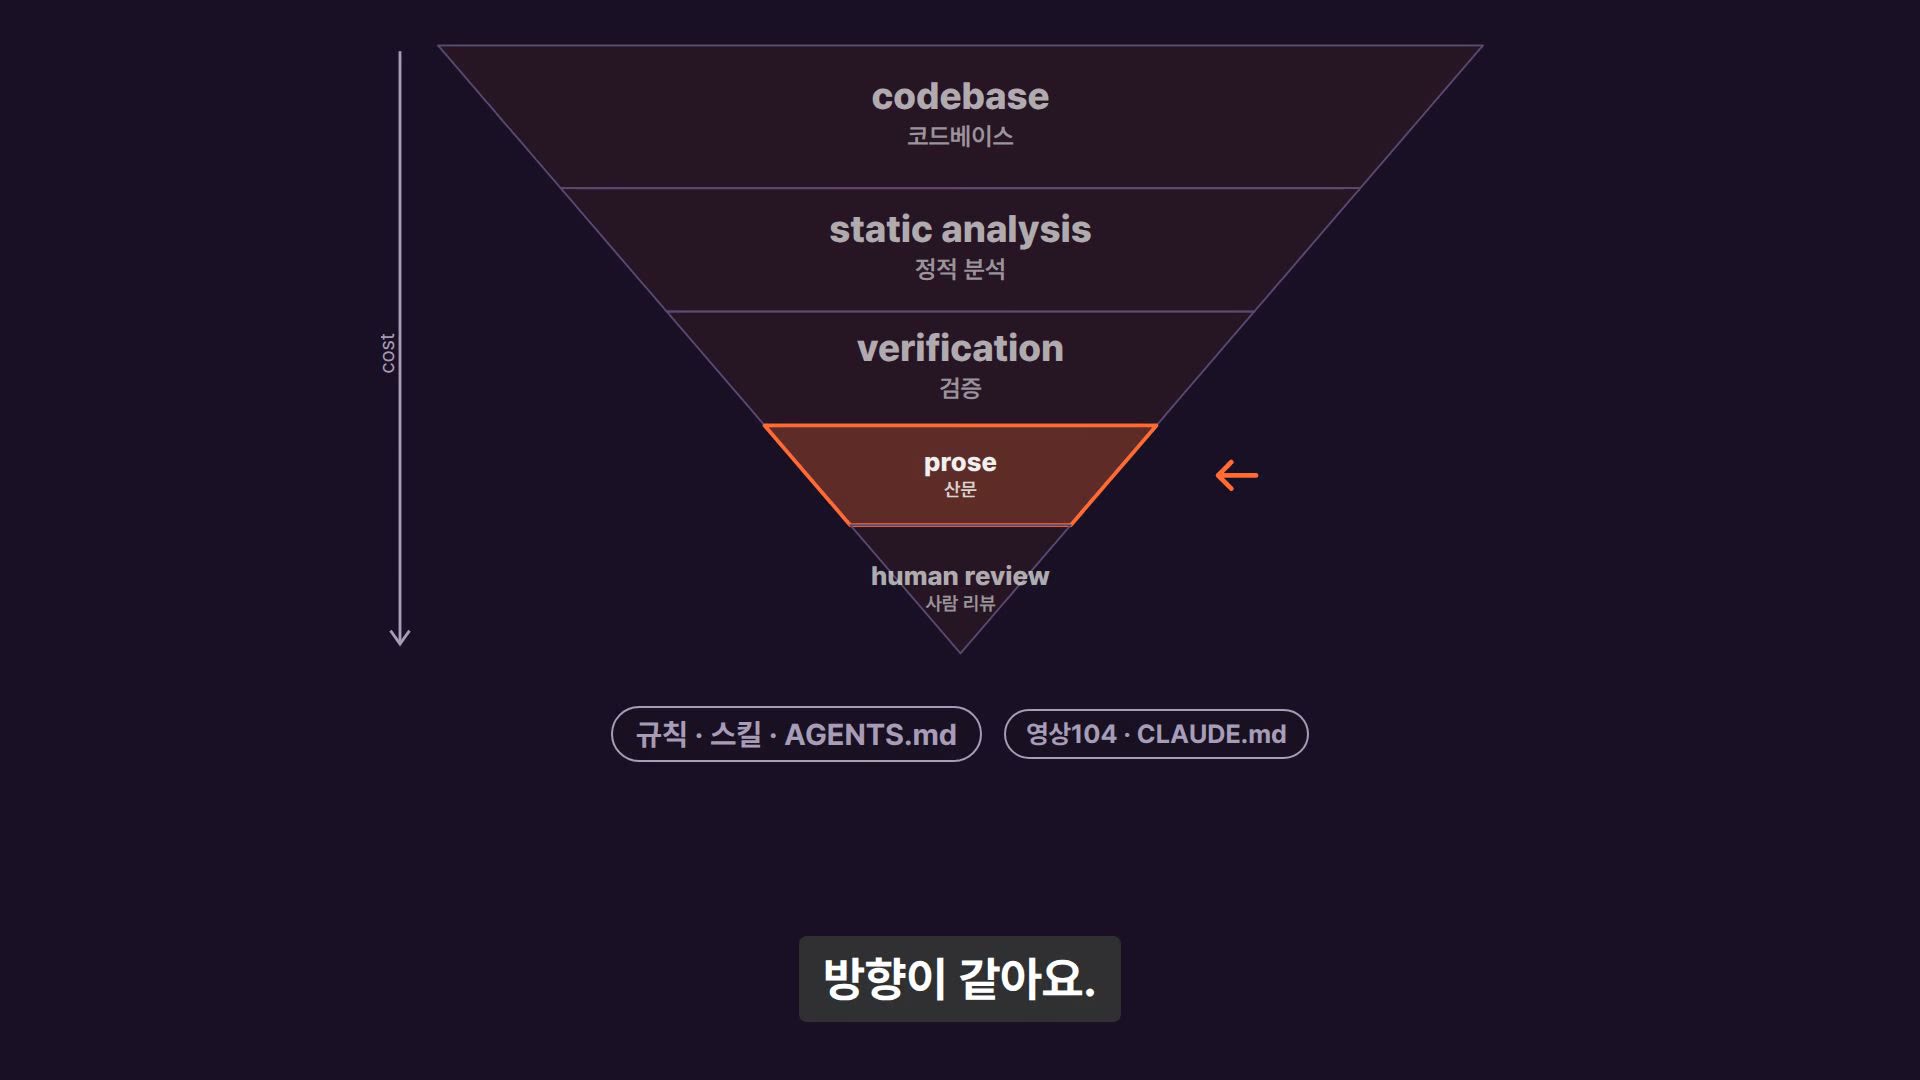
해설 규칙 파일·스킬·AGENTS.md 같은 글이 아래쪽 좁은 칸이라는 점을 다시 짚는다. 판단이 필요한 것만 조금 적는 자리라는 뜻이다. 채널이 앞서 다룬 Anthropic 발표(영상 104, CLAUDE.md의 감정 섞인 문구를 걷어낸 이야기)와 방향이 같다고 연결한다.
[04:27] 5. 코드는 기억이다 — 정원과 잡초
발표 에이전트는 입력을 바탕으로 결과를 만들고, 코드베이스는 그 입력 가운데 가장 큰 것이다(슬라이드: code is memory). 그래서 에이전트를 교정할 때마다 규칙이나 AGENTS.md에 한 줄을 더하는 대신 결정적 검사로 만들 방법을 생각하라고 한다. 코드로 돼 있어야 재현성이 좋고 더 믿을 수 있다.
예전엔 코드가 PR 몇 개씩 들어왔다. 2024년에는 출근해서 동료가 쓴 PR 세 개를 리뷰했는데 지금은 그 숫자가 300개쯤이다. 엔지니어 한 명이 에이전트 수백·수천 개로 된 팀인 셈이고, 코드가 끊임없는 흐름처럼, 살아 있는 것처럼 들어온다. 이 비유에서 코드베이스·제약·가드레일은 에이전트가 쓴 새 코드가 그 둘레로 자라는 콘크리트 기초다. 소프트웨어 엔지니어의 일이 정원 가꾸기처럼 돼 간다(2026-10-31-x-poteto-organic-architecture).
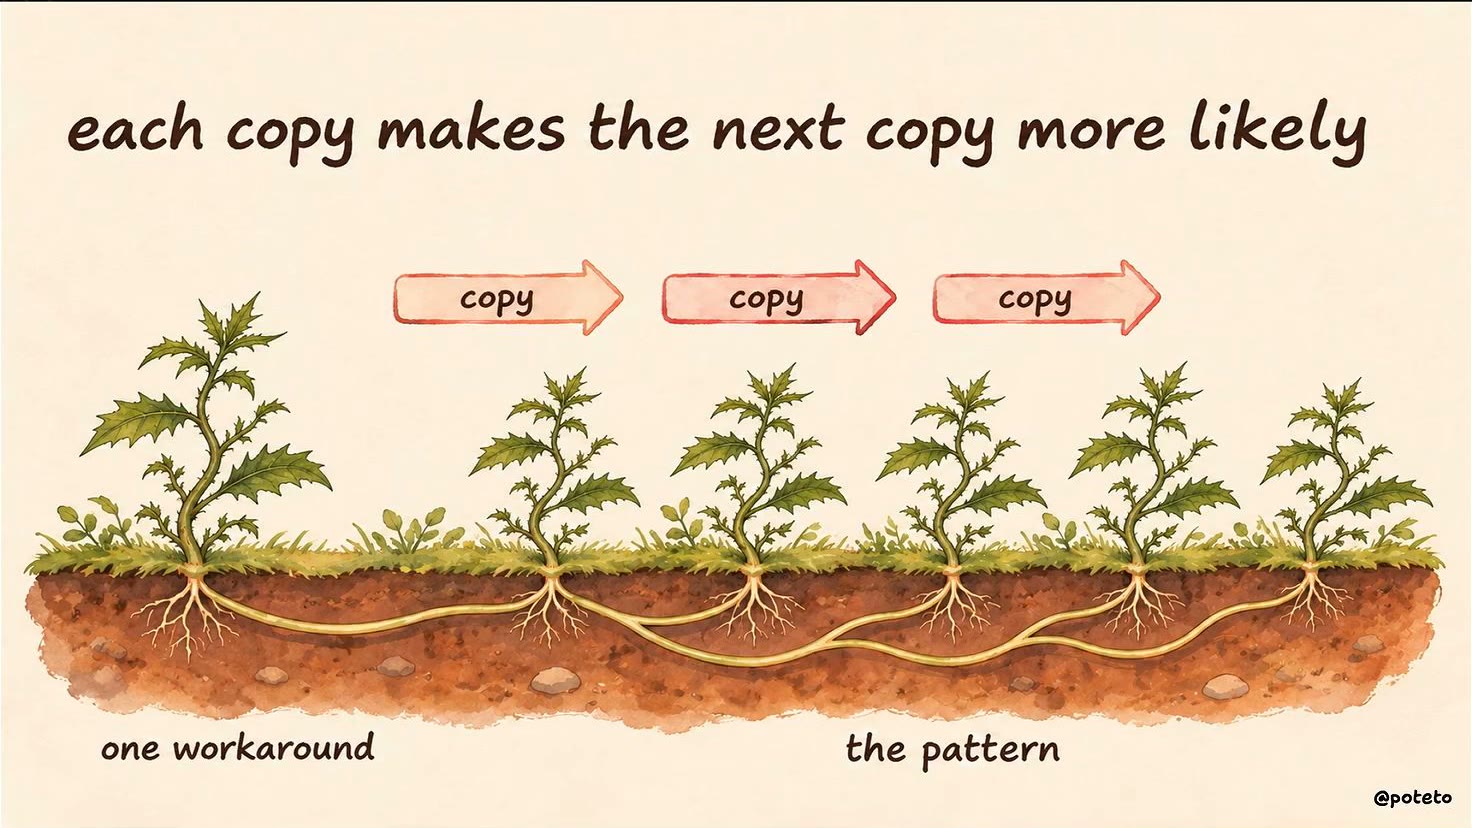
땜질·안티패턴·폐기된 코드·기술 부채가 무엇이든, 코드베이스의 확립된 패턴처럼 보이니 다음 에이전트가 그냥 베낄 가능성이 커진다. 정원에 잡초나 해충이 자라다 정신 차려 보면 사방에 퍼져 있는 것과 같다. 그래서 코드베이스를 최대한 깨끗하게 유지해 에이전트가 늘 좋은 것만 베끼게 해야 한다(슬라이드: yes, you should read the code sometimes).
[06:27] 6. Dune — 쓰기 까다로운 건 아예 금지
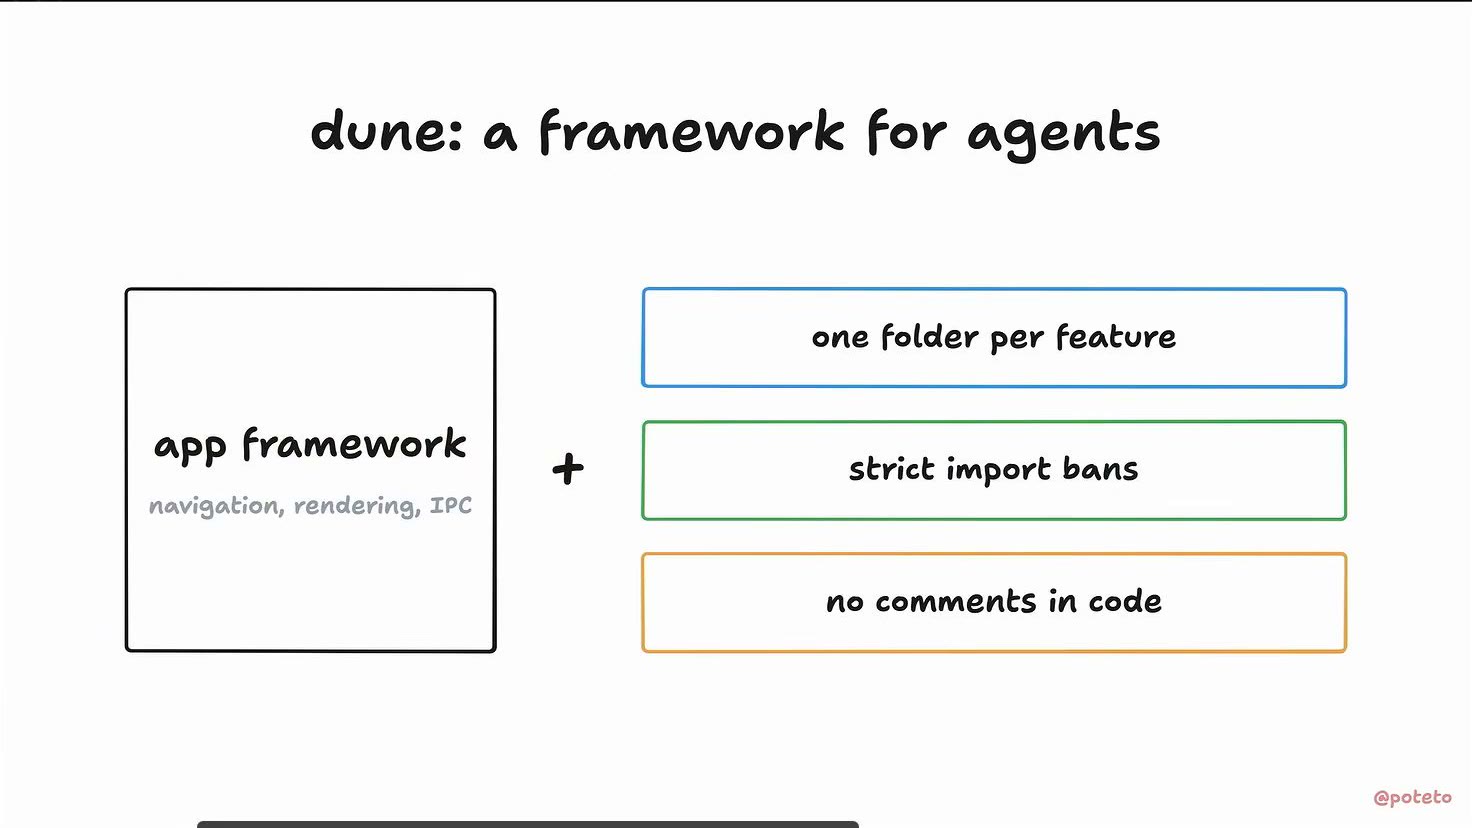
해설 Lauren Tan 팀은 Grok Bot을 만들면서 Dune이라는 자체 프레임워크를 쓴다. 예시 두 개가 모두 프런트엔드 이야기라 용어를 먼저 푼다. useEffect는 “쓸 수는 있지만 제대로 쓰기가 까다로운 기능” 정도로 들으면 된다. 두 번째 예시의 “화면을 그리는 쪽 코드와 뒤에서 일하는 쪽 코드가 섞이면 앱이 버벅인다”는 말은, 백엔드로 치면 서로 다른 프로세스에서 도는 모듈끼리 가져다 쓰지 못하게 경계를 막아 두는 것과 비슷하다.
발표 Dune은 Grok Bot용 클라이언트 프레임워크로, “Electron 앱용 Next.js” 정도라 기술적으로는 그다지 흥미롭지 않다. 흥미로운 점은 제약과 린트 규칙이 아주 많다는 것이고, 데스크톱 앱을 만들며 배운 교훈을 거기에 담았다. 교훈 하나는 “잘 쓰려면 미묘한 판단이 필요한 것은 슬롭으로 이어지기 쉽다 — 그냥 더 나은 API를 설계하라”다. 대표 예가 React의 useEffect로, 쓰려면 박사 학위가 필요하다는 농담이 있을 만큼 판단이 많이 필요하고 에이전트는 이걸 잘 못 쓴다. 해결책은 제품 코드에서 아예 금지하고 Dune API 안쪽 몇 군데에서만 허용하는 것이었다. 이 문제는 범주째 사라졌고, 코드 리뷰에서 다시 잡을 일도 없다.
[08:06] 7. 디렉터리 구조가 맥락이다
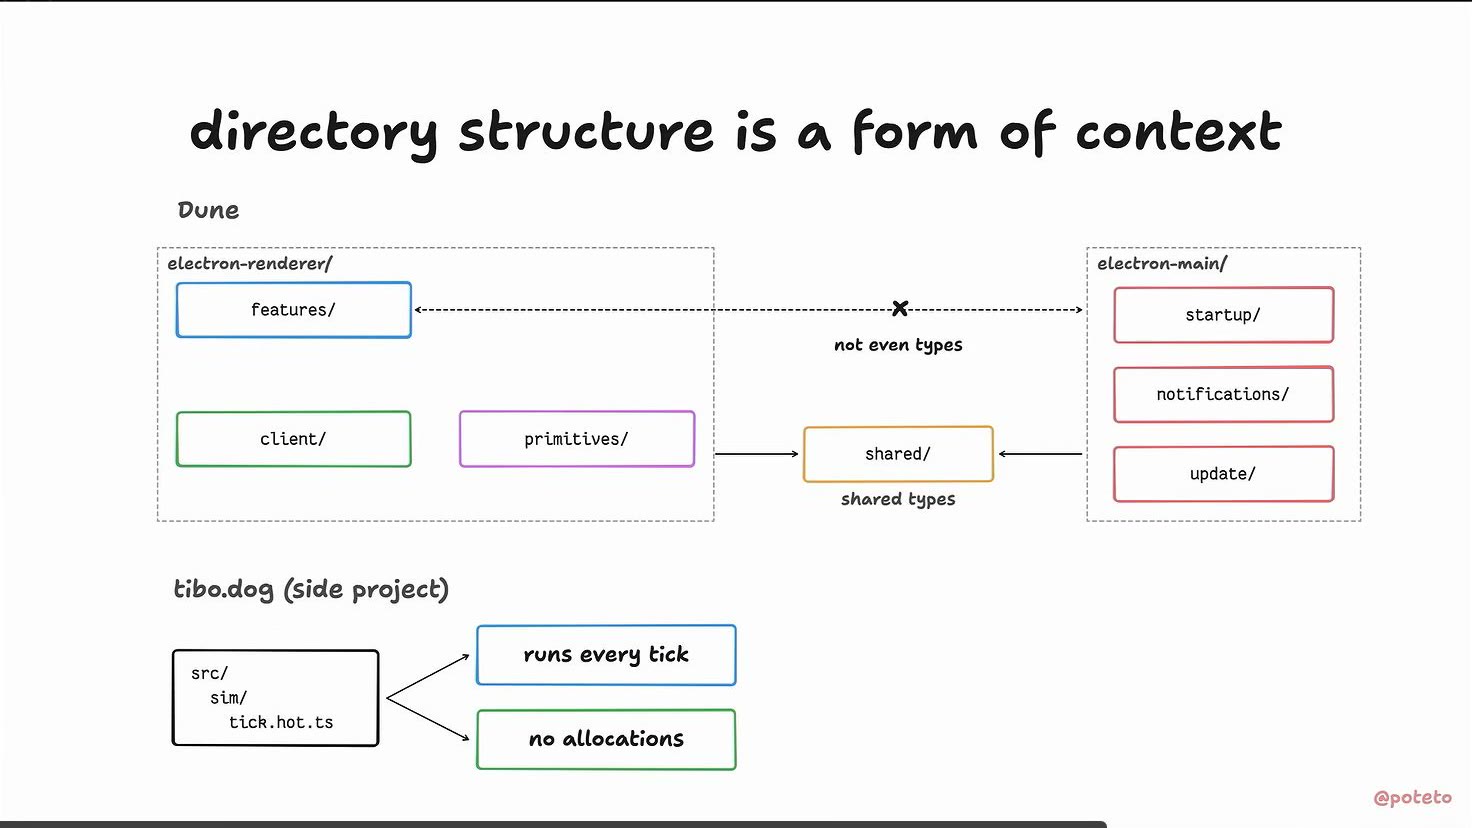
발표 Electron 앱인 Cursor에서 본 안티패턴은 에이전트가 main 스레드 코드를 renderer 스레드로 자주 import하는 것이었고, 그러면 긴 작업과 버벅임이 생긴다. Grok Bot과 Dune 앱에서는 이를 관례로 못 박았다. 최상위 디렉터리가 말 그대로 electron-renderer와 electron-main 두 개이고, 둘 사이의 import는 의존성 그래프 분석기와 린트 규칙 몇 개로 막아 뒀다(타입조차 직접 가져오지 못하고 shared/의 공유 타입만 쓴다). 덕분에 코드 리뷰 때 살피고 고민할 게 하나 줄었다. 개인 프로젝트 tibo.dog에서는 src/sim/tick.hot.ts처럼 경로 이름에 “매 tick 실행·할당 금지”라는 규칙을 담는다.
해설 쓰기 까다로운 건 제품 코드에서 아예 못 쓰게 했고, 섞이면 안 되는 건 폴더와 린트로 갈라놨다. 두 경우 모두 리뷰에서 다시 볼 일이 없어졌다.
[08:53] 8. 날짜 세 개 — setTimeout 한 줄이 타이머 183개로
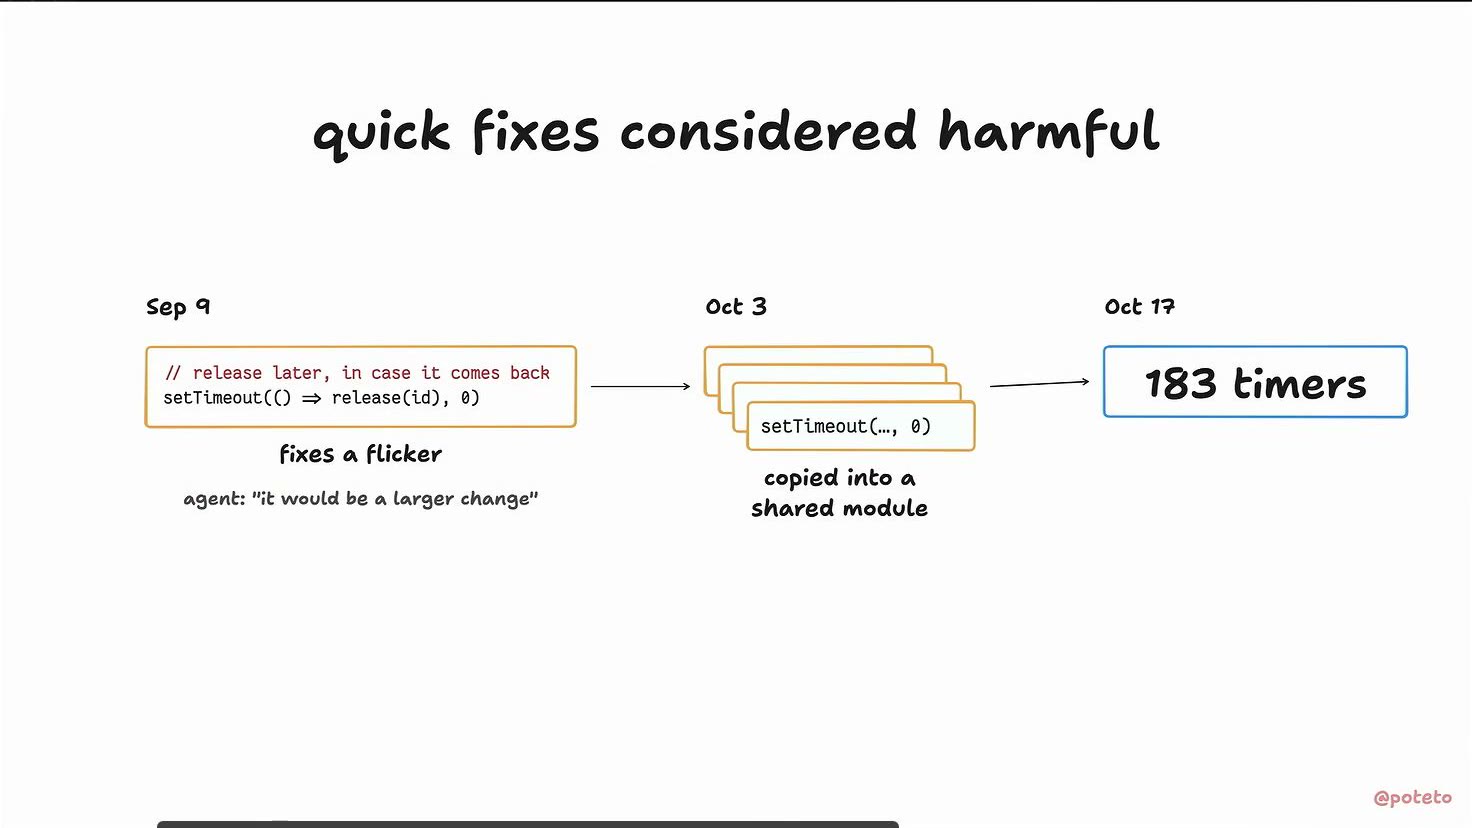
해설 화면에 9월 9일, 10월 3일, 10월 17일이 차례로 나온다. Cursor에서 있었던 일이다. setTimeout은 “이 코드를 조금 이따가 실행하라”고 미뤄 두는 타이머다. 9월 9일에는 화면 깜빡임을 고치려고 넣은 한 줄이었고, 그 위에 빨간 주석이 붙어 있었다.
// release later, in case it comes back
setTimeout(() => release(id), 0)
발표 먼저 에이전트가 쓰는 마크다운이 의외의 문제였다. 문서·코드 주석·규칙·스킬을 에이전트는 옳은 일을 안 한 데 대한 변명을 적는 곳으로 쓴다. 또 사람이 한 작은 교정에 과하게 반응해 절대 깨면 안 되는 철칙처럼 다룬다. Cursor의 예에서 에이전트는 setTimeout·requestAnimationFrame·requestIdleCallback 같은 명령형 타이머를 정말 좋아했다. 이걸 땜질로 썼지만 실은 VS Code의 명령형 스타일과 React의 선언형 스타일 사이의 아키텍처 충돌을 덮고 있었다(에이전트의 변명: “그러면 더 큰 변경이 된다”). 그 한 줄이 10월 3일 공유 모듈로 복사됐고, 10월 17일에는 타이머 183개가 됐다. 이 아키텍처 선택은 클라이언트 성능도, 에이전트 성능도 훨씬 나쁘게 만들었다.
[10:07] 9. 주석 99% 금지 — 교정은 린트로
발표 JavaScript로 성능 작업을 해 봤다면 알겠지만, 타이머가 많이 빠르게 생겼다 없어졌다 하면 큰 가비지 컬렉션이 자주 일어나 렉과 버벅임을 많이 일으킨다. 더 나쁜 건 에이전트가 이 땜질이 왜 정당한지 설명하는 주석을 잔뜩 달았다는 점이다. 그러다 어느새 타이머가 사방에 퍼졌고 앱 성능이 정말 나빠졌다.
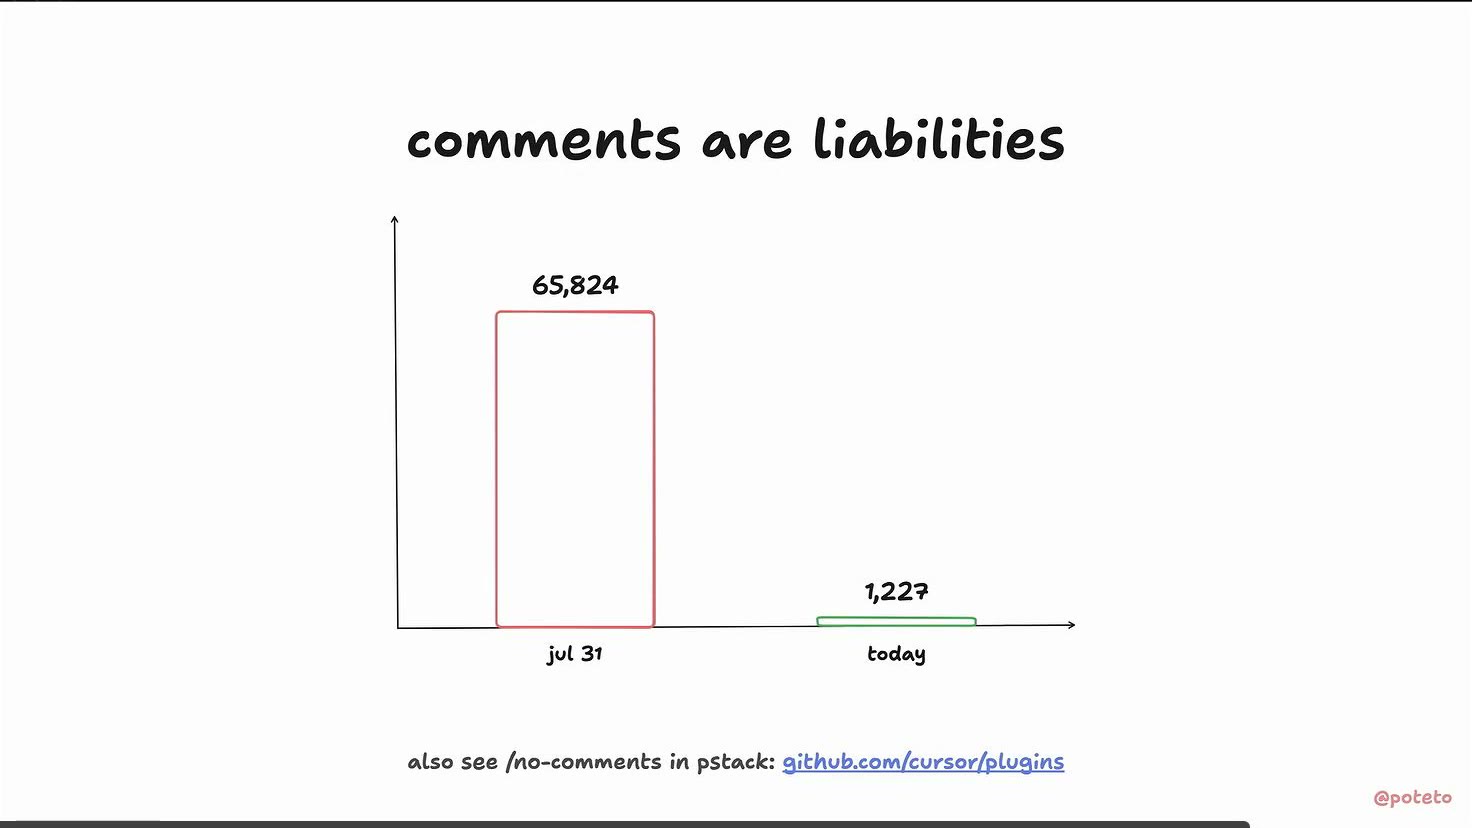
그래서 Grok Bot에서는 교훈을 얻어 주석의 99%를 금지했다. 주석은 금방 낡고, 사람은 어차피 주석 슬롭을 굳이 읽지 않는다. 또 주석은 에이전트에게 어렵다는 이유로 옳은 일을 안 하는 걸 정당화하는 탈출구가 된다. 가장 나쁜 점은 강제할 수 없다는 것이다. 다음 에이전트한테 “이건 하지 마”라고 적어 두는 게 좋은 의도 같아 보여도, 결국 믿을 수 있는 무엇이 되지 못한다.
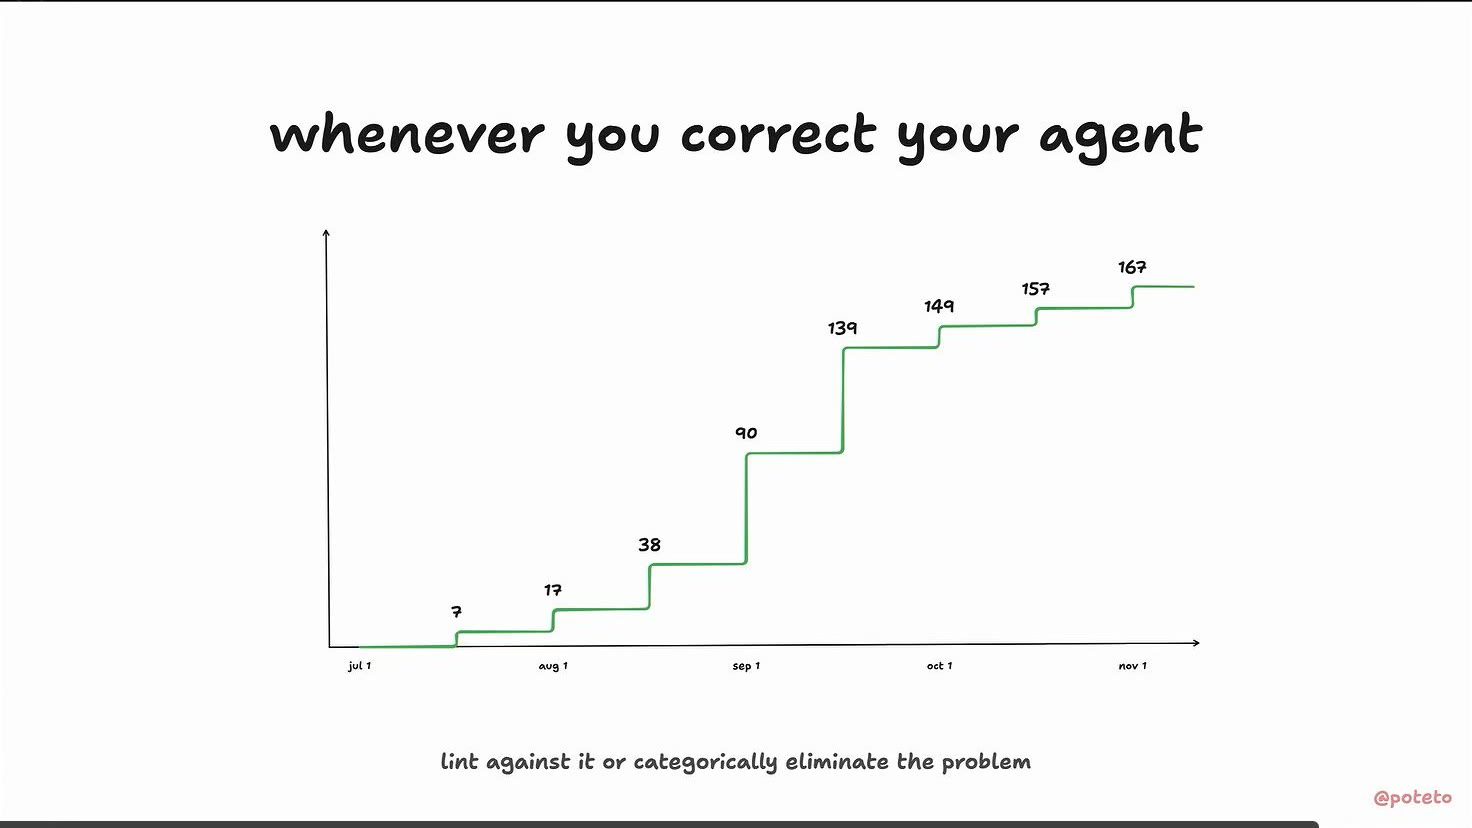
그래서 Grok Bot과 Dune에는 이제 땜질 말고 진짜 문제를 고치라고 에이전트에게 알려 주는 아주 친절한 에러 메시지를 내는 린트 규칙이 있다. 일반 원칙은 에이전트를 교정할 때마다 그게 결정적 검사 하나가 되게 하거나, 더 나은 API 설계·아키텍처로 그 문제를 코드에서 범주째 없앨 방법을 고민하는 것이다. 충분히 반복하면 코드 리뷰에서 살필 게 점점 줄고, 어느 순간 더 리뷰할 게 없다는 걸 깨닫게 되고, 에이전트가 자기 PR 대부분을 스스로 병합하게 둘 수 있다.
해설 주석은 7월 말 65,824개에서 지금 1,227개가 됐다. 계단 모양 그래프는 7월의 7에서 시작해 167까지 올라간다. 축 이름은 따로 없지만 교정할 때마다 린트나 설계로 옮긴다는 원칙을 말하는 대목에 나온 그래프다. 화면 아래 작게 지나간 /no-comments는 Lauren Tan이 만든 pstack 플러그인의 스킬 이름이다. 여기까지가 피라미드의 위쪽 두 칸(코드베이스와 정적 분석)이다.
[12:01] 10. 가장 중요한 칸, 검증 — 런타임 검증
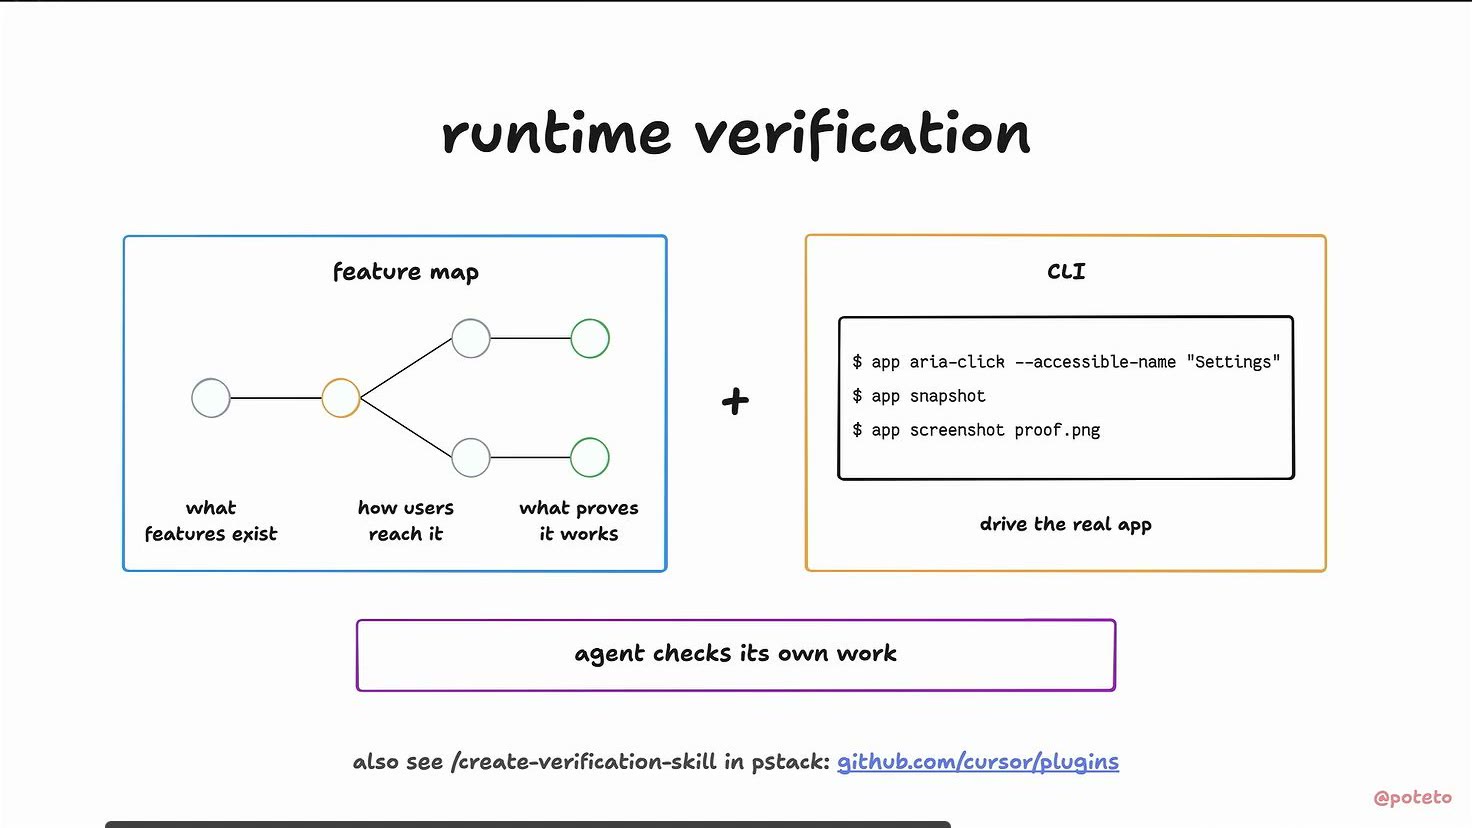
해설 Lauren Tan이 가장 중요한 단계라고 부르는 것은 세 번째 칸, 검증이다. 데모 끝에 나오는 터미널 명령어 세 줄은 앱에서 설정 버튼을 누르고, 화면 상태를 찍고, 스크린샷을 증거 파일로 남기는 명령이다.
$ app aria-click --accessible-name "Settings"
$ app snapshot
$ app screenshot proof.png
발표 검증은 에이전트를 더 자율적으로 만들고 그 작업에 대한 확신과 신뢰를 높이는 큰 부분이다. 코드 리뷰 과정은 이제 검증 산출물을 보는 걸로 확 줄었다 — 영상, 스크린샷, 다이어그램, 형식 검증 같은 것이다. 가장 기본적인 예가 런타임 검증으로, 에이전트가 코드를 직접 실행해 볼 수 있게 하고 Chrome DevTools Protocol처럼 사람 개발자가 쓰는 디버깅 도구도 쓰게 한다는 말을 멋지게 부르는 것이다. 런타임 검증 스킬에는 **피처 맵(기능 지도)**이 있다. 사용자 관점에서 본 앱의 모든 기능의 사이트맵 같은 것으로, “왼쪽 사이드바에 있는 그거”라고 해도 에이전트가 짐작할 필요가 없다. 공통 어휘가 생기는 셈이다. 스킬 안에는 전용 CLI도 둬서 에이전트가 매번 같은 CLI와 드라이버를 재사용하게 하고, 그러면 토큰 사용량도 줄고 테스트도 할 수 있다(pstack /create-verification-skill, 같은 구조는 2026-10-03-lauren-tan-agent-verification-environment).
해설 에이전트가 PR 대부분을 스스로 병합한다면 사람이 보는 건 코드가 아니라 검증의 증거다. 에이전트가 실제 앱을 직접 돌려 보고 그 증거를 남기는 게 런타임 검증이다.
[13:46] 11. 형식 검증과 속성 기반 테스트 — 어디까지인가
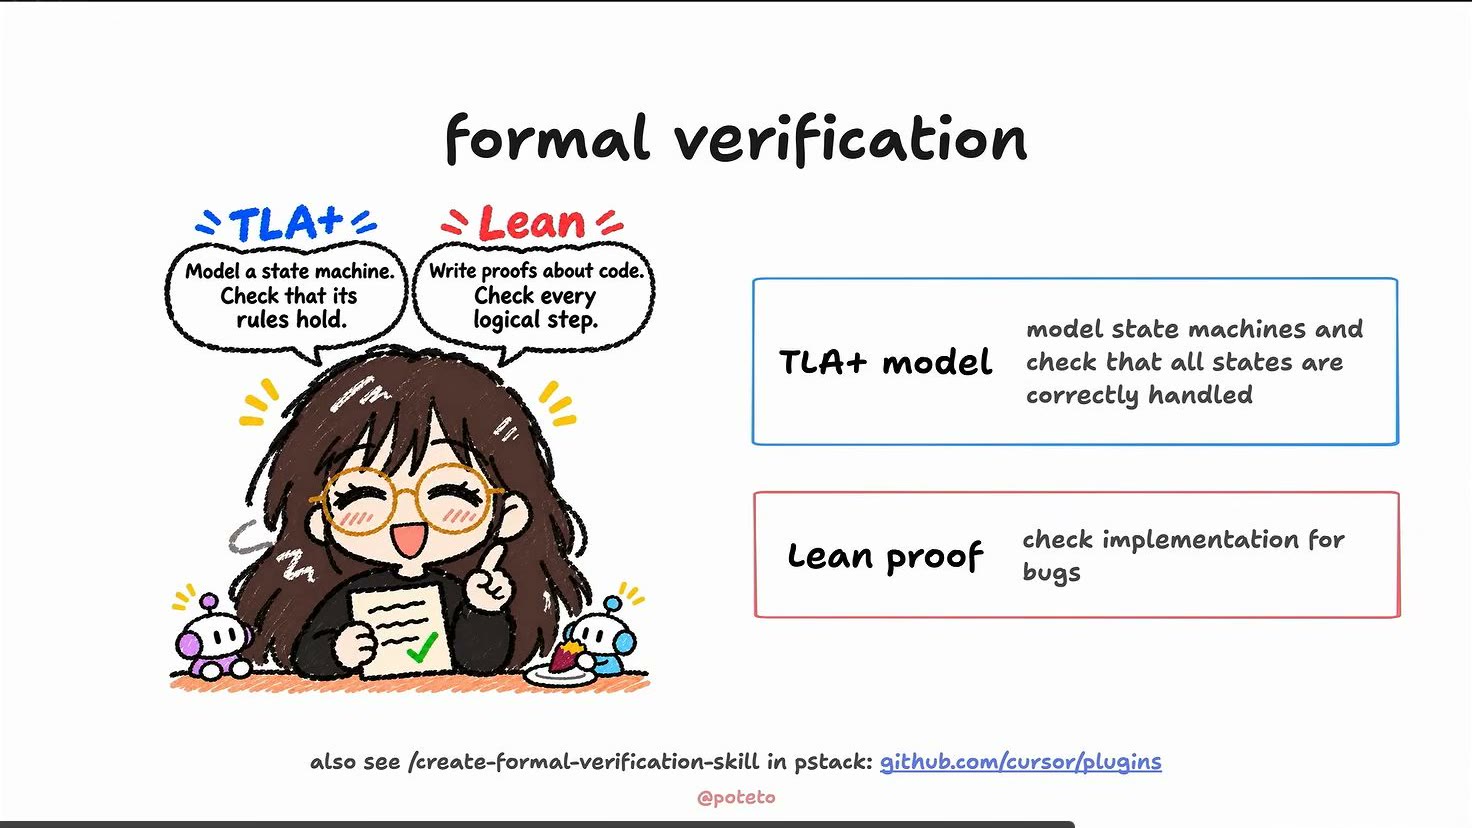
해설 낯선 이름 세 개를 먼저 푼다.
| 도구 | 해설의 풀이 |
|---|---|
| TLA+ | 시스템이 가질 수 있는 상태를 전부 펼쳐 놓고 빠뜨린 경우가 없는지 기계가 따져 보게 하는 도구 |
| Lean | 알고리즘이 맞다는 걸 수학 증명처럼 한 단계씩 확인하는 도구 |
| 속성 기반 테스트 | 예시 몇 개를 손으로 적는 대신, 어떤 입력이 와도 지켜져야 하는 조건을 적어 두고 입력을 무작위로 쏟아붓는 방식 |
발표 최근엔 형식 검증도 보기 시작했다. TLA+로 여러 기기와 플랫폼에 걸친 알림 같은 주요 사용자 흐름의 모델 검사를 하고, 특정 알고리즘을 증명할 땐 Lean(정리 증명기)을 쓴다. 예를 들어 직접 만든 가상화 라이브러리에 깜빡임이나 떨림이 없는지 Lean으로 확인한다. 전반적으로는 아직 실험 중이지만 꽤 유망해 보이고, 형식 검증으로 이미 버그를 꽤 찾았다. 그리고 막 보기 시작한 또 하나가 UI용 속성 기반 테스트로, Bombadil(github.com/antithesishq/bombadil)이라는 라이브러리로 벌써 UI 버그를 몇 개 잡았다.
해설 화면에 지나간 결론은 “은탄환은 아니고, 층 하나를 더 쌓은 것”이다. 마지막에 나온 Bombadil은 화면에 저장소 주소가 함께 적혀 있었다.
[15:17] 12. 트윗 두 장 — 하루 토큰의 70%가 검증으로
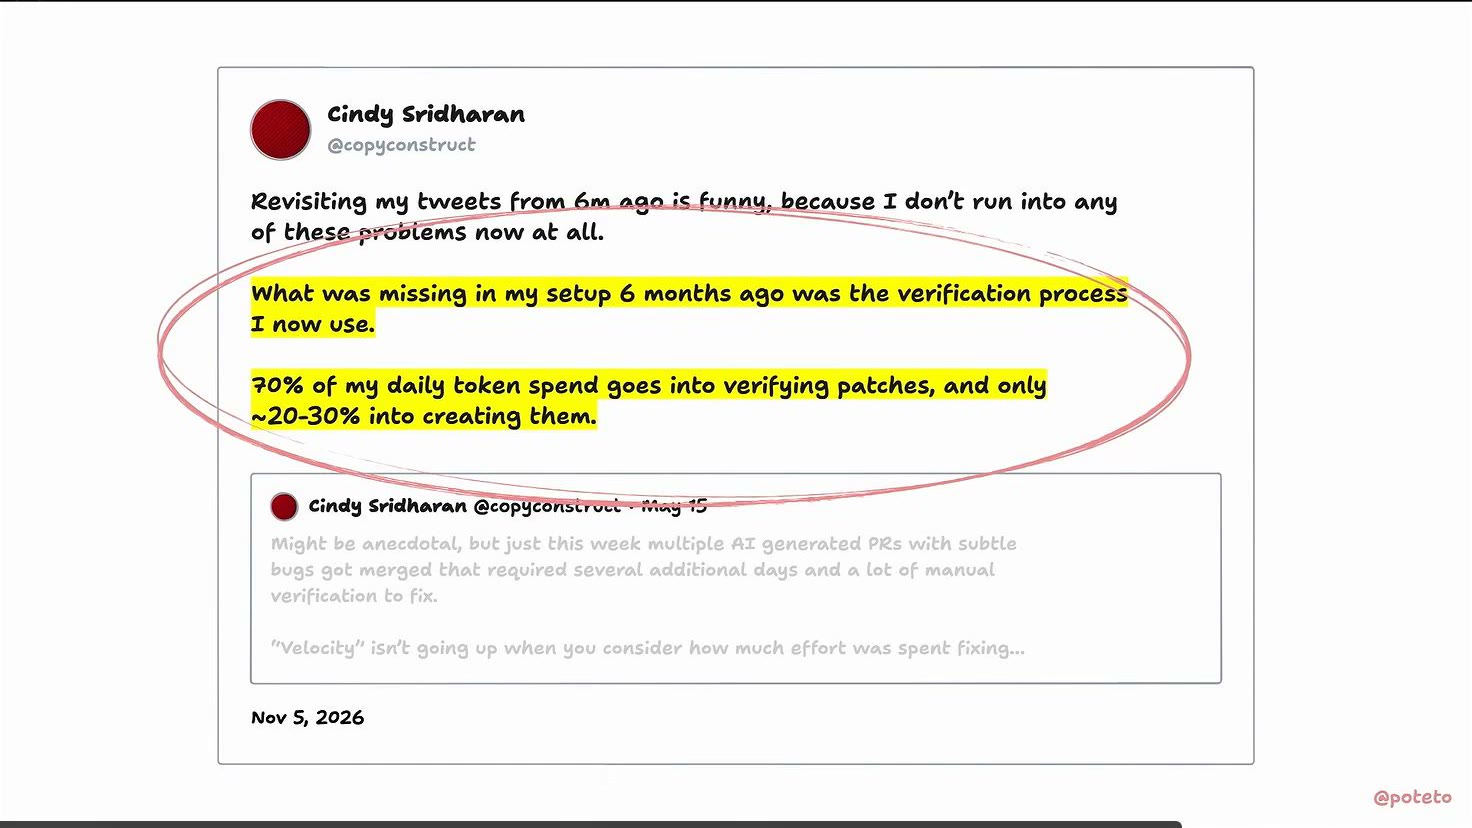
해설 Lauren Tan은 Cindy Sridharan이 여섯 달쯤 간격을 두고 쓴 트윗 두 장을 보여 준다. 5월 15일 트윗은 미묘한 버그가 있는 AI 생성 PR 여러 개가 병합돼 고치느라 며칠이 더 들고 수작업 검증도 많이 필요했다는 내용이다. 11월 5일 트윗에는 하루에 쓰는 토큰이 어디로 가는지에 관한 숫자가 나온다.
발표 6개월 전 Cindy는 미묘한 버그가 든 PR이 자꾸 병합돼 에이전트를 믿을 수 없다고 했다. 에이전트를 믿으려면 정말 빠져 있던 건 검증 과정이었고, 6개월이 지난 지금은 하루 토큰의 70%를 검증에 쓴다. Lauren Tan은 이게 자기가 보는 것과도 맞는다고 한다. 그의 토큰도 대부분 검증에 쓰인다. Cindy가 정리한 기법 목록(단위·퍼즈·속성 기반·형식 검증부터 카나리·카오스 테스트까지)에 새롭고 참신한 기법은 하나도 없다. 그냥 좋은 소프트웨어 엔지니어링 도구지만, 이해하고 쓰고 유지하기 어려워 예전엔 쓰기에 너무 비쌌다. 에이전트가 이 비용을 확 낮춰 줘서 “지금 우리는 소프트웨어 테스트와 검증의 황금기에 들어서고 있다.” 형식 검증은 제품이 어떻게 동작해야 하는지, 에이전트가 의도와 목표를 제대로 이해했는지 따져 보게도 해 준다. 그래서 사용자 관점의 상태 기계를 시각화하는 /statechart 스킬을 pstack에 새로 넣었고, 영상·스크린샷과 함께 리뷰하기가 훨씬 쉽다고 한다(2026-10-30-x-minheo-poteto-state-diagram-verifier).
해설 하루 토큰의 70%가 검증으로 간다는 얘기였다. 끝에 나온 statechart도 pstack에 들어 있는, Lauren Tan이 직접 만든 스킬이다. 여기까지가 투자다 — 코드베이스를 정리하고, 교정을 린트로 옮기고, 검증을 여러 겹으로 쌓는 일.
[17:09] 13. 돌아온 것 — 팀 숫자
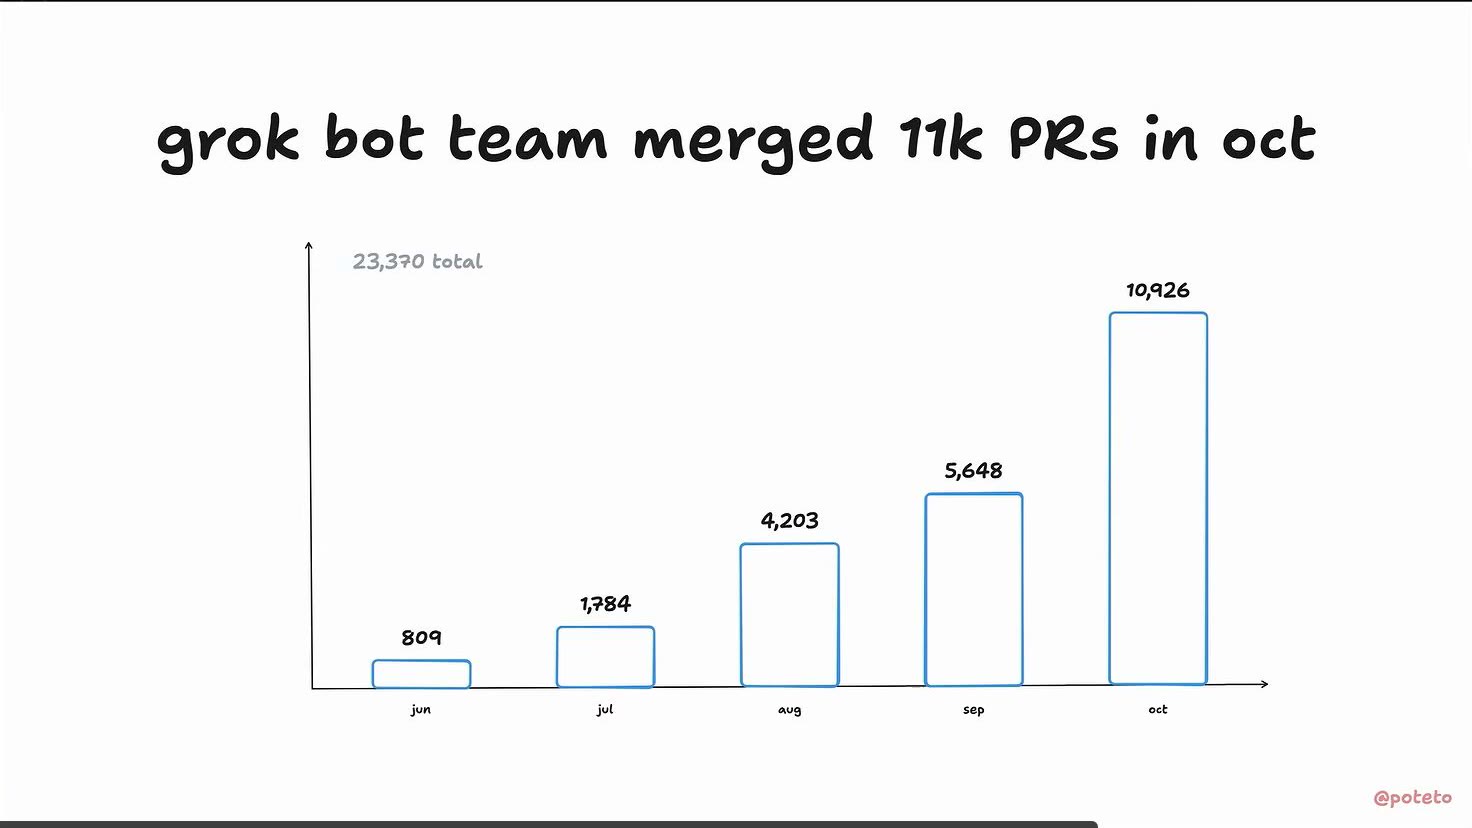
해설 차트 다섯 장이 연달아 나온다. 앞의 세 장은 팀이 병합한 PR 수, 데스크톱 앱 릴리스 횟수, 기여한 사람 수다. 기여자 차트의 막대 색은 한 사람이 올린 PR 수에 따라 나뉜다. 이 속도에서 되돌림 비율이 어떻게 움직였는지가 네 번째, 앱 성능이 다섯 번째다.
발표 Grok Bot 팀의 속도는 날아오르듯 빠르게 올라가고 있고, 지난달 팀은 무려 PR 11,000개를 프로덕션에 냈다. 클라이언트 릴리스 속도도 빨라져 새 안정 버전을 거의 하루에 한 번꼴로 낸다. 코어 팀도 훨씬 많이 내보내고, 맥락이 많지 않은 가볍게 또는 한 번씩 들르는 기여자도 훨씬 많아졌다. 10월엔 약 227명이 PR을 하나 이상 냈다.
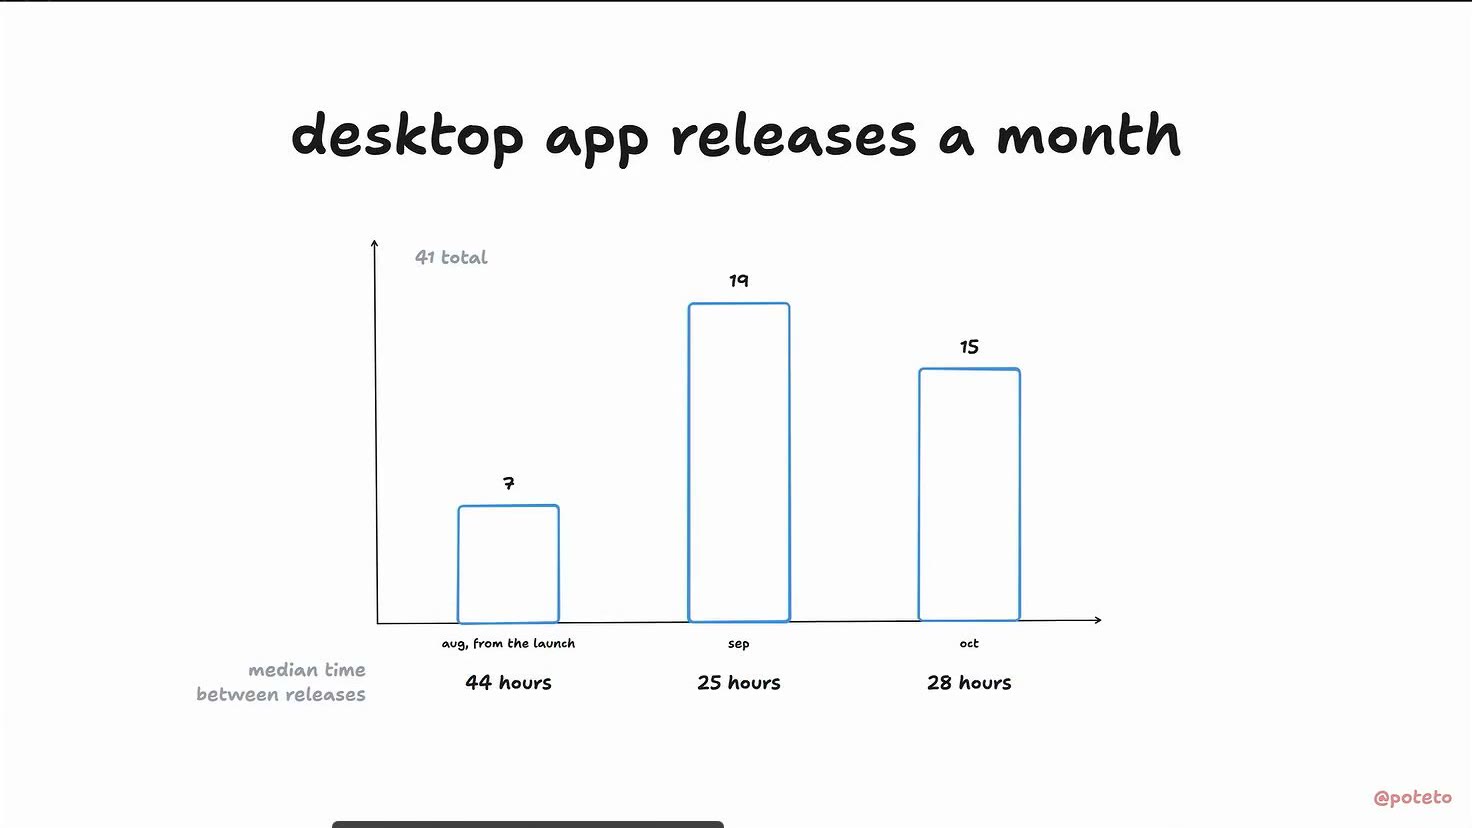
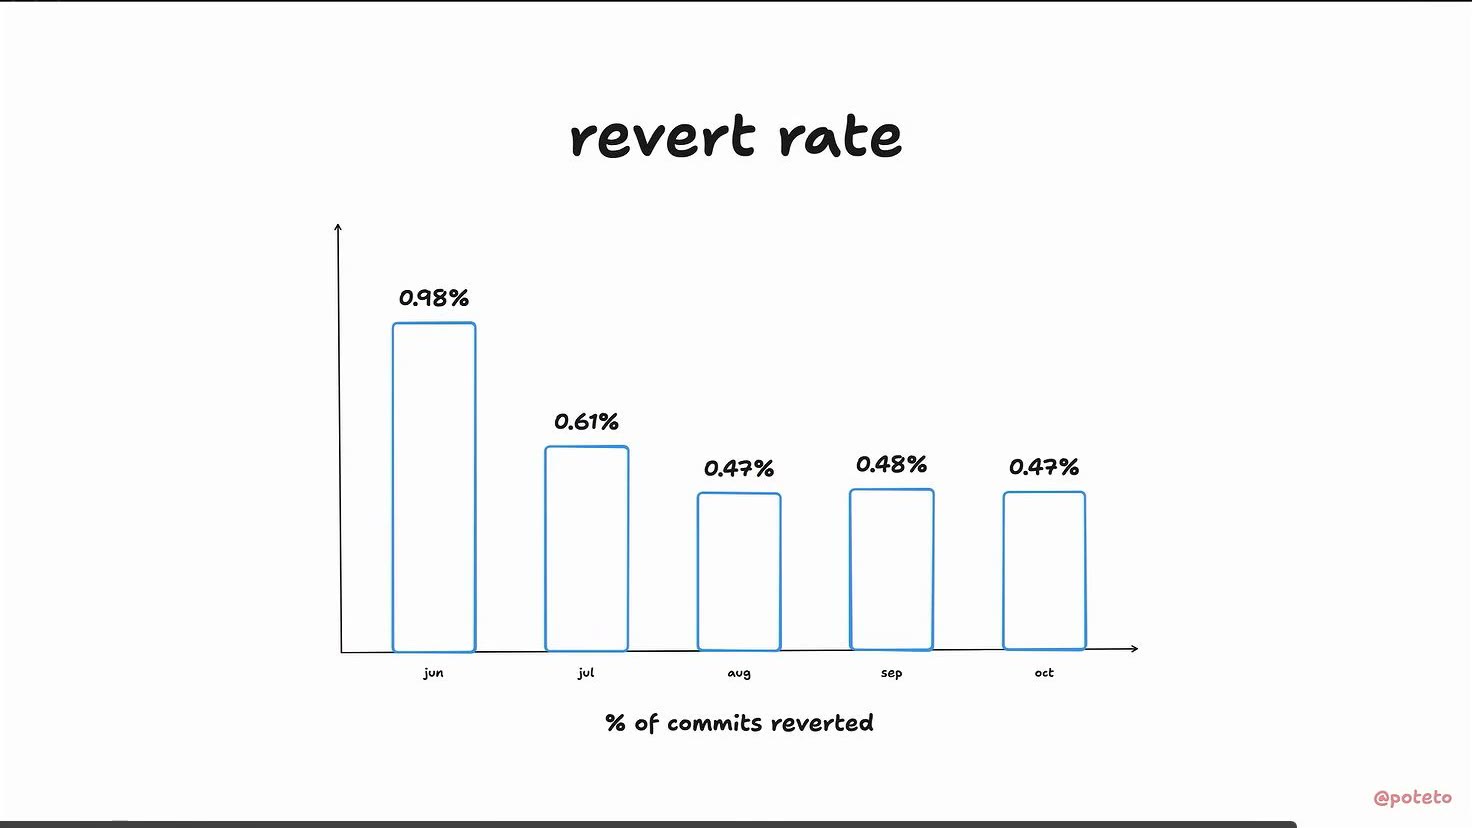
이렇게 빨라지니 “이거 혼돈 아니야? 슬롭 덩어리 아니야?” 싶을 수 있다. 하지만 되돌려지는 PR 수는 상대적으로 오히려 줄었고 약 0.5%에서 안정적이다. 성능도 그냥 유지된 게 아니라 출시 때보다 여러 면에서 좋아졌다. 시작·타이핑·새 채팅 열기·채팅 전환이 전부 빨라졌다. Grok Bot은 아직 Electron 앱이지만 다른 많은 에이전트 UI보다 이미 훨씬 빠르고, 이 속도에 기여자도 이렇게 많은 Electron 앱치고는 꽤 괜찮다는 것이 발표자의 평가다(성능표 전체와 기여자 분포는 2026-11-15-lauren-tan-all-code-is-slop 장면 12).
해설 성능표 아래 작은 글씨 한 줄 — Electron 앱에는 천장이 있고 Rust로 다시 쓰는 것도 생각해 보는 중이라는 내용이다. 그리고 두 가지 단서를 단다.
- 이 숫자들은 발표에서 Lauren Tan 팀이 직접 제시한 값이라 따로 확인할 수 있는 자료가 없었다.
- 릴리스는 말로는 “하루에 한 번쯤”이라고 했지만, 슬라이드에 적힌 릴리스 간격 중앙값은 9월 25시간, 10월 28시간이다.
원본 노트가 지적하듯 같은 성능표에서 유휴 메모리(+12%)·유휴 CPU(+100%)·시작 시 JS+CSS 크기(+285%)는 오히려 늘었다.
[19:24] 14. 소프트웨어 공장보다 먼저 — 나쁜 루프는 자동화하지 마라
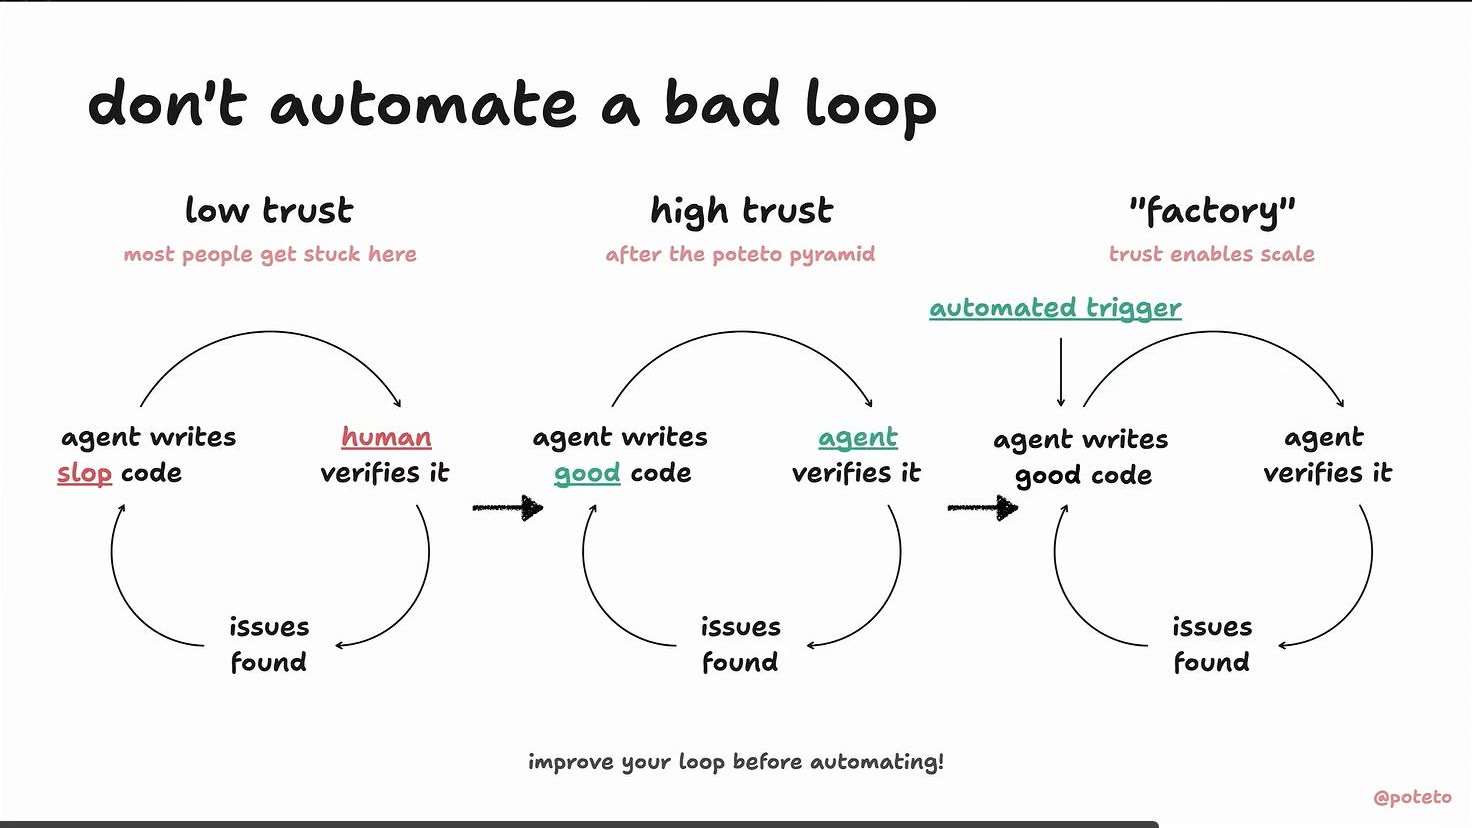
해설 그러면 이 결과를 보고 자동화부터 시작하면 될까. Lauren Tan의 답은 순서에 관한 것이다.
발표 소프트웨어 공장을 짓고 할 수 있는 건 다 자동화하기 전에, 에이전트를 교정할 땐 먼저 코드베이스를 개선하는 걸로 해 보라. 새 안티패턴이 생기지 않게 린트 규칙부터 만들고, 그다음 옛 패턴도 청소하고, 검증 체계를 정말 탄탄하게 만든다. 이런 작업 대부분은 어차피 자동화의 전제 조건이다. 안쪽 코딩 루프가 슬롭을 만들면 그 루프를 자동화해 봐야 슬롭만 더 나오고, 문제에 토큰을 계속 더 쏟아부어야 하는데 다들 알다시피 아주 비싸다. 코드베이스·정적 분석·런타임·형식 검증에 투자해 두면 이 기초 위에서 많은 게 가능해지고, 여러분만의 공장을 정말 쉽게 지을 수 있다는 걸 알게 된다. 같은 채널의 2026-07-27-agentos-why-software-factories-fail은 슬롭의 원인을 다른 쪽(테스트 통과만 보상하는 RL)에서 찾지만, 자동화보다 앞단의 품질이 먼저라는 결론은 같다.
[20:42] 15. Grok Bot을 바깥 루프로 — 릴리스마다 퍼징
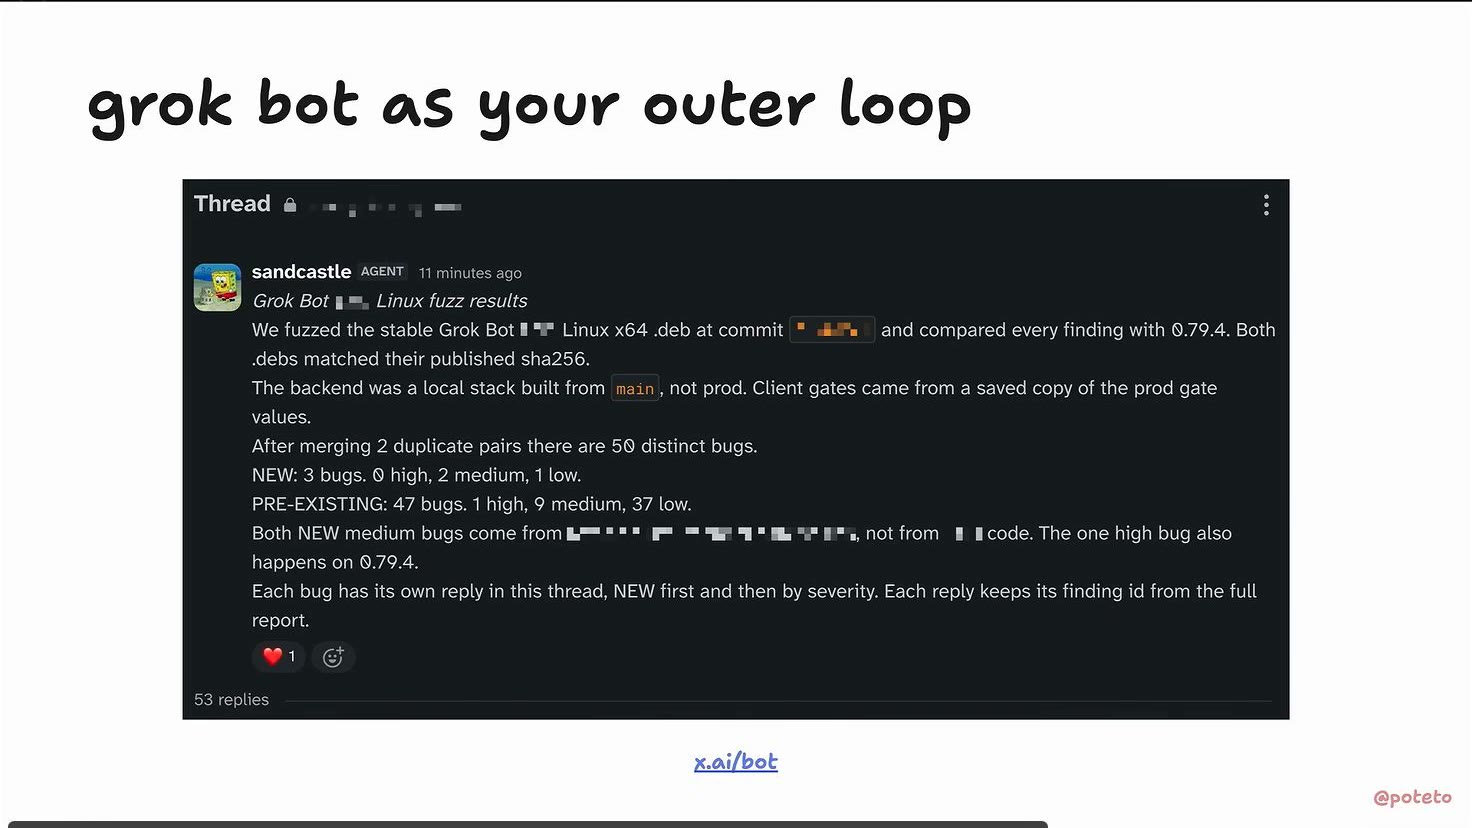
해설 코드를 쓰는 안쪽 루프가 슬롭을 내고 있으면 그 루프를 자동화해도 슬롭만 더 나온다. 그래서 새로 생기는 안티패턴을 린트로 먼저 막고 이미 있는 건 그다음에 치우라는 순서였다. 이 기초 위에 팀이 올린 것이 마지막 예시다. Lauren Tan은 자기 팀 제품인 Grok Bot을 바깥 루프로 쓰라고 권한다. X에 올라온 피드백·이슈 티켓·Slack 메시지·모니터링 알림 같은 신호가 들어오면 Grok Bot이 에이전트를 띄워 일을 시작하는 그림이다. 마지막 예시의 퍼징은 앱에 온갖 입력과 조작을 마구 던져서 깨지는 곳을 찾는 테스트이고, 화면의 Slack 스레드는 그 결과 보고다.
발표 이제 새 릴리스를 낼 때마다 Grok Bot이 자동으로 새 Cursor 프로젝트를 띄워 앱 전체, 빌드 전체를 퍼징한다. 실제 사용자처럼 앱을 실행하고 써 보면서 버그를 찾아내고, 찾은 버그마다 수정 PR을 열어 자동으로 병합한다. 코드베이스가 충분히 좋아서 PR이 기본적으로 좋게 나오는 편이고, 넣는 제품 코드 대부분은 이제 사람이 깊이 리뷰할 필요가 별로 없기 때문이다. 슬라이드의 스레드는 안정판 Linux x64 .deb를 퍼징해 0.79.4와 비교한 결과로, 중복 두 쌍을 합쳐 고유 버그 50개(신규 3 — high 0·medium 2·low 1, 기존 47 — high 1·medium 9·low 37)를 보고했다.
[21:53] 16. 정리 — 내 코드베이스에 넣을 것
발표 단단한 기초와 좋은 유기적 아키텍처가 있으면 슬롭을 금으로 바꿀 수 있고, 품질을 타협하지 않고도 높은 품질로, 빠른 속도로 내보낼 수 있다.
해설 발표는 처음 제목으로 돌아가서 끝난다. 마지막 슬라이드에서 괄호 안의 말이 “내 것만 빼고”에서 **“여러분 것만 빼고”**로 바뀌어 있다. 해설은 오늘 내 저장소에 넣어 볼 수 있는 일을 작게 줄인다. 에이전트가 같은 실수를 해서 또 고쳐 줬다면 규칙 파일에 한 줄을 보태기 전에 그걸 린트 규칙이나 테스트로 만들 수 있는지 먼저 본다. 새로 생기는 것부터 막고 이미 있는 건 그다음에 지운다. 그리고 에이전트가 자기 결과를 직접 실행해서 확인할 방법을 하나 열어 준다 — 스크린샷이든 테스트 출력이든, 사람이 코드 대신 그 증거를 볼 수 있게.
반대로 주석을 거의 다 없애는 일이나 PR 자동 병합은 다른 이야기라고 선을 긋는다. Lauren Tan도 PR 수천 개를 올리는 데까지 여섯 달이 걸렸고, 팀의 숫자는 그 팀의 코드베이스에서 나온 것이다. 그러니 피라미드의 맨 윗칸부터 한 가지씩 옮겨 보면 된다.
부록 — 실전 체크리스트
해설이 “오늘 해 볼 것”으로 추린 항목이 위쪽, 발표에 나왔지만 해설이 “다른 이야기”로 미룬 항목이 아래쪽이다.
오늘 넣어 볼 것
- 같은 교정을 두 번 했다면, AGENTS.md·규칙 파일에 한 줄 보태기 전에 린트 규칙이나 테스트로 만들 수 있는지 본다. 린트 에러 메시지에 “땜질 말고 근본 원인을 고쳐라”는 안내를 넣는다.
- 새 안티패턴의 발생부터 린트로 막고, 기존 코드 정리는 그다음에 한다.
- 에이전트가 결과를 직접 실행해 확인할 길을 하나 연다. 예: 실제 앱을 조작하는 작은 CLI(
aria-click·snapshot·screenshot), 사용자 관점의 피처 맵. 리뷰는 코드 대신 그 증거(스크린샷·테스트 출력)로 한다. - 섞이면 안 되는 코드(UI 스레드 ↔ 백그라운드 프로세스 등)는 최상위 폴더로 나누고 경계 import를 린트로 금지한다.
- 쓰기 까다로운 API(예:
useEffect)는 제품 코드에서 금지하고 더 단순한 API를 제공한다.
바로 따라 하지 않을 것(해설의 단서)
- 주석 99% 금지, PR 자동 병합 — 발표자 팀도 여섯 달이 걸렸고, 숫자는 그 코드베이스에서 나온 것이다.
- 형식 검증(TLA+·Lean)·UI 속성 기반 테스트 — 발표자 스스로 “아직 실험 중”이라고 했다.
- 팀 숫자(PR 10,926개·되돌림 0.47%·하루 한 번 릴리스)는 자체 집계이고, 릴리스 간격 중앙값은 실제로 25~28시간이다.
원문 인용 모음
발표 구간은 영상에 입혀진 채널 자막의 영어 원문, 해설 구간은 한국어 자동자막을 가볍게 정정했다.
- [01:04] (발표) “How many of you have ever looked at code that somebody else wrote and you thought, that’s all slop?”
- [01:12] (발표) “But today, I’m going to convince you that you can turn that slop into gold.”
- [02:12] (발표) “Not blind trust, but investing in your agent’s environment so you can trust that your agents are going to do the right thing.”
- [04:45] (발표) “Whenever you’re correcting your agent, think about how you can make that a deterministic check instead of adding another line to your rules or your AGENTS.md.”
- [07:24] (발표) “Anything that requires nuance to use well often leads to slop.”
- [11:03] (발표) “The worst part about comments, though, is that they’re not enforceable.”
- [11:54] (발표) “At some point, you’ll realize there’s nothing left to review. And you can just let agents merge most of their own pull requests.”
- [16:31] (발표) “We’re entering a golden age of software testing and verification.”
- [19:34] (해설) “이 숫자들은 발표에서 로렌 탄 팀이 직접 제시한 값이라 제가 따로 확인할 수 있는 자료는 없었어요.”
- [20:13] (발표) “If your inner coding loop produces slop, then automating that loop just produces more slop.”
- [22:33] (해설) “주석을 거의 다 없애는 일이나 PR 자동 병합은 다른 이야기예요.”
관련 노트
- 2026-11-15-lauren-tan-all-code-is-slop — 같은 발표의 원본 노트(성능표·기여자 분포·발표 시각 인용)
- 2026-08-03-agentos-own-the-outer-loop — 같은 채널의 발표+해설 구성, “검증의 증거와 서명”이라는 같은 결론
- 2026-07-27-agentos-why-software-factories-fail — 같은 채널의 소프트웨어 공장 비판(슬롭의 원인을 RL 보상에서 찾고 앞단 30분을 해법으로 듦)
- 2026-10-03-lauren-tan-agent-verification-environment — Dune·실제 앱 검증 CLI·바깥 루프를 다룬 대담 해설
- 2026-10-31-x-poteto-organic-architecture — 정원·유기적 아키텍처 비유의 원문 글
- 2026-09-20-pstack-overengineering — 발표에 나온 pstack 스킬 묶음 소개
- cursor
- moc-ai-coding