출처: All Code Is Slop (Except Mine) — Lauren Tan, SpaceXSI · 길이: 17:31 · 채널: AI Engineer (Code Summit) · 공개: 2026-11-15 발표자: Lauren Tan(@poteto), Grok Bot @ SpaceXSI, Principal Engineer 자막: 영어 자동자막. “Potato”→poteto, “Graph Bot/Grabot/Growth Bot”→Grok Bot, “P stack”→pstack 등은 슬라이드·설명란과 대조해 고쳤다. 주의: 수치는 모두 발표자 팀의 자체 집계다. “성능이 여러 면에서 좋아졌다”는 말과 달리 같은 슬라이드에서 메모리·유휴 CPU·시작 시 JS/CSS 크기는 늘었다.
한눈에 보는 요약
- 에이전트 시대에는 누구나 “코딩 머신”이 될 수 있다. 엔지니어의 새 과제는 생산량을 크게 늘리면서 코드 품질을 유지하거나 높이는 것이고, 그 핵심은 맹목적 신뢰가 아니라 에이전트 환경에 투자해서 얻는 신뢰다.
- 투자 순서는 역삼각형 poteto 피라미드: 코드베이스(API 설계·아키텍처) → 정적 분석(린트·타입·테스트) → 검증(런타임·형식) → 산문(rules·skills·AGENTS.md) → 사람 리뷰. 위쪽일수록 결정적이고 재현 가능하다.
- 코드베이스는 에이전트의 가장 큰 입력이라 우회책 하나가 다음 에이전트의 “패턴”으로 복제된다. 그래서 useEffect 금지, renderer↔main import 금지, 주석 99% 금지 같은 제약을 린트로 박는다.
- 에이전트를 교정할 때마다 문서 한 줄이 아니라 결정적 검사(린트 규칙)로 바꾸거나 문제를 구조적으로 없앤다. 쌓이면 리뷰할 것이 사라지고 에이전트가 PR 대부분을 스스로 머지한다.
- 코드 리뷰는 검증 산출물(영상·스크린샷·다이어그램·형식 검증) 확인으로 줄었다. 토큰 대부분이 검증에 쓰이고, 에이전트 덕에 예전엔 비싸던 테스트·검증이 경제적이 됐다.
- 결과: Grok Bot 팀 10월 PR 10,926개, 기여자 227명, 되돌림 비율 약 0.47%, 안정판 하루 1회.
- 결론: 나쁜 내부 루프를 자동화하면 슬롭만 늘어난다. 기반을 먼저 다지고, 그 위에 Grok Bot 같은 바깥 루프(소프트웨어 팩토리)를 얹어라.
장면별 상세 설명
[00:01] 1. 지난달 PR 3,000개
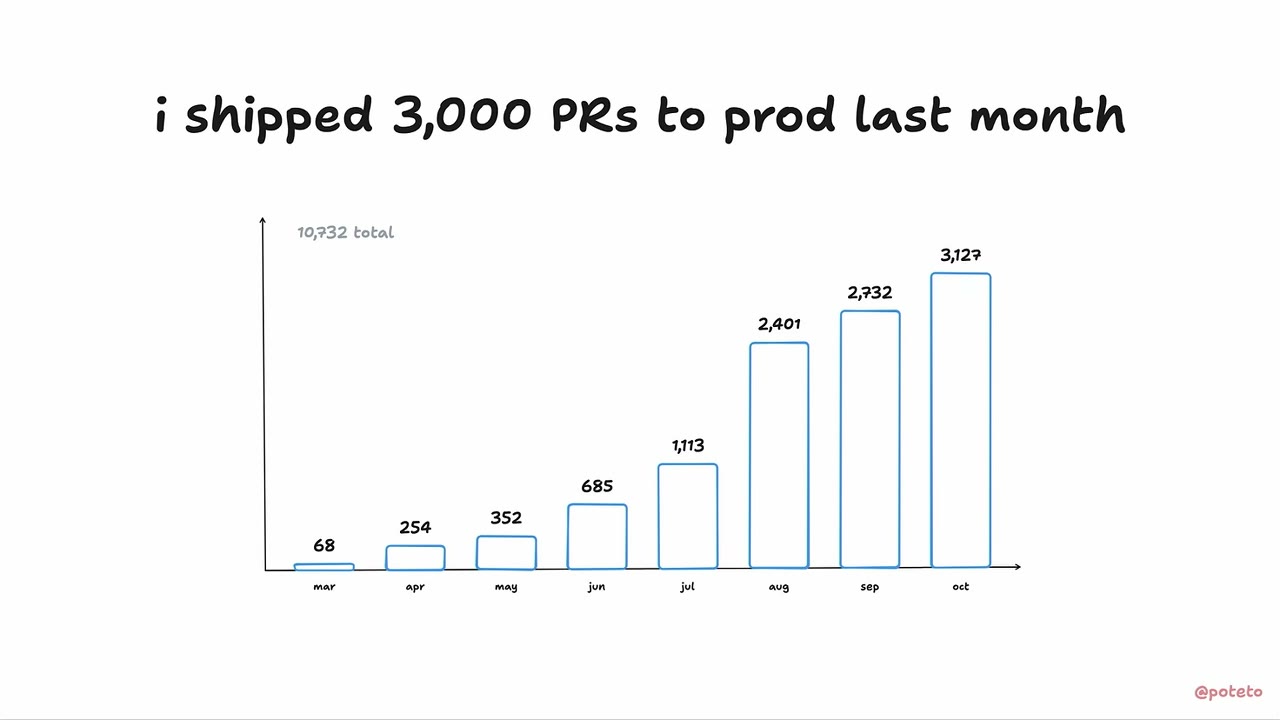
“남이 쓴 코드를 보고 다 슬롭이라고 생각해 본 적 있나?”라는 질문으로 시작한다. 발표 제목도 그 농담이다. poteto는 지난달 혼자 PR 3,000개를 프로덕션에 냈다. 슬라이드의 월별 수치는 3월 68 → 4월 254 → 5월 352 → 6월 685 → 7월 1,113 → 8월 2,401 → 9월 2,732 → 10월 3,127(누적 10,732)이다.
에이전트 이전에는 생산량을 신경 쓰지 않았고, 예외적인 사람만 “코딩 머신”이라 불렀다(주말 동안 Google Maps를 다시 짰다는 Bret Taylor처럼). 이제는 에이전트로 누구나 코딩 머신이 될 수 있다. 그래서 그는 품질을 유지하거나 높이면서 생산성을 크게 늘리는 법을 찾는 것이 지금 소프트웨어 엔지니어의 일이라고 본다(슬라이드: “the new meta is shipping fast without compromising on quality”).
[01:10] 2. 결국 신뢰의 문제
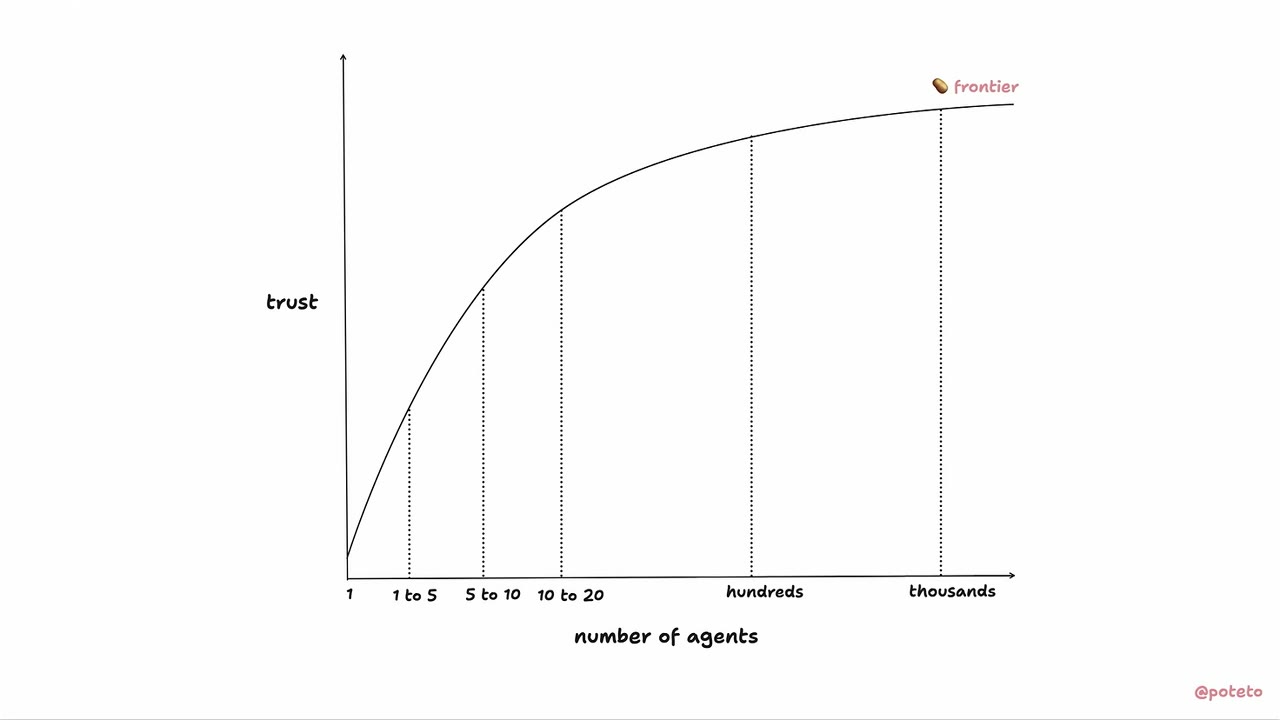
이것을 “소프트웨어 팩토리”라고 부르는 사람도 있지만, poteto는 신뢰로 단순하게 본다. 맹목적 신뢰가 아니라 에이전트가 옳은 일을 하리라고 믿을 수 있도록 에이전트의 환경에 투자하는 것이다. 슬라이드 그래프는 가로축이 에이전트 수(1, 15, 510, 10~20, 수백, 수천), 세로축이 신뢰이고, 곡선 끝에 “frontier”가 표시돼 있다(발표에서 따로 설명하지는 않았다). 그 지점까지 가는 데 6개월이 걸렸고, 지금은 잠든 사이에도 PR 수천 개를 낸다.
[01:58] 3. 낮은 신뢰 루프에서 높은 신뢰 루프로 — poteto 피라미드
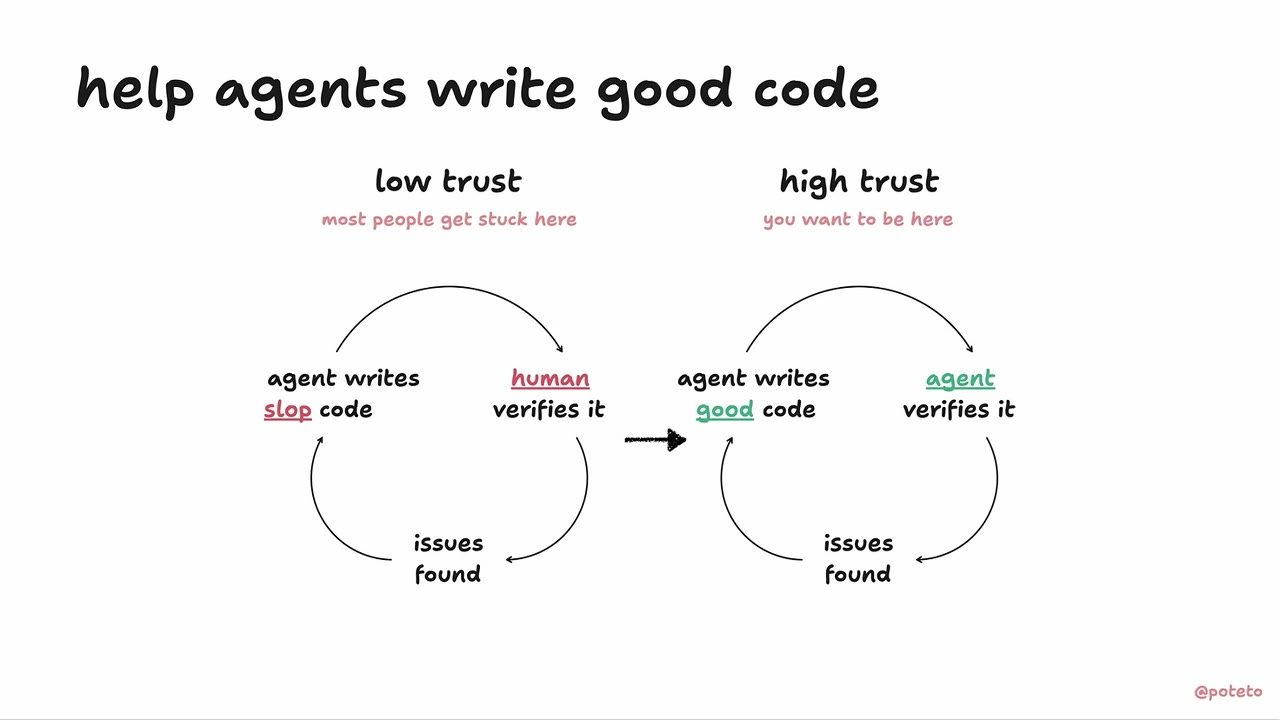
대부분은 “에이전트가 슬롭을 쓰고 → 사람이 검증하고 → 문제를 찾는” 낮은 신뢰 루프에 갇혀 있다. 목표는 “에이전트가 좋은 코드를 쓰고 → 에이전트가 검증하는” 높은 신뢰 루프다.
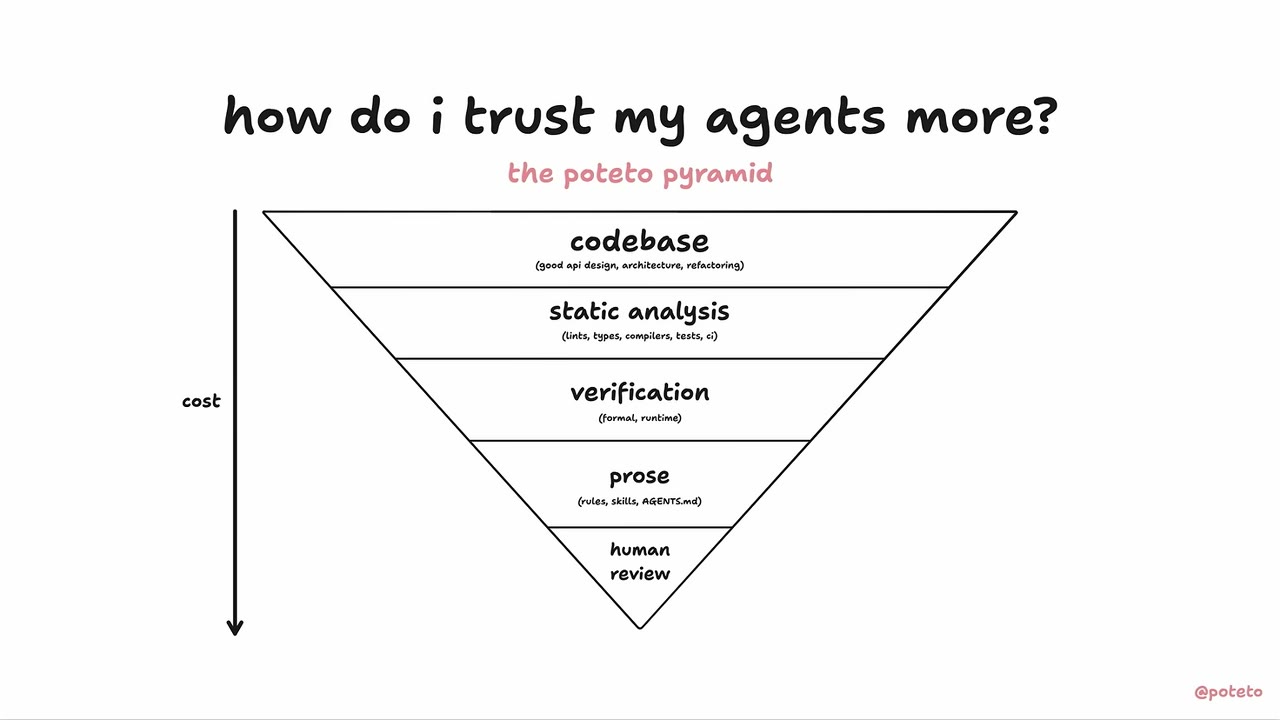
시간을 어디에 쓸지 정하는 역삼각형이다. 왼쪽 화살표는 아래로 갈수록 비용이 커진다는 뜻이다.
| 층 | 내용 | 성격 |
|---|---|---|
| codebase | 좋은 API 설계, 아키텍처, 리팩터링 | 결정적 |
| static analysis | 린트, 타입, 컴파일러, 테스트, CI | 결정적 |
| verification | 형식 검증, 런타임 검증 | 버그·불변식 확인, 의도를 이해했는지 확인 |
| prose | rules, skills, AGENTS.md | 판단이 필요한 것만 |
| human review | 사람 리뷰 | 마지막 |
위 두 층은 코드 자체로 에이전트가 할 수 있는 일을 제한해 기본값으로 옳은 일을 하게 만든다. 산문은 판단이 필요한 것에만 조금 얹는다. 그래서 에이전트를 고칠 때는 rules나 AGENTS.md에 한 줄을 더하는 대신 결정적 검사로 바꿀 수 있는지 먼저 생각하라고 한다. 코드에 있는 것이 더 재현 가능하고 더 믿을 수 있다(“code is memory”).
[03:31] 4. 코드베이스는 정원이다 — Organic Architecture
2024년에는 출근해서 동료가 쓴 PR 3개를 리뷰했는데, 지금은 300개쯤이다. 엔지니어 한 명이 에이전트 수백~수천의 팀이 됐고, 코드는 연속된 흐름처럼, 살아 있는 것처럼 들어온다. 이 비유에서 코드베이스의 제약과 가드레일은 콘크리트 기초이고, 에이전트가 쓰는 새 코드는 그 주위로 자라는 식물이다. 엔지니어의 일이 정원 가꾸기에 가까워진다(2026-10-31-x-poteto-organic-architecture에서 같은 주장을 글로 냈다).
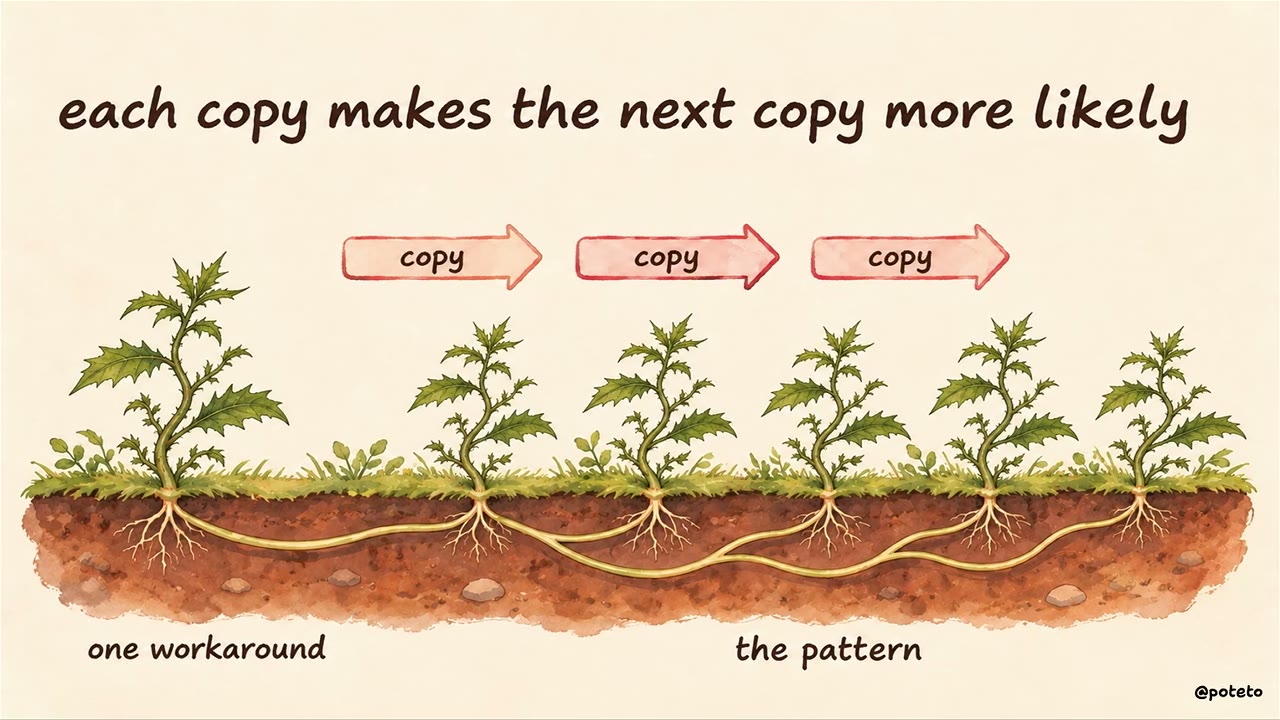
코드가 에이전트의 가장 큰 입력이므로 우회책·안티패턴·deprecated 코드·기술 부채는 “이 코드베이스의 확립된 패턴”처럼 보여서 다음 에이전트가 복사한다. 한 번 복사될 때마다 다음 복사가 더 쉬워진다. 잡초가 퍼지기 전에 코드베이스를 최대한 깨끗하게 유지해야 에이전트가 좋은 것만 복사한다.
[05:00] 5. Dune — 에이전트를 위한 프레임워크
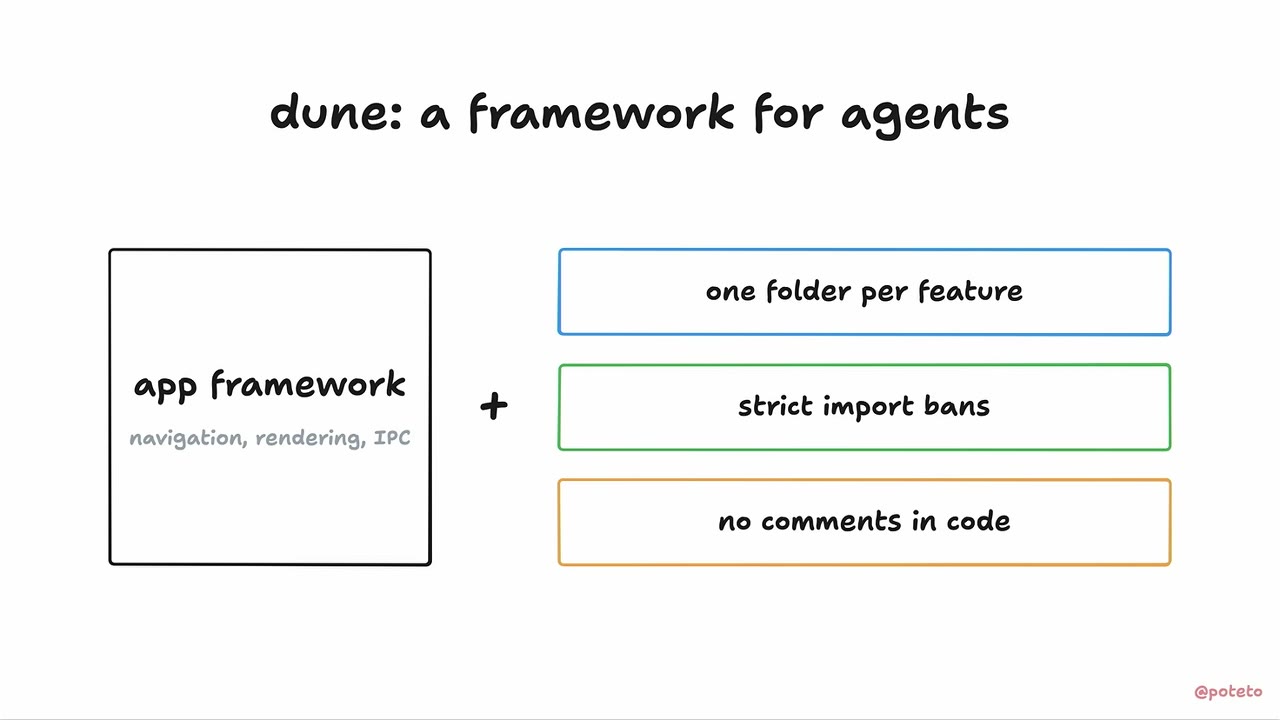
Dune은 Grok Bot을 위해 만든 클라이언트 프레임워크다. 기술적으로는 “Electron 앱용 Next.js” 정도로 특별할 것이 없다. 핵심은 데스크톱 앱을 만들며 얻은 교훈을 제약과 린트 규칙으로 코드화했다는 점이다. 기본 앱 프레임워크(내비게이션·렌더링·IPC) 위에 세 가지 규칙을 얹는다: 기능마다 폴더 하나, 엄격한 import 금지, 코드에 주석 금지.
그중 하나가 “뉘앙스가 필요한 것은 슬롭으로 이어진다 — 그냥 더 나은 API를 설계하라”다. 대표 예가 React의 useEffect다. 쓸 데가 있지만 자주 잘못 쓰이고(“쓰려면 박사 학위가 필요하다”는 농담), 에이전트는 특히 못 쓴다. 그래서 제품 코드에서 아예 금지하고 Dune API 내부 일부에서만 허용했다. 이 문제는 범주째 사라졌고, 코드 리뷰에서 다시 잡을 일이 없다.
[06:00] 6. 디렉터리 구조도 컨텍스트다
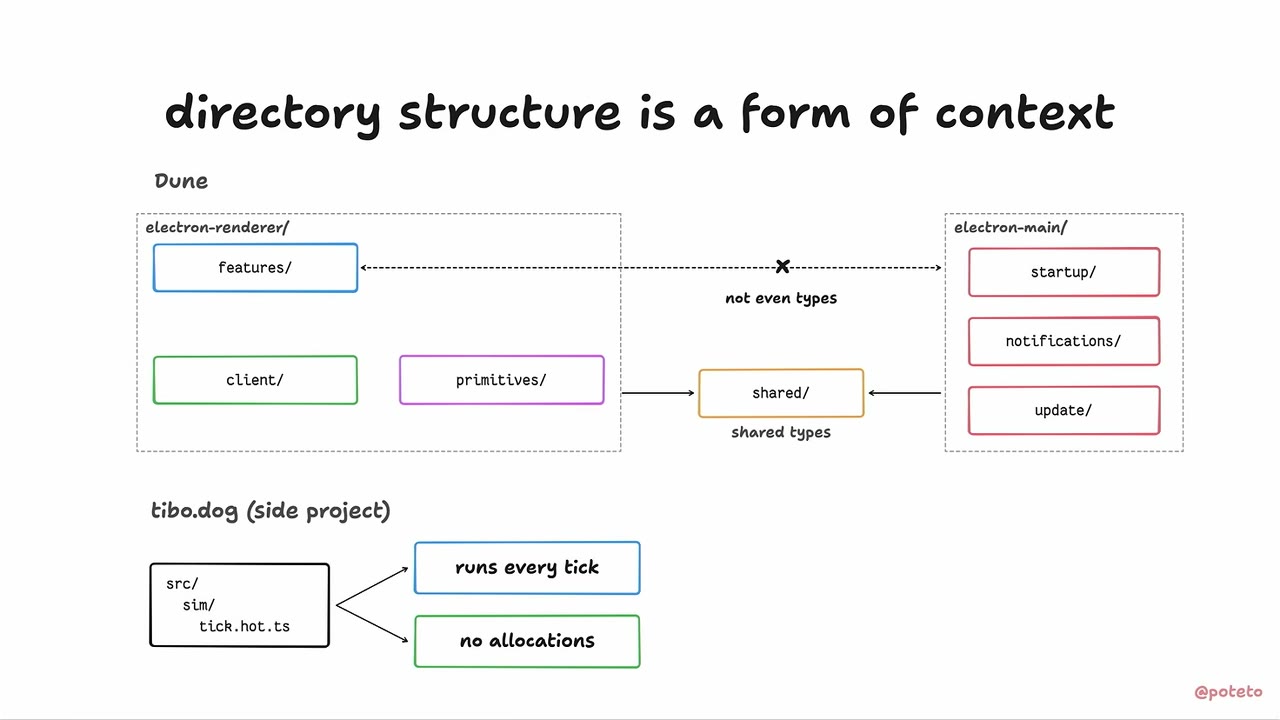
Cursor(Electron 앱)에서 본 안티패턴은 에이전트가 main 스레드 코드를 renderer 스레드로 import해서 long task와 버벅임을 만드는 것이었다. Grok Bot과 Dune 앱에서는 이를 관례로 고정했다.
Dune
├── electron-renderer/   features/  client/  primitives/
├── electron-main/       startup/  notifications/  update/
└── shared/              ← 공유 타입만 여기로
    features/ ↔ electron-main/ 직접 import 금지 ("not even types")
두 최상위 디렉터리 사이의 import는 의존성 그래프 분석기와 린트 규칙으로 금지한다. 개인 프로젝트 tibo.dog에서도 src/sim/tick.hot.ts처럼 이름에 규칙(매 tick 실행, 할당 금지)을 담는다. 간단한 린트지만 리뷰에서 신경 쓸 것이 하나 줄어든다.
[06:56] 7. 에이전트가 쓰는 마크다운과 임시방편
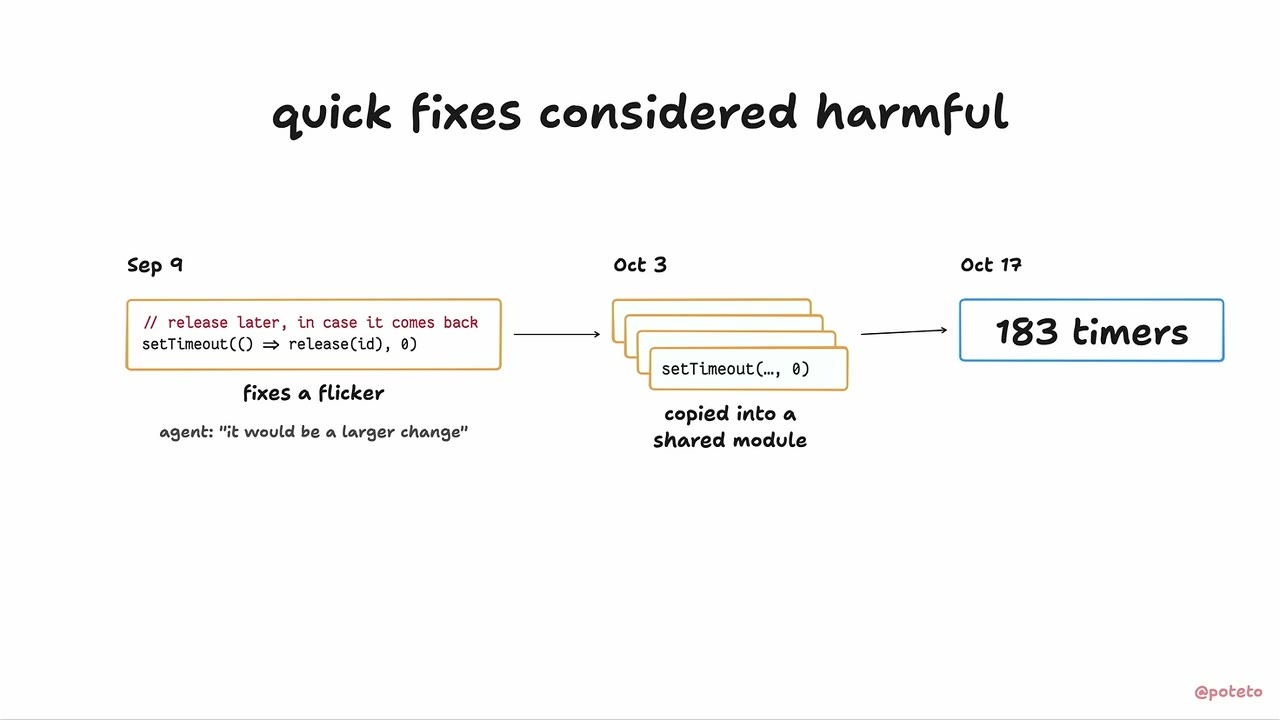
의외로 문제가 된 것은 에이전트가 쓰는 마크다운(문서, 코드 주석, rules, skills)이다. 에이전트는 이를 옳은 일을 하지 않은 이유를 정당화하는 장소로 쓰거나, 작은 교정 하나를 영원히 깨면 안 되는 규칙처럼 과하게 적용한다.
Cursor의 예: 에이전트는 setTimeout, requestAnimationFrame, requestIdleCallback 같은 명령형 타이머를 즉석 수정으로 즐겨 썼다. 실제로는 VS Code의 명령형 스타일과 React의 선언형 스타일이 충돌하는 아키텍처 문제를 덮는 것이었다.
// release later, in case it comes back
setTimeout(() => release(id), 0)
9월 9일 깜빡임을 고친 이 한 줄(에이전트: “그렇게 하면 더 큰 변경이 된다”)이 10월 3일 공유 모듈로 복사됐고, 10월 17일에는 타이머 183개가 됐다. 타이머가 빠르게 생성·파괴되면 major GC가 자주 돌아 버벅임이 생긴다. 더 나쁜 것은 이 임시방편이 정당하다고 설명하는 주석이 잔뜩 붙어 있었다는 점이다.
[08:16] 8. 주석은 부채다 — 교정은 린트로
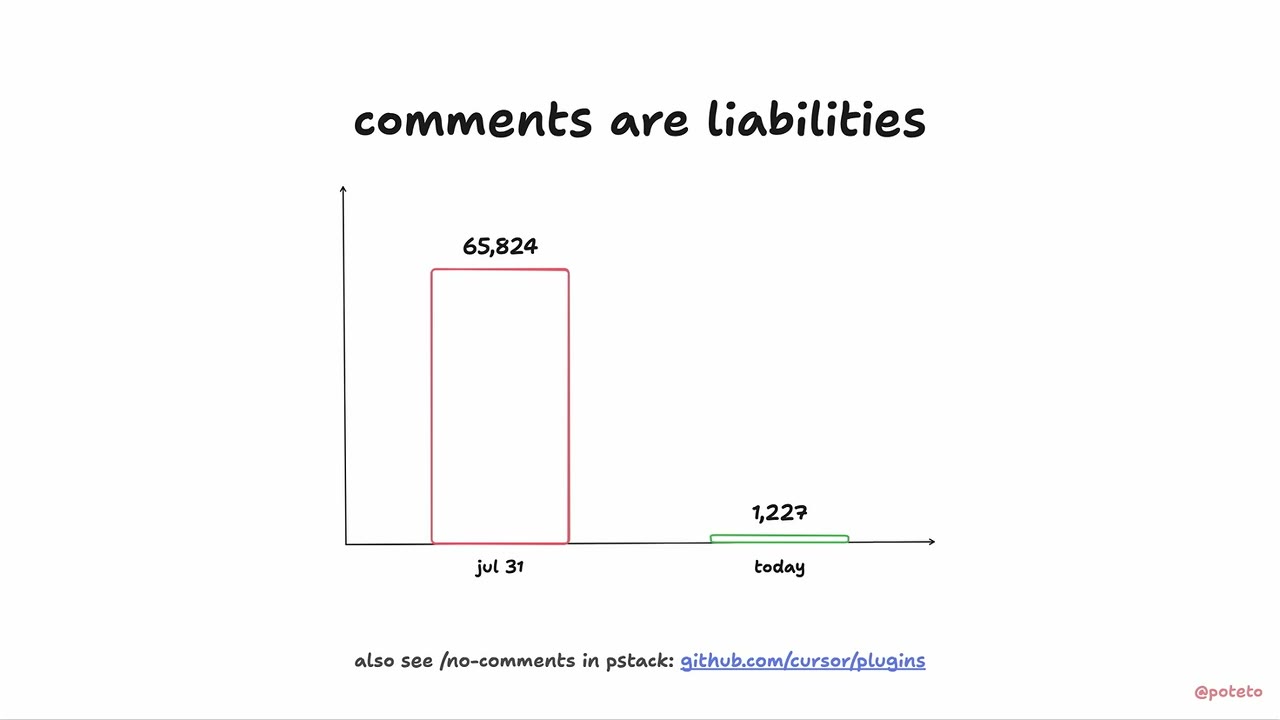
Grok Bot에서는 주석의 99%를 금지했다. 주석은 쉽게 낡고, 사람은 주석 슬롭을 읽지 않으며, 에이전트에게 “어려우니까 안 한다”는 탈출구를 준다. 무엇보다 강제할 수 없다. “다음 에이전트에게 이걸 하지 말라고 적어 두자”는 선의는 결국 믿을 수 있는 무엇도 되지 않는다. 주석 수는 7월 31일 65,824개에서 1,227개로 줄었다(pstack의 /no-comments 스킬 참고).
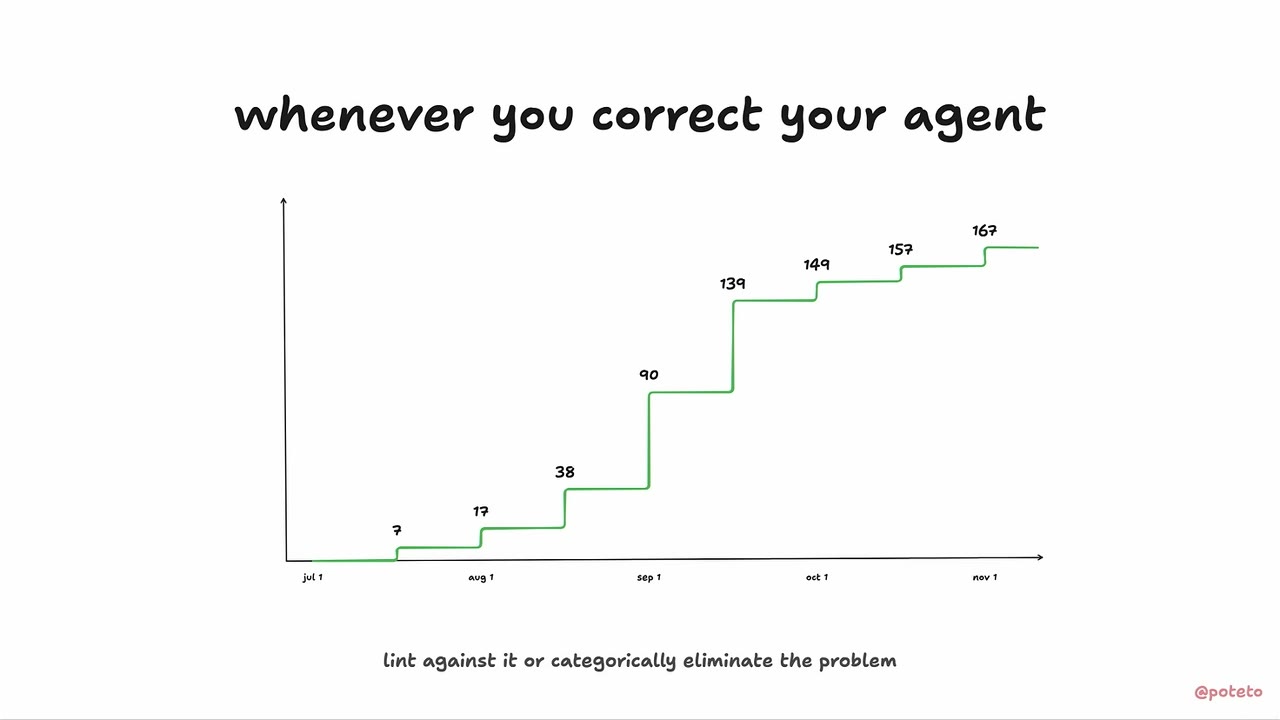
대신 Grok Bot과 Dune에는 에이전트에게 근본 원인을 고치라고 알려 주는 친절한 오류 메시지를 가진 린트 규칙이 있다. 일반 원칙은 “에이전트를 교정할 때마다 결정적 검사로 바꾸거나, 더 나은 API 설계·아키텍처로 그 문제를 범주째 없앤다”(슬라이드: “lint against it or categorically eliminate the problem”)이다. 그래프는 7월부터 11월까지 그렇게 쌓인 수(축 이름은 없음, 문맥상 규칙 수)가 167까지 늘어난 모습이다. 이를 반복하면 리뷰할 것이 점점 줄고, 어느 순간 리뷰할 것이 없어져 에이전트가 PR 대부분을 스스로 머지하게 된다.
[09:28] 9. 검증 — 런타임 검증과 기능 지도
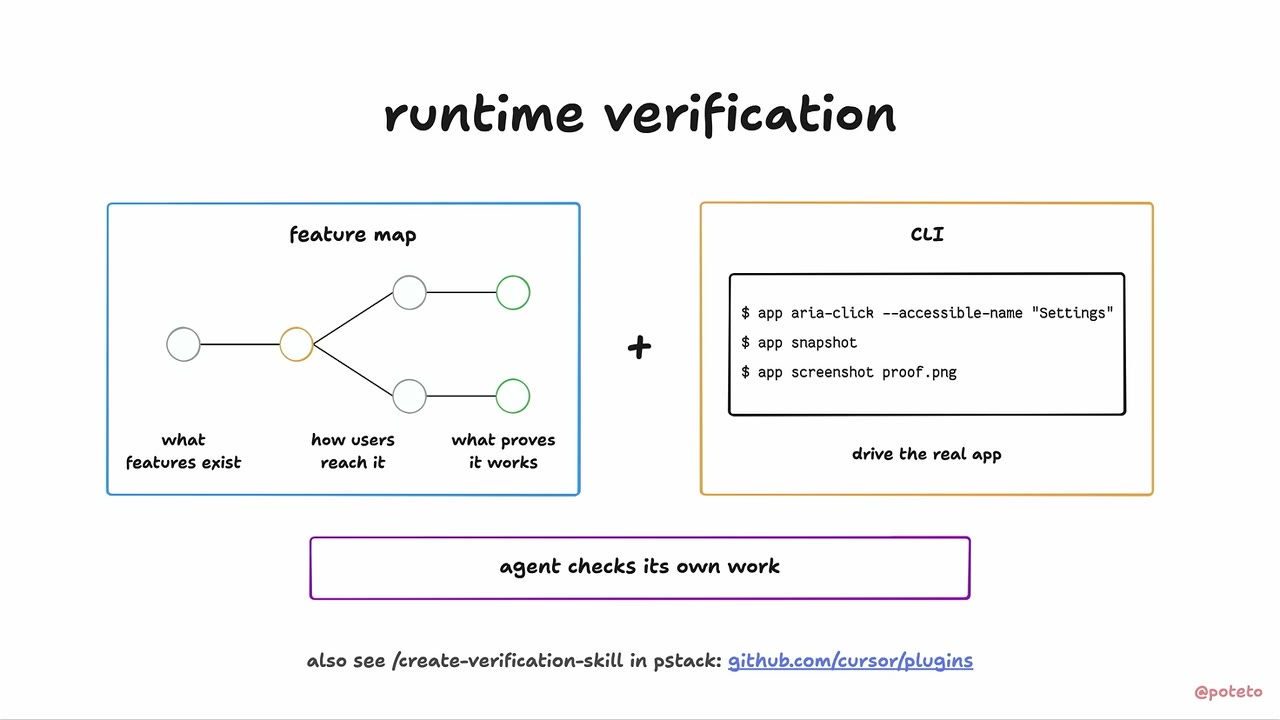
“검증이 가장 중요한 단계”다. 코드 리뷰는 이제 영상·스크린샷·다이어그램·형식 검증 같은 검증 산출물을 보는 일로 줄었다. 가장 기본은 런타임 검증, 즉 에이전트가 코드를 직접 실행하고 Chrome DevTools Protocol처럼 사람 개발자가 쓰는 디버깅 도구를 쓰게 하는 것이다.
런타임 검증 스킬에는 feature map이 있다. 사용자 관점에서 앱의 모든 기능을 적은 사이트맵 같은 것으로, “어떤 기능이 있나 / 사용자가 어떻게 도달하나 / 무엇이 동작을 증명하나”를 담는다. “왼쪽 사이드바의 그거”라고 말해도 에이전트가 추측할 필요가 없는 공용 어휘가 된다. 스킬 안에는 실제 앱을 조작하는 전용 CLI도 둔다. 에이전트가 매번 같은 CLI와 드라이버를 재사용하니 토큰이 줄고, CLI 자체를 테스트할 수 있다.
$ app aria-click --accessible-name "Settings"
$ app snapshot
$ app screenshot proof.png
pstack의 /create-verification-skill로 비슷한 스킬을 만들 수 있다(2026-10-03-lauren-tan-agent-verification-environment에서 같은 구조를 자세히 다룬다).
[10:50] 10. 형식 검증과 UI 속성 기반 테스트
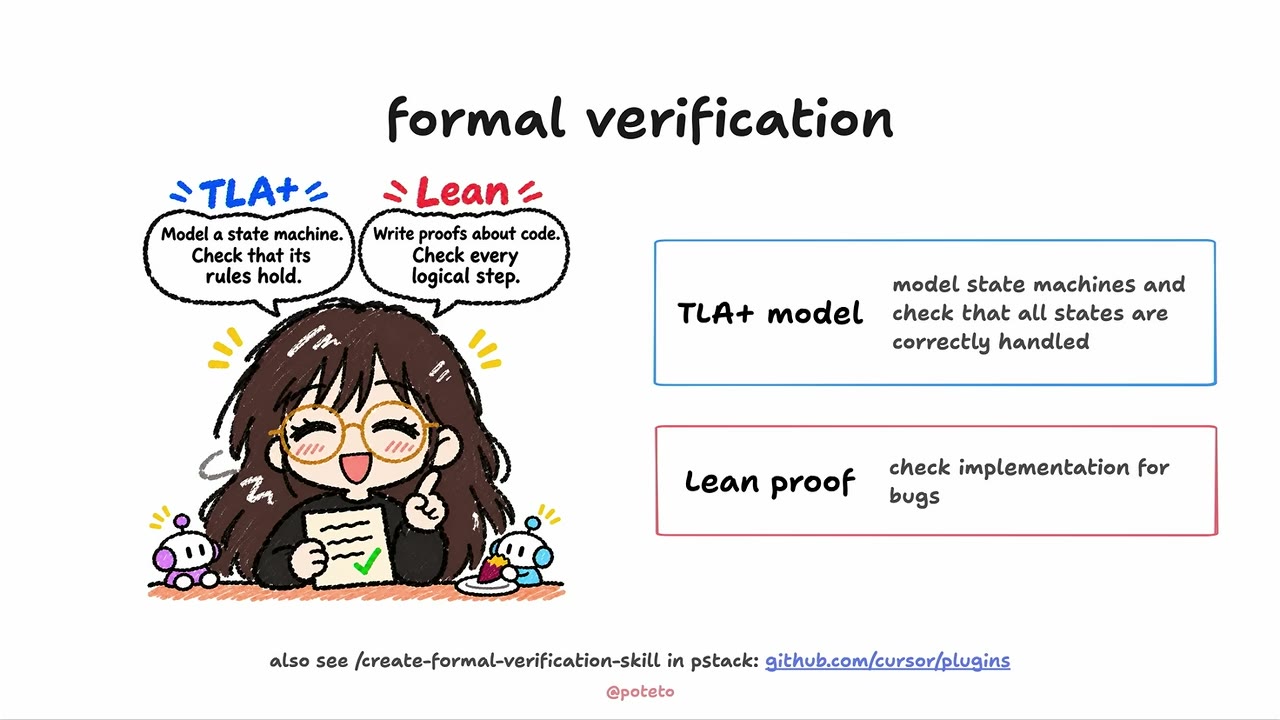
최근에는 형식 검증도 쓴다. **TLA+**로 여러 기기·플랫폼에 걸친 알림 같은 주요 사용자 흐름을 모델 체킹하고, Lean으로 일부 알고리즘을 증명한다. 예컨대 직접 만든 가상화(virtualization) 라이브러리에 깜빡임·떨림이 없음을 Lean으로 확인한다. 이미 버그를 꽤 찾았지만 은탄환은 아니고, 에이전트 환경의 또 한 층으로 다룬다(pstack /create-formal-verification-skill).
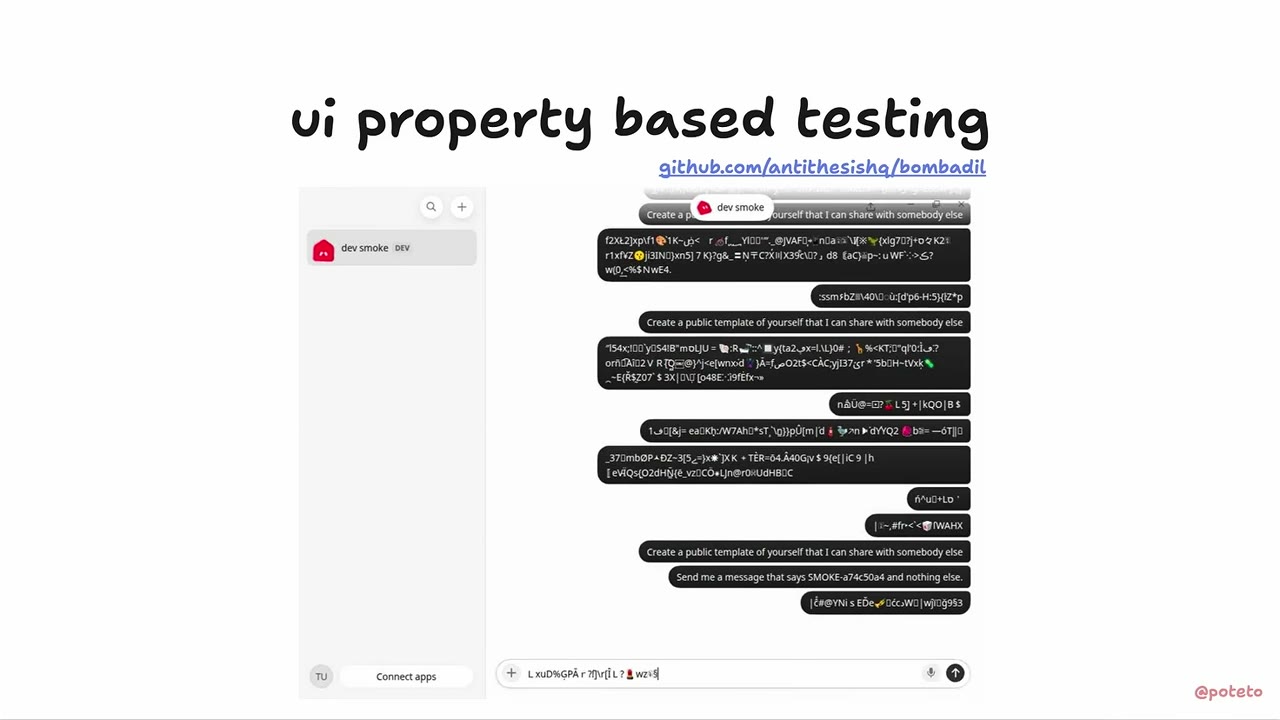
UI에는 속성 기반 테스트 라이브러리 Bombadil(github.com/antithesishq/bombadil)을 쓰기 시작했고, 이것도 UI 버그를 몇 개 잡았다.
[11:51] 11. 토큰의 70%를 검증에
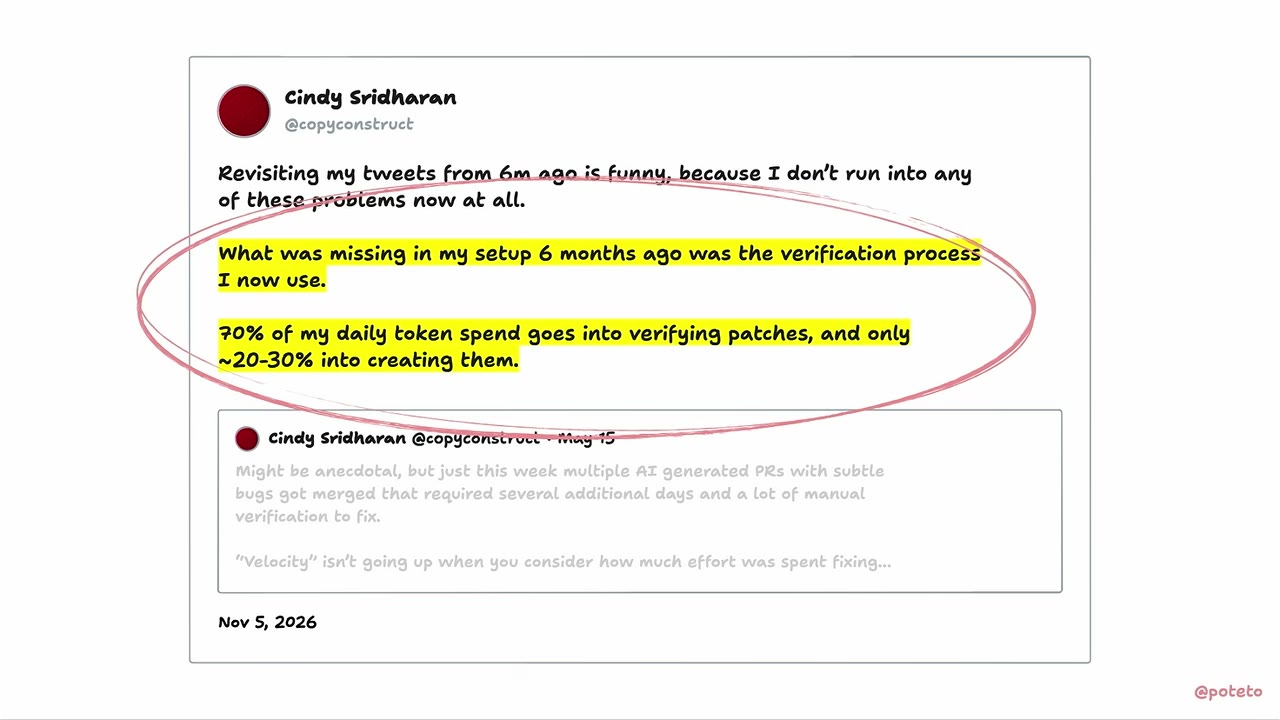
Cindy Sridharan(@copyconstruct)은 6개월 전 “미묘한 버그가 있는 AI PR이 머지돼 수동 검증에 며칠이 들었다”며 에이전트를 믿을 수 없다고 썼다. 2026-11-05에는 빠져 있던 것이 지금 쓰는 검증 절차였고, 하루 토큰의 70%를 패치 검증에, 20~30%만 생성에 쓴다고 썼다. poteto도 토큰 대부분이 검증에 간다고 한다.
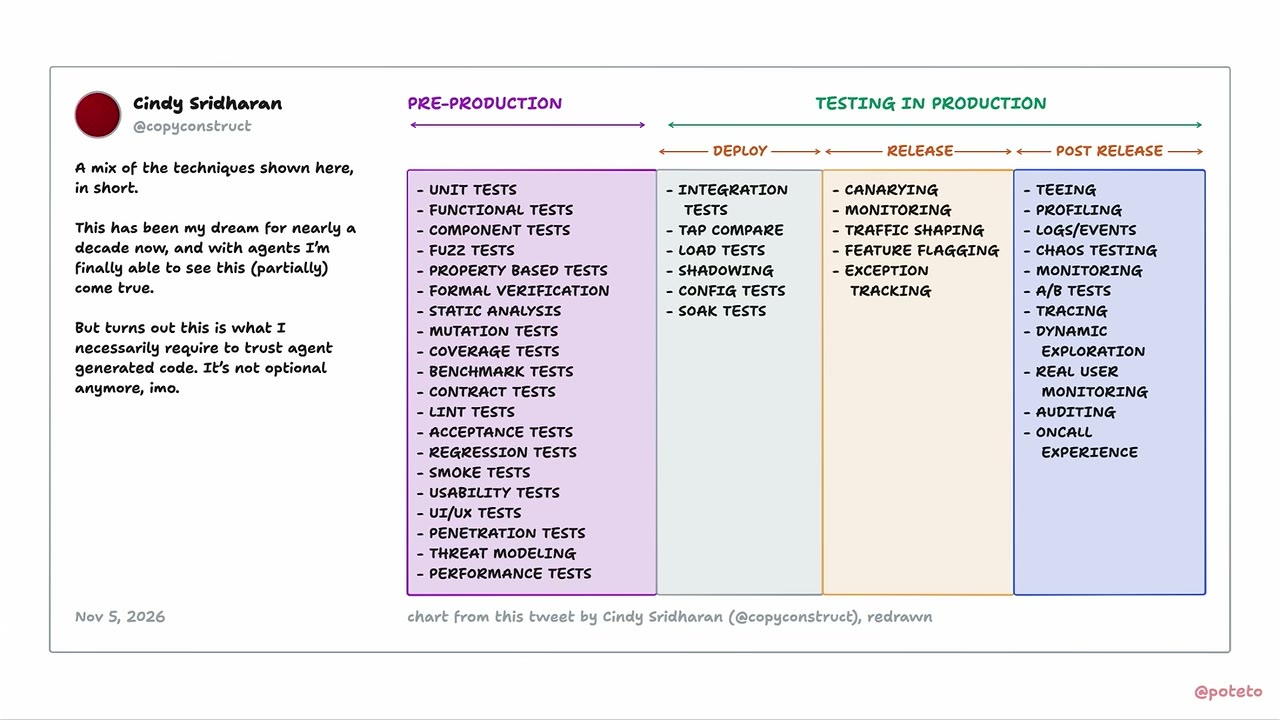
목록에 새로운 기법은 없다. 모두 좋은 소프트웨어 공학 도구지만 이해·작성·유지 비용 때문에 예전엔 감당하기 어려웠다. 에이전트가 그 비용을 크게 낮췄으니 **“소프트웨어 테스트와 검증의 황금기”**가 왔다. 형식 검증은 제품이 어떻게 동작해야 하는지, 에이전트가 의도를 제대로 이해했는지 따져 보는 데도 도움이 된다.
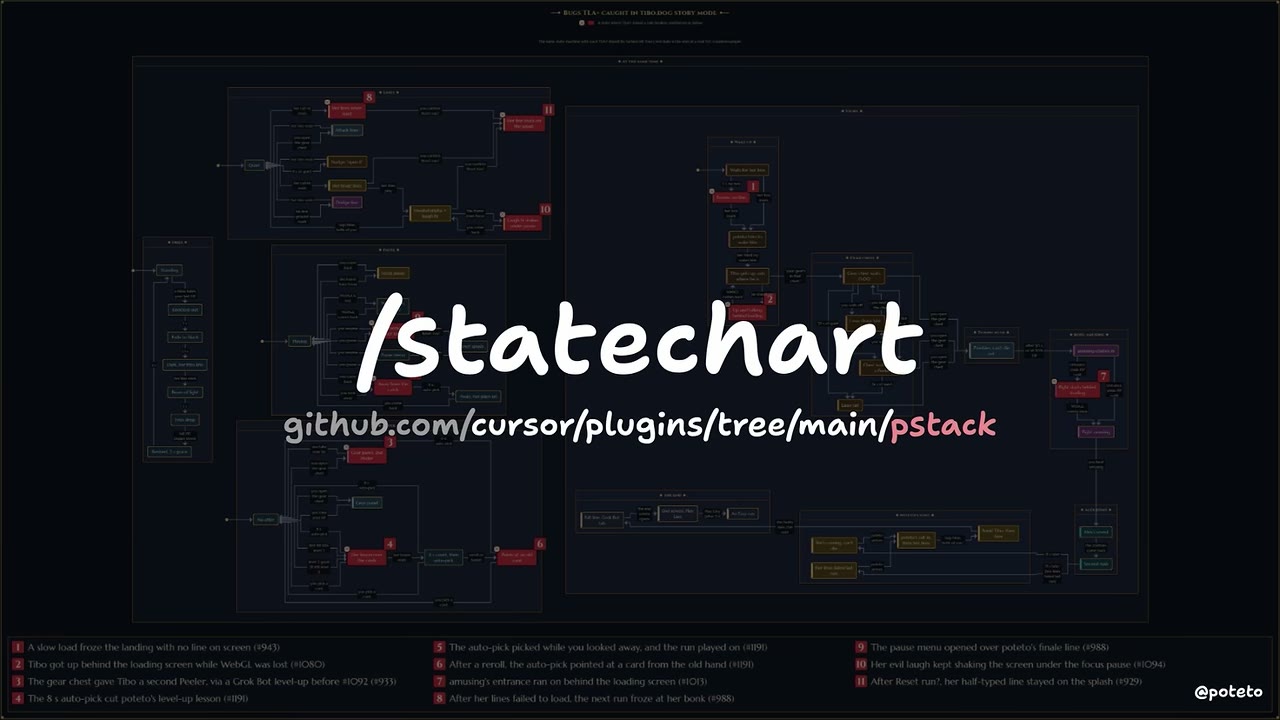
그래서 pstack(potato stack)에 사용자 관점의 상태 기계를 시각화하는 /statechart 스킬을 새로 넣었다. 영상·스크린샷과 함께 리뷰하기가 훨씬 쉽다고 한다(2026-10-30-x-minheo-poteto-state-diagram-verifier).
[13:25] 12. 성과 — 한 달 PR 1.1만 개, 되돌림 0.5%
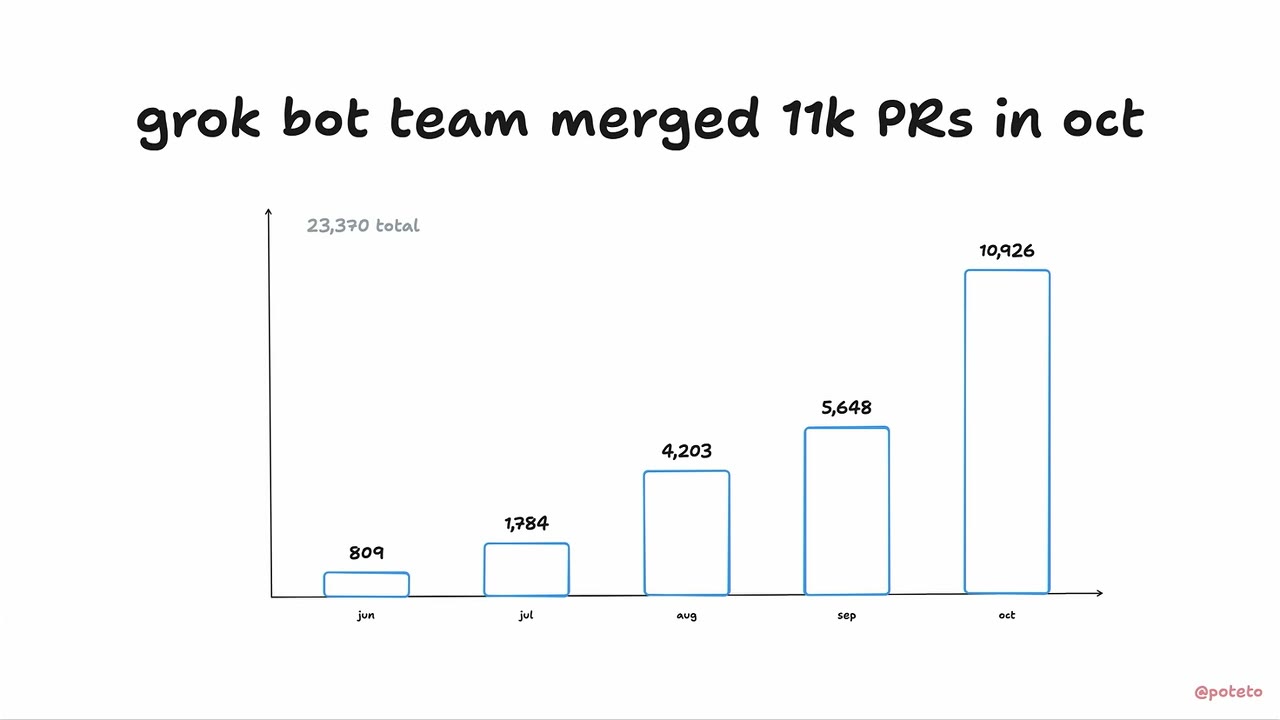
Grok Bot 팀은 10월 한 달에 PR 10,926개를 프로덕션에 냈다. 클라이언트 안정판도 하루에 한 번꼴로 낸다.
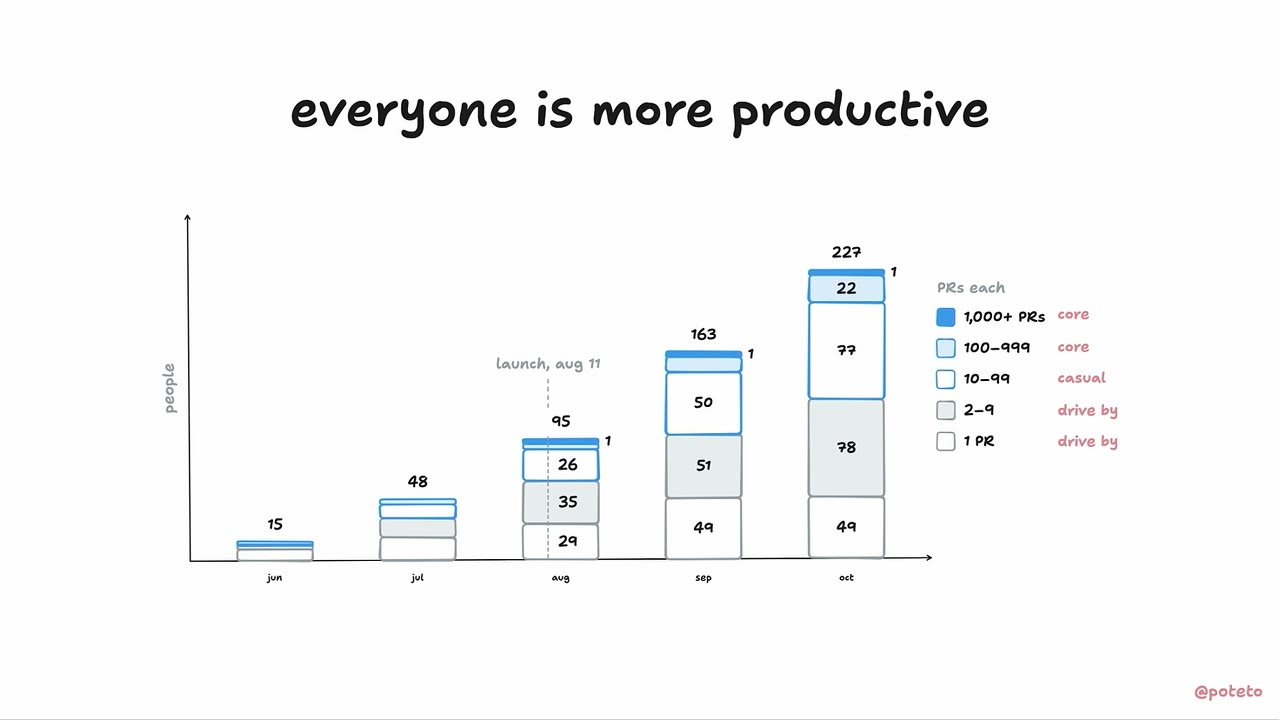
핵심 팀만이 아니라 맥락이 적은 가벼운 기여자도 늘었다. 10월 기여자 227명의 분포는 PR 1,000개 이상 1명, 100999개 22명(여기까지 core), 1099개 77명(casual), 2~9개 78명, 1개 49명(drive-by)이다.
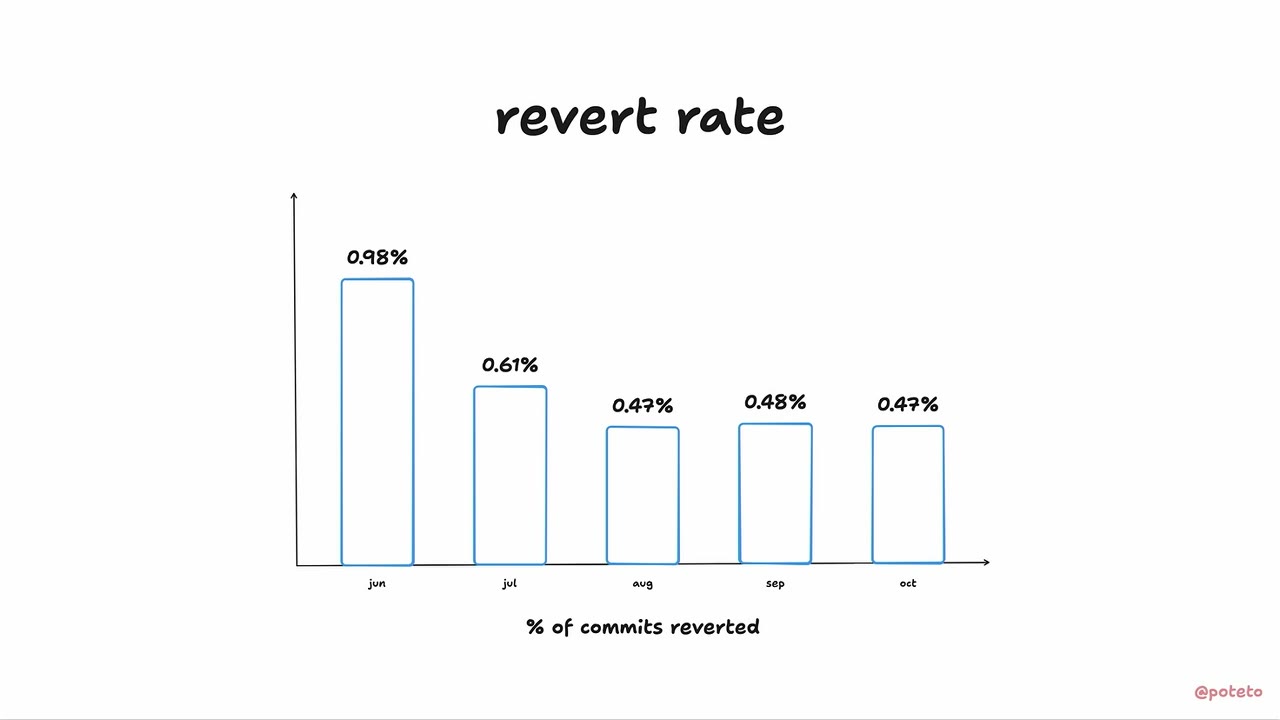
“속도가 이렇게 빨라지면 혼돈이고 슬롭 아니냐”는 의문에 대한 답이 되돌림 비율이다. 전체 커밋 중 되돌린 비율이 오히려 낮아져 약 0.5%에 머문다.
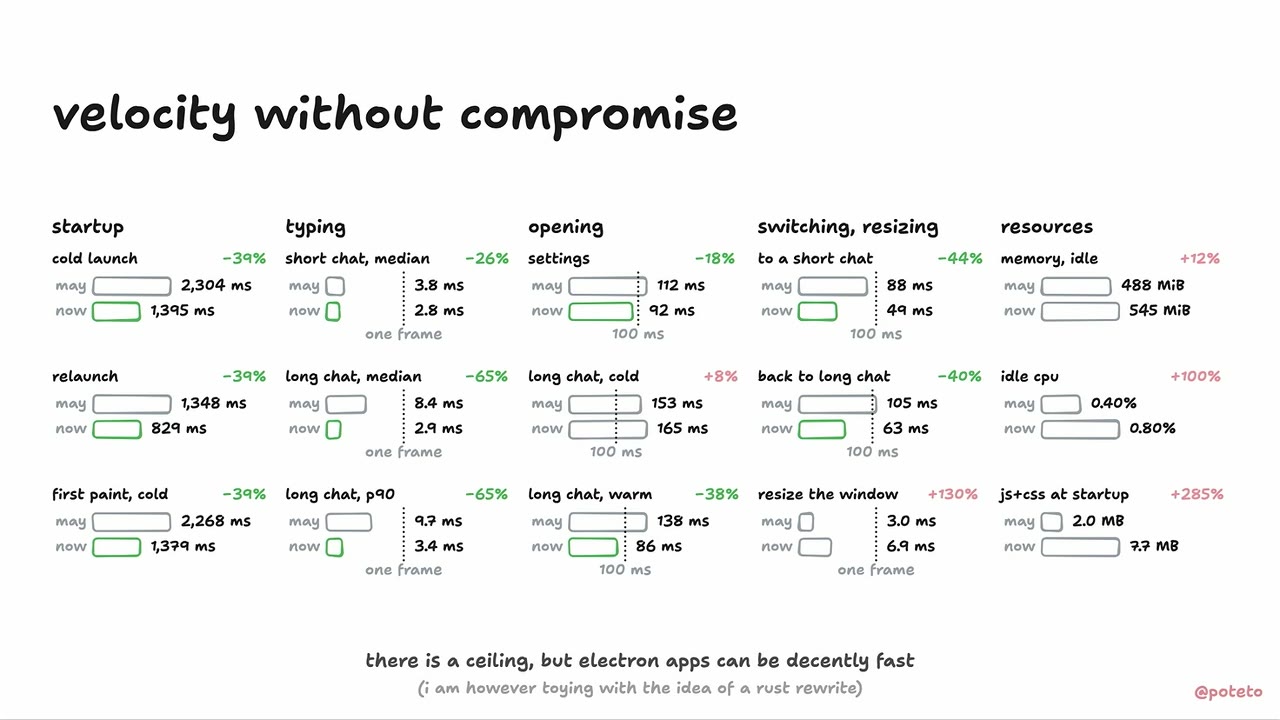
성능도 출시 때보다 나아졌다는 것이 발표자의 주장이다. 슬라이드의 주요 수치(5월 → 현재)는 다음과 같다.
| 항목 | 5월 | 현재 | 변화 |
|---|---|---|---|
| cold launch | 2,304 ms | 1,395 ms | −39% |
| first paint, cold | 2,268 ms | 1,379 ms | −39% |
| 타이핑, long chat median | 8.4 ms | 2.9 ms | −65% |
| 짧은 채팅으로 전환 | 88 ms | 49 ms | −44% |
| long chat 열기, warm | 138 ms | 86 ms | −38% |
| long chat 열기, cold | 153 ms | 165 ms | +8% |
| 창 크기 조절 | 3.0 ms | 6.9 ms | +130% |
| 유휴 메모리 | 488 MiB | 545 MiB | +12% |
| 유휴 CPU | 0.40% | 0.80% | +100% |
| 시작 시 JS+CSS | 2.0 MB | 7.7 MB | +285% |
시작·타이핑·채팅 전환은 빨라졌지만 자원 사용은 늘었다. 슬라이드 하단에는 “한계는 있지만 Electron 앱도 꽤 빠를 수 있다(다만 Rust 재작성을 고민 중)“라고 적혀 있다.
[15:02] 13. 나쁜 루프는 자동화하지 마라
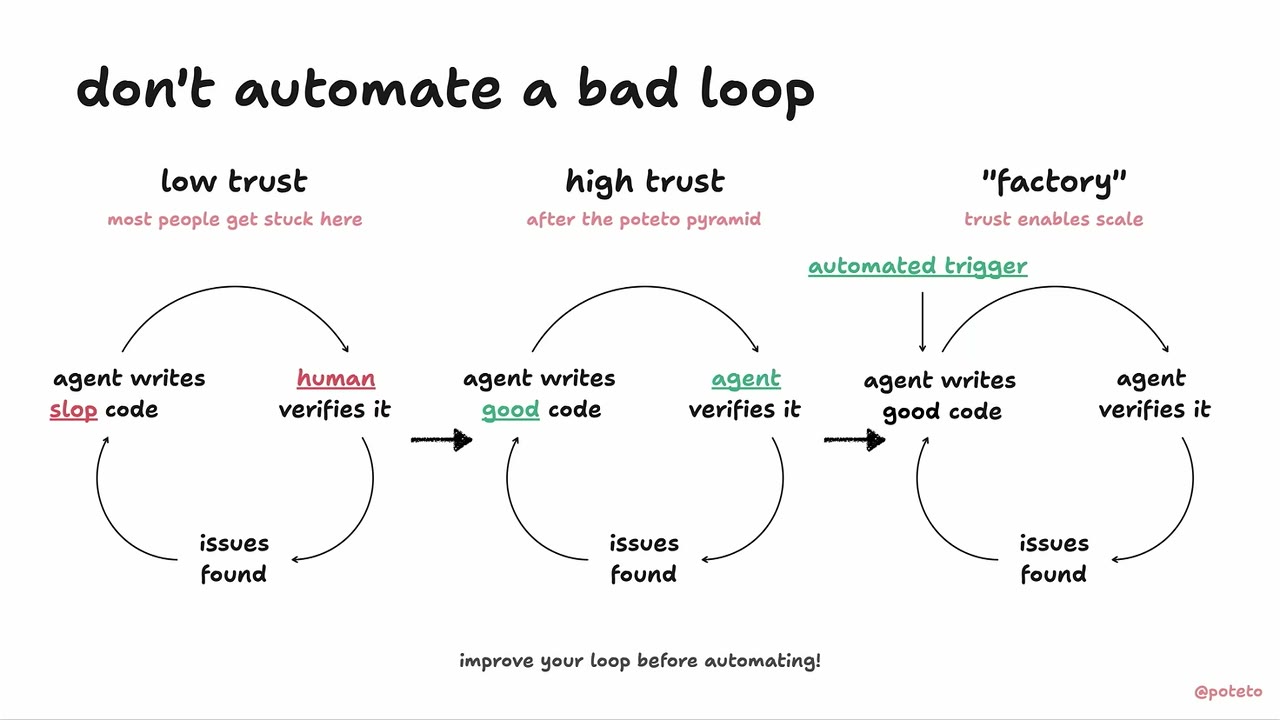
소프트웨어 팩토리를 만들어 모든 것을 자동화하기 전에, 에이전트를 교정할 때마다 코드베이스를 개선하는 방식으로 하라. 린트 규칙으로 안티패턴의 새 발생을 막고, 기존 패턴도 정리하고, 검증 체계를 탄탄히 한다. 이 작업은 어차피 자동화의 전제 조건이다. 내부 루프가 슬롭을 만들면 그 루프를 자동화해도 슬롭만 늘고, 문제에 토큰을 더 쏟아붓게 되어 비싸진다(슬라이드: “improve your loop before automating!”). 신뢰가 쌓인 루프에 자동 트리거를 붙여야 규모가 생긴다.
[15:49] 14. Grok Bot을 바깥 루프로
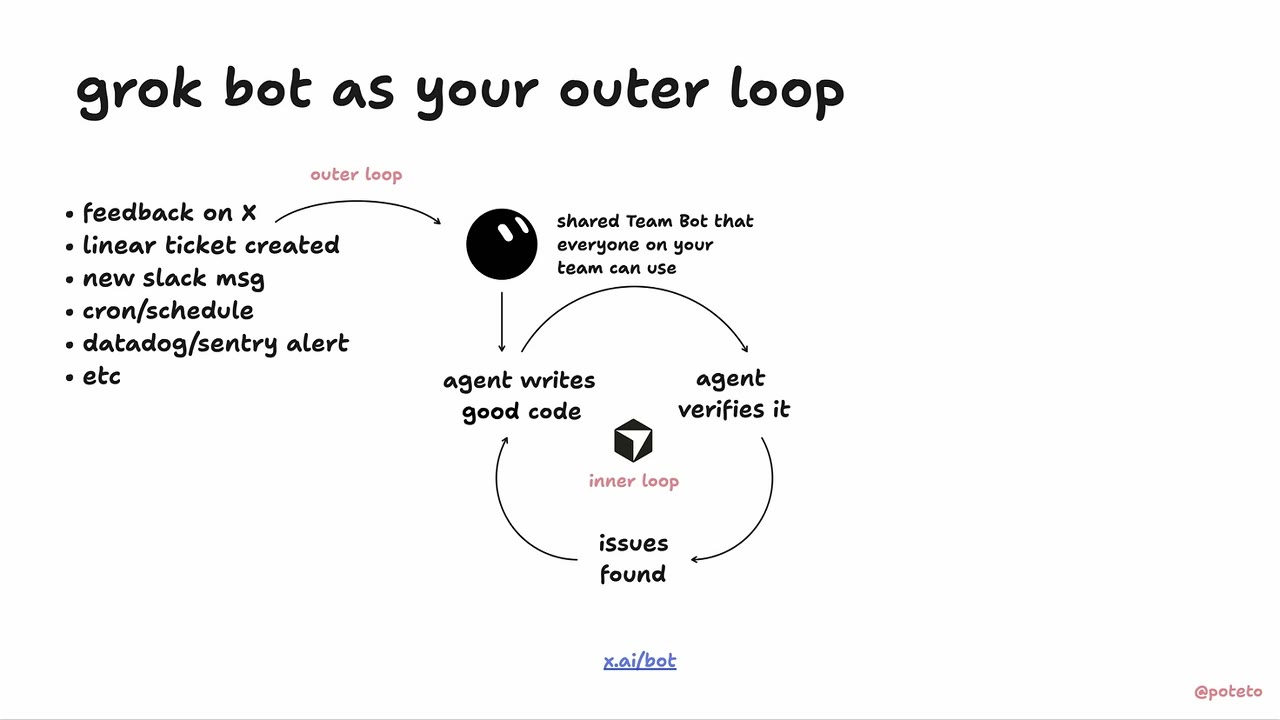
기반이 갖춰지면 그 위에 팩토리를 쉽게 올릴 수 있다. 발표자는 Grok Bot(x.ai/bot)을 바깥 루프로 소개한다. 커넥터와 routine으로 Cursor 클라우드 에이전트를 띄우고, 프로젝트로 에이전트 수백~수천을 조율한다. 트리거는 X 피드백, Linear 티켓 생성, Slack 메시지, cron, Datadog/Sentry 알림 등이고, 팀 전체가 쓰는 공용 봇이 내부 루프(에이전트가 쓰고 → 에이전트가 검증)를 돌린다.
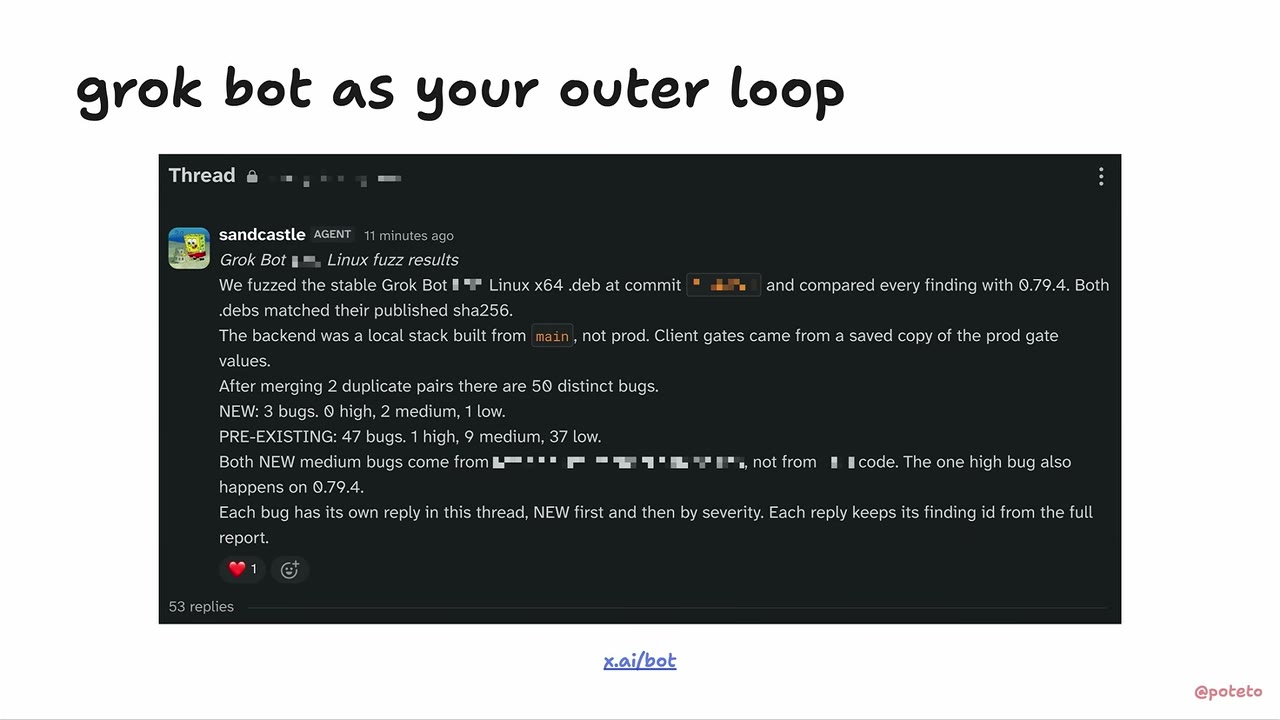
예: 새 릴리스를 자를 때마다 Grok Bot이 Cursor 프로젝트를 띄워 빌드 전체를 실제 사용자처럼 실행하며 퍼징한다. 슬라이드의 스레드는 안정판 Linux x64 .deb를 퍼징해 0.79.4와 비교한 결과다. 중복 2쌍을 합쳐 고유 버그 50개, 그중 신규 3개(high 0, medium 2, low 1)와 기존 47개(high 1, medium 9, low 37)를 찾았고, 버그마다 답글을 달았다. 이후 버그마다 수정 PR을 열고 자동 머지까지 한다. 코드베이스가 충분히 좋아서 PR이 기본적으로 좋게 나오고, 제품 코드 대부분은 더 이상 깊은 사람 리뷰가 필요 없기 때문이다.
마무리: 단단한 기반과 좋은 유기적 아키텍처가 있으면 슬롭을 금으로 바꾸고, 품질을 타협하지 않고 빠르게 낼 수 있다.
부록 — 실전 체크리스트
- 에이전트를 교정할 때 AGENTS.md·rules에 한 줄 추가하기 전에 린트 규칙·타입·의존성 그래프 검사로 만들 수 있는지 먼저 본다. 린트 오류 메시지에는 “근본 원인을 고쳐라”는 안내를 담는다.
- 뉘앙스가 필요한 API(예:
useEffect)는 제품 코드에서 금지하고 더 단순한 API를 제공한다. - 스레드·계층 경계는 최상위 디렉터리 이름으로 드러내고, 경계를 넘는 import는 린트로 막는다(공유 타입만 별도 디렉터리).
- 코드 주석을 줄이고, 에이전트가 쓴 “왜 이렇게 했는지” 주석을 임시방편 신호로 본다.
setTimeout(…, 0)같은 땜질이 퍼지기 전에 구조를 고친다. - 런타임 검증 스킬에 feature map(기능·도달 경로·증거)과 실제 앱을 조작하는 전용 CLI를 넣는다.
- 핵심 흐름은 TLA+ 모델 체킹, 까다로운 알고리즘은 Lean 증명, UI는 속성 기반 테스트(Bombadil)를 한 층씩 더한다.
- 리뷰는 코드보다 검증 산출물(영상·스크린샷·상태 차트)로 한다.
- 되돌림 비율·성능 지표를 추적해 속도가 품질을 깎는지 확인한다.
- 내부 루프가 높은 신뢰에 도달한 뒤에 자동 트리거(티켓·알림·cron)와 바깥 루프를 붙인다.
원문 인용 모음
- [00:25] “How many of you have ever looked at code that somebody else wrote and you thought that’s all slop?”
- [01:10] “The meta of being a software engineer is figuring out how to maintain or even improve the quality of your code while massively increasing your productivity.”
- [01:35] “Not blind trust but investing in your agents’ environment so you can trust that your agents are going to do the right thing.”
- [03:07] “Whenever you’re correcting your agent, think about how you can make that a deterministic check instead of adding another line to your rules or your AGENTS.md.”
- [04:19] “Any workarounds, anti-patterns, deprecated code, tech debt — it’s now likely to be just copied by the next agent since it looks like the established pattern in your codebase.”
- [05:08] “Anything that requires nuance to use well often leads to slop.”
- [08:41] “The worst part about comments though is that they’re not enforceable.”
- [09:28] “At some point you’ll realize there’s nothing left to review.”
- [12:39] “We are entering a golden age of software testing and verification.”
- [15:25] “If your inner coding loop produces slop, then automating that loop just produces more slop.”
관련 노트
- 2026-11-15-agentos-all-code-is-slop — 같은 발표를 AgentOS가 클립+한국어 해설로 푼 영상(용어 풀이, 숫자 단서, “오늘 넣을 것 / 아직 아닌 것”)
- 2026-10-31-x-poteto-organic-architecture — 같은 “유기적 아키텍처” 주장을 X 글로 낸 원문
- 2026-10-03-lauren-tan-agent-verification-environment — Dune, 실제 앱 검증 CLI, 기능 디렉터리, 바깥 루프를 다룬 대담 해설
- 2026-09-09-cursor-poteto-agent-trust — Cursor 시절 3,000+ PR 자동 머지까지의 여정, 검증 스킬·pstack
- 2026-10-05-threads-aicoffeechat-poteto-30-lessons — 같은 사람의 대담을 30개 포스트로 정리한 스레드
- 2026-10-30-x-minheo-poteto-state-diagram-verifier — 상태 다이어그램 전수 탐색 도구(/statechart 계열)
- 2026-10-09-x-silentguyy66-grokbot-engineers-workday — Grok Bot 팀의 일하는 방식(자동 머지되는 에이전트 PR)
- 2026-11-16-tech-bridge-ryan-carson-agent-org-chart — 사람이 영상으로 확인하는 다른 팀의 에이전트 운영 구조
- cursor
- moc-ai-coding