출처: https://www.youtube.com/watch?v=6sAJz8CUSWE 길이: 00:57:06 · 채널: 고요 · 자막: 한국어 자동자막
한눈에 보는 요약
- AI의 가장 좋은 쓰임은 코드를 대신 쓰는 도구가 아니라 페어 프로그래밍 짝꿍이다. 생각을 아웃소싱하면 실력이 아니라 손해가 쌓인다.
- 에이전트를 신뢰하게 되는 여정은 검증 → 고품질 스킬 → 에이전트 친화 아키텍처 세 기둥으로 올라간다.
- 가장 멍청한 에이전트도 좋은 코드를 쓰게 하려면 가장 짧은 길이 가장 좋은 길이 되도록 코드베이스를 설계하고, 규칙이 아니라 CI·린트·컴파일러 같은 하드 강제에 투자하라.
- 검증(verification)이 툴박스의 첫 번째 스킬이다. 에이전트가 앱을 직접 실행·트레이스·테스트해서 루프를 닫게 하면, 사람이 병목에서 벗어나 병렬화가 열린다.
- 스킬은 실패 모드의 관찰에서 태어난다. P-Stack과 eval(에이전트용 단위 테스트) 로 스킬을 벼리고, 로컬에서 벼린 신뢰를 클라우드 에이전트(Benny)로 확장하면 PR 자동 머지까지 간다.
- 발표자는 Cursor의 Lauren Tan(Potato, @poteto). 전 Meta React 팀(React Compiler), 전 Netflix 테크 리드·EM으로, 합류 5개월 만에 월 1000 PR을 내는 체제에 도달했다.
핵심 한 줄: 에이전트를 믿고 싶으면 에이전트를 다그치지 말고 환경을 설계하라 — 검증으로 루프를 닫고, 지름길이 정답이 되는 아키텍처를 깔면 자동 머지가 따라온다.
발표자 소개
Lauren Tan, 트위터에서는 Potato(E가 들어간 Potato). Cursor에 온 지 다섯 달 된 엔지니어로, 그 전에는 Meta React 팀에서 React Compiler를 작업했고 지금도 코어 팀에 남아 오픈소스에 기여한다. Meta 이전에는 Netflix 테크 리드였고 2년 정도 엔지니어링 매니저로 전환한 경험도 있다. 관리 스킬과 에이전트를 다루는 법 사이에 공통점이 많다는 게 오늘 이야기의 큰 축이다. cursor와 에이전트 하네스 일반론은 moc-ai-agents·harness에도 연결된다.
장면별 상세 설명
[00:00] 1. AI는 페어 프로그래밍 짝꿍이다
개인적으로 AI를 가장 잘 쓰는 방법은 페어 프로그래밍을 하듯 짝꿍처럼 쓰는 것이라고 단언한다. 코드 쓰는 행위를 대체하는 도구로 쓰거나, 더 나쁘게는 생각을 아웃소싱하는 용도가 아니라는 것. 요즘은 AI가 신나니까 여기저기 AI를 갖다 붙이고 “AI에 밝은 사람”으로 보이고 싶어 하는 경향이 있는데, “이번 주에 PR 100개를 올려야 해” 같은 압박 속에 정작 뭘 하는지도 모르면서 바이브 코딩으로 ARR 백만을 외치는 풍경이 그 예시다.
직접 겪어본 바로는 AI를 쓰면 코드를 쓰는 시간은 좀 아껴도, AI가 한 일을 리뷰하고 고치는 데 시간을 더 쓰게 되더라고 한다. 스펙부터 짜게 하고 리뷰한 뒤 진행하는 정석적인 방식도 시도해봤지만 정말 오래 걸리는 과정이었다. 학교에서 계산기를 쓰거나 오픈북 시험을 보는 것과 같아서, 도구를 쓰는 지식이 실력의 본질인데 그 생각 자체를 통째로 아웃소싱해버리면 위험하다는 경고다.
[02:10] 2. useEffectEvent — effect부터 의심하라
본 발표 전 React Q&A가 먼저 나온다. 자신이 PR을 썼지만 가장 안 좋아하는 기능이기도 하다는 농담과 함께 useEffectEvent를 소개한다. 남용하지 않았으면 해서 조심스럽다는 전제를 깔고, 코드베이스에 뿌리기 전에 “여기에 effect가 정말 필요한가?”를 먼저 물으라고 권한다. “effect가 필요 없을 수도 있다”는 문서를 읽어보라는 것.
정말 드물게 effect가 필요한 경우에만 useEffectEvent가 빛난다. 대표 예는 채팅방 웹소켓 연결 같은 effect에서, 의존성 배열에 선언하지 않고도 이벤트를 발생시키는 경우다. 고급 API이니 너무 많이 쓰지 말라는 게 요점. 덧붙여 의존성을 피하려고 ESLint 예외 처리를 남발하는 짓은 그만두자고 한다. 새 버전 린터는 useEffectEvent 오용에 적절한 경고를 주니, 쓴다면 린터를 꼭 쓰라는 당부다.
[04:33] 3. React Compiler 근황 — 폐기 계획은 없다
수동 메모이제이션을 다 걷어내야 한다는 압박은 느끼지 말라고 한다. 이미 쓴 메모이제이션은 둬도 컴파일러가 알아서 최적화해주니 서두를 필요가 없다는 것. useMemo와 useCallback을 React Compiler 때문에 폐기할 계획이 있냐는 질문에는 “없을 것”이라고 답한다.
단골 질문인 “컴파일러가 언제 SWC 파이프라인에서 네이티브로 도는가”에 대해서는 팀에서 많이 논의한 주제라고 밝힌다. 현재 계획은 Meta의 Static Hermes 프로젝트 — Hermes JS 엔진을 이용해 JS를 네이티브 코드로 미리 컴파일하면서, TypeScript로 쓰인 컴파일러의 유연한 개발 과정은 유지하자는 발상이다. 아직 먼 이야기일 수도 있고, 안 되면 Rust 포팅을 다시 고민해야 할 것이라고 덧붙인다.
[06:28] 4. 발표자: I am Potato
Lauren Tan, 트위터에서는 Potato. Cursor에 온 지 다섯 달, 전 Meta React 팀(React Compiler), 그 전 Netflix 테크 리드·EM 경력. 엔지니어링 매니지먼트와 개인 기여자를 오가며 쌓인 경험이 에이전트 다루기와 통한다는 문제의식으로 발표를 연다.
[07:34] 5. 코드를 안 본다 — 신뢰의 결과
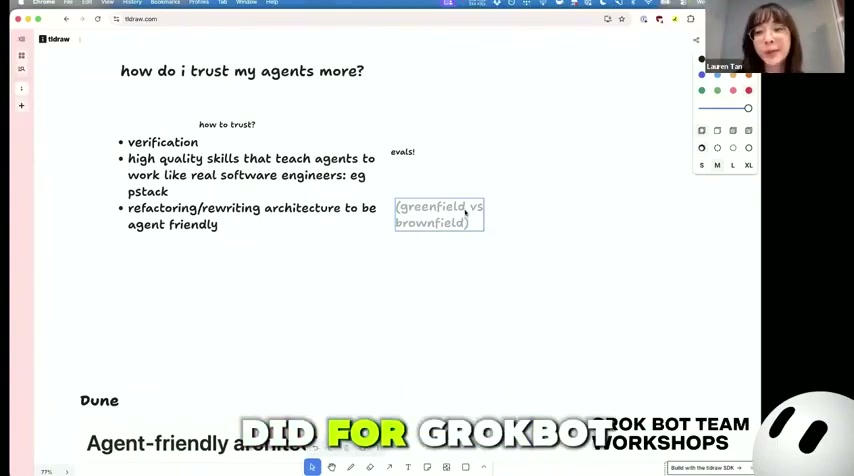
“이젠 코드를 거의 안 본다”고 선언한다. 토큰 팔려고 하는 말이 아니라 그 경지까지 진짜 노력이 많이 들었고, 토큰도 엄청 썼다는 것. 기대되는 지점은 이게 본인에게만 좋은 게 아니라 기여자 모두에게 좋다는 점이다. 디자이너, PM, 심지어 GTM까지 기능을 추가할 수 있게 되고, “누가 성능 회귀를 머지했나 봐” 하며 밤중에 걱정하며 일어날 필요가 없어진다.
이어서 완전한 그린필드 앱 GrokBot 얘기로 넘어간다. 어제 막 출시한 새 앱으로, 각자 정체성을 가진 개별 에이전트들을 직접 오케스트레이션할 수 있게 해준다. 대부분의 프로토타입처럼 완전 그린필드라 바이브 코딩으로 아주 빨리 만들었고 사람은 코드를 전혀 안 읽었다. 문제는 완전히 바이브 코딩된 앱에는 가드레일이 전혀 없어서, 에이전트가 가장 편한 방법으로 풀어버린 지름길에 최적화된 코드베이스가 걷잡을 수 없이 커진다는 것이다. 그래서 코드베이스를 시작할 때부터 강한 제약으로 시작해야 하며, 신뢰할 수 있는 코드베이스와 가드레일이 있으면 “아침에 일어나니 에이전트가 PR 20개를 머지해둔” 경지에 들어갈 수 있다고 말한다. 실제로 600개가 넘는 PR을 들여 GrokBot 전체를 새 아키텍처로 리팩터링한 것이 그 배경이다.
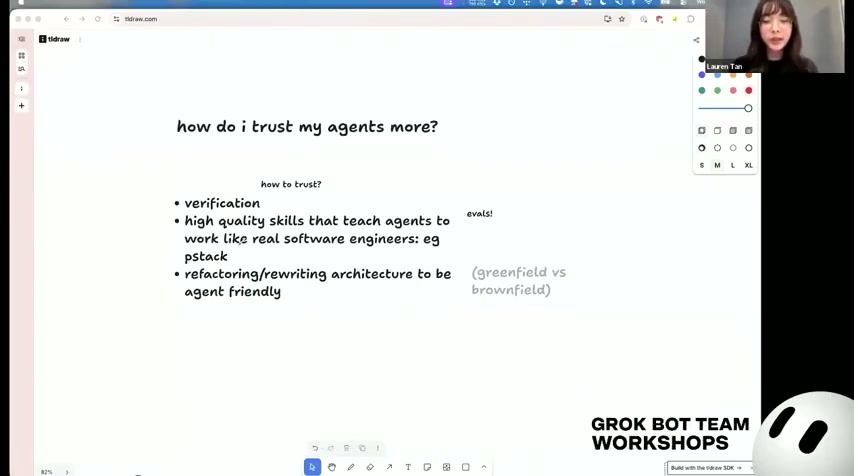
화이트보드의 아젠다는 오늘 이야기의 전체 지도다. 에이전트를 더 신뢰하는 방법은 verification(검증), 실제 소프트웨어 엔지니어처럼 일하도록 가르치는 고품질 스킬(예: P-Stack), 에이전트 친화적으로 리팩터링·리라이팅한 아키텍처 세 가지다.
[12:02] 6. 원자적 PR과 git 히스토리
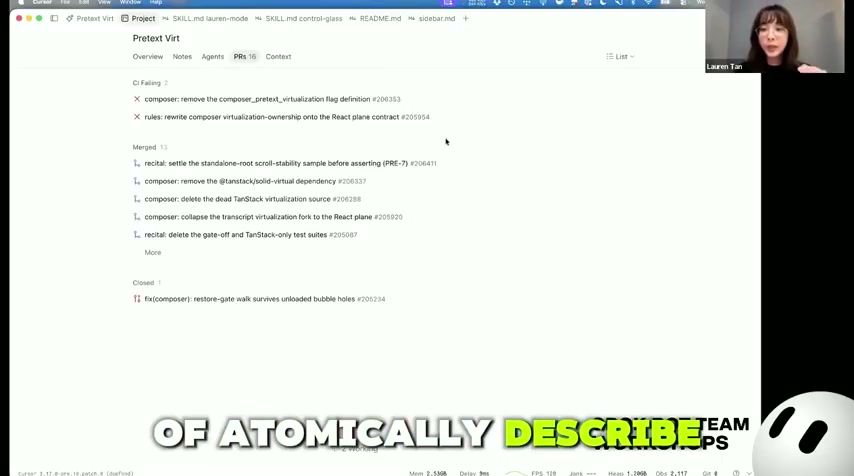
평균 PR 크기를 묻는 질문에 50줄에서 수백 줄, 천 줄까지 다양하고 상한선은 없다고 답한다. 대신 에이전트에게 일을 여러 PR로 나누라고 권장한다. 에이전트 시대엔 커밋이 너무 많아서 어렵게 느껴질 수도 있지만, git 히스토리가 정말 풍부한 컨텍스트라고 보기 때문이다. 각 PR이 작은 작업 단위를 원자적으로 설명해주면 되돌리기도 쉽고 버그가 났을 때 “아, 여기네” 하고 바로 알 수 있다. 뭐가 들어갔는지 알 수 없는 4만 줄짜리 PR이 아니라는 것. 화면에 비친 PR 목록(Pretext 가상화 관련 PR들)이 바로 그런 작은 단위들의 실물 예시다.
[13:01] 7. Dune — useEffect도 주석도 금지
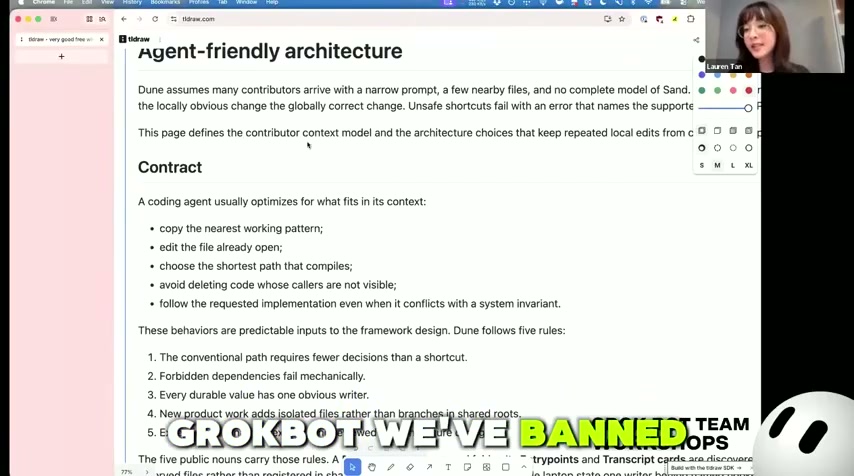
Dune은 GrokBot용으로 만든 아키텍처의 코드네임이다. CI는 꽤 빡빡해서 모든 것에 대한 검사가 있다. React를 써봤다면 useEffect가 최대의 함정 중 하나라는 걸 알 텐데, Dune과 GrokBot에서는 useEffect를 금지했다. 쓰면 CI가 실패하면서 소리 지른다. 멘탈 모델은 “Electron 앱용 Next.js”로, 에이전트가 쓰도록 설계된 에이전트 기반 앱 전용 커스텀이다.
눈썹이 올라갈 만한 규칙 중 하나는 코드 주석 금지다. 에이전트가 쓰는 코드 주석의 99%는 코드와 상관없는 과거 얘기(“Lauren이 이러지 말랬대” 같은)를 설명할 뿐이기 때문이다. 원래는 특정 PR에 대한 일회성 코멘트였는데 에이전트가 말을 못 알아듣고 주석으로 박제해버린 것이다. 에이전트는 놀랍게도 우리 말을 잘 못 알아듣고 지나치게 넘겨짚으며 멍청한 방식으로 일하기도 해서, 그냥 “에이전트가 못하는 건 상상 가능한 모든 걸 다 금지”하는 쪽을 택했다.
[15:17] 8. Electron 격리를 CI로 강제
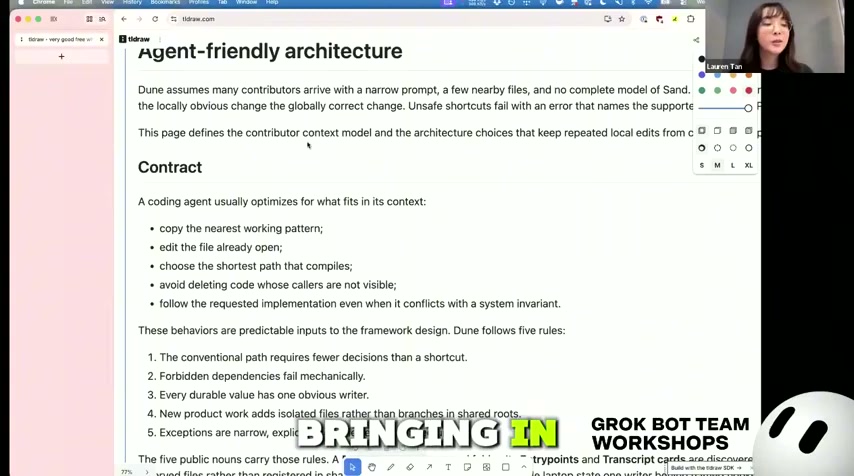
성능 이슈는 끝나지 않는 싸움이다. 머지되는 PR이 너무 많으니 어느 하나가 성능·안정성·신뢰성을 망가뜨릴 수 있는데, 에이전트 윈도우는 아직 이 아키텍처가 아니라서 배운 교훈을 가져가 전부 리팩터링할 계획이다. 대표적인 회귀가 프로세스 간 격리 실패다. Electron에는 UI를 그리는 렌더러 스레드와 막지 않아도 되는 코드를 돌릴 수 있는 메인 스레드가 있는데, 에이전트는 이 둘을 나누지 못한다. 렌더러 스레드에서 돌아가면 안 되는 무겁거나 IO 많은 코드가 딸려 들어와 16밀리초 프레임 예산을 깨고 뚝뚝 끊기는 경험을 만든다.
그래서 Electron 앱을 만들며 배운 패턴을 프레임워크에 인코딩했다. GrokBot에는 ElectronMain, ElectronRenderer 디렉터리가 있고, 의존성 그래프를 검사하는 import CI가 한쪽 코드를 다른 쪽에서 실수로 import하지 못하게 막는다. CI가 강제하는 하드 실패다. 여기에 코드 리뷰 도구 BugBot과 agents MD가 겹겹이 얹혀 있다.
[18:05] 9. 가장 멍청한 에이전트용 설계
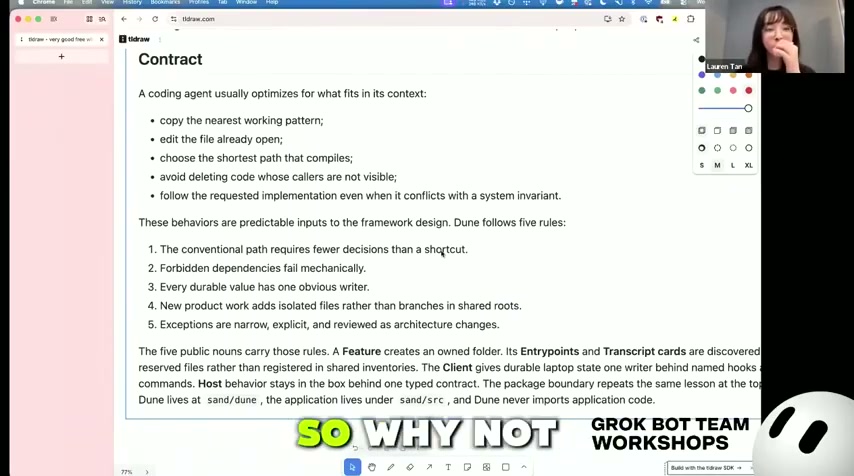
좋은 코드베이스를 만드는 층위가 여러 개 있다는 관점이 나온다. 이렇게 엄격한 아키텍처가 있으면 기능을 만드는 방식이 아주 정형화된다. 에이전트는 기존 패턴 복사를 좋아하는데, GrokBot의 feature 개념이 그 예다. 진입점(entry point)과 트랜스크립트 카드 같은 프레임워크의 명사들이 있고 만드는 방법이 정형화돼 있다. feature는 전부 단일 디렉터리에 있어서 그 기능에 기여하는 코드가 한곳에 모여 있다. 에이전트가 여기저기 뒤지며 위치를 찾을 필요가 없고, 일의 80%가 그 안에 캡슐화된다.
핵심 원칙은 “가장 짧은 길이 가장 좋은 길”이다. 에이전트는 지름길을 좋아하고 문제를 푸는 가장 빠른 길을 찾아내는데, 그 길이 곧 가장 좋은 길이 되게 설계하면 된다는 것. 문서에 적힌 Dune의 다섯 규칙(정석 경로가 지름길보다 결정을 덜 요구하게, 금지된 의존성은 기계적으로 실패하게, 내구성 있는 값은 하나의 명확한 작성자에게, 새 작업은 공유 루트 분기 대신 격리된 파일로, 예외는 좁고 명시적이며 아키텍처 변경으로 리뷰)이 바로 그 인코딩이다. 이 프레임워크는 오픈소스로 풀기보다 아이디어와 원칙의 모음에 가깝다며, 원하면 스크린샷을 찍어가서 자기 에이전트에게 같은 걸 만들어달라고 하라고 권한다.
[19:06] 10. 부드러운 규칙만으론 쓰레기가 된다
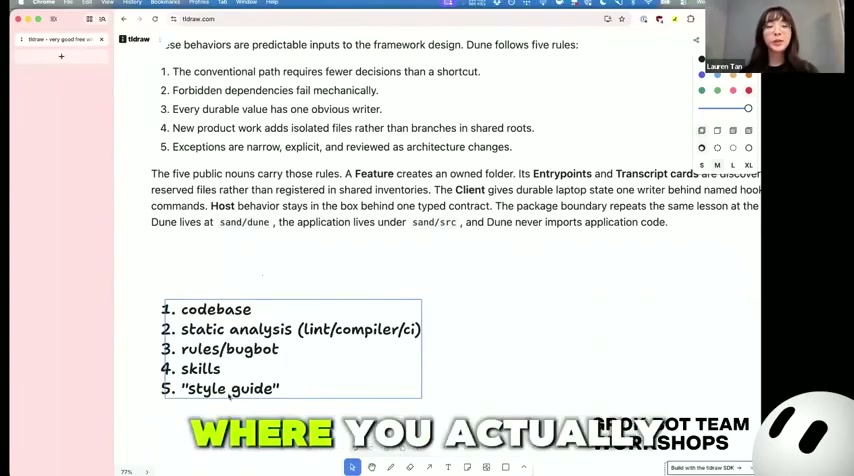
핵심은 층위다. 코드베이스라는 한 층 위에 feature·디렉터리 구조, import 차단 같은 의존성 규칙이 있고 전부 정적 분석과 CI 검사로 강제된다. 관찰된 나쁜 패턴에 대한 린트, 컴파일러 진단이 있고, 그 아래 부드러운 층으로 규칙과 BugBot이 있다. 화면에 정리된 다섯 층 — 1. codebase, 2. static analysis(lint/compiler/CI), 3. rules/bugbot, 4. skills, 5. style guide — 이 바로 그것이다.
규칙·스킬·BugBot은 에이전트가 잊을 수 있고 항상 일관되게 적용하지 않으니, 겹겹이 쌓되 유일한 강제 수단으로는 쓰지 말라고 강조한다. 규칙·BugBot·스킬·스타일 가이드만 있으면 코드베이스가 쓰레기가 되는 건 시간문제라는 것. 그래서 “하드하게 강제할 수 있는 것에 투자하라”는 권고가 나온다. 기술 스택 선택도 중요해서 Rust가 다시 뜨는 이유가 여기 있다. 엄격한 컴파일러와 borrow checker 덕분에 unsafe 블록만 막으면 “컴파일되면 아마 동작한다”는 확신을 얻을 수 있고, 사람이 직접 가서 확인할 필요가 없어진다.
최악의 자리는 코드 리뷰 지옥 — 사람이 코드를 직접 읽으면서 제약과 불변식을 강제하는 상태다. 그렇게 해야 할 때마다 코드 스멜·안티패턴으로 보고 “PR에 댓글 다는 대신 어떻게 하드 규칙으로 바꾸지? 린트 규칙으로? CI 실패로? 아니면 문제를 원천 제거할 수 있지?”라고 자문하라는 것이 실전 공식이다.
[21:31] 11. 토큰 ROI — 초반 과금이 날씬한 팀을 산다
같은 화면(화이트보드 아젠다) 이어짐 — [장면 5]와 스크린샷 공유
“평범한 토큰 사용량으로도 현실적인 이야기냐”는 질문에 솔직하게 답한다. AI 랩에 다니니 토큰이 무제한이라 자기가 한 그대로 하라고 말할 수는 없다는 것. 그래도 돈을 깨지 않고도 갈 수 있다고 본다. 엔지니어링 리더라면 ROI 문제로 보라는 권고다. 초반에 토큰을 많이 쓰는 건 맞다. 코드베이스 리팩터링과 제약 추가에 토큰이 잔뜩 든다.
하지만 목표가 에이전트가 모든 코드를 쓰고 아주 린하게 가는 세상이라면 계산이 달라진다. 1만 명짜리 엔지니어 조직(Meta 같은)의 오버헤드 없이 날렵하게 있고 싶다면, 전엔 못 하던 일 — 혼자 힘으로 코드베이스에 이런 수준의 제약을 강제하는 것 — 을 에이전트가 하게 해주는 게 가치다. 혼자 했다면 몇 년이 걸릴 프레임워크·리팩터링·테스트·검증을 토큰으로 산 셈이고, 본인 연봉을 생각하면 트레이드오프는 “누굴 뽑아서 시키느냐 vs 토큰을 써서 가장 순진하고 멍청한 에이전트도 잘하는 코드베이스를 만드느냐”가 된다. 여기까지 오면 뛰어나지 않은 에이전트도 코드를 훌륭하게 쓰고, PM·디자이너·낯선 엔지니어까지 지속 가능한 방식으로 기여할 수 있게 돼 팀 전체가 생산적이 된다. etclovg-v-verification의 검증·평가 관점과도 맞닿는다.
[25:09] 12. GrokBot, 비개발자의 Cursor 모먼트
같은 화면(화이트보드 아젠다) 이어짐 — [장면 5]와 스크린샷 공유
제품 팀이 엔지니어 군단의 속도를 어떻게 따라가느냐는 질문에는 GrokBot 얘기로 답한다. 그 전에는 에이전트 윈도우·CLI·IDE라는 파워유저 도구만 있었고, 개발자 중심으로 설계돼 GTM·제품 같은 분들에게 즐거운 경험이 아니었다. 이제 GrokBot이 비개발자를 위한 Cursor 모먼트가 됐다. iMessage처럼 생긴 편안하고 익숙한 인터페이스에서 에이전트를 쓰는 아주 쉬운 방법이고, 에이전트에게 재밌는 이름을 지어주고 오케스트레이션도 자연스럽게 할 수 있다. 관리하는 계정마다 에이전트 하나, “Lauren이 어젯밤에 한 일을 요약해줘” 같은 식이다.
실제로 PM들이 코드를 낸다. “어, 버그 있네. 고쳤어” 하고 오는 경우가 많고 리뷰해보면 실제로 완벽해서 “오케이, 도장”으로 끝난다. 엄격한 제약(Dune) 덕분에 비전문가도 높은 수준으로 기여하는 것이고, 그 증거다. 이미 디자이너·PM이 직접 기능을 내고 있어서 GrokBot 팀이 엄청 빠르다.
[27:16] 13. 신뢰 곡선 — 1개도 못 믿으면 100개는 못 띄운다
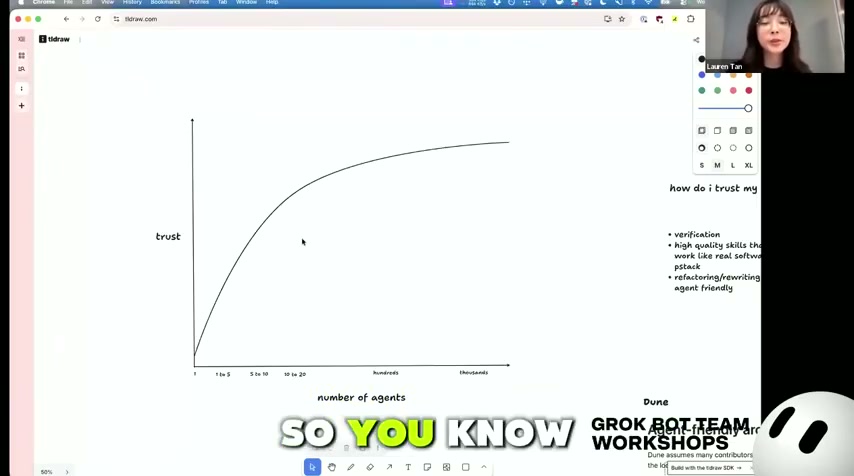
오래 코드 써온 엔지니어라면 좋은 엔지니어링에 대한 의견과 교훈이 많은데, 에이전트가 대충 때려 맞추고 환각하고 “결정적 단서를 찾았다”고 백 번째 자신만만하게 말하는데 실제 문제가 아닐 때 신뢰를 크게 잃는다. 에이전트를 신뢰하지 못하면 최대한 뽑아낼 수 없다는 것. 그래서 관리 비유를 든다. 팀원을 신뢰하지 못하는 엔지니어링 매니저는 마이크로매니징 모드가 돼 리포트 어깨너머로 들여다보며 프로덕션 버그를 감시하는 데 시간을 다 쓴다.
과학적이진 않지만 여정을 상상한 차트를 그렸다. 1년 전으로 돌아가면 에이전트로 코딩하는 사람이 거의 없었고, 하나 또는 몇 개의 에이전트와 깊이 엮여 에이전트가 뭘 하는지 끊임없이 이해하려고 애쓰는 완전 인더루프 모드가 된다. 모든 출력을 지켜보고 앉아서 프롬프트해야 해서 병렬화가 안 된다. 신뢰가 없으니 에이전트 하나 출력도 못 믿는데 백 개를 띄울 수는 없기 때문이다. 지난 다섯 달 동안 그 신뢰 곡선을 올라올 수 있었고, 이제는 에이전트가 PR을 자동 머지해준다. 오늘 아침에 일어나니 PR 20개가 랜딩돼 있었고 main에서 리뷰했는데 좋았다. 어떻게 여기까지 왔는지가 오늘 이야기의 본론이다.
[30:05] 14. 5개월 3000+ PR
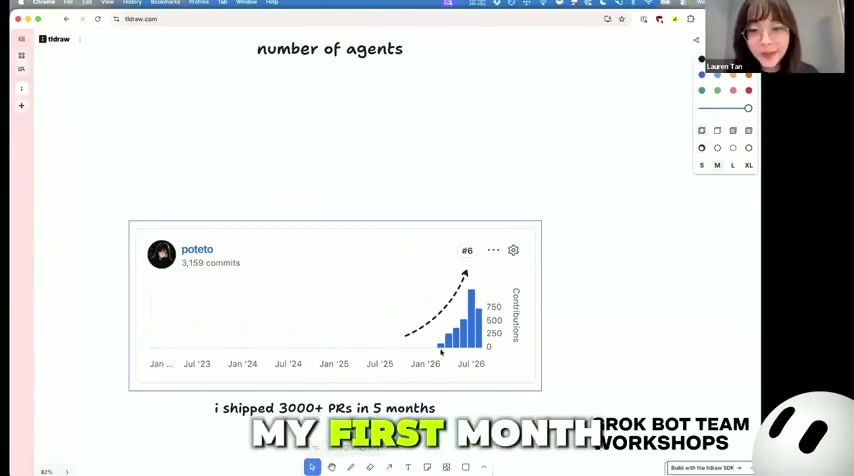
곡선을 보면 Cursor에서의 기여도와 반비례하는 게 보인다. 5개월 전 합류 첫 달엔 코드베이스를 익히느라 생산성이 별로였는데, 에이전트를 신뢰하게 되면서 생산성을 확 끌어올렸다. 지난달엔 PR을 천 개 냈고, 이번 달은 12일밖에 안 됐는데 벌써 랜딩이 800개 가까이 된다. 속도는 확실히 빠르고, 코드가 얼마나 좋은지는 의문이 들 만하다. “에이전트를 잘 세팅하면 비슷한 수준까지 충분히 갈 수 있다”며 그 방법을 이어서 설명한다.
[31:20] 15. 검증 — 툴박스의 첫 번째 스킬
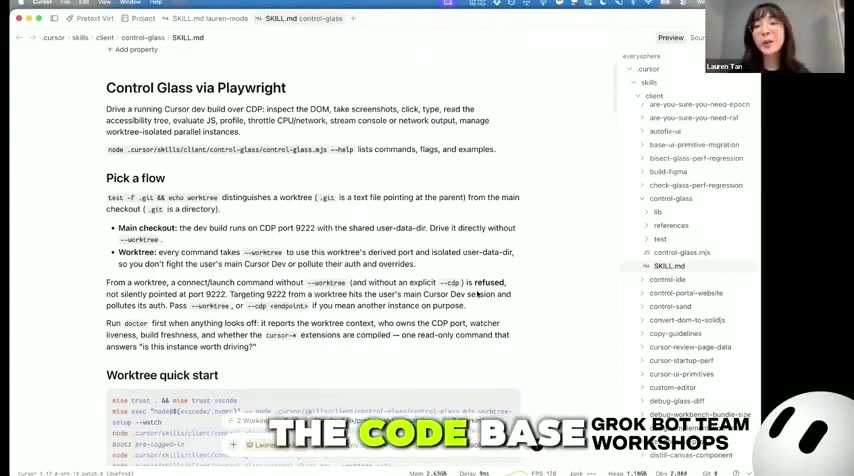
에이전트와 일할 때 툴박스에 있어야 할 가장 중요한 스킬은 검증(verification)이다. 검증이란 에이전트가 실제로 코드를 실행하거나 CPU 트레이스를 뜨거나 힙 스냅샷을 뜨거나 iOS 시뮬레이터를 여는 것, 즉 사용자에게 노출되는 것과 같은 방식으로 실행할 수 있는 능력을 말한다. 실제로 돌려서 테스트하고 검증하면 루프가 닫힌다. 좋은 코드를 쓴다는 보장은 안 되지만 적어도 올바른 코드는 쓸 수 있게 해준다.
Cursor에 합류했을 때 원래 클라우드 에이전트 팀에 갈 예정이었는데, React 경험 때문에 출시 일주일 앞둔 에이전트 윈도우를 돕게 된 사연이 나온다. 마감은 빡빡했고, Chrome 개발자 도구 성능 탭의 트레이스를 플레임 그래프로 직접 보며 이해하려 했다. 코드베이스는 완전히 처음 보는 것이었고, 에이전트도 트레이스 스크린샷을 보내면 “대충 이런 것 같아요”라며 자신만만하게 틀린 원인을 짚었다. 검증 스킬 없이 에이전트와 개발하면 검증자가 본인이 되어 병목이 된다. 에이전트가 코드를 쓰고, 사람이 로컬 빌드를 열어 확인하고, 스크린샷·콘솔 에러를 복붙하고, 에이전트가 천천히 이해하고 고치는 루프에 갇혀 병렬화가 안 된다.
그래서 만든 초기 스킬 중 하나가 control glass다. glass는 에이전트 윈도우의 내부 코드네임이다. 스킬 자체 코드는 별로 흥미롭지 않고 핵심은 가르치는 내용이다. Electron·웹·iOS 앱을 만든다면 Chrome DevTools 프로토콜이나 Apple의 시뮬레이터 실행·트레이스·프로그램 제어 유틸리티 쓰는 법을 가르치면 에이전트가 쉽게 따라온다. 화면에 비친 SKILL.md 문서(Control Glass via Playwright — CDP로 DOM 검사·스크린샷·클릭·타이핑·프로파일링, worktree 격리 실행)가 그 실물이다.
그런데 스킬을 만들었는데도 에이전트는 허우적거렸다. “왼쪽 사이드바가 느려요”, “PR 탭이 안 돼요” 같은 말이 나오면 코드만 뒤지며 한참 헤매고 UI에서 어떻게 가는지 몰라서 사실상 쓸모가 없었다. 그래서 추가한 것이 feature map이다. 모든 기능에 가는 법을 가르쳐주는 파일로, P-Stack 플러그인에 들어 있다. 사용자 관점에서 어디서 어떻게 가는지, 단축키는 뭔지, CDP로 선택할 때 쓰는 DOM 요소·속성까지 전부 담겨 있다. 들어오는 사용자 리포트를 매핑할 수 있으니 모호한 리포트나 스크린샷 한 장(”???”, “이게 뭐예요?”)도 처리할 수 있게 된다. create verification skill로 직접 세팅을 돕고 maintain verification skill로 최신 유지까지 한다.
[38:25] 16. P-Stack — 실패 모드를 스킬로
같은 화면(화이트보드 아젠다) 이어짐 — [장면 5]와 스크린샷 공유
P-Stack이라는 이름부터가 농담이다. P는 potato의 P로, Y Combinator CEO Gary Tan의 G stack(Gary stack) 플러그인을 놀리면서 자기 엔지니어링 관행에 맞춘 버전을 만든 것이다. 사실 P-Stack을 만들려고 한 건 아니고 스킬 모음에서 시작됐다. control glass 스킬에서 시작해 에이전트를 관찰하다가 how라는 스킬도 만들었다.
초반에 사다리를 오를 때는 완전 인더루프였고 에이전트에게 극도로 잔소리를 했다. 에이전트는 자신만만하게 “이거임, 맞죠?”라고 하는데 실제 툴 호출을 보니 영향받을 거라 생각한 코드를 전혀 안 읽고 있었다. 그래서 “이 에이전트는 못 믿겠다, 완전 환각이네” 싶어지고, 불신을 쌓고 무력감을 느끼기 쉽다. 여기서 관리 비유가 다시 등장한다. 코딩은 잘하지만 비즈니스 맥락이 전혀 없는 신입 엔지니어를 방금 뽑아 5초 전에 온보딩했다고 상상해보라. 그런 사람을 일 잘하게 가르치는 방법이 스킬이다. 스킬은 그냥 마크다운인데 정보와 지시를 코드로 담아 에이전트에서 지능을 확 끌어낼 수 있다. 트위터 표현으로는 “에이전트를 다른 잠재 공간으로 끈다”는 것. LLM이 다음 토큰을 예측하니 처음에 고품질 토큰을 주면 더 상위 공간에서 패턴 매칭을 해서 더 똑똑해진다는 모델이다.
P-Stack은 아주 점진적으로 만들었다. 에이전트의 온갖 실패 모드를 관찰하다가 볼 때마다 “이건 스킬로 만들자”고 했다. “환각 멈춰, 실제로 가서 코드를 찾아, 서브 에이전트를 많이 써, 찍지 마” 같은 것들이다.
[42:04] 17. eval은 에이전트용 단위 테스트
채팅의 두 가지 큰 질문 — 스킬을 어떻게 유지하느냐, 검증이 충분한지 어떻게 아느냐 — 에 답한다. 유지 얘기부터다. eval 개념을 모른다면 에이전트용 단위 테스트라고 생각하면 된다. 특별한 프레임워크 없이 직접 만들 수 있고 얼마나 과학적·엄밀하게 할지는 알아서 정하면 된다.
P-Stack의 potato 모드에 eval playbook이라는 꽤 엄밀한 플레이북이 있다. 방식은 서브 에이전트를 잔뜩 띄우는 것이다. 메인 코디네이터 에이전트가 스킬의 루브릭을 만들고, 서브 에이전트들을 띄워서 각자 디렉터리를 만들게 한다. 이때 평가받는다는 걸 서브 에이전트가 모르게 디렉터리 이름을 영리하게 짓는다. 알면 행동이 바뀌기 때문이다. 그렇게 만들고 바꾸는 스킬이 생각한 대로 동작하는지 테스트한다. Cursor의 좋은 점은 지원하는 모델이 정말 많아서 온갖 모델에 걸쳐 스킬을 eval하고 성능 매트릭스의 감을 잡을 수 있다는 것이다. 스킬을 고칠 때마다 플레이북을 돌려 원하는 결과가 나오는지 확인한다.
그래도 스킬 유지는 꽤 어렵고 취향과 관찰이 많이 필요하다. 뒷좌석 운전수가 되라는 조언이 나온다. 페어 프로그래밍할 때 동료가 코딩하는데 “내가 더 잘할 수 있는데” 싶으면서 질문을 많이 하듯이, 에이전트를 수동적으로 지켜보지 말고 스킬 모음을 만드는 초기엔 운전석에 앉아 있어야 한다. 툴 호출을 다 열고 코드·에이전트 행동·사고 과정을 읽으며 어디서 실패하는지 보고 그걸 스킬로 만들면 된다.
검증 신뢰도도 비슷한 반복 루프다. eval의 재밌는 점은 힐 클라이밍이 된다는 것이다. eval이 점수를 내고, 코디네이터가 점수를 내게 하거나 다른 모델의 판정 에이전트로 교차 확인할 수 있다. Cursor의 slash loop로 “전부 10점 만점 될 때까지 이 eval을 계속 돌려” 같은 식이다. control 스킬도 기본적으로 같은 방식으로 만들어서 꽤 손을 뗐다. 처음엔 전혀 매끄럽지 않았고 반복을 많이 해야 했다. 지금 엔지니어인 자신은 매니저 같고, 좋아하는 비유는 레스토랑의 헤드 셰프다. 음식을 전부 직접 요리하지 않고 요리사 팀과 스테이션을 두고 환경을 설계하고 일을 나눠주는 책임을 진다.
[47:52] 18. 로컬에서 벼려 클라우드로 — Benny
같은 화면(화이트보드 아젠다) 이어짐 — [장면 5]와 스크린샷 공유
검증 시스템을 만든다면 실질 단계는 무엇이고 어디서 시작하느냐는 질문에 “로컬에서 시작”이 답이다. 관찰할 수 있기 때문이다. 에이전트에게 애플리케이션을 띄우게 하고(CLI든 데스크톱 앱이든) 애플리케이션과 어떻게 상호작용하는지, 여러 API를 어떻게 호출하는지 직접 보면 된다.
개인적으로는 클라우드 에이전트에 거의 올인했다. 엄청 강력하기 때문이다. Cursor의 정말 강력한 점이 클라우드 에이전트인데, 돈을 조금 쓰고 환경 세팅에 시간을 조금 쓰면 control·검증 스킬이 엄청난 배당을 준다. 엔지니어 한 명이 좋아지는 게 아니라 팀 전체, 심지어 회사 전체가 레벨업한다. 클라우드 에이전시를 자동화라고 생각하기 시작할 수 있다. 예를 들면 Benny라는 에이전트가 있다. 들어오는 버그 리포트를 전부 받아서 클라우드에서 자동으로 나가 자기 데스크톱의 Cursor를 실행하고 같은 control 스킬로 애플리케이션과 상호작용하며 버그·사용자 리포트를 재현하려 한다. 자동으로 정보를 엄청 얻는다. 예시에서는 Benny가 실제로 버그를 재현했는데 main에선 이미 고쳐져 있어서, 새 빌드만 릴리스하면 된다는 걸 확인해줬다. 에이전트랑 한 시간씩 붙잡고 고쳐졌나 확인하지 않아도 되는 엄청난 정보이고, 시간을 엄청 되찾는다. 팀 모두, 회사 모두가 혜택을 본다.
단, 여정이 필요하다. 먼저 신뢰해야 한다. 아직 인더루프 구간이라면 “클라우드 에이전트 수천 개를 지금 띄우겠다”고 점프하지 말라고 권한다. 토큰만 잔뜩 낭비하고 엄청 비싸질 것이다. 정리하면 검증부터 시작해서 에이전트가 적어도 올바른 코드를 내는지 판단하는 스킬·방법을 만들고, 로컬에서 신뢰가 생기면 클라우드로 확장해서 스스로 신호를 잡는 에이전트를 더 돌리고, 마지막 단계가 PR 자동 머지 — 지금 발표자가 있는 위치다. main에서 리뷰하는 방식이다. 시작할 땐 에이전트 몇 개 겨우 쓰며 모든 걸 지켜봤던 여정이고, 지름길은 없다. 에이전트에 대한 개인적인 신뢰의 문제라 취향과 판단이 많이 든다. P-Stack 같은 플러그인이 적응을 도와줄 수 있지만 맹목적으로 믿지 말고 직접 스킬 모음을 만들거나 포크해서 자기 것으로 만들고 개선하라고 권한다. 각자 엔지니어링 기준이 다르고 코드베이스에서 중요한 게 다르니, 그걸 전부 스킬로 인코딩하고 에이전트가 실제로 하는지 검증할 수 있으면 곡선을 올라 자동화할 수 있다.
[52:54] 19. 리라이트가 답일 때
같은 화면(화이트보드 아젠다) 이어짐 — [장면 5]와 스크린샷 공유
마지막 주제는 리팩터링과 리라이트 — 업계에서 가장 논란 많은 “앱을 다시 써야 하냐”는 문제다. 엔지니어는 회사에 합류해서 코드베이스를 보면 “이거 쓰레기네, 전부 다시 쓰고 싶어”라는 충동을 느끼기 쉽다. 에이전트 이전에는 다시 쓰지 말라는 게 정설이었겠지만, 경우에 따라 고려해볼 만한 이유를 말하러 왔다.
브라운필드 앱은 사실 꽤 좋은 위치에 있다, 이미 잘 세팅돼 있다면. 최근 여러 사람과 얘기하며 느낀 공통점은 빅테크의 문제가 이젠 모두의 문제라는 것이다. Meta 다닐 때 거대한 모노레포에 수만 명의 엔지니어가 코드를 냈는데, 훌륭한 엔지니어가 많아도 코드 품질은 사실 별로였다. 그래서 “AI 쓰레기 이전에 인간 쓰레기가 있었다”고 농담한다. Meta·구글 같은 빅테크 인프라는 그걸 전제로 설계돼 있다. 팀에서 가장 실력이 떨어지는 엔지니어에 맞추는 것으로, 프레임워크·컨벤션·가드레일을 만들어 인턴이 프로덕션 DB를 날리지 못하게 권한을 막는 수준의 인프라다. 그런 수준의 인프라가 이미 있다면 에이전트가 이미 꽤 잘한다. 가드레일이 있어서 큰 사고를 치지 않기 때문이다. 가드레일은 계속 추가하면 되고, 트레이드오프인 건 확실하다. 공짜는 없고 토큰은 꽤 비싸다.
여담으로 오늘 Grok 4.6을 발표했다는 소식이 나온다. 정말 똑똑하고 벤치마크도 정말 좋으며, 토큰 단가는 4.5와 같은 걸로 알아서 같은 비용에 더 똑똑해지는 것이다. Cursor와 xAI가 비용 대 지능의 파레토 프론티어를 최적화하려는 분야라는 설명과 함께, 가장 큰 모델이 아니라 거대할 필요 없이 엄청 똑똑하고 추론 비용이 비싸지 않은 스위트 스팟을 찾는 게 핵심이라고 말한다. 마무리는 GrokBot과 4.6을 써보고 피드백을 달아달라는 부탁과 감사 인사다.
부록 — 실전 체크리스트
- 에이전트에게 일을 시키기 전에 “이 작업에 effect(부수효과)가 정말 필요한가”부터 묻기 — 지름길 금지 규칙의 첫 질문으로 쓰기
- PR에 같은 코멘트를 두 번 달았다면 린트 규칙·CI 실패·아키텍처 변경 중 하나로 승격할 방법 찾기
- 내 코드베이스의 “가장 짧은 길” 점검하기 — 에이전트가 가장 먼저 손대는 경로가 정답이 아니라면 그 경로를 정답으로 만들기
- 검증 스킬 하나 만들기 — 에이전트가 앱을 직접 실행·트레이스·테스트해서 루프를 닫게 하기 (CDP·시뮬레이터·CLI 중 하나부터)
- 에이전트 실패 모음집 시작하기 — 환각·찍기·안 읽기를 볼 때마다 스킬 한 줄로 적립하기
- 스킬마다 작은 eval 만들기 — 서브 에이전트로 돌려보고 10점 만점까지 힐 클라이밍하기
- 로컬 신뢰가 생기기 전에는 클라우드 에이전트 수천 개 점프 금지 — 토큰 화형 방지
원문 인용 모음
- [00:00] “개인적으로 AI를 가장 잘 쓰는 방법은, 페어 프로그래밍을 하듯 짝꿍처럼 쓰는 거라고 생각합니다.”
- [00:56] “대신 AI가 한 일을 리뷰하고 고치는 데 시간을 더 쓰게 되더라고요.”
- [01:41] “그 생각을 통째로 아웃소싱해버리면, 정말 위험하다고 생각합니다.”
- [02:27] “먼저 ‘여기에 effect가 정말 필요한가?‘라고 물어봐야 한다고 생각합니다.”
- [07:19] “재밌게도 관리 스킬과 에이전트를 다루는 법 사이에 공통점이 정말 많다는 걸 느꼈어요.”
- [09:15] “에이전트에게 일을 시키면 가장 편한 방법으로 그냥 풀어버립니다.”
- [10:13] “600개가 넘는 PR을 들여 GrokBot 전체를 제가 만들어온 새 아키텍처로 리팩터링했기 때문입니다.”
- [19:51] “규칙, BugBot, 스킬, 스타일 가이드만 있으면 코드베이스가 쓰레기가 되는 건 시간문제예요.”
- [21:14] “그리고 ‘PR에 댓글 다는 대신, 어떻게 하드 규칙으로 바꾸지?‘라고 말하세요.”
- [28:04] “마이크로매니징 모드가 되죠. 리포트 어깨너머로 들여다보며 일을 잘하는지 확인하는 데 시간을 많이 써야 해요.”
- [31:20] “에이전트와 일할 때 툴박스에 있어야 할 가장 중요한 스킬은 검증(verification)이라고 생각해요.”
- [40:35] “스킬은 그냥 마크다운이에요.”
- [42:08] “eval이라는 개념을 모른다면, 에이전트용 단위 테스트라고 생각하면 돼요.”
- [46:50] “여러분의 일은 환경을 설계하는 거예요.”
- [51:39] “여기서 저기로 가는 지름길은 없어요. 에이전트에 대한 개인적인 신뢰의 문제니까요.”
- [54:22] “그래서 ‘AI 쓰레기 이전에 인간 쓰레기가 있었다’고 농담해요.”
관련 노트
- cursor — Cursor 플랫폼과 에이전트 윈도우의 맥락
- moc-ai-agents — AI 에이전트 MOC, 하네스·오케스트레이션부터 시작하기
- etclovg-v-verification — 검증·평가(Verification & Evaluation) 관점
- harness — 에이전트 하네스 개념 정리