출처 https://youtu.be/ePw0u6B40kU · 채널 AgentOS · 길이 13:14 · 공개 2026-07-27 10:00 (KST) 포맷 목소리가 둘인 영상이다. 뼈대는 덱스 호시(Dex Horthy, HumanLayer 공동창업자·CEO)가 AI Engineer World’s Fair 2026에서 한 발표 “Harness Engineering is not Enough: Why Software Factories Fail”(19:17, https://www.youtube.com/watch?v=Ib5GBkD555M )의 원본 클립이고, 그 사이사이를 AgentOS 채널의 한국어 해설이 잇는다. 이 노트는 발표(덱스) 와 해설(AgentOS) 을 장면마다 구분해 표시했다 — 특히 마지막의 “되돌리기 비용” 기준은 발표에 없는 해설자 본인의 덧붙임이다. 원본 자막(자동 생성):
raw/transcripts/2026-07-27-agentos-why-software-factories-fail.en.srt,.ko.srt표기 주의 yt-dlp가 받아온
ko자막은 영어 자동자막을 기계번역한 것이라 오역이 많다(MTS(모바일 기술 지원)← Member of Technical Staff,황금빛 땅← golden patch,개인 최고 기록(PR)← pull request). 발표 구간의 한국어 인용은 영상에 입혀진 채널 자막을 따랐다. 해설 구간은 영어 자동자막에 아예 잡히지 않아 mlx-whisper(ko)로 별도 전사한 뒤, 같은 구간의 채널 자막과 대조해 수치·연도를 확인했다(전사본의회기 테스트→회귀 테스트 같은 오인식은 이 대조로 바로잡았다). 고유명사는 슬라이드 화면과 원본 발표로 대조했다 —Swebench multilingual→ SWE-Bench Multilingual,Sweep Marathon→ SWE-Marathon(abundant.ai),Deep Sweep/Data Coral→ DeepSWE(datacurve.ai),Dylan Mulroy→ Dillon Mulroy(@dillon_mulroy),Frontier Code→ Cognition,Calvin French Owen→ Calvin French-Owen,Strong DM→ StrongDM. 자동자막의A lesson be damned는 채널 자막이 “쓴 교훈이고 뭐고” 로 옮긴 데서 보듯 Bitter Lesson(쓰라린 교훈)을 잘못 받아적은 것이다. 다만 “우리는 더 이상 코드를 읽지 않는다”라는 말을 만든 사람의 이름은 세 자막이 각각Dan North·Dan Shapiro·Dentsu Bureau로 갈려 확정하지 못해 본문에서 뺐다.
한눈에 보는 요약
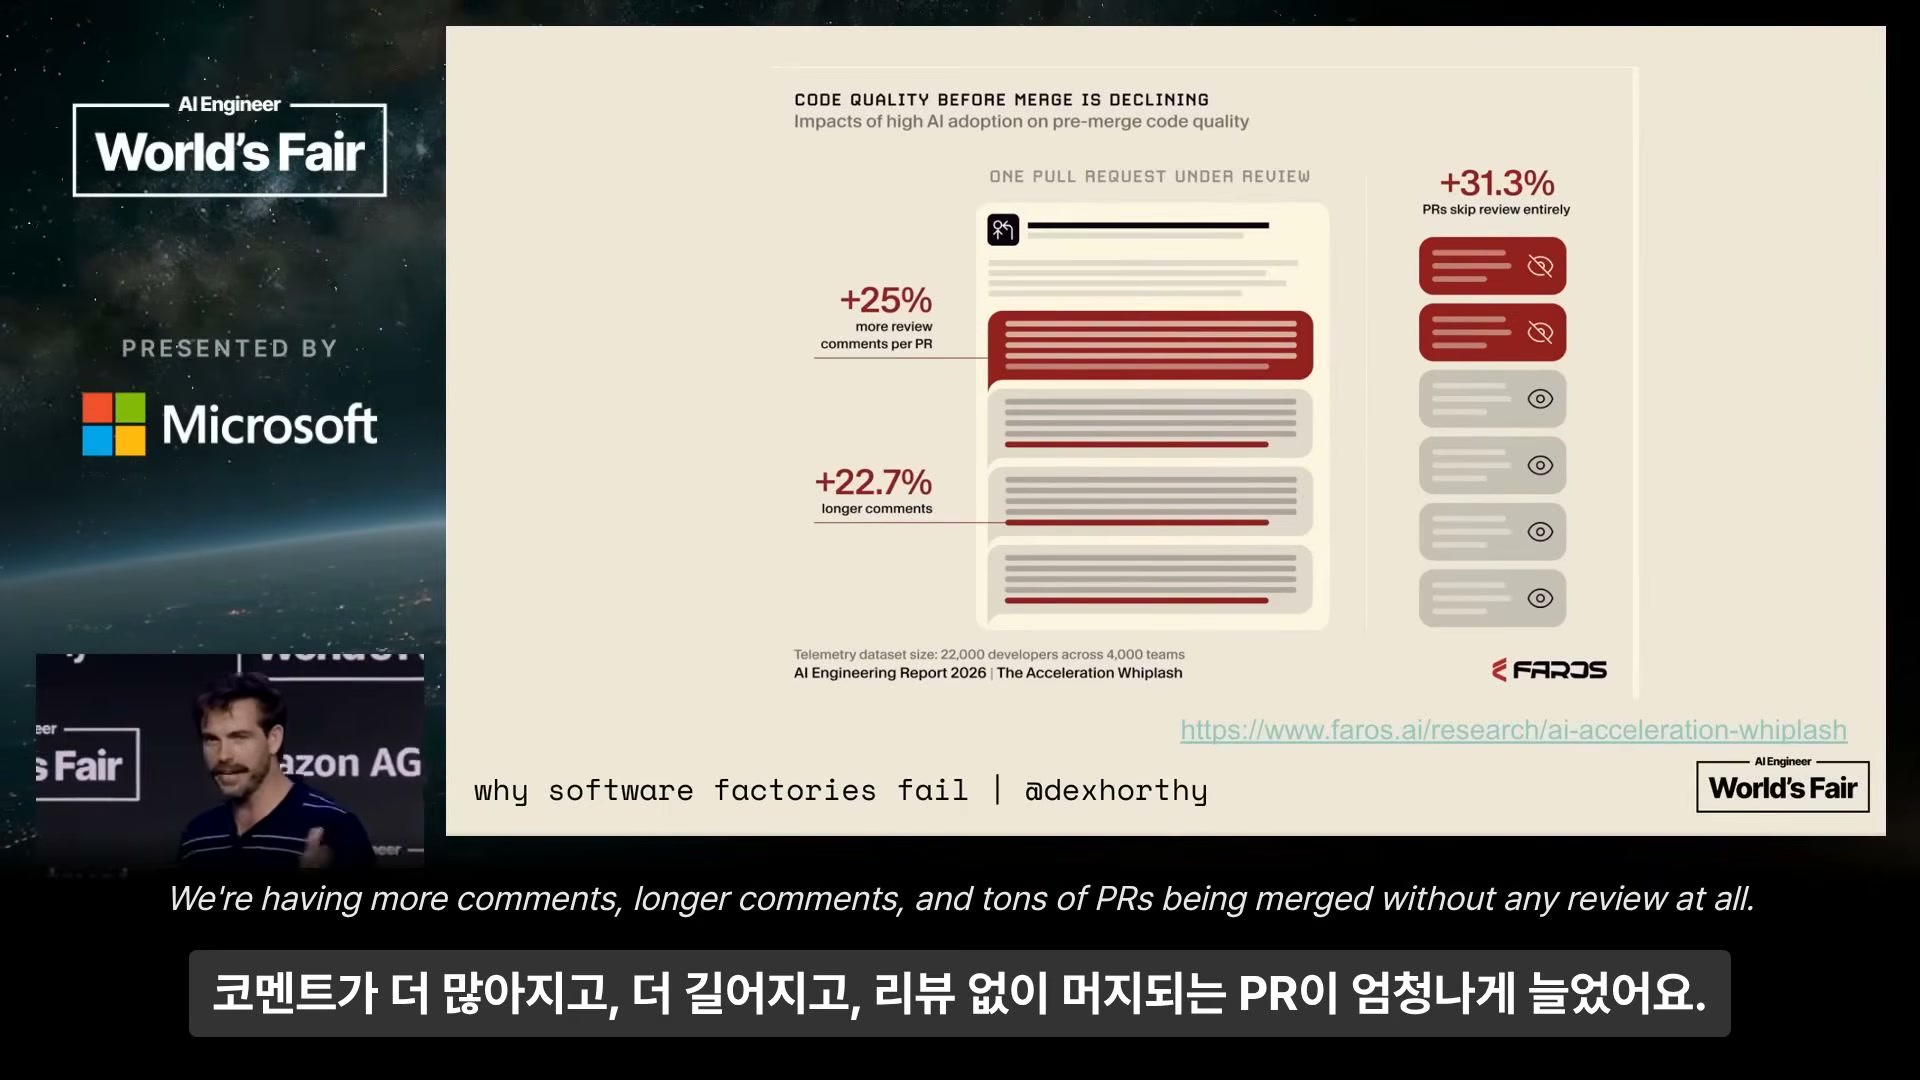
- 처리량은 올랐는데 버그·장애·재작업이 더 빨리 올랐다. Faros AI가 개발자 22,000명·팀 4,000개의 실제 작업 기록 2년치를 분석한 「The Acceleration Whiplash」가 근거다. 머지 전 코드 품질 지표는 PR당 리뷰 코멘트 +25%, 코멘트 길이 +22.7%, 리뷰를 아예 건너뛴 PR +31.3%.
- “아무도 코드를 읽지 않는 공장”은 3~6개월에 무너진다. HumanLayer가 2025년 7월에 직접 lights-off로 가봤고, 되돌렸다. 에이전트가 못 푸는 이슈가 하나 터지는 순간 3개월간 안 읽은 코드베이스를 사이트가 죽은 채로 파헤쳐야 한다.
- 원인은 프롬프트가 아니라 학습 방식이다. 이게 발표의 중심 주장이다. 코딩 에이전트 RL의 보상은 “테스트가 통과했는가” 0/1 하나라서, 나쁜 프로그램 설계나 유지보수성 훼손에 벌점을 줄 자리가 구조적으로 없다. 그래서 필요 없는 try/catch, 통과만 시키려는 캐스팅 같은 슬롭이 나온다.
- 품질 검증은 “코드가 돌고 테스트가 통과한다”보다 몇 자릿수 어렵다. 나쁜 아키텍처의 비용 함수는 개월·연 단위로 측정되기 때문이다. 코딩 한 번의 결과를 몇 달 뒤에야 안다.
- 채점표를 더 잘 만드는 방향은 실제로 진행 중이고 발표도 인정한다 — SWE-Marathon(abundant.ai), DeepSWE(datacurve.ai), Frontier Code(Cognition). 하지만 심사 모델에는 빠져나갈 수 없는 고리가 있다: 모델이 좋은 코드가 뭔지 알았다면 애초에 그렇게 썼을 것이다.
- 그래서 지금은 읽는 수밖에 없다. 단, 리뷰를 빠르게 하는 게 아니라 읽기 쉬운 PR이 오게 만드는 것이 해법이다. 에이전트에 넘기기 전 사람이 밟는 네 단계 — 제품 리뷰 → 시스템 아키텍처 → 프로그램 디자인 → 버티컬 슬라이스.
- 앞단 30분이 리뷰 몇 시간을 아낀다. PR이 너무 많은 게 아니라 나쁜 PR이 너무 많은 것이다. 잘 만들어진 PR은 읽는 게 즐겁고, 20%만 재작업이 필요해도 리뷰어와 제출자 양쪽에 감정적·지적 부담이 된다.
- (해설자의 덧붙임) 사람이 어디까지 적어야 하는가의 기준은 “되돌리기 비용”이다. 혼자 뒤집을 수 있는 건 에이전트에게, 여럿이 합의해야 하는 건 사람이. 함수 안은 틀려도 파일 하나만 고치면 되고 테스트가 잡아주지만, 시그니처가 틀리면 호출부 전부가 깨지고 의존성 방향이 틀리면 한 군데 고치려 열 군데를 건드린다. 그 경계의 맨 아래가 인터페이스다.
장면별 상세 설명
[00:00] 1. (해설) 처리량은 올랐는데, 버그가 더 빨리 올랐다
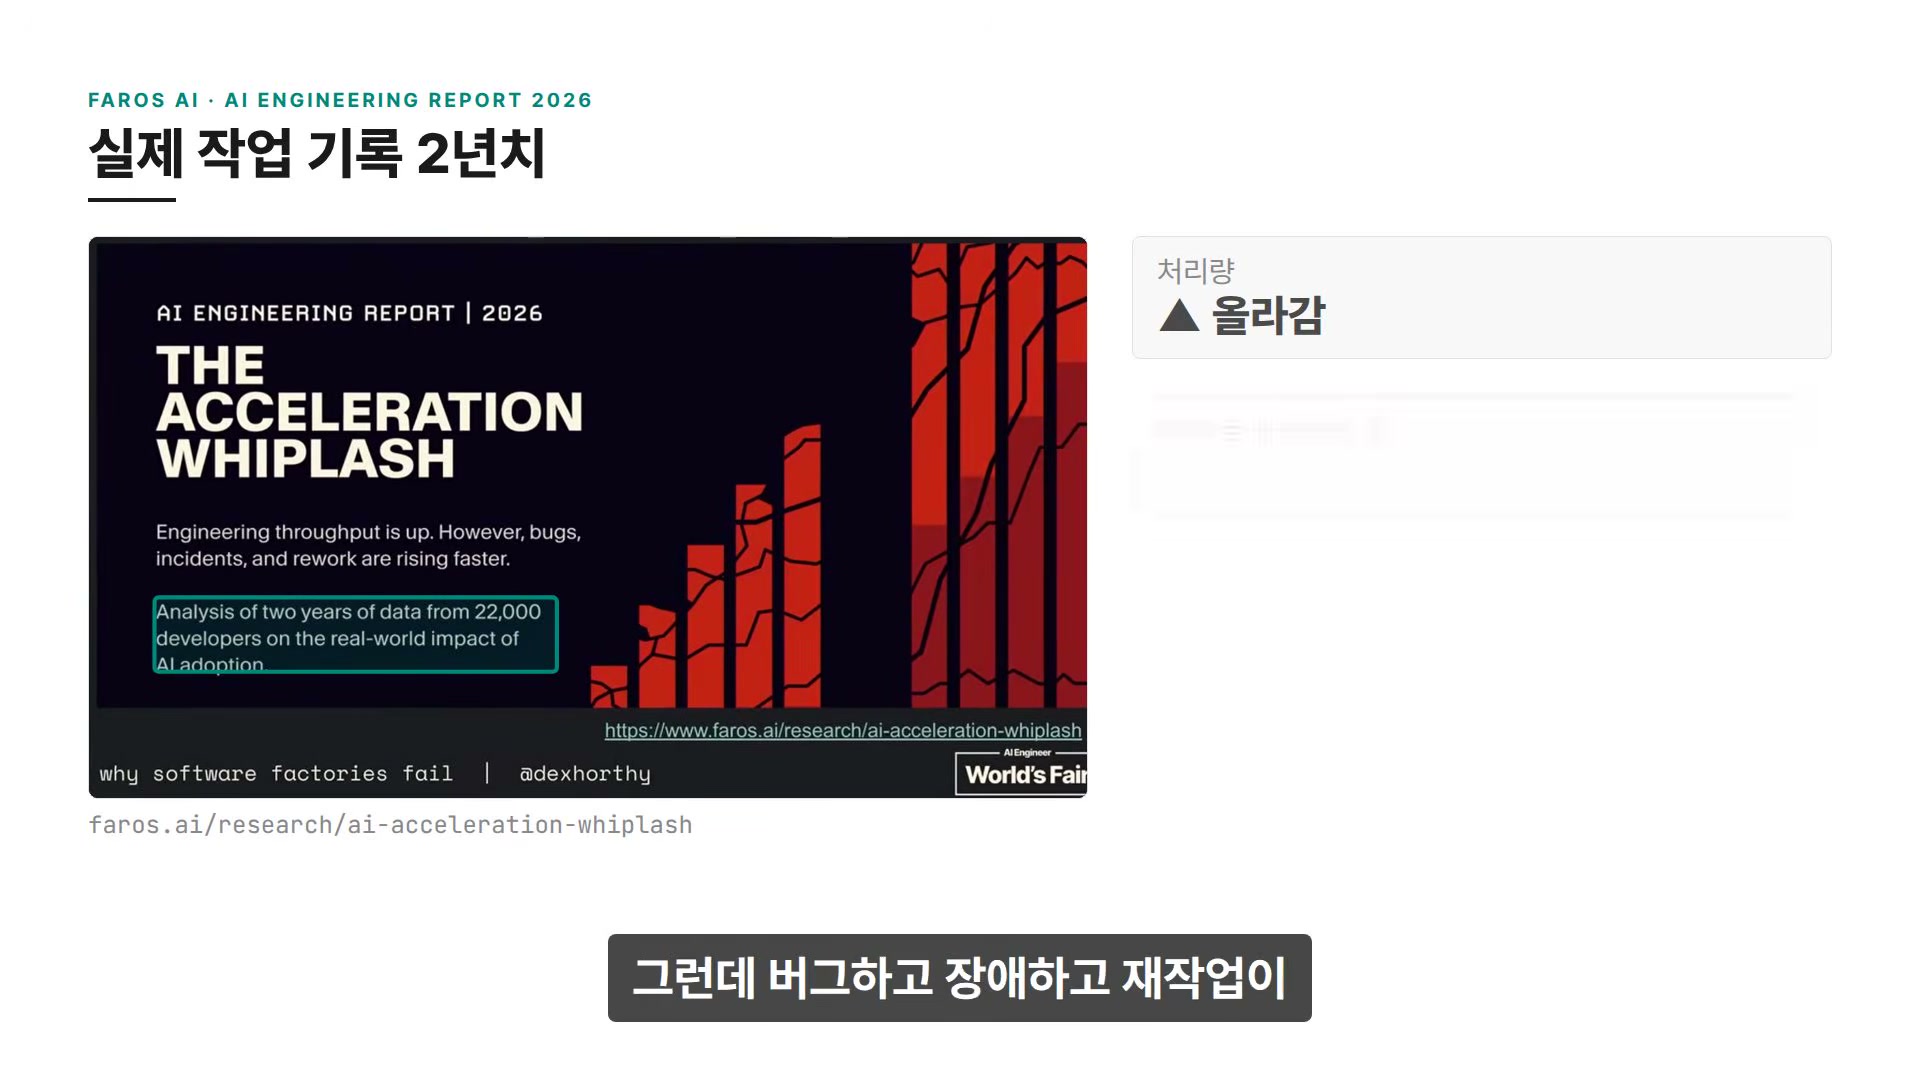
해설은 숫자부터 깐다. Faros AI가 올해 낸 「AI Engineering Report 2026 — The Acceleration Whiplash」는 개발자 22,000명의 실제 작업 기록 2년치를 분석해 AI 도입의 실효를 본 리포트다(faros.ai/research/ai-acceleration-whiplash). 결론은 한 줄이다 — 엔지니어링 처리량은 올라갔다. 그런데 버그와 장애와 재작업이 더 빨리 올라갔다. 해설자가 인용한 수치로는 개발자당 버그가 54%, 리뷰 없이 그냥 머지되는 PR이 31% 늘었다. (뒤에 발표 슬라이드로 다시 나오는 **+31.3%**와 같은 숫자다.)
그래서 생기는 질문이 이 영상의 출발점이다. 에이전트에게 맡기기 시작하면 PR이 쏟아진다. 이걸 다 읽어야 하나? 어차피 테스트는 통과했는데?
이 질문에 정면으로 답한 발표가 AI Engineer 무대에 올라왔다. 발표자는 코드 리뷰를 3개월 동안 실제로 없애봤고 다시 되돌린 사람이다.
[00:29] 2. (발표) 다들 루프를 짜는 중이고, 다들 프로덕션으로 달려가는 중이다
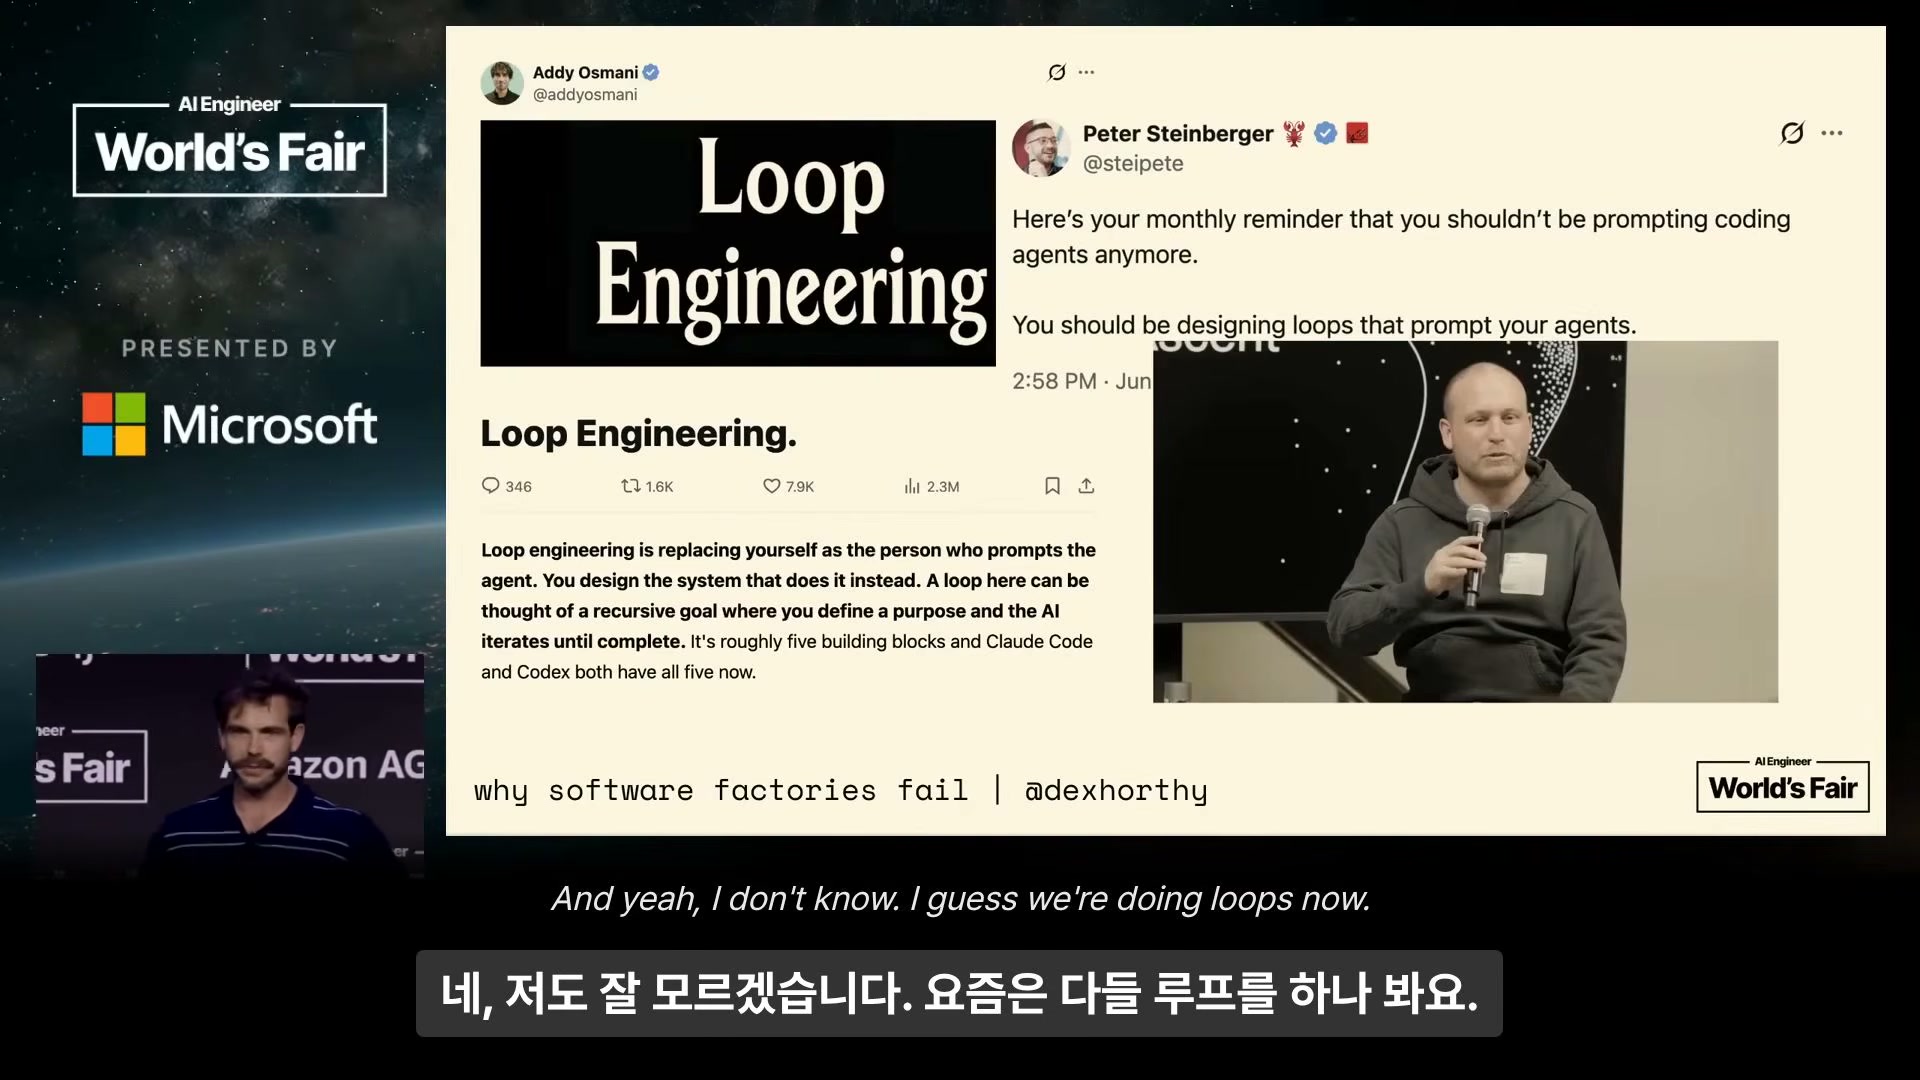
발표는 지금의 분위기를 먼저 보여준다. 다들 AI 코딩을 프로덕션에 넣으려 달려가는 중이고, 루프 엔지니어링 이야기가 넘친다 — 화면의 인용은 “에이전트에게 프롬프트를 넣지 말고, 에이전트를 프롬프트하는 루프를 설계하라”는 Peter Steinberger의 글이다. StrongDM은 아무도 코드를 읽지 않는 lights-out 소프트웨어 공장을 만들었다. 지배적인 서사는 이렇다: 당신이 병목이다. 모델은 충분히 좋다. 코드는 공짜다. 더 많이 배포해라.
[00:59] 3. (발표) 그런데 균열이 보이기 시작했다
AI Engineer Europe의 마리오는 “속도를 늦춰달라”고 호소했다. 코딩 에이전트 실수 때문에 장애를 겪을 리 없던 회사들이 장애를 겪고 있어서다. 코드베이스는 그 어느 때보다 빠르게 무너지고 있다.
Faros의 슬라이드가 이걸 수치로 못 박는다. 높은 AI 도입률이 머지 전 코드 품질에 미친 영향은 PR당 리뷰 코멘트 +25%, 코멘트 길이 +22.7%, 리뷰를 통째로 건너뛴 PR +31.3%. 텔레메트리는 팀 4,000개, 개발자 22,000명 규모다. 사건 발생 건수와 개발자당 버그도 함께 급증했다.
[01:39] 4. (발표) “당신이 잘못 잡고 있다”는 말로는 안 풀린다
이쯤에서 나오는 반응은 늘 같다 — “you’re holding it wrong”(당신이 잘못 잡고 있다). 토큰 맥싱이 안 되면 실력 문제다, 토큰을 더 써라, 코드 읽는 걸 놓아라, 하네스를 충분히 엔지니어링하고 PR 봇에 “adversarial review” 같은 마법의 단어를 뿌리면 두 마리 토끼를 다 잡는다 — 10~100배 빠르고, 품질도 좋고, 아무도 싫어하는 코드 리뷰를 할 필요가 없다.
발표자 본인이 그 “잘 잡는 법”을 가장 많이 이야기해온 사람이다(여러 발표 합쳐 유튜브 조회수 백만 회 이상). 그런 사람이 무대에서 하는 말이 이거다. 이건 실력 문제가 아니다. 하네스 엔지니어링을 아무리 하고 루프를 아무리 늘려도, 근본적으로 모델 학습의 문제라서 풀리지 않는다. 그래서 “하네스만으로는 부족하다”고 말하는 것이다.
[02:38] 5. (해설) 소프트웨어 공장에서 바뀌는 건 딱 한 칸
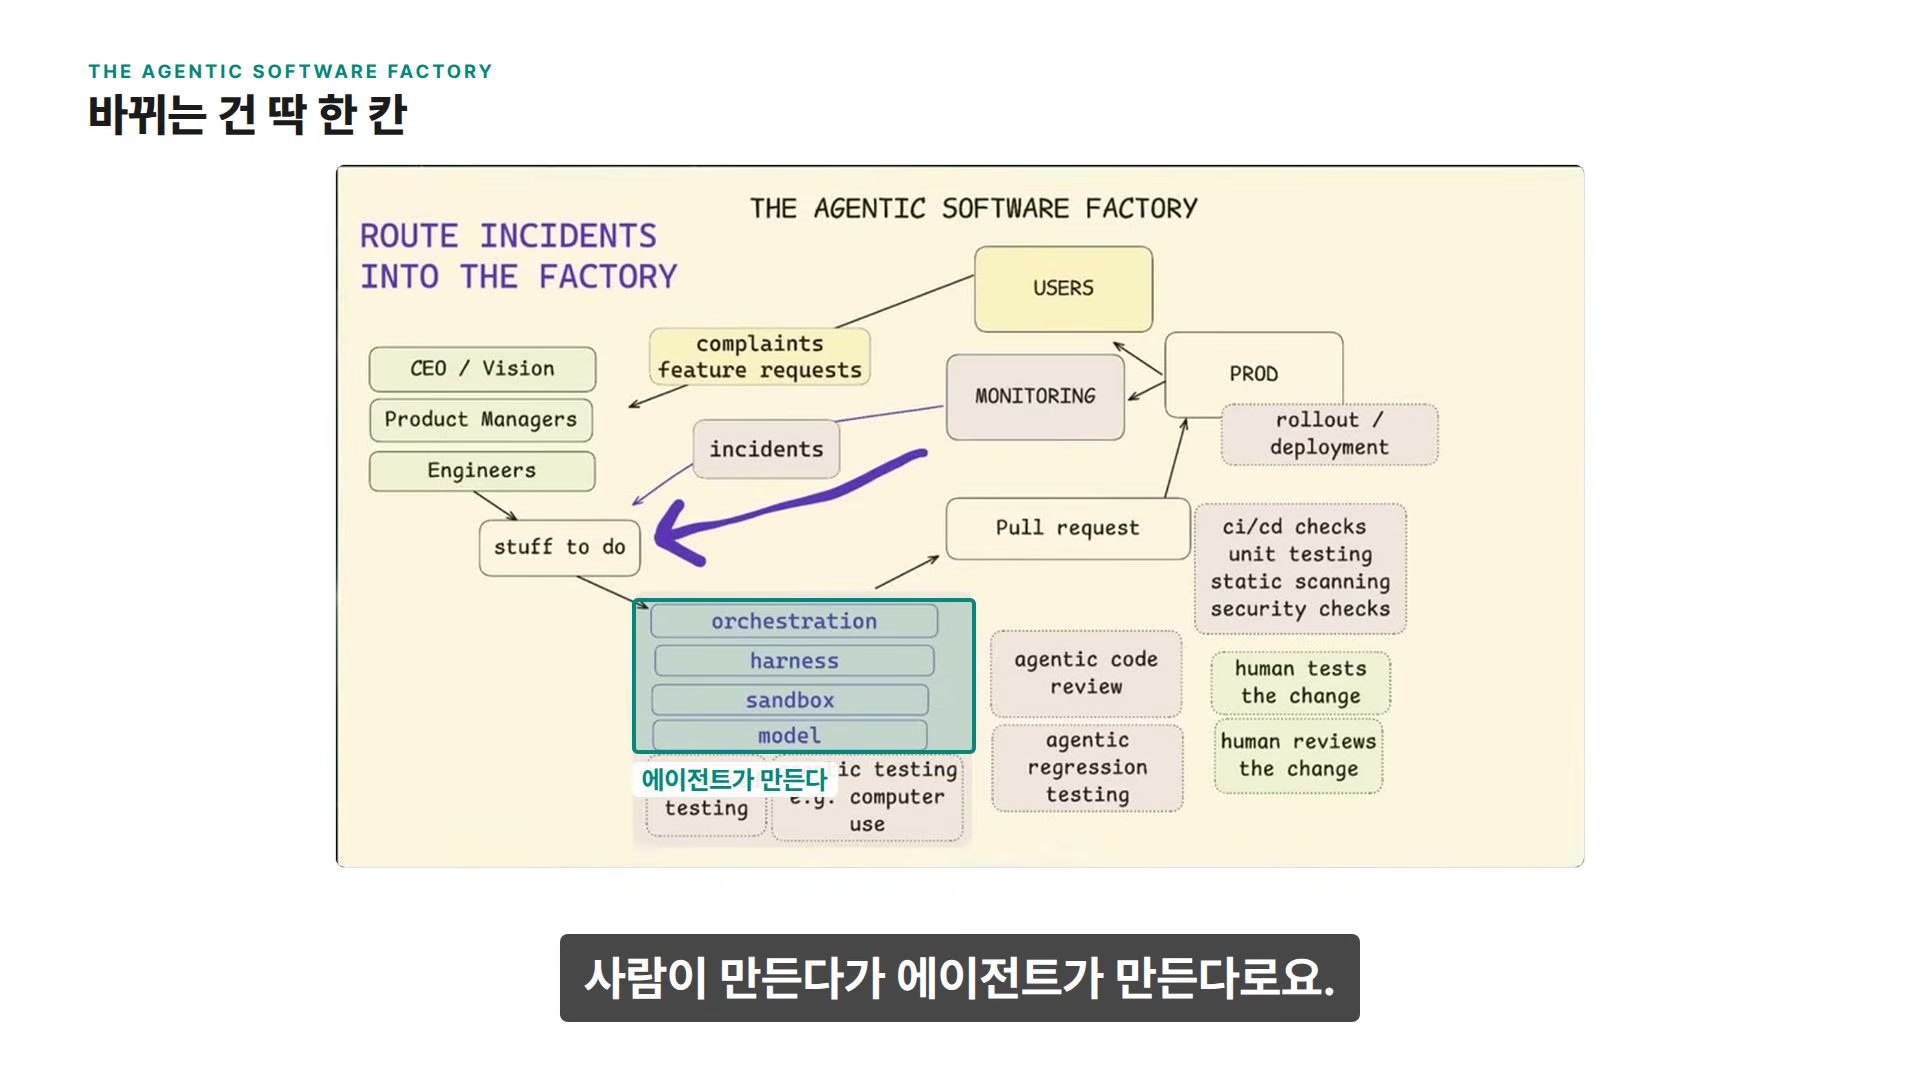
해설이 “소프트웨어 공장”이라는 용어를 풀어준다. 1968년 NATO 학회에서 정의된 말인데, 2022년 버전은 이렇게 생겼다 — 사람이 만들고 → PR 올리고 → 사람이 리뷰하고 → 프로덕션에 나가고 → 유저가 불평하면 다시 돌아오는 고리.
여기서 딱 한 칸이 바뀐다. “사람이 만든다”가 “에이전트가 만든다”로. 만드는 데 걸리던 며칠이 몇 분이 되는데 리뷰는 그대로 며칠이다. 그래서 리뷰도 에이전트에게 넘기고, 회귀 테스트도 넘기고, 장애도 유저 요청도 전부 공장으로 밀어 넣게 된다. 그러고 나면 마지막 한 칸이 남는다.
[03:08] 6. (발표) 불 끄고 돌리는 공장, 그리고 그게 실패하는 이유
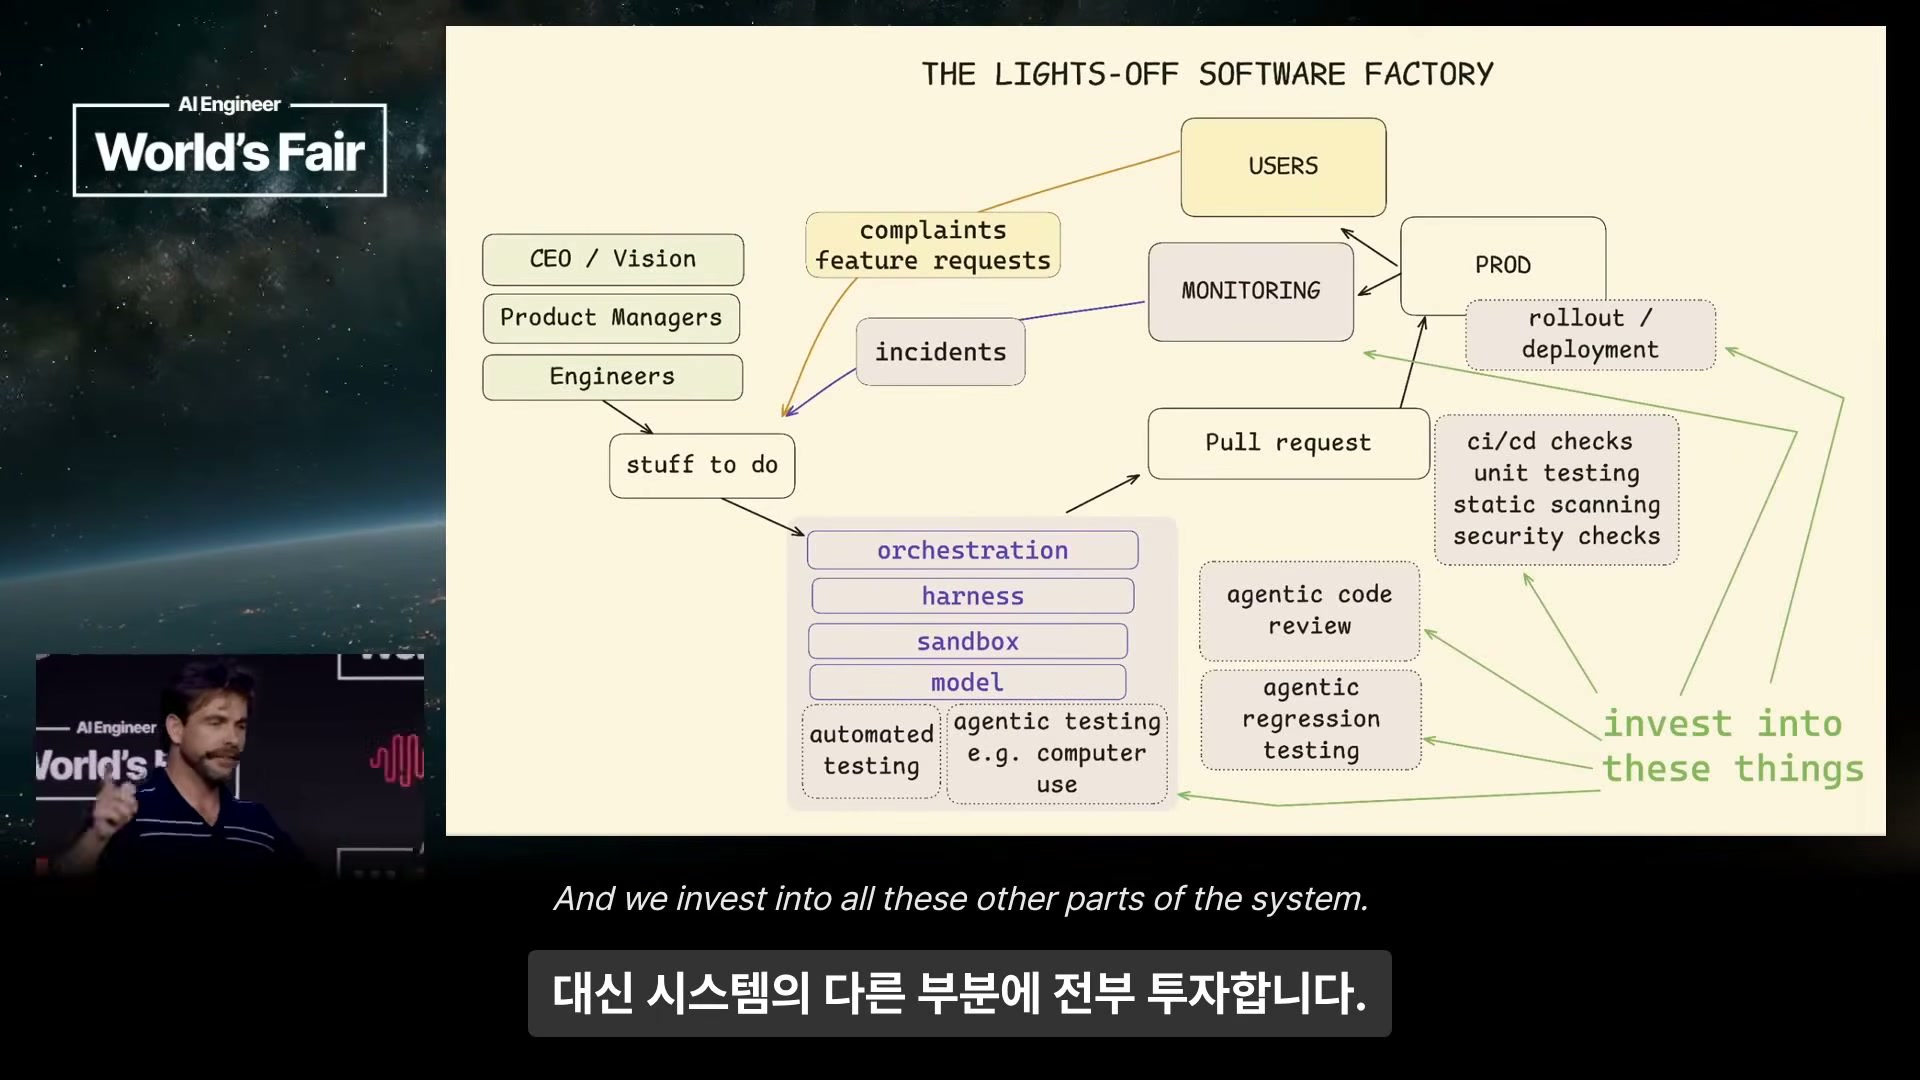
lights-off 소프트웨어 공장의 그림이다. “우리는 더 이상 코드를 읽지 않는다.” 코드 리뷰는 사양하고, 대신 시스템의 다른 모든 부분 — 테스트, 모니터링, 롤아웃 — 에 전부 투자한다. 그리고 나면 유일하게 남는 일은 “에이전트에게 얼마나 많은 걸 만들어 달라고 시킬 수 있는가” 뿐이다.
발표자의 주장은 이것이 작동하지 않는다는 것이고, 이것이 소프트웨어 공장이 실패하는 이유다.
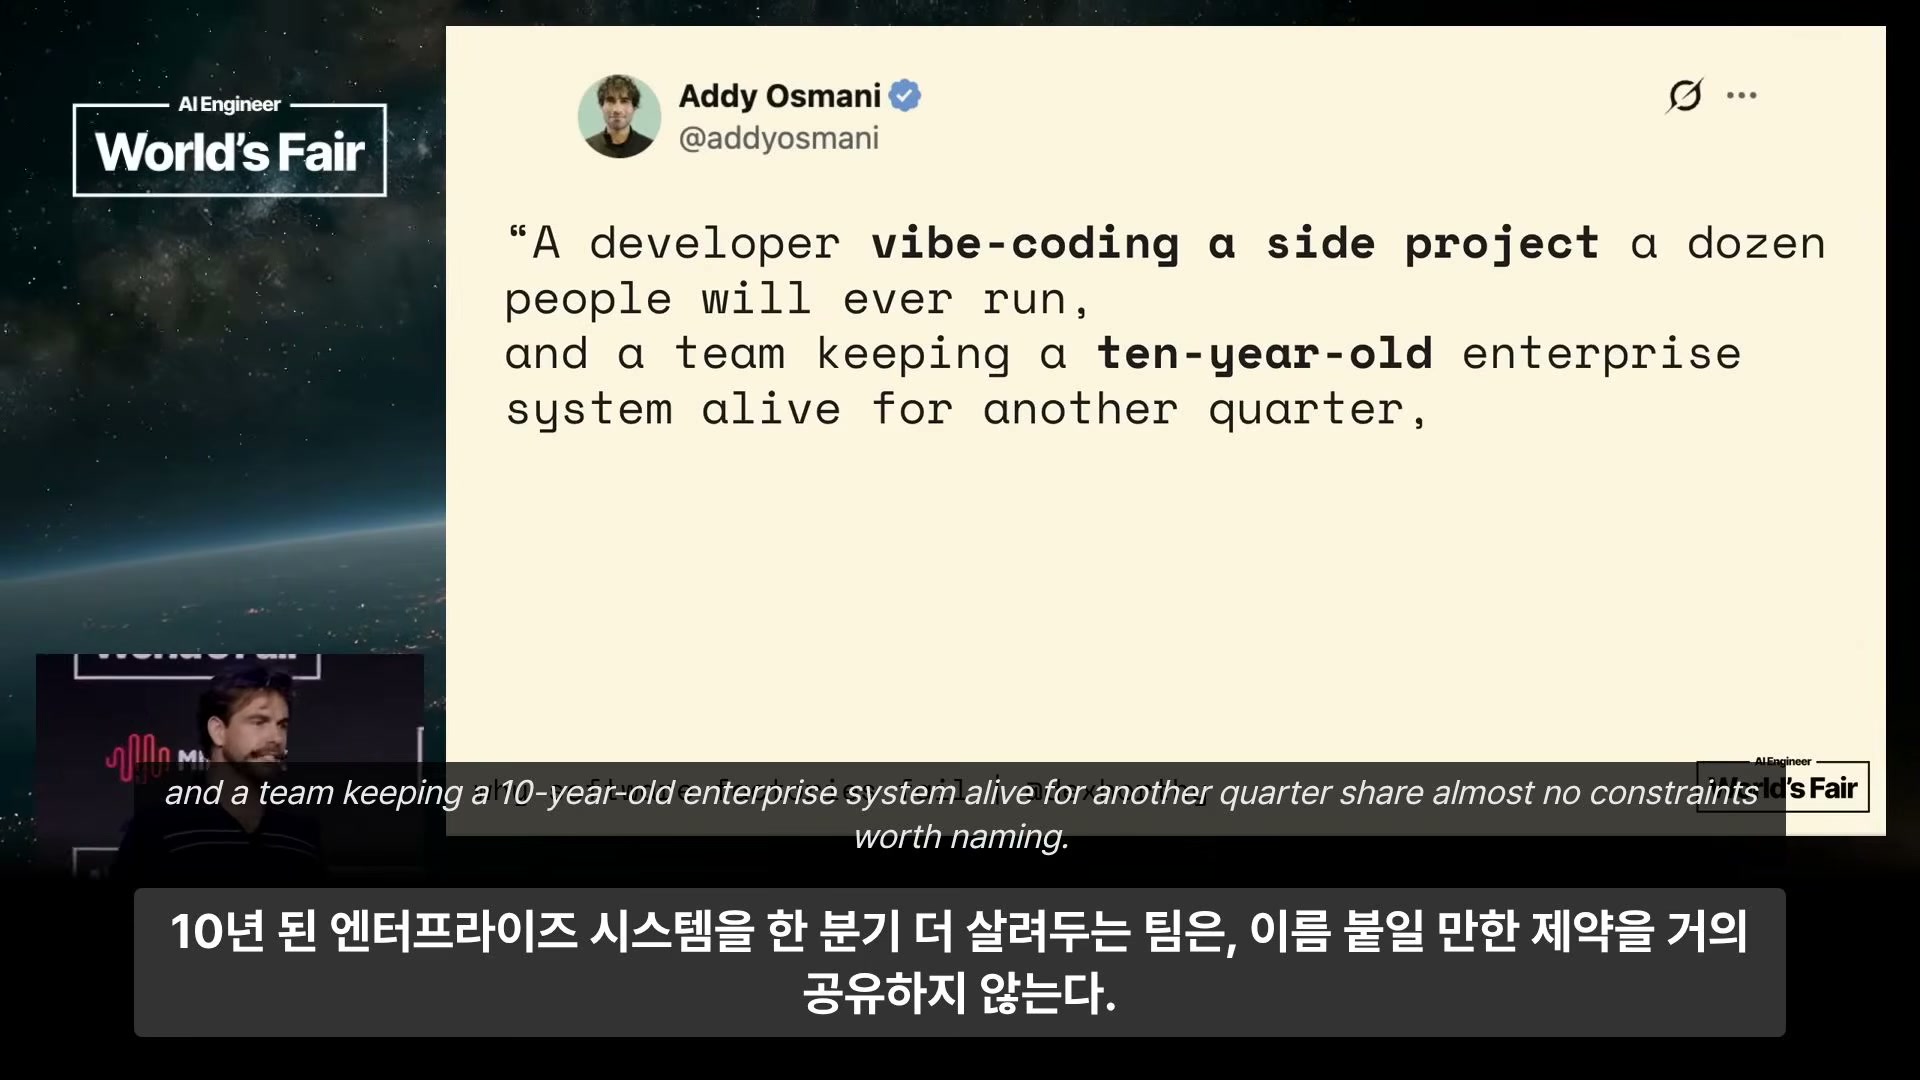
본론 전에 하나 짚고 간다. Addy Osmani의 글을 그대로 인용하는데, “열두 명이나 쓸 사이드 프로젝트를 바이브 코딩하는 개발자와, 10년 된 엔터프라이즈 시스템을 다음 분기까지 살려두는 팀은 이름 붙일 만한 제약 조건을 거의 공유하지 않는다.” 인터넷에서 들리는 이야기의 대부분은 이 두 집단 중 한쪽이 다른 쪽에게 사는 법을 가르치는 것이다. 그러니 바이브 코딩이 좋다면 그대로 하면 된다 — 이 발표는 복잡한 코드베이스에서 어려운 문제를 푸는 쪽을 향한다.
HumanLayer가 쓰는 단어는 “브라운필드”인데, 역사적으로는 10년 된 자바 공장 같은 걸 뜻했다. 발표자 생각에는 지금의 배포 속도라면 에이전트가 만든 코드베이스도 3~6개월이면 그 상태가 된다.
[04:33] 7. (발표) 우리도 해봤다 — 2025년 7월, 불을 껐고, 되돌렸다
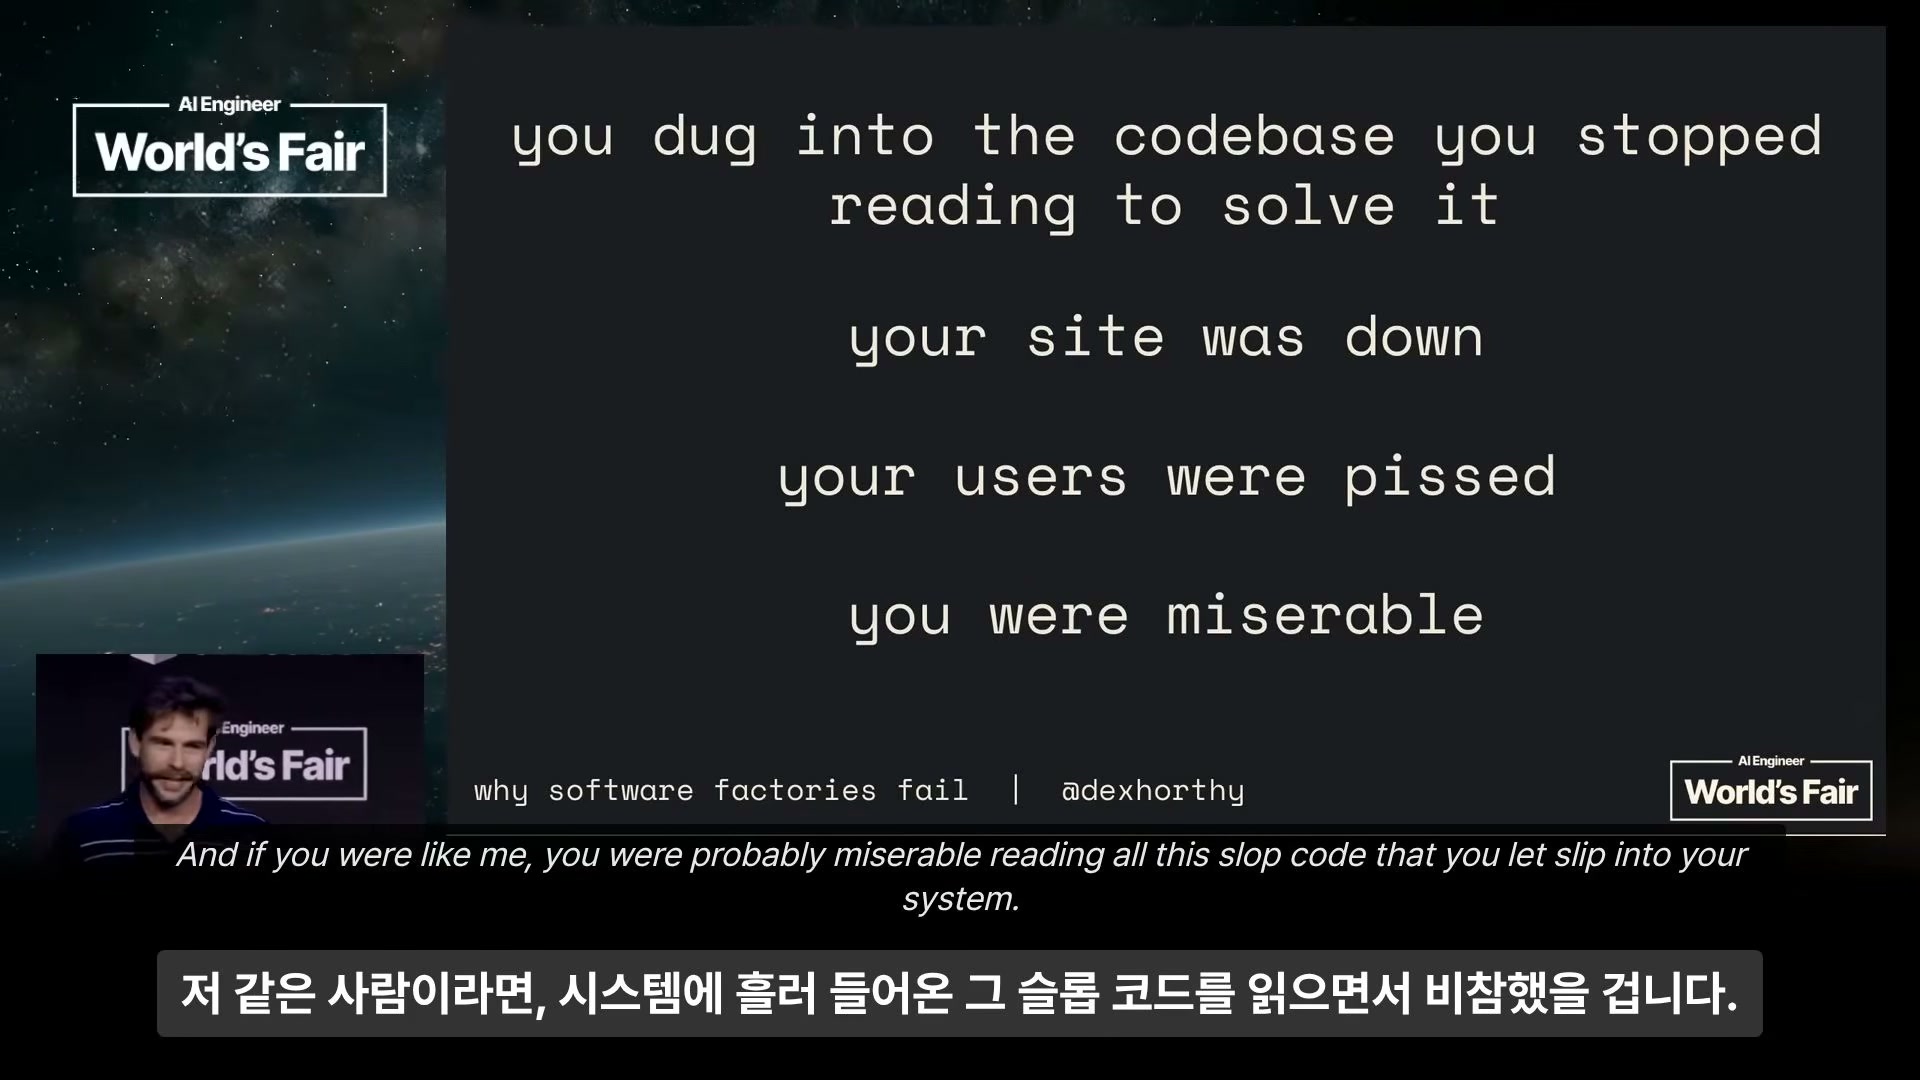
“어떻게 아느냐”에 대한 답이 이 발표의 신뢰를 만든다. 2025년 7월에 HumanLayer가 직접 해봤다. 완전히 불을 껐다.
몇 달 진지하게 해봤다면 에이전트가 못 푸는 이슈를 최소 하나는 만난다. 아무리 최첨단 프롬프트를 써도 결국 직접 조사하고, 재현하고, 3개월 전에 읽기를 그만둔 그 코드베이스로 들어가 뭐가 망가졌는지 파헤쳐야 한다. 그러는 동안 사이트는 다운돼 있고, 유저는 화가 나 있고, 자기 같은 사람이라면 시스템에 흘러 들어온 그 슬롭 코드를 읽으면서 비참했을 것이다.
핵심은 이거다. 모델에는 한계가 있다 — 상당한 수준의 사람 개입 없이는 시간이 지남에 따라 코드베이스 품질을 유지·개선하지 못한다.
[05:16] 8. (해설) 뿌리는 도구가 아니라 학습에 있다
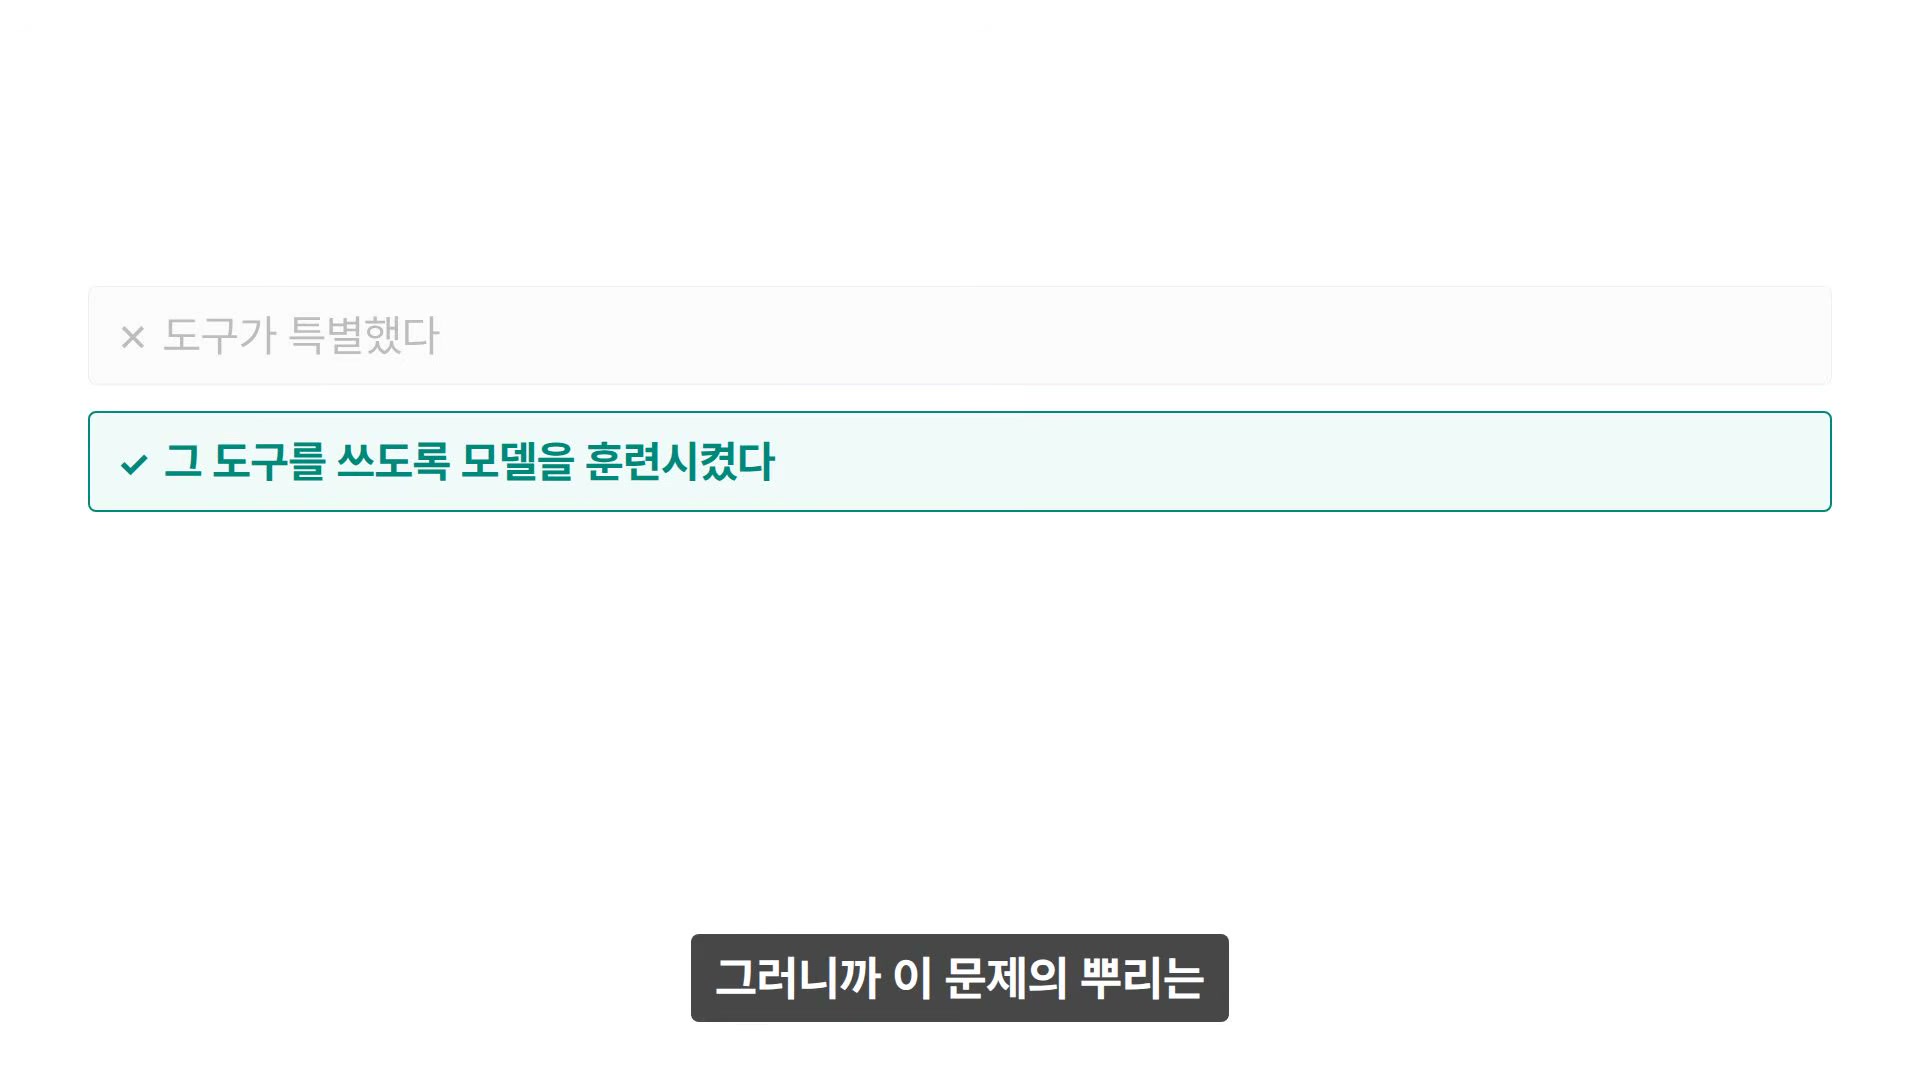
발표가 프롬프트 얘기를 접고 모델을 어떻게 학습시키는지로 들어가기 전에, 해설이 다리를 놓는다. 출발점은 클로드 코드다 — 공개 1년 만에 연 환산 매출이 35억 달러 근처까지 갔다. 그런데 그 전에도 터미널에서 도는 코딩 도구는 많았다. 읽고, 쓰고, 고치고, 검색하고 — 도구 목록은 거의 똑같았다.
차이는 하나였다. 모델을 만드는 곳이 자기가 배포할 도구 환경에 맞춰 직접 모델을 학습시킨 첫 사례였다는 것. 도구가 특별했던 게 아니라 그 도구를 쓰도록 모델을 훈련시킨 것이다. 그러니 이 문제의 뿌리도 도구가 아니라 학습 안에 있다.
[05:48] 9. (발표) 60초 만에 보는 코딩 에이전트 강화학습
Codex 초기 출시 때 MTS(Member of Technical Staff)였던 Calvin French-Owen의 슬라이드를 빌려 시작한다. LLM은 결국 다음 토큰 예측기다 — 에이전트 루프를 도는 동안 컨텍스트 윈도가 들어가고 다음 단계가 나온다.
모델이 도구 호출을 더 잘하고 소프트웨어 문제를 더 잘 풀게 하려면: 문제를 주고 → 여러 방식으로 풀게 해 트레이스를 잔뜩 만들고 → 정확성·테스트 통과 여부로 점수를 매기고 → 나쁜 행동의 확률을 낮추고 좋은 행동의 확률을 높이도록 가중치를 갱신한다.
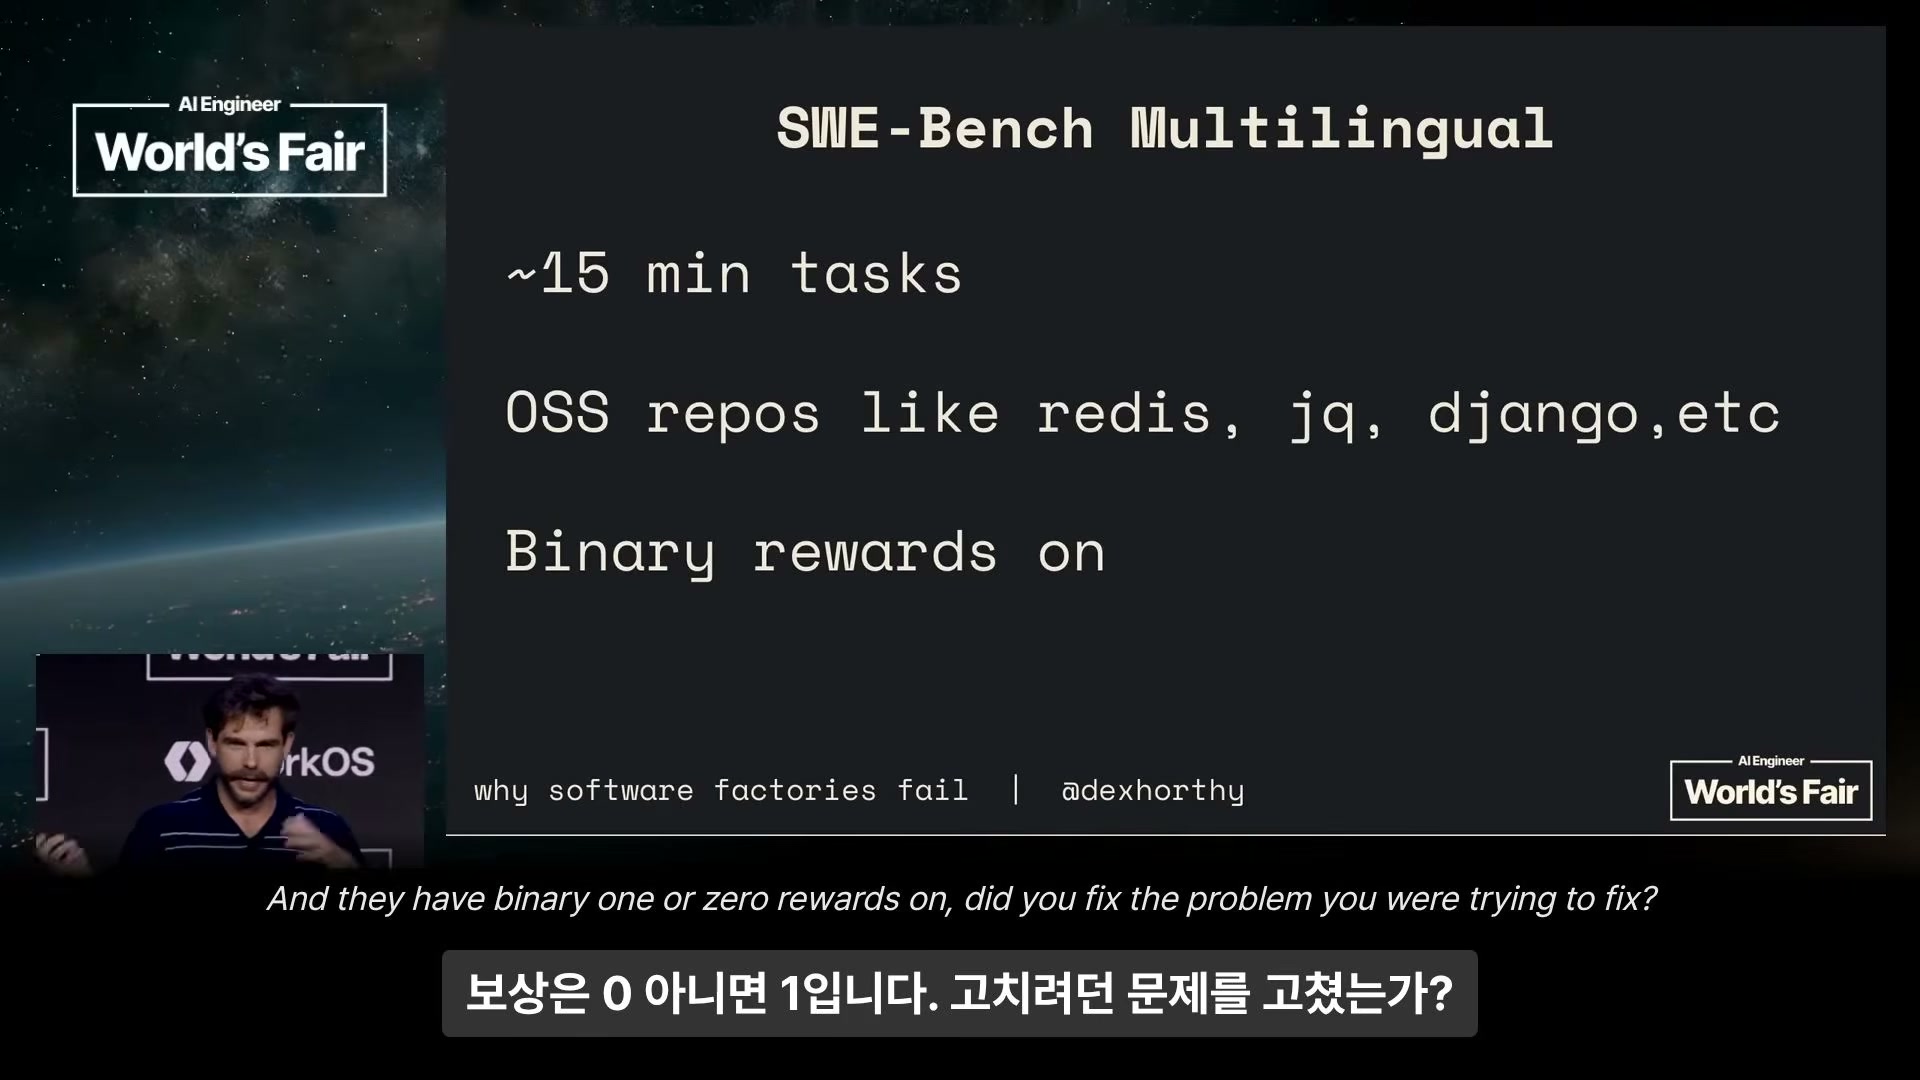
대표적인 벤치마크가 SWE-Bench Multilingual이다. 약 15분짜리 과제들이고, redis·jq·django 같은 오픈소스 저장소에서 가져왔다. 보상은 0 아니면 1 — FAIL_TO_PASS와 PASS_TO_PASS, 즉 고치려던 문제를 고쳤는가, 그리고 다른 걸 깨뜨리지 않고 그렇게 했는가.
실제 문제 하나를 예로 든다. Ruby 프로젝트 fastlane에서 nil 체크를 안 해 널 포인터 예외가 나고 스택 트레이스가 터진 이슈다.
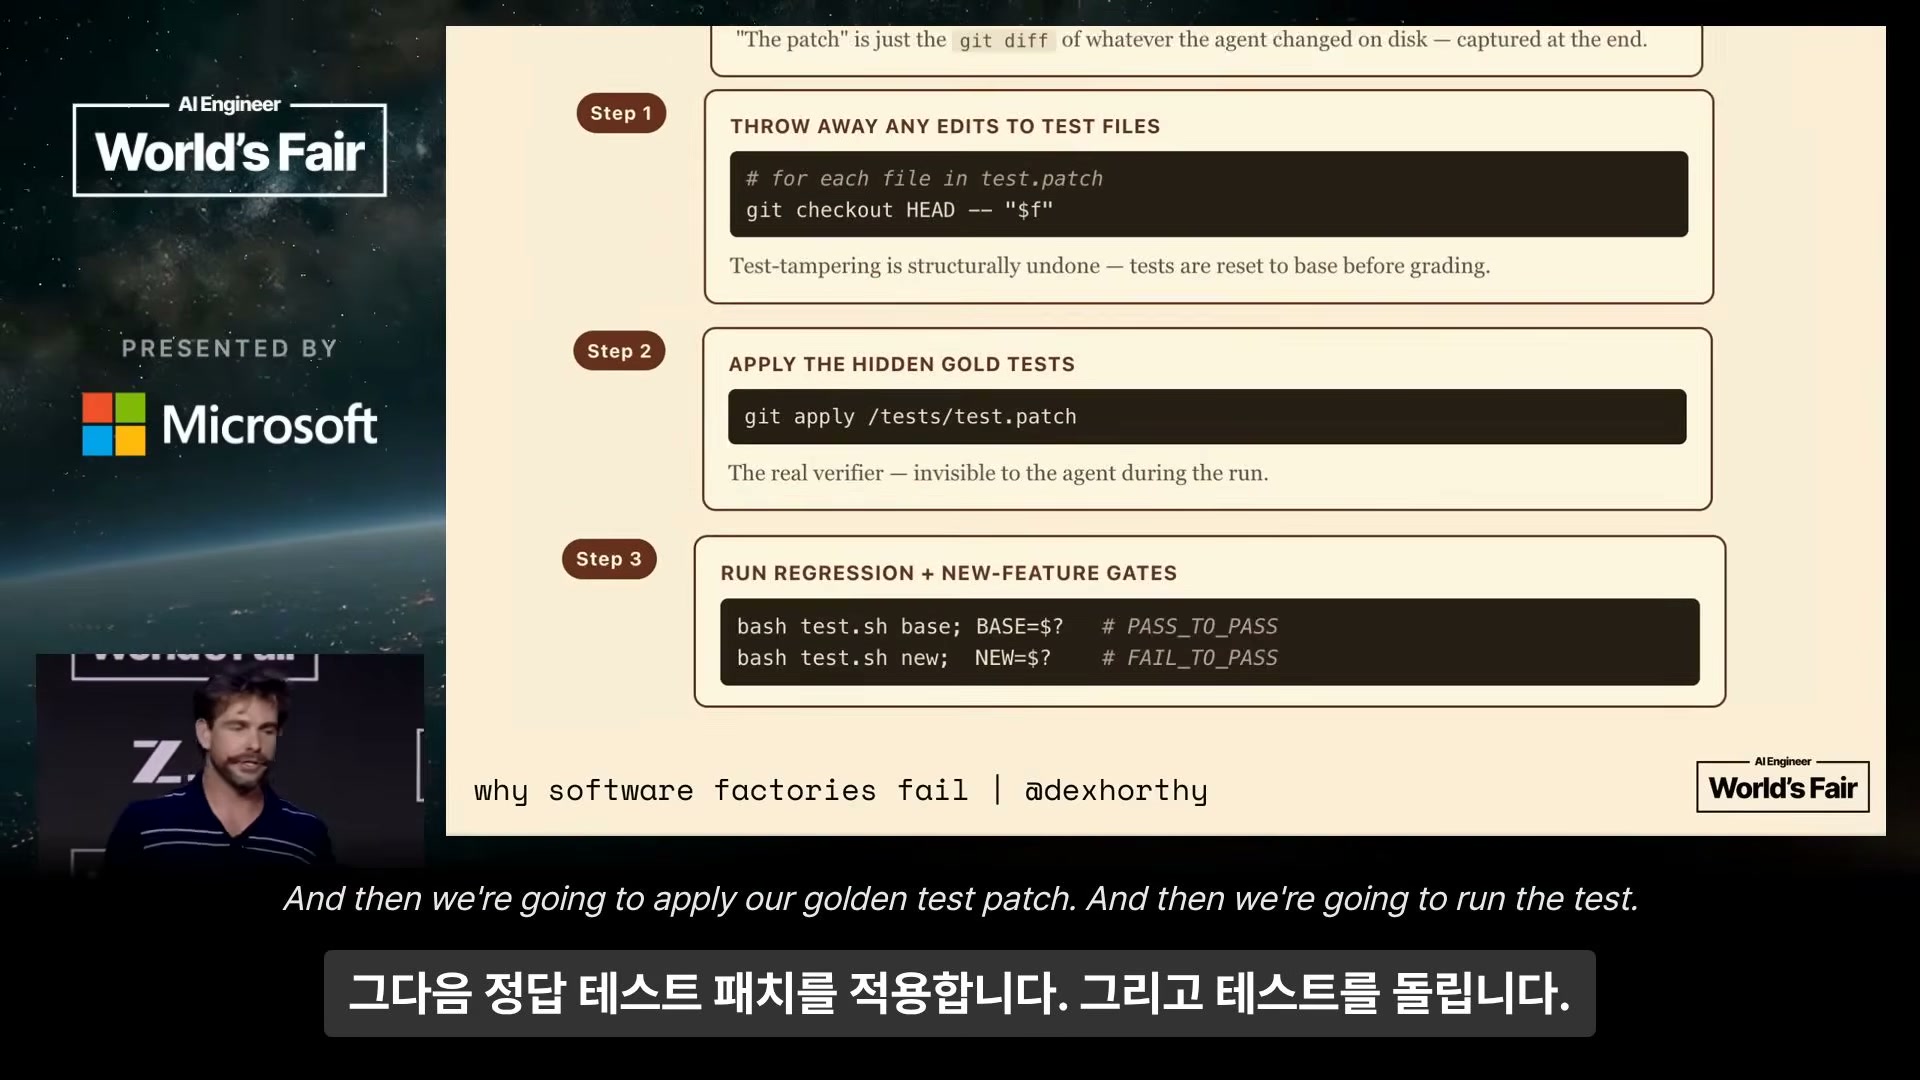
채점 파이프라인은 이렇게 돈다. 사람이 과거에 이슈를 해결하기 전의 base commit을 체크아웃하고, 이후 동작이 어때야 하는지 적은 test patch와 정답인 golden patch를 준비한다. 둘 다 모델에게는 숨긴다. 에이전트가 문제를 풀면 그 패치를 저장하고 — 테스트 파일에 가한 변경은 전부 되돌린다. 모델이 그냥 통과시키려고 테스트를 주석 처리하는 걸 다들 봤기 때문이다. 그다음 골든 테스트 패치를 적용하고 기존 테스트와 새 테스트를 돌린다. 둘 다 통과하면 보상, 아니면 없음.
[07:30] 10. (발표) 그래서 나오는 것들 — 벌점 줄 자리가 없다
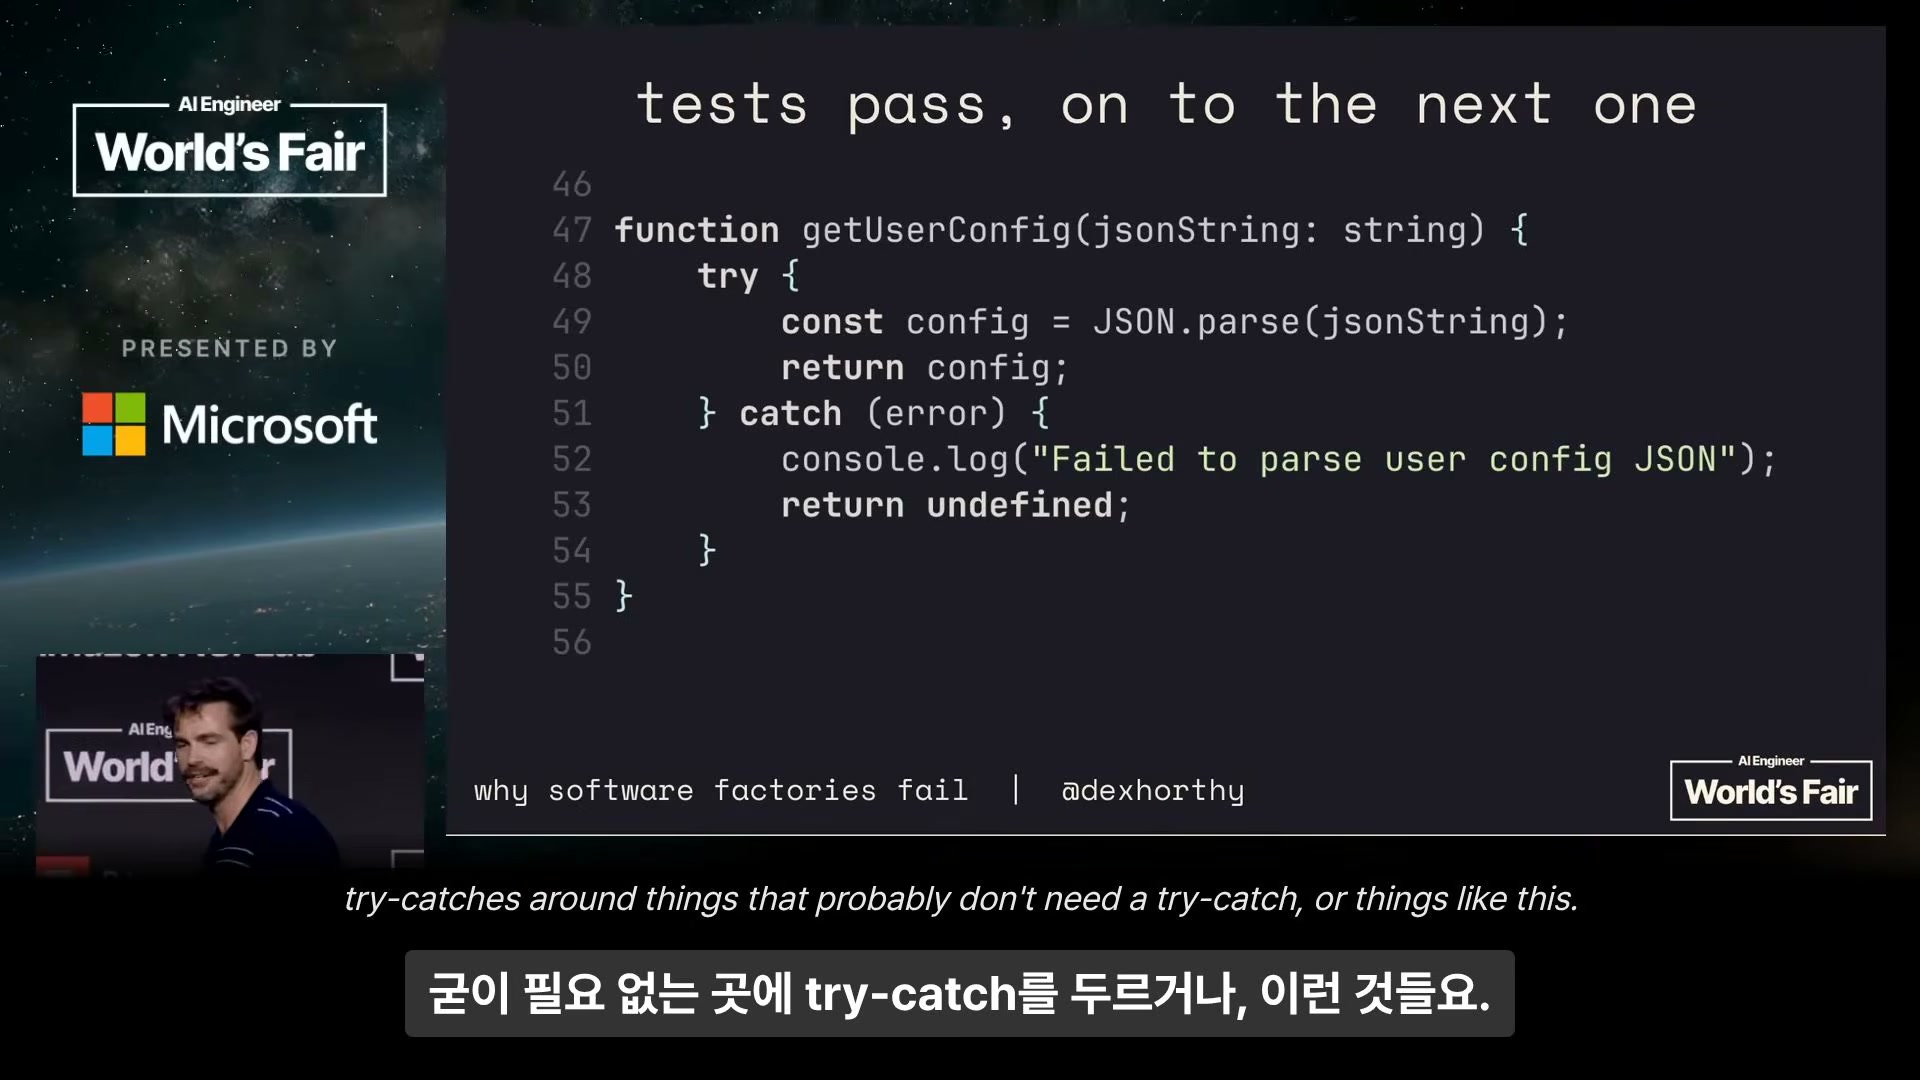
모델은 테스트를 통과시키려고 노력한다. 그리고 이 시스템에는 부실한 프로그램 설계나 유지보수성 훼손에 벌점을 줄 방법이 없다.
그래서 이런 게 나온다 — 굳이 필요 없는 곳에 두른 try/catch(화면의 getUserConfig는 파싱 실패를 삼키고 undefined를 반환한다), 혹은 테스트를 통과시키려고 객체를 다른 객체로 캐스팅하는 것.
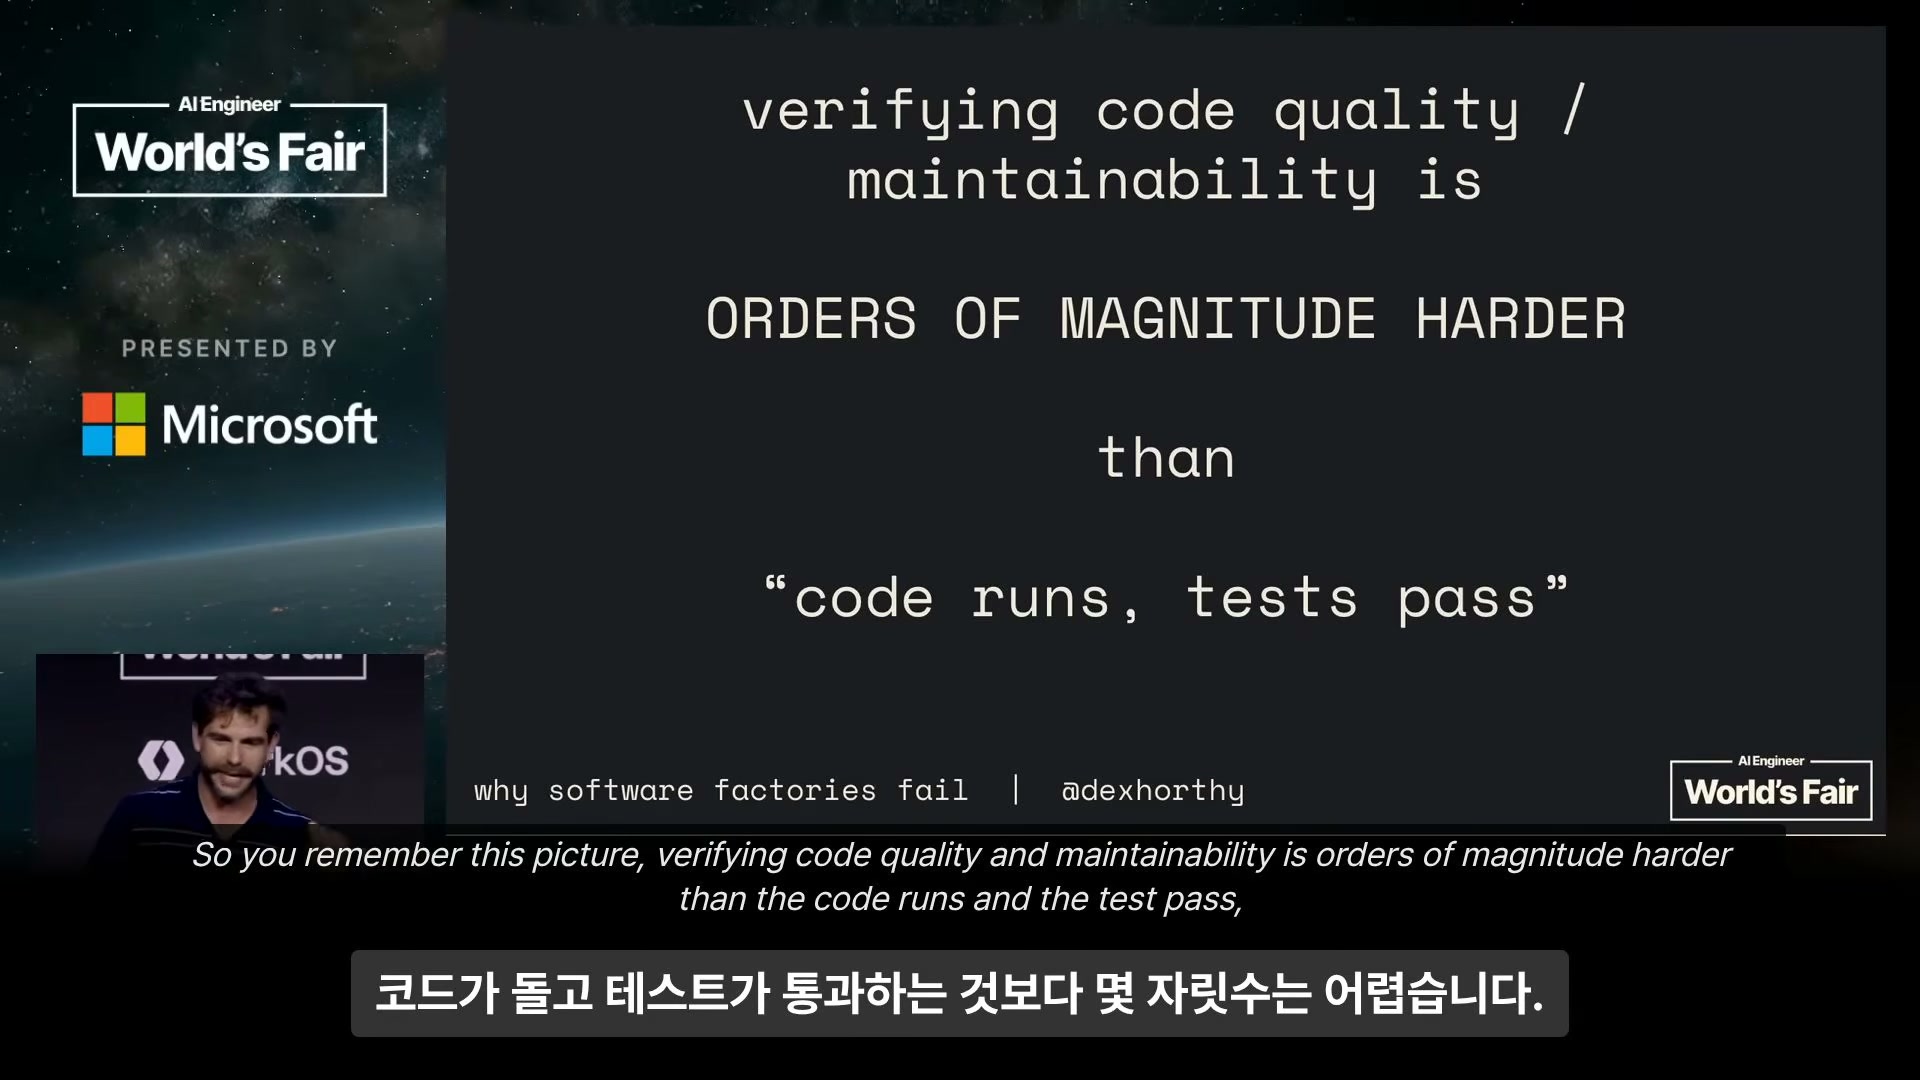
코드의 유지보수성을 검증할 수 없으면 그걸로 학습시키는 건 훨씬 어려워진다. 그리고 품질·유지보수성 검증은 “코드가 돌고 테스트가 통과한다”보다 몇 자릿수(orders of magnitude) 더 어렵다. 이유는 명확하다 — 나쁜 아키텍처의 비용 함수는 개월·연 단위로 측정되기 때문이다. 코딩 한 번을 해놓고, 누군가 너무 과하게 바이브 코딩했다는 걸 몇 달 뒤에야 알게 되는 식이다.
[08:15] 11. (해설) “채점표를 더 잘 만들면 되잖아요”
여기서 당연히 드는 생각을 해설이 대신 꺼낸다. 그럼 채점표를 더 잘 만들면 되잖아요. 실제로 그 방향으로 가고 있고 발표도 그걸 인정한다 — 화면의 슬라이드도 “벤치마크 구조는 방향은 맞다(directionally correct)“고 적고 있다. 그런데 거기에 빠져나갈 수 없는 고리가 하나 있다.
[08:26] 12. (발표) 새로운 프런티어 벤치마크들, 그리고 심사 모델의 한계
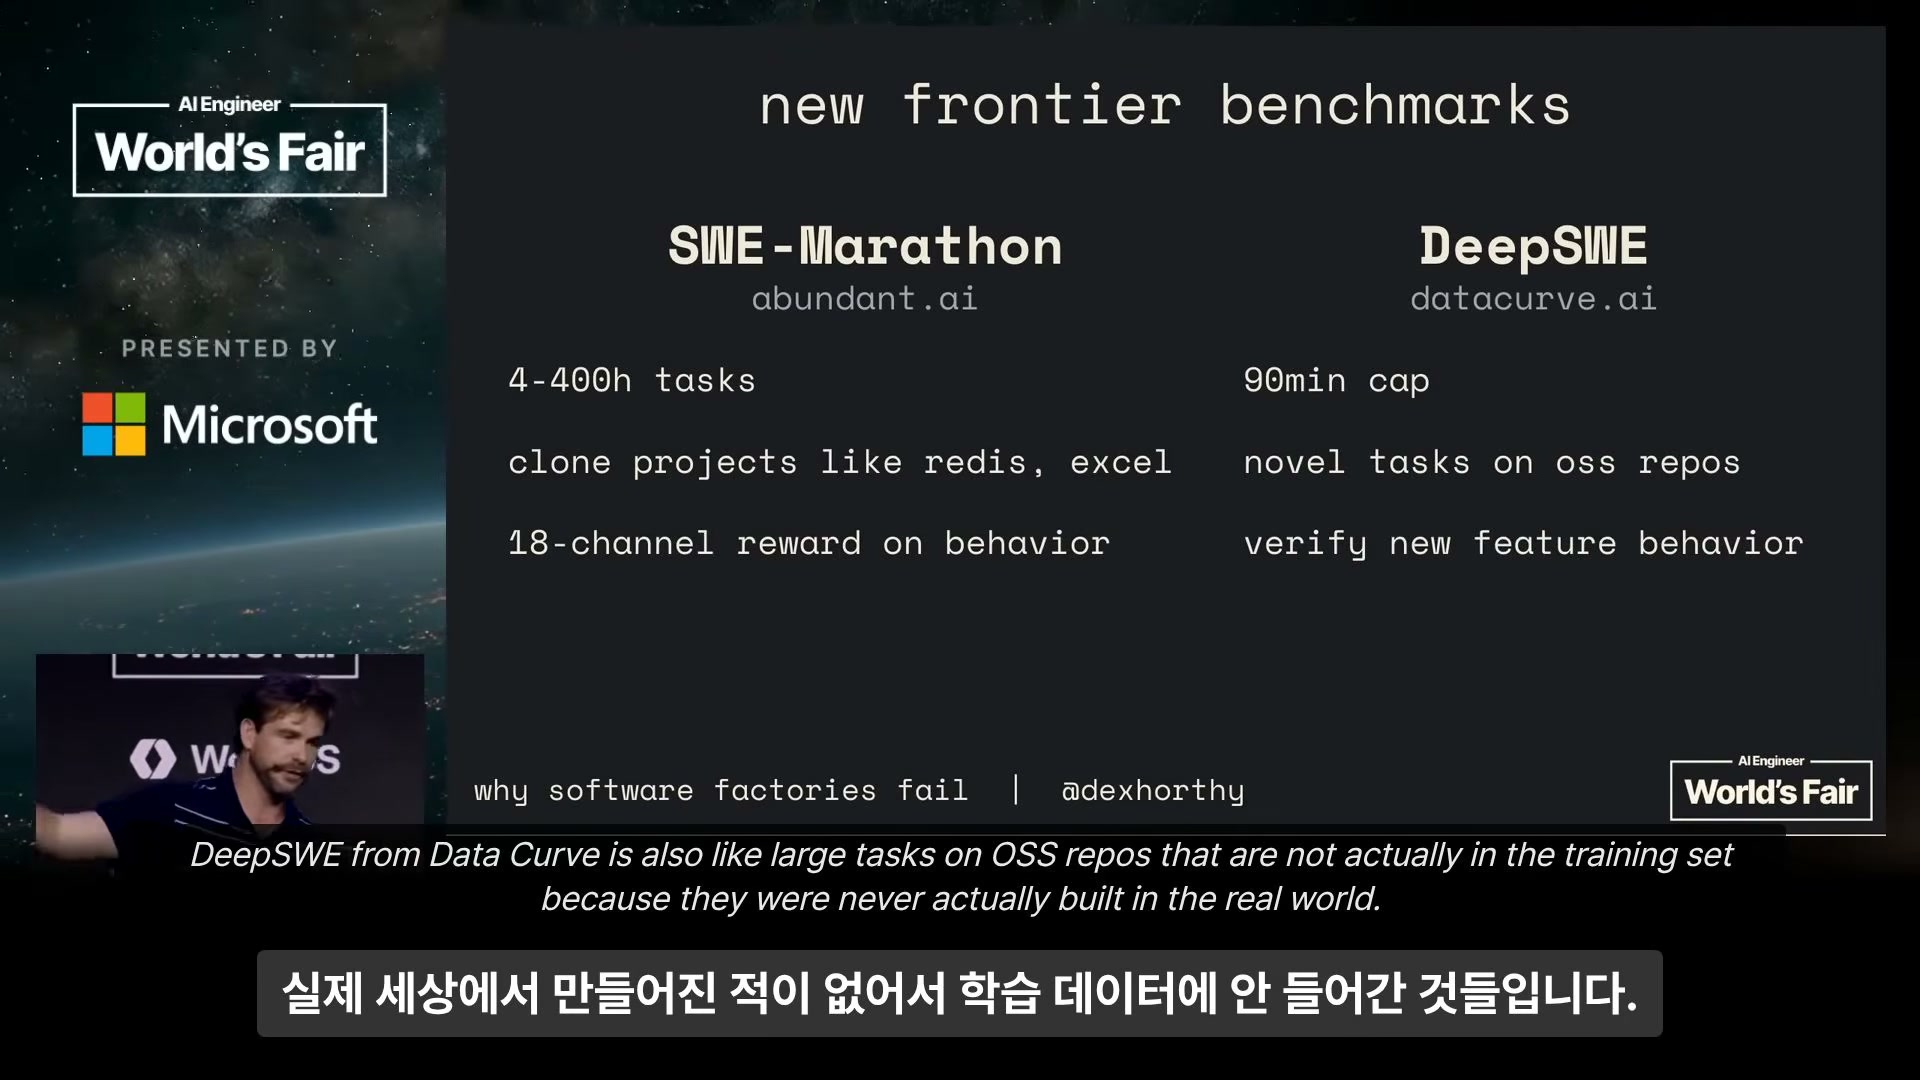
유지보수성 평가의 미래로 세 가지를 든다.
- SWE-Marathon (abundant.ai) — 4~400시간짜리 과제. “마이크로소프트 엑셀의 모든 기능을 복제하라” 같은 규모이고, 18개 채널의 행동 기반 보상이라는 정교한 보상 체계를 쓴다.
- DeepSWE (datacurve.ai) — 90분 상한, OSS 저장소의 큰 과제인데 실제 세상에서 만들어진 적이 없어 학습 데이터에 안 들어간 것들이다. 새 기능의 동작을 검증한다.
- Frontier Code (Cognition) — 다중 PR 과제. 흥미로운 장치가 있는데, 모델이 패치 전 코드에서 실패하지 않는 테스트를 쓰면 벌점을 준다. 그리고 “이 코드가 우리 코드 품질 규칙을 다 지켰나”를 묻는 심사(judge) 모델이 붙는다.
점점 나아지고는 있다. 하지만 품질을 판단하는 모델에는 한계가 있다. 이게 해설이 예고한 그 고리다 — 모델이 좋은 코드가 뭔지 알았다면, 애초에 그렇게 썼을 것이기 때문이다. 리뷰 에이전트를 붙이고 토큰을 더 쏟으면 최저 성능(floor)은 올릴 수 있지만, 강화학습에서 가르칠 수 있는 것에 여전히 갇혀 있다.
결론은 이렇다. 지금으로서는 코드를 읽는 수밖에 없다. 물론 미래에 이 문제가 풀리는 세상도 있을 것이고, GPT-7이 나올 때까지 그냥 프롬프트만 계속 던지고 싶다면 그래도 된다. 하지만 발표자의 선택은 반대다 — “쓴 교훈(Bitter Lesson)이고 뭐고, 우리한텐 지금 풀어야 할 문제가 있으니까, 우리 힘으로 빠져나가 봅시다.” 스케일링이 언젠가 해결해줄 거라고 기다리는 대신, 지금 엔지니어링으로 우회하겠다는 선언이다.
[09:37] 13. (해설) 리뷰를 빠르게 하는 게 아니라, 읽기 쉬운 PR이 오게 만든다
해설이 방향을 한 문장으로 정리한다. 방법은 리뷰를 빠르게 하는 게 아니다. 읽기 쉬운 PR이 오게 만드는 것이다. 에이전트에게 일을 넘기기 전에 사람이 먼저 밟는 단계가 네 개 있다.
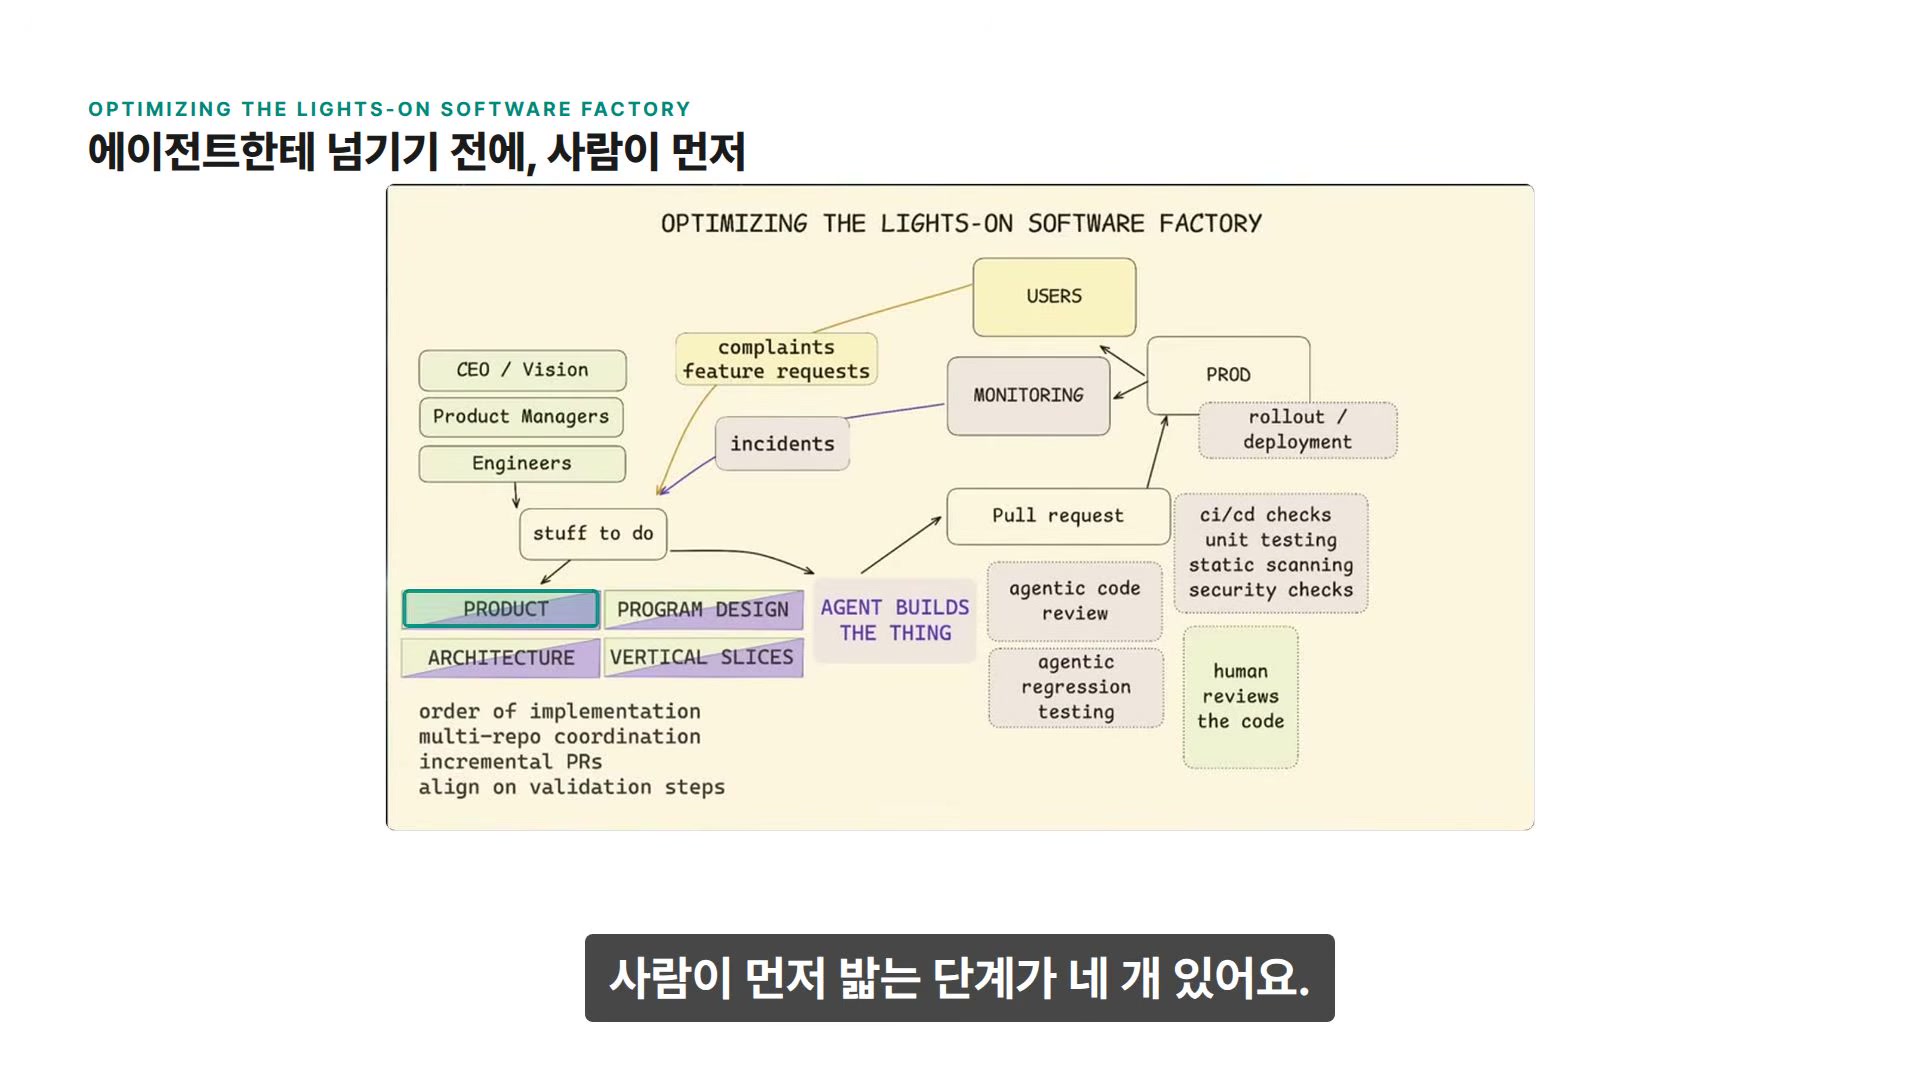
lights-on 소프트웨어 공장 그림에서 사람이 차지하는 자리가 앞으로 옮겨 붙는다 — PRODUCT → ARCHITECTURE → PROGRAM DESIGN → VERTICAL SLICES, 그리고 나서야 “AGENT BUILDS THE THING”이다.
[09:47] 14. (발표) 네 단계를 실제로 어떻게 밟는가
발표의 실무 파트다.
① 제품 리뷰 — 어떤 문제를 푸는지, 원하는 동작이 무엇인지 이해하고 필요하면 목업을 본다. (다만 사소한 일은 이 과정 없이 바로 에이전트에게 보낸다.)
② 시스템 아키텍처 — 컴포넌트 계약, 데이터 모델, 제약 조건. 많은 사람이 이미 오래전부터 해온 것이고, 시스템들이 어떻게 맞물리는지 큰 그림을 잡는 문서를 만든다.
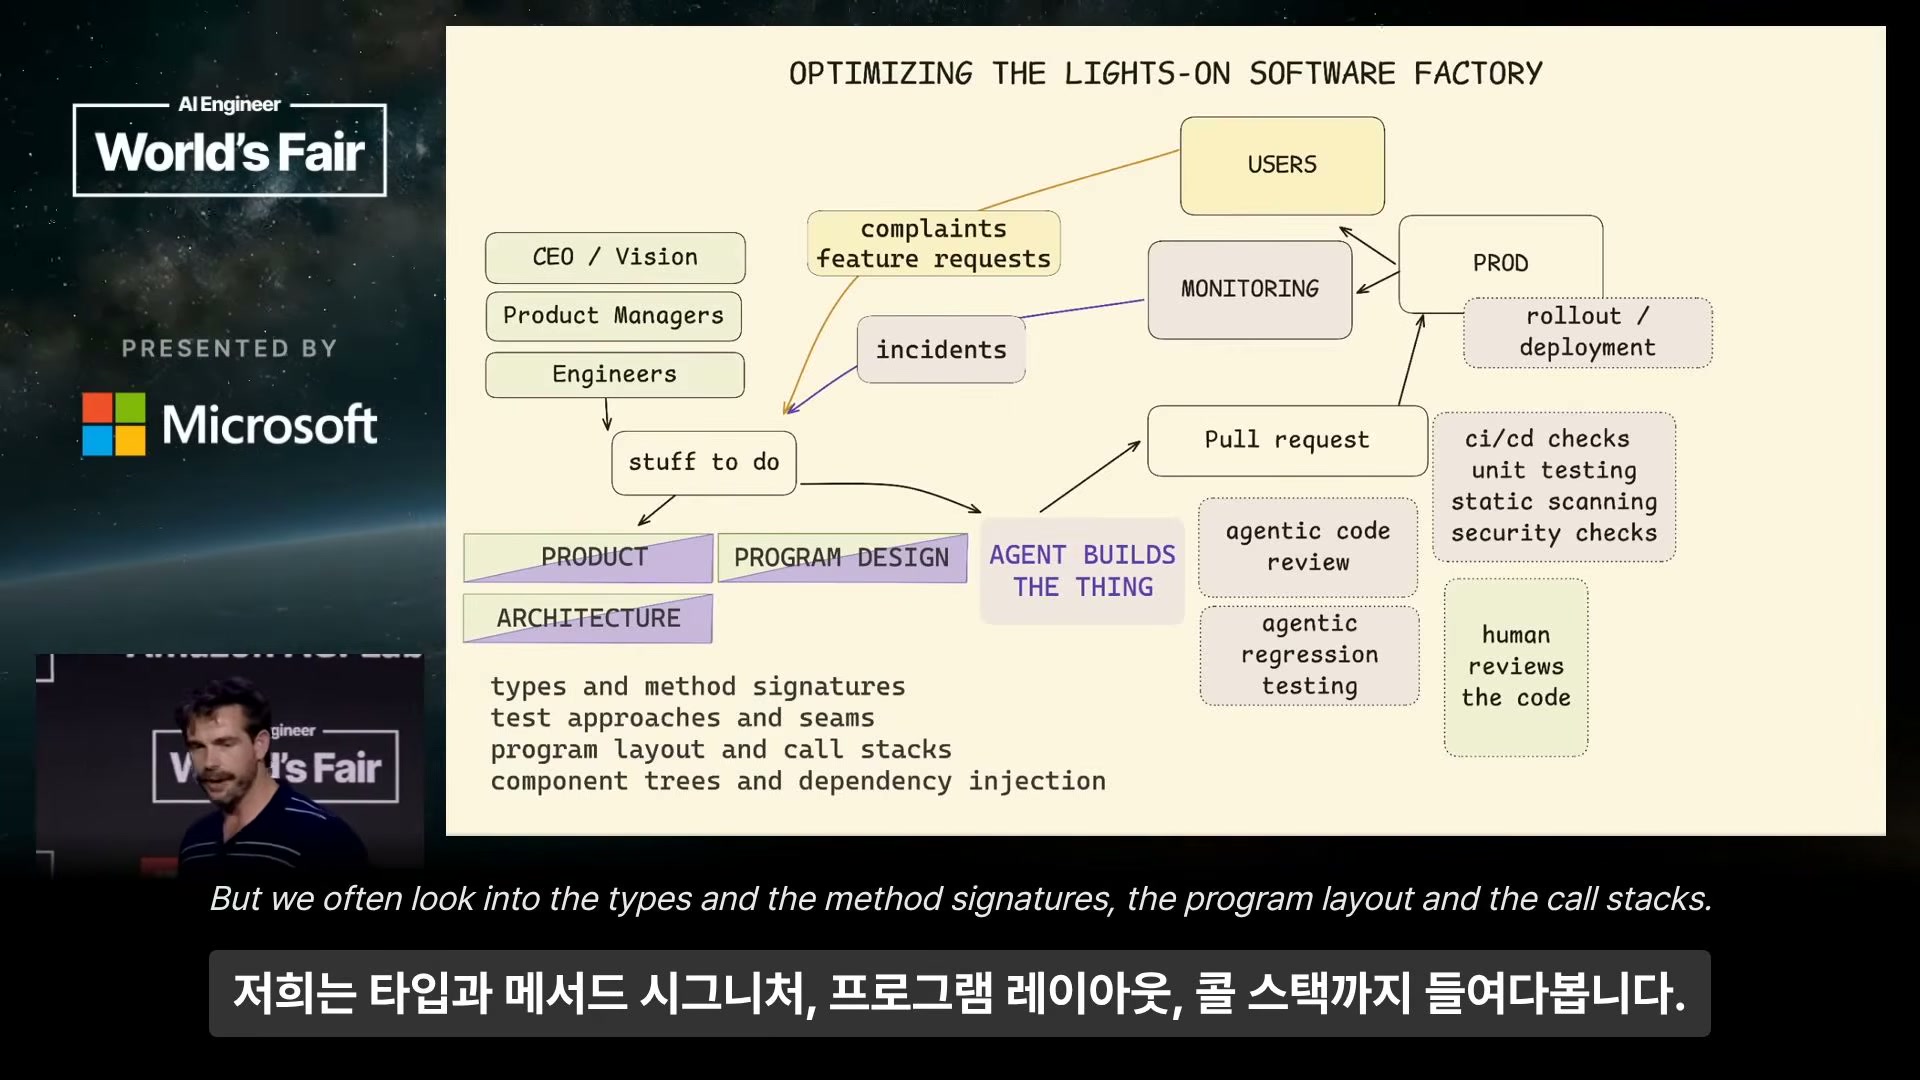
③ 프로그램 디자인 — 발표자가 요즘 에이전트 코딩에서 가장 과소평가된다고 보는 단계다. 사람들은 아키텍처만 제대로 잡으면 모델이 알아서 잘할 거라 생각하는데, HumanLayer는 타입과 메서드 시그니처, 테스트 접근과 이음새(seams), 프로그램 레이아웃과 콜 스택, 컴포넌트 트리와 의존성 주입까지 들여다본다. Cloudflare의 Dillon Mulroy도 계획 수립에 콜 그래프를 쓰는 이야기를 자주 하는데, 발표자는 그게 정확히 맞다고 본다.
④ 버티컬 슬라이스 — 구현 순서, 멀티 레포 조율, 전체 시스템에 걸쳐 어떻게 지어 올릴지, 그리고 그 과정에서 어떻게 점검할지. (모델이 만드는 계획이 왜 “수평적”인지에 대한 이야기는 AI Engineer Miami 발표로 넘긴다.)
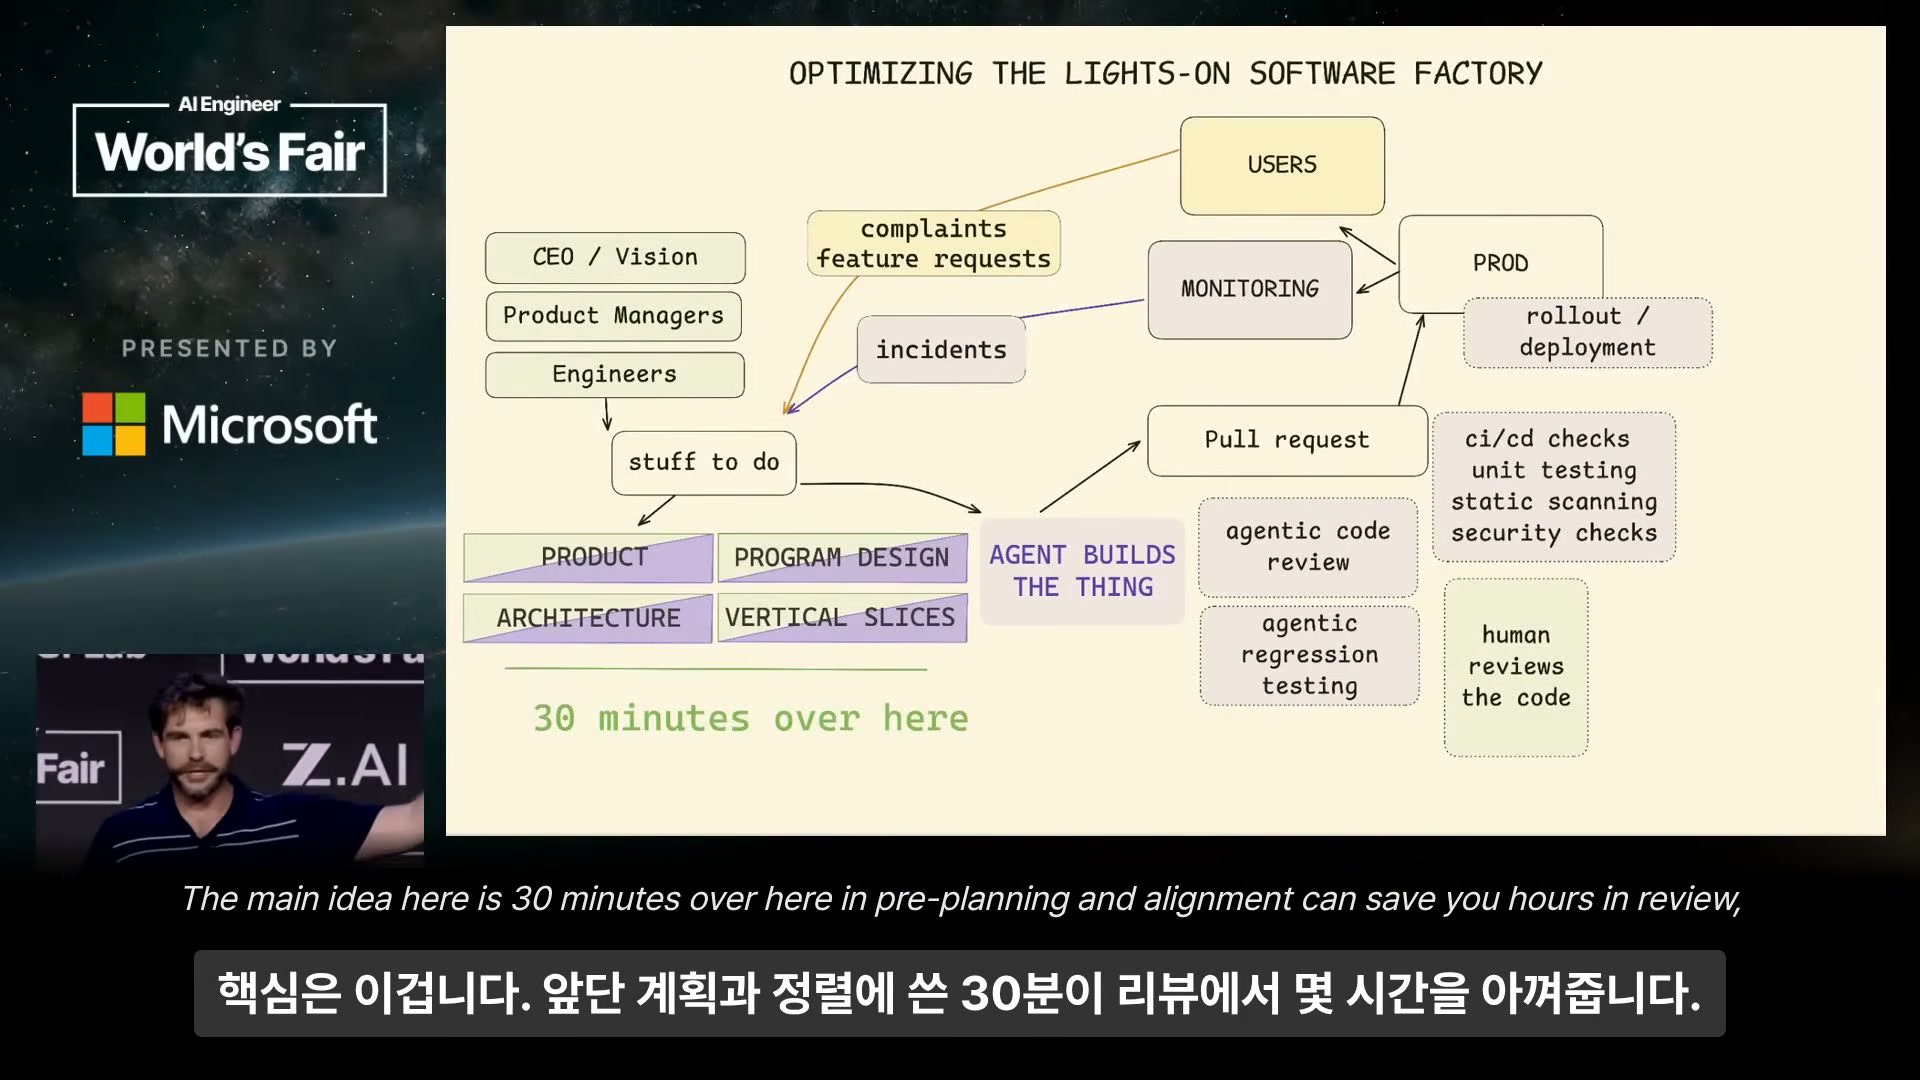
핵심은 한 줄이다. 앞단 계획·정렬에 쓴 30분이 리뷰에서 몇 시간을 아껴준다. 그래서 코드의 모든 줄을 읽는 게 여전히 가능해진다.
[11:25] 15. (발표) PR이 너무 많은 게 아니라, 나쁜 PR이 너무 많은 것
요약하자면 당신에게 PR이 너무 많은 게 아니다. 나쁜 PR이 너무 많은 것이다. 잘 만들어진 PR은 리뷰하는 게 즐겁다 — 그냥 읽어 내려가면서 “그래, 이거 좋네, 우리가 논의한 그대로네” 하게 된다.
반대로 20%만 재작업이 필요해도 — AI가 바이브 코딩한 슬롭을 생각하면 후한 수치인데 — 리뷰어와 제출자 양쪽 모두에게 감정적이고 지적인 부담이 된다.
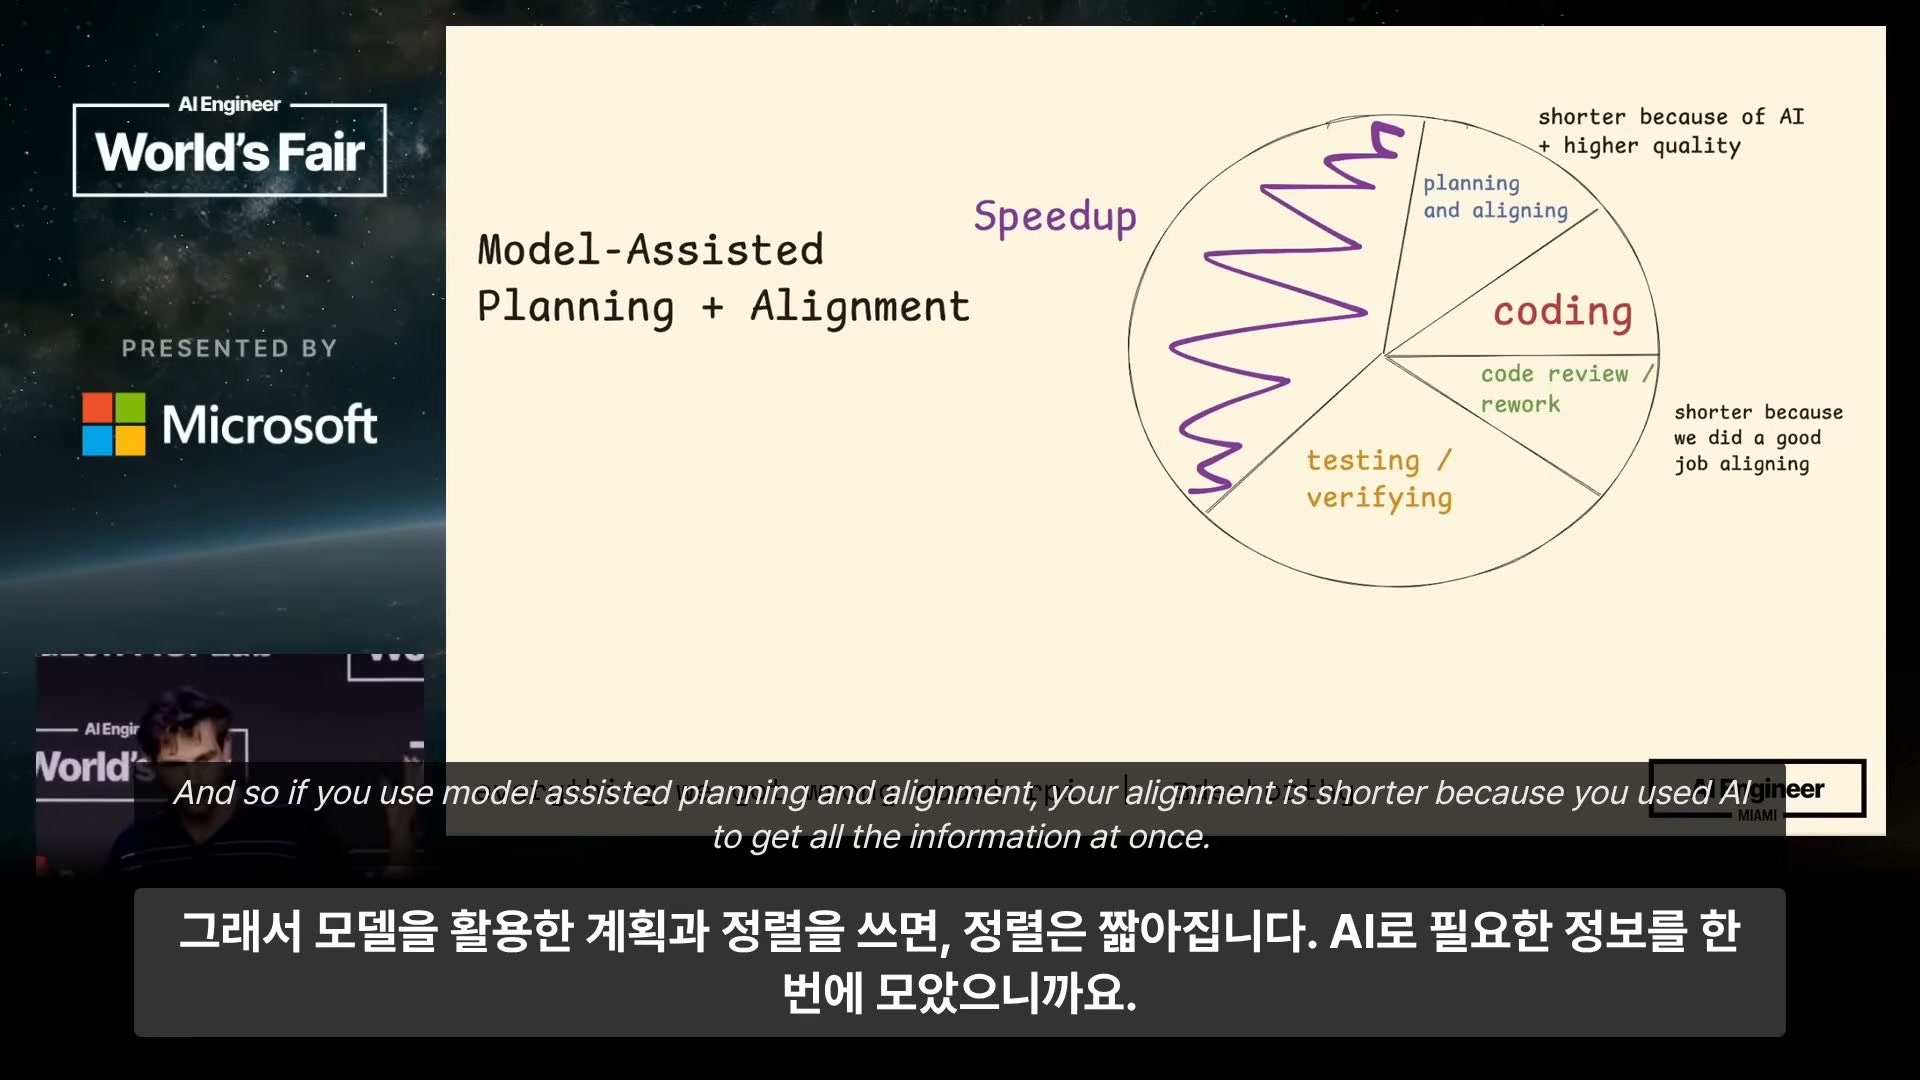
모델을 활용한 계획·정렬을 쓰면 세 군데가 동시에 짧아진다. 정렬은 AI로 필요한 정보를 한 번에 모아서 짧아지고, 코드 리뷰는 앞에서 정렬을 맞췄기 때문에 빨라지고, 코딩은 AI가 했으니 빨라진다. 그래서 실제로 더 빠르게 가면서도 여전히 전부 읽고 있고, 여전히 코드를 책임지고 있다.
[12:12] 16. (해설) 다섯 줄 정리
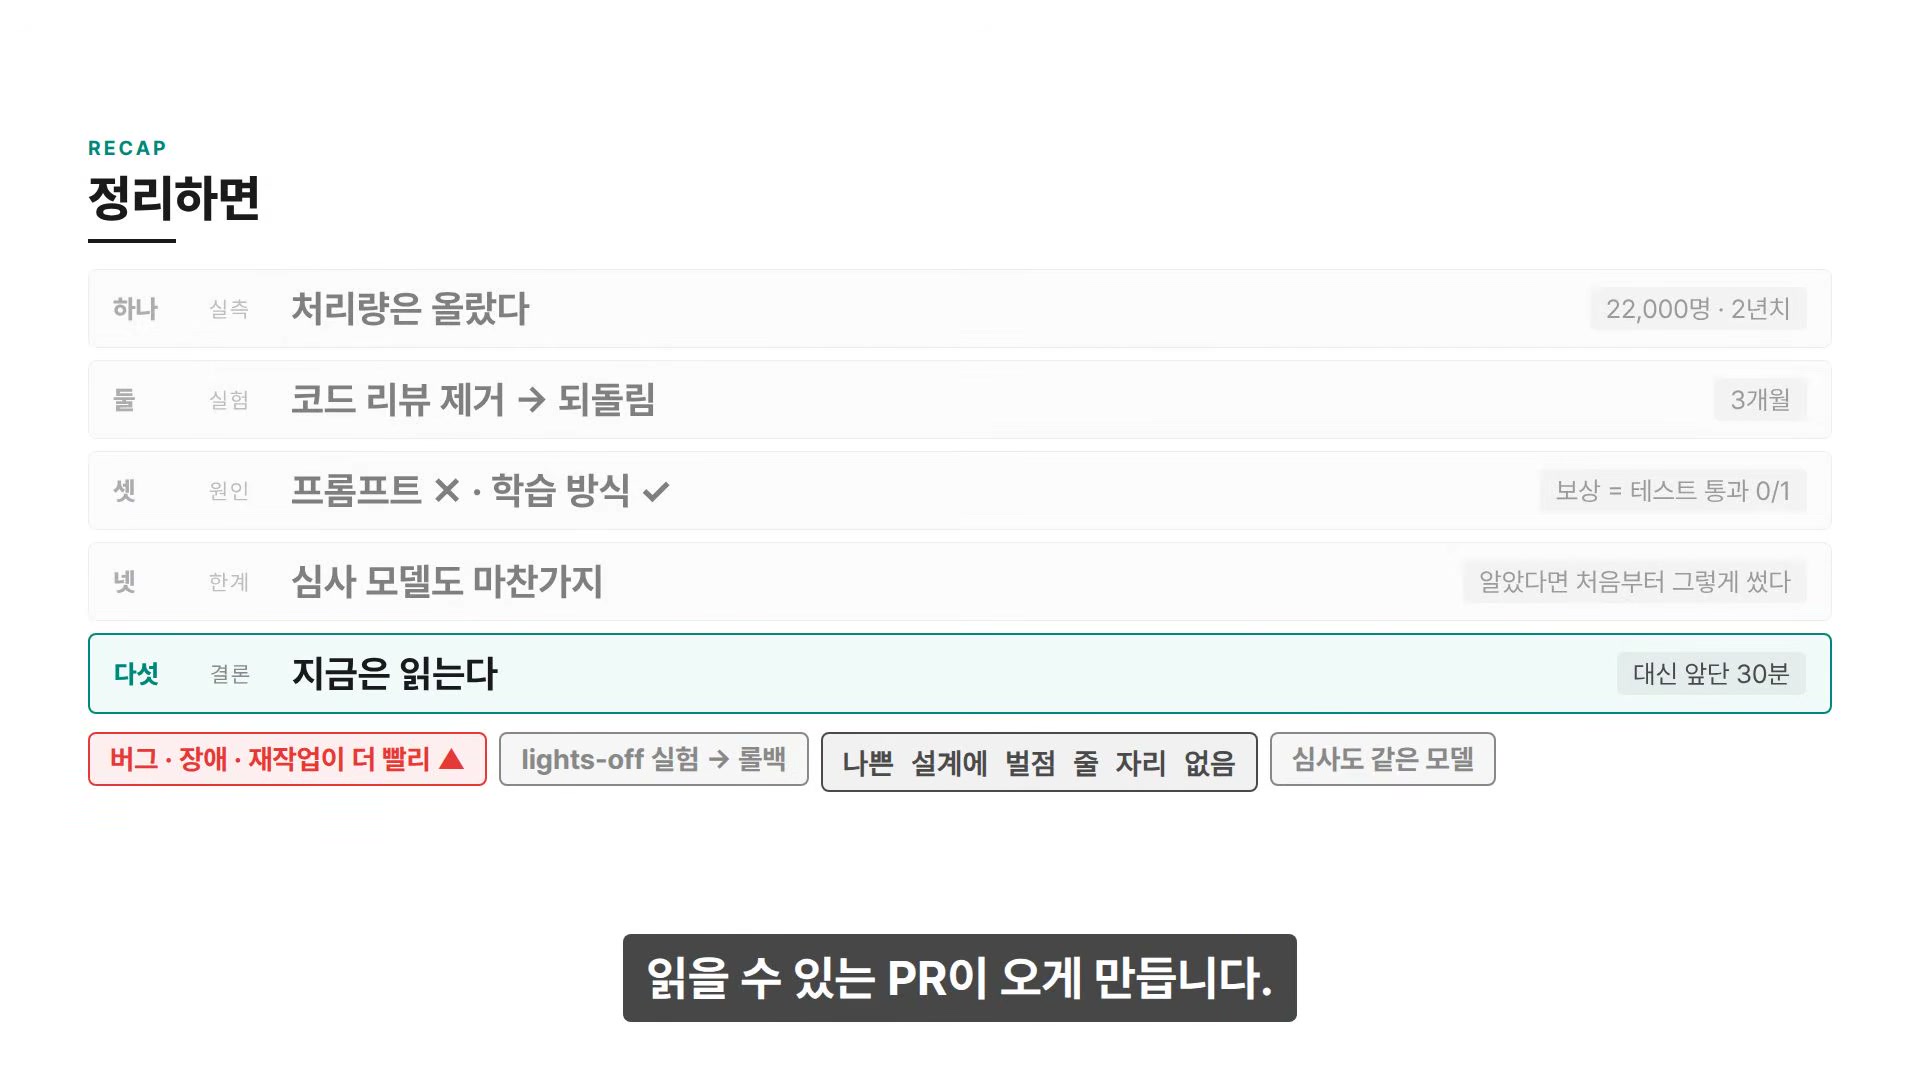
| # | 구분 | 내용 | 근거 |
|---|---|---|---|
| 하나 | 실측 | 처리량은 올랐다 | 22,000명 · 2년치 (버그·장애·재작업이 더 빨리 올랐다) |
| 둘 | 실험 | 코드 리뷰 제거 → 되돌림 | 3개월 |
| 셋 | 원인 | 프롬프트 ✗ · 학습 방식 ✓ | 보상 = 테스트 통과 0/1 (나쁜 설계에 벌점 줄 자리가 없다) |
| 넷 | 한계 | 심사 모델도 마찬가지 | 알았다면 처음부터 그렇게 썼다 |
| 다섯 | 결론 | 지금은 읽는다 | 대신 앞단 30분 — 읽을 수 있는 PR이 오게 만든다 |
[12:39] 17. (해설의 덧붙임) 기준은 되돌리기 비용
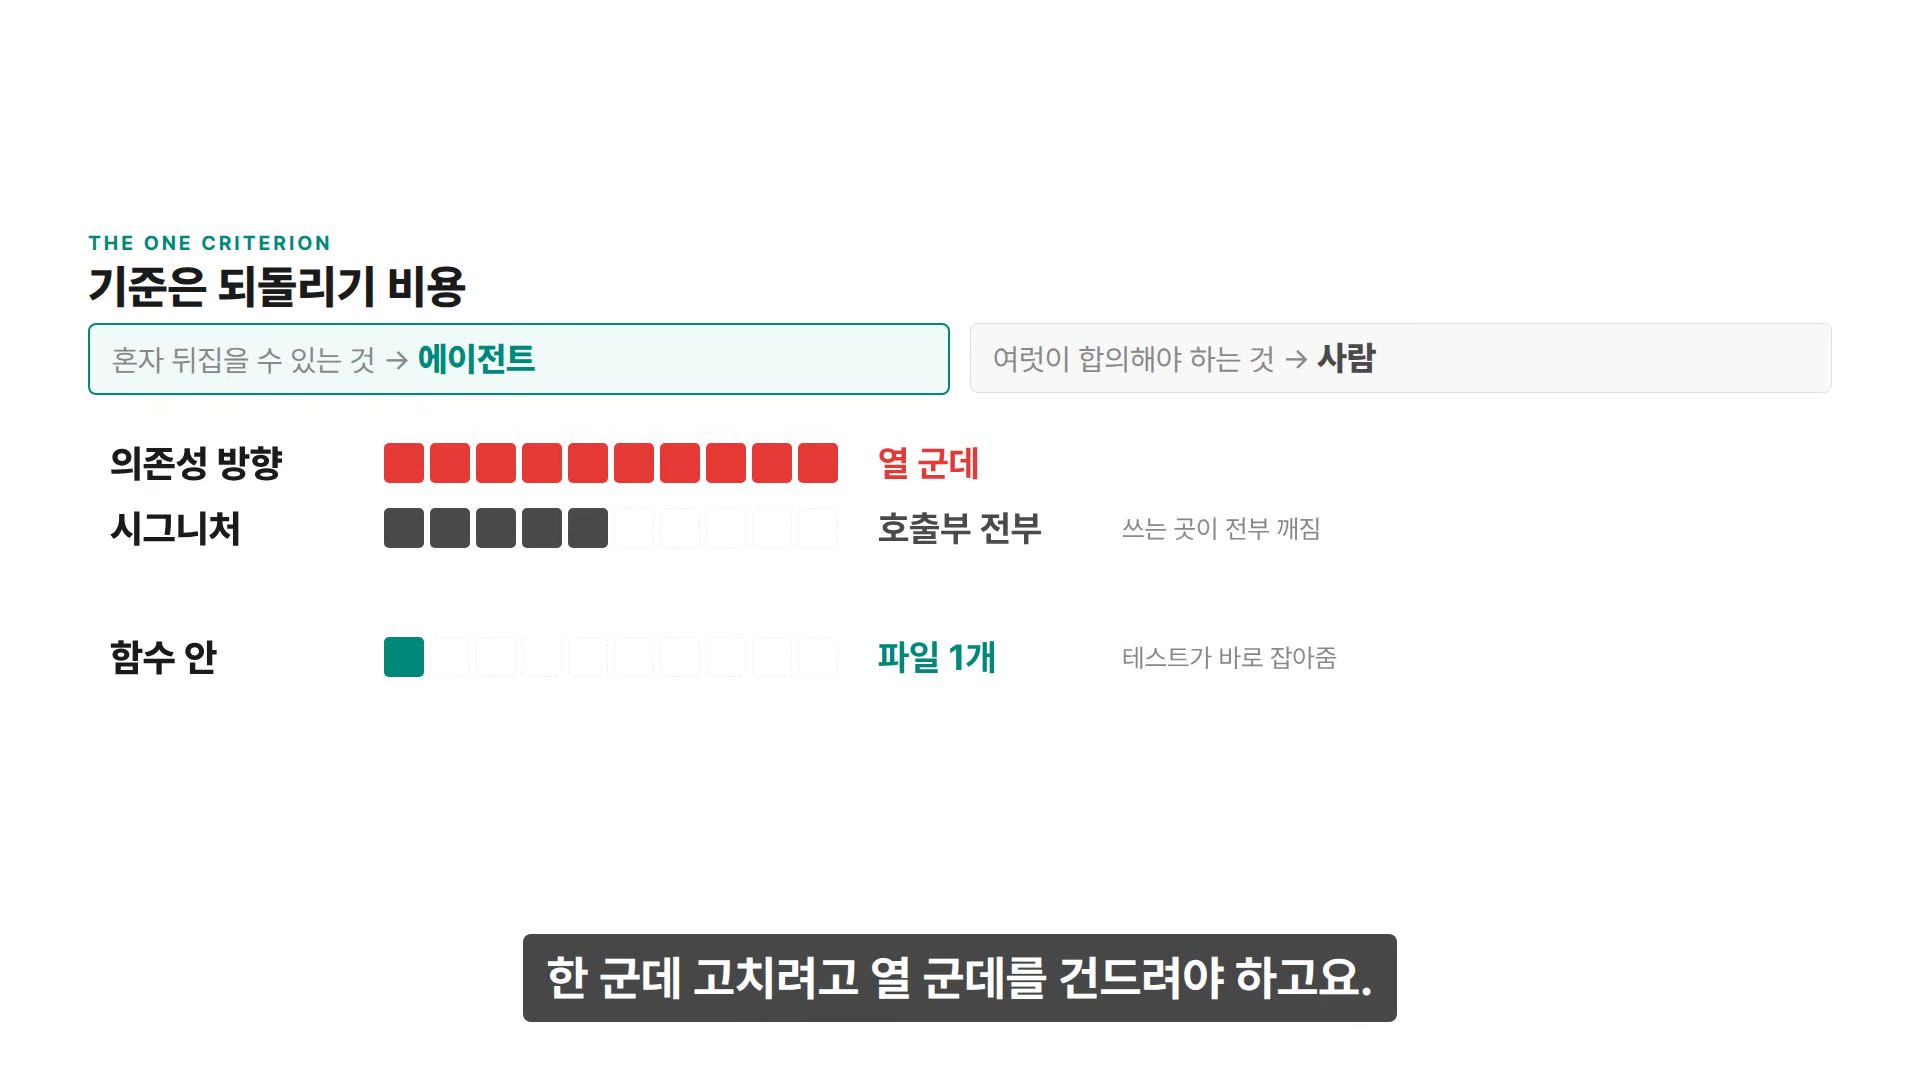
여기부터는 발표에 없는 해설자 본인의 덧붙임이다. 발표가 프로그램 디자인을 가장 과소평가된 단계로 꼽았지만, 막상 해보면 그걸 어디까지 적어야 하는지가 헷갈린다. 해설자가 제시하는 기준은 하나다.
혼자 뒤집을 수 있는 건 에이전트에게, 여럿이 합의해야 하는 건 사람이.
- 함수 안 — 틀려도 그 파일 하나만 고치면 되고 테스트가 바로 잡아준다. → 안 적는다.
- 시그니처 — 틀리면 그걸 쓰는 호출부가 전부 깨진다. → 사람이 적는다.
- 의존성 방향 — 틀리면 한 군데 고치려고 열 군데를 건드려야 한다. → 사람이 적는다.
그 경계의 맨 아래가 마침 인터페이스다. 거기까지는 사람이 적고, 함수 안은 안 적는다.
마지막으로 원본 발표(19:17)를 통째로 볼 것을 권한다 — 이 13분에 담기지 않은 슬라이드가 많다.
부록 — 실전 체크리스트
- 에이전트에 던지기 전 4단계를 밟는다. 제품 리뷰(무슨 문제·원하는 동작·목업) → 시스템 아키텍처(컴포넌트 계약·데이터 모델·제약) → 프로그램 디자인(타입·시그니처·이음새·콜 스택) → 버티컬 슬라이스(구현 순서·멀티 레포 조율·검증 지점). 단, 사소한 일은 이 과정 없이 바로 넘긴다.
- 어디까지 적을지는 “되돌리기 비용”으로 정한다. 인터페이스(시그니처·의존성 방향)까지는 사람이 적고, 함수 안은 에이전트에게 맡긴다.
- PR이 밀린다면 리뷰 속도부터 손대지 않는다. 나쁜 PR이 많은 것이므로 앞단 정렬에 30분을 투자한다.
- 에이전트가 테스트 파일을 건드렸는지 항상 확인한다. RL 파이프라인조차 테스트 개변을 되돌리고 채점한다. 리뷰에서도 같은 원칙을 적용한다.
- 테스트 통과만으로 판단하지 않는다. 필요 없는 try/catch, 예외를 삼키고
undefined를 반환하는 처리, 통과를 위한 캐스팅 — 보상 구조가 만들어내는 전형적인 패턴이라 리뷰 체크리스트에 넣을 만하다. - lights-off를 시도한다면 3~6개월 지점을 미리 계획한다. 그 시점에 “에이전트가 못 푸는 이슈 하나”를 만나며, 그때 읽지 않은 코드베이스가 부채로 청구된다.
원문 인용 모음
- [00:16] “이걸 다 읽어야 하나? 어차피 테스트는 통과했는데?” — 해설
- [01:14] “코드베이스가 그 어느 때보다 빠르게 무너지고 있습니다.” — 발표(Matt Pocock 인용 슬라이드)
- [01:30] “코멘트가 더 많아지고, 더 길어지고, 리뷰 없이 머지되는 PR이 엄청나게 늘었어요.”
- [02:26] “오늘 저는 이게 실력 문제가 아니라는 걸 설득하러 왔습니다.”
- [02:30] “하네스 엔지니어링을 아무리 하고 루프를 아무리 늘려도, 근본적으로 모델 학습의 문제라서 풀리지 않습니다.”
- [03:18] “우리는 더 이상 코드를 읽지 않는다.”
- [03:56] “열두 명이나 쓸 사이드 프로젝트를 바이브 코딩하는 개발자와, 10년 된 엔터프라이즈 시스템을 한 분기 더 살려두는 팀은, 이름 붙일 만한 제약을 거의 공유하지 않는다.” — Addy Osmani
- [04:36] “2025년 7월에 저희가 직접 해봤습니다. 완전히 불을 껐어요.”
- [05:04] “저 같은 사람이라면, 시스템에 흘러 들어온 그 슬롭 코드를 읽으면서 비참했을 겁니다.”
- [05:10] “모델에는 한계가 있습니다. 상당한 사람의 개입 없이는 시간이 지나면서 코드베이스 품질을 유지하고 개선할 수 없어요.”
- [05:41] “도구가 특별했던 게 아니라, 그 도구를 쓰도록 모델을 훈련시킨 거예요.” — 해설
- [07:33] “이 시스템에는 부실한 프로그램 설계나 유지보수성 훼손에 벌점을 줄 방법이 없습니다.”
- [08:01] “품질과 유지보수성을 검증하는 건 코드가 돌고 테스트가 통과하는 것보다 몇 자릿수는 어렵습니다.”
- [08:05] “나쁜 아키텍처의 비용 함수는 몇 개월, 몇 년 단위로 측정되니까요.”
- [09:06] “모델이 좋은 코드가 뭔지 알았다면, 애초에 그렇게 썼을 테니까요.”
- [09:20] “지금으로서는 코드를 읽는 수밖에 없다고 봅니다. 하지만 여전히 꽤 빠르게 갈 수 있어요.”
- [09:35] “쓴 교훈(Bitter Lesson)이고 뭐고, 우리한텐 지금 풀어야 할 문제가 있으니까, 우리 힘으로 빠져나가 봅시다.”
- [10:22] “프로그램 디자인은 요즘 에이전트 코딩에서 가장 과소평가되는 단계라고 생각합니다.”
- [11:17] “앞단 계획과 정렬에 쓴 30분이 리뷰에서 몇 시간을 아껴줍니다.”
- [11:30] “PR이 너무 많은 게 아닙니다. 나쁜 PR이 너무 많은 겁니다.”
- [12:08] “그래서 실제로 더 빠르게 가면서도, 여전히 전부 읽고 있고 여전히 코드를 책임지고 있습니다.”
- [12:47] “혼자 뒤집을 수 있는 건 에이전트한테, 여럿이 합의해야 하는 건 사람이.” — 해설의 덧붙임