출처: https://youtu.be/ymj8Ha0oBtU?si=FeuGi32BJXAnj_x4
길이: 15:56 · 채널: Tech Bridge · 공개: 2026-08-19
발표: Ankit Jain(Aviator 공동 창업자), AI Engineer World’s Fair 2026 발표를 편집·자막화한 영상
다운로드 자막: 한국어 자동 번역 자막, 801 cue · raw body SHA-2562ce67b4476d74802426528b1829590edfb64c023b4c01ca70398bad07bd10f1c
포맷: A형 — 발표자 화면과 19장 슬라이드가 함께 나오는 AI 코드 검증·코드 리뷰 설계 발표다. 아래 15개 프레임은 본편에서 직접 추출했고 자막 구간과 화면을 전수 대조했다.
주의:+861%등의 수치는 슬라이드가 인용한 Faros AI의 보고서 수치이며 여기서 별도 검증하지 않았다.AI Slop Register와Verify는 발표자의 제안·제품 시연 맥락으로 읽어야 한다. 발표자 이해관계: 발표자는 코드 리뷰 자동화·검증 제품(Aviator Verify)을 판매하는 창업자다. “diff 리뷰는 죽었다”는 진단과 “의도·증거 검증으로 옮기자”는 처방은 자사 제품의 필요조건을 깔아주는 논지이기도 하다.
발표자 — Ankit Jain
- 직위: Aviator 공동 창업자 & CEO. Aviator는 엔지니어링 팀이 AI 생성 코드를 대규모로 신뢰하고 쉽핑하도록 돕는 개발자 생산성·AI 코드 검증 플랫폼으로, 이 강연에서 시연한
Verify(AI 코드 검증)가 핵심 제품이다. - 커뮤니티: 시니어 DevOps·소프트웨어 엔지니어 중심 DX 커뮤니티 The Hangar와 전 구글러 알럼나이 네트워크 Xoogler를 운영한다. DevEx 팟캐스트 HangarDX의 호스트이기도 하다.
- 경력: Google·Adobe에서 엔지니어로 근무했고, Sunshine · Homejoy · Shippo에서 엔지니어링 팀을 이끌었다.
- 집필: CIO.com(“AI killed the code review. What happens to knowledge sharing?”, 2026-06), The New Stack(“Code review is a taste problem”, 2026-08, David Poll 공저), Latent.Space 게스트 포스트(이 강연의 원고, 2026-03) 등에 코드 리뷰·AI 코딩 칼럼을 연재한다.
- 논지 변화: 2026년 3월 Latent.Space 글에서는 “Human-written code died in 2025. Code reviews will die in 2026”이라고 선언했으나, 이후 회고 글과 본 강연에서는 정렬(alignment) 반쪽은 반드시 살려야 한다로 논지를 보정했다.
한눈에 보는 요약
- AI가 코드를 쓰는 속도는 빨라졌지만, 사람이 diff를 한 줄씩 읽는 기존 리뷰는 새로운 병목이 됐다.
- 코드 리뷰의 목적은 버그·보안·규칙을 찾는 의미 정확성뿐 아니라 지식 공유·멘토링·아키텍처 피드백 같은 정렬(alignment) 이다.
- 사양 문서만 에이전트에 넘기는 방식은 실행 중 생기는 질문과 결정을 버리기 때문에, 실제 의도는 Jira·PRD보다 개발 세션과 프롬프트에 더 많이 남는다.
- 세션에서 사용자 응답과 에이전트와의 결정을 추출해 인수 조건(acceptance criteria) 으로 만들고, 반복되는 리뷰 지적은 AI Slop Register라는 불변식·검사 목록으로 codify한다.
- 인수 조건과 불변식으로 테스트 계획을 만들고 preview 환경에서 실행한 뒤, 사람은 코드 전체가 아니라 의도·아키텍처·검증 증거를 검토한다.
- 가능한 검사는 결정론적으로, 모호한 행동 판단은 LLM으로 처리하되 LLM은 하네스 안의 도구일 뿐 최종 판정자가 되어서는 안 된다.
핵심 한 줄: 코드 리뷰를 없애는 일은 인간의 판단을 없애는 것이 아니라, 반복 가능한 diff 검사를 자동화하고 사람이 무엇을 만들려 했는지와 그것을 입증하는 증거에 집중하게 만드는 일이다.
장면별 상세 설명
[00:30] 1. 5계층 신뢰 모델에서 출발하기
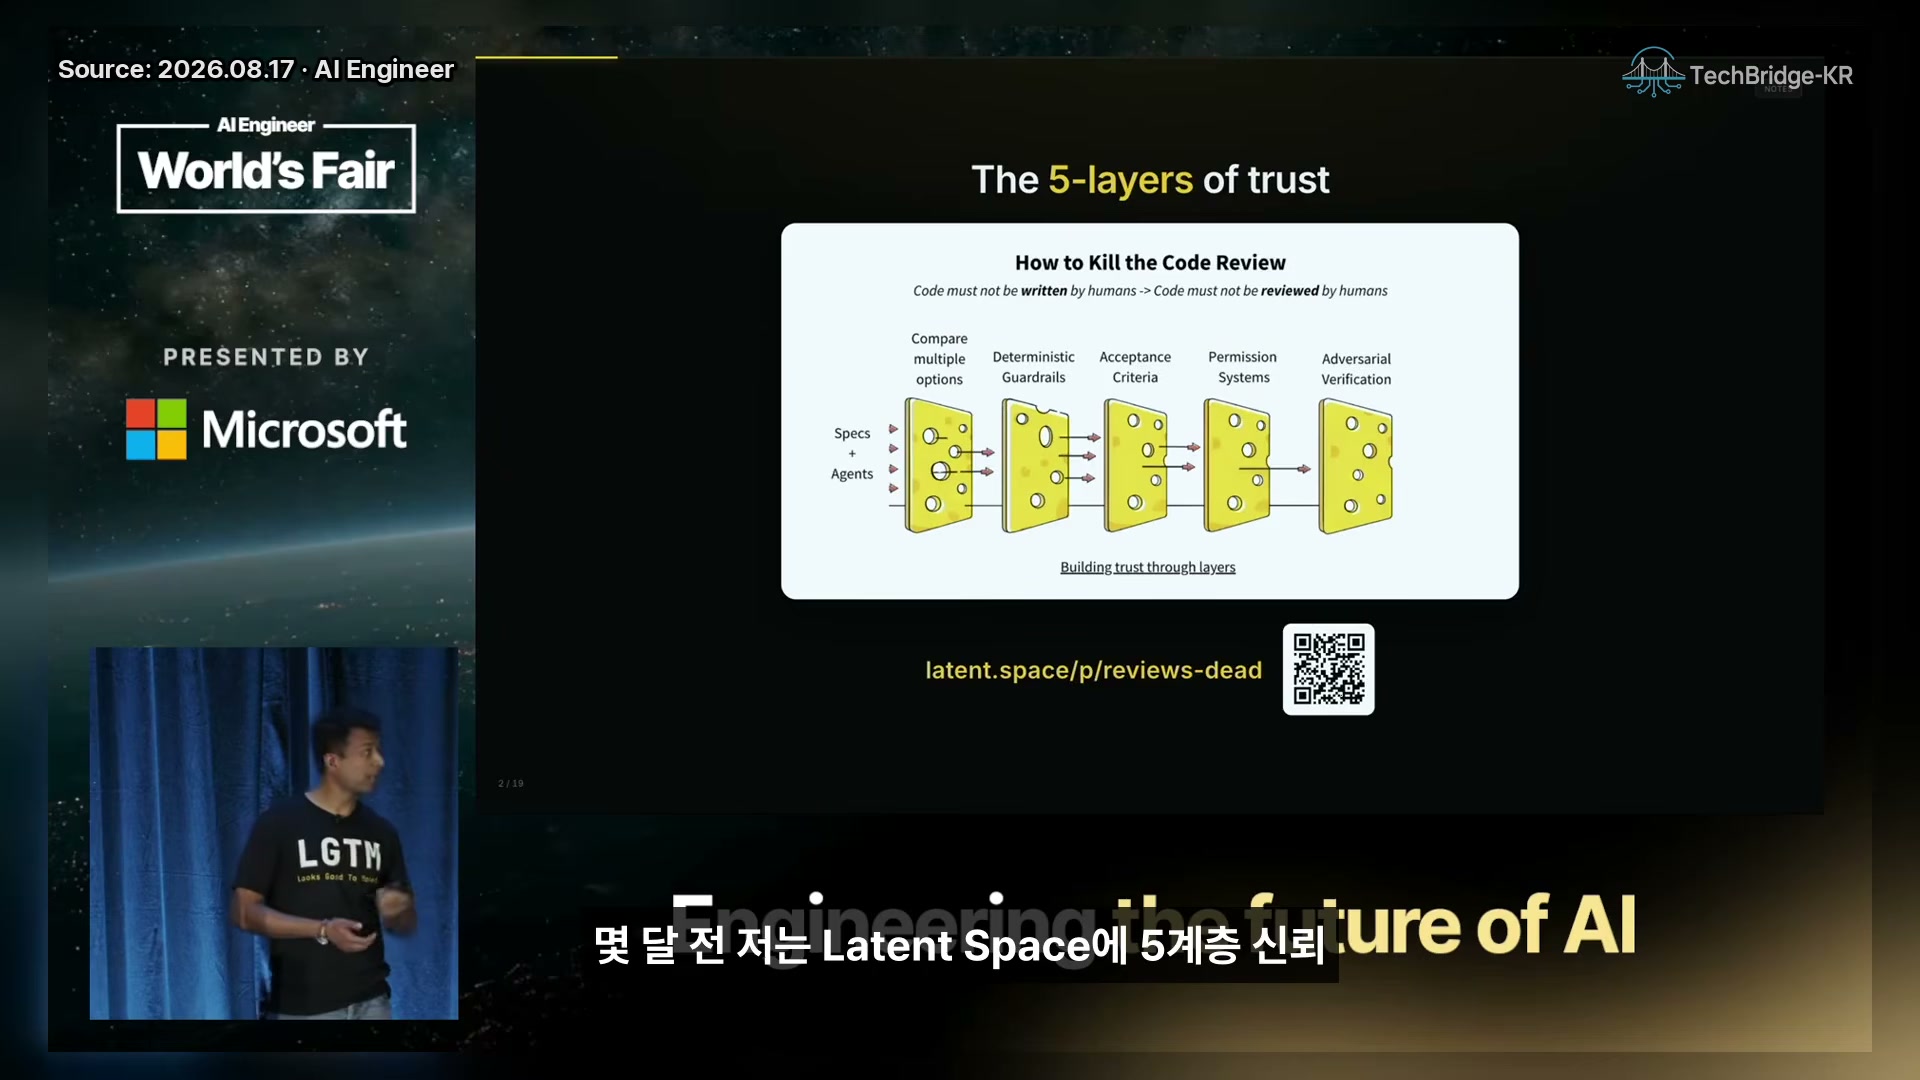
발표자는 이전에 제안한 “코드 리뷰를 죽이는 방법”을 다시 꺼낸다. 핵심 전제는 코드가 인간에 의해 작성되지 않는다면 인간이 한 줄씩 리뷰할 필요도 줄어든다는 것. 화면은 여러 에이전트와 사양을 통과시키며 Compare multiple options → Deterministic Guardrails → Acceptance Criteria → Permission Systems → Adversarial Verification의 다섯 층으로 신뢰를 쌓는 모델을 보여준다. 이번 발표에서는 각 층의 구현보다 이 모델에서 빠졌던 개념, 즉 팀의 정렬을 보완하겠다고 예고한다.
[01:31] 2. 코드 리뷰는 이미 멈췄다
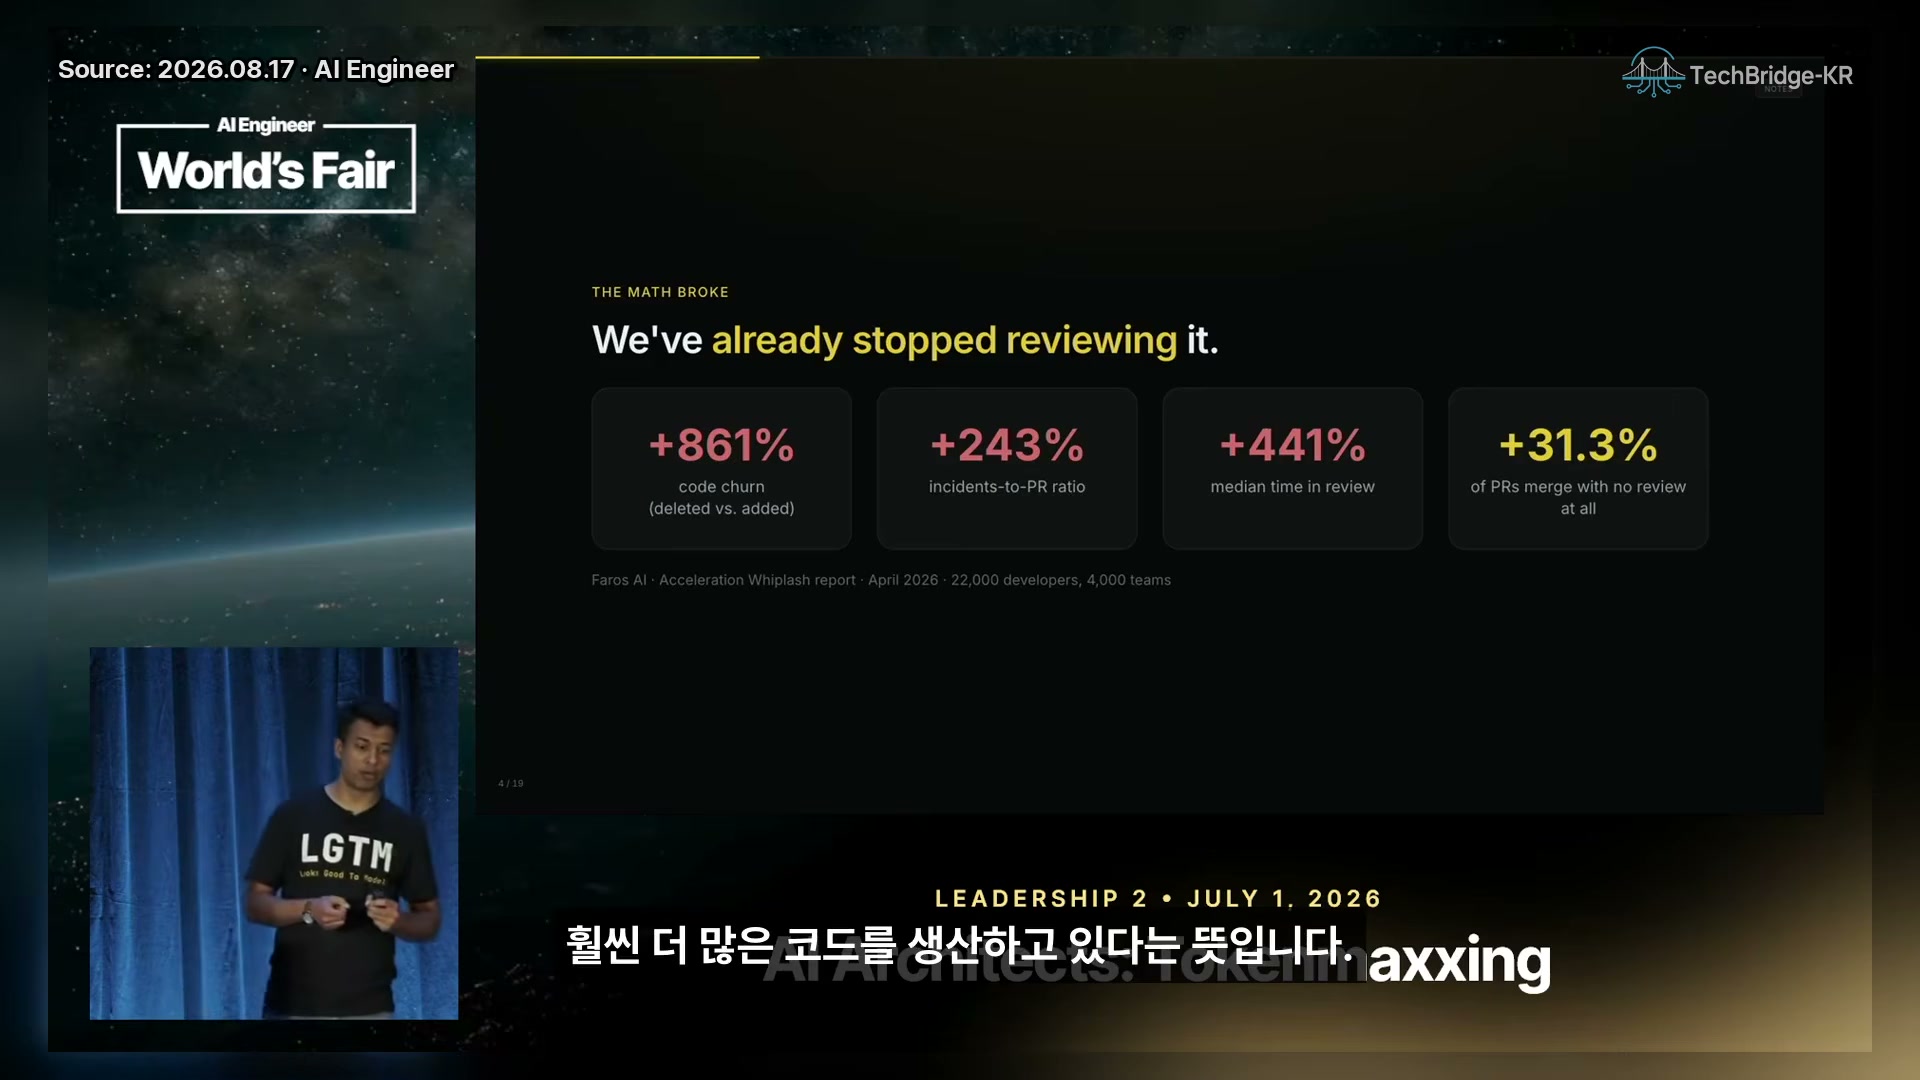
슬라이드의 제목은 “We’ve already stopped reviewing it.” 이다. AI 코딩으로 코드 생산량이 늘면서 코드 churn +861%, incident-to-PR 비율 +243%, 중앙값 리뷰 시간 +441%, 리뷰 없이 merge되는 PR +31.3%라는 수치를 제시한다. 발표자의 논지는 개발 속도를 높였는데 병목이 코딩에서 리뷰로 이동했고, 실제 팀에서는 이미 모든 변경을 제대로 읽지 못한다는 것이다. 수치는 슬라이드가 Faros AI·Acceleration Whiplash 보고서(2026년 4월, 2만 2천 개발자·4천 팀)를 출처로 표기한다.
[02:16] 3. AI가 쓰고 AI가 리뷰하는 ‘리뷰 극장’
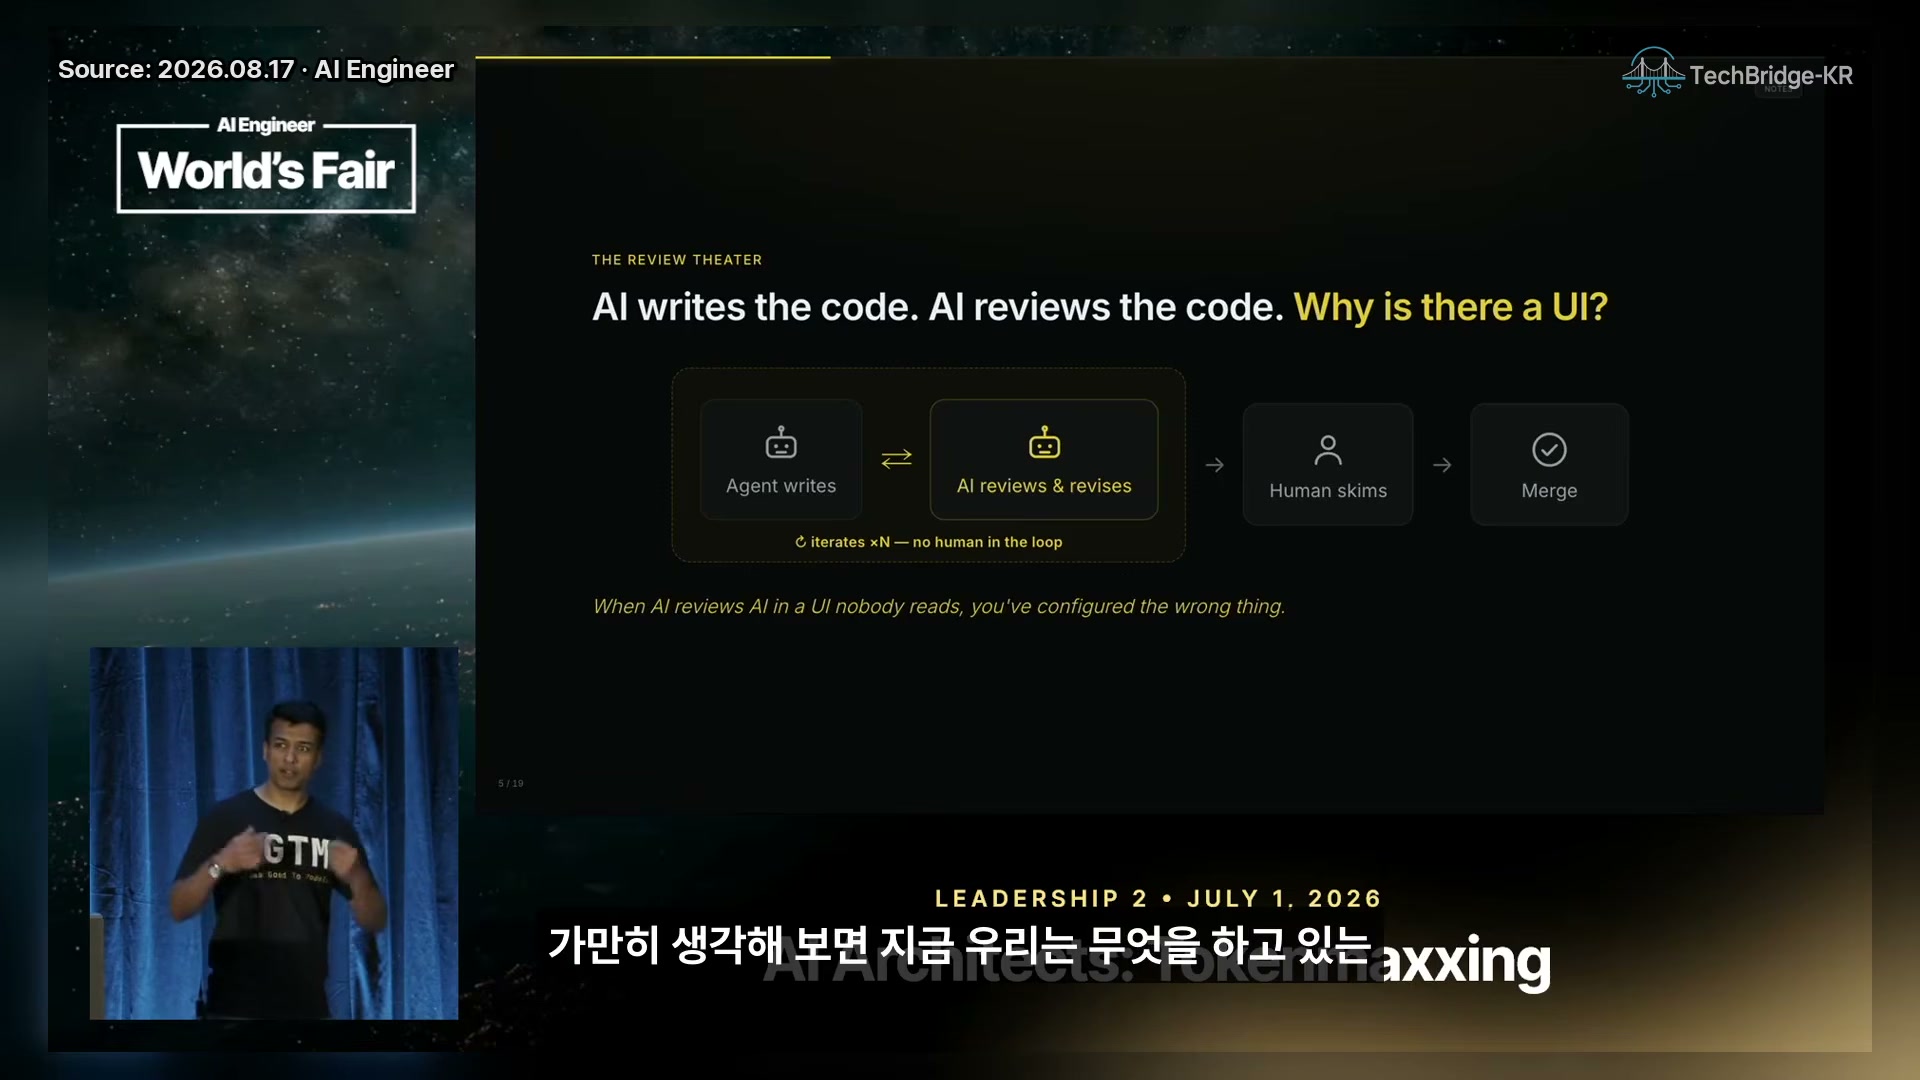
AI가 코드를 쓰고, 다른 AI가 리뷰와 수정을 반복하며, 마지막에 사람은 대충 훑고 merge하는 흐름을 화면에 그린다. AI 간 왕복은 iterate × N으로 늘어날 수 있지만 사람은 실제 판단 과정에서 빠진다. 발표자는 이때 사람이 “AI가 리뷰했으니 중요한 것은 잡혔겠지”라고 생각한다면 UI만 남은 잘못된 구성이 된 것이라고 말한다. 자동 리뷰의 목적은 인간이 읽지 않아도 되는 코멘트를 더 만드는 것이 아니라, 사람이 읽어야 할 판단면을 더 의미 있게 만드는 데 있어야 한다.
[03:19] 4. 코드 리뷰의 진짜 목적은 코드가 아니다
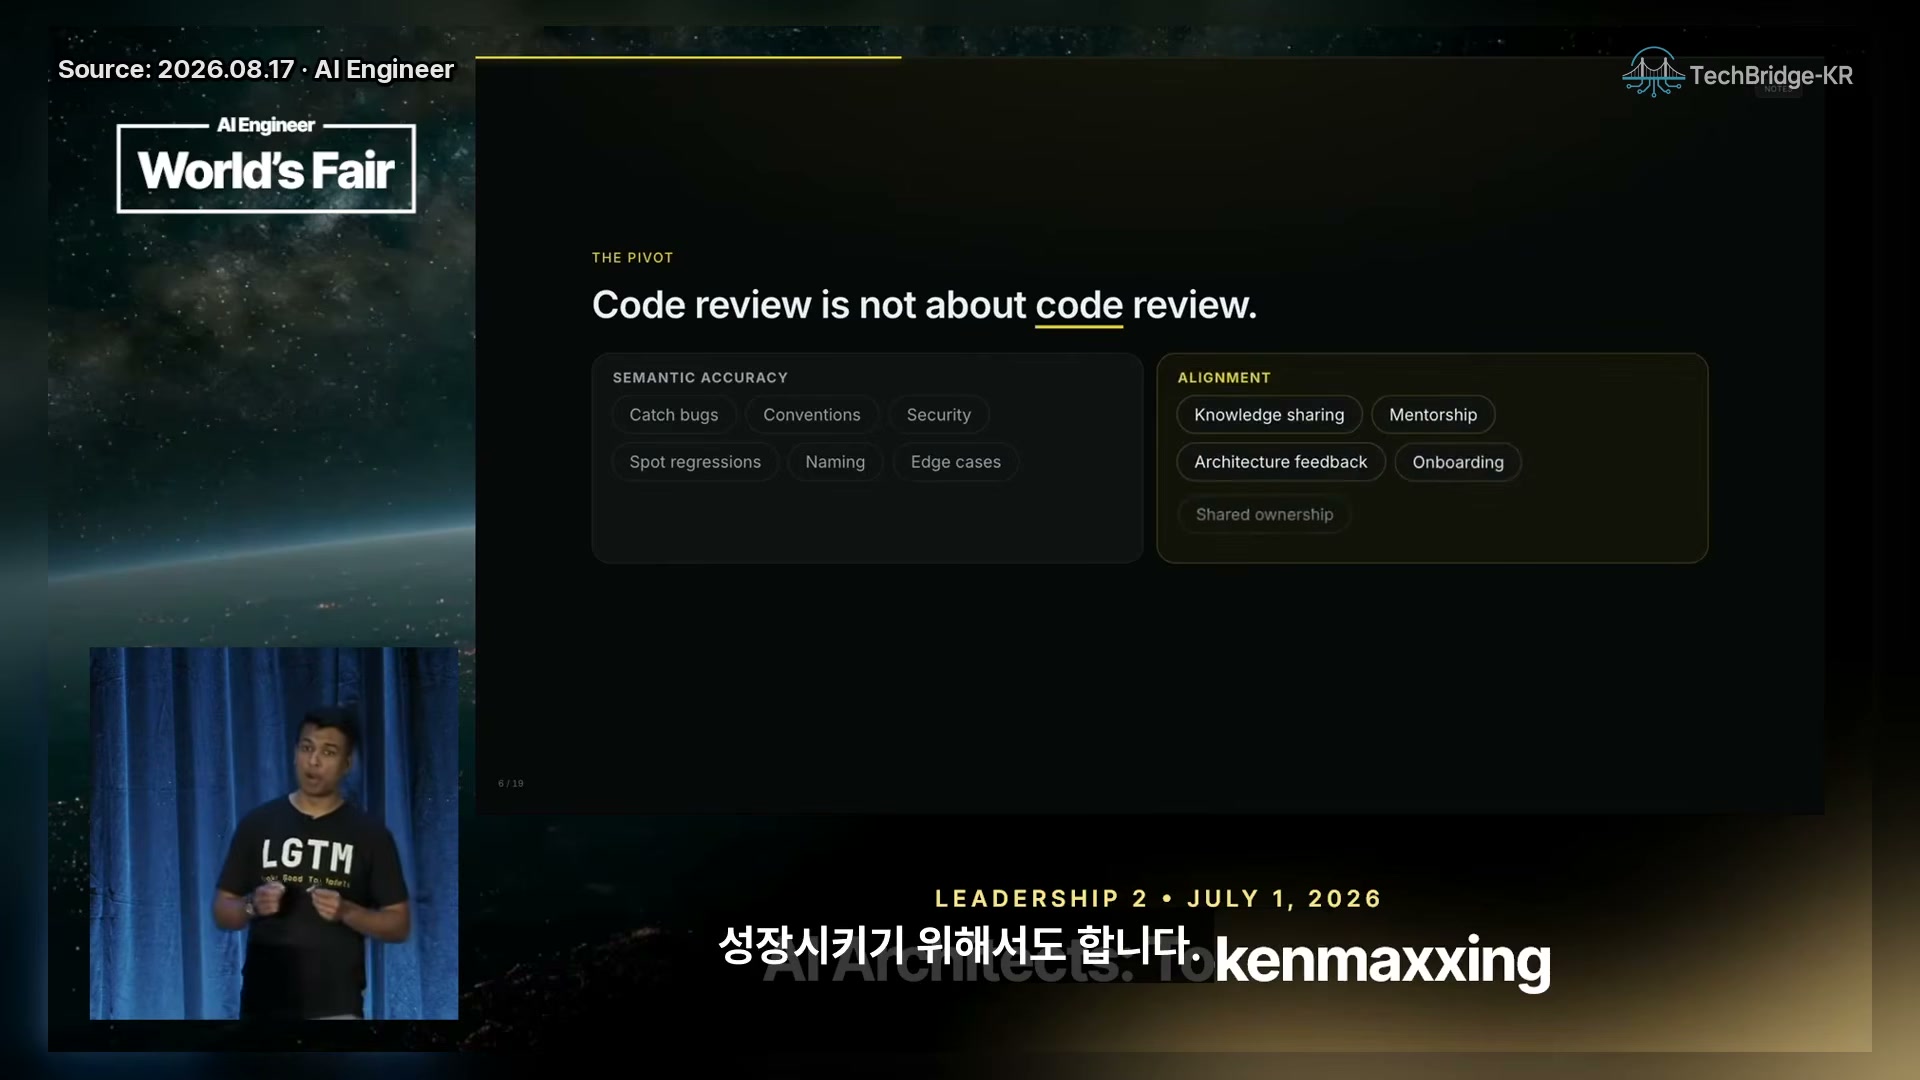
발표자는 코드 리뷰를 두 반쪽으로 나눈다. Semantic accuracy는 버그·규칙·보안·회귀·이름·엣지 케이스를 점검하는 일이고, alignment는 지식 공유·멘토링·아키텍처 피드백·온보딩·공동 소유권을 만드는 일이다. 정적 분석과 실행 검증은 첫 번째 축을 자동화할 수 있지만, 팀이 무엇을 만들고 왜 그렇게 만들었는지 맞추는 과정은 사라지면 안 된다. 따라서 리뷰의 표면을 diff에서 의도와 증거로 옮기더라도 아키텍처 논의와 사람 사이의 정렬은 남겨야 한다.
[04:28] 5. 사양 중심 개발은 ‘새 옷을 입은 폭포수’인가
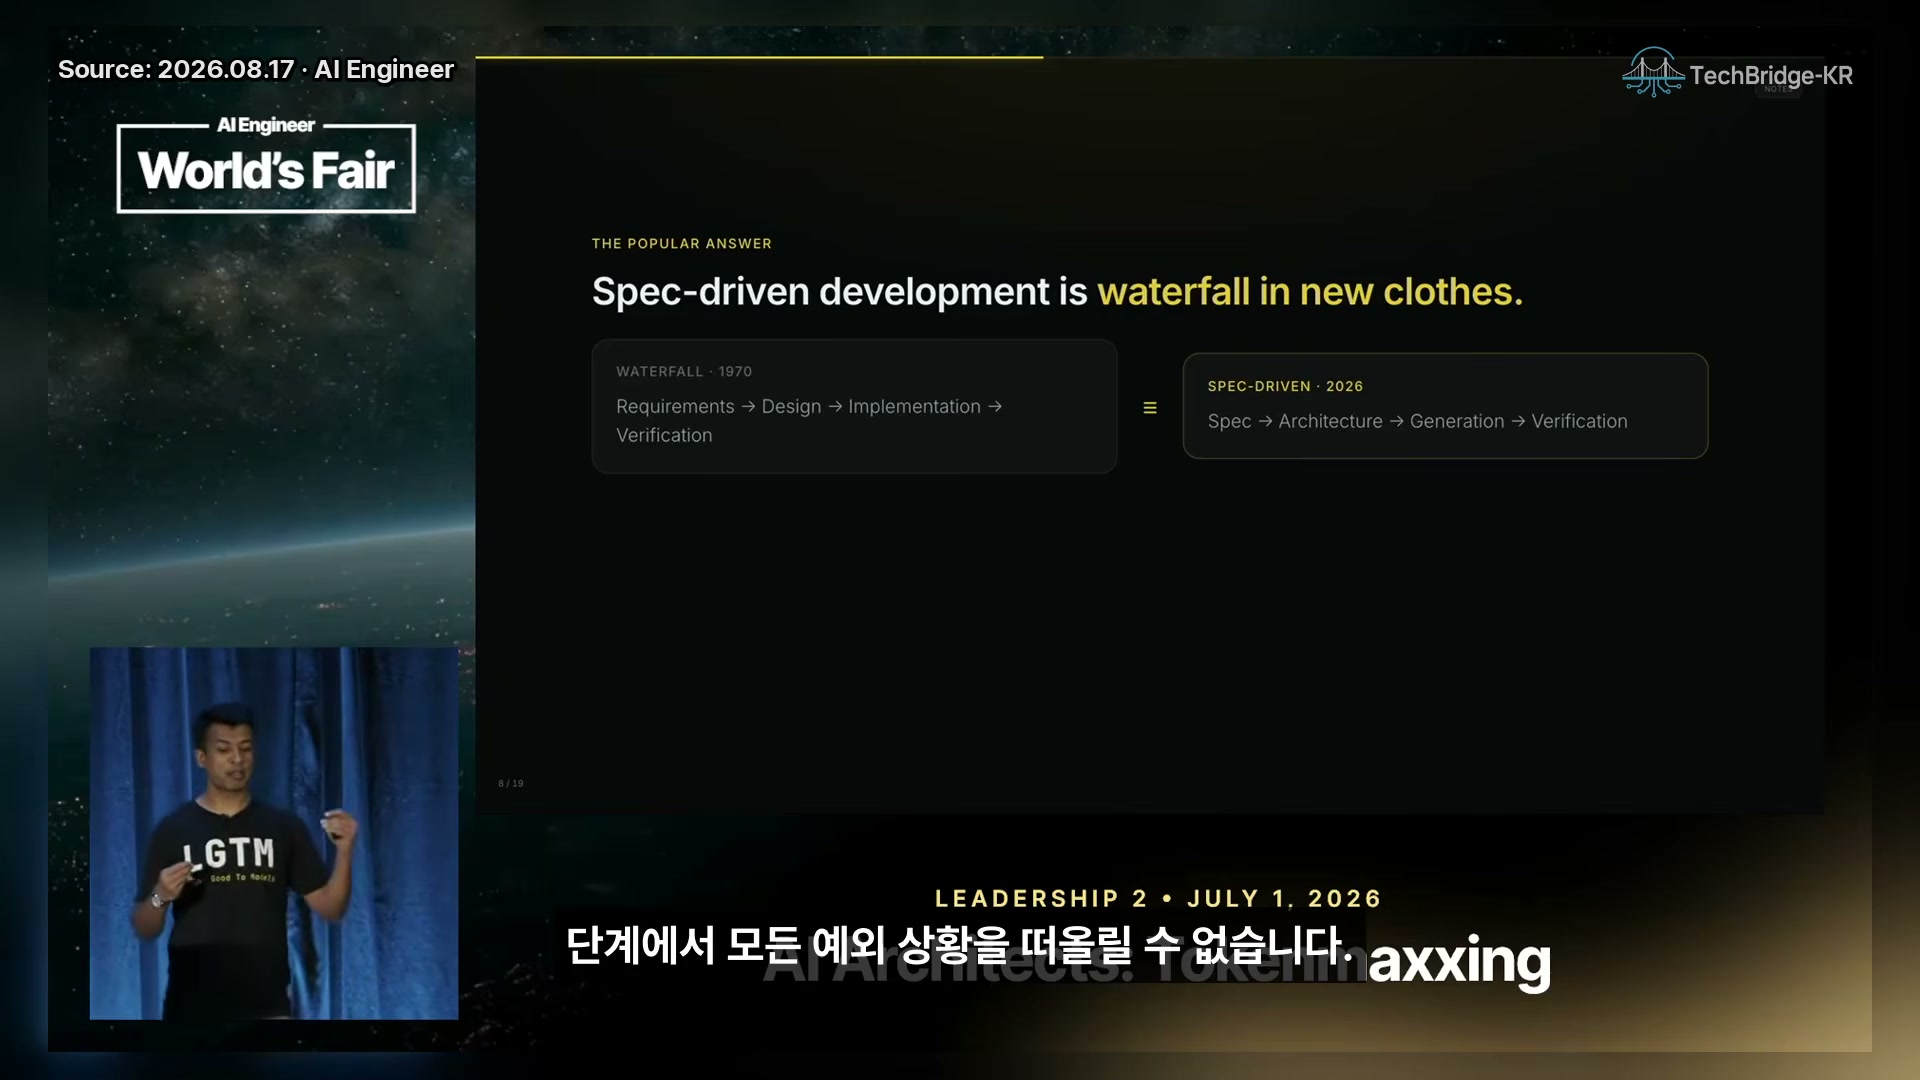
화면은 1970년식 폭포수의 Requirements → Design → Implementation → Verification과 2026년식 spec-driven 개발의 Spec → Architecture → Generation → Verification을 나란히 놓고, 후자를 “waterfall in new clothes” 라고 부른다. 발표자의 비판은 사양이 작성된 뒤 구현 중 발견한 문제를 다시 사양으로 되돌리는 피드백 루프가 없다는 데 있다. 특히 LLM은 결정론적 컴파일러가 아니므로 사양이 완성되면 코드가 한 가지 방식으로 나올 것이라고 기대할 수 없다. 그래서 실제 코딩 세션에서 에이전트와 질문·결정을 주고받는 과정이 필요하다.
[05:58] 6. 진짜 의도는 프롬프트에서 만들어진다
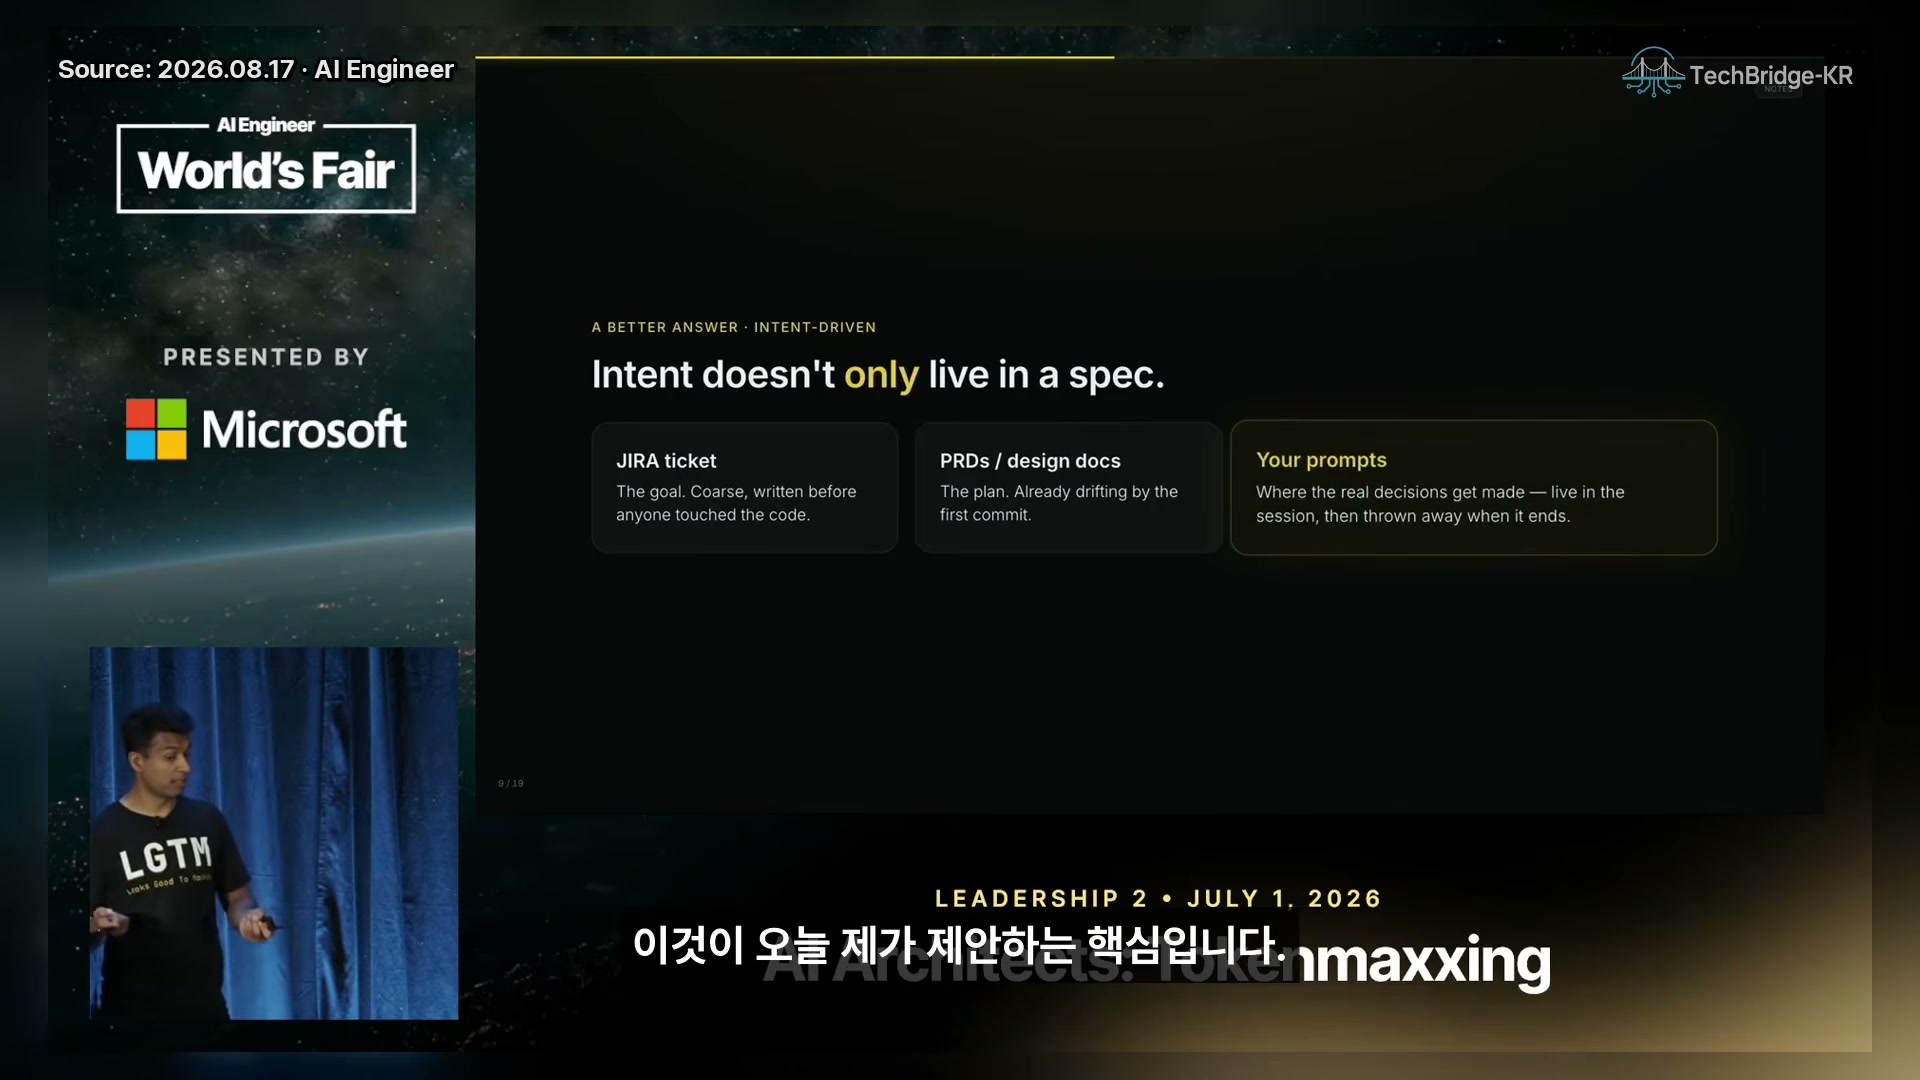
의도는 사양에만 존재하지 않는다. Jira 티켓은 구현 전에 작성한 거친 목표이고, PRD·디자인 문서는 계획이지만 첫 커밋부터 현실과 어긋나기 시작한다. 반면 프롬프트와 세션에서는 사용자가 에이전트의 질문에 답하고, 방향을 수정하고, 대안을 거절하면서 실제 결정을 내린다. 지금의 PR은 코드 변경만 남기고 그 프롬프트를 버리므로, 리뷰어가 사후에 diff만 읽어서는 무엇을 의도했는지 복원하기 어렵다는 주장이다.
[06:40] 7. 반복 지적을 AI Slop Register로 codify하기
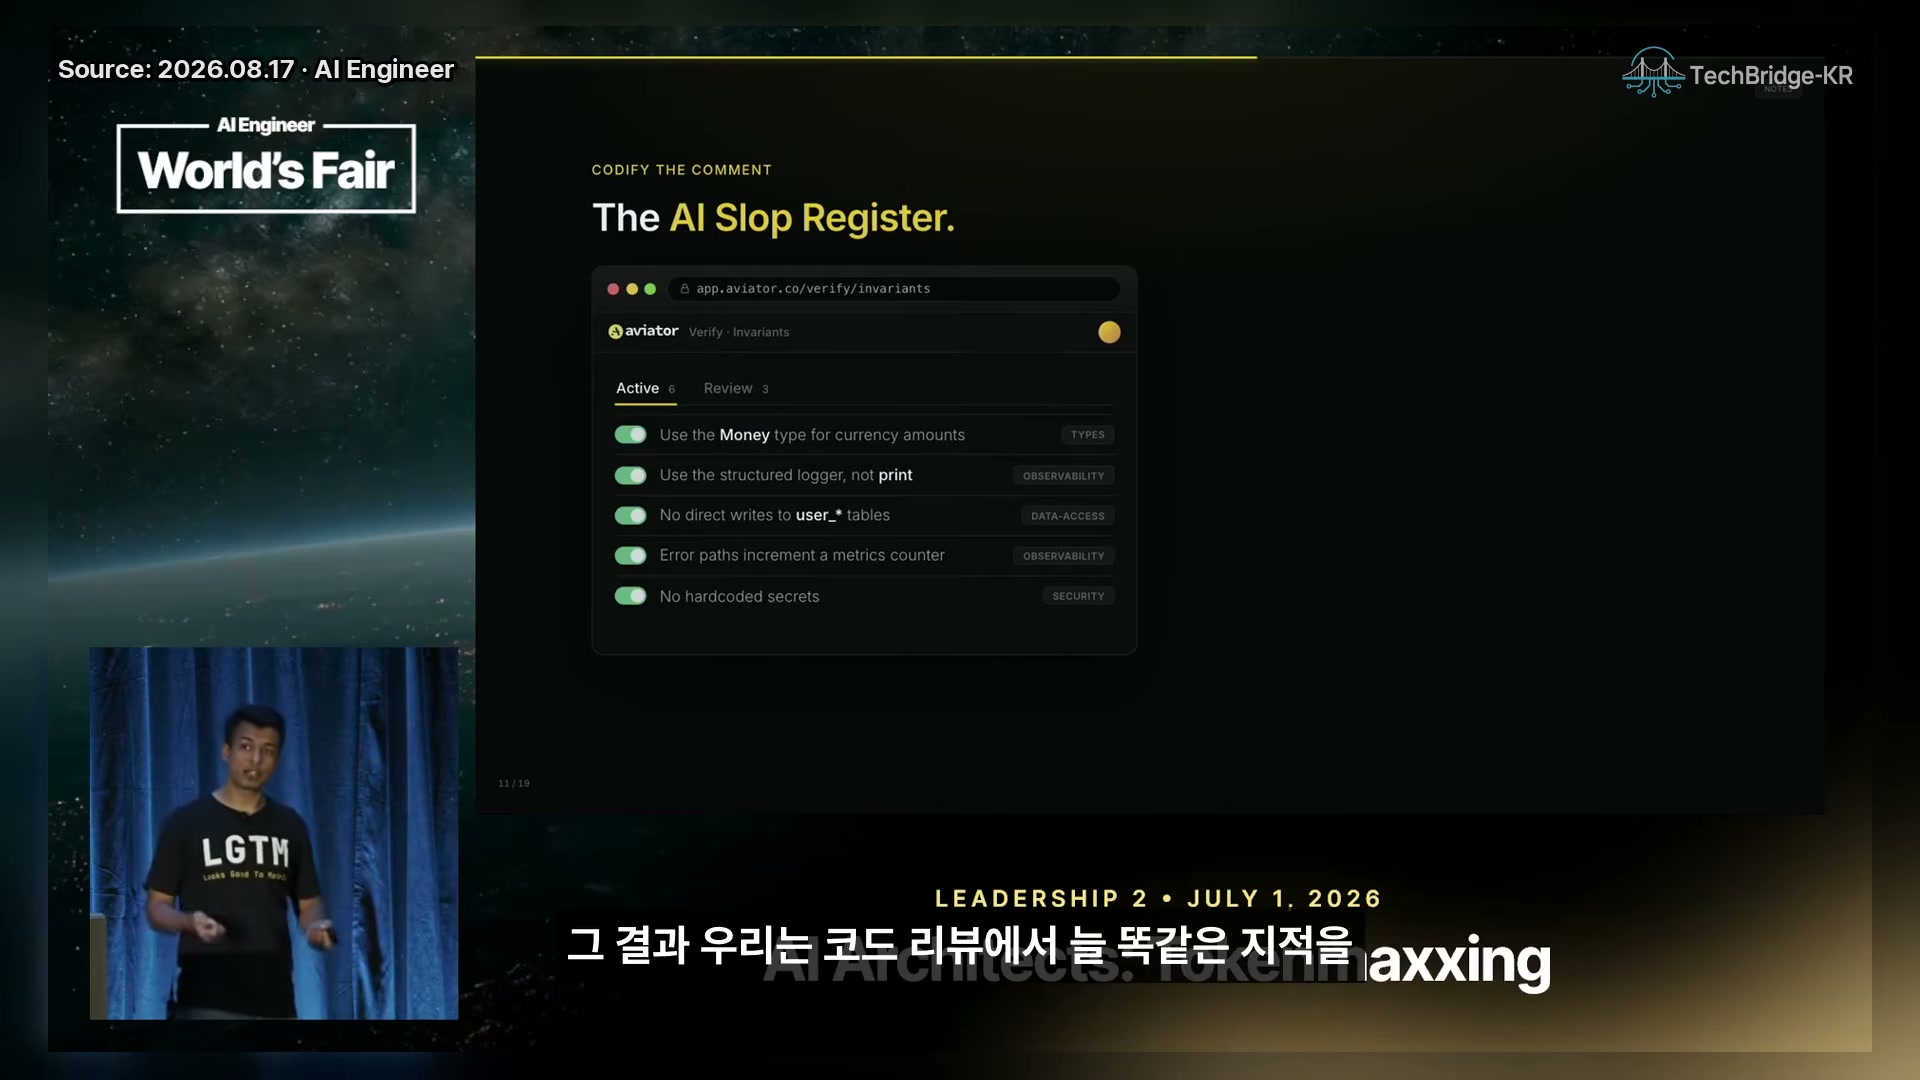
사람이 리뷰할 때 매번 같은 문제를 지적한다면 그것은 새 토론이 아니라 시스템에 등록할 규칙이다. AI Slop Register는 반복되는 코멘트를 불변식(invariant)·가드레일로 바꾸어 다음 PR부터 자동 검사하게 하는 목록이다. 화면의 예시는 currency amount에는 Money 타입, print 대신 structured logger, user_* 테이블 직접 쓰기 금지, 오류 경로의 metrics counter 증가, 하드코딩된 secret 금지다. 지적을 한 번 등록하면 모델을 다시 학습시키지 않아도 팀의 리뷰 경험이 계속 검사 규칙으로 누적된다는 발상이다.
[08:11] 8. 세션이 인수 조건이 되는 첫 단계
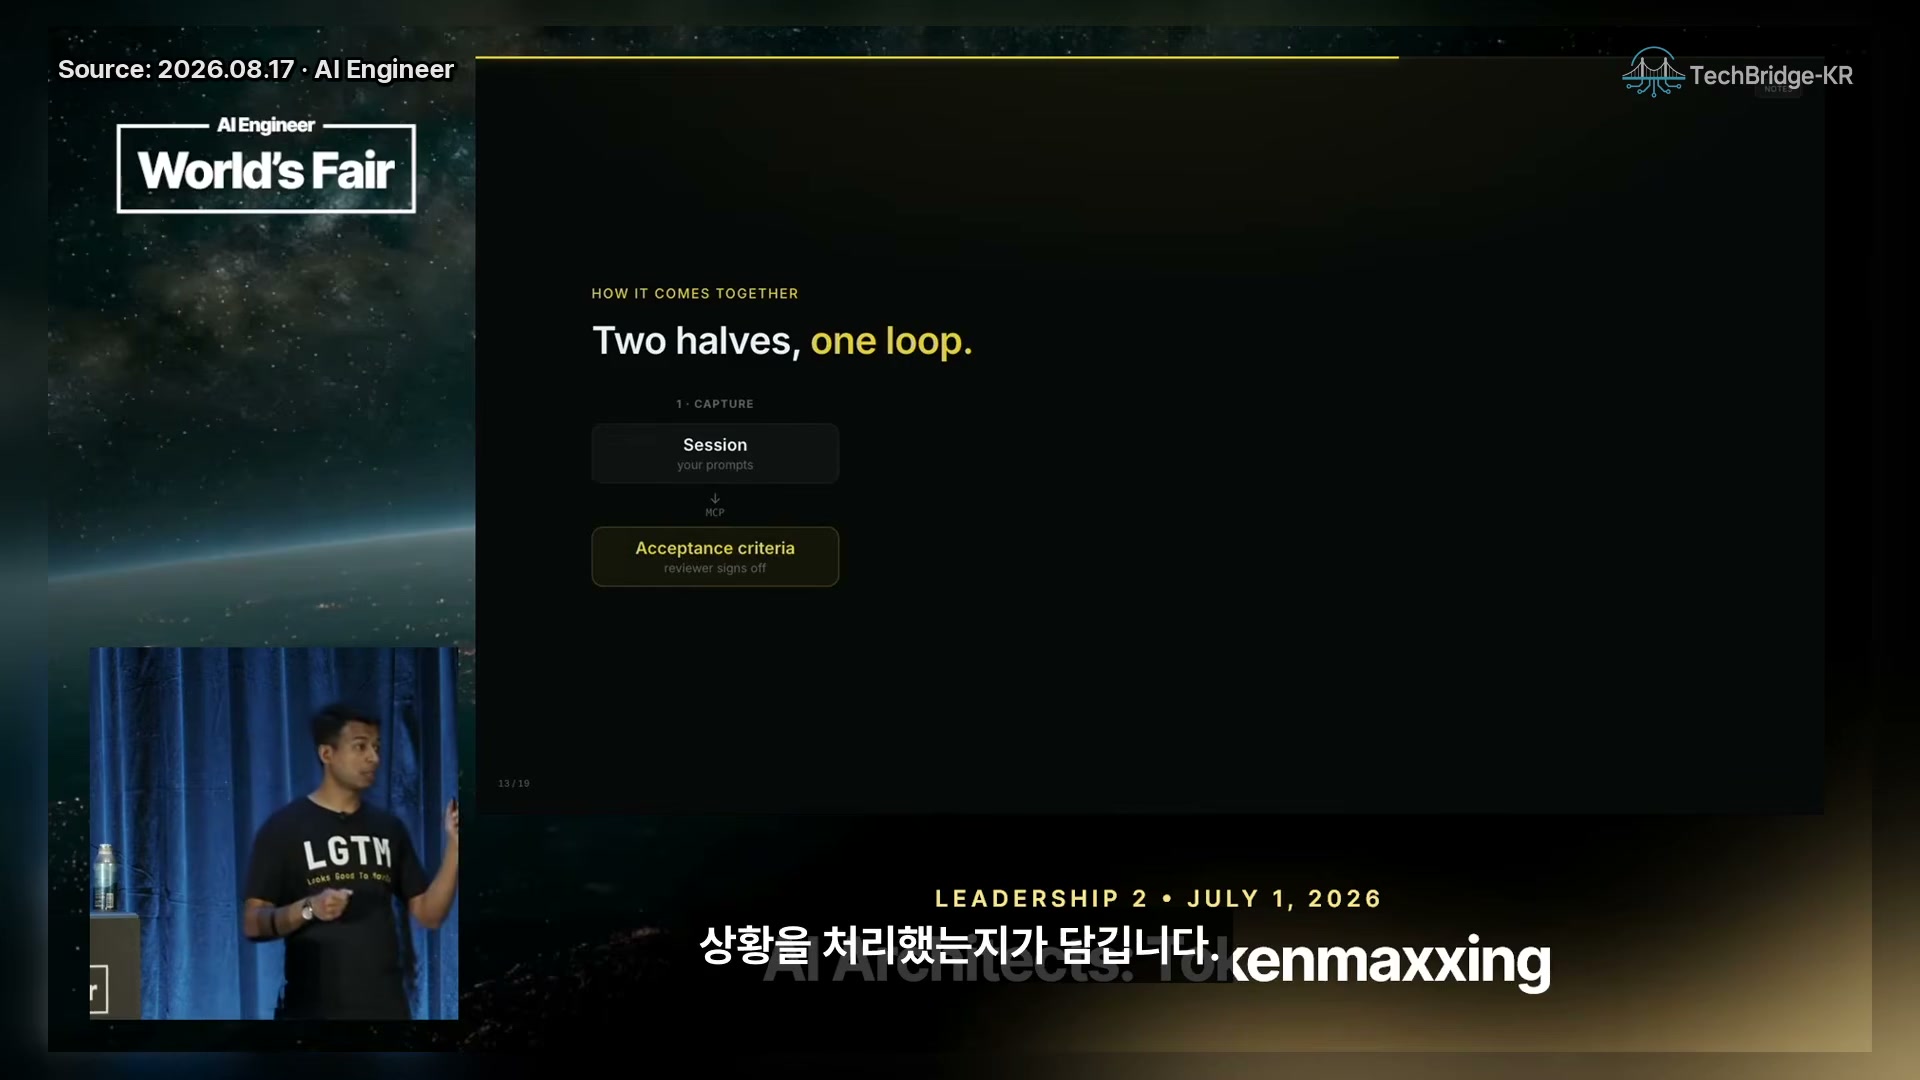
화면의 첫 단계는 Session (your prompts) → MCP → Acceptance criteria (reviewer signs off)다. 에이전트가 질문하고 사용자가 답하는 대화, 중간에 선택한 대안과 거절한 방향, “이 기능은 이런 동작이어야 한다”는 응답을 캡처해 리뷰어가 서명할 수 있는 인수 조건으로 바꾼다. 이렇게 하면 의도를 코드에서 역추론하지 않고 의도가 형성된 현장에서 보존할 수 있다.
[08:35] 9. 두 반쪽을 하나의 검증 루프로 묶기
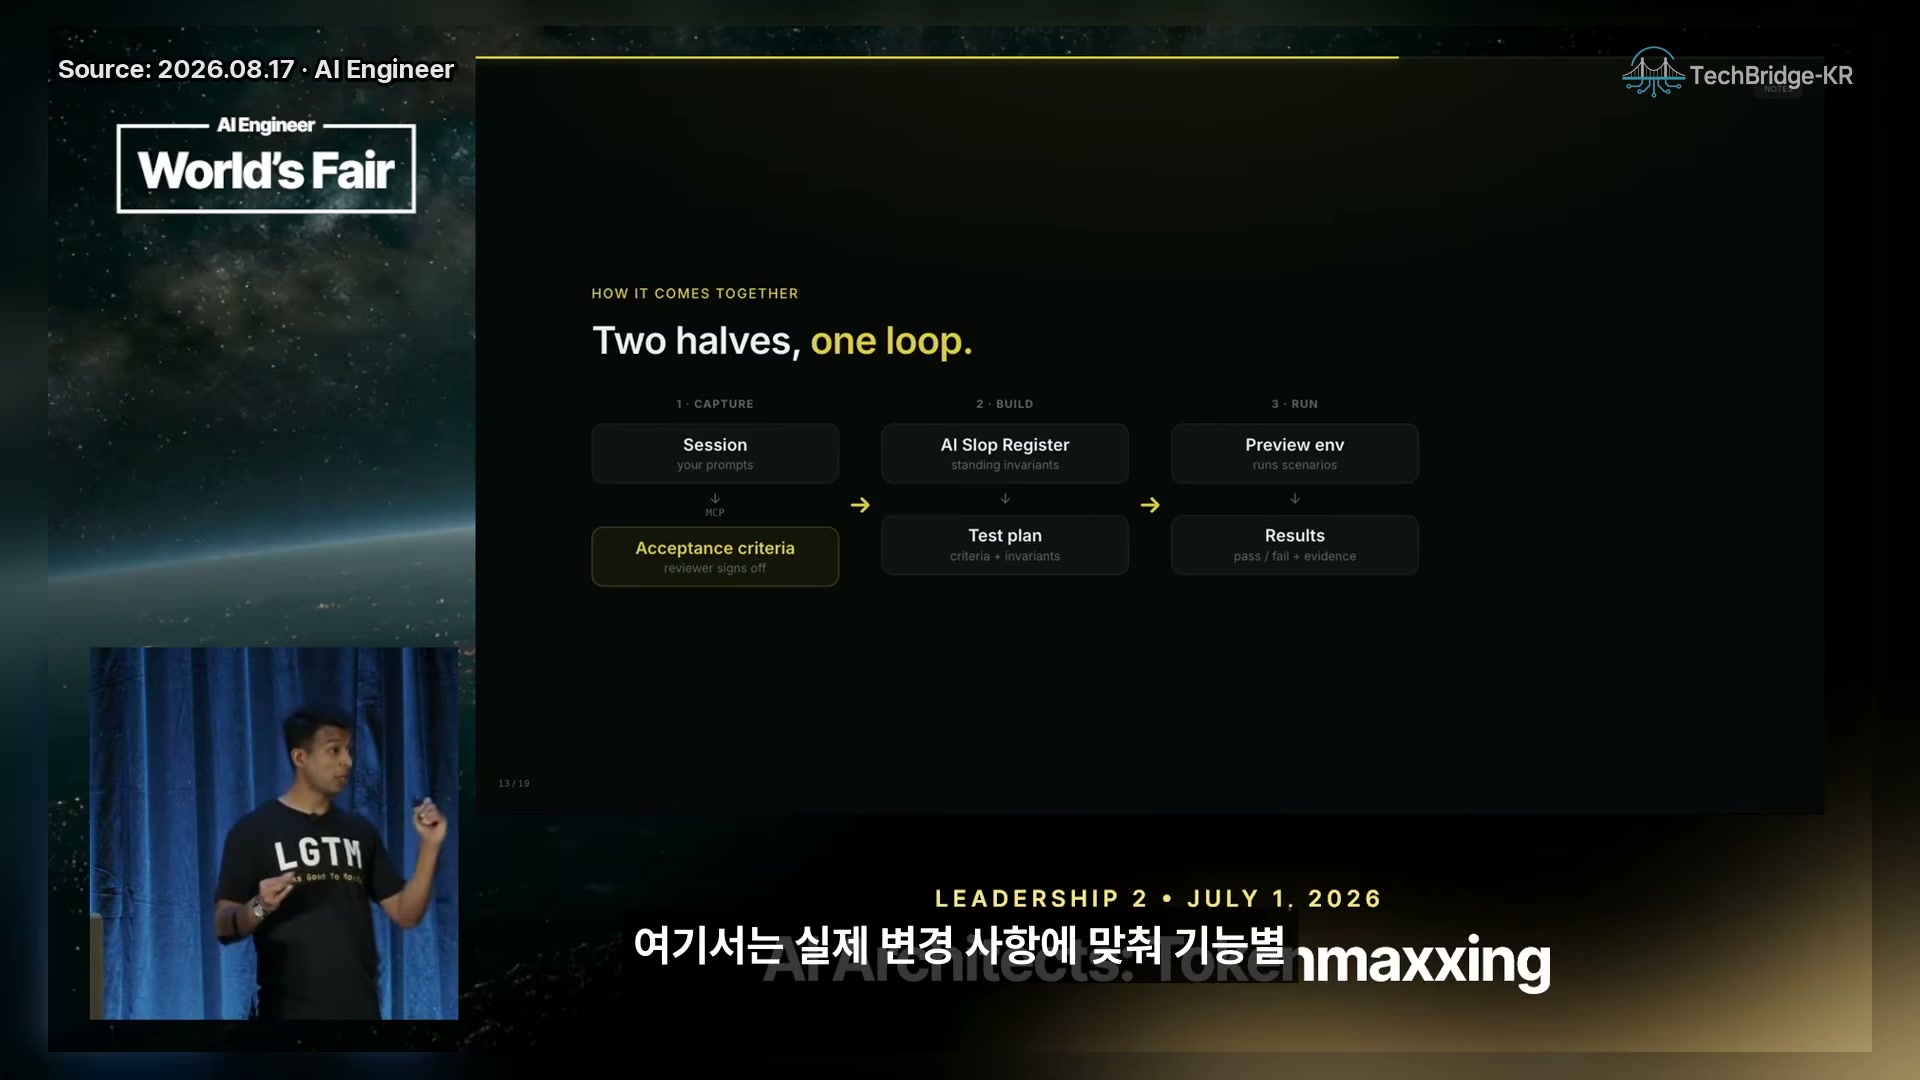
전체 흐름은 Session → Acceptance criteria, AI Slop Register → Test plan, Preview env → Results의 세 단계다. 인수 조건과 반복 규칙을 합쳐 테스트 계획을 만들고, preview 환경에서 시나리오를 실행해 pass/fail과 증거를 남긴다. 리뷰어가 보는 표면은 더 이상 “코드가 그럴듯한가?”가 아니라 의도한 기능이 구현됐는가, 요구한 행동을 실제로 만족하는가, 어떤 증거가 있는가가 된다. 아키텍처 결정과 논쟁은 여전히 사람이 다루지만, 반복적인 의미 정확성 검사는 실행 가능한 계획으로 이동한다.
[09:24] 10. 개발 세션에서 결정과 멘토링을 보존하기
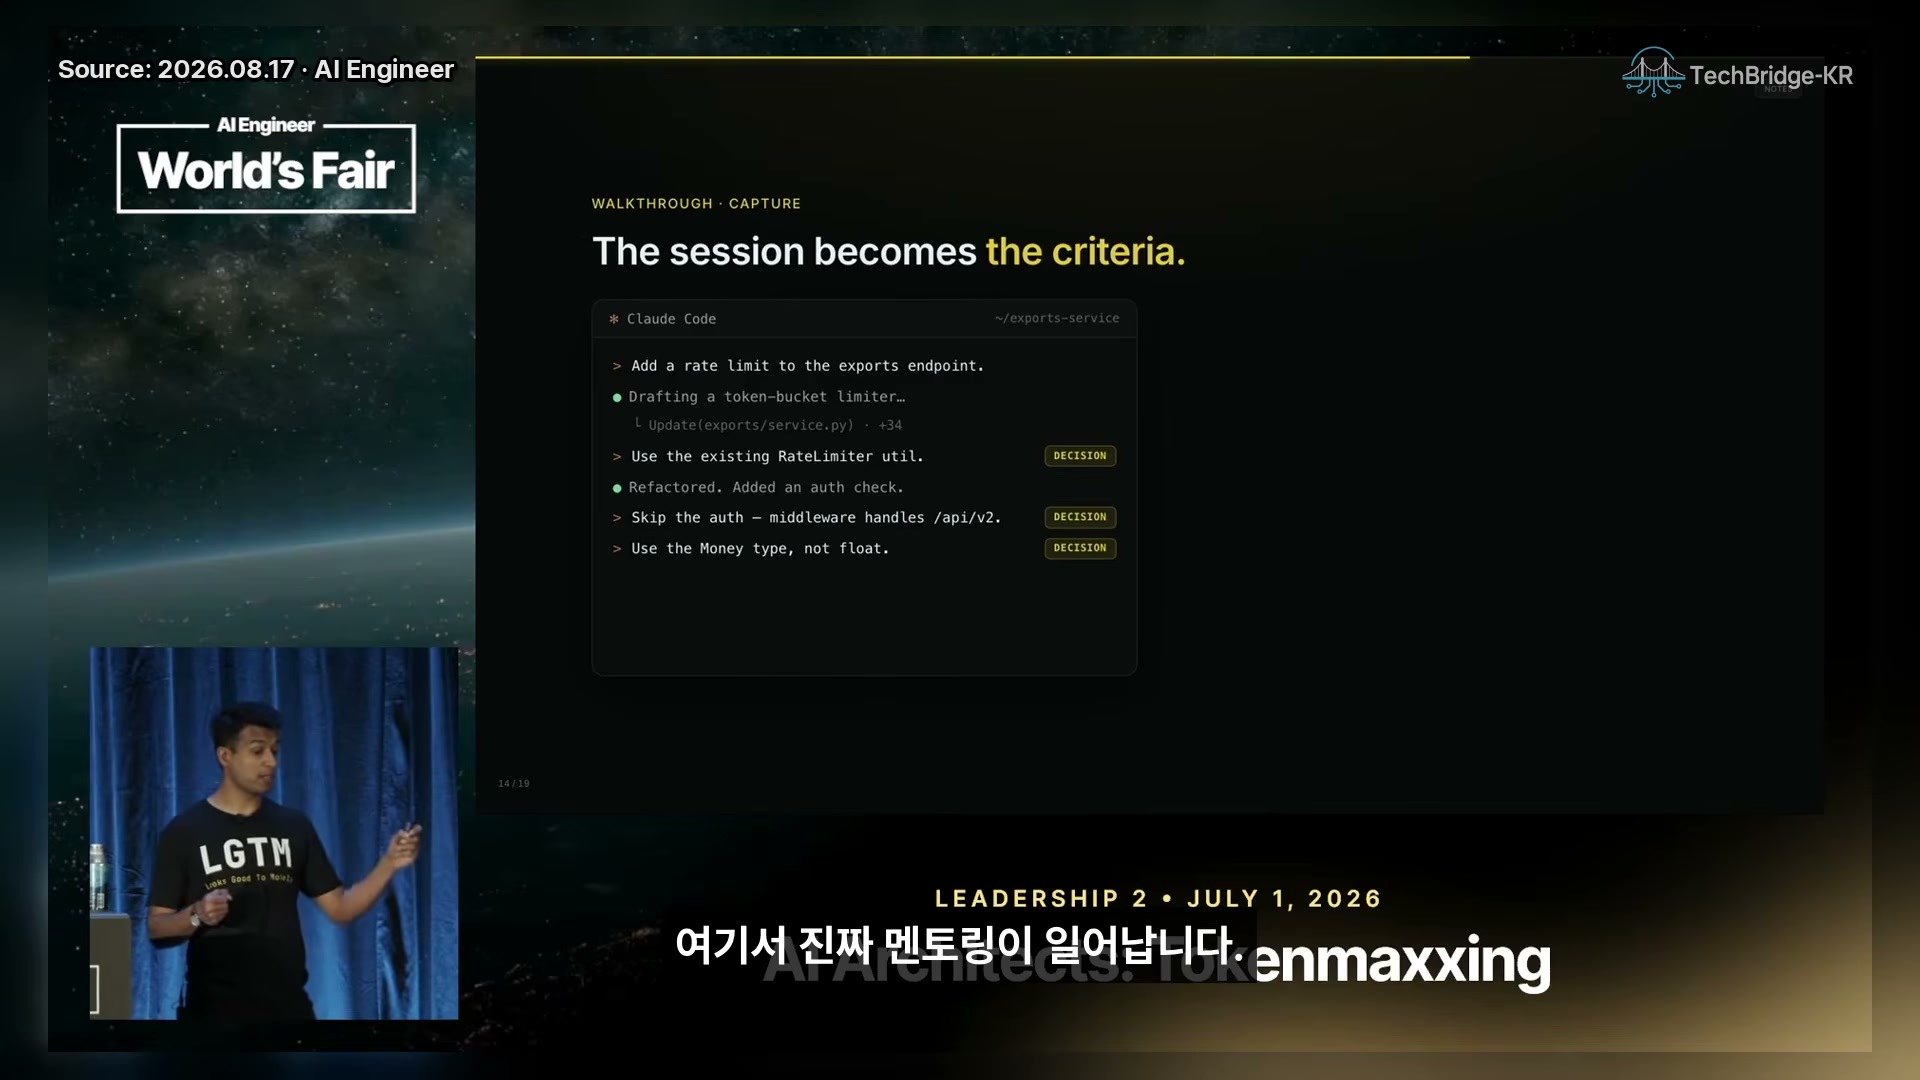
예시 세션은 exports-service에 rate limit을 추가하는 작업이다. 대화 안에 기존 RateLimiter 유틸을 쓰기, 미들웨어가 /api/v2 인증을 처리하므로 별도 인증을 건너뛰기, 금액은 float가 아니라 Money 타입을 쓰기 같은 결정이 DECISION으로 표시된다. 발표자는 이런 왕복과 질문·답변이 단순한 작업 로그가 아니라 리뷰와 협업의 가치, 그리고 주니어 엔지니어를 가르치는 멘토링의 기록이라고 본다. 이 결정을 인수 조건으로 변환하면 세션의 맥락이 테스트 가능한 형태로 남는다.
[10:26] 11. 인수 조건과 불변식에서 실행되는 테스트 계획 만들기
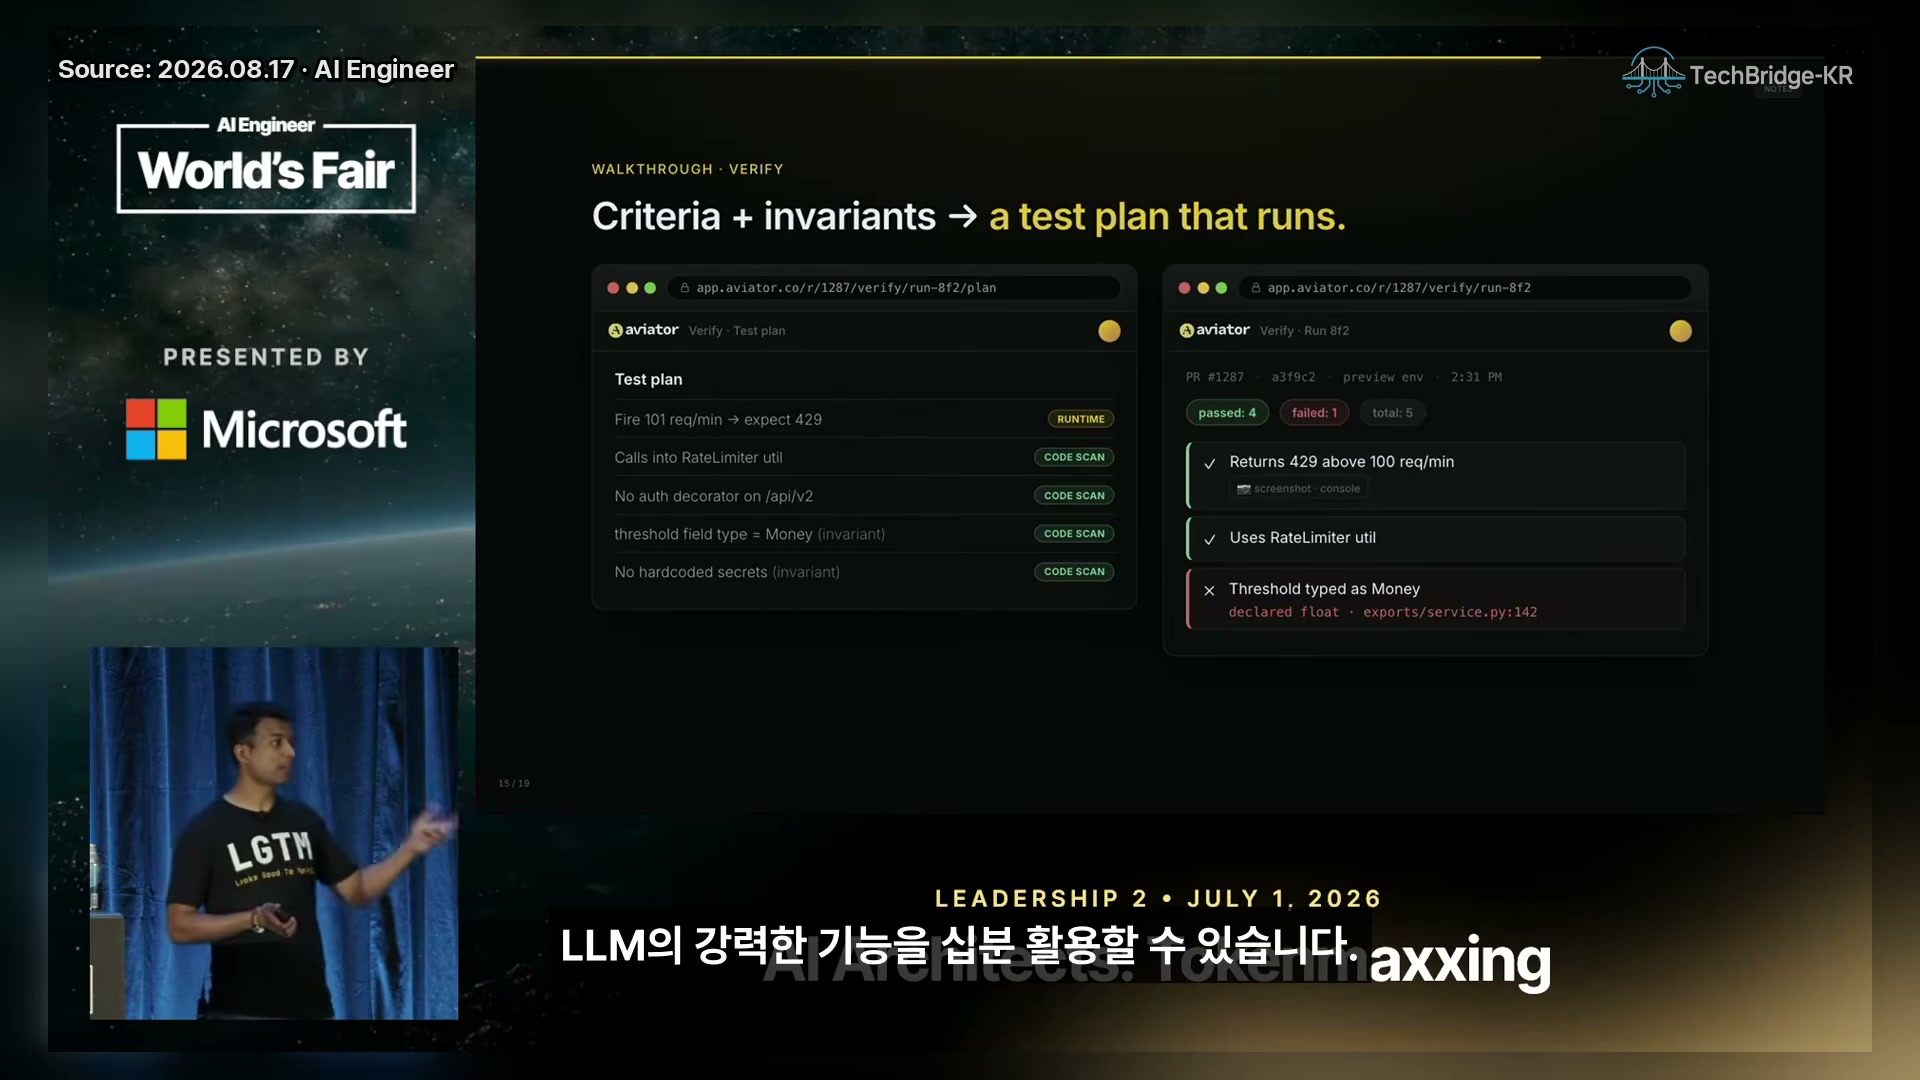
화면의 테스트 계획에는 101 req/min 요청은 429를 반환, RateLimiter 유틸 호출, /api/v2에 auth decorator 없음, threshold 필드 타입은 Money, 하드코딩된 secret 없음이 들어 있다. 오른쪽 결과는 5개 중 4개가 통과하고, threshold typed as Money 항목은 declared float · exports/service.py:142로 실패한다. 중요한 점은 테스트 계획을 사람이 매번 손으로 유지하는 대신 LLM이 세션의 인수 조건에서 초안을 만들고, 실행 가능한 코드 스캔·런타임 검사·스크린샷 증거로 검증한다는 것이다. 사람은 코드 전체를 다시 읽기보다 테스트 계획과 실패 증거를 검토한다.
[12:27] 12. 가능한 곳은 결정론적으로, 필요한 곳은 LLM으로
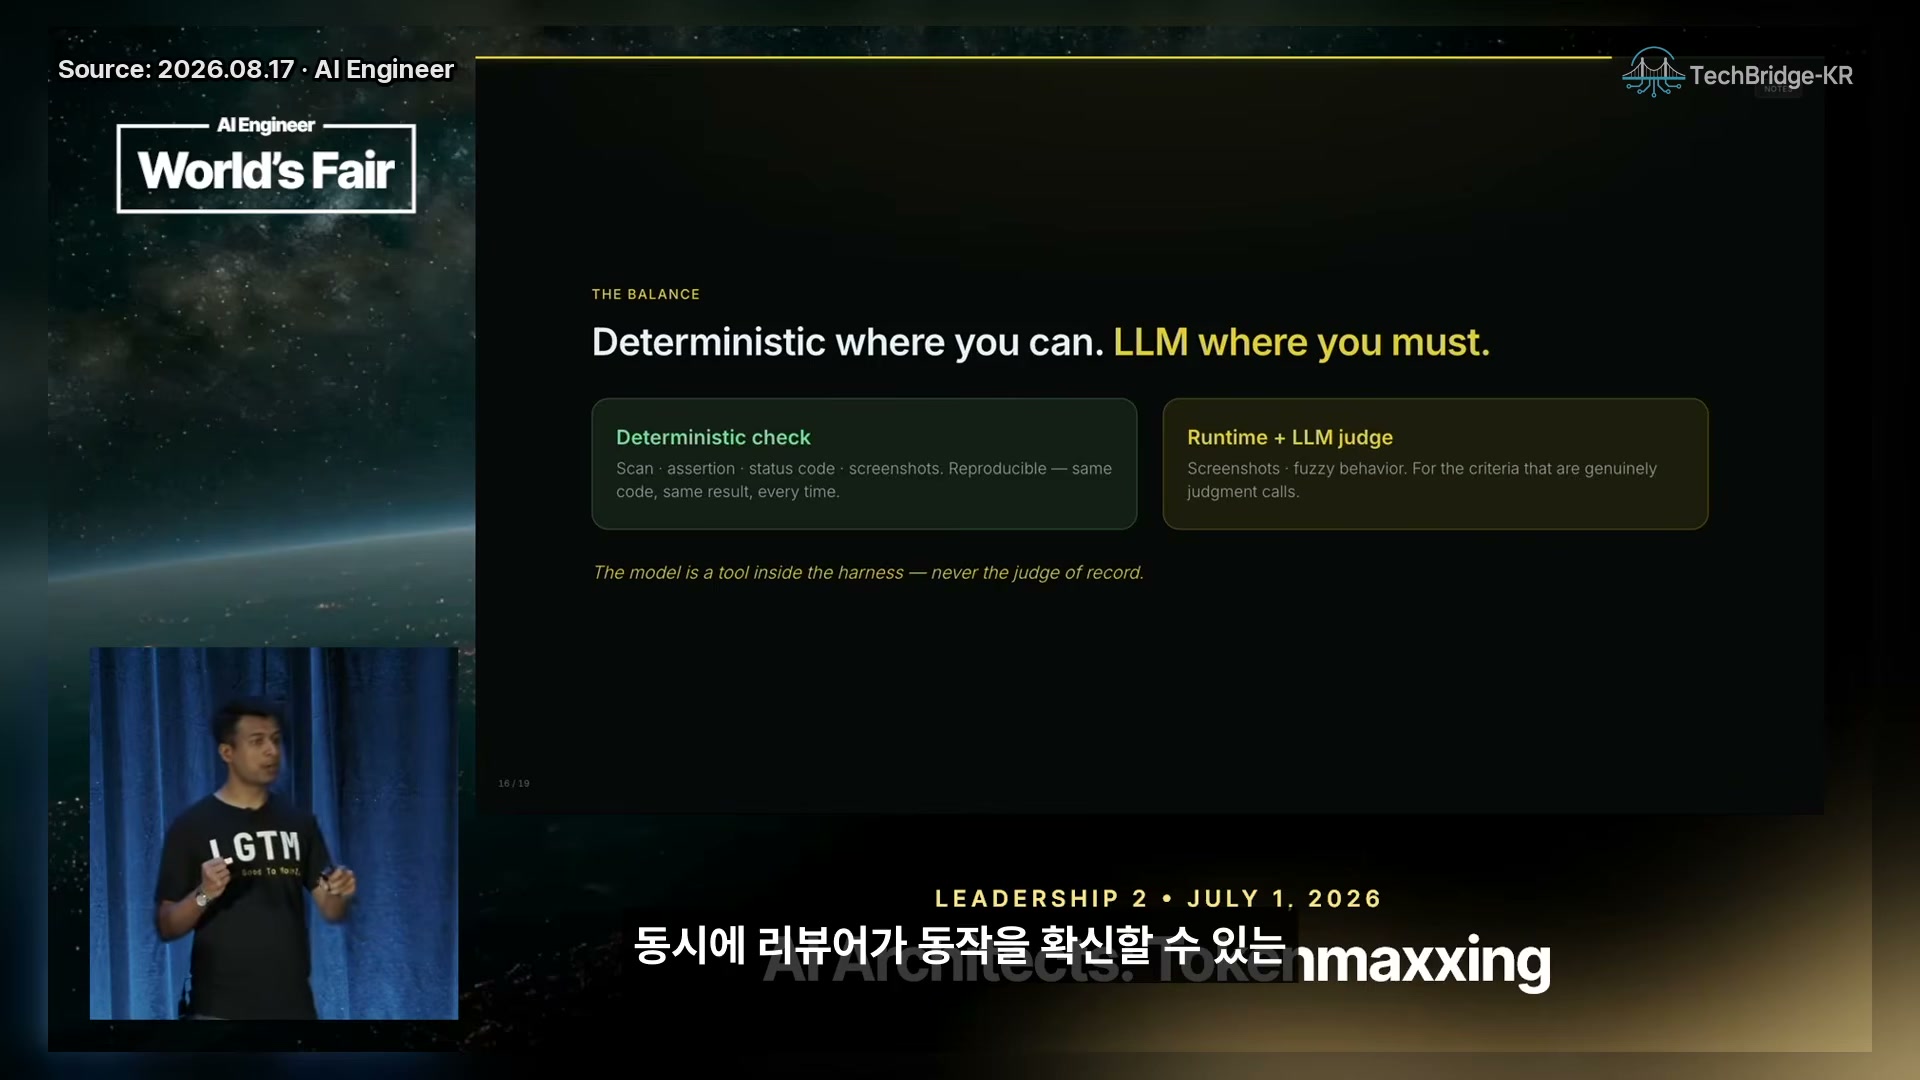
발표자가 제안하는 균형은 “Deterministic where you can. LLM where you must.” 다. scan·assertion·status code·재현 가능한 스크린샷처럼 같은 코드에 같은 결과를 내는 검사는 결정론적으로 수행한다. 반면 모호한 UI 행동이나 fuzzy behavior처럼 규칙만으로 판정하기 어려운 경우에만 runtime과 LLM judge를 사용한다. 여기서 모델은 하네스 내부의 도구이지 최종 판정 기록(judge of record) 이 아니다. 결론적으로 “AI가 검사했다”가 아니라 재현 가능한 결과와 사람이 검토할 증거가 신뢰의 근거가 된다.
[12:59] 13. 리뷰어는 diff가 아니라 의도를 리뷰한다
새 리뷰 표면은 무엇을 만들려 했는가, 어떤 결정을 했는가, 무엇을 시도했다가 거절했는가, 그 결과를 어떤 증거로 확인했는가다. 발표자는 이 정보를 코드에서 추출하려 하면 다시 같은 문제로 돌아가므로 반드시 세션에서 캡처해야 한다고 강조한다. 또한 코드를 만든 에이전트와 테스트 계획을 만든 에이전트가 완전히 같다면 결함을 놓칠 수 있으므로, 독립적인 검증 관점과 아키텍처 논의를 남겨야 한다. 인간은 모든 줄을 읽는 대신 의도·구조·증거의 적합성을 판단한다.
[14:05] 14. 숙제: 지난 1,000개 리뷰 코멘트를 채굴하기
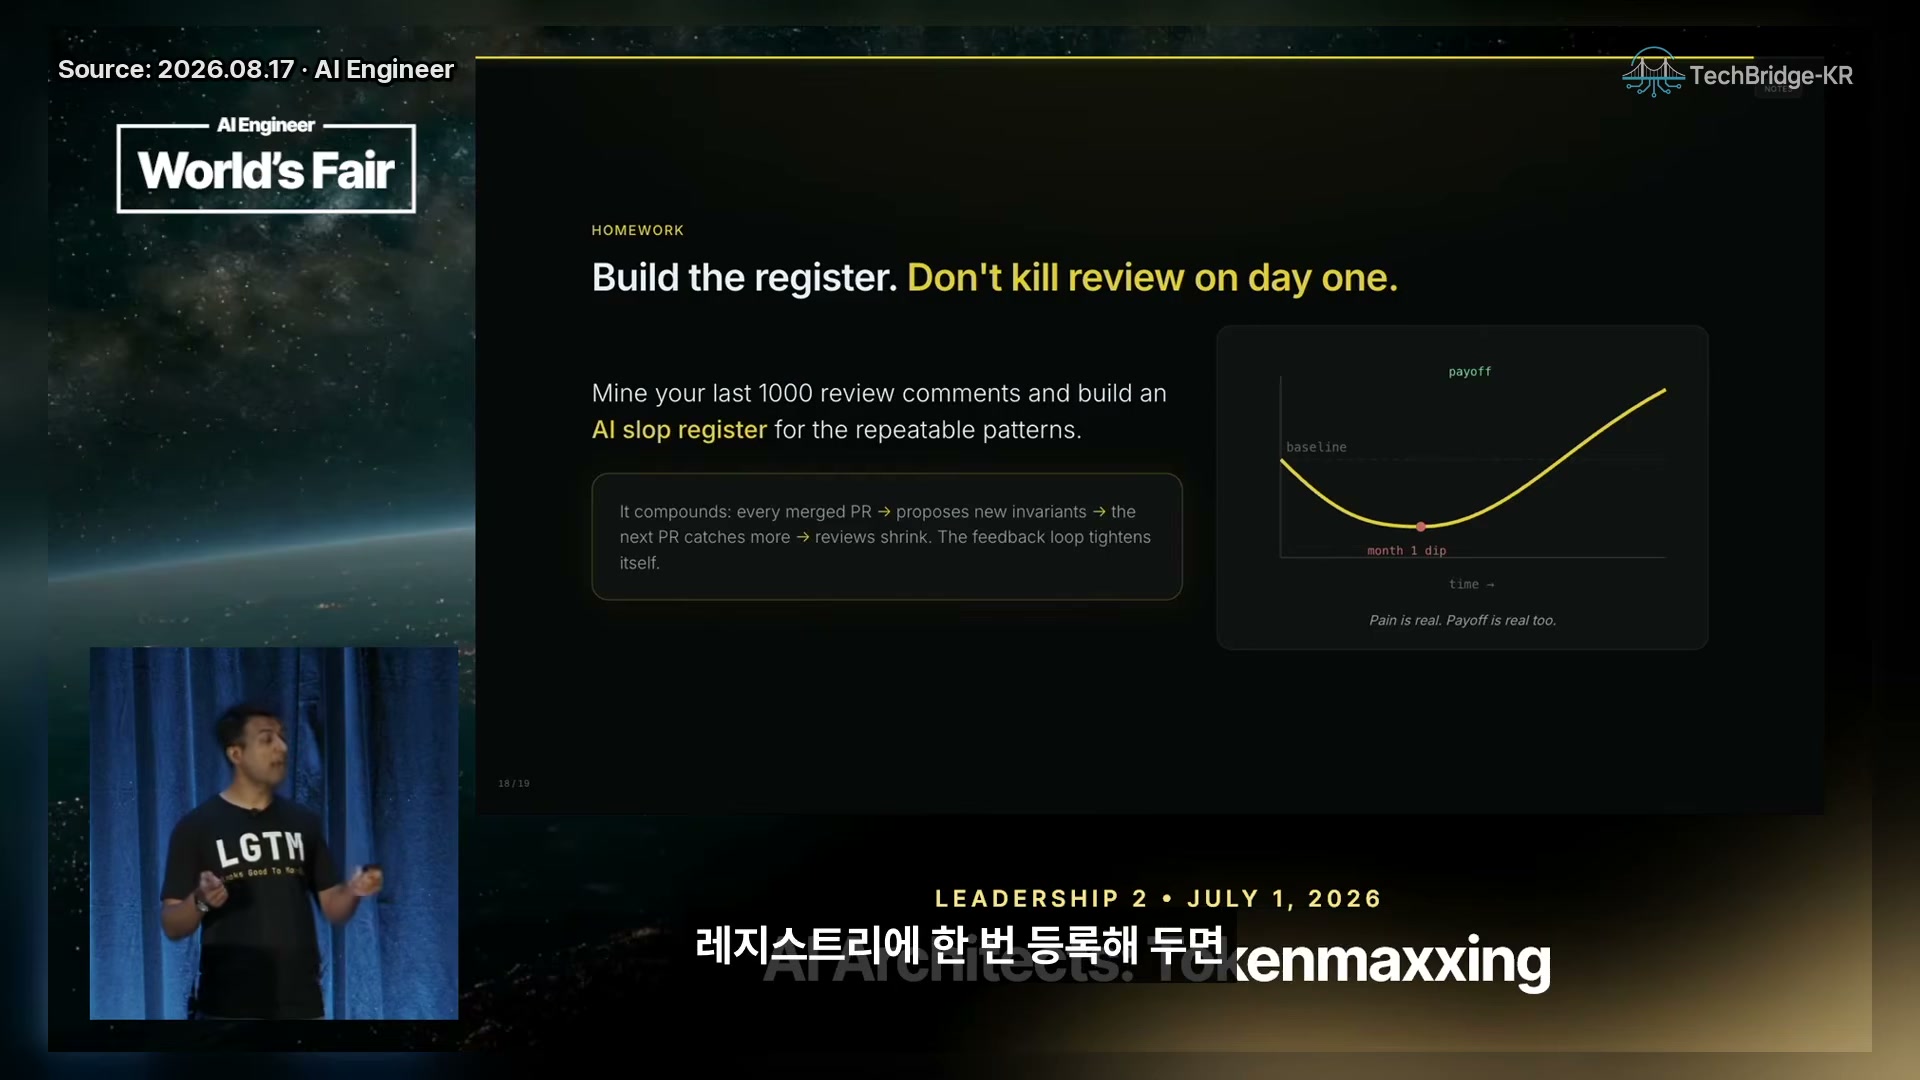
실천 과제는 지난 1,000개 리뷰 코멘트를 모아 반복 가능한 패턴을 AI Slop Register로 만드는 것이다. 처음에는 규칙을 정리하는 비용 때문에 생산성이 떨어지는 J-커브 구간을 지나지만, 매 merge PR마다 새 불변식이 쌓이면 같은 코멘트를 다시 쓰지 않아도 된다. 발표자의 결론은 첫날부터 리뷰 자체를 없애라는 것이 아니다. 반복 가능한 의미 정확성은 등록·자동화하고, 리뷰가 제공하는 정렬과 지식 공유는 더 높은 수준의 판단으로 보존하라는 것이다.
[15:18] 15. 결론: diff에서 의도로, 코멘트에서 시스템으로
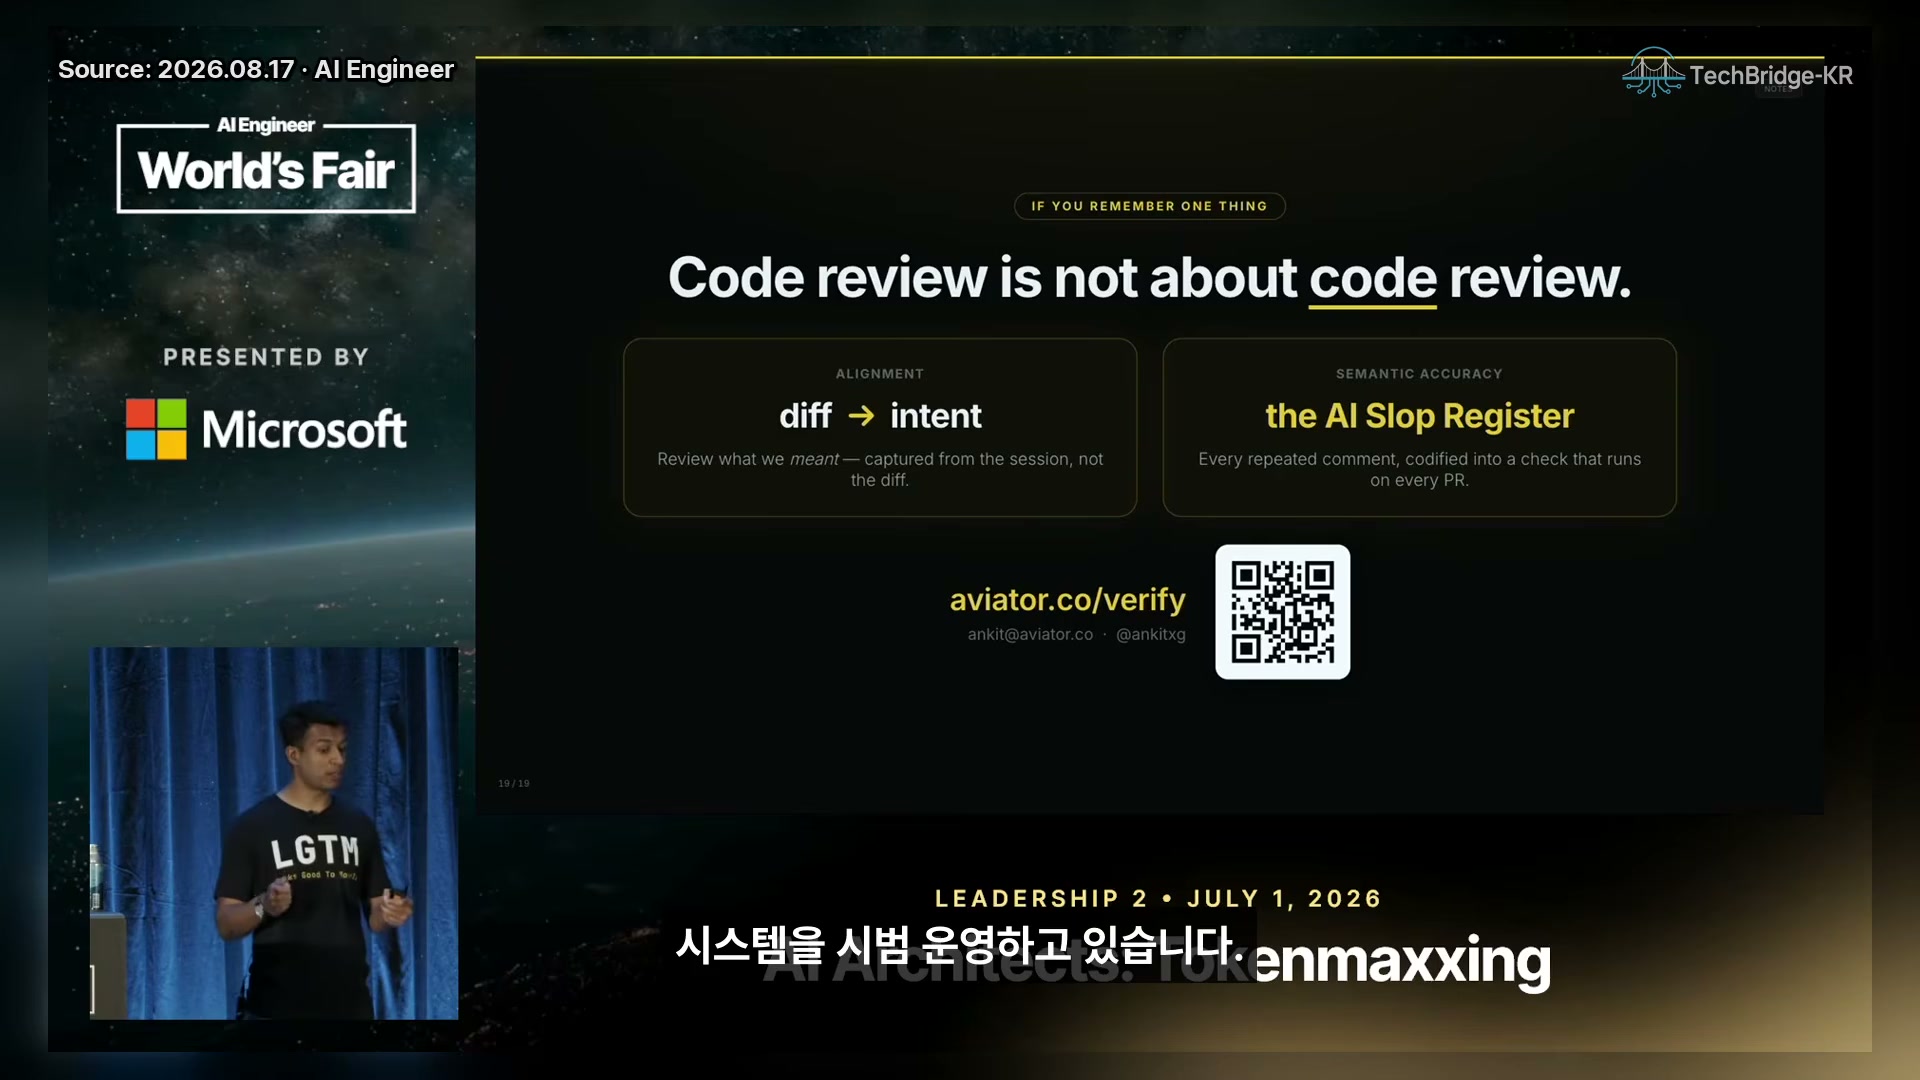
마지막 슬라이드는 메시지를 두 축으로 압축한다. 정렬 측면에서는 diff → intent, 즉 세션에서 캡처한 “우리가 무엇을 의미했는가”를 리뷰한다. 의미 정확성 측면에서는 반복되는 코멘트를 AI Slop Register로 바꾸어 모든 PR에서 검사한다. 발표자는 Aviator의 Verify를 이 두 축을 결합한 검증 시스템으로 시범 운영 중이라고 소개한다. 따라서 영상의 “코드 리뷰 제거”는 사람을 제거하는 선언이 아니라, 사람이 읽을 대상을 diff에서 의도·아키텍처·검증 증거로 바꾸자는 재정의다.
부록 — 실전 체크리스트
- 최근 리뷰 코멘트 100~1,000개를 모아 반복되는 지적과 정말 새로 판단해야 하는 논점을 분리한다.
- 팀의 리뷰 목적을 의미 정확성(버그·보안·불변식)과 정렬(의도·아키텍처·멘토링)으로 나눈다.
- 에이전트 세션에서 프롬프트, 사용자 결정, 거절한 대안, 질문·답변을 보존하고 PR에 연결한다.
- 세션의 결정을 인수 조건으로, 반복 지적을 불변식으로 변환한다.
- 결정론적 검사·런타임 시나리오·스크린샷/로그 증거를 우선 만들고, LLM judge는 모호한 부분의 보조 수단으로 제한한다.
- 리뷰어는 코드 전체가 아니라 테스트 계획, 실패 증거, 아키텍처 결정, 의도와 결과의 정합성을 검토한다.
- 검증 루프가 안정화되기 전에는 인간 리뷰를 성급히 삭제하지 않는다.
원문 인용 모음
- [00:30] “How to Kill the Code Review.”
- [02:44] “When AI reviews AI in a UI nobody reads, you’ve configured the wrong thing.”
- [03:19] “Code review is not about code review.”
- [04:28] “Spec-driven development is waterfall in new clothes.”
- [05:40] “The most important part is the intent.”
- [06:39] “The AI Slop Register.”
- [08:35] “The session becomes the criteria.”
- [11:41] “Deterministic where you can. LLM where you must.”
- [12:58] “Reviewers review intent. Not diffs.”
- [14:05] “Build the register. Don’t kill review on day one.”
발표자의 다른 코드 리뷰 자료 (2026-08-23 조사)
강연자 본인의 발표·집필:
- How to Kill the Code Review — Latent.Space 게스트 포스트 (2026-03-02) — 이 강연의 원고가 된 에세이. “코드 리뷰는 2026년에 죽는다”는 원 논지.
- I said code review was dead. Here’s what I got wrong – and right — Aviator Blog (2026-03-24) — 위 주장에 대한 스스로의 회고·보정.
- AI killed the code review. What happens to knowledge sharing? — CIO.com (2026-06-02) — 리뷰의 지식 공유 기능이 사라질 때의 대안.
- How long before we stop reading the code? — Aviator Blog (2026-07-09)
- How to kill the code review — Aviator Blog (2026-07-22)
- Move code review before the code — Aviator Blog (2026-08-03) — 검증을 PR 이후가 아닌 생성 이전으로 옮기는 논의.
- Code review is a taste problem — The New Stack (2026-08-13, GitHub David Poll 공동 집필)
- How do you go from junior to staff engineer when AI writes the code? — CIO.com (2026-07-14)
본인이 호스트로 진행한 인터뷰(HangarDX 팟캐스트, 코드 리뷰 관련):
- Ship to Production Without Code Review? — Jade Rubick (2026-05-21)
- What Happens to Code Review When Agents Write the Code — Vanitha Kumar(Thoughtworks) (2026-07-16)
- GitHub’s David Poll on the Future of Code Review (2026-08-13)
AI Engineer World’s Fair 2026 공식 세션 페이지(본 영상의 원 발표): aiengineer.podhood.com 요약, 행사 일정
이 강연을 넓히기 — 볼트 종합 관점
이 강연의 처방(“diff → intent”, 반복 검사 자동화, 정렬 보존)은 볼트 안의 다른 노트들과 합쳐지면 하나의 방향론이 된다.
- 2026-07-27-agentos-why-software-factories-fail — 리뷰를 실제로 3개월간 없애봤다가 되돌린 사례. “리뷰 제거”가 아니라 계획·정렬 단계를 앞으로 당겨 리뷰를 짧게 만드는 것이 답이라는 상반된 실험이 같은 결론에 도달한다.
- loop-engineering — 구현 에이전트와 검증 에이전트의 분리, 병렬성보다 리뷰 대역폭 우선, 증거를 갖춘 핸드오프라는 설계 원칙이 강연의 검증 루프를 운영 차원에서 받쳐 준다.
- 2026-08-03-agentos-own-the-outer-loop — “96%가 AI 코드를 불신하지만 항상 검증하는 사람은 48%“라는 통계가 왜 의도·증거 리뷰로의 전환이 필요한지 수치로 보여준다.
- 2026-07-26-alibaba-open-code-review — 결정론 파이프라인 + LLM 에이전트 하이브리드로 “반복 가능한 의미 정확성”을 자동화한 오픈소스 사례.
위 노트들을 종합한 실무 가이드는 2026-08-23-ai-era-code-review-guide에 정리했다. 한 줄 요약: 리뷰는 사라지지 않고 재분배된다 — 반복 검사는 시스템으로, 의도·아키텍처·증거 판단은 사람으로.
연결
- moc-ai-coding — AI 코딩 도구·하네스·운영면의 관련 노트
- moc-ai-agents — 에이전트가 수행하는 코드 생성·검증 루프
- 2026-07-27-agentos-why-software-factories-fail — 에이전트 PR을 둘러싼 코드 리뷰와 하네스의 한계
- 2026-07-26-alibaba-open-code-review — 결정론적 검사와 LLM 에이전트를 결합한 코드 리뷰 사례
- loop-engineering — 반복 작업을 자동화·검증 루프로 바꾸는 설계 관점