출처 https://youtu.be/gXPdfXxIRqg · 채널 AgentOS · 길이 11:54 · 공개 2026-08-03 01:32 (KST) 포맷 앞선 2026-07-27-agentos-why-software-factories-fail와 같은 구조다. 뼈대는 애디 오스마니(Addy Osmani, 전 Google Cloud AI/Gemini 디렉터)가 AI Engineer World’s Fair 2026 클로징 키노트에서 한 발표 “Own the Outer Loop”(18분, https://www.youtube.com/watch?v=n97BCfyFIvw )의 원본 클립이고, 그 사이를 AgentOS 채널의 한국어 해설이 잇는다. 이 노트는 장면마다 발표(오스마니) 와 해설(AgentOS) 을 구분해 표시했다. 같은 내용의 원문 글은 https://addyosmani.com/blog/own-the-outer-loop/ 에 있다. 원본 자막(자동 생성):
raw/transcripts/2026-08-03-agentos-own-the-outer-loop.ko-orig.srt,.en.srt표기 주의 yt-dlp가 받아온
ko-orig자막은 해설 구간의 한국어 음성인식이라 고유명사가 대부분 깨진다(에디 오스만,코어 웹 바이타,오D뒤 아우터로프,재미나이,DK, 마지막 정리에서는역량이 통째로영향,고리가꼬리로 잡혔다). 발표 구간의 인용은 영상에 입혀진 채널 한국어 자막과 영어 자막을 화면에서 직접 읽어 옮겼고, 슬라이드 위 수치·출처는 캡처를 확대해 대조했다 —Sonar State of Code Developer Survey report 2026,GitLab AI accountability research, June 2026,OpenAI Economic Research, June 25 2026,Anthropic, 52 engineers. 자동자막이not my로 뭉갠 03:34 구절은 화면 자막이 “not mystique”(신비주의가 아니다)로 확인됐다.
한눈에 보는 요약
- 만드는 비용만 내려갔다. Sonar 「State of Code 2026」 기준 커밋된 코드 중 AI가 만들었거나 상당 부분 도운 비율은 2023년 6% → 2024년 19% → 지금 42%, 2026년 55%·2027년 65%로 전망된다. 슬라이드의 한 줄이 정확하다 — “공장은 더 이상 실험이 아니다. 커밋 히스토리에 들어오고 있다.”
- 그런데 확인하는 비용은 그대로다. 같은 조사에서 96%가 AI 코드를 온전히 신뢰하지 않지만, 커밋 전에 항상 검증하는 사람은 48%뿐이고 38%는 AI 코드 리뷰가 사람 코드보다 더 오래 걸린다고 답했다. 위험은 불신 자체가 아니라 불신하면서도 검증보다 빠르게 배포하는 것이다.
- 답을 찾으려고 발표는 용어 두 개를 꺼낸다 — 알파와 디케이. 알파는 지금 모델이 할 수 있는 것보다 내가 의미 있게 더 나은 지점(내 강점)이고, 디케이는 그 격차를 모델이 따라잡는 속도다. 모든 역량에는 시계가 걸려 있다.
- 디케이 테스트를 통과하는 역량은 없다. 속도는 끝났고(커피 뽑는 사이 600줄), 기억력도 끝났고(이제 컨텍스트 윈도다), 검증은 하네스·이밸·정적 검사·모델 크리틱으로 자동화되는 중이다. 취향조차 알파이고, 모델이 예시와 선호를 학습할 때마다 리셋된다. 판단도 벽이 아니라 경사면이다.
- 그래서 질문을 바꾼다. “에이전트가 뭘 할 수 있나”는 더 이상 전략적 질문이 아니다(못 하는 것의 목록은 계속 줄어든다). “오직 사람만이 답변 책임을 질 수 있는 게 뭔가” 로 바꾼다.
- 에이전트를 쓸수록 조용히 새는 게 셋 있다. ① 인지 부채 — 레포에 존재하는 코드와 팀이 진짜로 이해하는 코드 사이의 격차(Anthropic 조사에서 AI 생성 코드로 배우면 이해도가 17%p 낮았다, 50% vs 67%). ② 인지적 항복 — 내 의견을 만들기 전에 AI의 답을 내 답으로 삼는 것(와튼 1,372명, AI가 틀렸을 때 73%가 그대로 받아들이고 더 확신했다). ③ 오케스트레이션 세금 — 에이전트를 더 돌린다고 내가 더 생기지 않는다. 인지 대역폭은 병렬화되지 않는다.
- 셋의 공통점은 하나다 — 결과물은 남는데 내 판단력이 깎인다.
- 안쪽 고리는 역량, 바깥 고리는 에이전시다. 에이전트가 조사·구현·테스트·보고를 하고 증거(디프·테스트·로그·근거·트레이스·트라젝토리·스크린샷)를 돌려주면, 거기서부터가 엔지니어링이다 — 할 가치가 있었는지 결정하고, 증거가 충분한지 검증하고, 프로덕션에 나가는 것을 승인하거나 되돌리고 책임진다. 경계는 “사람이 화면을 들여다보느냐”가 아니라 증거와 책임이다.
- 커리어 계산이 한 줄로 나온다. “엣지의 반감기는 릴리스 한 번, 서명의 반감기는 커리어 전체다.” 스킬은 레버리지를 벌고, 책임은 그 레버리지를 신뢰로 바꾼다.
- 마지막이 이 발표의 정수다. 소프트웨어를 만들기 쉬워질 때마다 사람들은 세상이 소프트웨어를 덜 필요로 할 거라 예측했다 — 고급 언어, 프레임워크, 클라우드, 로우코드. 매번 반대로 갔다. 에이전트도 엔지니어링을 없애는 게 아니라 병목을 옮긴다 — “이걸 만들 수 있나”에서 “이게 존재해야 하나, 그리고 우리가 그걸 책임질 수 있나” 로.
장면별 상세 설명
[00:00] 1. (해설) AI가 틀렸을 때, 73%가 그대로 받아들였다
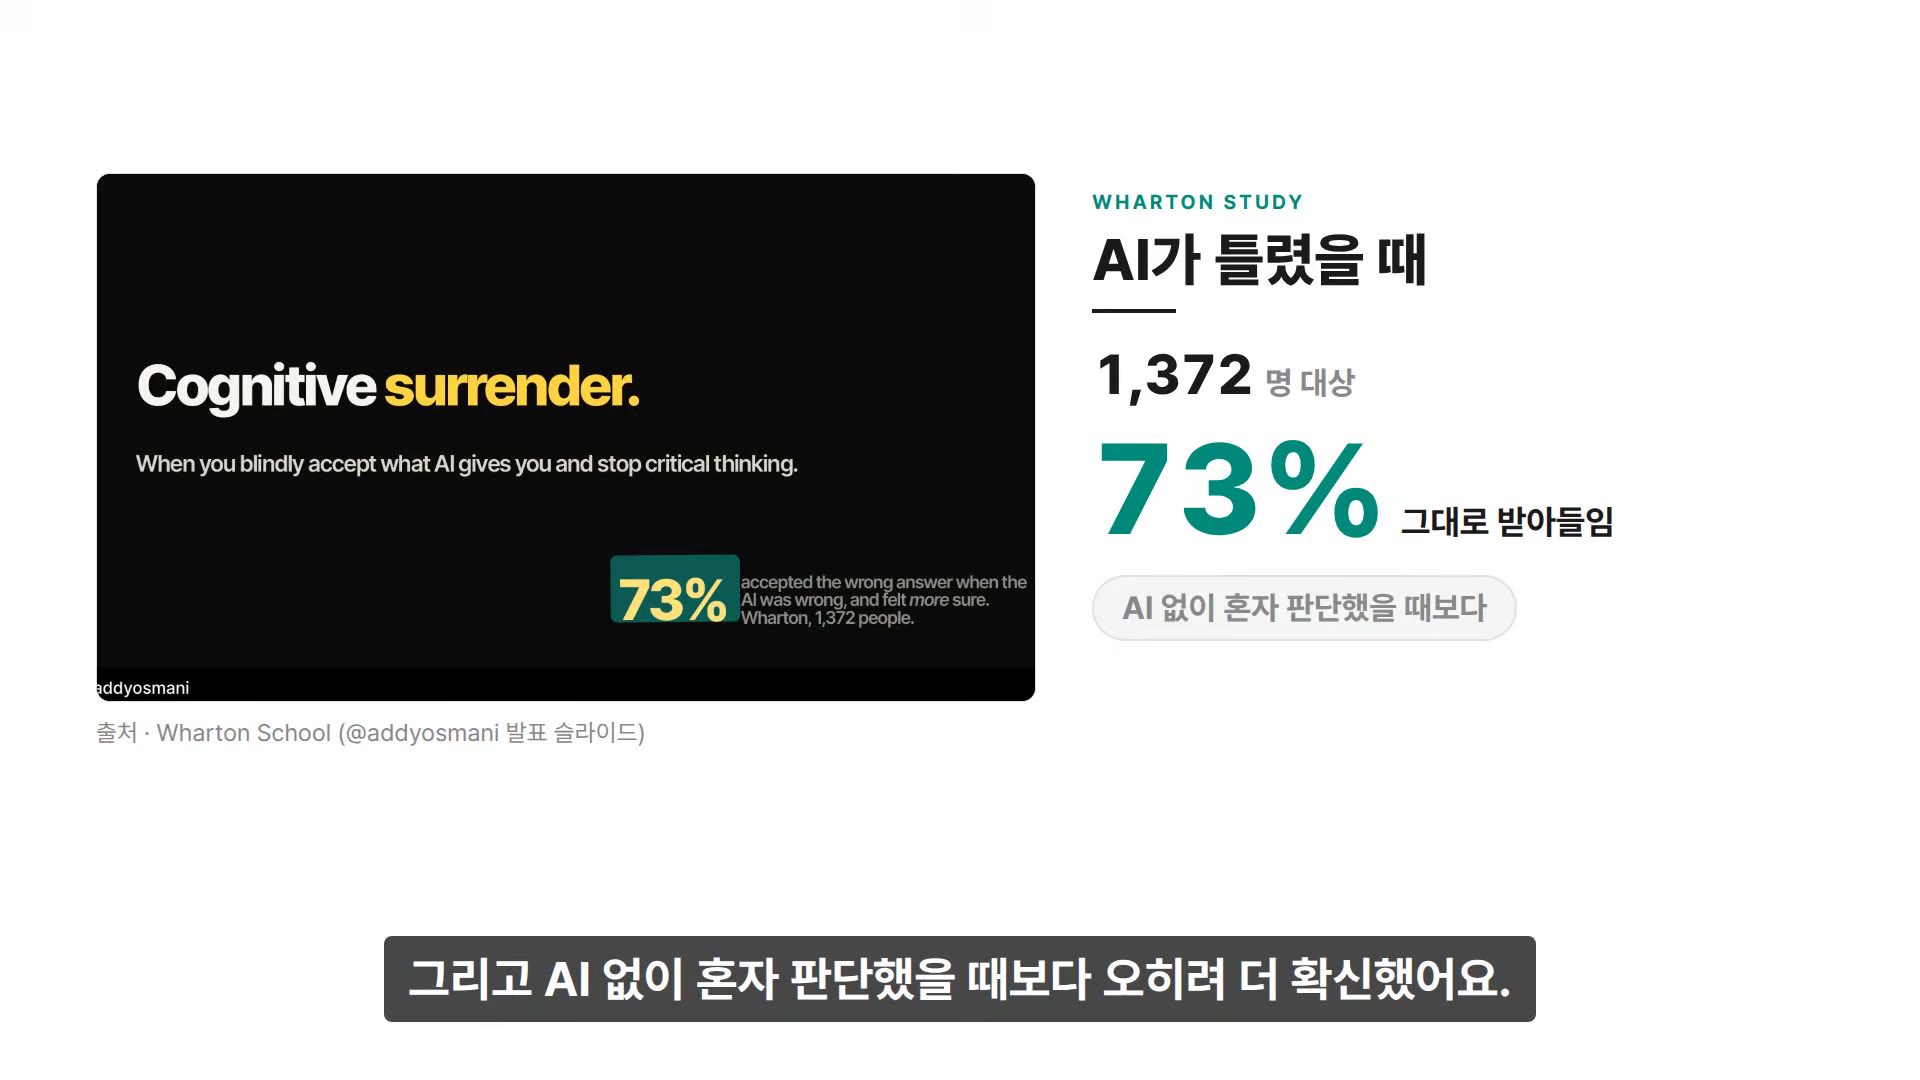
해설은 숫자 하나로 시작한다. 와튼 스쿨이 1,372명을 대상으로 한 실험에서, AI가 틀린 답을 줬을 때도 73%가 그 답을 그대로 받아들였다. 더 나쁜 건 그다음이다 — AI 없이 혼자 판단했을 때보다 오히려 더 확신했다.
이 숫자는 뒤에 발표의 “인지적 항복(cognitive surrender)” 슬라이드로 다시 나온다. 슬라이드의 정의는 **“AI가 주는 것을 맹목적으로 받아들이고 비판적 사고를 멈추는 것”**이다.
[00:13] 2. (해설) 이 숫자를 꺼낸 사람 — 애디 오스마니
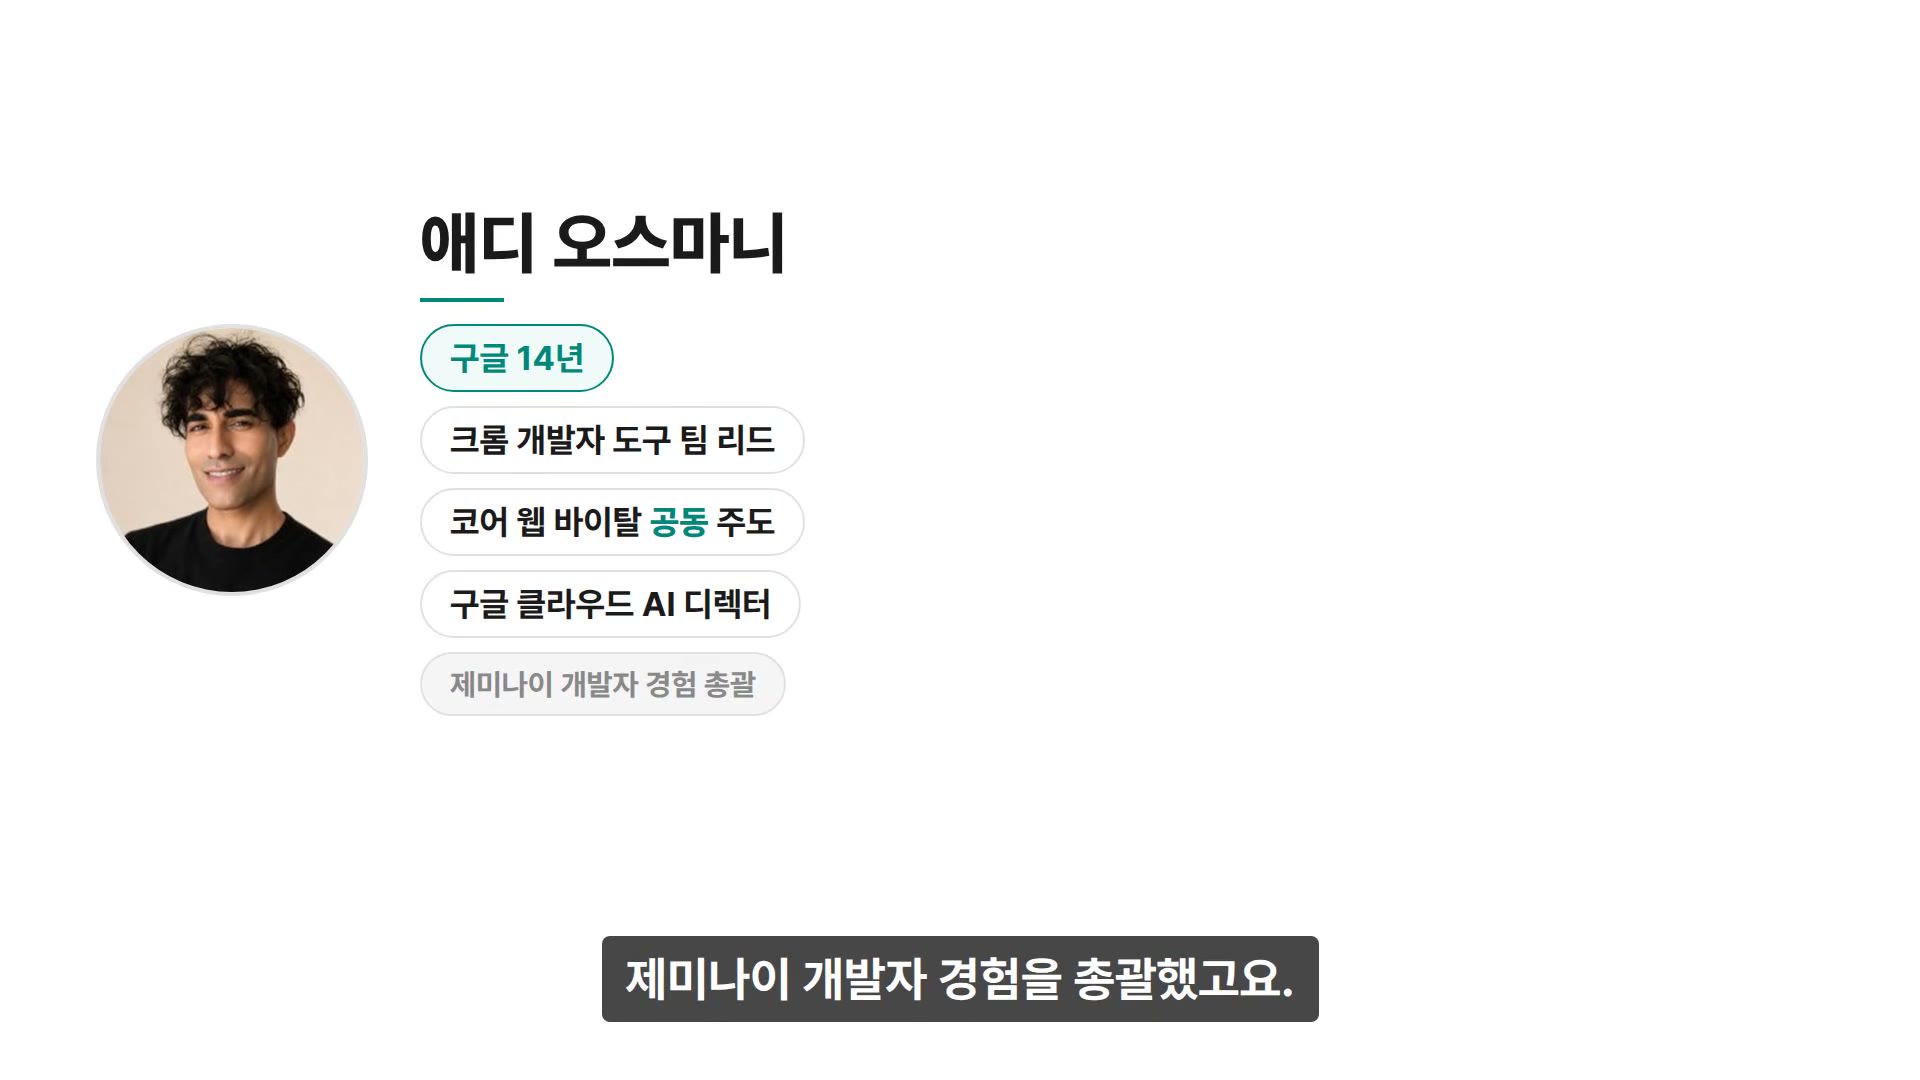
애디 오스마니(Addy Osmani)는 구글에서 14년을 보내며 크롬 개발자 도구 팀을 이끌었고 코어 웹 바이탈(Core Web Vitals)을 공동 주도했다. 마지막에는 구글 클라우드 AI 디렉터로 제미나이 개발자 경험을 총괄했다. 발표 하단 자막이 그를 소개하는 방식도 같다 — Former Director of Google Cloud AI/Gemini.
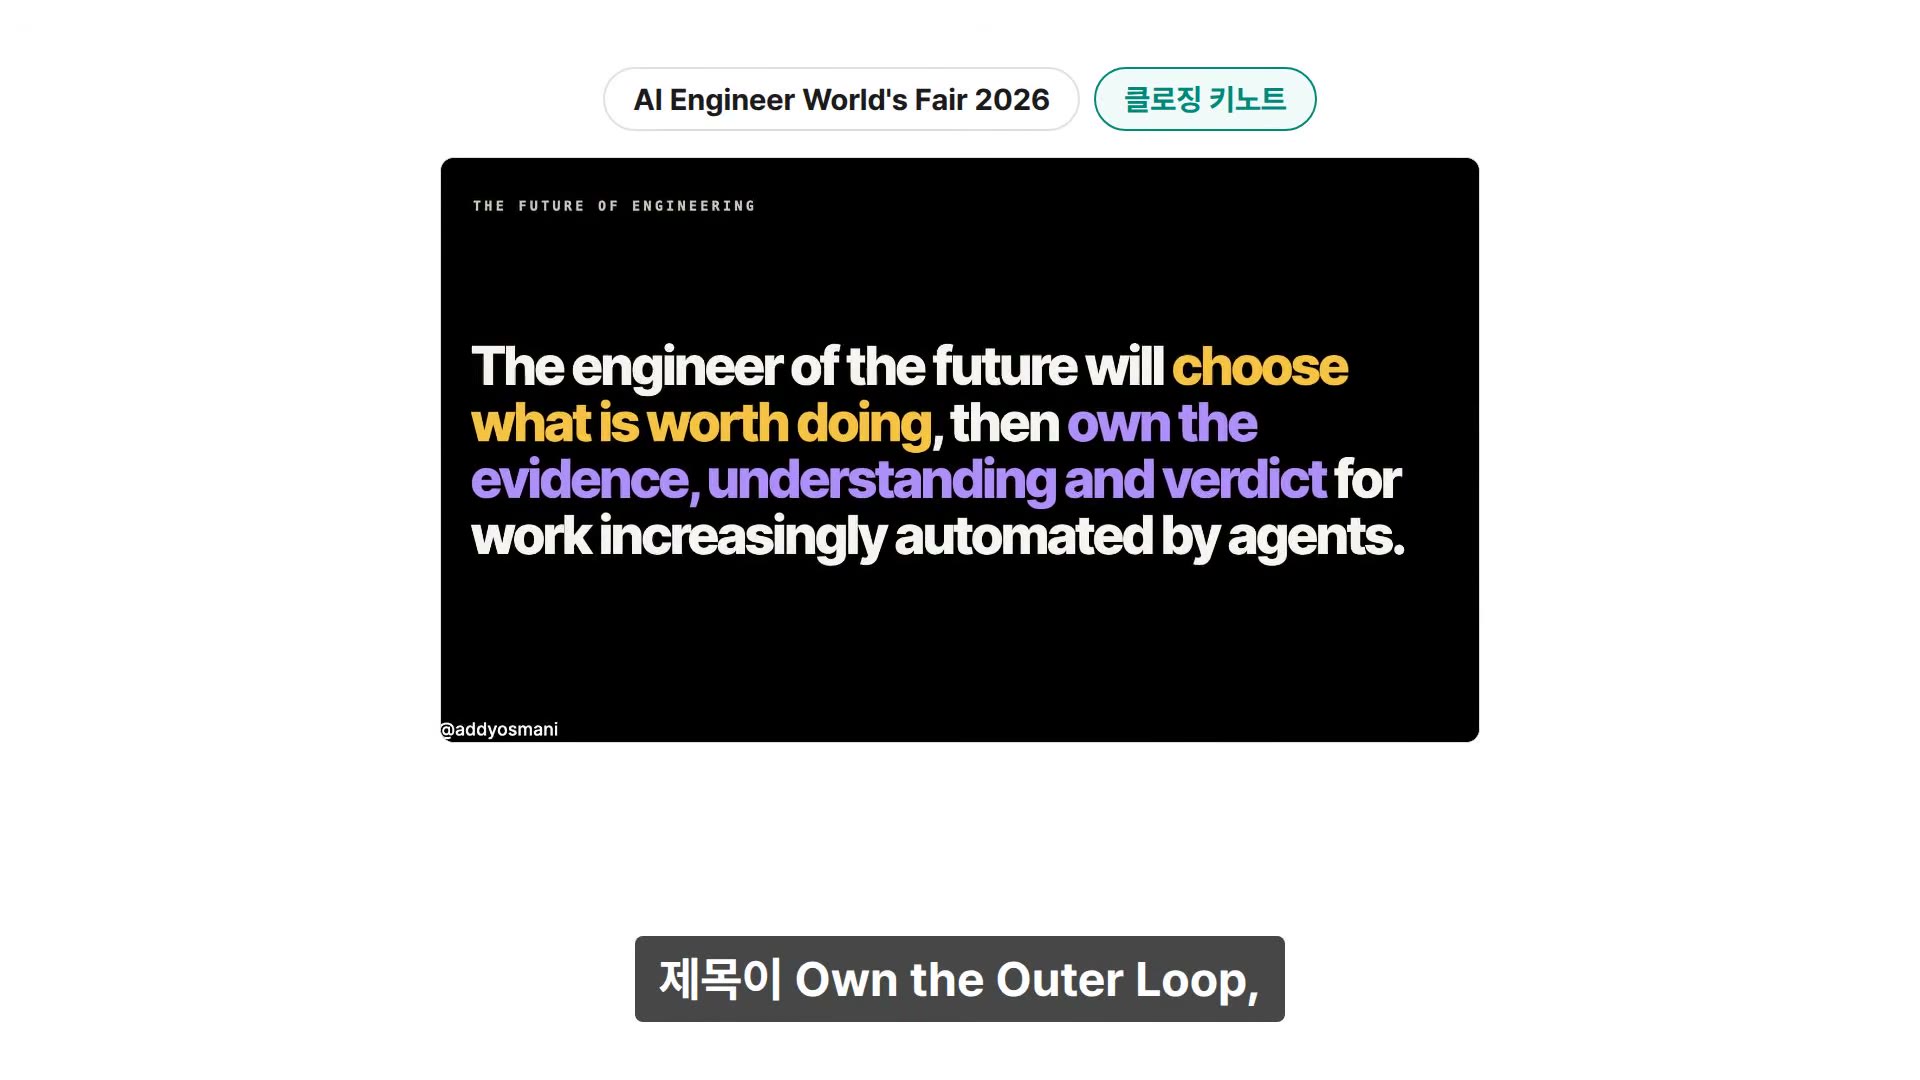
발표는 AI Engineer World’s Fair 2026 클로징 키노트였고 제목은 “Own the Outer Loop” — 바깥 고리를 소유하라는 뜻이다. 첫 슬라이드가 결론을 미리 박아둔다.
The engineer of the future will choose what is worth doing, then own the evidence, understanding and verdict for work increasingly automated by agents. (미래의 엔지니어는 무엇이 할 가치가 있는지 고르고, 점점 더 에이전트가 자동화하는 작업에 대해 증거와 이해와 판정을 소유한다.)
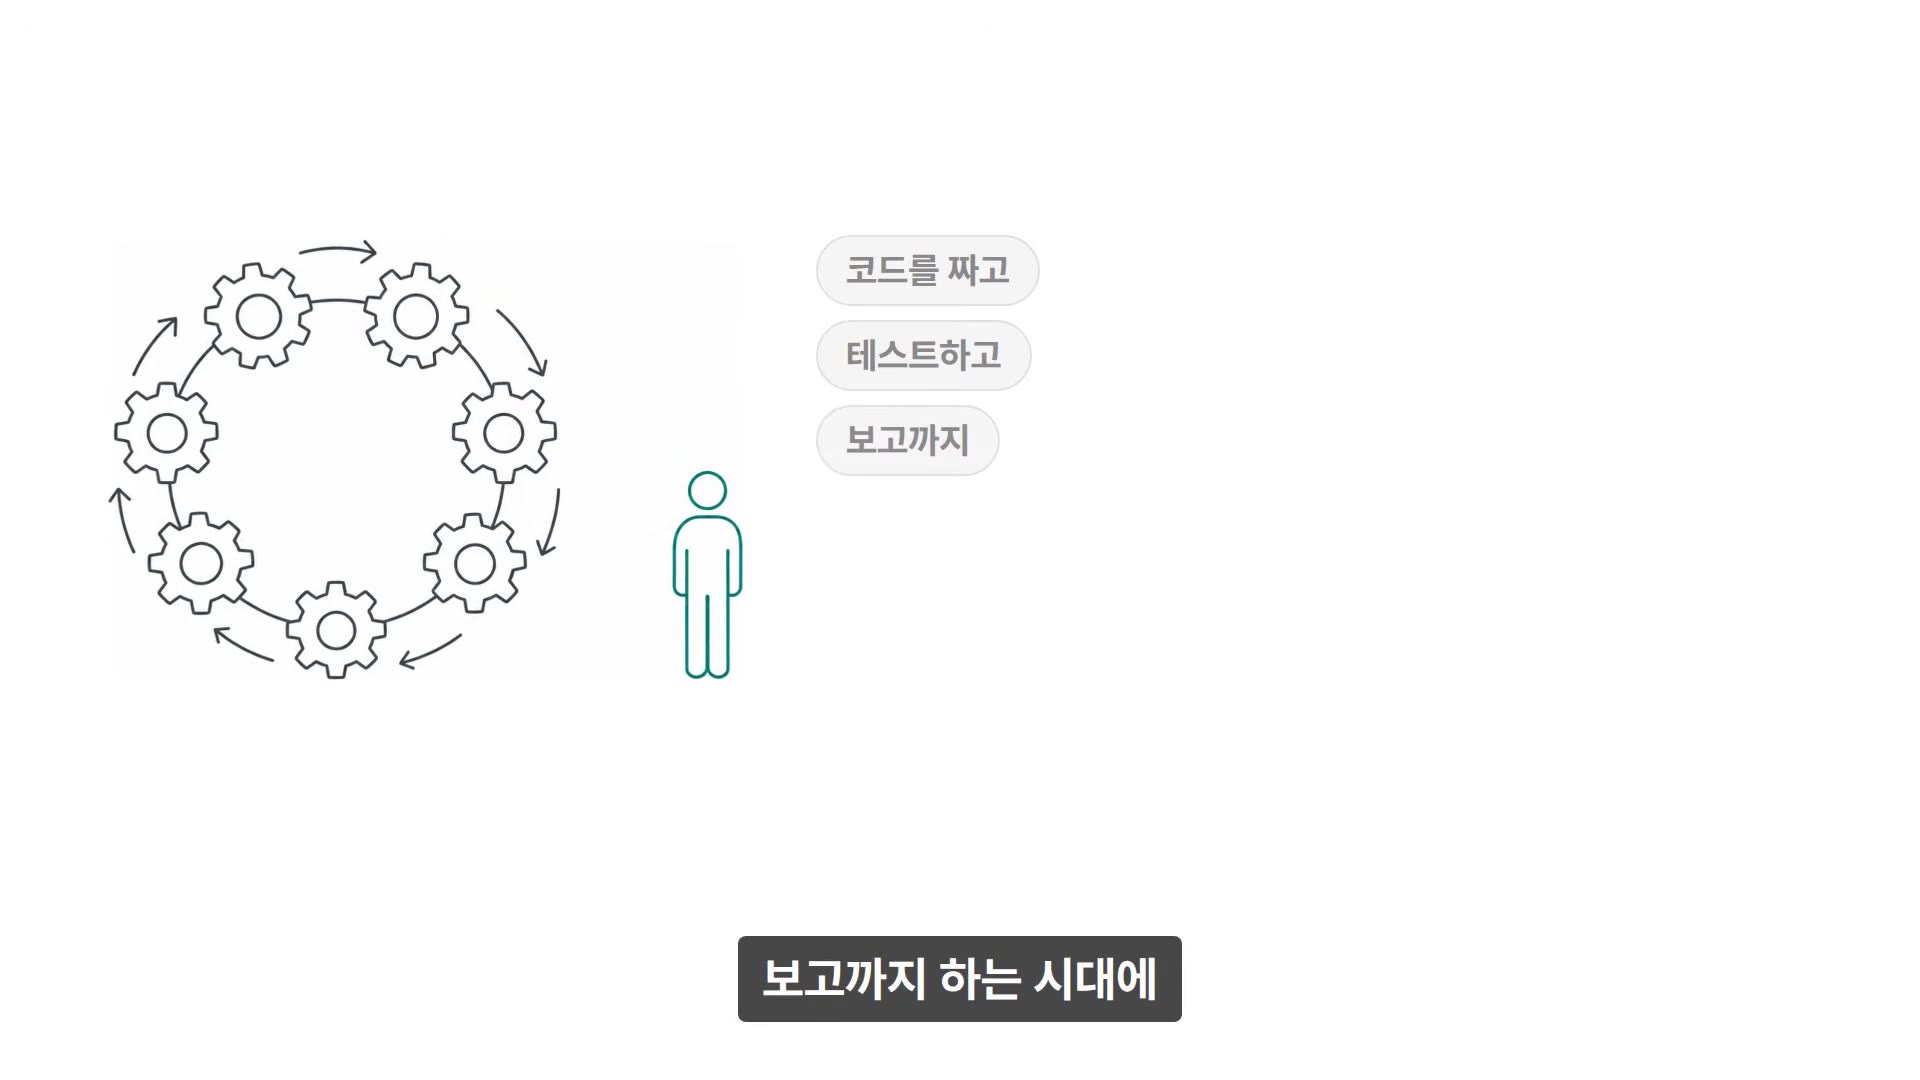
에이전트가 코드를 짜고, 테스트하고, 보고까지 하는 시대에 사람은 정확히 어느 자리에 남아야 하는가. 이 발표는 그 경계선을 꽤 구체적으로 그린다.
[00:41] 3. (해설) 커밋된 코드의 42%, 그런데 확인 비용은 그대로
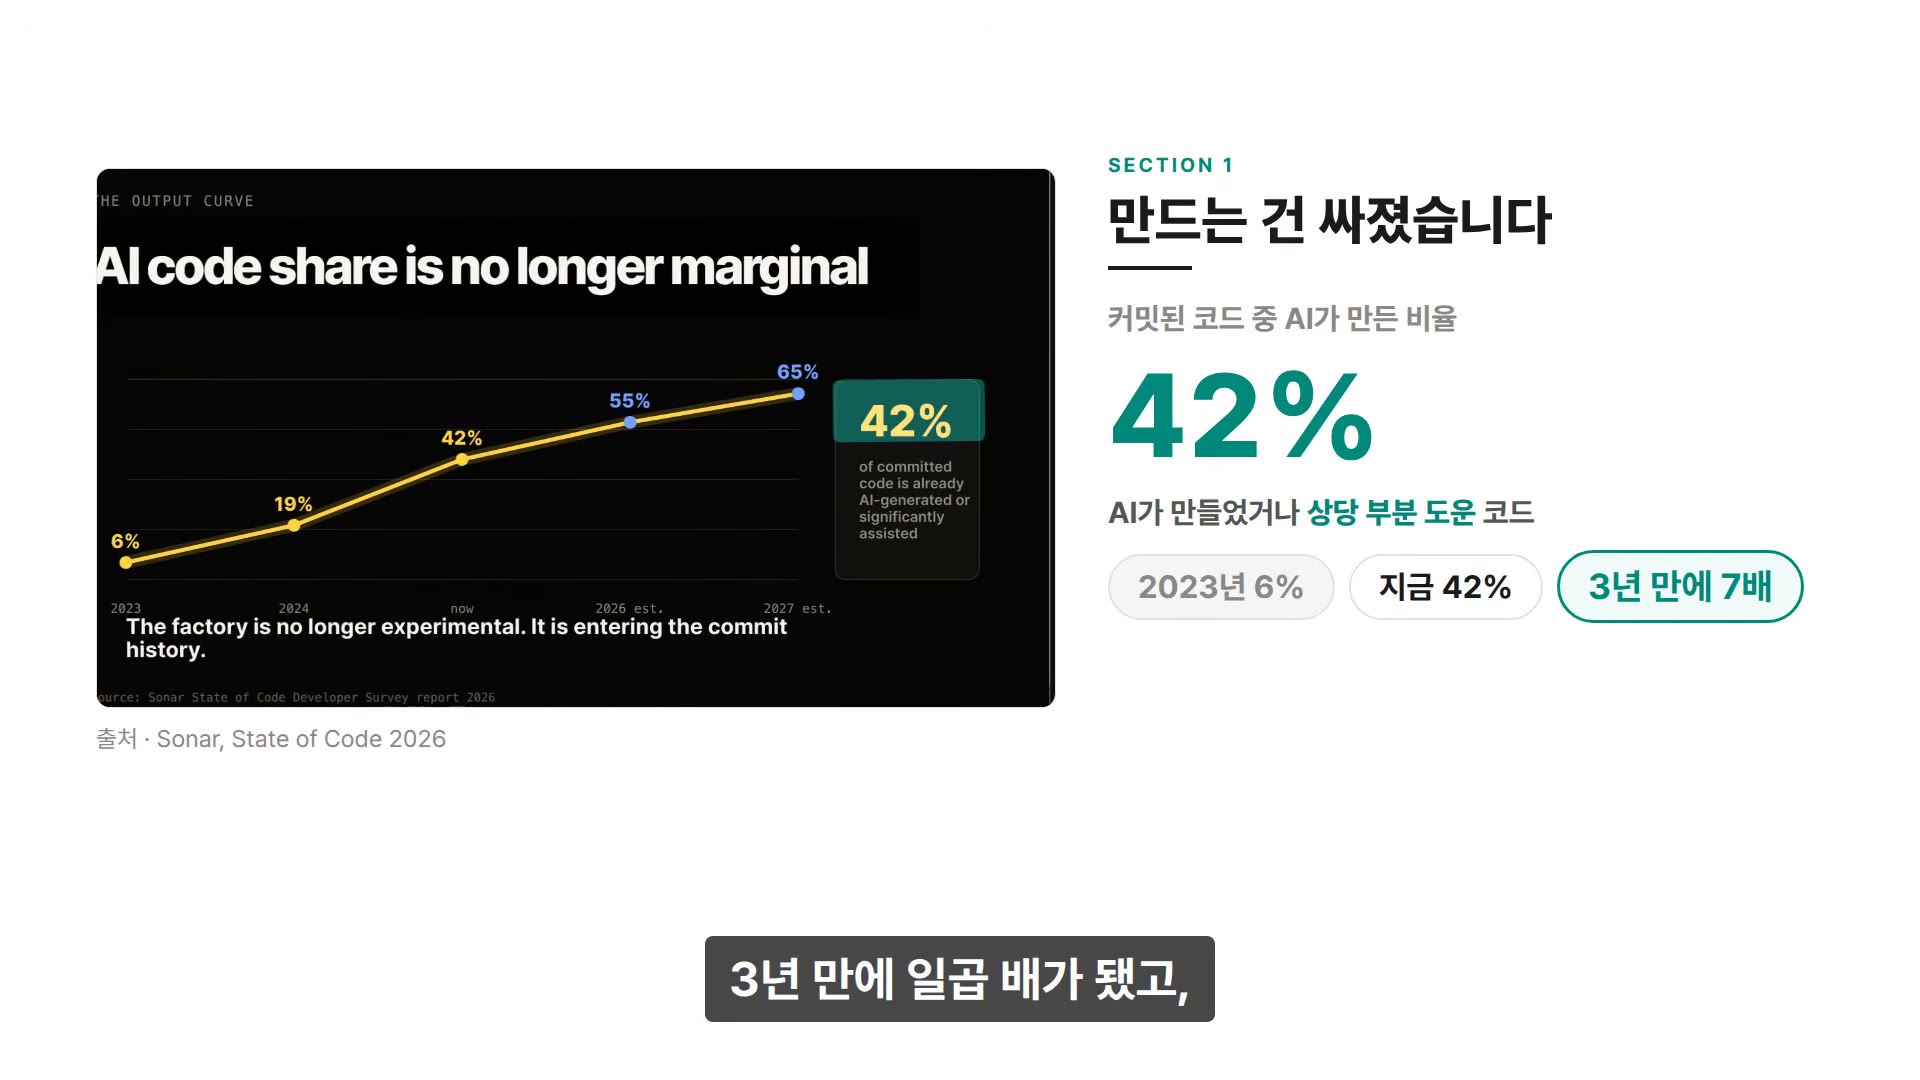
Sonar가 2026년에 낸 State of Code Developer Survey를 보면, 커밋된 코드 중 **AI가 만들었거나 상당 부분 도운 비율이 42%**다. 2023년엔 6%였으니 3년 만에 일곱 배다. 곡선은 2024년 19%를 거쳐 2026년 55%, **2027년 65%**로 이어진다. 슬라이드의 한 줄이 상황을 요약한다 — “The factory is no longer experimental. It is entering the commit history.”
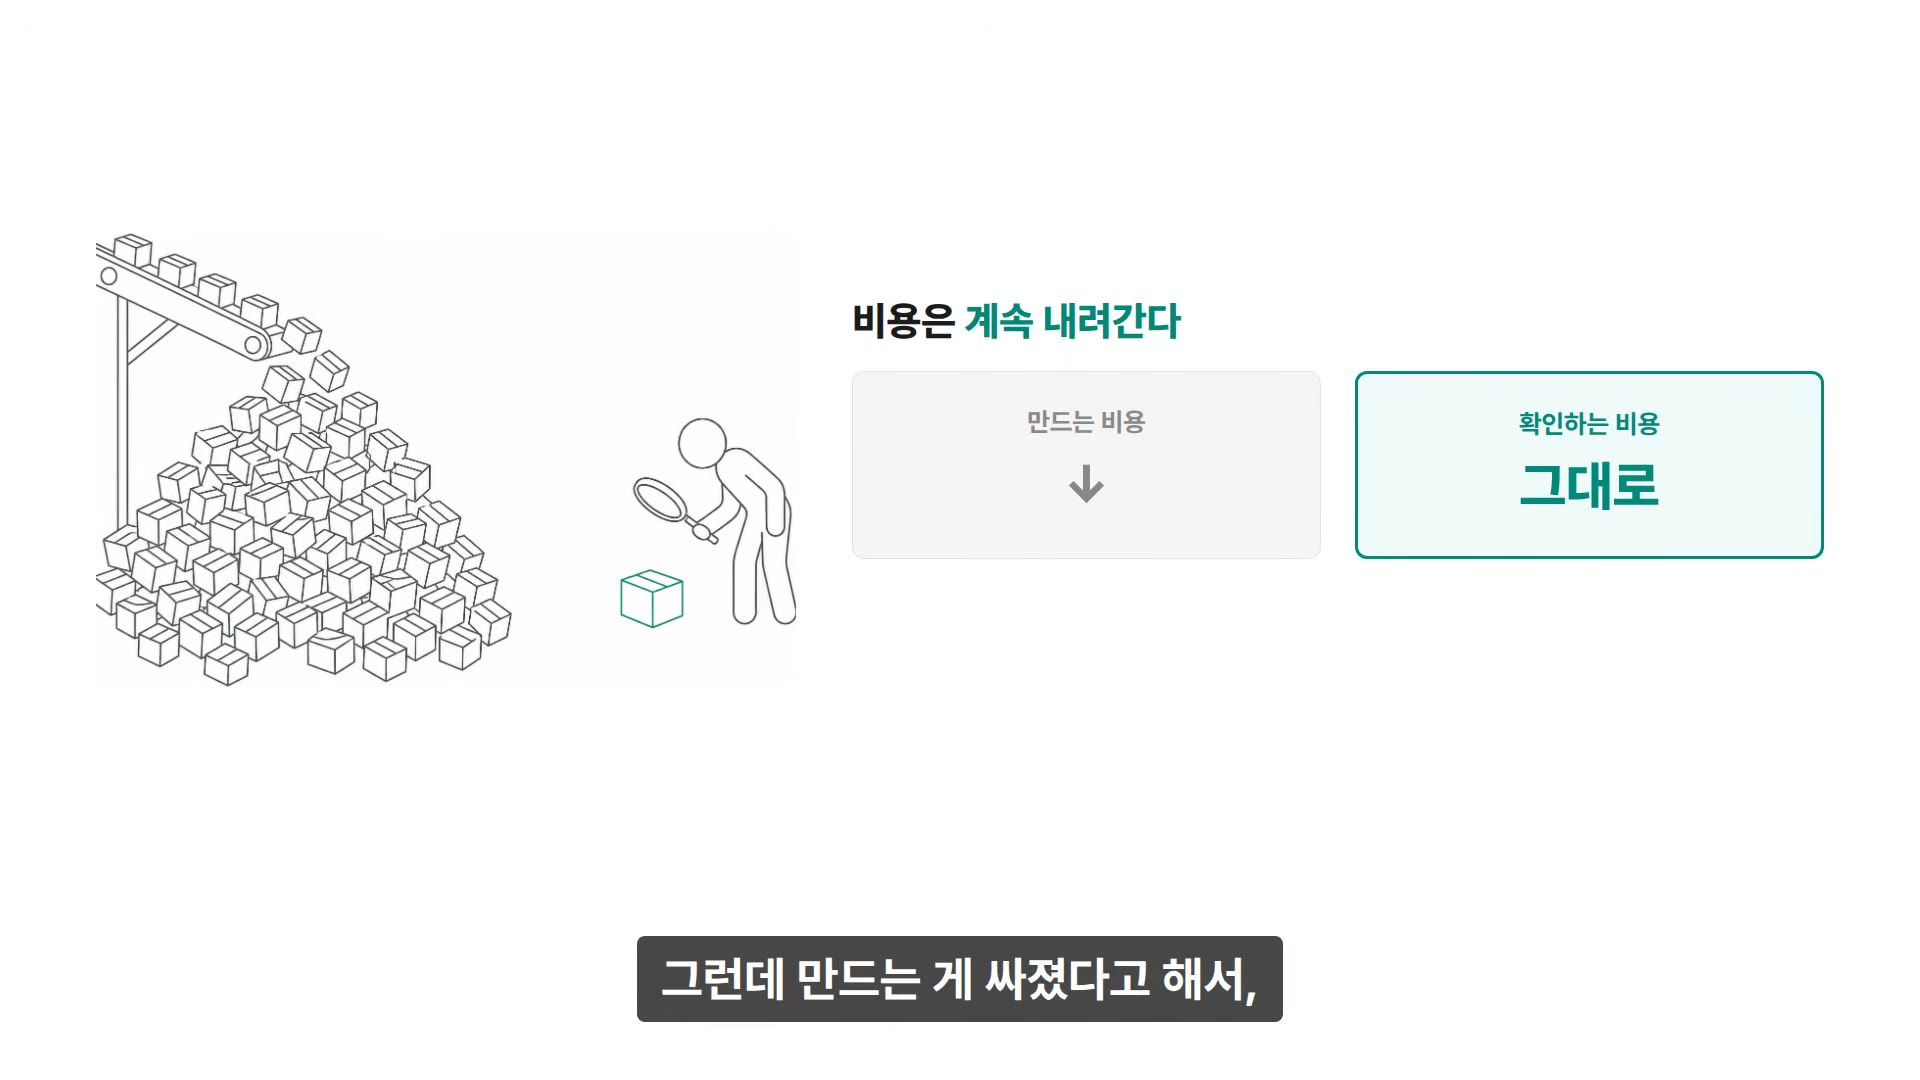
코드를 만드는 비용은 이렇게 계속 내려간다. 그런데 만드는 게 싸졌다고 해서 확인하는 것까지 싸지지는 않았다. 컨베이어에서 상자가 쏟아지는데 돋보기를 든 사람은 하나다. 발표가 첫 파트에서 붙잡는 격차가 정확히 이것이다.
[01:16] 4. (발표) 리뷰어는 이미 과부하다 — 신뢰 없이, 대역폭도 없이
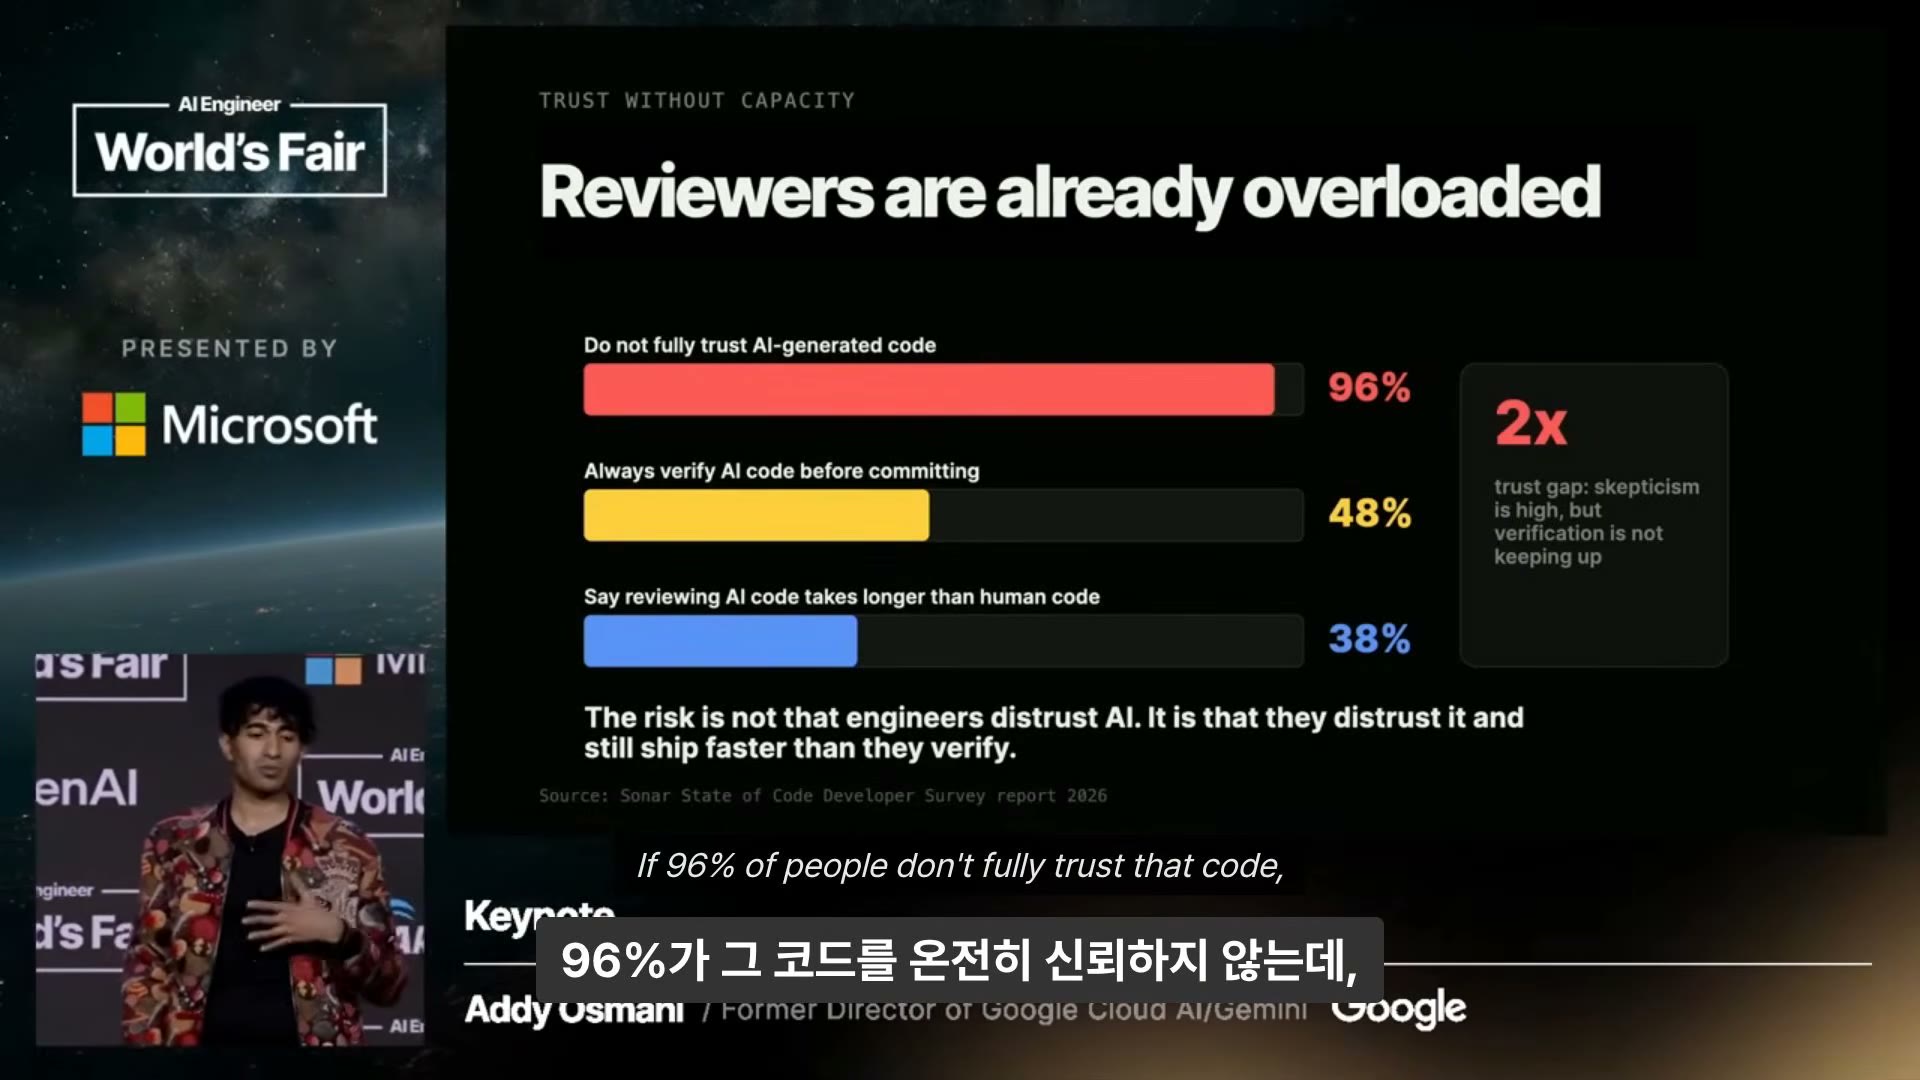
발표의 첫 클립은 이렇게 시작한다. “저는 제 공장에서 일하는 게 좋습니다. 엔지니어링 루프를 만드는 게 좋아요. 그런데 문제는 여전히 용량(capacity)입니다.”
같은 Sonar 조사의 숫자가 그 용량 문제를 못 박는다.
| 항목 | 비율 |
|---|---|
| AI 생성 코드를 온전히 신뢰하지 않는다 | 96% |
| 커밋 전에 항상 AI 코드를 검증한다 | 48% |
| AI 코드 리뷰가 사람 코드보다 오래 걸린다 | 38% |
회의는 높은데 검증이 따라가지 못하는 2배의 신뢰 격차다. 오스마니의 정리는 이렇다 — “위험은 엔지니어가 AI를 불신한다는 게 아니라, 불신하면서도 검증보다 빠르게 배포한다는 것이다.” 그래서 안전은 검증을 더 싸고, 더 명확하고, 건너뛰기 더 어렵게 만드는 데서 나온다.
[01:37] 5. (발표) 생성이 통제보다 빨리 움직였다
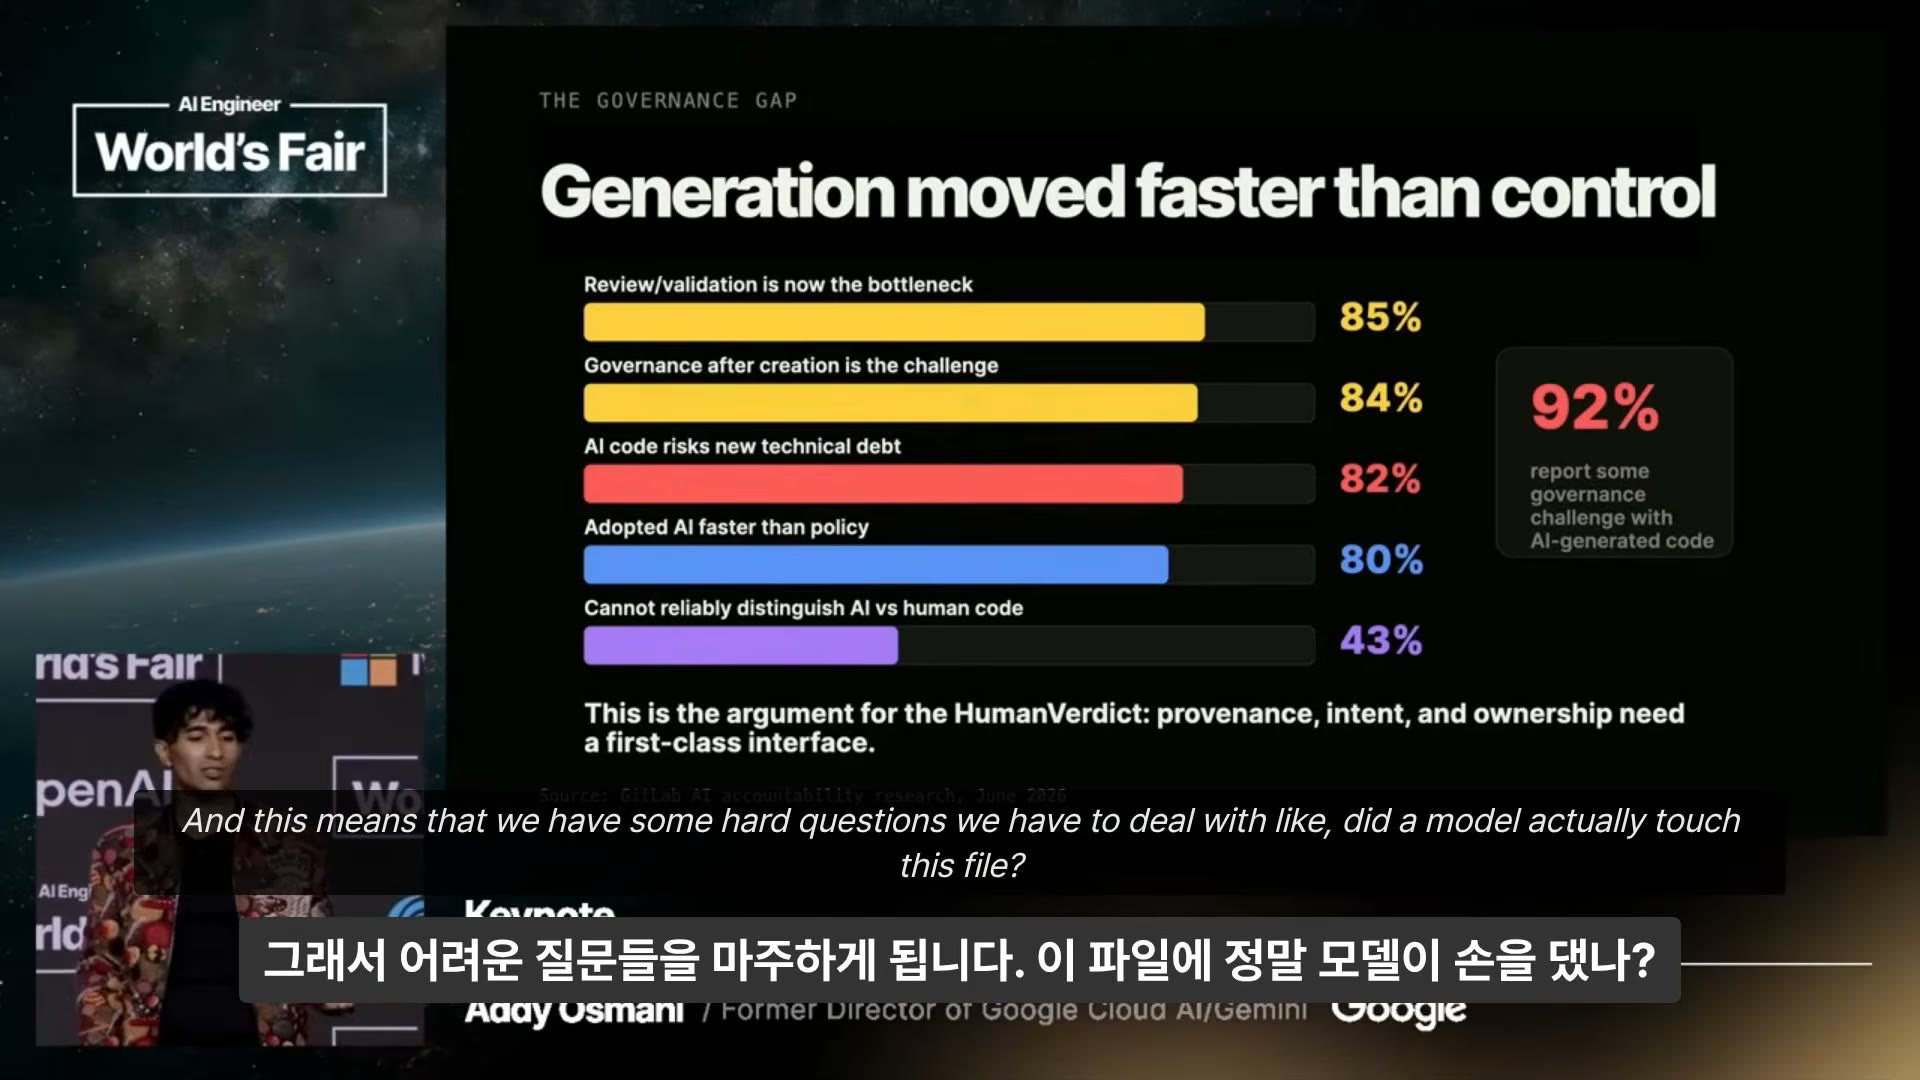
개인 리뷰어에서 조직으로 시야를 넓히면, 거버넌스가 따라잡지 못하는 사이 도입 속도는 어떤 회사가 정책을 세우는 속도보다 훨씬 빠르게 움직인다. GitLab의 2026년 6월 AI 책임성 조사가 그 그림이다.
| 항목 | 비율 |
|---|---|
| 리뷰/검증이 이제 병목이다 | 85% |
| 생성 이후의 거버넌스가 과제다 | 84% |
| AI 코드가 새로운 기술 부채 위험을 만든다 | 82% |
| 정책보다 AI 도입이 빨랐다 | 80% |
| AI 코드와 사람 코드를 신뢰성 있게 구분하지 못한다 | 43% |
92%가 AI 생성 코드에서 어떤 형태로든 거버넌스 문제를 보고했다.
그래서 어려운 질문들을 마주하게 된다 — 이 파일에 정말 모델이 손을 댔나? 어떤 제약이 그 작업을 이끌었나? 어떤 증거가 만들어졌나? 어떤 리스크가 수용됐나? 그리고 그 결과를 누가 소유했나? 슬라이드는 이걸 HumanVerdict의 논거라고 부른다 — 출처(provenance), 의도(intent), 소유(ownership)에 일급(first-class) 인터페이스가 필요하다.
[02:06] 6. (발표) 에이전트가 리뷰할 수 있는 양보다 많이 내보낸다
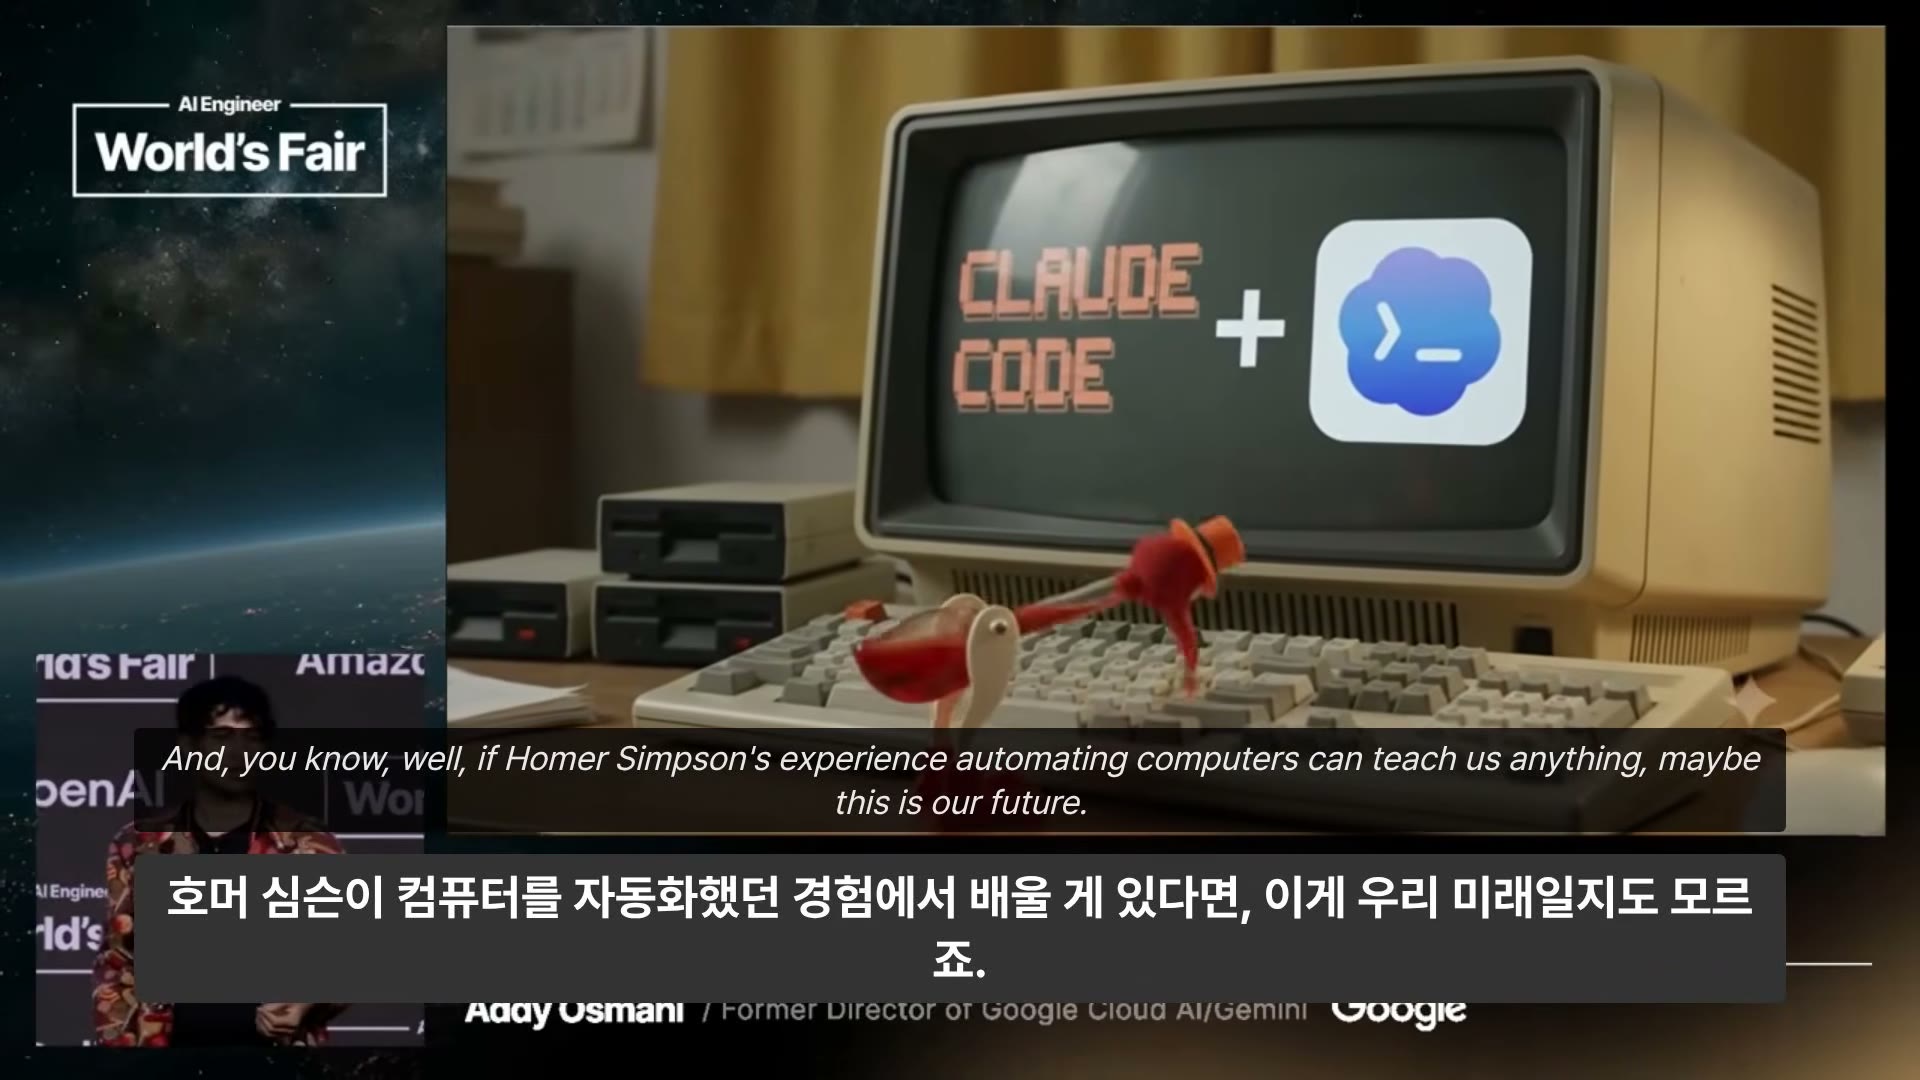
“이제 에이전트는 우리 중 누구도 리뷰할 수 없는 양을 내보냅니다. 그럼 우리는 아직 뭘 위해 있는 거죠?”
여기서 농담이 하나 들어간다. 호머 심슨이 자판 위에 물 마시는 새 인형을 올려놓고 자동화했던 그 장면 — 이번엔 화면에 CLAUDE CODE가 떠 있다. “호머 심슨이 컴퓨터를 자동화했던 경험에서 배울 게 있다면, 이게 우리 미래일지도 모르죠.” 오스마니 본인은 그렇게 되지 않는다고 보지만, 가능한 한 방향이긴 하다고 덧붙인다.
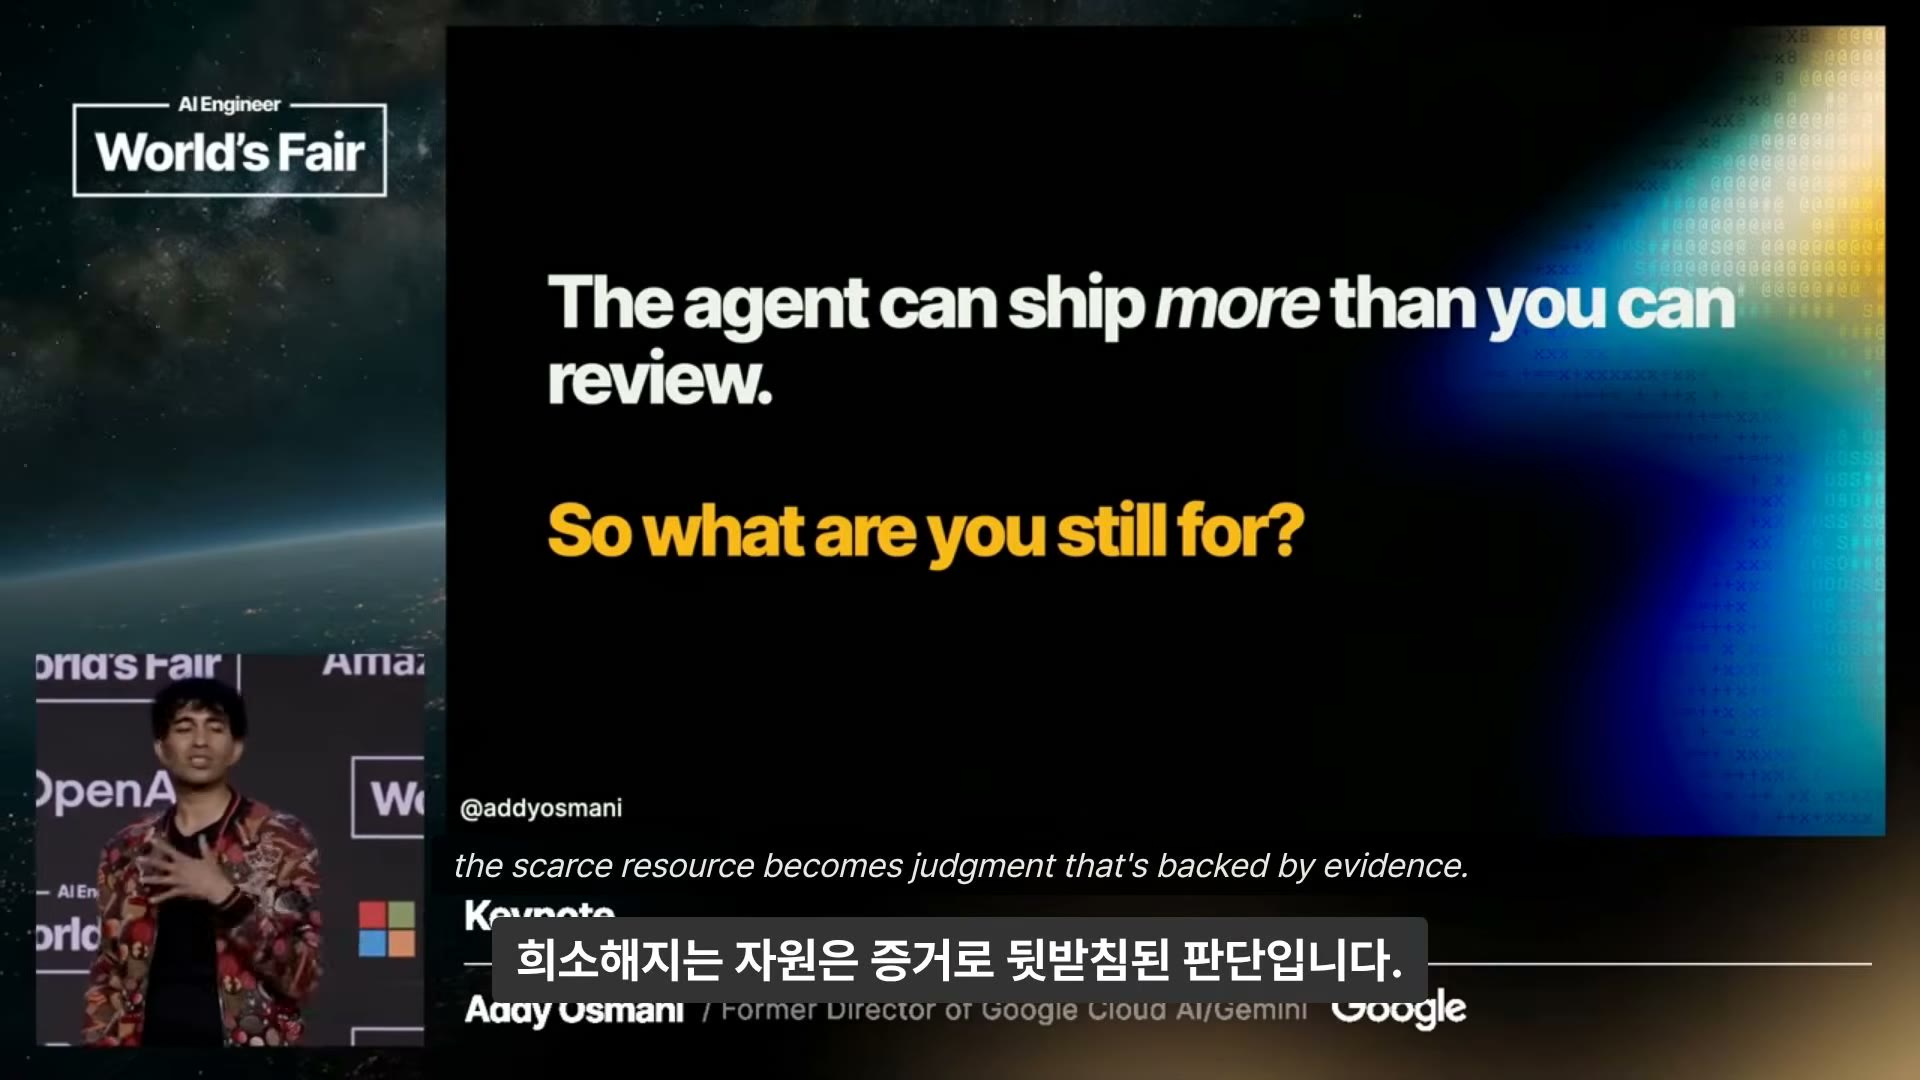
다시 진지하게 잡는다. 변화가 사람이 루프에 들어가는 지점을 바꾸고, 생성이 이해보다 빠르게 확장된다면, 희소해지는 자원은 증거로 뒷받침된 판단(judgment backed by evidence)이 된다.
[02:47] 7. (해설) 알파와 디케이 — 그리고 취향에도 시계가 걸려 있다
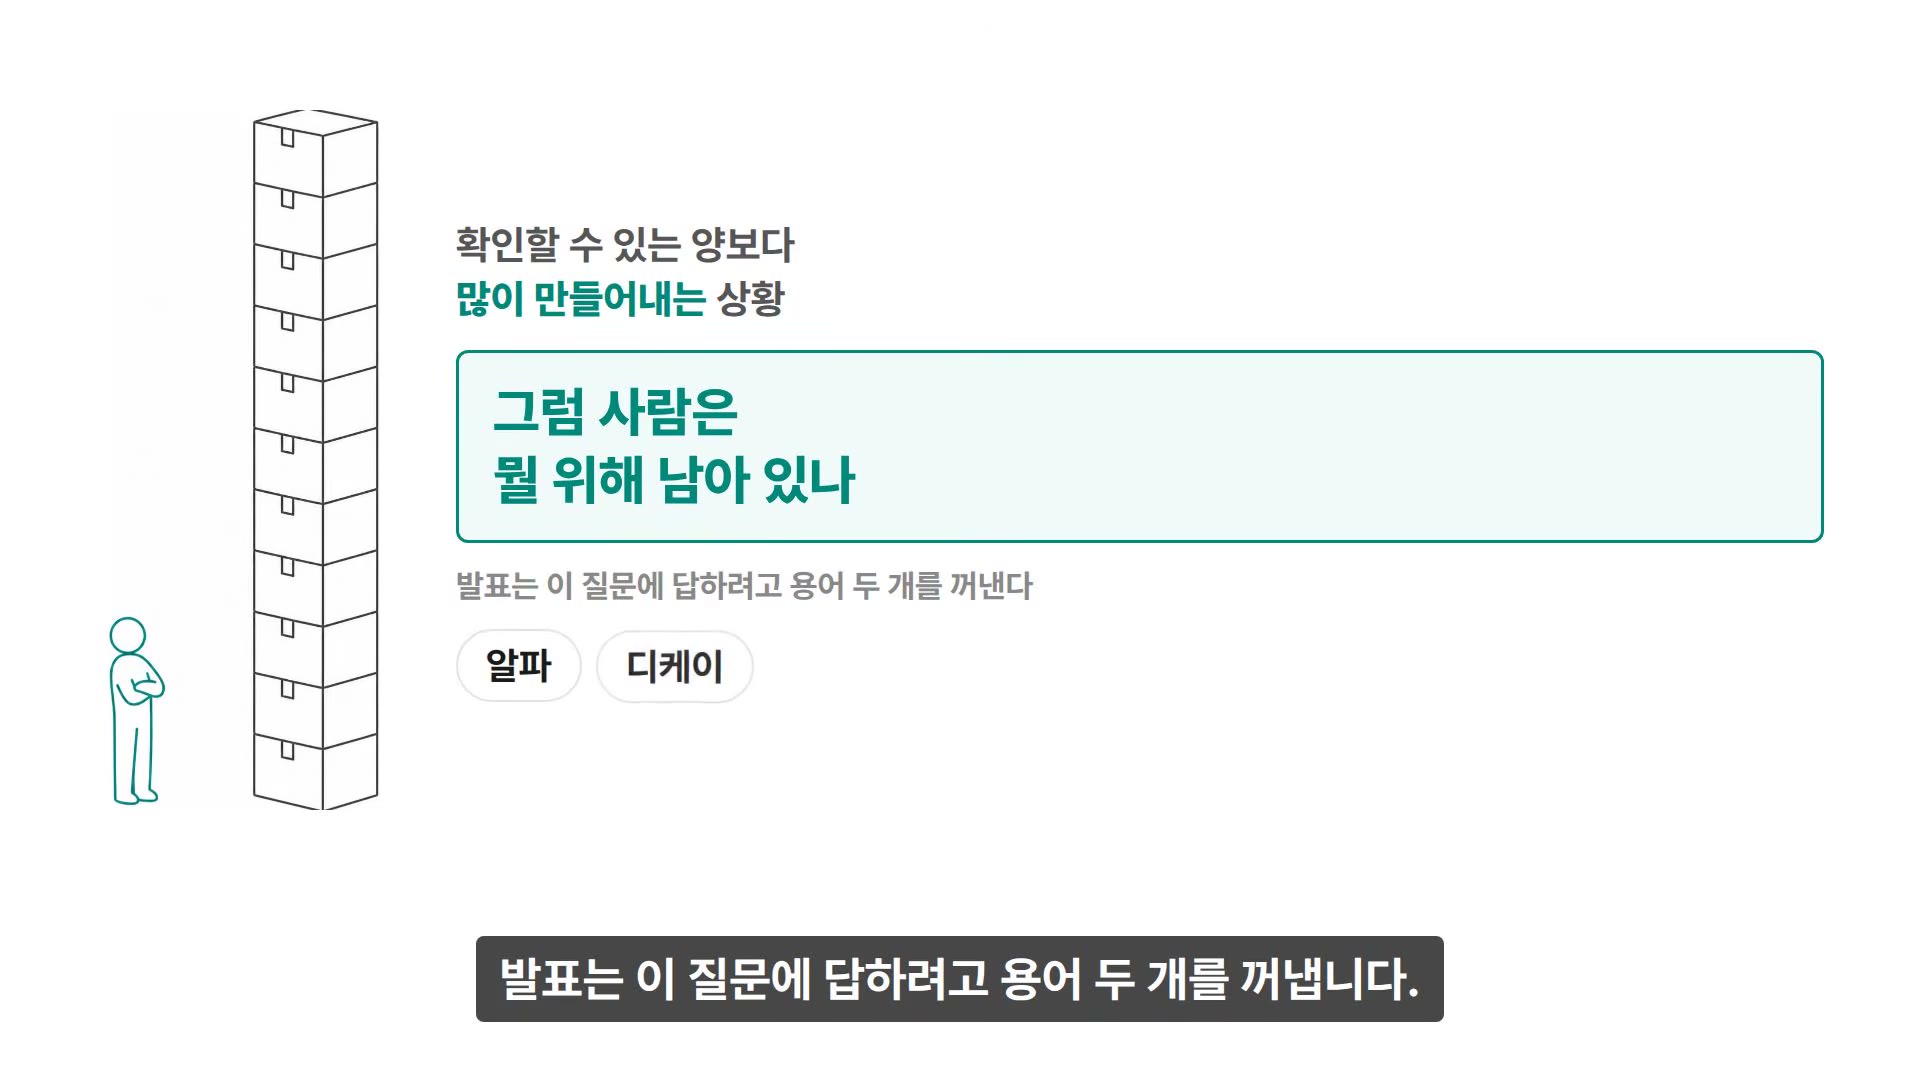
해설이 용어 두 개를 정리해준다.
- 알파(alpha) — 지금 모델이 할 수 있는 것보다 내가 의미 있게 더 나은 지점. 쉽게 말해 내 강점이다.
- 디케이(decay) — 그 격차를 모델이 따라잡는 속도. 내 강점에 걸린 시계라고 보면 된다.
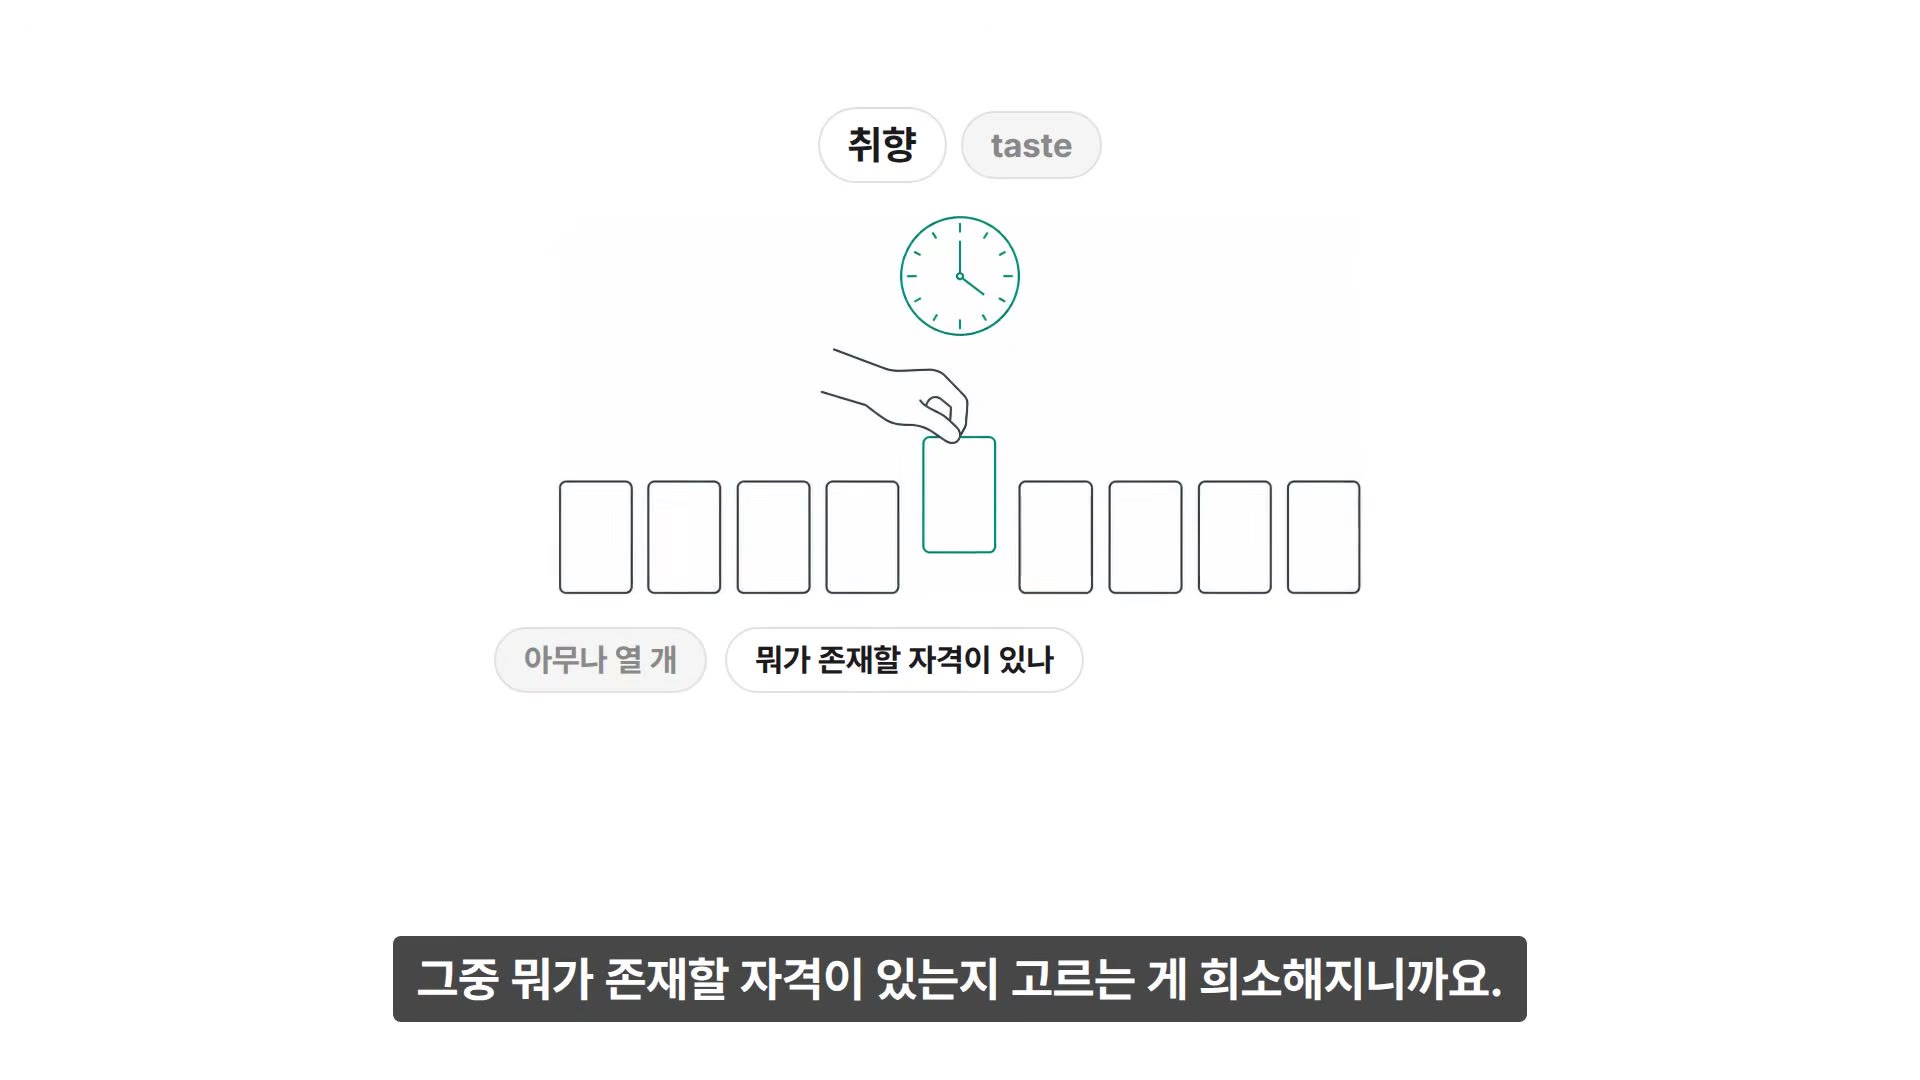
요즘 다들 취향(taste) 을 이야기한다. 아무나 열 개를 만들어 낼 수 있으면 그중 뭐가 존재할 자격이 있는지 고르는 게 희소해지니까다. 그런데 해설이 짚는 함정이 여기 있다 — 그 취향도 결국 알파고, 알파에는 시계가 걸려 있다.
[03:09] 8. (발표) 취향은 지표가 생기기 전의 판단이다
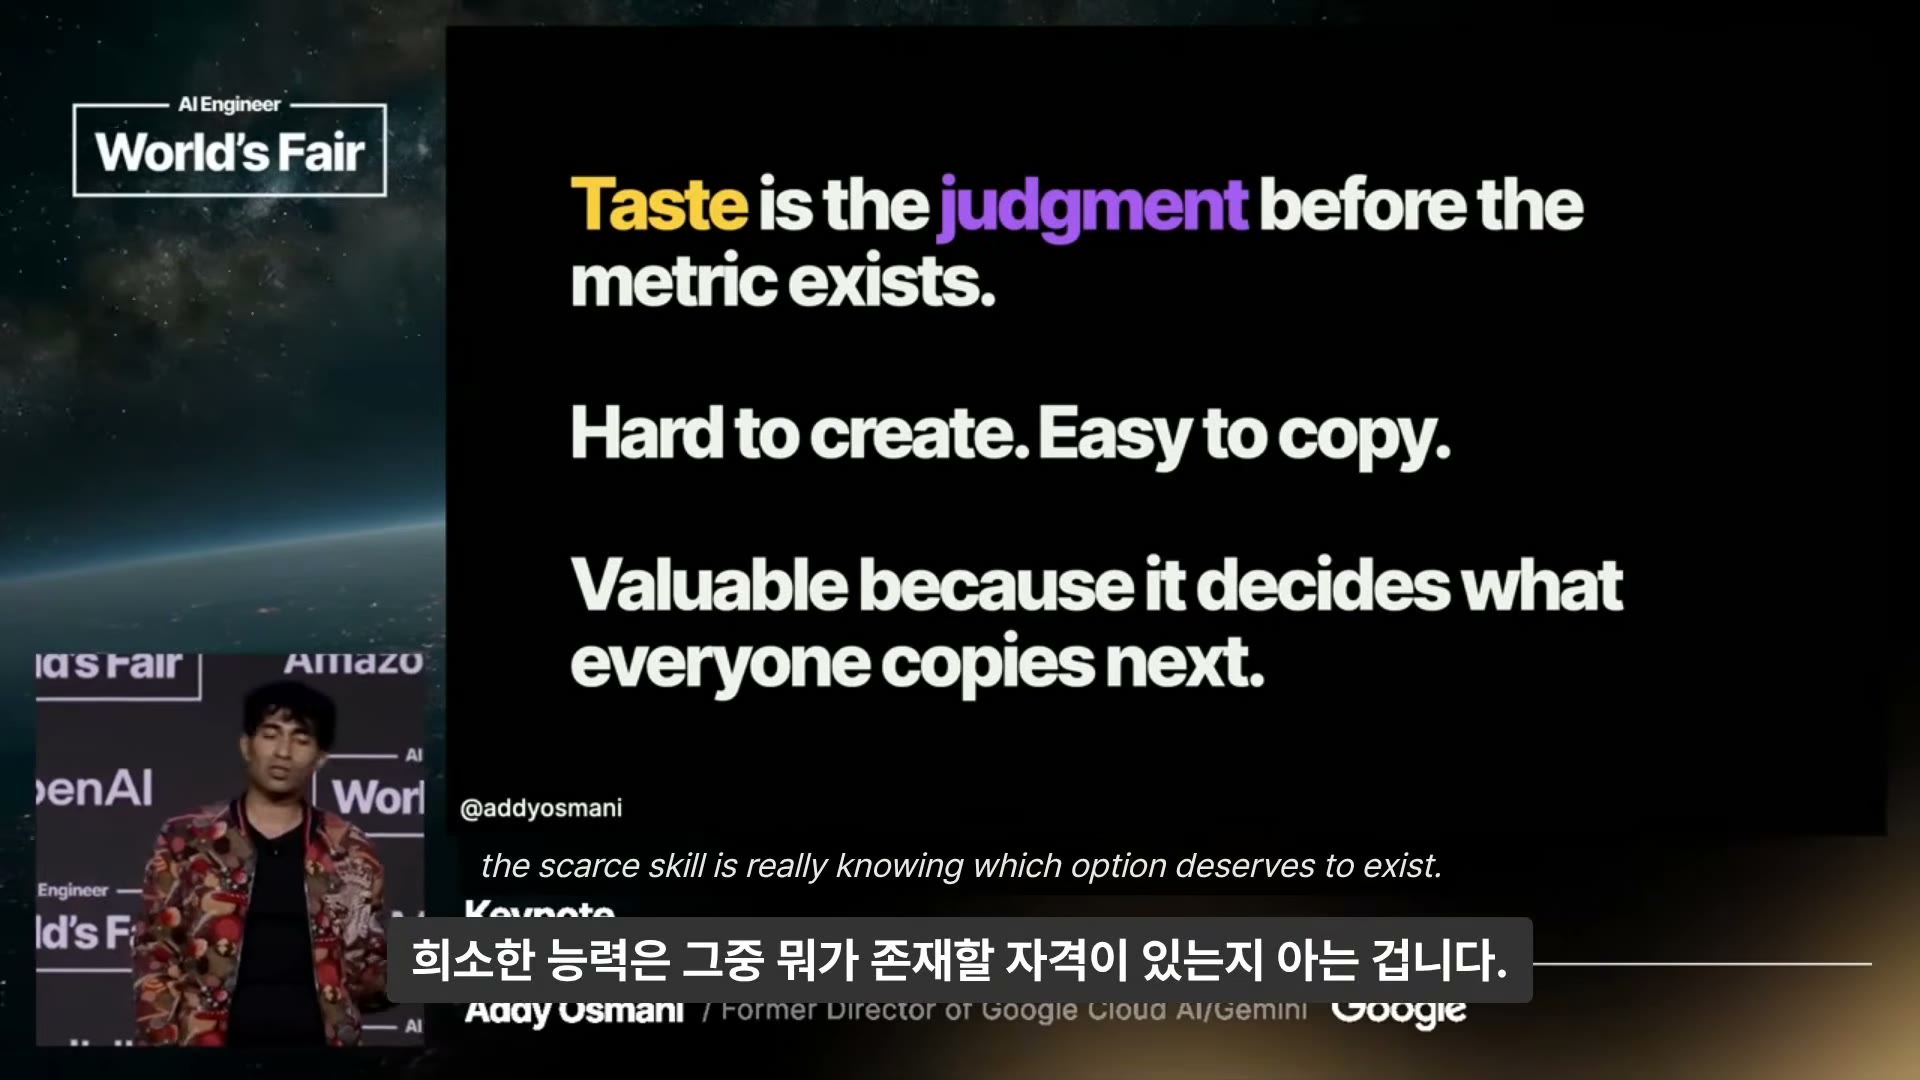
발표도 같은 말을 한다. “생산이 싸질수록 취향은 중요해집니다. 아무나 열 개의 선택지를 만들어낼 수 있다면, 희소한 능력은 그중 뭐가 존재할 자격이 있는지 아는 겁니다.” 슬라이드의 정의는 이렇다.
Taste is the judgment before the metric exists. Hard to create. Easy to copy. Valuable because it decides what everyone copies next. (취향은 지표가 생기기 전의 판단이다. 만들기는 어렵고 베끼기는 쉽다. 다음에 모두가 무엇을 베낄지 결정하기 때문에 가치가 있다.)
그리고 곧바로 못을 박는다. “취향은 영원한 해자(moat)가 아닙니다. 그것도 알파입니다.” 취향을 가진 사람들은 앞으로도 오랫동안 중요하겠지만, 그 능력의 최고 버전은 신비주의(mystique)가 아니라 — 더 나은 판단을 내리고, 팀과 시스템이 배울 수 있는 예시를 남기는 것이다.
[03:44] 9. (발표) 디케이 테스트 — 역량이면 사라진다
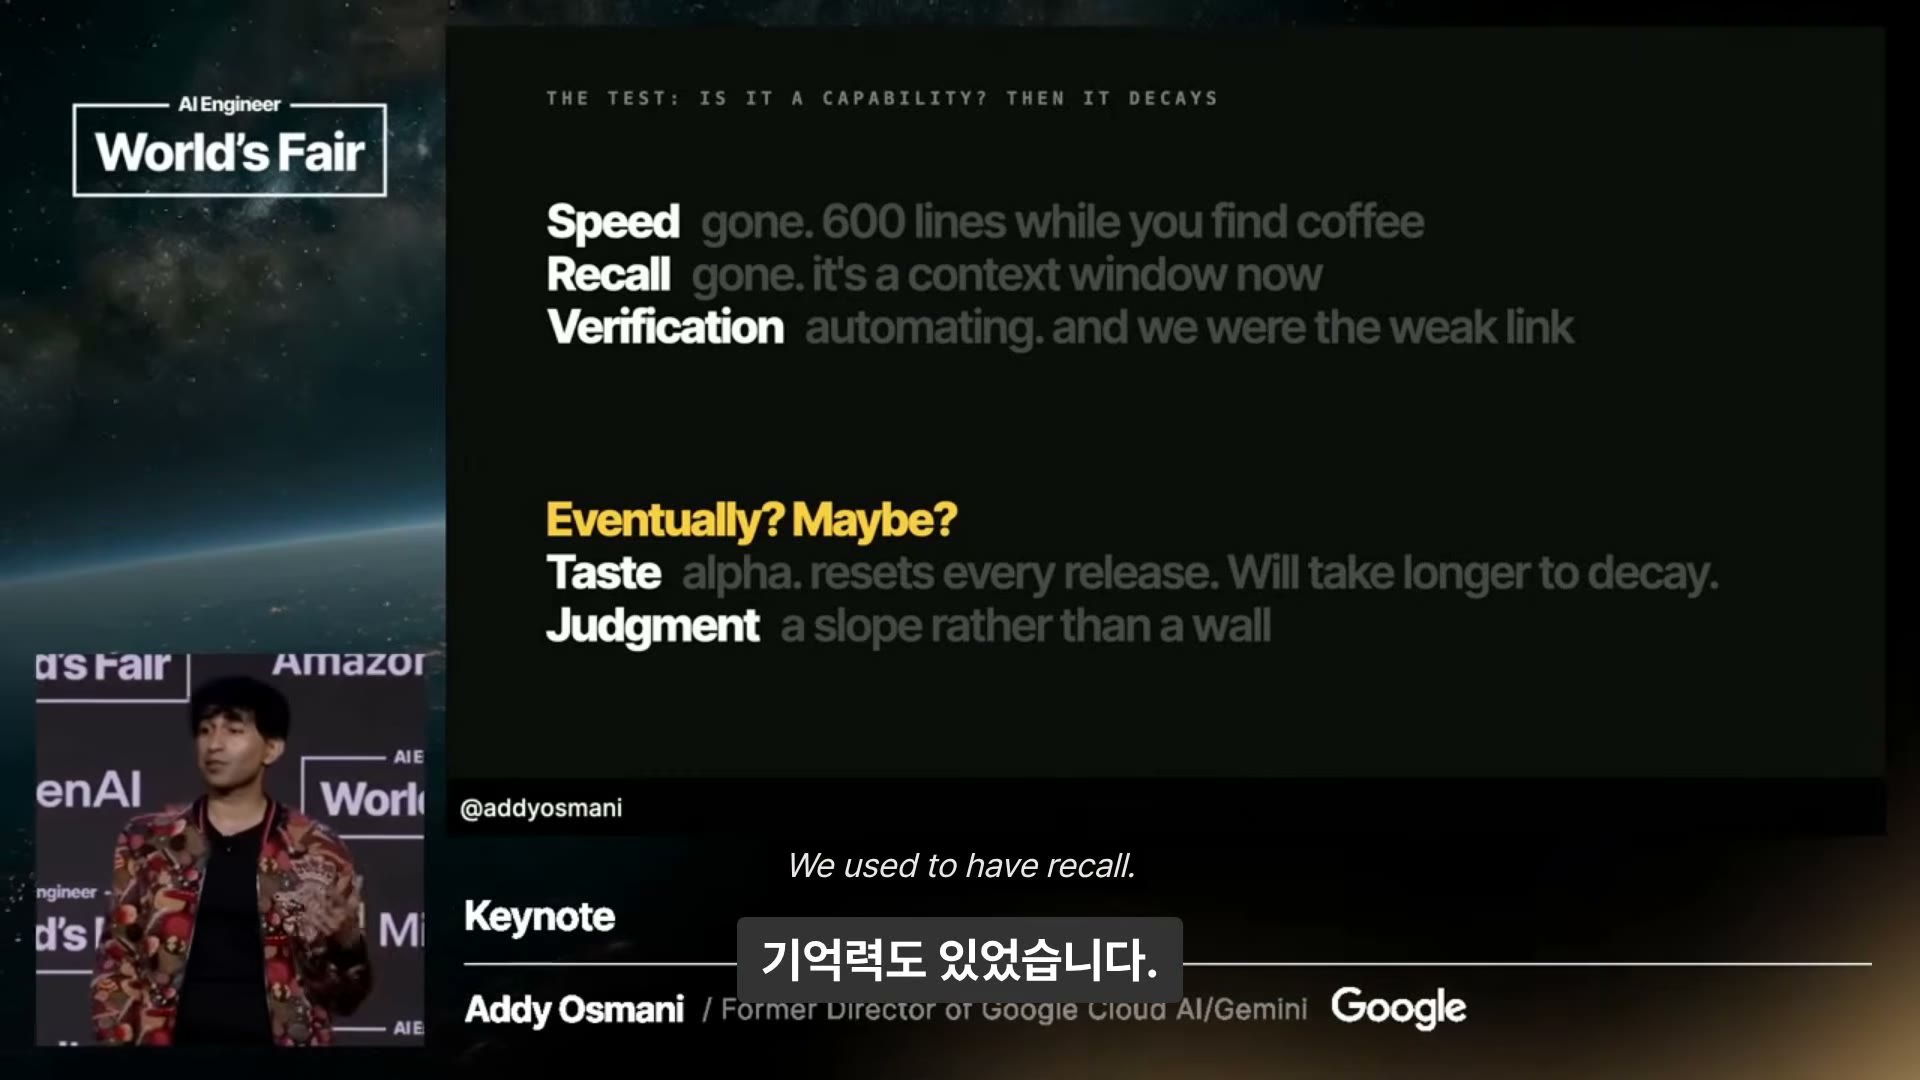
이제 하나씩 테스트를 통과시켜 본다. 슬라이드 제목이 곧 기준이다 — “이게 역량인가? 그렇다면 사라진다.”
| 항목 | 슬라이드의 판정 |
|---|---|
| Speed | 끝났다. 커피 뽑으러 간 사이 600줄 |
| Recall | 끝났다. 이제 그건 컨텍스트 윈도다 |
| Verification | 자동화되는 중. 그리고 우리가 약한 고리였다 |
| Taste | 언젠가는? 아마도? — 알파다. 릴리스마다 리셋된다. 사라지는 데 더 오래 걸릴 뿐 |
| Judgment | 벽이라기보다 경사면(a slope rather than a wall) |
검증은 하네스로, 이밸로, 정적 검사와 모델 크리틱으로 넘어가고 있다. 취향은 더 천천히 사라지겠지만 모델이 예시와 선호를 학습할 때마다 리셋된다. 결론은 하나다 — 어느 한 역량에 매달리는 게 전략이 아니다. 우리가 할 일은 엣지를 계속 한 단계 위로 옮기는 것이다.
[04:16] 10. (발표) 질문을 바꾼다
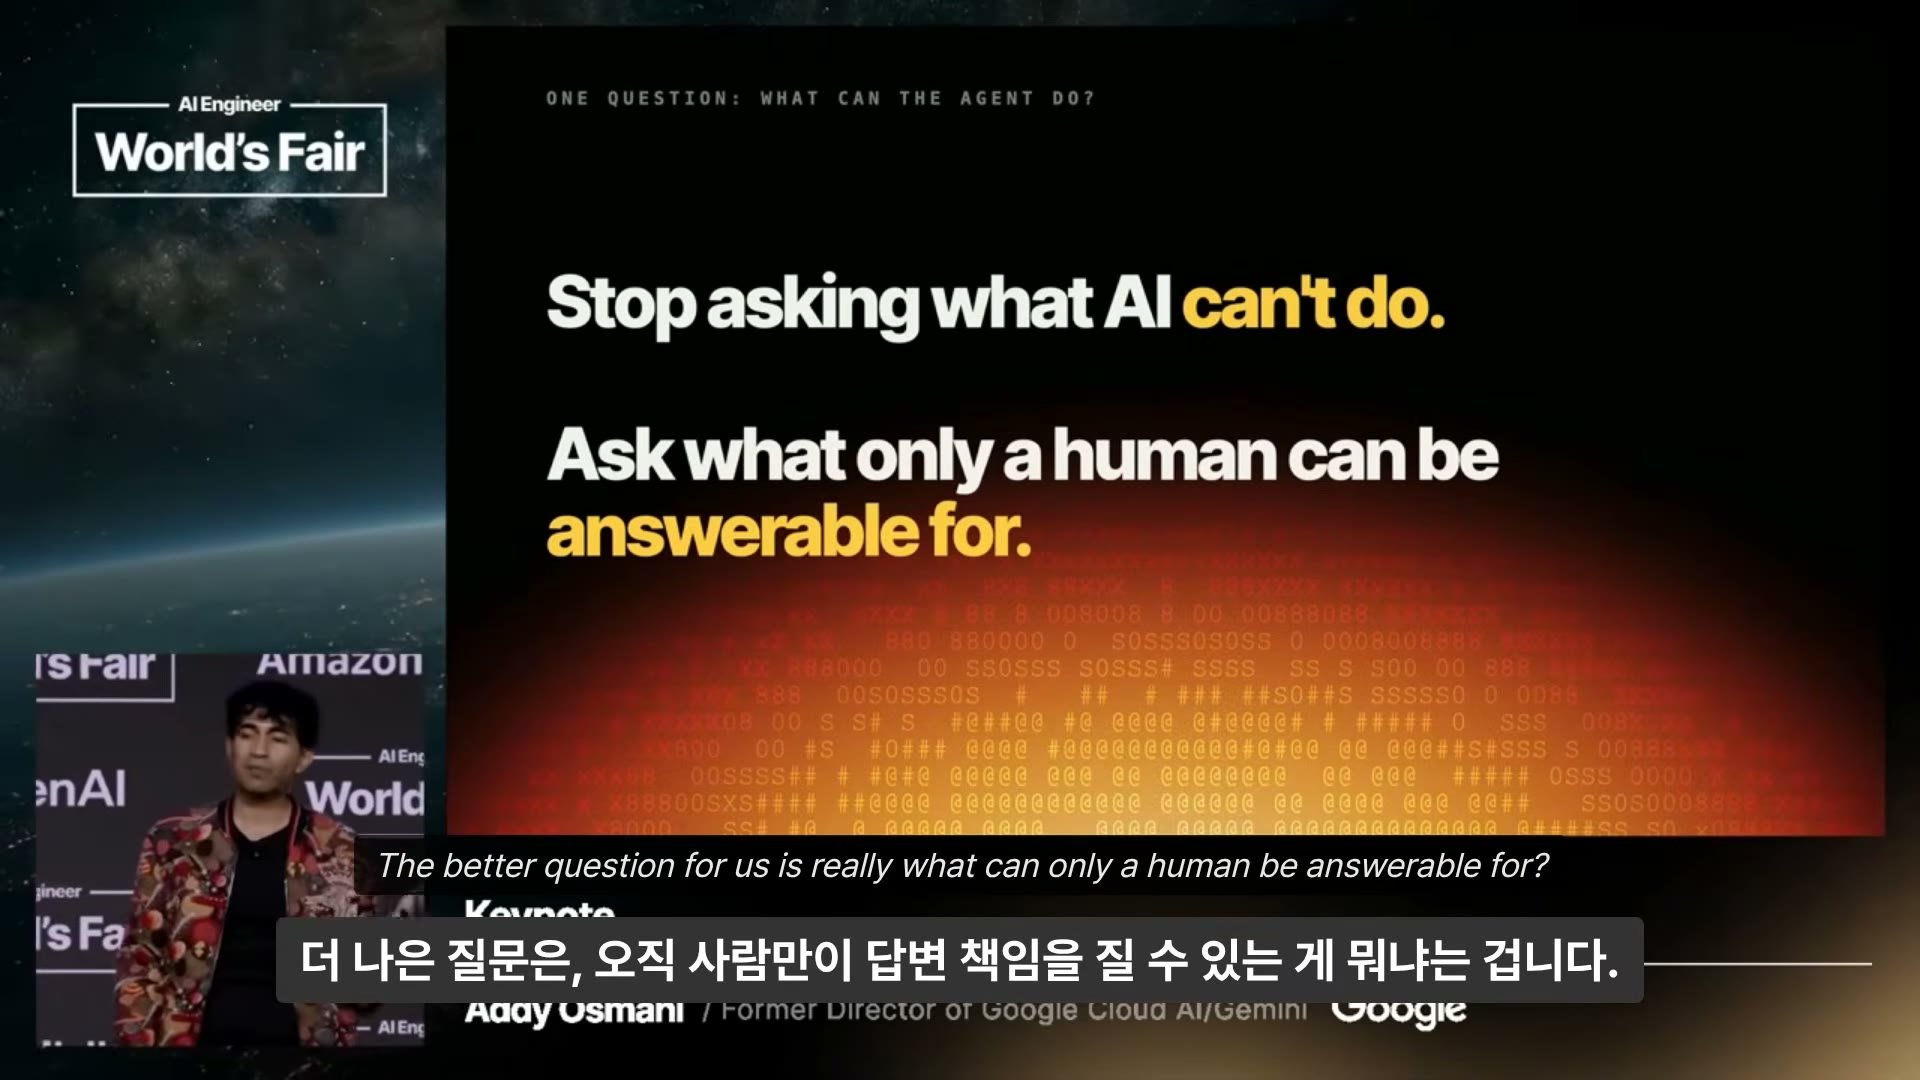
그래서 “에이전트가 뭘 할 수 있나”는 더 이상 최선의 전략적 질문이 아니다. 에이전트가 못 하는 것의 목록은 계속 줄어들기만 한다.
Stop asking what AI can’t do. Ask what only a human can be answerable for. (AI가 못 하는 게 뭔지 묻지 말고, 오직 사람만이 답변 책임을 질 수 있는 게 뭔지 물어라.)
우리 중 누가 마법 같아서가 아니다. 어떤 결정은 실제로 소유(ownership)를 요구하기 때문이다.
[04:44] 11. (해설) 엔지니어라는 말이 좁아진다
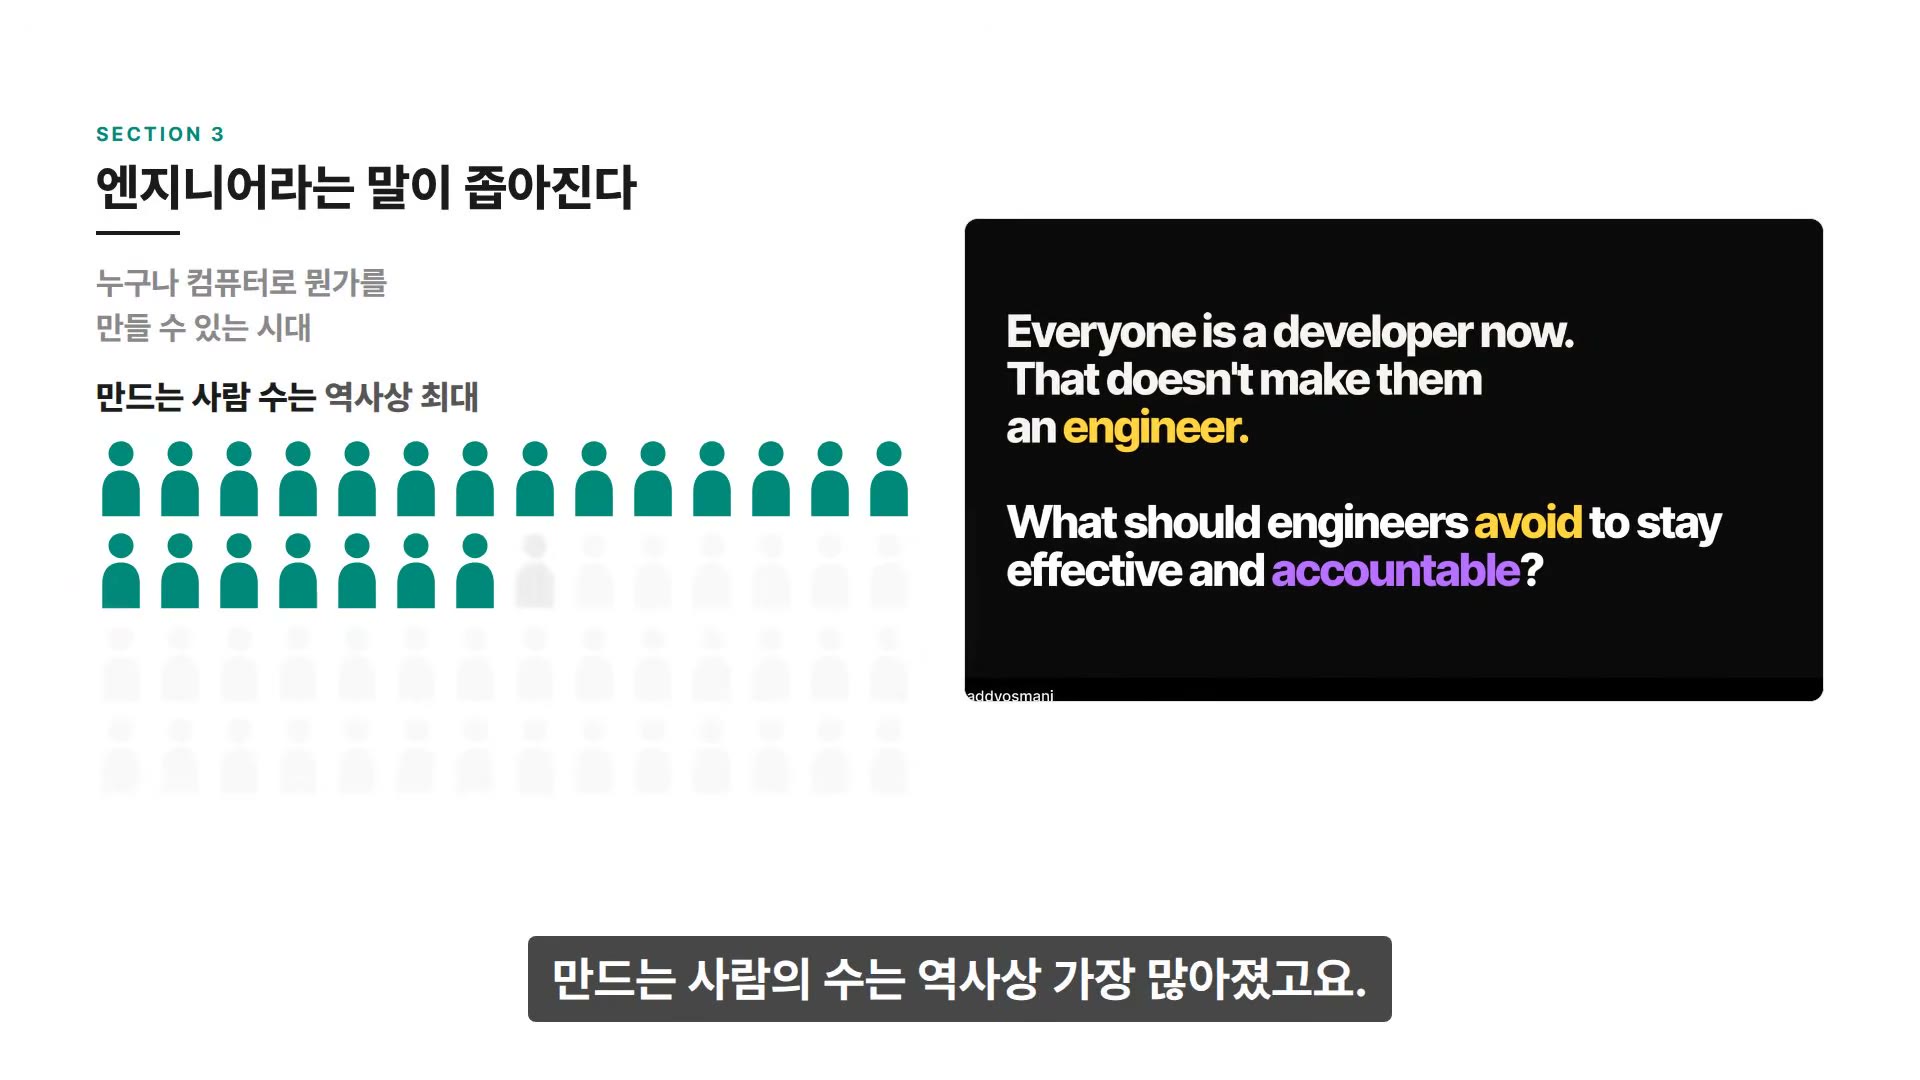
해설이 그 자리를 이름 붙인다. 지금은 누구나 컴퓨터로 뭔가를 만들 수 있는 시대이고 만드는 사람의 수는 역사상 가장 많아졌다. 그런데 슬라이드가 선을 긋는다 — “이제 모두가 개발자다. 그렇다고 그들이 엔지니어가 되는 건 아니다.”
코드를 짜서 결과물을 존재하게 만드는 것과, 시스템을 놓고 판단하는 건 다르다. 제약을 따지고, 트레이드오프를 방어하고, 리스크를 관리하고, 무너졌을 때 연락이 가는 사람. 그리고 슬라이드가 다음 파트의 질문을 던진다 — “엔지니어가 유효하고 책임질 수 있는 상태로 남으려면 무엇을 피해야 하는가?” 잘하는 걸 늘리기 전에 피해야 할 게 먼저 있다는 뜻이다.
[05:30] 12. (발표) 피해야 할 것 ① 인지 부채
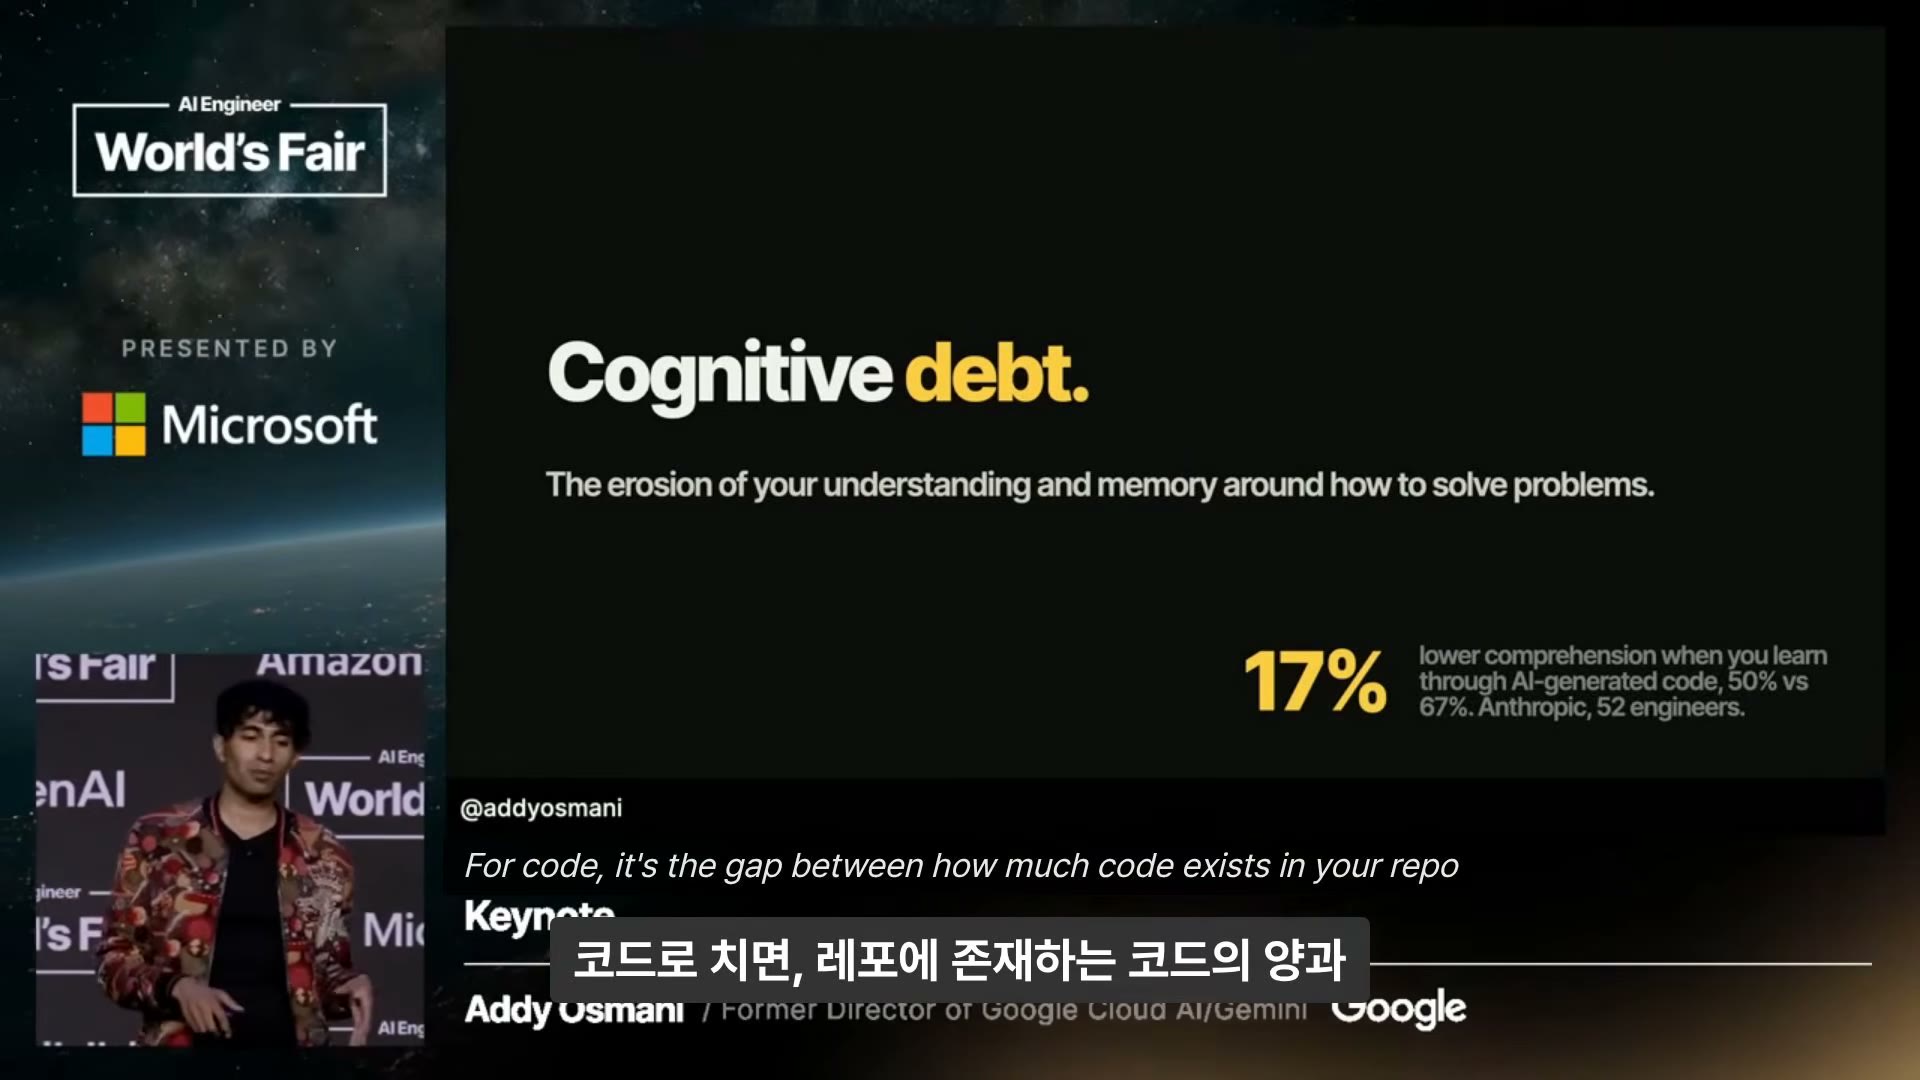
첫 번째는 인지 부채(cognitive debt) — 슬라이드의 정의는 **“문제를 어떻게 푸는지에 대한 당신의 이해와 기억이 침식되는 것”**이다. 근거는 Anthropic이 엔지니어 52명을 대상으로 한 조사다. AI 생성 코드를 통해 배운 경우 이해도가 17%p 낮았다 — 50% 대 67%.
코드로 치면, 레포에 존재하는 코드의 양과 팀의 누군가가 진짜로 이해하는 양 사이의 격차다. 빌드는 통과하고 PR은 머지할 수 있는데, 팀은 자기가 프로덕션에 내보내고 있는 시스템을 설명할 능력을 잃어갈 수 있다.
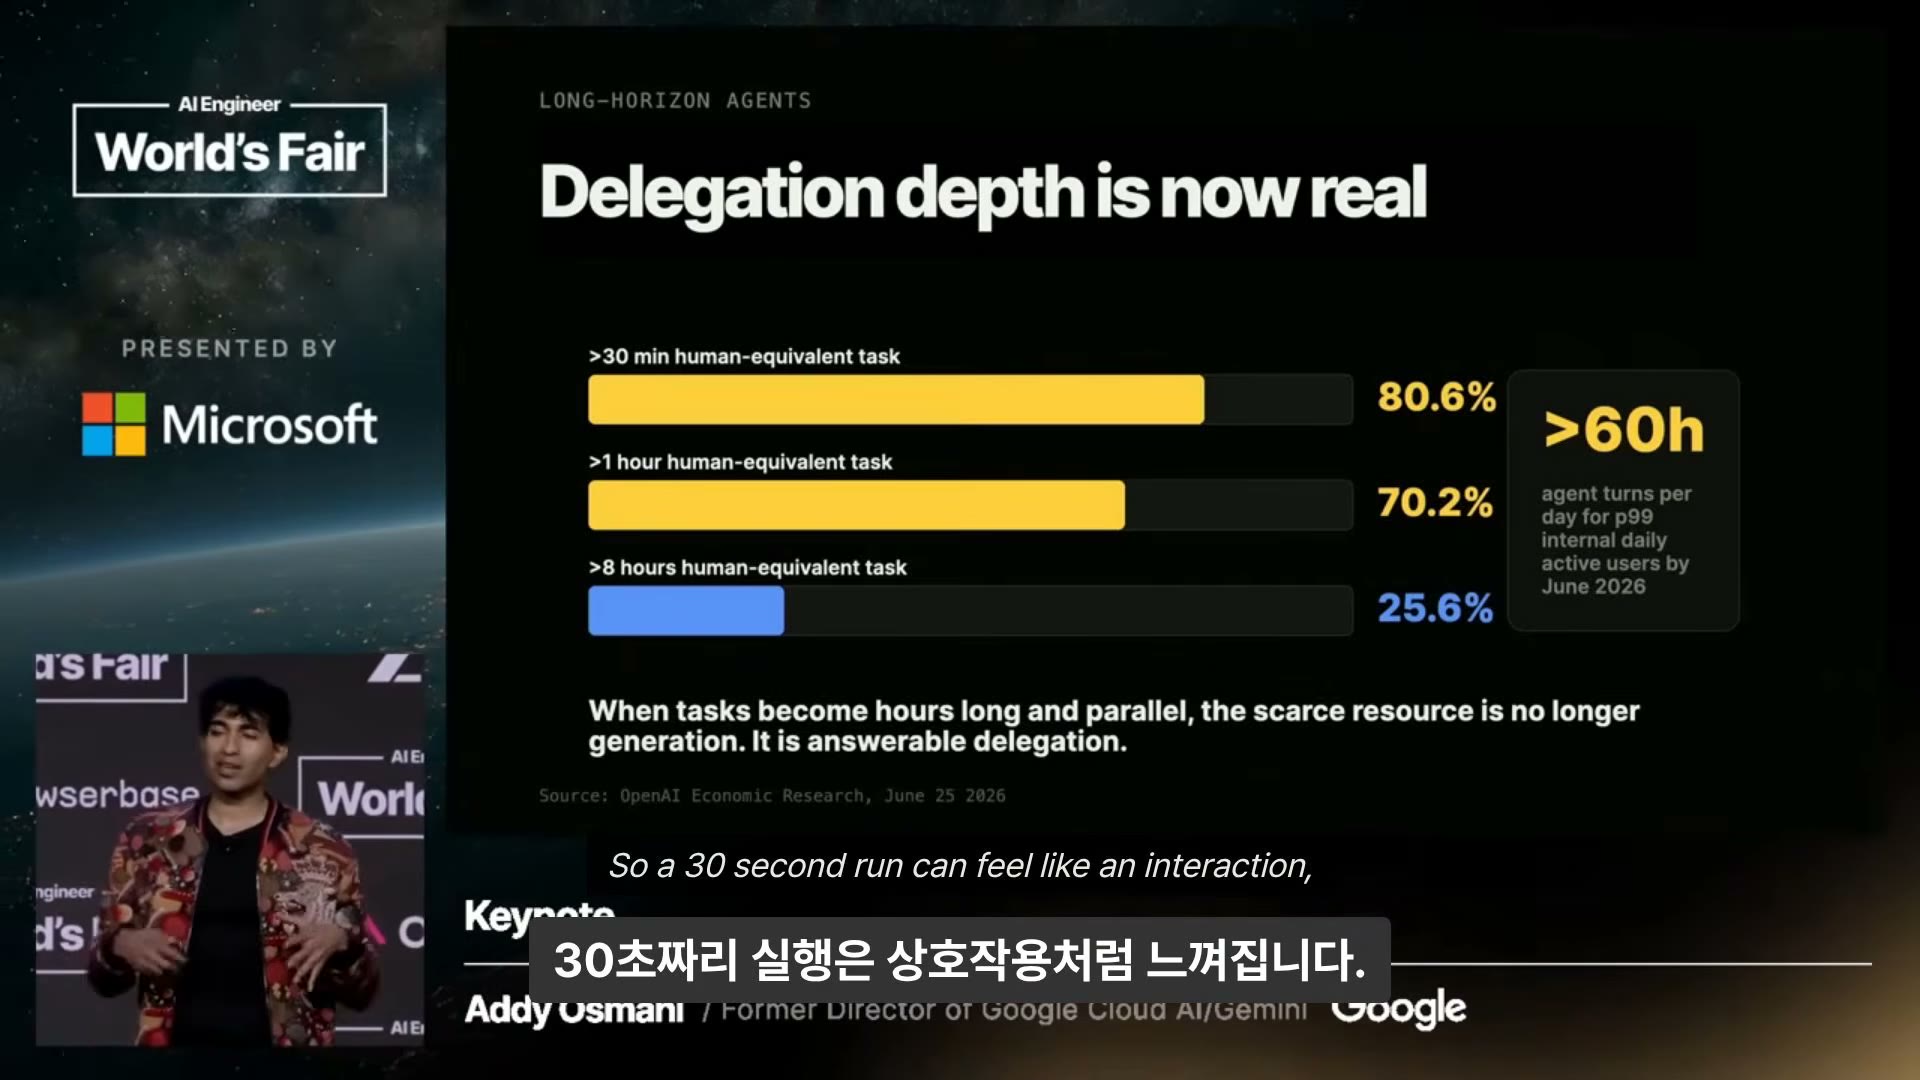
그래서 위임 깊이(delegation depth) 가 중요해진다. OpenAI Economic Research(2026년 6월 25일) 데이터가 그 압력을 보여준다.
| 과제 길이 (사람 기준 환산) | 비율 |
|---|---|
| 30분 초과 | 80.6% |
| 1시간 초과 | 70.2% |
| 8시간 초과 | 25.6% |
여기에 2026년 6월 기준 p99 내부 일간 활성 사용자의 하루 에이전트 턴이 60시간을 넘는다. 오스마니의 표현으로는 에이전트가 사람이 실을 놓칠 만큼 오래 시스템 안에 머무를 수 있게 됐다. 30초짜리 실행은 상호작용처럼 느껴지지만, 한 시간이나 하루 단위의 롱 호라이즌 과제는 워크스트림이다. 그런 과제를, 특히 여러 개를 병렬로 돌리기 시작하면 리뷰는 마지막에 한 번 훑어보는 것일 수 없고 통제 시스템 전체가 되어야 한다. 슬라이드의 결론이 그것이다 — “과제가 몇 시간짜리가 되고 병렬화되면, 희소한 자원은 더 이상 생성이 아니다. 답변 책임이 붙은 위임(answerable delegation)이다.”
[06:23] 13. (발표) 피해야 할 것 ② 인지적 항복
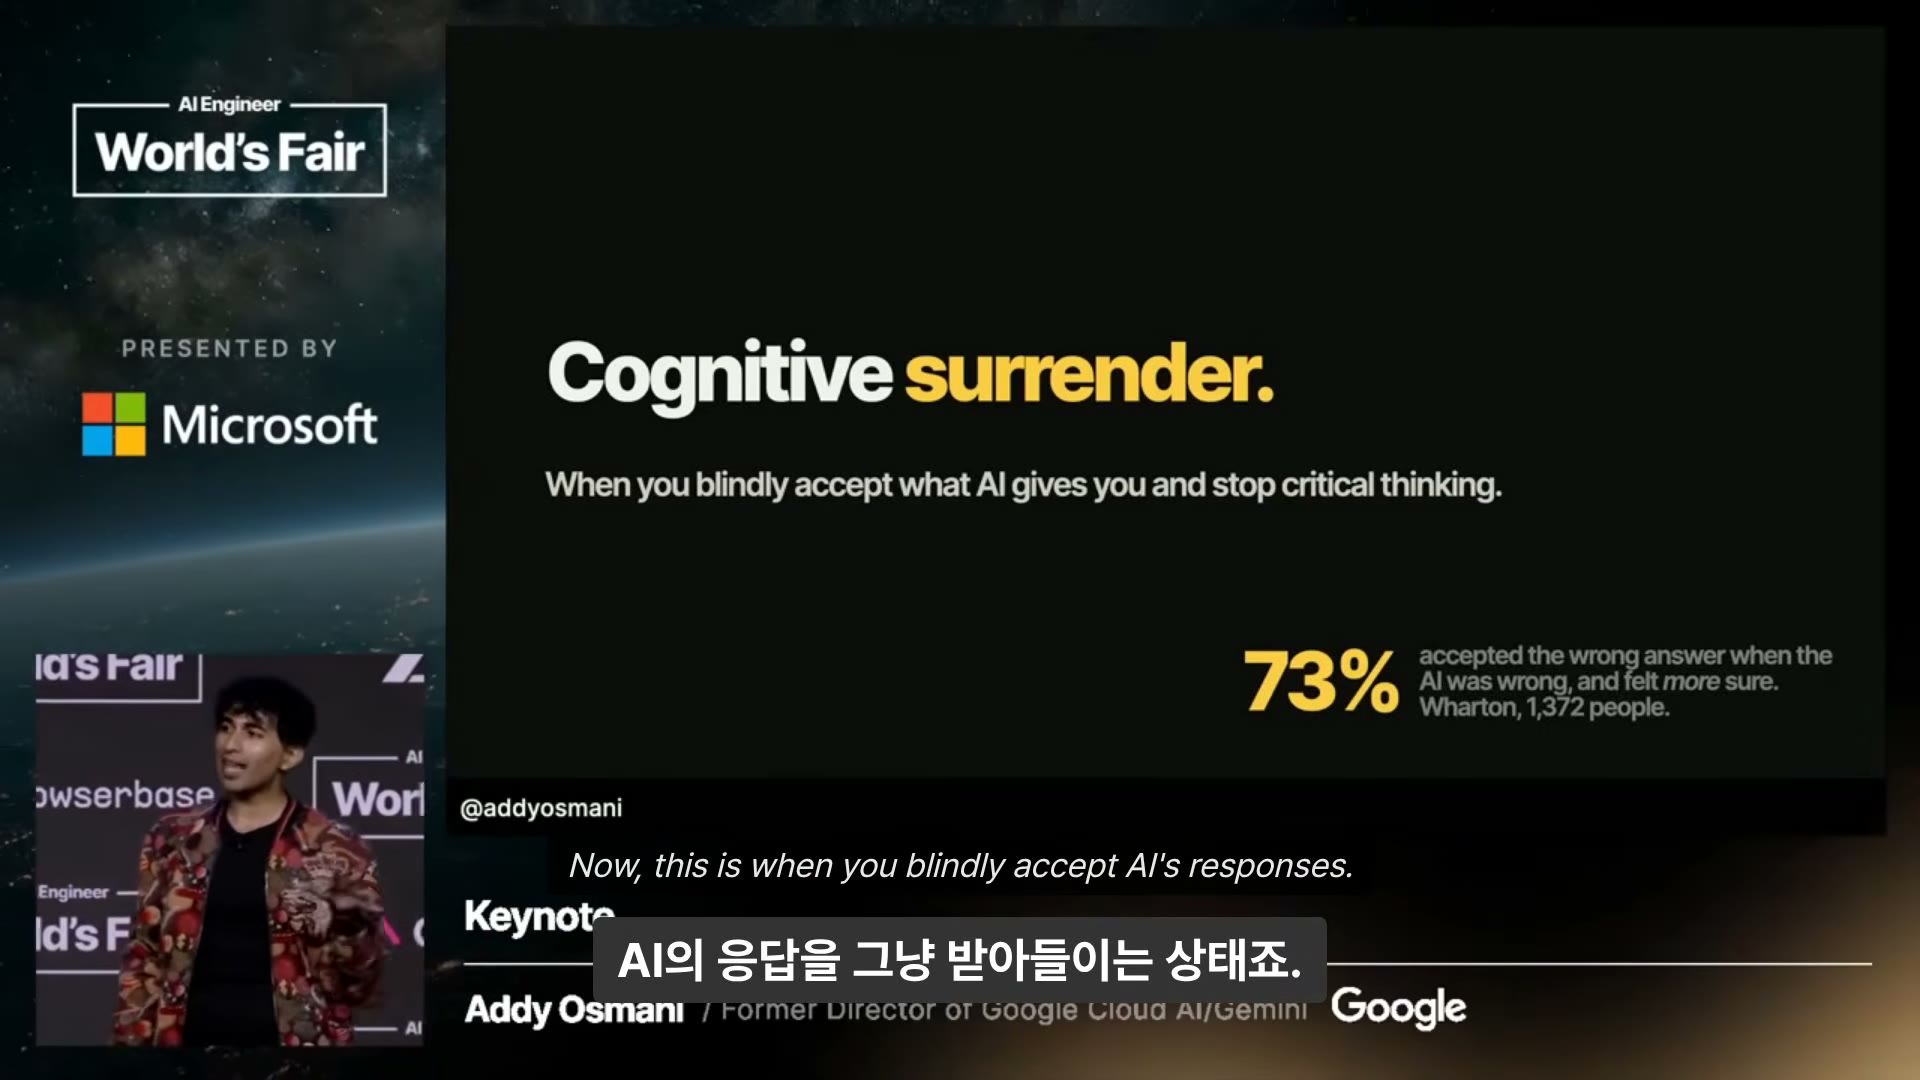
두 번째는 인지적 항복(cognitive surrender) 이다. 오스마니가 위임과 항복을 가르는 방식이 이 발표에서 가장 실용적인 구분이다.
위임은 “일을 하고, 내가 판단할 수 있을 만큼 증거를 보여달라”고 말한다. 그 상황에서 나는 여전히 판단을 내린다. 항복은 “네 답이 이제 내 답이다”라고 말하는 것이다 — 내가 어떤 의견도 만들기 전에.
경고등이 앞의 그 와튼 조사다. AI가 틀렸을 때 73%가 여전히 틀린 답을 골랐고, 더 확신했다. 그래서 실패 모드는 AI를 쓰는 것이 아니라 “빌려 온 확신(borrowed confidence)” 이다.
[07:06] 14. (발표) 피해야 할 것 ③ 오케스트레이션 세금
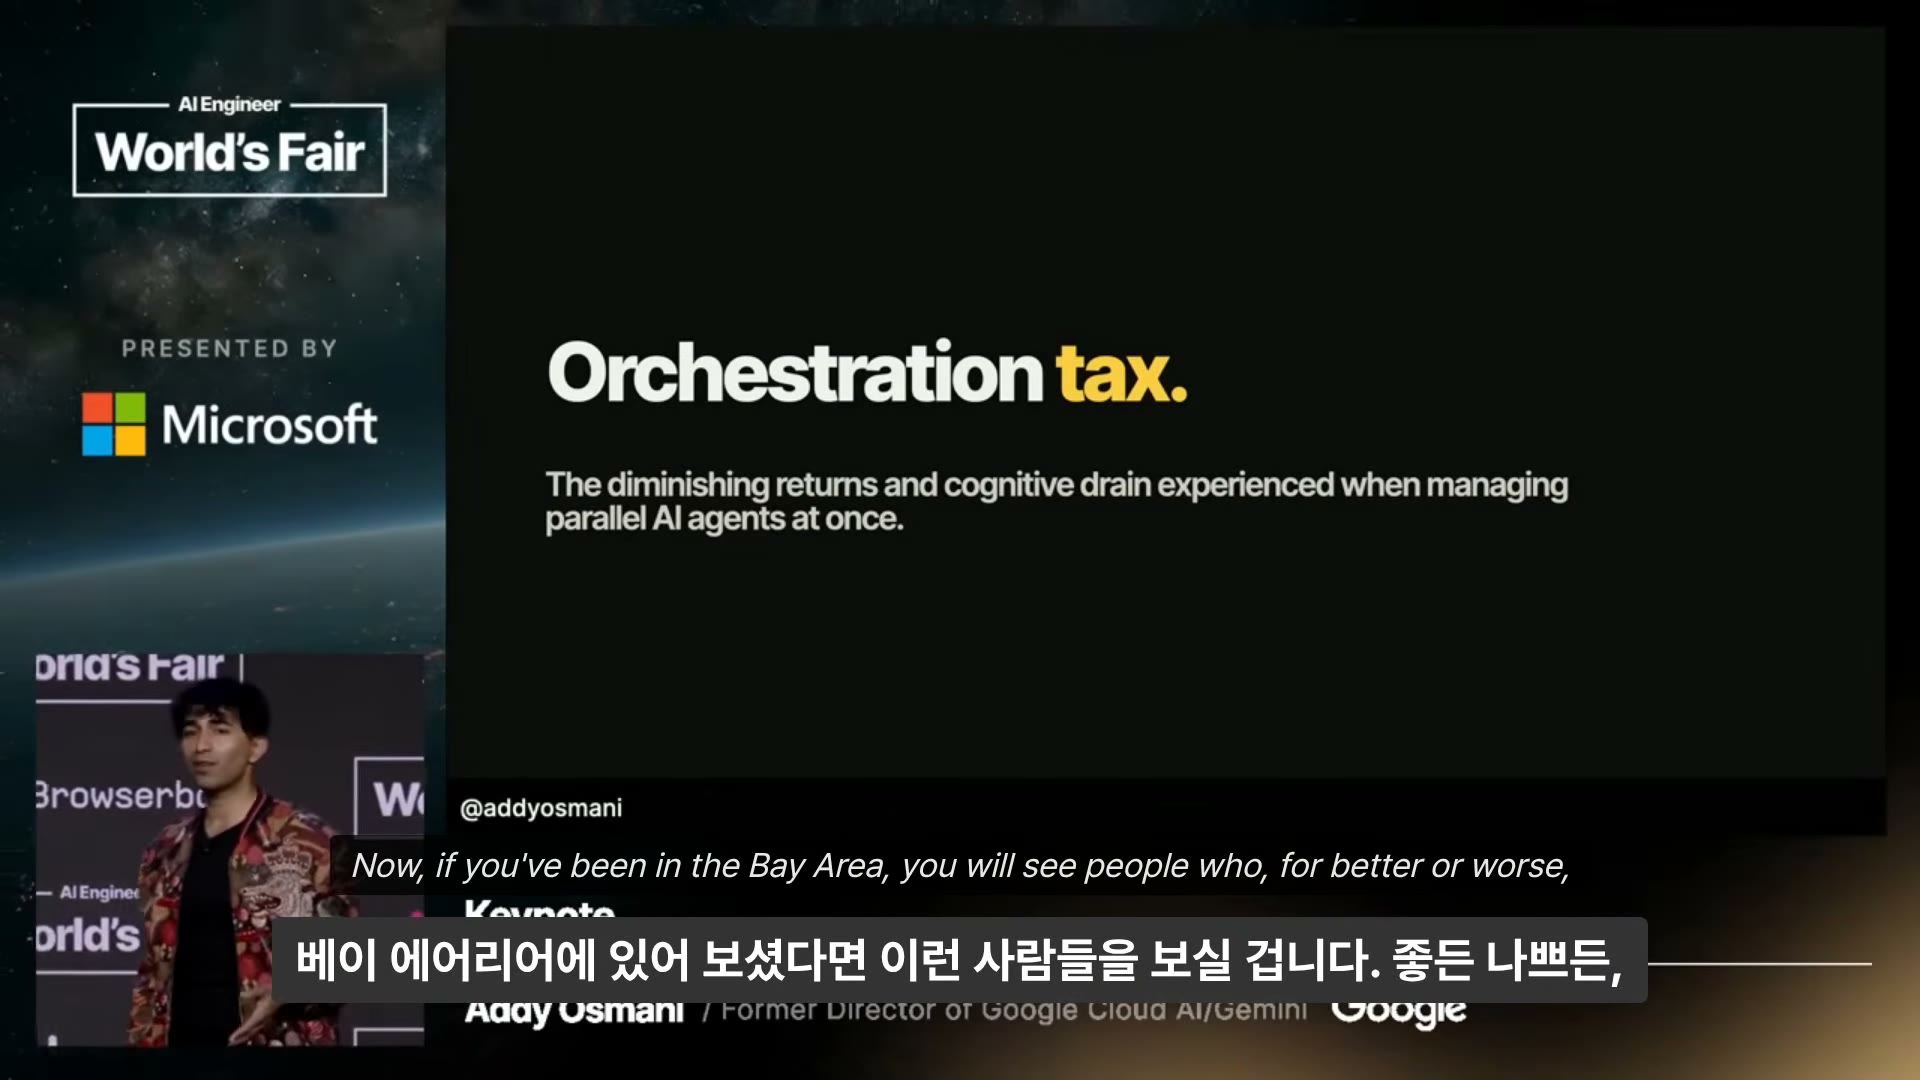
세 번째는 오케스트레이션 세금(orchestration tax) — **“여러 AI 에이전트를 한꺼번에 관리할 때 겪는 수확 체감과 인지적 소모”**다.
베이 에어리어에 있어 봤다면, 좋든 나쁘든 랩톱을 열어 든 채 돌아다니며 클라우드 에이전트 이야기를 하는 사람들을 본다. 다들 점점 더 많은 걸 병렬로 돌리려 하고, 서로에게 수백 개, 수천 개의 에이전트로 배포한다고 말한다. 오스마니의 반박은 짧다.
더 많은 AI 에이전트가 돌아간다고 해서 당신이 더 많아지지는 않습니다. 당신의 인지 대역폭은 병렬화되지 않습니다.
만드는 루프 하나가 늘 때마다 라우팅하고, 머지하고, 검증하고, 통합할 결정이 더 생긴다. 해법은 반드시 에이전트를 줄이는 게 아니라 주의(attention)를 시스템처럼 설계하는 것이다 — 어디서 들어가고, 뭘 확보하고, 뭘 재사용할지.
[07:51] 15. (해설) 셋의 공통점, 그리고 커리어 계산
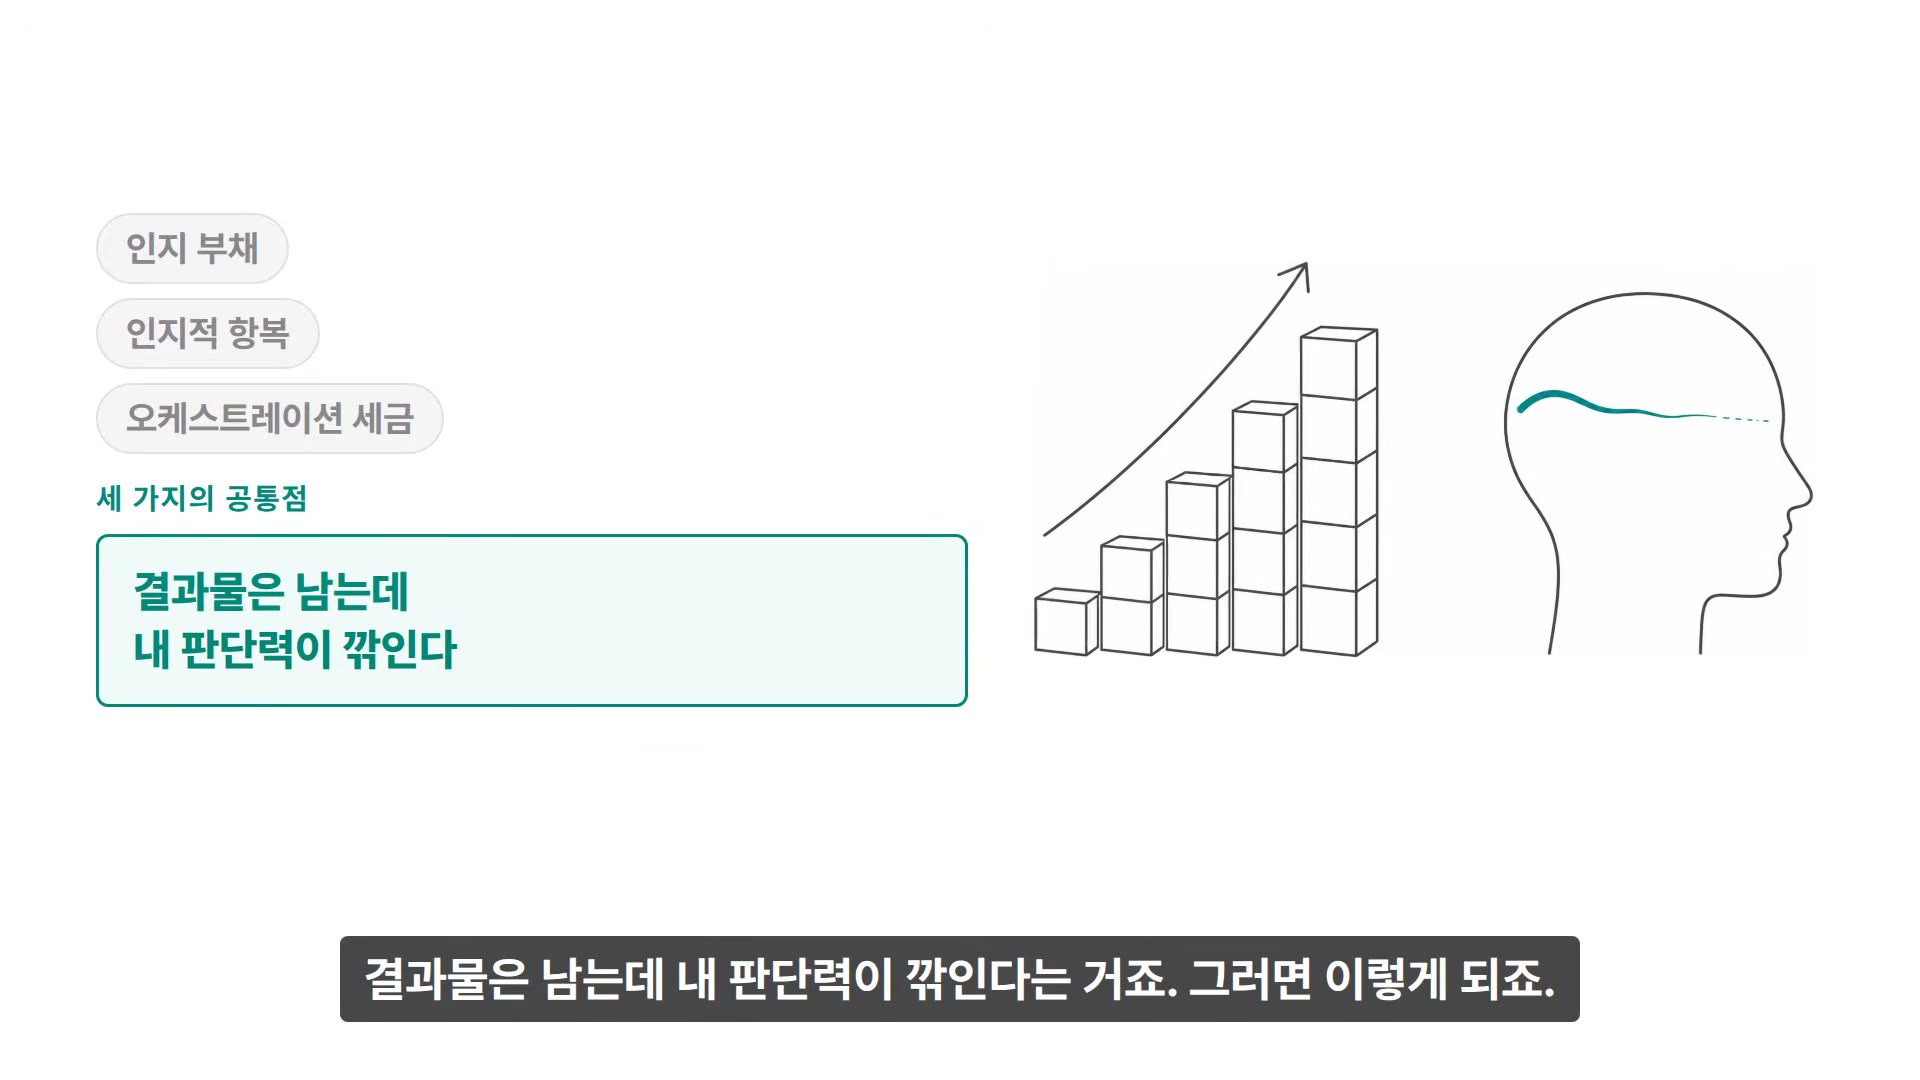
해설이 세 가지를 한 문장으로 묶는다. 결과물은 남는데 내 판단력이 깎인다.
그러면 책임이라는 단어가 무거워진다. 에이전트에게 떠넘기고 숨고 싶어진다. 그런데 발표는 여기서 방향을 뒤집는다 — 책임은 에이전트가 충분히 좋아진 다음에 남는 찌꺼기가 아니라, 나머지 전부를 확장시키는 조건이다.
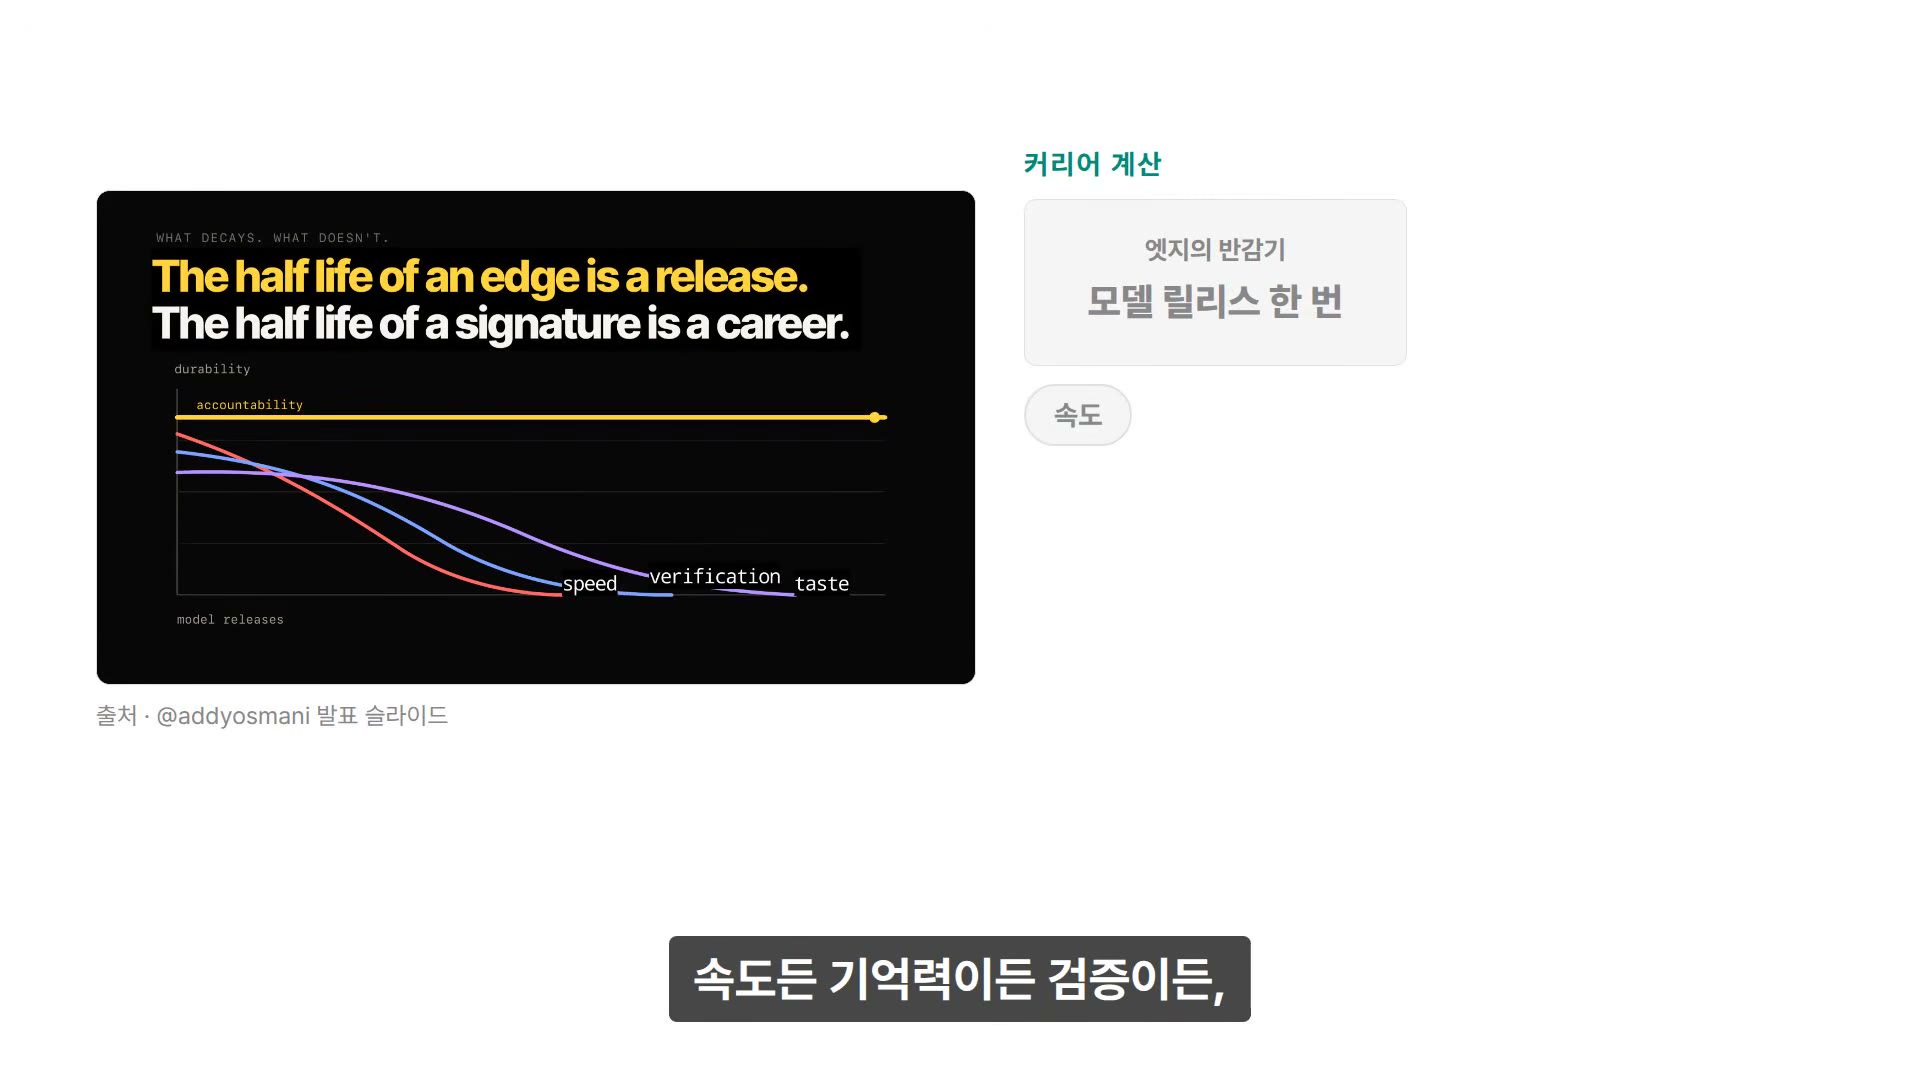
여기서 커리어 계산이 하나 나온다. 슬라이드의 그래프는 x축이 모델 릴리스, y축이 지속성(durability) 이고, speed·verification·taste 곡선은 차례로 무너지는데 accountability만 평평하게 끝까지 간다.
The half life of an edge is a release. The half life of a signature is a career. (엣지의 반감기는 릴리스 한 번, 서명의 반감기는 커리어 전체.)
엣지의 반감기가 모델 릴리스 한 번인 이유는 간단하다 — 속도든 기억력이든 검증이든, 프런티어가 움직이면 같이 움직인다. 서명은 결과물에 붙는 이름이다. 내가 내보낸 것 뒤에 서 있는 사람, 팀, 조직. 그러니까 스킬은 레버리지를 벌고, 책임은 그 레버리지를 신뢰로 바꾼다.
[08:27] 16. (발표) 실행과 책임은 다르다
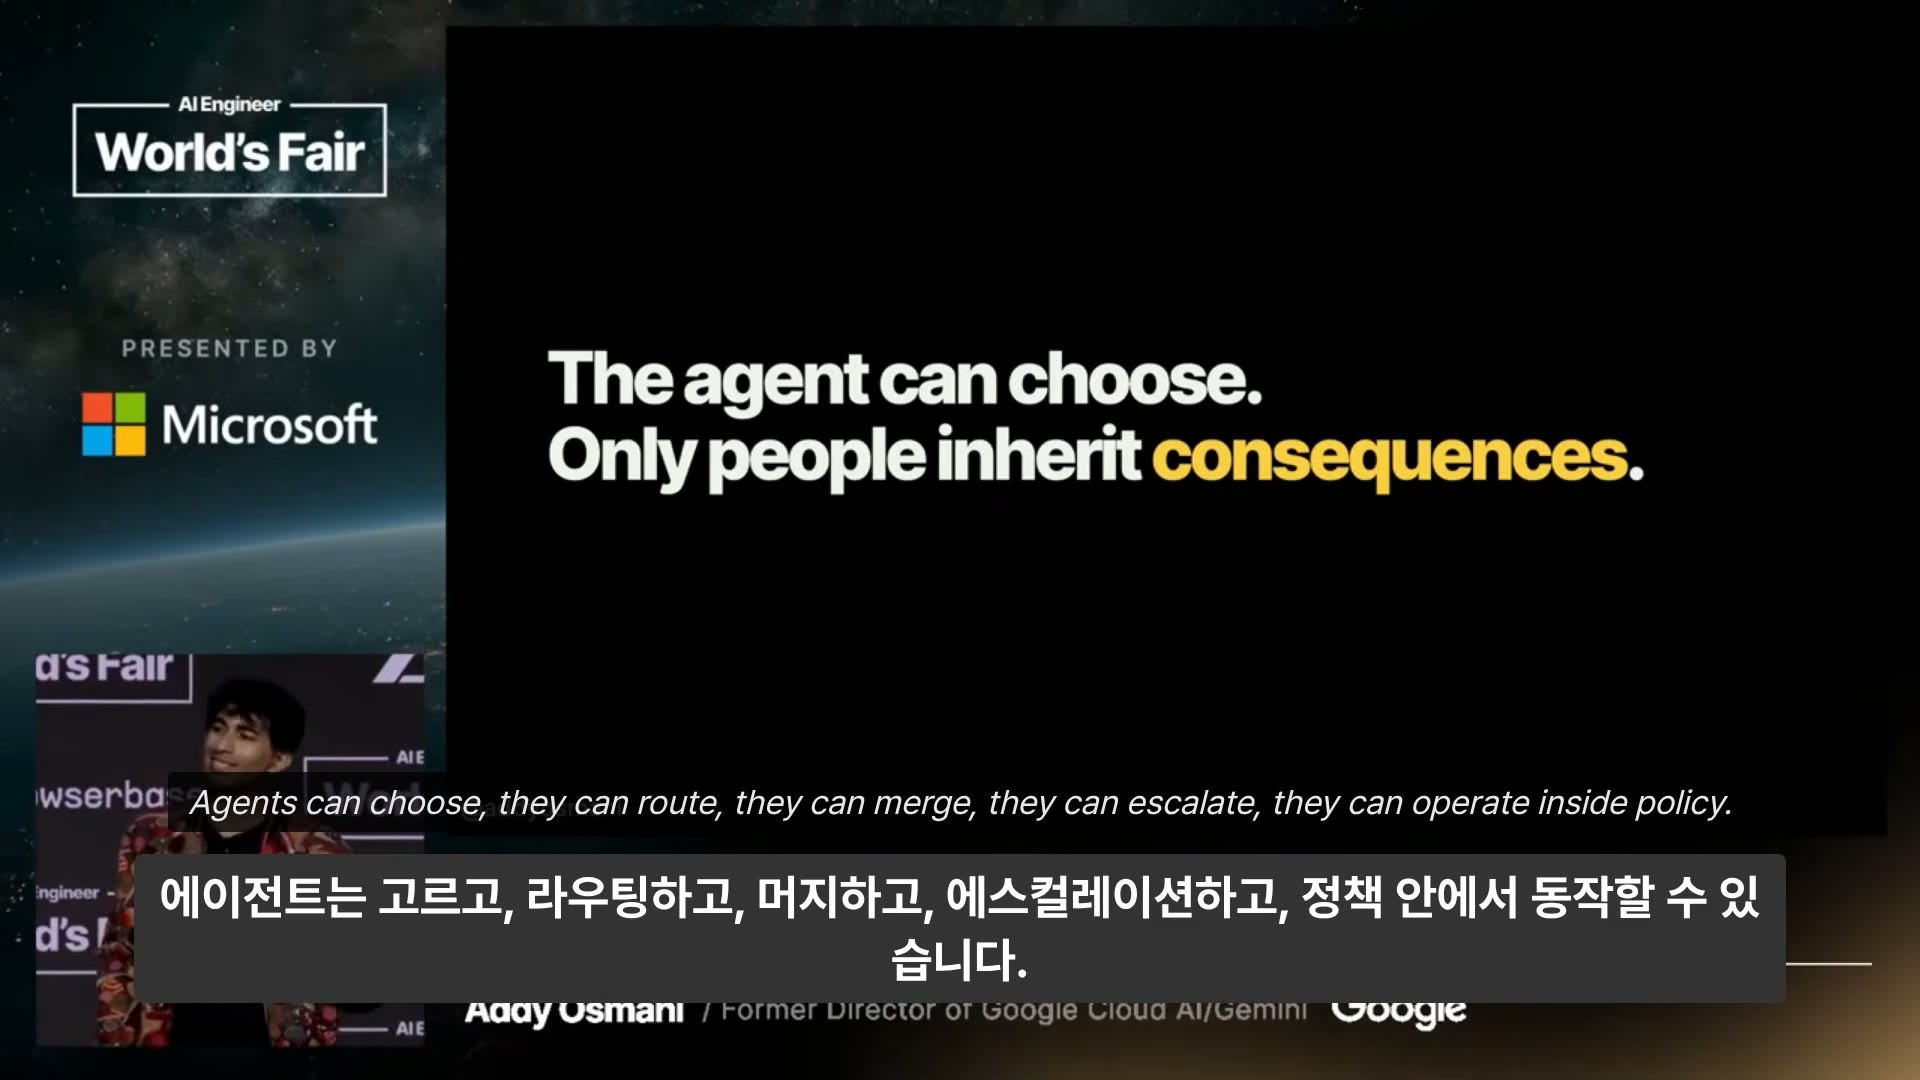
오스마니가 가장 분명하게 긋고 싶어 하는 선이 여기다. 에이전트는 고르고, 라우팅하고, 머지하고, 에스컬레이션하고, 정책 안에서 동작할 수 있다. 많은 시스템에서 실제로 그럴 수 있고, 그래야 한다. 그런데 실행(execution)과 책임(responsibility)은 아주 다른 것이다.
에이전트는 당신의 런북을 따를 수 있지만, 결과를 상속받을 수는 없습니다.
뭔가 실패했을 때 남는 질문은 이거다 — 누가 그 정책을 이해했나? 누가 리스크를 수용했고, 누가 블래스트 레이디어스(blast radius)를 소유하나?
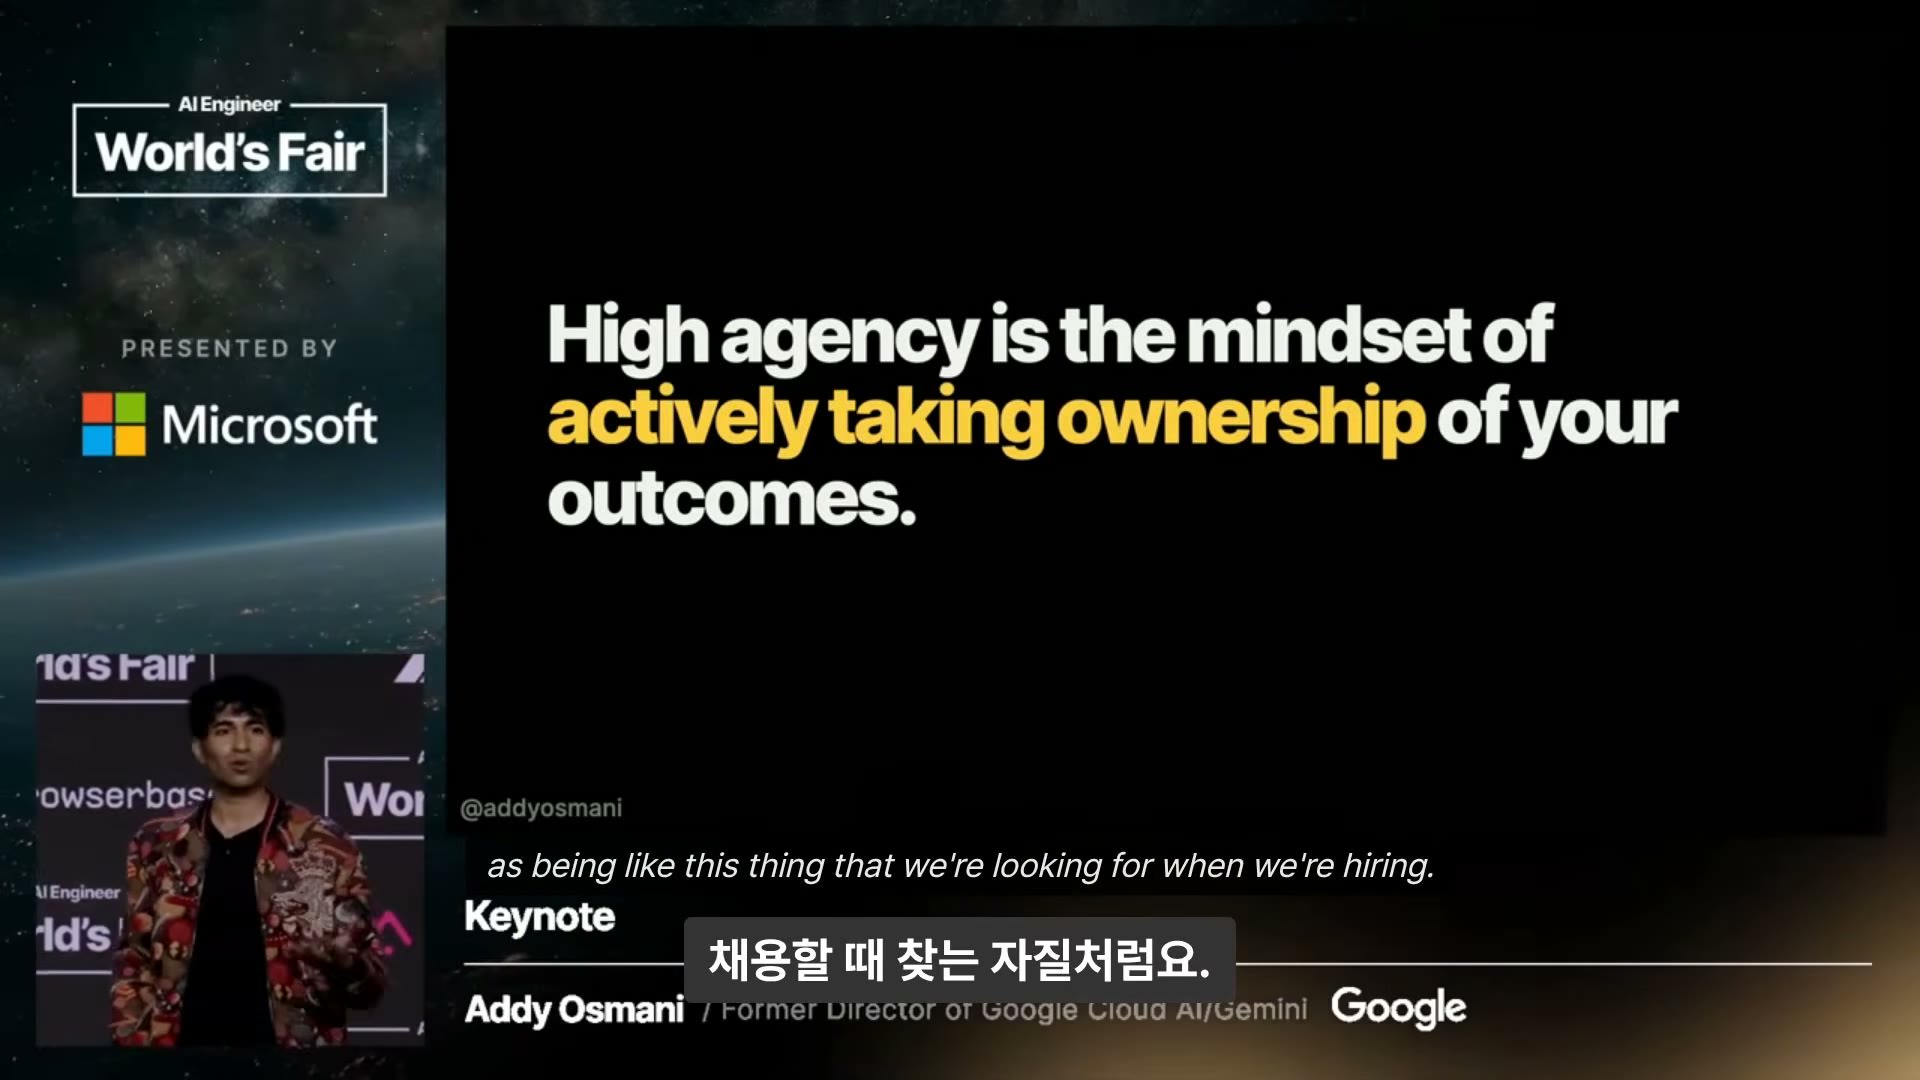
요즘 채용에서 다들 찾는다는 하이 에이전시(high agency) 를 여기에 연결한다. 슬라이드의 정의는 **“자기 결과물의 소유권을 능동적으로 가져가는 마인드셋”**이고, 실무로는 언제 위임하고, 언제 들여다보고, 언제 멈추고, 언제 결과에 내 이름을 붙일지 아는 것이다.
이 세계에서 하이 에이전시는 “내가 전부 직접 한다”가 아니다. 그 버전은 확장되지 않는다. 허슬 연극이 아니라 판단이 붙은 소유(ownership with judgment attached) 다.
[09:20] 17. (발표) 에이전시 사다리 — 문제의 얼마만큼을 소유하는가
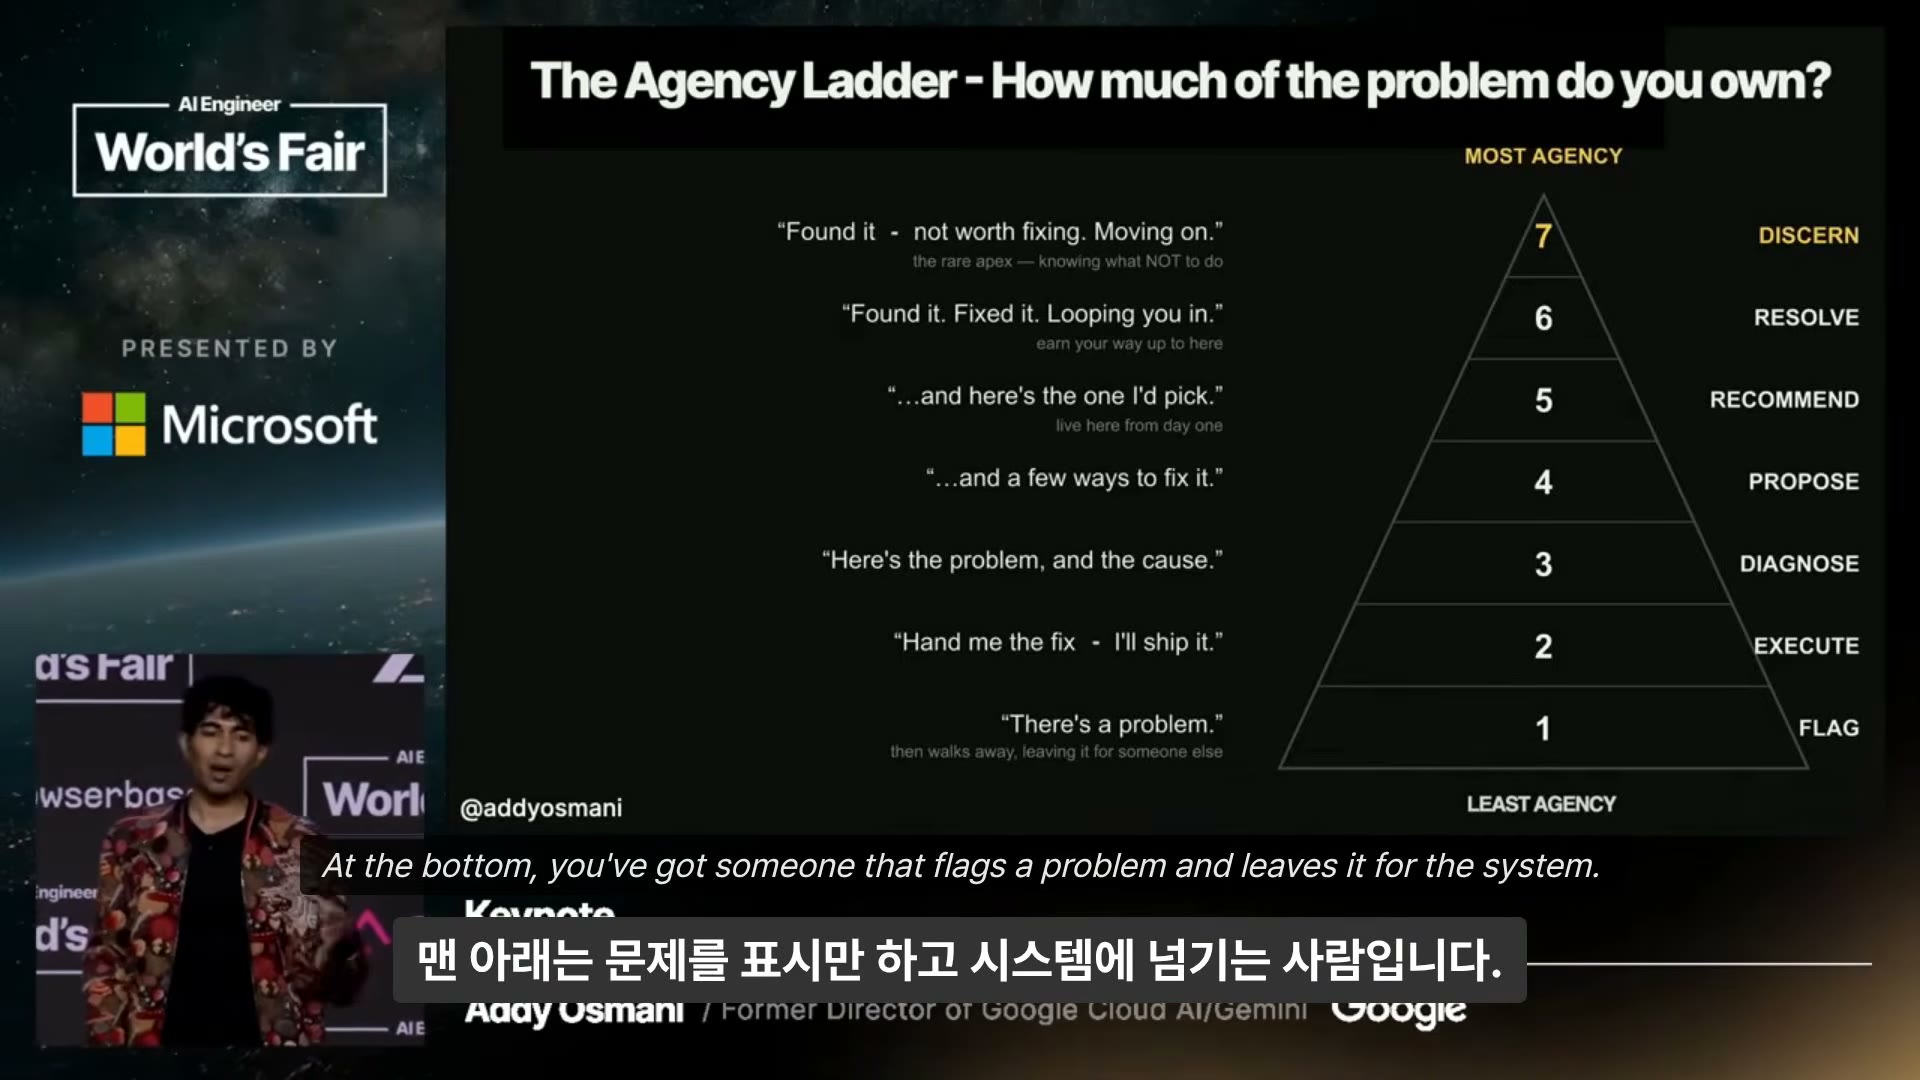
이걸 조금 더 구체적으로 만든 게 에이전시 사다리(The Agency Ladder) 다. 부제가 곧 축이다 — “문제의 얼마만큼을 당신이 소유하는가?”
| 단계 | 이름 | 그 사람이 하는 말 |
|---|---|---|
| 7 | DISCERN | ”찾았는데 — 고칠 가치가 없어요. 넘어갑시다.” (드문 정점 — 무엇을 하지 않을지 아는 것) |
| 6 | RESOLVE | ”찾았고, 고쳤고, 공유드립니다.” (여기까지는 실력으로 올라와야 한다) |
| 5 | RECOMMEND | ”…그리고 제가 고른다면 이겁니다.” (첫날부터 여기서 살아라) |
| 4 | PROPOSE | ”…그리고 고칠 방법 몇 가지요.” |
| 3 | DIAGNOSE | ”문제는 이거고, 원인은 이겁니다.” |
| 2 | EXECUTE | ”고치는 걸 주세요 — 제가 내보낼게요.” |
| 1 | FLAG | ”문제가 있어요.” (그리고 걸어 나가 남에게 넘긴다) |
맨 위가 분별(discernment) 인 게 이 사다리의 핵심이다. 문제를 찾고서 투자할 가치가 있는지 결정하는 것 — 아닐 수도 있고, 그러면 넘어간다. 에이전트가 가능한 경로를 더 많이 만들어낼수록, 에이전시는 모든 경로를 쫓는 게 아니라 어떤 경로가 내 소유와 주의를 받을 자격이 있는지 정하는 일이 된다.
[09:54] 18. (발표) 안쪽 고리는 역량, 바깥 고리는 에이전시
이걸 운영 모델로 옮기면 발표의 제목이 된다. 에이전트는 안쪽 실행 루프를 훨씬 많이 돌릴 수 있다 — 조사하고, 구현하고, 테스트하고, 보고한다. 거기에 레버리지가 있다. 그런데 바깥 고리는 여전히 엔지니어링이다 — 결정하고, 검증하고, 승인하고, 소유하는 것.
안쪽 고리는 역량(capability)이고, 바깥 고리는 에이전시(agency)다.
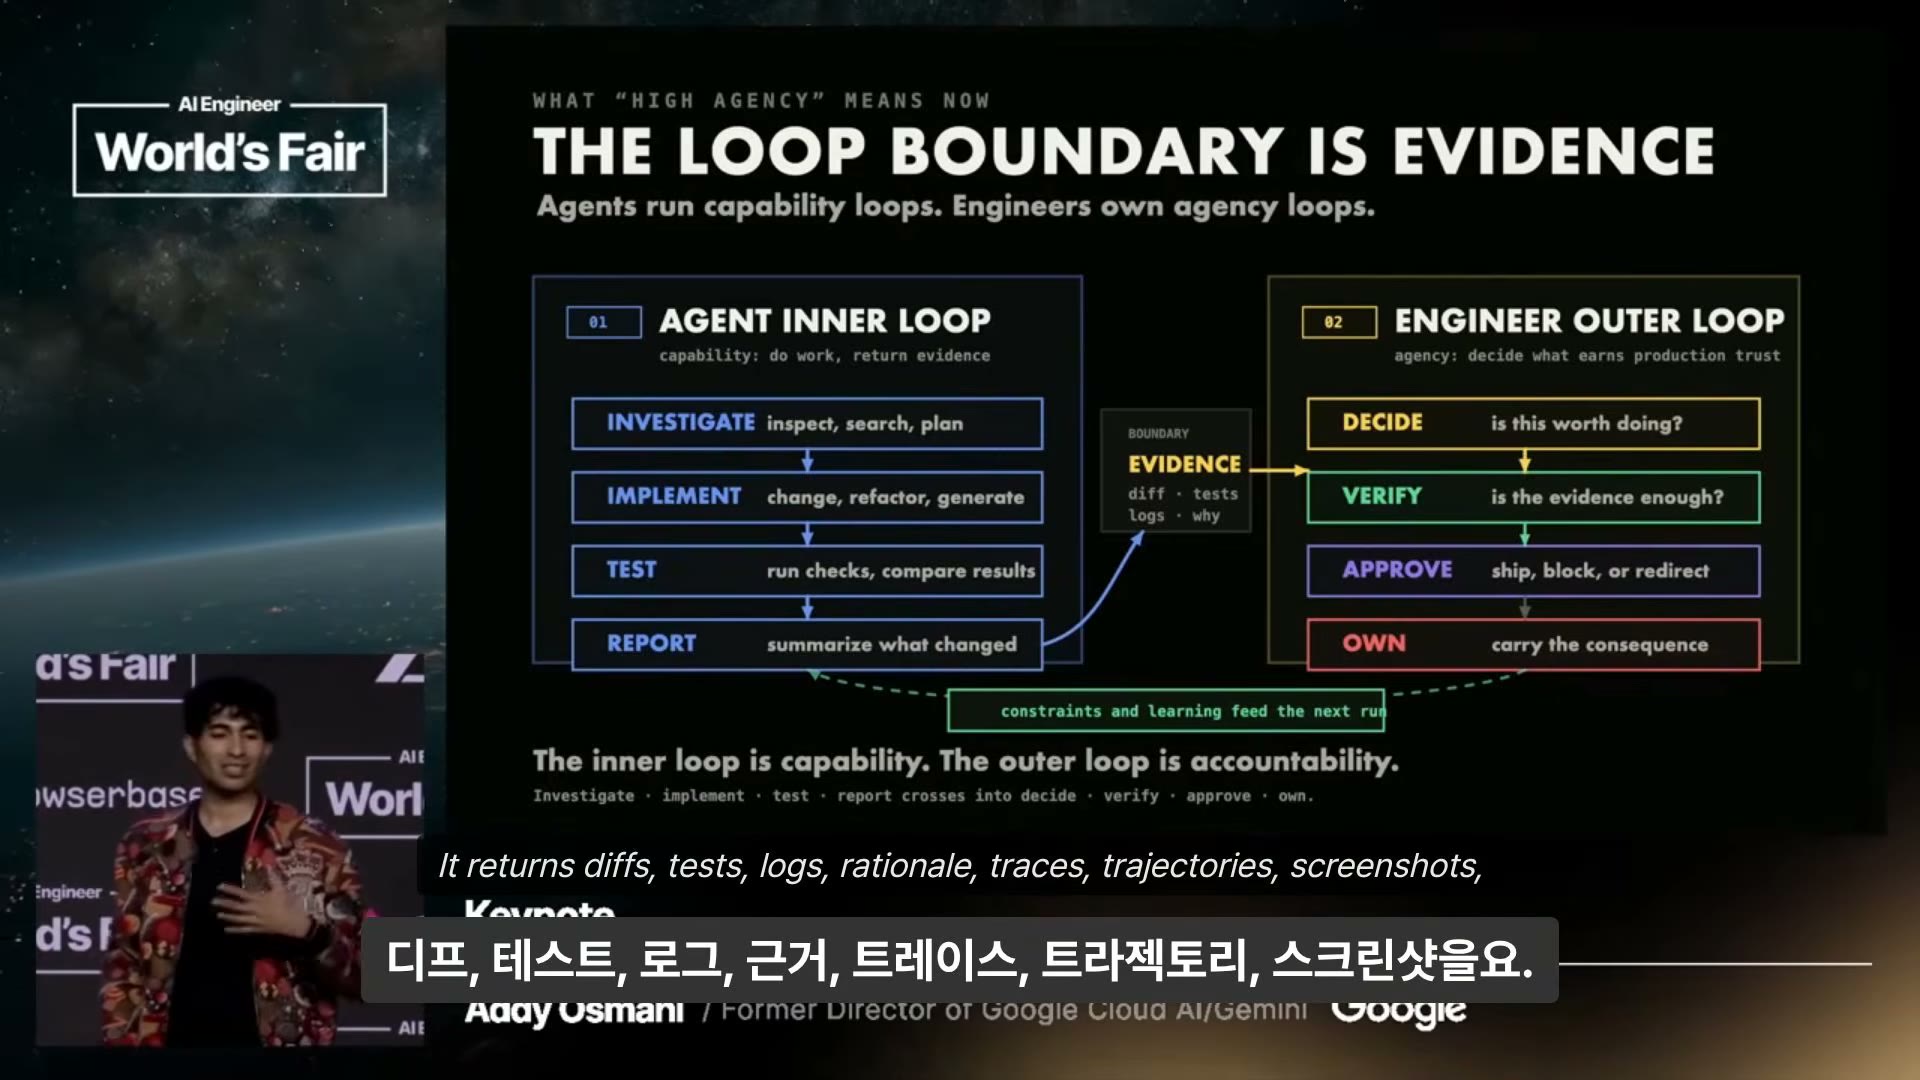
경계를 그린 슬라이드가 이 발표의 중심 도해다. 부제가 “Agents run capability loops. Engineers own agency loops.”
| 01 AGENT INNER LOOP (capability: 일을 하고 증거를 돌려준다) | 02 ENGINEER OUTER LOOP (agency: 무엇이 프로덕션의 신뢰를 얻는지 결정한다) |
|---|---|
| INVESTIGATE — 조사, 검색, 계획 | DECIDE — 이건 할 가치가 있는가? |
| IMPLEMENT — 변경, 리팩터, 생성 | VERIFY — 증거가 충분한가? |
| TEST — 검사 실행, 결과 비교 | APPROVE — 내보내거나, 막거나, 되돌린다 |
| REPORT — 무엇이 바뀌었는지 요약 | OWN — 결과를 짊어진다 |
둘 사이에 있는 것이 BOUNDARY: EVIDENCE — diff · tests · logs · why다. 그리고 아래로 제약과 학습이 다음 실행에 다시 먹여진다(constraints and learning feed the next run).
오스마니의 설명은 이렇다. 에이전트는 증거를 돌려준다 — 디프, 테스트, 로그, 근거, 트레이스, 트라젝토리, 스크린샷, 그 일이 요구하는 무엇이든. 그리고 거기서부터 진짜 엔지니어링이 시작된다. 에이전트를 몇 개 쓰든 수천 개를 쓰든 이 아이디어는 똑같이 적용된다.
경계는 “사람이 AI 출력을 들여다본다”가 아닙니다. 경계는 증거와 책임입니다.
[11:08] 19. (해설) 다섯 줄 정리
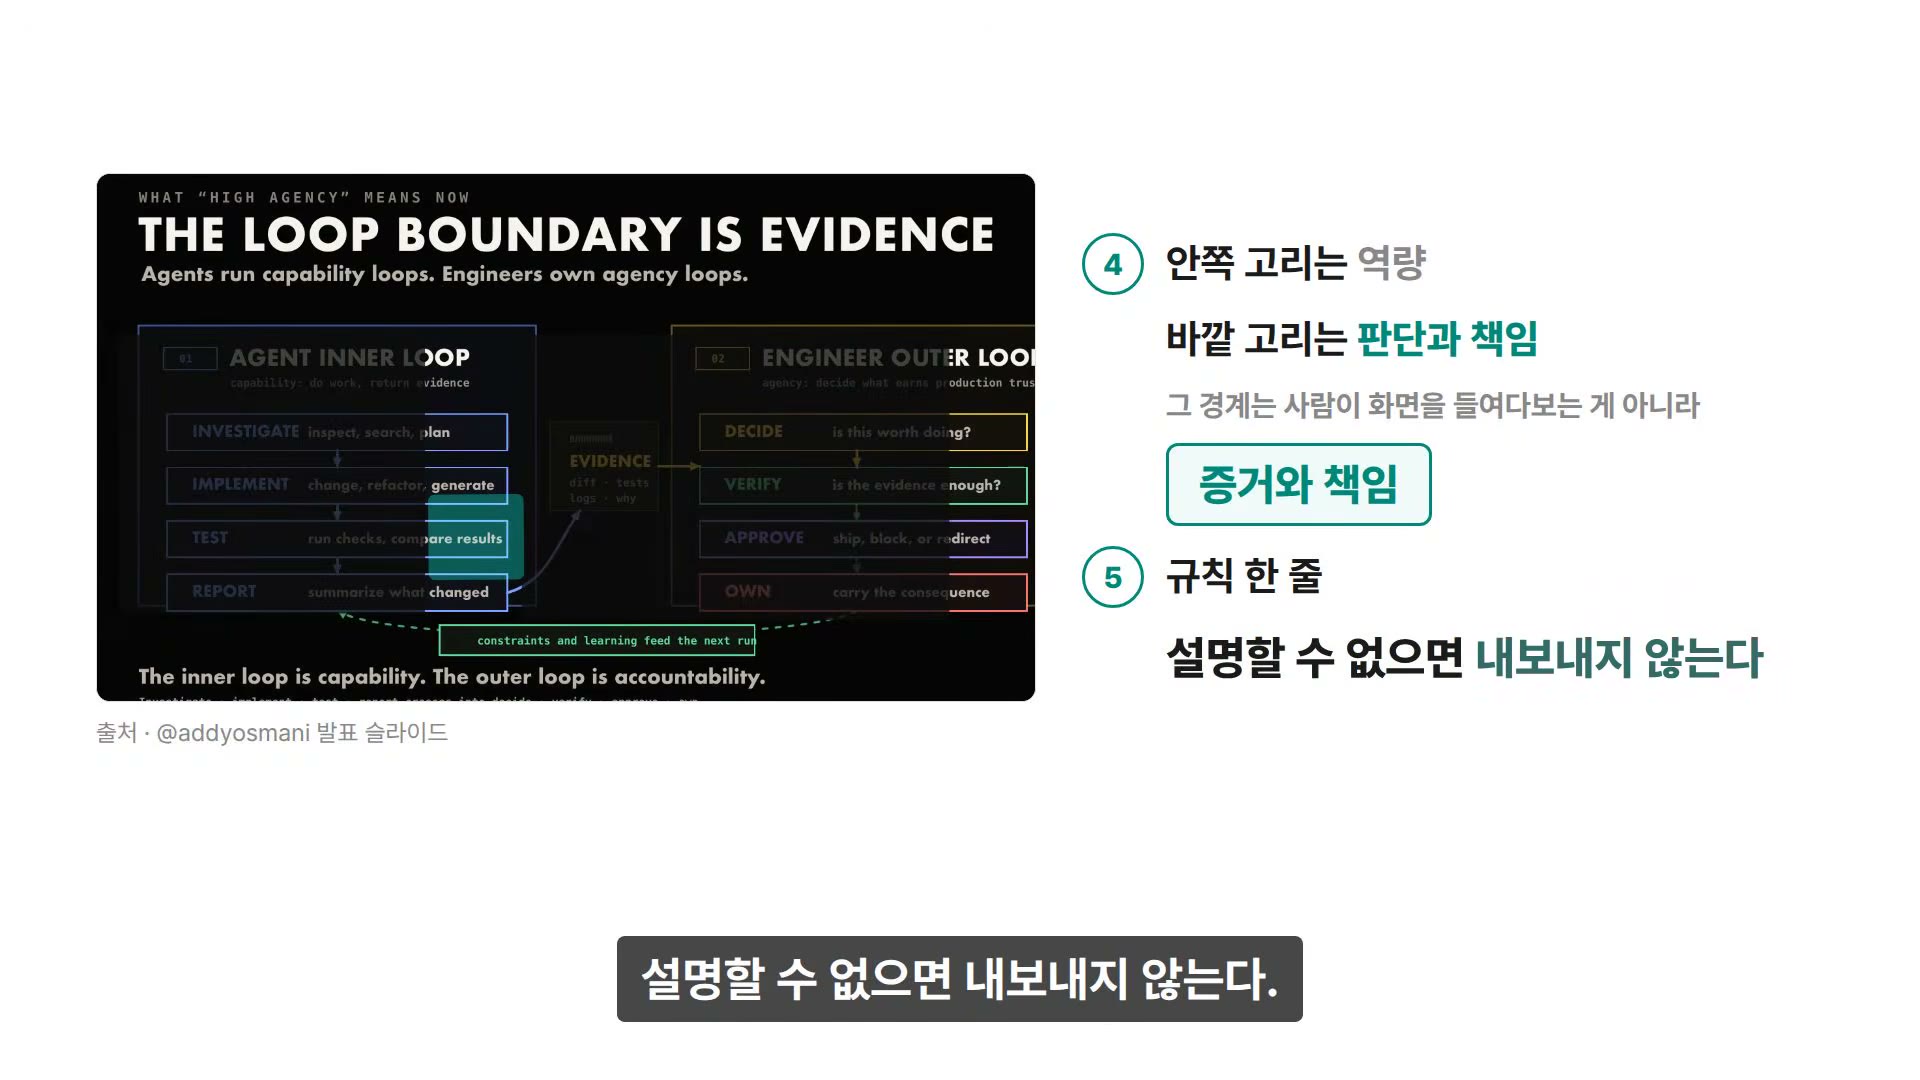
| # | 내용 |
|---|---|
| 하나 | 만드는 비용은 계속 내려가는데, 확인하는 비용은 그대로다 (생성 ↓ → 검증 →) |
| 둘 | 역량이면 사라진다. 속도도 기억력도 검증도 이미 넘어갔고, 취향도 예외가 아니다 |
| 셋 | 에이전트를 쓸수록 세 가지가 조용히 샌다 — 인지 부채, 인지적 항복, 오케스트레이션 세금 |
| 넷 | 안쪽 고리는 역량, 바깥 고리는 판단과 책임. 그 경계는 사람이 화면을 들여다보는 게 아니라 증거와 책임이다 |
| 다섯 | 규칙 한 줄 — 설명할 수 없으면 내보내지 않는다 |
[11:29] 20. (해설) 만들기 쉬워질 때마다, 우리는 더 많이 만들었다
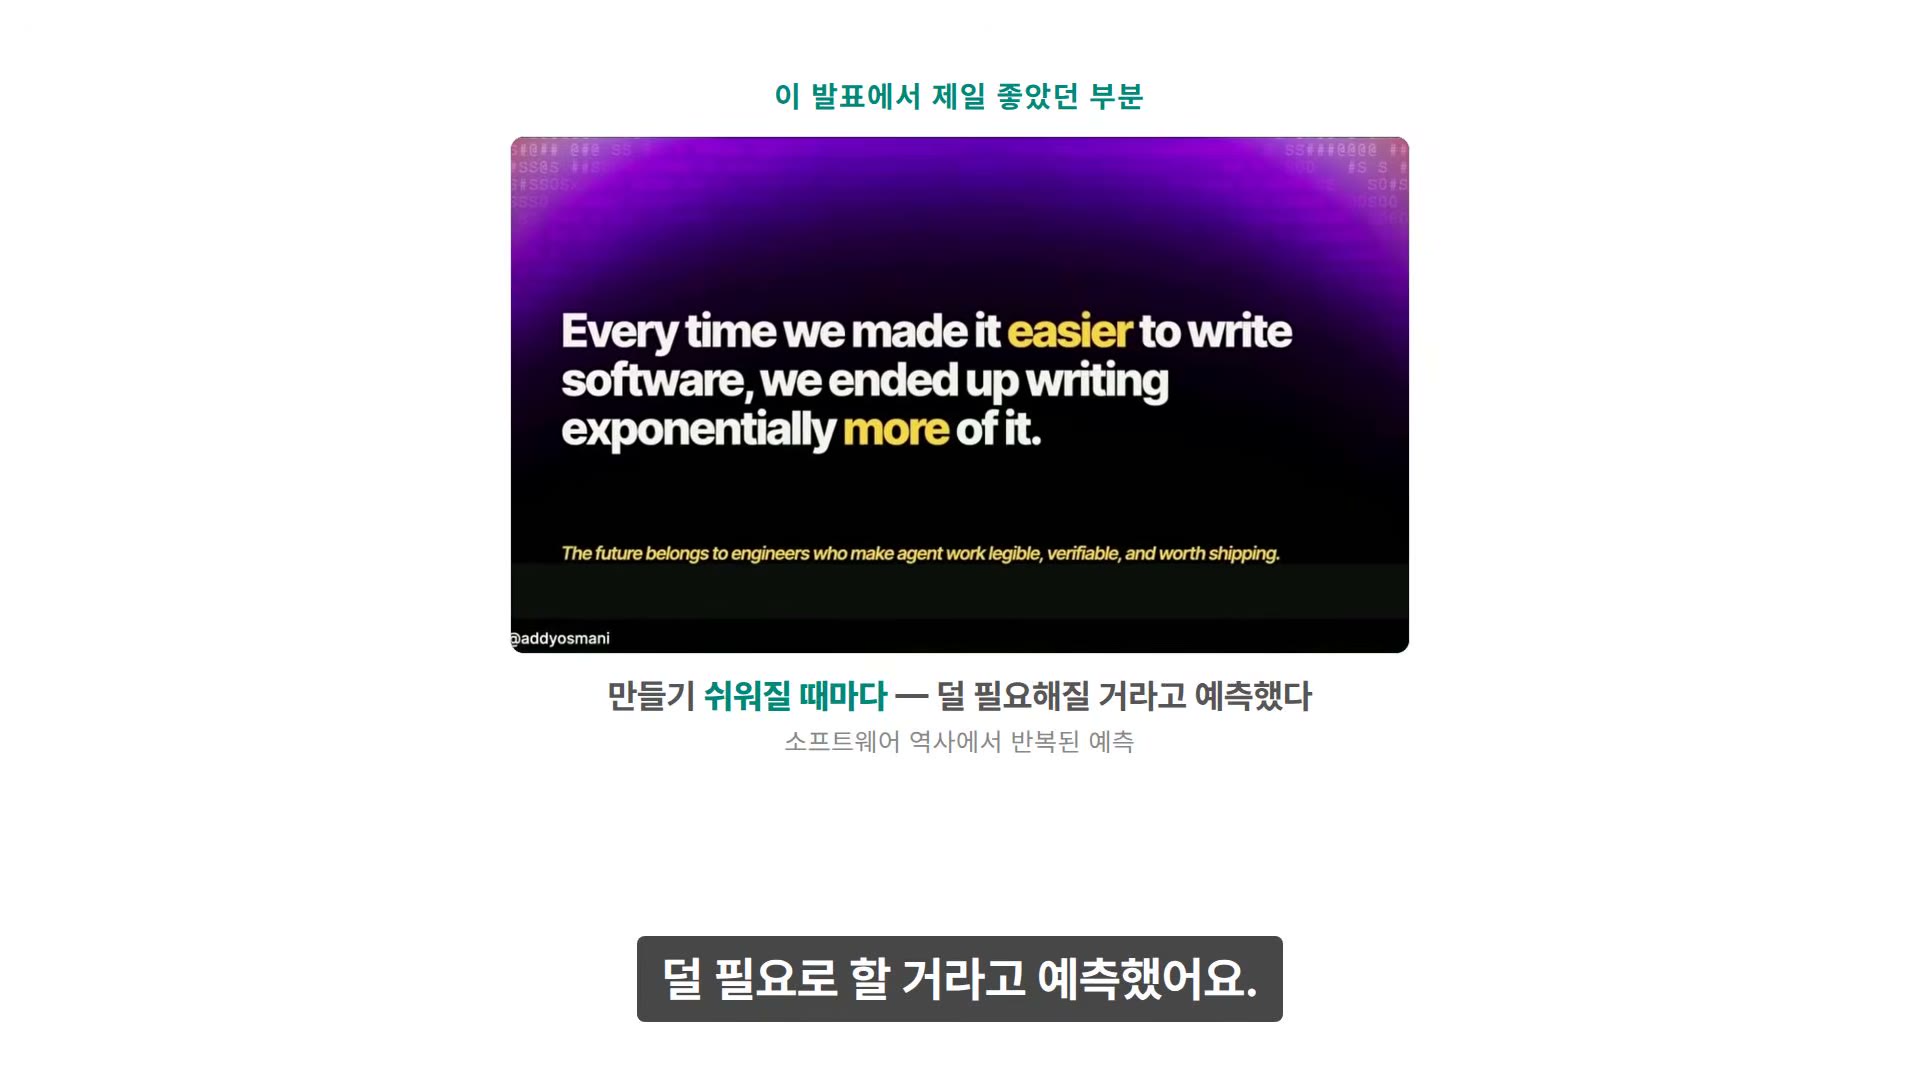
해설이 “이 발표에서 제일 좋았던 부분”으로 꼽는 대목이다. 슬라이드는 이렇게 적혀 있다.
Every time we made it easier to write software, we ended up writing exponentially more of it. The future belongs to engineers who make agent work legible, verifiable, and worth shipping. (소프트웨어를 쓰기 쉽게 만들 때마다, 우리는 결국 기하급수적으로 더 많이 썼다. 미래는 에이전트의 작업을 읽을 수 있고, 검증 가능하고, 내보낼 가치가 있게 만드는 엔지니어의 것이다.)
소프트웨어를 만들기 쉬워질 때마다 사람들은 세상이 소프트웨어를 덜 필요로 할 거라고 예측했다. 고급 언어가 나왔을 때, 프레임워크가 나왔을 때, 클라우드가, 로우코드가 나왔을 때. 근데 매번 반대로 갔다. 비용이 내려가니까 그동안 만들 엄두를 못 냈던 것들이 쏟아져 나왔다.
에이전트도 같은 일을 할 거라는 게 결론이다. 엔지니어링을 없애는 게 아니라 병목을 옮기는 것 — “이걸 만들 수 있나”에서 “이게 존재해야 하나, 그리고 우리가 그걸 책임질 수 있나”로.
부록 — 실전 체크리스트
- 내보내기 전에 한 줄로 자문한다 — “설명할 수 있는가?” 설명할 수 없으면 내보내지 않는다. 이 발표에서 유일하게 규칙 형태로 제시된 문장이다.
- 위임과 항복을 말로 구분한다. 에이전트에게 “일을 해라”가 아니라 **“일을 하고, 내가 판단할 수 있을 만큼 증거를 보여달라”**고 요구한다. 증거 없이 결론만 받으면 그건 이미 항복이다.
- 에이전트 산출물을 받을 때 증거 목록을 고정한다. 디프, 테스트, 로그, 근거(why), 트레이스, 트라젝토리, 스크린샷 — 안쪽 고리가 바깥 고리로 넘길 때 무엇이 함께 넘어와야 하는지 미리 정해둔다.
- 바깥 고리 네 칸을 실제로 밟는다. DECIDE(할 가치가 있었나) → VERIFY(증거가 충분한가) → APPROVE(내보낼까/막을까/되돌릴까) → OWN(결과를 짊어진다). 리뷰를 “마지막에 한 번 훑기”에서 통제 시스템으로 올린다.
- 에이전트를 늘리기 전에 주의(attention)부터 설계한다. 어디서 들어가고, 뭘 확보하고, 뭘 재사용할지. 인지 대역폭은 병렬화되지 않는다 — 병렬 개수는 그 설계 다음 문제다.
- 롱 호라이즌 과제에는 중간 점검 지점을 심는다. 30초 실행은 상호작용이지만 한 시간·하루짜리는 워크스트림이다. 실을 놓치는 지점이 어디인지 미리 정한다.
- 에이전시 사다리로 내 위치를 잰다. FLAG에 머물러 있는지, RECOMMEND 이상에서 사는지. 목표는 “찾았는데 고칠 가치가 없다, 넘어간다”를 말할 수 있는 DISCERN이다.
- 커리어 투자 배분에 반감기를 적용한다. 속도·기억력·검증에 쓰는 시간은 릴리스 한 번짜리다. 책임과 서명이 붙는 자리 — 제약을 정의하고, 트레이드오프를 방어하고, 무너졌을 때 연락받는 자리 — 를 늘린다.
원문 인용 모음
- [00:07] “AI가 틀렸을 때도 73%가 그 답을 그대로 받아들였습니다. 그리고 AI 없이 혼자 판단했을 때보다 오히려 더 확신했어요.” — 해설
- [00:56] “그런데 만드는 게 싸졌다고 해서, 확인하는 것까지 싸지지는 않았어요.” — 해설
- [01:19] “문제는 여전히 용량입니다.” — 발표
- [01:31] “안전은 검증을 더 싸고, 더 명확하고, 사람들이 건너뛰기 더 어렵게 만드는 데서 나옵니다.” — 발표
- [01:53] “그래서 어려운 질문들을 마주하게 됩니다. 이 파일에 정말 모델이 손을 댔나?” — 발표
- [02:01] “어떤 제약이 그 작업을 이끌었나, 어떤 증거가 만들어졌나, 어떤 리스크가 수용됐나, 그리고 그 결과를 누가 소유했나.” — 발표
- [02:06] “이제 에이전트는 우리 중 누구도 리뷰할 수 없는 양을 내보냅니다. 그럼 우리는 아직 뭘 위해 있는 거죠?” — 발표
- [02:19] “호머 심슨이 컴퓨터를 자동화했던 경험에서 배울 게 있다면, 이게 우리 미래일지도 모르죠.” — 발표
- [02:34] “생성이 이해보다 빠르게 확장된다면, 희소해지는 자원은 증거로 뒷받침된 판단입니다.” — 발표
- [03:16] “아무나 열 개의 선택지를 만들어낼 수 있다면, 희소한 능력은 그중 뭐가 존재할 자격이 있는지 아는 겁니다.” — 발표
- [03:21] “취향은 영원한 해자가 아닙니다. 그것도 알파입니다.” — 발표
- [03:34] “다만 그 능력의 최고 버전은 신비주의가 아닙니다.” — 발표
- [04:08] “그래서 전략은 어느 한 역량에 매달리는 게 아닙니다. 우리 엣지를 계속 한 단계 위로 옮기는 겁니다.” — 발표
- [04:25] “더 나은 질문은, 오직 사람만이 답변 책임을 질 수 있는 게 뭐냐는 겁니다.” — 발표
- [04:34] “우리 중 누가 마법 같아서가 아니라, 어떤 결정은 실제로 소유를 요구하기 때문입니다.” — 발표
- [05:44] “빌드는 통과하고 PR은 머지할 수 있는데, 팀은 자기가 프로덕션에 내보내는 시스템을 설명할 능력을 잃어갈 수 있습니다.” — 발표
- [05:58] “에이전트는 이제 사람이 실을 놓칠 만큼 오래 시스템 안에 머무를 수 있습니다.” — 발표
- [06:18] “리뷰는 마지막에 한 번 훑어보는 것일 수 없습니다. 통제 시스템 전체가 되어야 합니다.” — 발표
- [06:33] “위임은 ‘일을 하고, 내가 판단할 수 있을 만큼 증거를 보여달라’입니다. 항복은 ‘네 답이 이제 내 답이다’라고 말하는 거고요 — 내가 어떤 의견도 만들기 전에.” — 발표
- [07:00] “실패 모드는 AI를 쓰는 게 아니라, 빌려 온 확신입니다.” — 발표
- [07:26] “더 많은 AI 에이전트가 돌아간다고 해서 당신이 더 많아지지는 않습니다. 당신의 인지 대역폭은 병렬화되지 않습니다.” — 발표
- [07:48] “어디서 들어가고, 뭘 확보하고, 뭘 재사용할지.” — 발표
- [07:57] “결과물은 남는데 내 판단력이 깎인다는 거죠.” — 해설
- [08:04] “책임은 에이전트가 충분히 좋아진 다음에 남는 찌꺼기가 아니라, 나머지 전부를 확장시키는 조건입니다.” — 해설
- [08:11] “엣지의 반감기는 모델 릴리스 한 번, 서명의 반감기는 커리어 전체입니다.” — 해설(슬라이드 인용)
- [08:24] “스킬은 레버리지를 벌고, 책임은 그 레버리지를 신뢰로 바꿉니다.” — 해설
- [08:42] “에이전트는 당신의 런북을 따를 수 있지만, 결과를 상속받을 수는 없습니다.” — 발표
- [08:46] “뭔가 실패했을 때 질문은 이겁니다. 누가 그 정책을 이해했나? 누가 리스크를 수용했고 블래스트 레이디어스를 소유하나?” — 발표
- [09:15] “허슬 연극이 아니라, 판단이 붙은 소유입니다.” — 발표
- [09:46] “에이전시는 모든 경로를 쫓는 게 아니라, 어떤 경로가 내 소유와 주의를 받을 자격이 있는지 정하는 겁니다.” — 발표
- [10:10] “안쪽 고리는 역량입니다. 바깥 고리는 에이전시고요.” — 발표
- [10:49] “경계는 사람이 AI 출력을 들여다보는 게 아닙니다. 경계는 증거와 책임입니다.” — 발표
- [11:25] “규칙 한 줄. 설명할 수 없으면 내보내지 않는다.” — 해설
- [11:39] “비용이 내려가니까, 그동안 만들 엄두를 못 냈던 것들이 쏟아져 나왔어요.” — 해설
- [11:45] “엔지니어링을 없애는 게 아니라 병목을 옮기는 거죠. ‘이걸 만들 수 있나’에서 ‘이게 존재해야 하나, 그리고 우리가 그걸 책임질 수 있나’로.” — 해설