출처: https://youtu.be/_mi3alkqy4s 길이: 24:40 · 채널: AI Engineer 발표자: Laurie Voss (Arize AI DevRel 총괄, npm 공동 창업자) · 행사: AI Engineer World’s Fair, 2026-07-01 (Leadership 2 트랙) 참고: 한영자막 번역본은 Tech Bridge 채널(
-TeOEuplMrQ)에 있다.
한눈에 보는 요약
- 자율 에이전트를 켠 개발자는 코드를 741% 더 썼지만 출시된 소프트웨어는 30% 늘었다. 생성은 더 이상 병목이 아니고, 사람의 리뷰가 병목이다.
- 더 열심히 읽는 것으로는 해결되지 않는다. Cisco 연구에서 리뷰어는 한 번에 약 400줄을 넘기면 결함을 못 잡는데, 에이전트 PR은 1만 줄이 흔하다.
- 사람을 아예 빼려는 시도(OpenAI 내부 제품, Bun의 Zig→Rust 이식, Carlini의 C 컴파일러)는 리뷰가 사라진 게 아니라 시스템으로 옮겨졌고, 그 시스템도 사람이 만들었음을 보여 준다.
- GitHub·Cursor·CodeRabbit 같은 자동 리뷰는 이미 대규모로 돌지만, 성공 지표가 모두 “사람이 수락했는가”라서 사람의 판단에 의존한다. 자동 리뷰어는 그럴듯한 설명에 88%나 속았다.
- 결론은 PR을 읽는 일을 멈추고, 리뷰어·규칙·평가(eval)를 만드는 상위 계층에 시간을 쓰라는 것이다. 마지막 리뷰어는 프로덕션 관측이다.
장면별 상세 설명
[01:47] 1. 두 개의 숫자: +741%와 +30%
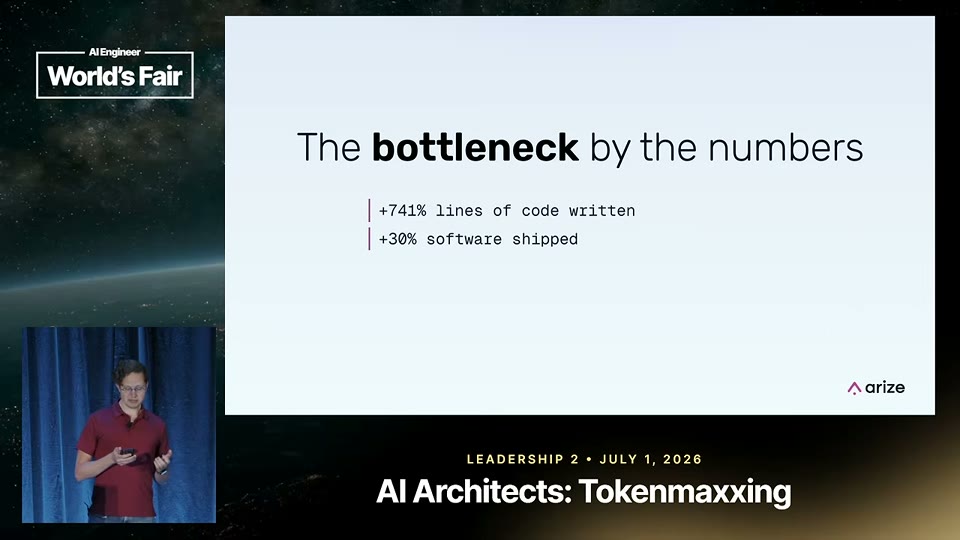
경제학자 세 명이 GitHub 개발자 10만 명 이상을 추적해, AI를 쓰기 시작한 시점과 맞춰 봤다. 자율 에이전트를 켠 개발자는 코드를 거의 8배 빨리 썼지만 실제 출시는 3분의 1 늘었을 뿐이다. 저자들은 원인이 리뷰라고 못 박는다. 프로덕션으로 가는 길이 여전히 사람을 거치고, 그중 코드 리뷰가 하류 전체를 막는다는 것이다.
발표자는 생성이 병목이 아니라는 증거로 Stripe가 5천만 줄 Ruby 코드베이스를 하루에 이전한 사례(Anthropic의 Fable 출시 자료 인용, 팀이 두 달 넘게 잡았던 일)와, 이제 Anthropic에 속한 Bun이 100만 줄 넘는 Zig를 6일 만에 Rust로 옮긴 사례를 든다. 청중도 에이전트가 만든 앱의 diff를 읽지 않고 머지 버튼을 누르며 찜찜해하고 있다는 지적이 따른다.
[04:00] 2. 더 열심히 리뷰하는 것은 답이 아니다
가장 좋은 근거는 20년 전 Cisco 연구다. 10개월간 리뷰 2,500건, 코드 320만 줄을 분석했더니 리뷰어는 한 번에 400줄을 넘겨 읽으면 결함을 효과적으로 찾지 못하고, 시간당 450줄을 넘기면 효과가 급락한다. 이 속도로 계산하면 에이전트 한 개가 만든 1만 줄 PR은 사람 리뷰에 사나흘이 걸린다. 개발자 한 명이 에이전트를 열두 개 돌릴 수 있는 시대에 이 방식은 지속되지 않는다. 리뷰를 전담하게 된 사람들은 지루함에 빨리 소진된다.
[05:20] 3. 사람을 빼 본 사람들: 루프를 설계하라
Peter Steinberger는 에이전트를 프롬프트하지 말고 에이전트를 프롬프트하는 루프를 설계하라고 하고, Andrej Karpathy도 사람을 루프에서 빼야 한다는 같은 논지를 편다. OpenAI는 올해 2월, 빈 저장소에서 직접 쓴 코드 없이 내부 제품을 만든 경험을 공개했다. 5개월 뒤 약 100만 줄, 병합된 PR 약 1,500개를 엔지니어 3명이 만들었고, 리뷰 노력은 거의 전부 에이전트끼리 처리했다고 한다.
발표자는 OpenAI가 그 제품이 무엇인지도, 재현할 오픈소스도 내놓지 않았다는 점을 들어 전략에 구멍이 남아 있을 것이라고 본다. 이 베팅의 핵심은 “루프 설계가 검사를 대신한다”인데, 루프가 얼마나 볼 수 있느냐가 관건이다.
[07:00] 4. 테스트 통과는 머지 가능과 다르다
업계는 오랫동안 테스트 통과를 품질의 대리 지표로 써 왔다. METR은 올해 3월 이를 직접 시험했다. SWE-bench 채점기를 통과한 PR을 해당 오픈소스 프로젝트의 활동 중인 메인테이너 4명에게 보여 주고 머지할지 물었더니, 약 절반만 머지 가능했다. 실패 원인은 정확성이 아니라 코드 품질과, 테스트 밖의 다른 코드를 조용히 깨뜨리는 변경이었다. METR은 에이전트가 피드백 후 재시도할 기회가 없었다는 단서를 달았지만, 발표자는 그것이 곧 사람을 루프에 넣는 것이라 우리 질문과 무관하다고 본다.
[08:20] 5. “머지하시겠습니까?”를 재는 벤치마크
Cognition(Devin 개발사)은 6월에 FrontierCode를 내놓았다. 메인테이너 20명 이상이 자기 저장소에서 150개 과제를 만들었고, 과제마다 전문가 작업 40시간이 넘는다. 채점 항목은 동작 정확성, 회귀, 안전성, 범위 규율, 테스트 품질, 유지보수성으로, 사람의 리뷰 기준을 기계가 확인할 수 있게 만든 셈이다. 결과적으로 Fable 5는 SWE-bench Pro에서 88%인데 FrontierCode의 가장 어려운 구간에서는 29%였고, GPT 5.5는 6% 미만이었다. 가장 강한 모델도 사람 리뷰를 안정적으로 통과하지 못한다.
[09:50] 6. 값싸게 검증되는 것은 곧 정복된다
투자자 Sarah Guo는 머지 가능성 벤치마크를 푸는 것이 코딩 모델의 전환점이 될 것이라고 썼다. 모델이 코드 생성에서 빨리 좋아진 이유는 컴파일러와 테스트 스위트가 공짜 검증기이기 때문이고, 값싸게 검증되는 것은 이길 때까지 학습할 수 있다. 따라서 유지보수성·범위 규율·회귀 안전성에 대한 신뢰할 만한 테스트가 나오는 순간 프론티어 모델이 그걸로 학습한다. 오늘 리뷰 기준을 쓰는 사람이 내년 기본 모델 행동을 쓰는 셈이다. 선례로 OpenAI의 CriticGPT(2024)는 모델이 쓴 코드의 버그를 찾는 모델이었고, 사람과 함께 쓸 때 사람이나 모델 단독보다 나았으며 학습 신호로 모델에 내장됐다.
[11:15] 7. 자동 리뷰는 이미 대규모로 돈다
GitHub Copilot 리뷰어는 6천만 건의 리뷰를 했고 GitHub 전체 코드 리뷰의 5건 중 1건 이상을 차지한다. 기계 리뷰가 세계 최대 코드 호스트의 주류 기본값이라는 말이다.
Cursor는 리뷰어 구조를 공개했다. 첫 버전은 diff마다 리뷰 패스를 8번 돌리면서 순서를 섞었다. 순서에 따라 결과가 달라졌고, 목적은 오탐 걸러내기였기 때문이다. 좋은 코드를 나쁘다고 하는 리뷰어는 무시당한다. 베이징대 연구진도 독립적으로 같은 아이디어(여러 패스를 돌려 합의된 것만 남기기)로 리뷰 품질을 최대 44% 올렸다.
[13:00] 8. 기본값은 의심: 모델에게 코드를 덜 믿으라고 말해야 했다
Cursor가 리뷰어를 다시 만들 때 가장 인상적이었던 점은 모델에게 더 의심하라고 지시해야 했다는 것이다. 모델은 코드를 보고 “괜찮아 보이니 출시하자”고 하는 경향이 있었는데, 사람도 그렇다. 그래서 코드를 기본적으로 믿지 말고 문제가 있다고 가정하라고 했다. 발표자는 좋은 리뷰란 기본적으로 의심하는 것이라는 데 한 편의 발표가 들어 있다고 말한다.
리뷰는 수리와도 합쳐지고 있다. Cursor의 리뷰어는 자기 지적에서 수정 에이전트를 띄워 패치를 만들고 사람에게 diff 승인만 맡기며, 다음 단계는 버그 보고가 진짜임을 코드를 실행해 증명하는 것이다. 리뷰와 재작성의 경계가 얇아지고, 그 승인이 또 하나의 사람 개입이라는 모순도 생긴다.
[13:55] 9. 모두의 지표: “사람이 수락했는가?”
CodeRabbit은 가장 큰 전용 리뷰어로 PR 1,300만 건 이상을 검토했다. Greptile은 저장소 전체 그래프를 만들어 변경이 먼 코드에 미치는 영향을 보게 하고, Graphite는 자기 제안의 수락·거부 기록으로 평가 세트를 만든다. 이들의 공통점은 성공의 정의가 모두 “사람이 내 답을 수락하는가”라는 점이다. Cursor의 해결률(resolution rate)은 52%에서 70% 이상으로 올랐다. 리뷰어들은 매일 대규모로 사람의 수락 판단을 학습한다. 지금 상태는 코드도 리뷰도 자동이지만 리뷰를 사람이 다시 리뷰하는 구조다.
[15:06] 10. 사람 없이 가능한가? Carlini의 컴파일러와 Bun의 이식
Anthropic의 Nicholas Carlini는 올해 2월 에이전트 16개로 Rust C 컴파일러를 밑바닥부터 만들어 약 2,000개 세션에 걸쳐 Linux 커널을 컴파일하게 했다. 코드를 승인하는 사람은 없었지만, 코드가 맞는지 확인하는 테스트 하네스와 피드백 시스템은 전부 사람이 썼다. 사람이 루프 안(in the loop)에는 없어도 루프 위(on the loop)에는 있었다는 것이다. Carlini 본인도 테스트 통과를 보고 일이 끝났다고 착각하기 쉽다고 경고했다.
Bun은 런타임 전체(약 100만 줄)를 6일 만에 Rust로 옮겼고, 게이트는 기존 테스트 스위트였다. **99.8%**가 통과했으니 테스트가 실제로 일을 한 셈이다. 재미있는 일화로 Zig 코드를 한꺼번에 지우는 PR을 다른 로봇이 AI 슬롭이라고 표시했다. 다만 이식된 코드를 자세히 본 사람이 있었고, unsafe 블록이 13,044개였다(비슷한 규모의 사람이 쓴 코드는 약 73개).
unsafe 블록은 작성자가 메모리 처리의 올바름을 증명하지 않고 주장하는 곳이다. 테스트 스위트는 공개 인터페이스의 동작만 보증하므로, 테스트가 애초에 찾도록 설계되지 않은 1만 3천 개의 주장은 아무도 확인하지 않았다.
[17:27] 11. 리뷰는 사라지지 않고 옮겨졌다
OpenAI도 리뷰를 없애지 않고 옮겼다. Codex가 자기 변경을 리뷰하고, 만족할 때까지 다른 에이전트를 불러 그 리뷰를 다시 리뷰한다. 변경마다 앱을 부팅해 UI를 보고 로그 스택까지 에이전트에 노출했다. 한동안은 매주 금요일마다 사람이 AI 슬롭을 손으로 청소해야 했고, 그것이 확장되지 않자 슬롭을 찾는 에이전트를 학습시켰다. 교훈은 리뷰는 시스템으로 재구성됐고, 그 시스템은 사람이 만든다는 것이다. 문제가 생겼을 때 해법은 거의 “더 열심히”가 아니었다는 Cisco 연구와 같은 이야기다.
[18:41] 12. 반대 사례: Dexter Horthy의 번복
Dexter Horthy는 6개월간 코드를 리뷰하지 말라고 말하고 다녔고 지난해 AIE에서도 그렇게 했다. 올해 3월 무대에서 그는 말을 거두었다. 코드를 안 읽는 방식을 6개월 해 봤더니 결과가 좋지 않았고 시스템의 큰 부분을 뜯어내 다시 만들어야 했다는 것이다. 벤치마크가 아니라 실제 시스템에서 실험하고 공개적으로 철회한 사례다. Sarah Guo는 이유를 이렇게 설명한다. 테스트 통과는 그 변경이 옳은 변경인지를 알려 주지 않는다. 이 모듈에 외부 사용자 셋이 있다는 것도, 아무도 자기가 썼다고 인정하지 않는 크론 잡이 이 모듈에 기대고 있다는 것도 알려 주지 않는다. 테스트가 찾지 못하는 맥락이 테스트 밖에 있다.
[19:55] 13. 사람의 체크포인트는 어디에 남는가
지금까지 본 모든 사례에서 사람의 체크포인트는 예측 가능한 곳에 살아남는다. 정확성을 값싸게 확인할 수 없는 곳, 폭발 반경이 큰 곳, 보안에 민감한 환경, 결과에 누군가 이름을 걸어야 하는 곳이다. 사람의 역할은 사라지는 게 아니라 코드를 직접 검사하던 자리에서 검사 시스템을 설계하고 조율하며 “좋음”을 정의하는 자리로 올라간다. 그러면 그 시스템은 누가 리뷰하는가 하는 질문이 남고, 답은 사람이다.
[20:47] 14. 리뷰어를 리뷰하는 일, 그리고 속는 리뷰어
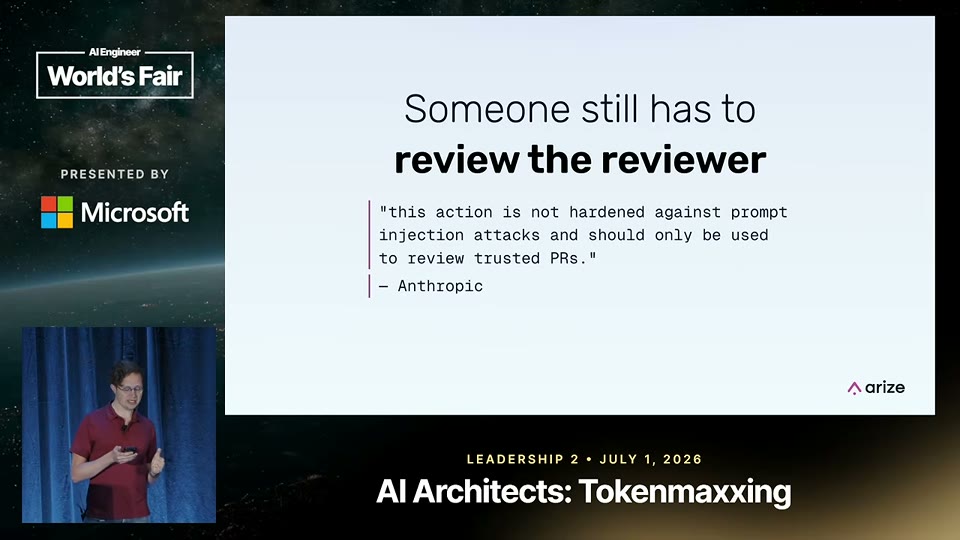
Anthropic이 내놓은 자동 보안 리뷰어 README에는 “이 액션은 프롬프트 인젝션에 강화되어 있지 않으니 신뢰할 수 있는 PR 리뷰에만 쓰라”는 큰 단서가 붙어 있다. 리뷰 대상이 리뷰어를 설득해 지적을 철회시킬 수 있다는 뜻이다. 올해 3월 연구는 이를 재확인했다. 순한 커밋 메시지로 포장한 취약한 코드가 자율 리뷰 에이전트를 88% 속였고, 같은 시도가 사람 리뷰어에게는 35%만 통과했다. 사람을 빼면 리뷰어 하나를 잃는 데 그치지 않고, 속이기 어려운 존재를 잃는다.
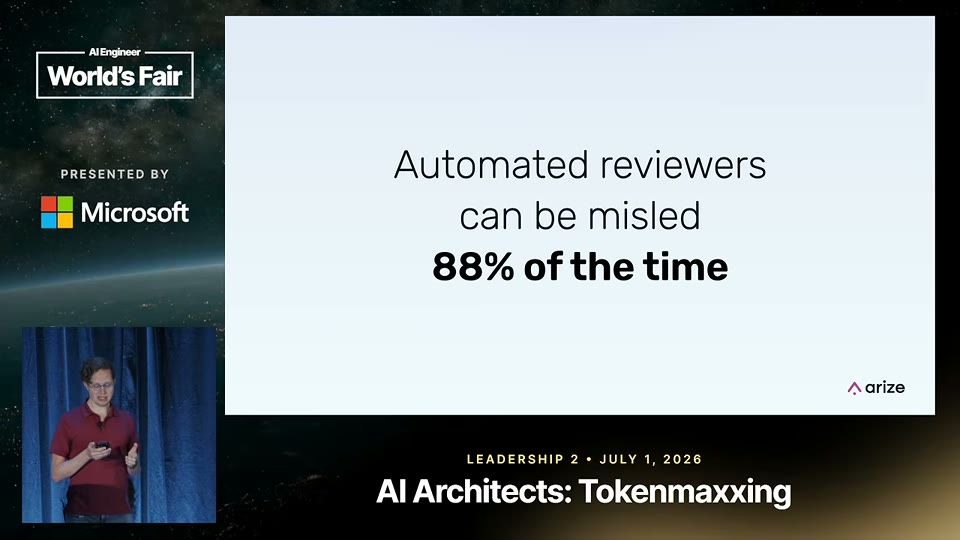
자신 있게 포장된 나쁜 코드는 에이전트가 가장 잘 만드는 종류의 코드다. 게다가 이 분야는 리뷰어를 채점하는 방법에도 합의가 없다. 벤치마크 스캐폴드가 정답을 유출하다 걸린 적이 있고, 연구자들도 리뷰 품질을 어떻게 잴지 의견이 갈린다.
[22:00] 15. 마지막 리뷰어는 프로덕션
자동화할 수도 건너뛸 수도 없는 리뷰어가 하나 남는다. 프로덕션이다. 머지 전 리뷰가 전부 기계가 되면, 코드가 실제로 무엇을 하는지 지켜보는 것이 마지막 리뷰어가 된다. 출시 이후에는 테스트 결과가 아니라 시스템이 실제 세계에서 단계마다 무엇을 했는지(트래젝터리)가 흥미로운 정보다. 발표자는 Arize 홍보는 하지 않겠다고 하면서도, 자동 리뷰된 코드를 배포한다면 프로덕션에서 그 동작을 관찰하는 시스템이 필수라고 말한다.
[22:41] 16. 결론과 오늘 할 일
발표자가 도달한 결론은 코드 리뷰가 완전히 죽은 것은 아니지만 엄청나게 바뀌고 있다는 것이다. 공학적으로 설계된 시스템으로 다시 만들어지고 있고, 사람은 코드를 한 줄씩 읽는 엔진에서 그 시스템의 조종사로 옮겨 간다. 벤치마크·분류기·루브릭·테스트 스위트·eval까지 이 시스템의 모든 층은 누군가 자기 일로 삼기 전까지 리뷰되지 않은 채로 남는다. 다음 몇 년을 이기는 팀은 코드를 가장 많이 만드는 팀이 아니라, 자기가 출시한 것을 왜 믿는지 증거로 말할 수 있는 팀이다.
처음에 약속한 실용적 조언은 PR을 리뷰하는 일을 멈추라는 것이다. 2026년에는 PR이 맞는 추상화 수준이 아니다. 사람의 판단은 매우 가치 있고 지금보다 훨씬 멀리 확장할 수 있으니, 시간을 믿을 만한 리뷰 하네스를 만드는 데 쓰라고 한다. “좋음”의 정의, 회사 맥락, 도메인 지식을 코드화해 두고 에이전트를 돌리면 3분의 1 빠른 수준을 훌쩍 넘어설 수 있다는 것이 마지막 말이다.
실전 체크리스트
- 에이전트 PR의 크기와 리뷰 소요 시간을 재 본다. 400줄 한계를 넘는 PR이 얼마나 되는지부터 확인한다.
- 자동 리뷰어는 오탐 관리를 1순위 과제로 둔다. 여러 패스를 돌려 합의된 지적만 남기는 방식을 검토한다.
- 리뷰어 프롬프트에 “코드를 기본적으로 믿지 말고 문제가 있다고 가정하라”는 기본 의심 지시를 넣는다.
- 테스트 통과만 머지 게이트로 쓰지 않는다. 테스트가 못 보는 영역(
unsafe같은 주장, 외부 의존, 크론 잡)을 규칙과 eval로 별도로 코드화한다. - 리뷰어를 속일 수 있는지(프롬프트 인젝션, 그럴듯한 커밋 메시지) 정기적으로 시험하고, 그 시스템 자체를 누가 리뷰하는지 정한다.
- 폭발 반경이 크거나 보안에 민감한 변경은 사람 체크포인트를 남긴다.
- 머지 후에는 프로덕션 관측(트레이스·로그)을 마지막 리뷰어로 둔다.
한계와 주의
- 숫자와 사례(741%/30%, METR, FrontierCode, Cisco, Bun 등)는 모두 발표자의 인용이며, 원 연구를 대조하지 않았다. 그래서
confidence: medium이다. - CriticGPT의 연도는 2024로 적었다. 전사 한 버전에서는 “2020”으로, 다른 버전에서는 “2024”로 들렸다. Bun 비교 수치는 슬라이드 기준 73개다(발표에서는 “about 74”라고 말함).
원문 인용 모음
- [01:47] “wrote 741% more code, but only 30% more software shipped.”
- [02:20] “Producing code is suddenly a whole lot cheaper. Knowing whether to trust it is still very expensive.”
- [09:42] “a compiler is a free verifier. A test suite is a free verifier.”
- [13:00] “Don’t trust the code by default. Assume there is something wrong with it.”
- [15:29] “there was absolutely a human on the loop.”
- [18:34] “Review didn’t disappear… It got rebuilt as a system and that system is built by humans.”
- [23:19] “They’ll be the ones who can say, with evidence, why they trust what they shipped.”
- [23:31] “stop reviewing PRs. It is the wrong level of abstraction for 2026.”
관련 노트
- 2026-09-27-ai-code-review-agent-risk-score — PR 전후 AI 리뷰와 리스크 점수로 auto-merge까지 잇는 실무 워크플로
- cursor — 다중 패스·기본 의심 리뷰어를 공개한 Cursor
- anthropic — Bun 인수, 자동 보안 리뷰어의 프롬프트 인젝션 단서
- 2026-08-29-code-outruns-review — 생성이 검증을 추월한 시대에 리뷰를 단계별 시스템으로 재분배하자는 정리
- 2026-08-22-code-review-intent-verification — diff 대신 의도·인수 조건·검증 증거를 리뷰하는 방법
- 2026-10-03-lauren-tan-agent-verification-environment — 사람 병목을 줄이는 검증 환경 설계
- 2026-07-21-aisparkup-post-14598-claude-code-bun-rust — 발표에 인용된 Bun의 Zig→Rust 재작성
- claude-fable-5 · openclaw · harness