출처: https://www.youtube.com/watch?v=Be5b6D1IoLI 길이: 00:38:23 · 채널: 실밸개발자 포맷: 패스트캠퍼스 강의 「파트 1 · Ch05 · AI-Powered Code Review」 무료 공개분. 전반부(~16분)는 슬라이드 강의, 후반부는 Claude Code로 pre-push 훅과 GitHub Actions 리뷰를 직접 만드는 실습이다. 자막은 한국어 자동자막을 화면 burn-in 자막과 대조해 정돈했다.
한눈에 보는 요약
- AI가 코드를 빨리 쓰기 시작하면 다음 병목은 리뷰다. 목표는 사람을 빼는 게 아니라, 기계가 1차를 잡고 사람을 아키텍처·보안 모델·비즈니스 트레이드오프 같은 고차원 판단에 재배치하는 것.
- 리뷰 에이전트는 두 시점에서 돈다 — Pre-PR(로컬 셀프 리뷰, 예방)과 Post-PR(GitHub Actions 자동 코멘트, 정밀). 두 단계는 대체가 아니라 누적이라, 앞에서 잡은 건 뒤에서 다시 볼 필요가 없다.
- PR마다 0~100 리스크 점수(보안 30 · 스코프 20 · Breaking change 20 · 테스트 15 · 마이그레이션 15)를 매기고, 점수 구간이 액션(자동 머지 후보 ~ 머지 차단)을 결정한다.
- 경계는 명확하다 — 고차원 판단·도메인 컨텍스트·미래 비용은 사람, 규칙·패턴·일관성·누락 탐지는 AI.
- 가장 중요한 것은 안전 가드 6가지(팀 동의, 저위험 PR부터, 보수적 임계치, 라벨·작성자 화이트리스트, 야간·주말 금지, 첫 1~2주 dry-run). 이걸 거치지 않고 회사 prod repo에 auto-merge를 켜지 말 것.
- 실습에선 pre-commit이 아니라 pre-push 훅으로
/code-review를 돌려 버그가 있으면 push를 막고, GPT API 기반 Actions 워크플로가 PR에 리스크 점수 코멘트와risk:*라벨을 단다.
핵심 한 줄: AI가 생성하는 PR 수를 사람이 다 볼 수는 없다. 리스크 점수 기반 리뷰로 “머지까지 맡길 수 있는” 신뢰를 보수적으로 쌓아 가는 것이 리뷰 병목을 푸는 길이다.
장면별 상세 설명
[00:53] 1. 이번 섹션에서 만들 것 — 코드 리뷰 에이전트
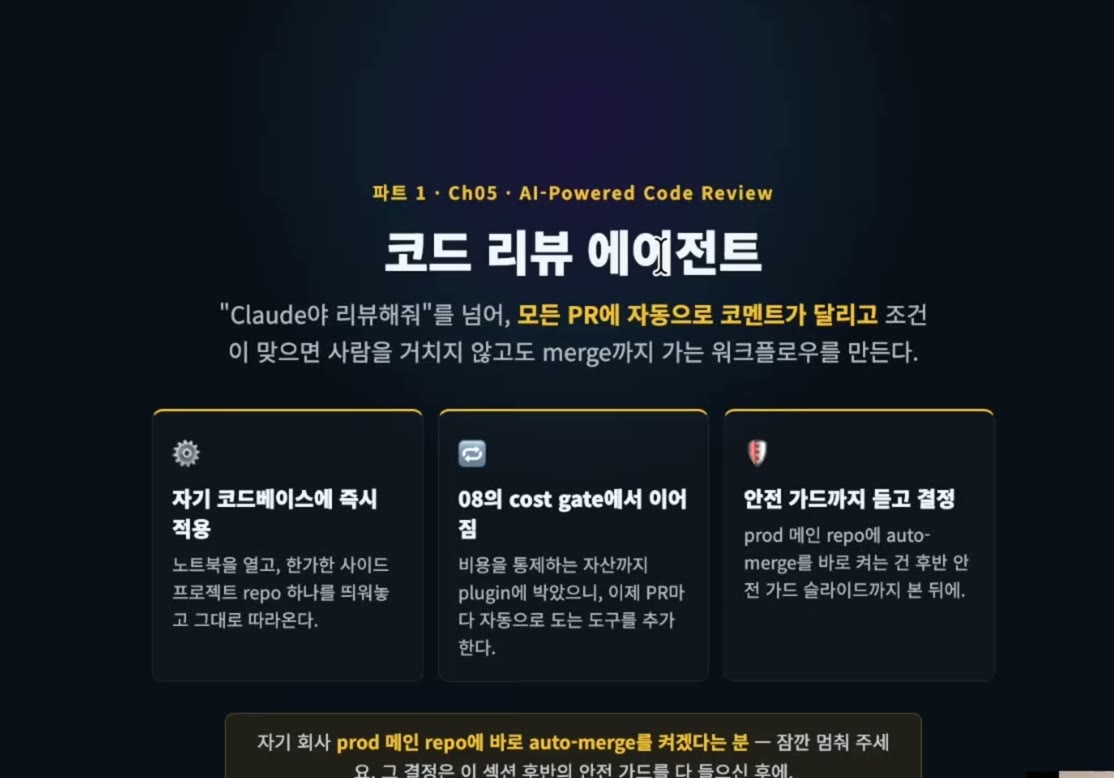
“Claude야 리뷰해줘”라고 매번 부르는 수준을 넘어, 저장소의 모든 PR에 자동으로 코멘트가 달리고, 조건이 맞으면 사람을 거치지 않고도 merge까지 가는 워크플로를 만드는 섹션이다. 직전 섹션(08)에서 비용을 통제하는 cost gate를 plugin에 넣었고, 이번엔 PR마다 자동으로 도는 리뷰를 더한다.
슬라이드의 세 카드가 이 섹션을 대하는 태도를 정리한다. 한가한 사이드 프로젝트 repo 하나를 띄워 그대로 따라 하고, prod 메인 repo에 auto-merge를 켜는 건 뒤의 안전 가드 슬라이드까지 본 다음에 결정하라는 것.
[01:45] 2. 2024 vs 2026 — 같은 시니어 엔지니어의 월요일 오전
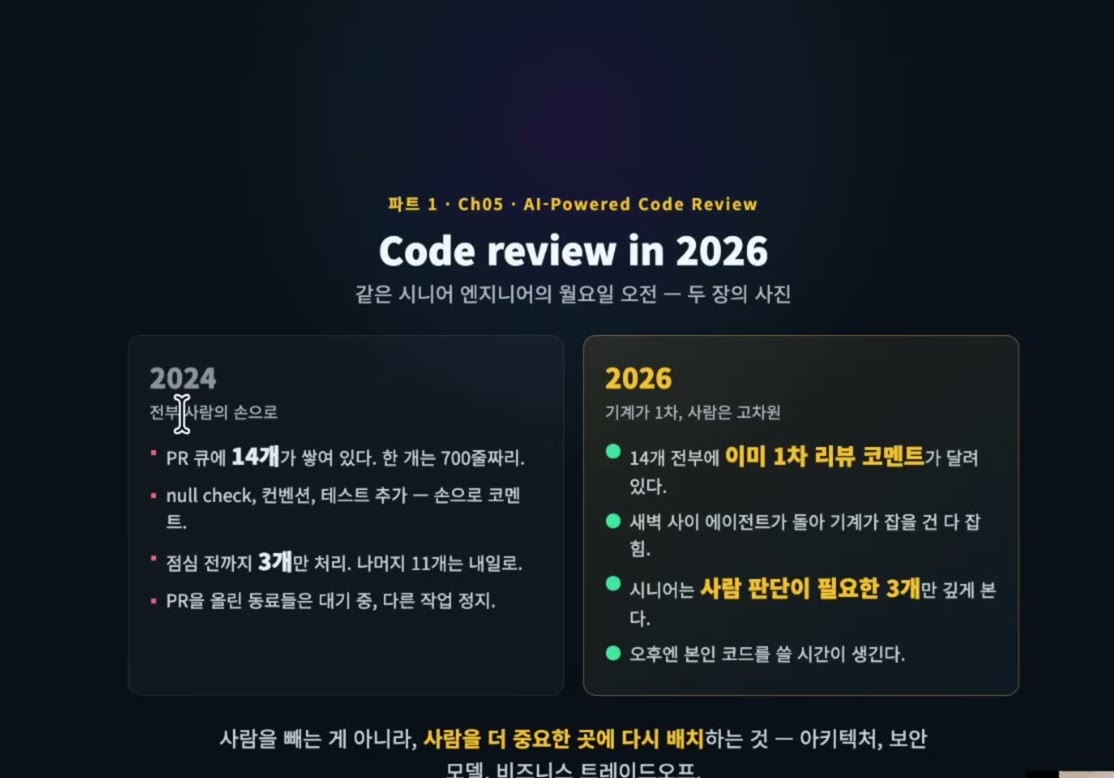
| 2024 — 전부 사람 손으로 | 2026 — 기계가 1차, 사람은 고차원 |
|---|---|
| PR 큐에 14개, 그중 하나는 700줄짜리 | 14개 전부에 이미 1차 리뷰 코멘트가 달려 있음 |
| null check·컨벤션·테스트 추가를 손으로 코멘트 | 새벽 사이 에이전트가 돌아 기계가 잡을 건 다 잡음 |
| 점심 전까지 3개 처리, 나머지 11개는 내일로 | 시니어는 사람 판단이 필요한 3개만 깊게 봄 |
| PR 올린 동료들은 대기, 다른 작업 정지 | 오후엔 본인 코드를 쓸 시간이 생김 |
이 차이가 이번 섹션이 만드는 자산의 효과다. 사람을 빼는 게 아니라 사람을 더 중요한 곳에 다시 배치하는 것이다.
[02:48] 3. AI 리뷰어의 네 가지 강점
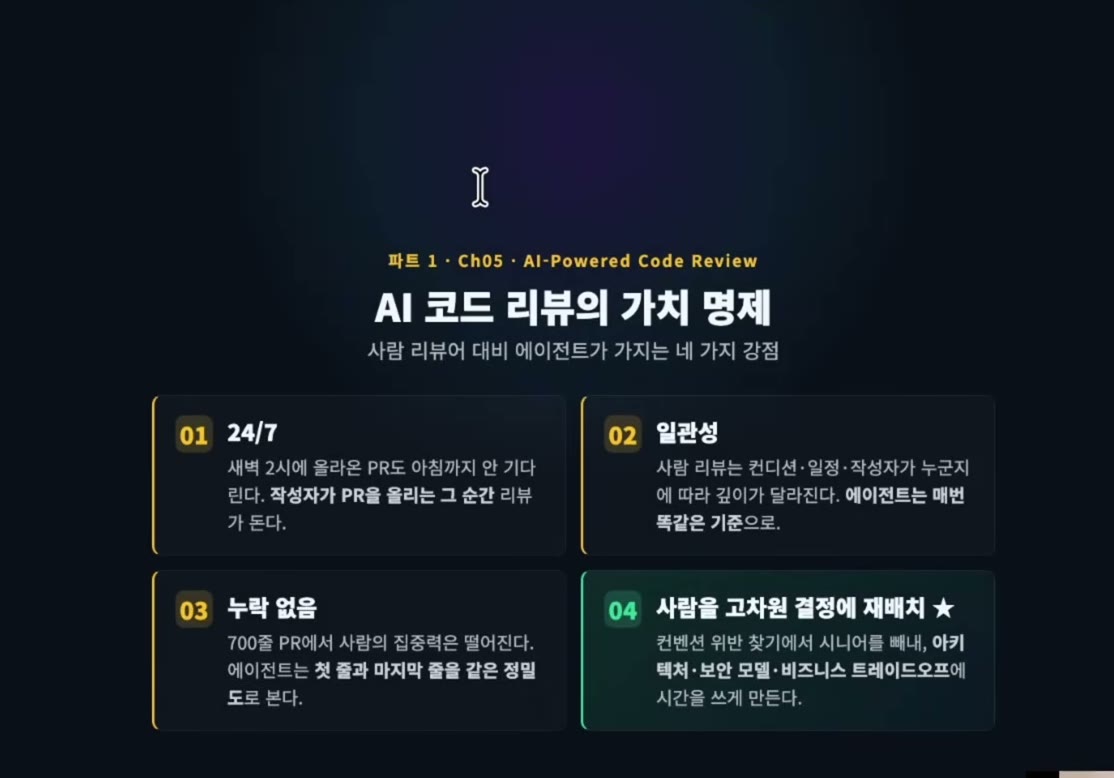
- 24/7 — 새벽 2시에 올라온 PR도 아침까지 기다리지 않는다. 작성자가 올리는 순간 리뷰가 돈다.
- 일관성 — 사람 리뷰는 컨디션·일정·작성자가 누군지에 따라 깊이가 달라지지만, 에이전트는 매번 같은 기준으로 본다.
- 누락 없음 — 700줄 PR의 마지막 부분은 사람이 대충 보게 된다. 에이전트는 첫 줄과 마지막 줄을 같은 정밀도로 본다.
- 사람을 고차원 결정에 재배치 ★ — 가장 중요한 강점. 컨벤션 위반 찾기에서 시니어를 빼내 아키텍처·보안 모델·비즈니스 트레이드오프에 시간을 쓰게 한다.
[04:10] 4. 두 갈래 리뷰 시점 — Pre-PR vs Post-PR
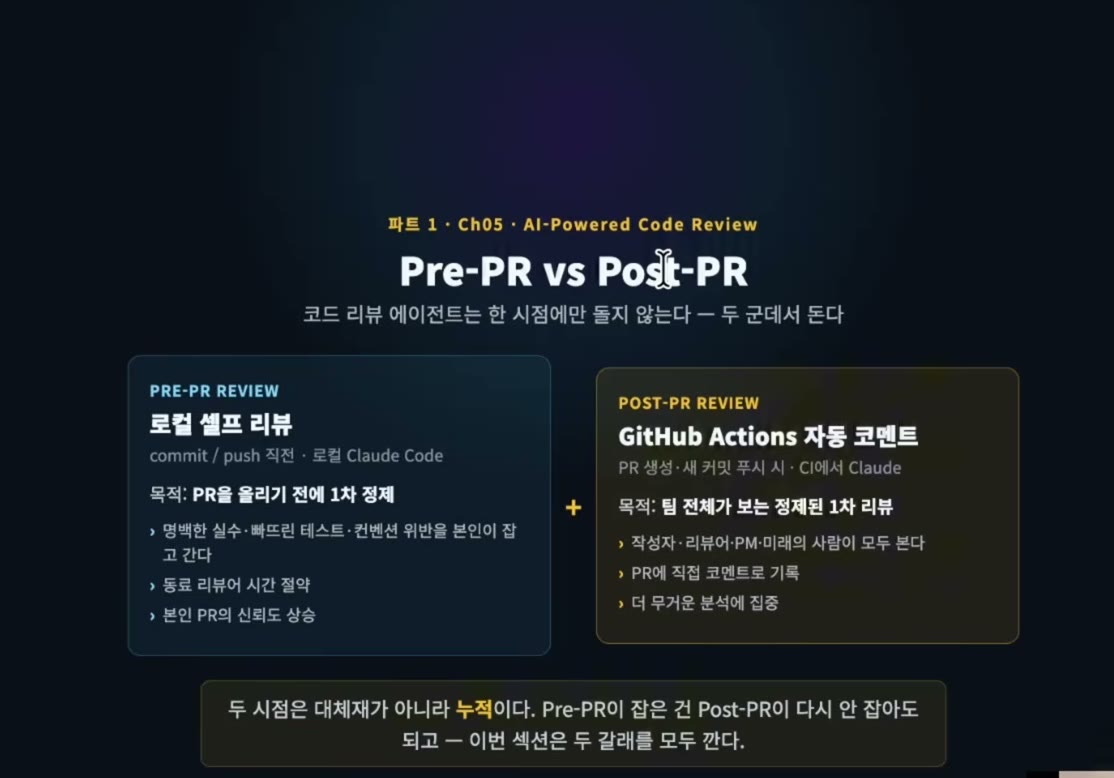
| Pre-PR 리뷰 (로컬 셀프 리뷰) | Post-PR 리뷰 (GitHub Actions 자동 코멘트) | |
|---|---|---|
| 시점 | commit/push 직전, 로컬 Claude Code | PR 생성·새 커밋 푸시 시, CI에서 실행 |
| 목적 | PR을 올리기 전에 1차 정제 | 팀 전체가 보는 정제된 1차 리뷰 |
| 잡는 것 | 명백한 실수·빠뜨린 테스트·컨벤션 위반 | 더 무거운 분석. 작성자·리뷰어·PM·미래의 사람이 모두 보는 기록 |
| 효과 | 동료 리뷰어 시간 절약, 본인 PR 신뢰도 상승 | PR에 직접 코멘트로 남음 |
화자는 셀프 리뷰를 사실상 의무로 본다. AI 시대에 셀프 리뷰 없이 PR을 올리는 건 리뷰어를 더 힘들게 하는 일이고, Claude Code든 Codex든 코드 리뷰 스킬은 이미 있으니 훅으로 강제하면 된다. Post-PR 쪽은 직접 만들 수도 있고, PR 리뷰 SaaS를 쓸 수도 있다(화자는 1인 개발자용 무료 플랜을 써 봤는데 편했다고 한다). 두 시점은 누적이라 Pre-PR에서 잡은 것은 Post-PR이 다시 잡지 않아도 되고, 그 덕에 Post-PR은 무거운 분석에 집중한다.
[06:34] 5. 리뷰 기법과 라벨 기반 라우팅
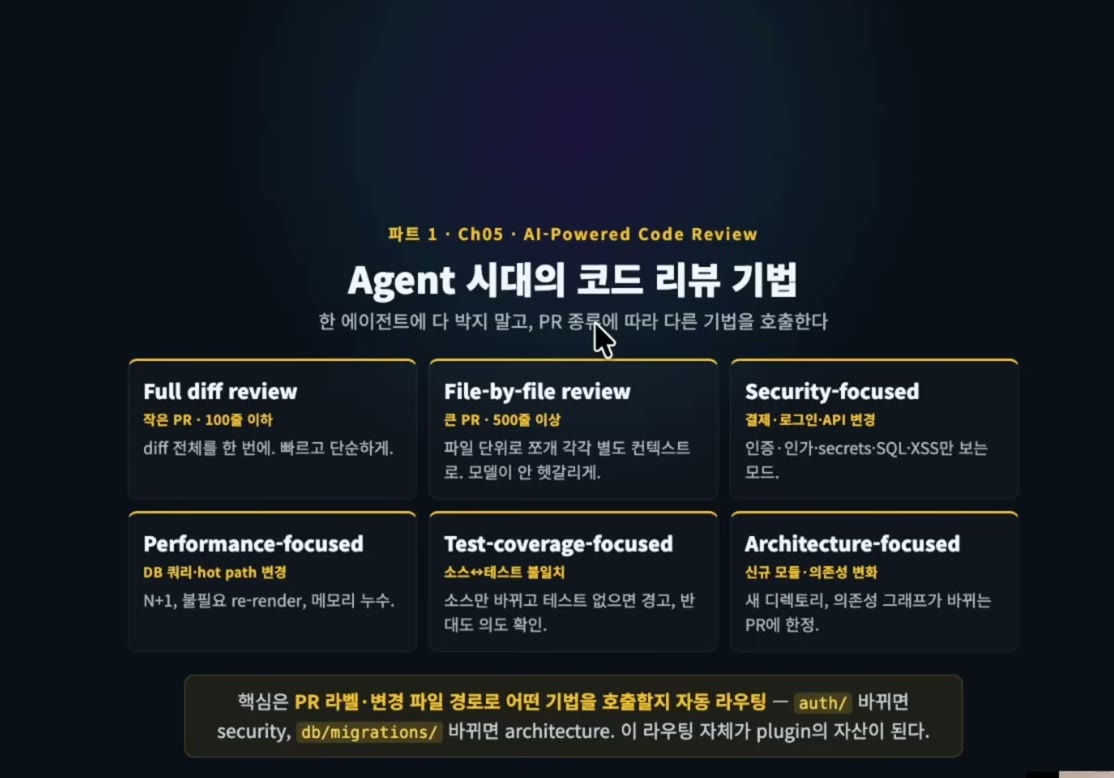
한 에이전트에 모든 걸 몰아넣지 말고 PR 종류에 따라 다른 기법을 호출한다.
| 기법 | 적용 대상 | 보는 것 |
|---|---|---|
| Full diff review | 작은 PR(100줄 이하) | diff 전체를 한 번에, 빠르고 단순하게 |
| File-by-file review | 큰 PR(500줄 이상) | 파일 단위로 쪼개 각각 별도 컨텍스트로(서브에이전트) — 모델이 헷갈리지 않게 |
| Security-focused | 결제·로그인·API 변경 | 인증·인가·secrets·SQL·XSS만 |
| Performance-focused | DB 쿼리·hot path 변경 | N+1, 불필요한 re-render, 메모리 누수 |
| Test-coverage-focused | 소스↔테스트 불일치 | 소스만 바뀌고 테스트가 없으면 경고, 반대면 의도 확인 |
| Architecture-focused | 신규 모듈·의존성 변화 | 새 디렉터리, 의존성 그래프가 바뀌는 PR에 한정 |
핵심은 PR 라벨·변경 파일 경로로 어떤 기법을 호출할지 자동 라우팅하는 것이다. 예컨대 auth/가 바뀌면 security 리뷰가, db/migrations/가 바뀌면 architecture 리뷰가 반드시 돈다. 라벨링도 에이전트가 한다. 화자는 회사에서도 이런 세분화된 리뷰 기법을 많이 쓴다고 말한다.
[08:32] 6. 리스크 점수 루브릭 — 5축 100점
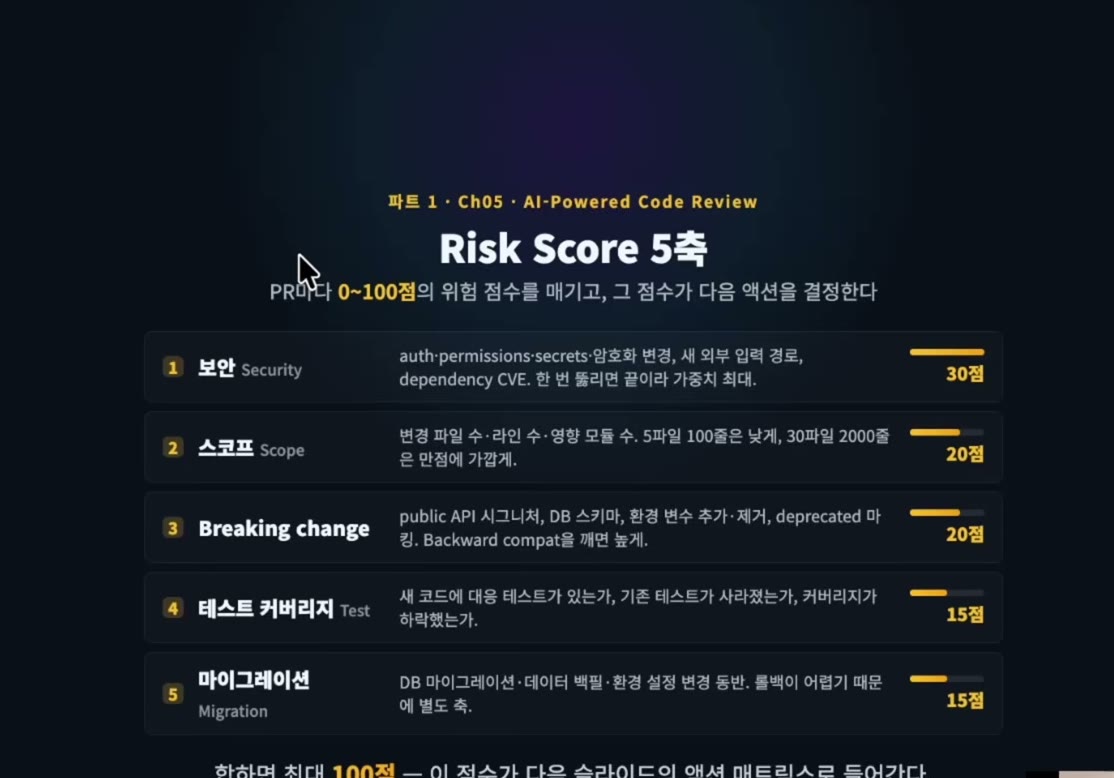
| 축 | 배점 | 기준 |
|---|---|---|
| 보안 (Security) | 30 | auth·permissions·secrets·암호화 변경, 새 외부 입력 경로, dependency CVE. 한 번 뚫리면 끝이라 가중치 최대 |
| 스코프 (Scope) | 20 | 변경 파일 수·라인 수·영향 모듈 수. 5파일 100줄은 낮게, 30파일 2000줄은 만점에 가깝게 |
| Breaking change | 20 | public API 시그니처, DB 스키마, 환경 변수 추가·제거, deprecated 마킹. backward compat을 깨면 높게 |
| 테스트 커버리지 (Test) | 15 | 새 코드에 대응 테스트가 있는가, 기존 테스트가 사라졌는가, 커버리지가 떨어졌는가 |
| 마이그레이션 (Migration) | 15 | DB 마이그레이션·데이터 백필·환경 설정 변경. 롤백이 어려워 별도 축 |
점수가 높을수록 위험하다. 스코프 축이 큰 PR에 높은 점수를 주는 건 작은 PR을 선호하게 만들려는 의도다. 90점짜리 diff는 반드시 사람이 보고 판단해야 하고, 10점 수준이면 사람이 검토할 필요가 거의 없다는 게 화자의 입장이다. 단, 이 배점은 화자가 웹 검색과 경험으로 만든 출발점일 뿐 절대 기준이 아니니 팀에 맞게 고쳐 쓰라고 강조한다.
[10:30] 7. 리스크별 액션 매트릭스와 자동 머지 기준
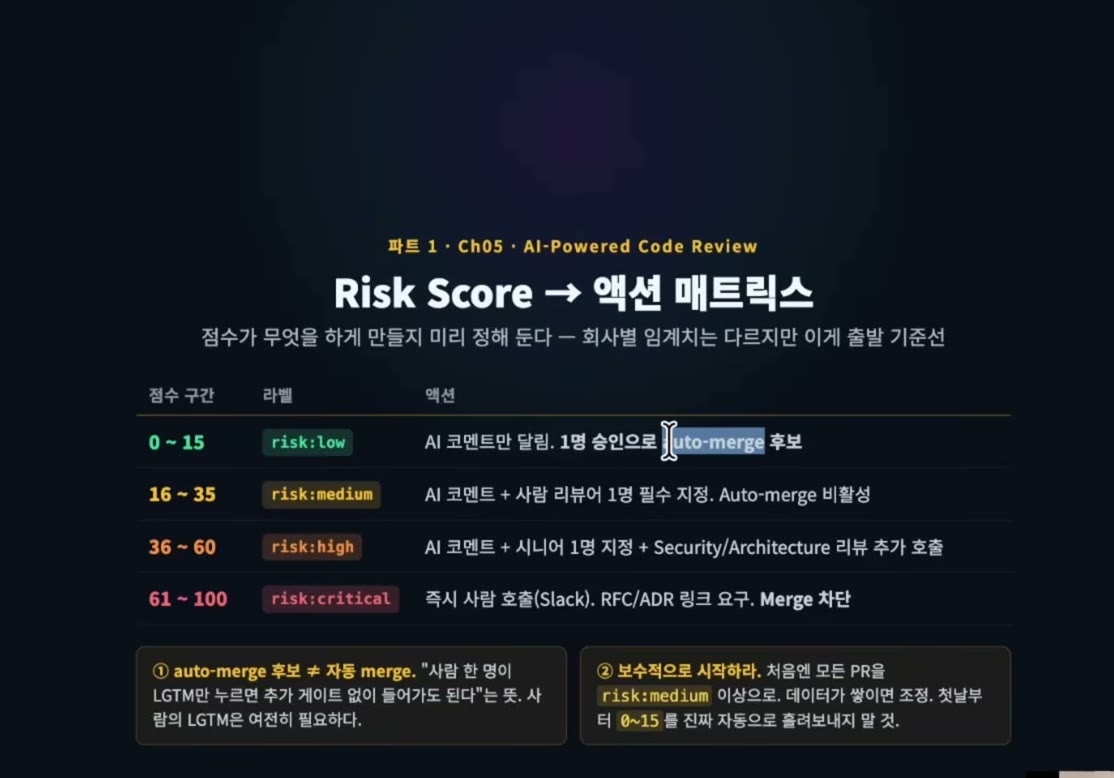
| 점수 구간 | 라벨 | 액션 |
|---|---|---|
| 0~15 | risk:low | AI 코멘트만. 1명 승인으로 auto-merge 후보 |
| 16~35 | risk:medium | AI 코멘트 + 사람 리뷰어 1명 필수. auto-merge 비활성 |
| 36~60 | risk:high | AI 코멘트 + 시니어 1명 지정 + Security/Architecture 리뷰 추가 호출 |
| 61~100 | risk:critical | 즉시 사람 호출(Slack), RFC/ADR 링크 요구, merge 차단 |
두 가지 단서가 붙는다. 첫째, auto-merge 후보 ≠ 자동 merge — “사람 한 명이 LGTM만 누르면 추가 게이트 없이 들어가도 된다”는 뜻이고 사람의 LGTM은 여전히 필요하다. 둘째, 보수적으로 시작하라 — 처음엔 모든 PR을 risk:medium 이상으로 두고, 데이터가 쌓이면 임계치를 조정한다.
화자 개인은 혼자 하는 사이드 프로젝트에선 30점 이하면 그냥 머지한다. 30점 이하에도 breaking change나 장애가 섞일 수 있다는 트레이드오프는 인정하고, 사고가 나면 그때마다 루브릭과 하네스를 고쳐 다음엔 잡히게 만든다. AI가 만드는 PR 수는 너무 많아서 리뷰가 병목이 되면 안 되고, 결국 리스크 점수 기반으로 머지까지 맡길 수 있는 신뢰 수준까지 가야 한다는 것이 그의 결론이다.
[12:38] 8. 사람이 봐야 할 것 vs AI에게 맡길 것
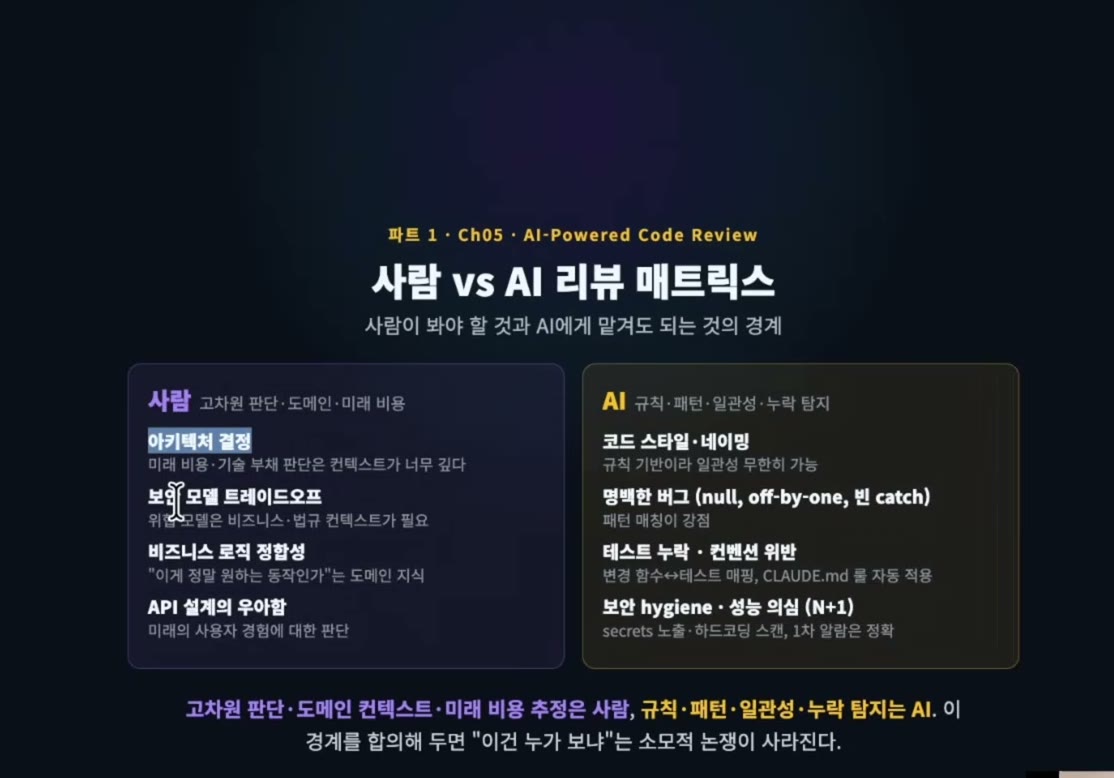
| 사람 — 고차원 판단·도메인·미래 비용 | AI — 규칙·패턴·일관성·누락 탐지 |
|---|---|
| 아키텍처 결정: 미래 비용·기술 부채 판단은 컨텍스트가 너무 깊다 | 코드 스타일·네이밍: 규칙 기반이라 일관성이 무한히 가능 |
| 보안 모델 트레이드오프: 위협 모델은 비즈니스·법규 컨텍스트가 필요 | 명백한 버그(null, off-by-one, 빈 catch): 패턴 매칭이 강점 |
| 비즈니스 로직 정합성: “이게 정말 원하는 동작인가”는 도메인 지식 | 테스트 누락·컨벤션 위반: 변경 함수↔테스트 매핑, CLAUDE.md 자동 적용 |
| API 설계의 우아함: 미래 사용자 경험에 대한 판단 | 보안 hygiene·성능 의심(N+1): secrets 노출·하드코딩 스캔, 1차 알람은 정확 |
이 경계를 팀 안에서 합의해 두면 “이건 누가 보냐”는 소모적 논쟁이 사라진다. 사람은 규칙·패턴 확인에 더 이상 시간을 쓰면 안 된다.
[13:21] 9. 도구 — /code-review, ultrareview, Codex 크로스 리뷰
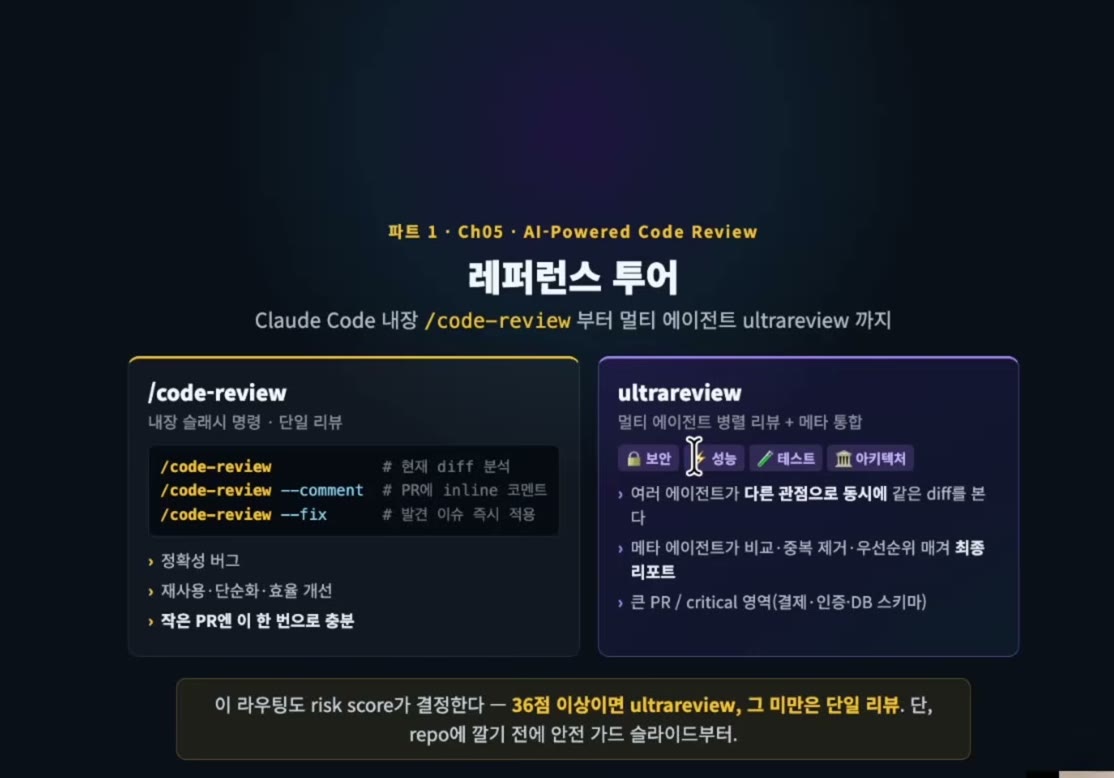
슬라이드가 소개하는 Claude Code 내장 도구는 두 가지다.
/code-review            # 현재 diff 분석
/code-review --comment  # PR에 inline 코멘트
/code-review --fix # 발견 이슈 즉시 적용/code-review— 내장 슬래시 명령, 단일 리뷰. 정확성 버그와 재사용·단순화·효율 개선을 본다. 작은 PR은 이 한 번으로 충분하다.- ultrareview — 여러 에이전트가 보안·성능·테스트·아키텍처 관점으로 같은 diff를 동시에 보고, 메타 에이전트가 비교·중복 제거·우선순위를 매겨 최종 리포트를 낸다. 큰 PR이나 결제·인증·DB 스키마 같은 critical 영역용. 화자는 추가 비용(1회 약 5달러로 알고 있다고 함)이 들고 몇 분 걸리며, 몇 번은 무료로 쓸 수 있다고 소개했지만 본인은 아직 써 보지 않았다.
슬라이드는 이 라우팅도 리스크 점수로 정하라고 제안한다 — 36점 이상이면 ultrareview, 그 미만은 단일 리뷰.
화자가 실제로 즐겨 쓰는 건 Codex ↔ Claude 크로스 리뷰다. 자기가 한 작업을 같은 모델에게 리뷰시키면 확증 편향이 생기고, 새 세션을 열어도 같은 모델이면 놓치는 게 비슷하다. 그래서 Codex(GPT)로 코딩하면 Claude에게 리뷰를 맡기고, 다시 Codex로 고치는 식으로 두 모델이 서로를 보완하게 한다. → codex · 멀티툴 핸드오프 패턴 전반은 2026-09-12-claude-code-codex-multitool-strategy
[14:30] 10. 도입 전 안전 가드 6가지 — 이 섹션에서 가장 중요한 부분
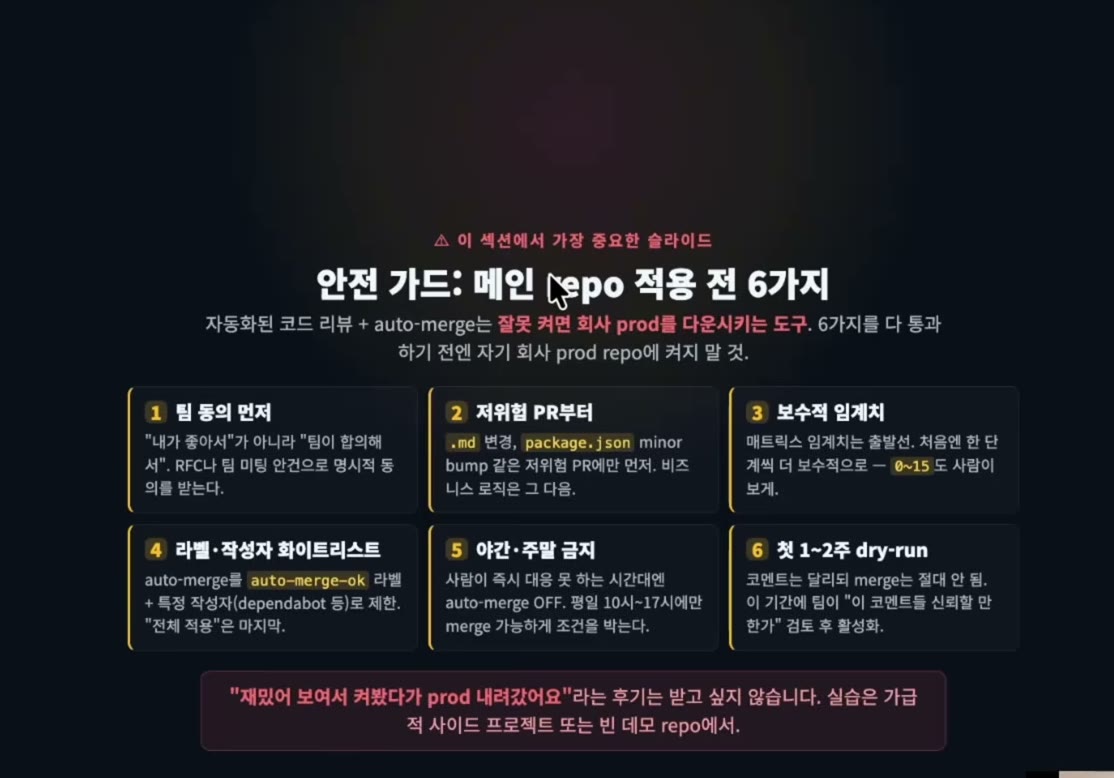
자동화된 코드 리뷰 + auto-merge는 잘못 켜면 회사 prod를 다운시키는 도구다. 강의를 듣고 다음 날 출근하자마자 도입하려는 사람에게 화자가 거는 제동이다.
| # | 가드 | 내용 |
|---|---|---|
| 1 | 팀 동의 먼저 | ”내가 좋아서”가 아니라 팀이 합의해서. RFC나 팀 미팅 안건으로 명시적 동의 |
| 2 | 저위험 PR부터 | .md 변경, package.json minor bump 같은 PR에만 먼저. 비즈니스 로직은 그다음 |
| 3 | 보수적 임계치 | 매트릭스 임계치는 출발선. 처음엔 한 단계씩 더 보수적으로 — 0~15도 사람이 보게 |
| 4 | 라벨·작성자 화이트리스트 | auto-merge를 auto-merge-ok 라벨 + 특정 작성자(dependabot 등)로 제한. “전체 적용”은 마지막 |
| 5 | 야간·주말 금지 | 사람이 즉시 대응 못 하는 시간대엔 auto-merge OFF. 평일 10~17시에만 merge 가능하게 |
| 6 | 첫 1~2주 dry-run | 코멘트는 달되 merge는 절대 안 됨. “이 코멘트들을 신뢰할 만한가”를 검토한 뒤 활성화 |
라벨링만 먼저 해 두고 “이 PR은 auto-merge 할 수도 있었다”는 기록을 모아 정확도가 확인되면 그때 켜는, 게이트를 여러 겹 두는 방식이다. 실습은 사이드 프로젝트나 빈 데모 repo에서 하라고 당부한다.
[16:09] 11. 실습 ① PR 전 셀프 리뷰 훅 — pre-commit에서 pre-push로
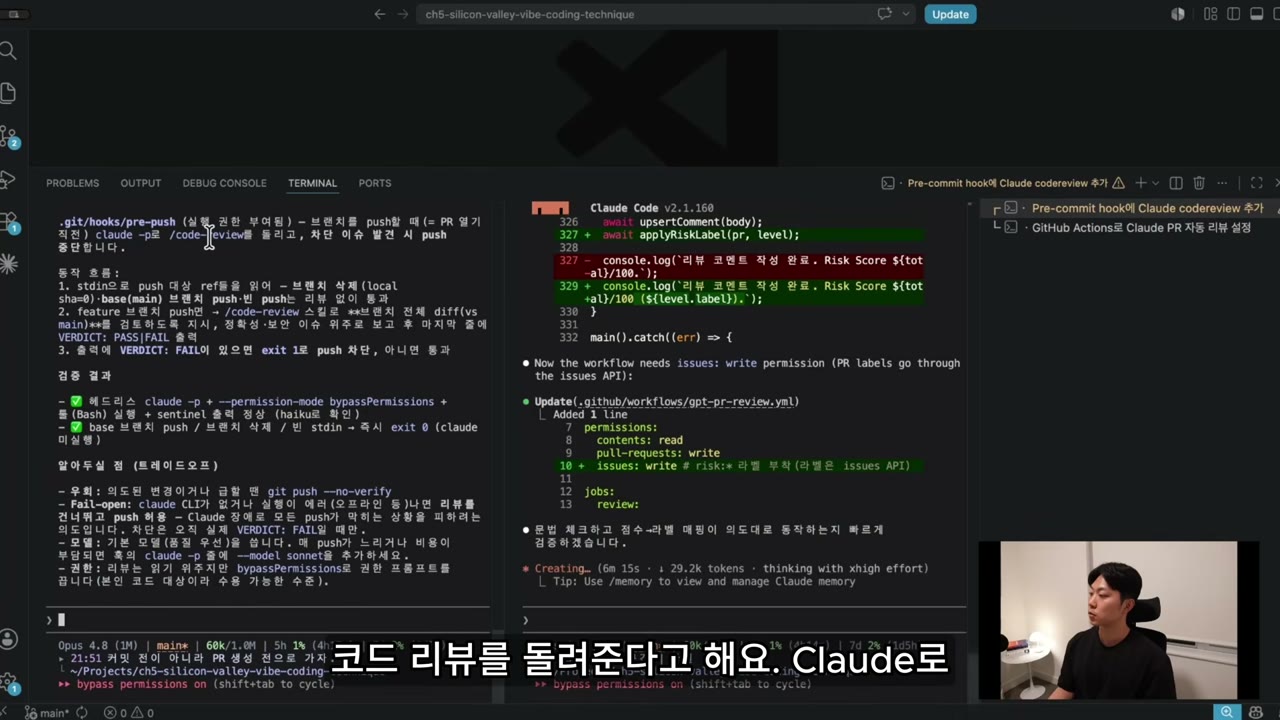
Claude Code 세션 두 개를 병렬로 띄워 하나는 “커밋 전에 /code-review를 꼭 돌리는 훅”을, 다른 하나는 “PR을 자동 리뷰하고 코멘트를 다는 GitHub Actions”를 설정한다.
훅 종류를 고를 때 화자는 Claude Code 훅이 아니라 git 자체의 훅을 택한다. Claude 이전부터 쓰던 git hook이 git 흐름과 더 잘 맞기 때문이다. 리뷰에서 문제가 나오면 커밋 흐름을 차단해야 한다 — 리뷰해 놓고 그대로 통과시키면 리뷰할 이유가 없다.
처음엔 pre-commit으로 시작했다가 pre-push로 바꾼다. 커밋마다 리뷰하면 토큰도 많이 들고 생산성도 떨어지니 “PR 생성 직전”이 맞는데, PR 생성은 git lifecycle 이벤트가 아니어서 그에 가장 가까운 push 시점을 쓴다. Claude가 만든 .git/hooks/pre-push의 동작은 화면에 이렇게 요약돼 있다.
.git/hooks/pre-push — 브랜치를 push할 때(= PR 열기 직전) claude -p로 /code-review를 돌리고,
차단 이슈 발견 시 push 중단

1. stdin으로 push 대상 ref를 읽어 브랜치 삭제·base(main) 브랜치 push·빈 push는 리뷰 없이 통과
2. feature 브랜치 push면 /code-review 스킬로 브랜치 전체 diff(vs main)를 검토,
   정확성·보안 이슈 위주로 보고 후 마지막 줄에 VERDICT: PASS|FAIL 출력
3. 출력에 VERDICT: FAIL이 있으면 exit 1로 push 차단, 아니면 통과

알아두실 점(트레이드오프)
- 우회: 의도된 변경이거나 급할 땐 git push --no-verify
- Fail-open: claude CLI가 없거나 실행 에러(오프라인 등)면 리뷰를 건너뛰고 push 허용
  — Claude 장애로 모든 push가 막히는 상황을 피하려는 의도. 차단은 오직 실제 VERDICT: FAIL일 때만
- 모델: 기본 모델(품질 우선). push가 느리거나 비용이 부담되면 claude -p 줄에 --model sonnet 추가
- 권한: 리뷰는 읽기 위주지만 bypassPermissions로 권한 프롬프트를 끕니다
[24:30] 12. fork 세션으로 테스트하고, 버그를 심어 훅 검증
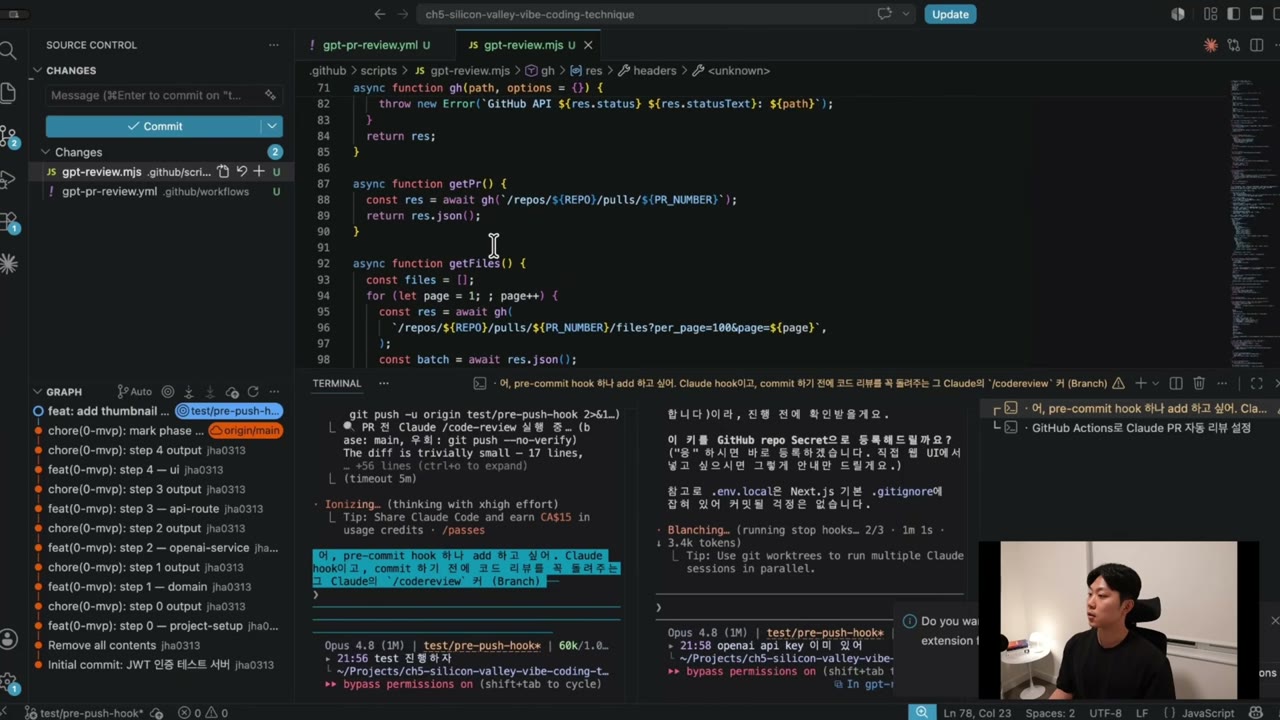
테스트는 세션을 fork(세션 복제)해서 진행한다. 원래 세션의 맥락을 그대로 가진 채 별도 세션에서 실험하는 용도다. Claude는 test/pre-push-hook 브랜치를 만들고 명백한 버그를 심은 뒤 push해서 훅을 실제로 발동시킨다. /code-review가 도는 데 1~3분이 걸린다.
같은 시각 다른 세션에선 Post-PR 리뷰가 만들어진다. 화자는 도중에 Claude 대신 GPT API로 PR을 리뷰하는 쪽으로 방향을 바꿨다(크로스 리뷰 취지). 결과물은 .github/workflows/gpt-pr-review.yml과 .github/scripts/gpt-review.mjs 두 파일이다. 스크립트는 GitHub API로 PR과 변경 파일 목록을 가져와 앞의 5축 루브릭으로 점수를 매기고, 코멘트를 upsert한 뒤 risk:low/medium/high/critical 라벨을 붙인다. 모델 ID는 환경 변수로 빼 두어 나중에 교체할 수 있게 했다. 라벨은 issues API로 붙기 때문에 워크플로 권한에 issues: write가 추가로 필요하다.
permissions:
  contents: read
  pull-requests: write
  issues: write   # risk:* 라벨 부착(라벨은 issues API)
[29:41] 13. 훅이 push를 막다
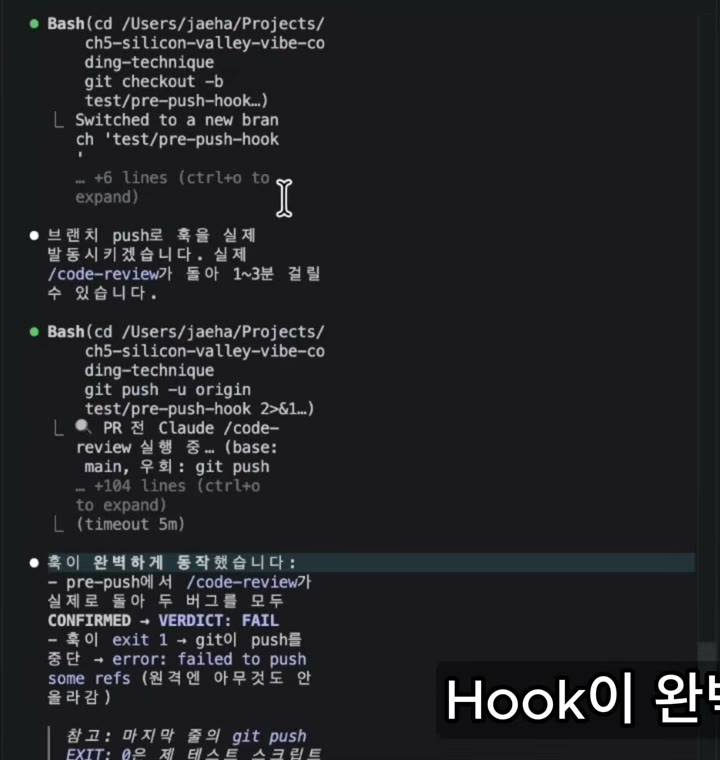
결과는 의도대로였다. pre-push에서 /code-review가 실제로 돌아 심어 둔 버그 두 개를 모두 잡았고(VERDICT: FAIL), 훅이 exit 1로 끝나 git이 push를 중단했다(error: failed to push some refs, 원격에는 아무것도 올라가지 않음). 이후 버그를 고친 커밋으로 다시 push해 훅이 통과하는 것도 확인했다.
[31:06] 14. API 키가 노출됐다면 — 지우고 새로 만든다
Actions 워크플로는 OPENAI_API_KEY를 GitHub repo Secret으로 요구한다. 처음엔 Actions secrets가 비어 있어(total_count: 0) 등록 작업을 하다가, 작업 도중 키가 화면에 드러나는 일이 생겼다. 화자의 조언은 단순하다. API 키는 집 열쇠를 넘기는 것과 같으니, 노출됐다면 고민할 것 없이 즉시 폐기하고 새로 발급하면 된다. gh secret set으로 등록할 땐 값을 큰따옴표로 감싸야 하고, 잘 안 되면 GitHub 웹 UI에서 직접 붙여 넣는 방법도 있다.
[34:21] 15. 테스트 PR — risk:low 판정
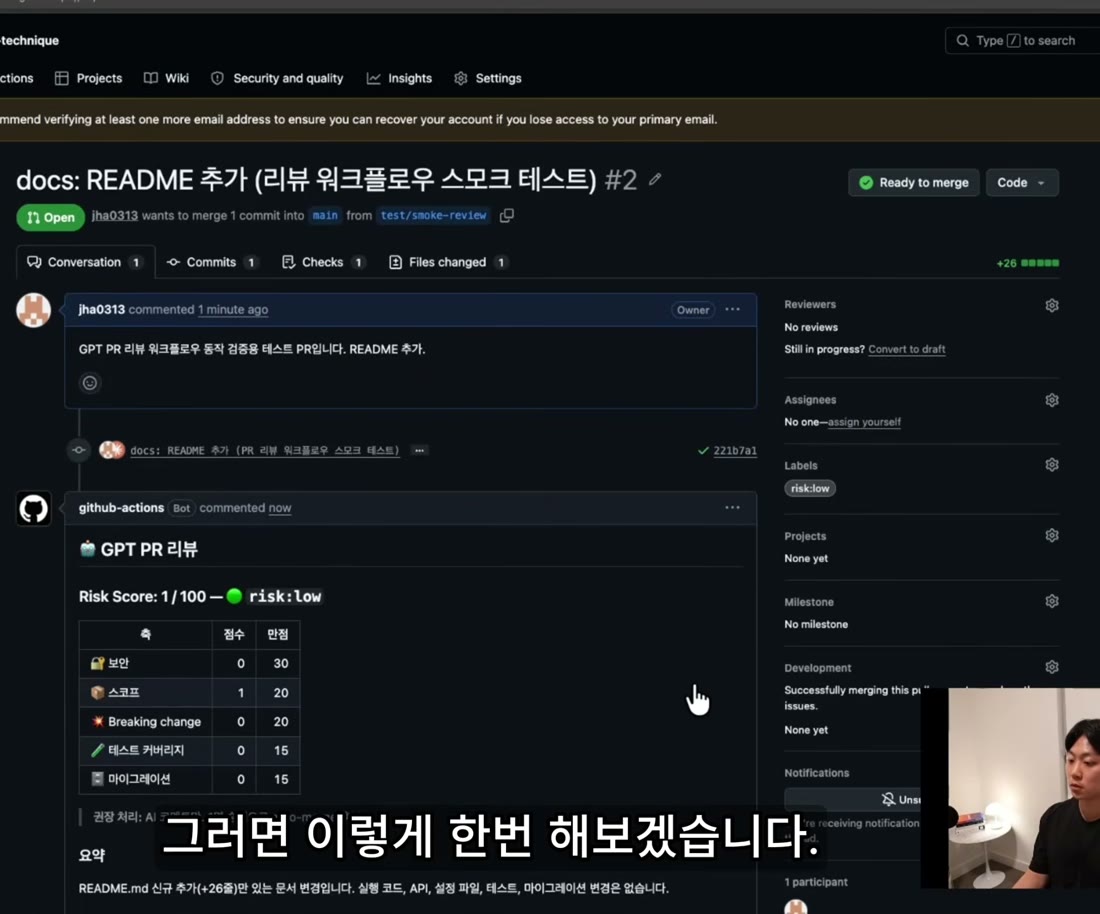
워크플로 스크립트는 main에 있어야 새 PR에서 실행되므로, 먼저 설정 PR을 main에 머지한 뒤 README를 추가하는 테스트 PR(#2)을 올렸다. github-actions 봇이 단 코멘트는 이렇다.
- Risk Score: 1/100 —
risk:low(보안 0/30, 스코프 1/20, Breaking change 0/20, 테스트 커버리지 0/15, 마이그레이션 0/15) - 요약: “README.md 신규 추가(+26줄)만 있는 문서 변경입니다. 실행 코드, API, 설정 파일, 테스트, 마이그레이션 변경은 없습니다.”
- 라벨
risk:low가 자동으로 붙고, 권장 처리는 1명 승인 후 auto-merge 후보.
문서만 바꾼 PR이니 머지해도 무방하다는 판정이다. 화자는 GPT-5.5 Codex로 리뷰를 돌리는 것과 결과가 같다고 설명하며, 실제 코드 변경이 들어가면 코멘트가 훨씬 자세해진다고 덧붙인다.
[36:03] 16. 숙제와 정리
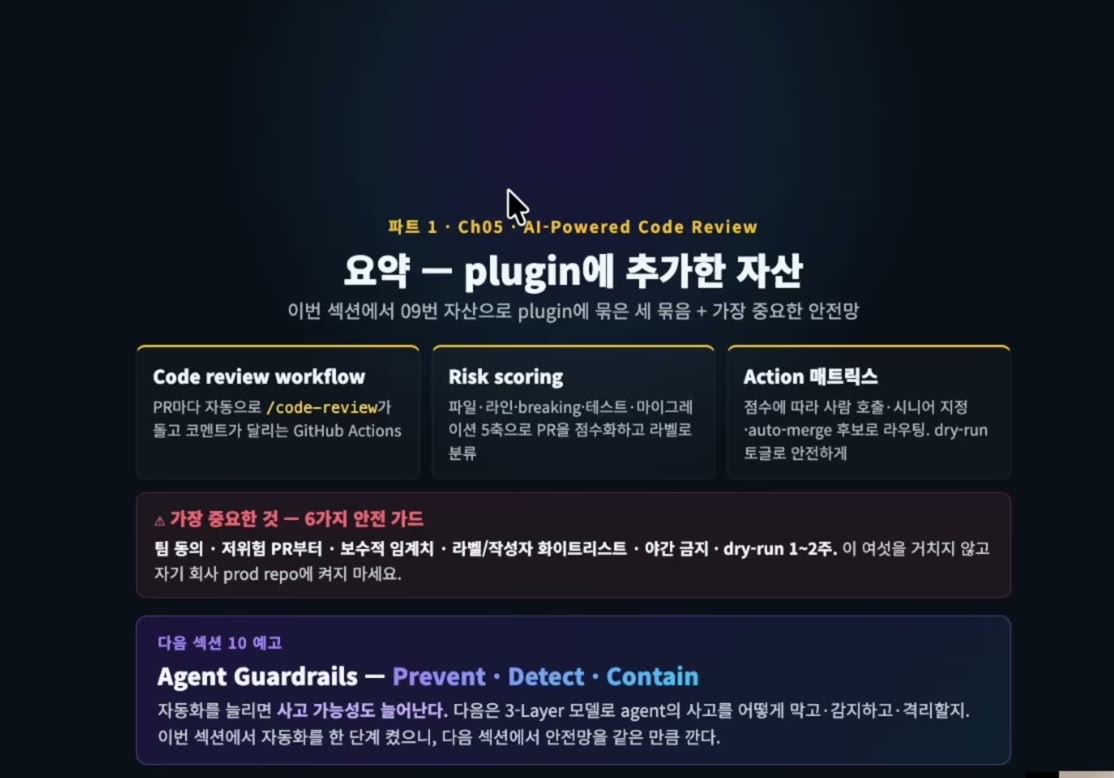
숙제는 risk:low일 때 실제로 auto-merge 되게 바꿔 보기다. Claude에게 한 줄만 지시하면 되니, 직접 해 보면서 “이걸 맡겨도 되는구나”라는 신뢰를 쌓아 보라는 것.
이번 섹션에서 plugin에 추가한 자산은 세 묶음이다.
- Code review workflow — PR마다 자동으로
/code-review가 돌고 코멘트가 달리는 GitHub Actions - Risk scoring — 파일·라인·breaking·테스트·마이그레이션 5축으로 PR을 점수화하고 라벨로 분류
- Action 매트릭스 — 점수에 따라 사람 호출·시니어 지정·auto-merge 후보로 라우팅, dry-run 토글로 안전하게
화자의 회사 팀도 이렇게 운영하고 있고, 그래야 리뷰 병목이 풀린다고 한다. 다만 자동화를 늘리면 코드 리뷰 에이전트의 오판, 과도한 권한, 위험 명령 실행 같은 사고 가능성도 따라 늘어나는 피할 수 없는 트레이드오프가 있다. 그래서 다음 섹션(10)은 에이전트 사고를 막고·감지하고·격리하는 3-Layer 안전망 Agent Guardrails — Prevent · Detect · Contain을 다룬다.
부록 — 실전 체크리스트
- 로컬 셀프 리뷰를 훅으로 강제한다 — pre-commit보다 pre-push(토큰·속도 부담이 적고 PR 직전에 가장 가까움). 실패 시
VERDICT: FAIL→exit 1. - 훅은 fail-open으로 — CLI 부재·오프라인이면 통과, 실제 FAIL 판정일 때만 차단. 급할 땐
git push --no-verify. - Post-PR 리뷰는 GitHub Actions로. 권한에
pull-requests: write와 라벨용issues: write를 넣는다. - 모델 ID는 환경 변수로 빼 둔다. 리뷰 모델은 코드를 쓴 모델과 다른 계열로(크로스 리뷰).
- 리스크 루브릭(보안 30 / 스코프 20 / breaking 20 / 테스트 15 / 마이그레이션 15)을 팀 사정에 맞게 고쳐 쓴다.
- 경로 기반 라우팅 —
auth/→ security 리뷰,db/migrations/→ architecture 리뷰, 36점 이상 → 멀티 에이전트 리뷰. - 안전 가드 6가지를 모두 통과하기 전엔 prod repo에 auto-merge를 켜지 않는다. 첫 1~2주는 dry-run(코멘트만).
- API 키는
.env.local(gitignore)과 repo Secret에만. 화면·로그에 노출됐다면 즉시 폐기하고 재발급. - 워크플로 스크립트는 main에 머지된 뒤에야 새 PR에서 돈다 — 설정 PR 먼저 머지하고 테스트 PR로 확인.
원문 인용 모음
- [02:32] “저희가 사람을 빼는 게 아닙니다. 사람을 더 중요한 일에 다시 배치할 수 있다라는 겁니다.”
- [04:24] “이 AI 시대에 셀프 리뷰를 안 돌리고 있다, 그거는 리뷰하는 사람들을 더 힘들게 하는 일이죠.”
- [06:13] “프리 PR에서 잡은 거는 포스트 PR이 잡을 필요가 없기 때문에, 포스트 PR은 좀 더 무거운 분석에 집중할 수 있어야 합니다.”
- [11:03] “결국에 이 리뷰가 병목이 되면 안 돼요. AI가 생성하는 PR 개수는 무조건 너무나도 많기 때문에.”
- [12:07] “점수 임계치는 보수적으로 시작하는 걸 추천드립니다. 무조건. 왜냐면 오토 머지 하면 큰일 나잖아요.”
- [13:45] “본인이 한 작업에 코드 리뷰를 시키면 확증 편향이 생겨서 리뷰를 잘 못 하게 돼요.”
- [14:38] “오토 머지는 절대 일단 하면 안 됩니다. … 정말 회사 프로덕션 다운됩니다.”
- [19:10] “리뷰를 했는데 그냥 커밋을 해 버리면 리뷰를 하는 의미가 없습니다.”
- [31:32] “API 키는 집 열쇠를 주는 거랑 똑같기 때문에, 만약에 노출이 됐다 그러면 그냥 새거 만드시면 됩니다.”
- [37:53] “자동화가 이렇게 늘어날수록 안전망이 훨씬 더 정교해져야 돼요.”
관련 노트
- 2026-08-17-ai-era-meta-engineer-career-tips-12 — 같은 채널(실밸개발자)의 AI 시대 엔지니어 커리어 팁
- 2026-08-22-code-review-intent-verification — AI 코드 리뷰에서 의도 검증
- 2026-08-23-ai-era-code-review-guide — 볼트 코드 리뷰 노트를 종합한 실무 가이드(원칙·절차·도입 로드맵)
- 2026-09-26-claude-ai-driven-code-modernization — 대규모 코드 현대화에서 변경을 프로덕션으로 올리는 “승격 정책” 설계 — auto-merge 게이트와 같은 문제
- 2026-09-12-claude-code-codex-multitool-strategy — Claude Code ↔ Codex 멀티툴·크로스 리뷰 전략
- 2026-09-12-hadaio-34310-ai-code-software-engineering — AI가 코드 대부분을 쓰면 리뷰·검증이 핵심 역량이 된다는 논의
- 2026-07-22-pytorchkr-topic-11350-code-review-skill-20-claude-code — Claude Code 코드 리뷰 스킬
- 2026-07-26-alibaba-open-code-review — 오픈소스 코드 리뷰 에이전트
- moc-claude-code · moc-ai-coding