출처 https://www.youtube.com/watch?v=LHpplKlnXes · 채널 Tech Bridge (원본: IBM Technology, 2026-09-13) · 길이 10:38 포맷 발표자 1인이 블랙보드에 직접 그리며 설명하는 강연. 보드는 3단 피라미드(파운데이션→RAG·에이전트→배포)가 뼈대고, RAG 파이프라인 다이어그램이 하이라이트. 원본 자막:
raw/transcripts/2026-09-16-ai-engineer-3-tier-skills.ko.srt(YouTube 자막 API 429로 whisper base 자체 전사한 영어 자막 — 화면의 Tech Bridge 한영 자막과 대조해 정리)
한눈에 보는 요약
- AI 엔지니어 ≠ ML 연구원. 연구원이 파운데이션 모델이라는 “엔진”을 만들면, AI 엔지니어는 그 엔진으로 “자동차” — 데이터·도구·메모리·가드레일을 엮은 실전 시스템 — 를 만드는 사람이다.
- 순서가 핵심인 3단계 스택. ① 파운데이션(Python·Git·CLI·Linux·API) → ② AI 스킬(임베딩·벡터 검색·RAG·에이전트와 도구) → ③ 배포(컨테이너화·관측가능성·모니터링). 기초를 건너뛰고 에이전트부터 만지면 결국 되돌아와 다시 배운다.
- RAG는 “접근 정보를 LLM 컨텍스트에 넣어 할루시네이션을 막는” 표준 파이프라인. 문서 Ingest→청크→임베드→Vector DB 저장, 질문 시 관련 정보 검색→질문과 함께 LLM 입력→근거 있는 답변. AI 실험 중인 거의 모든 회사가 어떤 형태로든 원한다.
- 워크플로(A→B→C 고정 경로)와 에이전트(도구 호출·관찰·판단을 반복하는 동적 루프)는 다르다. 이 루프를 안정적으로 대규모로 돌릴 수 있는 사람이 좋은 AI 엔지니어이며, 지금 가장 수요 높은 응용 스킬이다.
- 실전 유스케이스 3종. ① RAG 지식 시스템(HR·병원·챗봇), ② DB 조회·시각화까지 하는 에이전트, ③ AI 도구로 수 주 걸리던 배포를 수 시간으로 단축. 관심 분야와 겹치는 곳에서 직접 만들어보라는 것이 결론.
핵심 한 줄: AI 엔지니어는 모델을 만드는 사람이 아니라 모델을 실전 시스템으로 엮는 사람이며, 파운데이션→RAG·에이전트→배포 순서로 배우고 RAG·에이전트·배포 중 하나를 직접 만들어봐야 한다.
장면별 상세 설명
[00:05] 1. 오프닝 — 컴퓨터공학 학위 없이 AI 엔지니어가 되는 법
컴퓨터공학 학위가 필수는 아니지만, 올바른 스킬과 기초 이해는 필요하다고 문을 연다. 오늘 다룰 것은 세 가지 — AI 엔지니어의 정의, 배워야 할 스킬 스택, 그리고 고용주에게 실력을 보여줄 프로젝트 3종이다. 영상 전체가 “정의→스택→실전” 흐름으로 짜여 있다.
[00:40] 2. 전제 — 코드는 쉬워졌고, 어려운 건 판단력이다
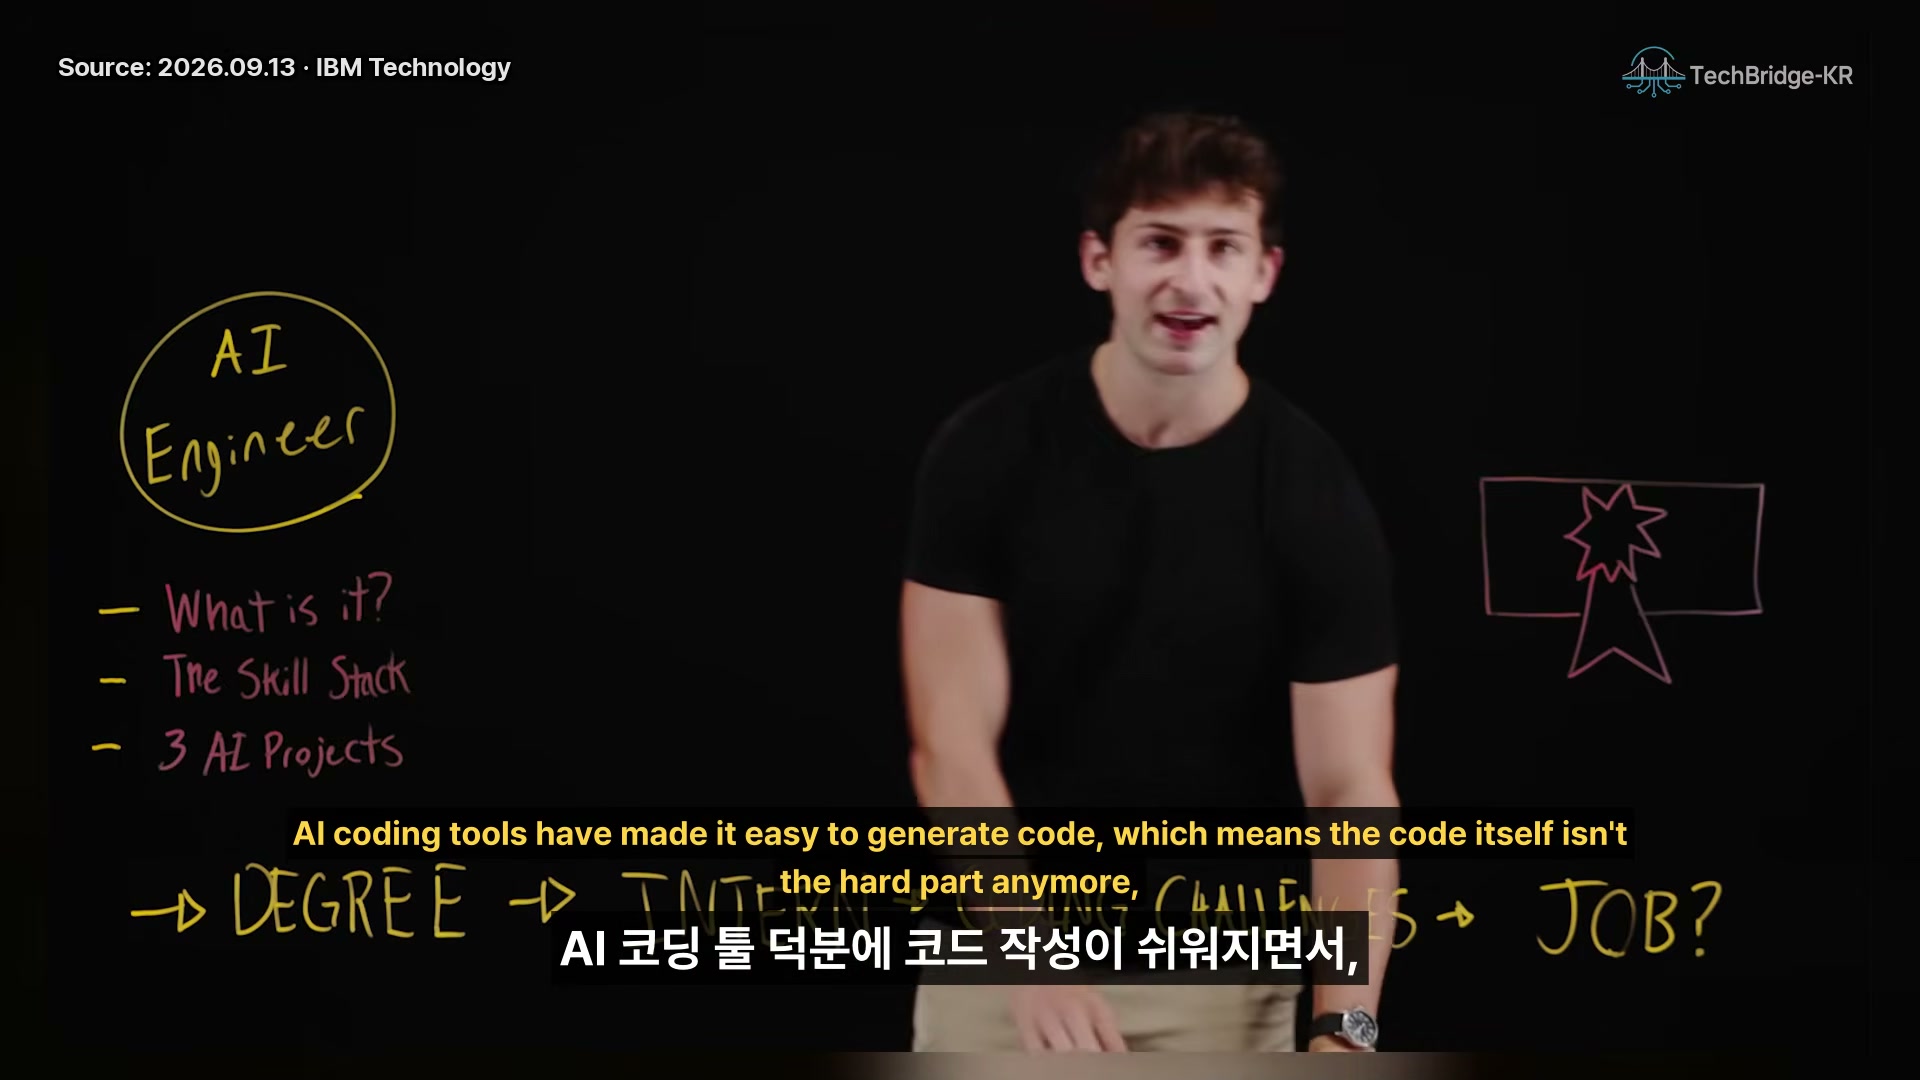
몇 년 전 테크 입문 경로는 학위→인턴→코딩 테스트→콜백 대기였지만, AI 코딩 도구가 코드 생성을 쉽게 만들면서 코드 자체는 더 이상 어려운 부분이 아니게 됐다. 어려운 부분은 판단(judgment) — 애플리케이션을 어떻게 구조화할지, 무엇을 만들지, 왜 한 접근법이 다른 것보다 나은지를 결정하는 능력이다. 수업으로 가르치기 어렵고 직접 만들면서 배우는 것이라서, “무엇을 배우고 어떻게 증명할 것인가”가 영상의 질문이 된다. 2026-06-20-karpathy-vibe-coding-to-agentic-engineering에서 Karpathy가 말한 “taste와 판단이 인간의 알파”라는 주장과 같은 결이다.
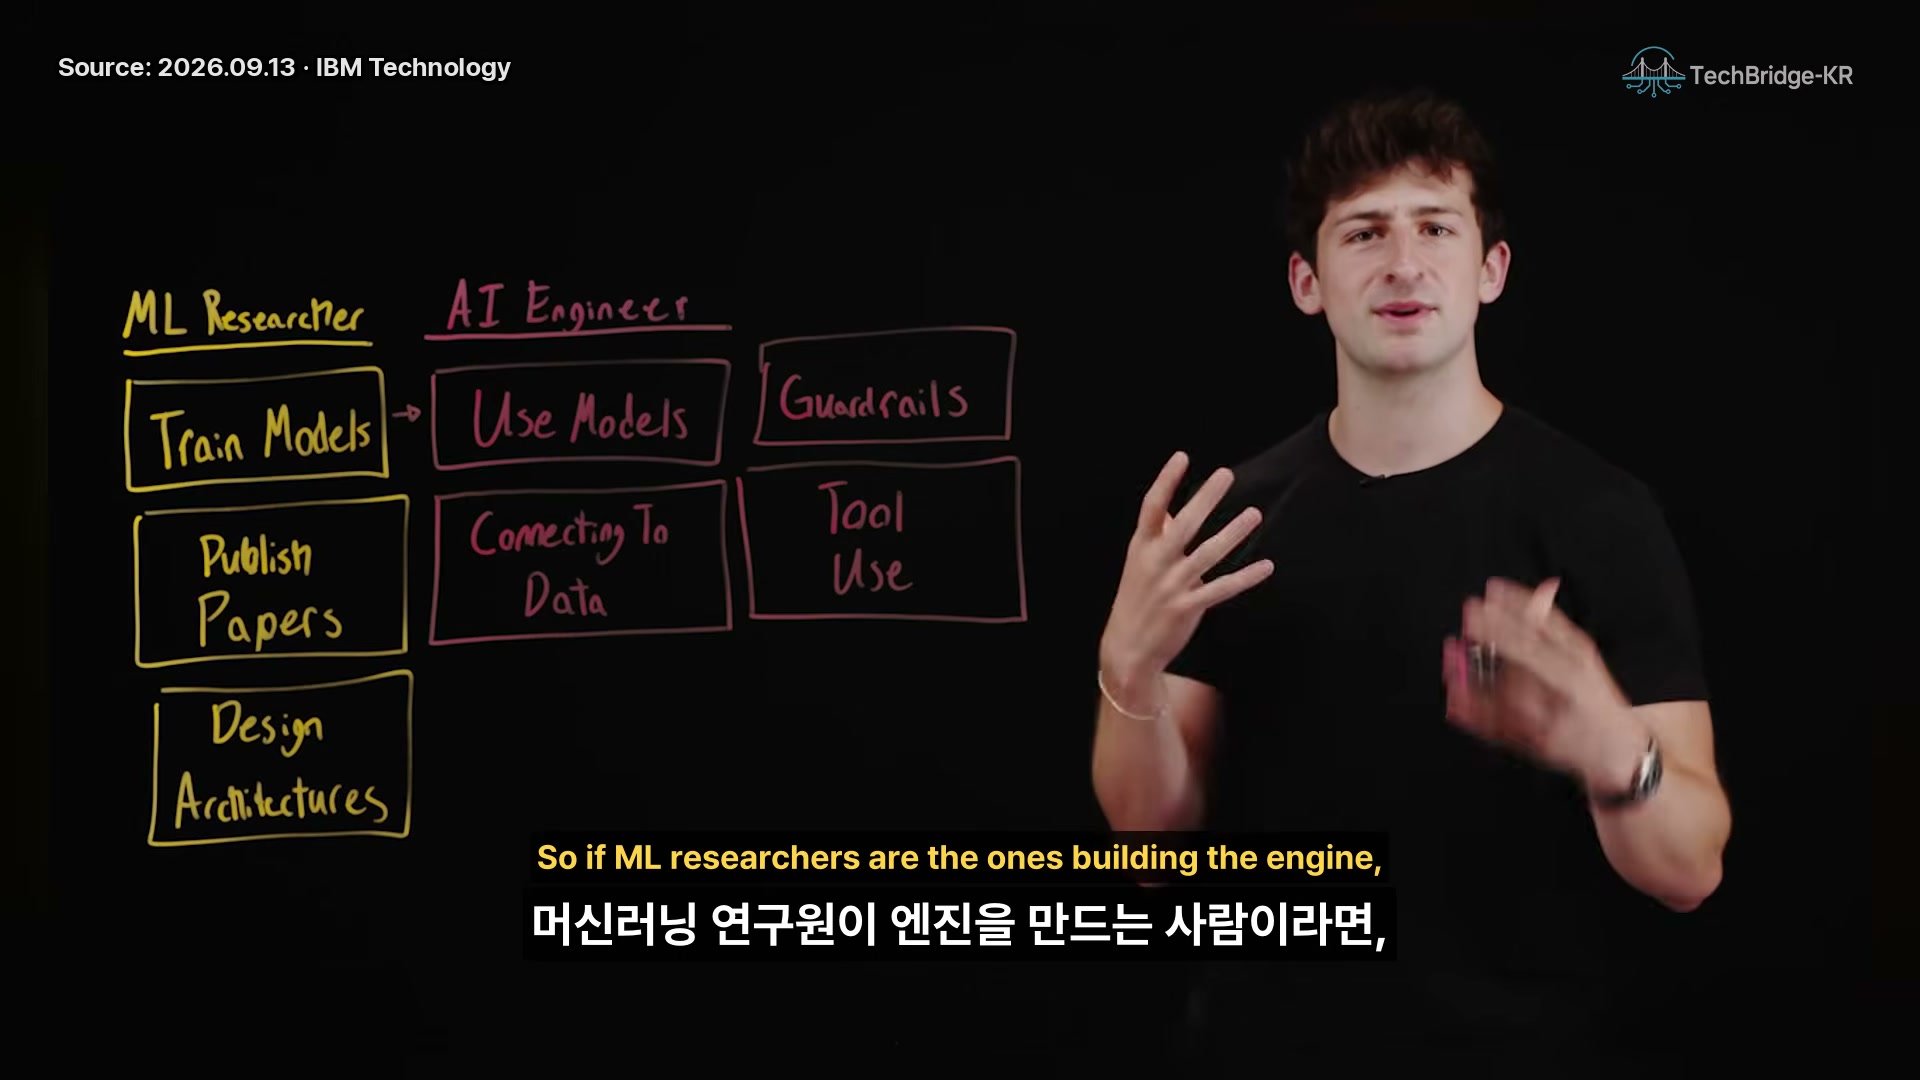
[01:20] 3. 정의 — 연구원은 엔진을, 엔지니어는 자동차를 만든다
용어 정리. ML 연구원은 파운데이션 모델을 처음부터 학습시키고 논문을 쓰는 사람으로, 깊은 수학과 보통 고급 학위가 필요하다. AI 엔지니어는 이미 존재하는 모델(프론티어든 오픈소스든)을 가져와 유용한 일을 하는 시스템에 연결한다 — 모델에 데이터를 연결하고, 도구와 외부 정보 접근을 주고, 메모리·루프·가드레일을 붙여 실제 쓸 수 있는 솔루션으로 만드는 것. “연구원이 엔진을 만들면 엔지니어는 자동차를 만든다”는 비유가 핵심이며, 모델이 쏟아지는 지금 자동차를 만들 사람이 절실하다는 진단이다.
[02:22] 4. 전체 지도 — 3단계 피라미드와 순서의 중요성
파운데이션을 맨 아래에 둔 3단 구조를 제시하고, 순서가 중요하다고 강조한다. 흔한 실패 패턴은 기초를 건너뛰고 바로 에이전트를 만들거나 배포하려다 데이터 처리와 인프라의 디테일에서 막혀 기초를 다시 배우는 것. 피라미드는 아래에서부터 ① 파운데이션, ② AI 스킬, ③ 배포다.
[03:10] 5. 1단계 파운데이션 — Python·Git·CLI·Linux·API
AI 전용은 아니지만 없으면 아무것도 못 만드는 층이다. Python은 달인이 될 필요는 없고, AI 에이전트가 쓴 코드를 읽고 이해할 수준의 유창함이면 된다 — PyTorch·TensorFlow 등 ML/AI 패키지가 전부 Python 기반이라서다. Git·CLI·Linux는 프로젝트를 만들고 공유하는 데 필수이며, AI 도구들이 전부 내부적으로 Linux 위에서 돌아가 에이전트가 배포될 운영체제를 다룰 줄 알아야 한다. API는 두 소프트웨어를 잇는 방법이자, 모델 호출·응답 처리·레이트 리밋 대응의 기본기다 — 결국 모든 AI 제품은 애플리케이션↔모델↔도구 사이의 잘 구조화된 API 호출 왕복이다.
[04:55] 6. 2단계 AI 스킬 — 임베딩과 벡터 검색
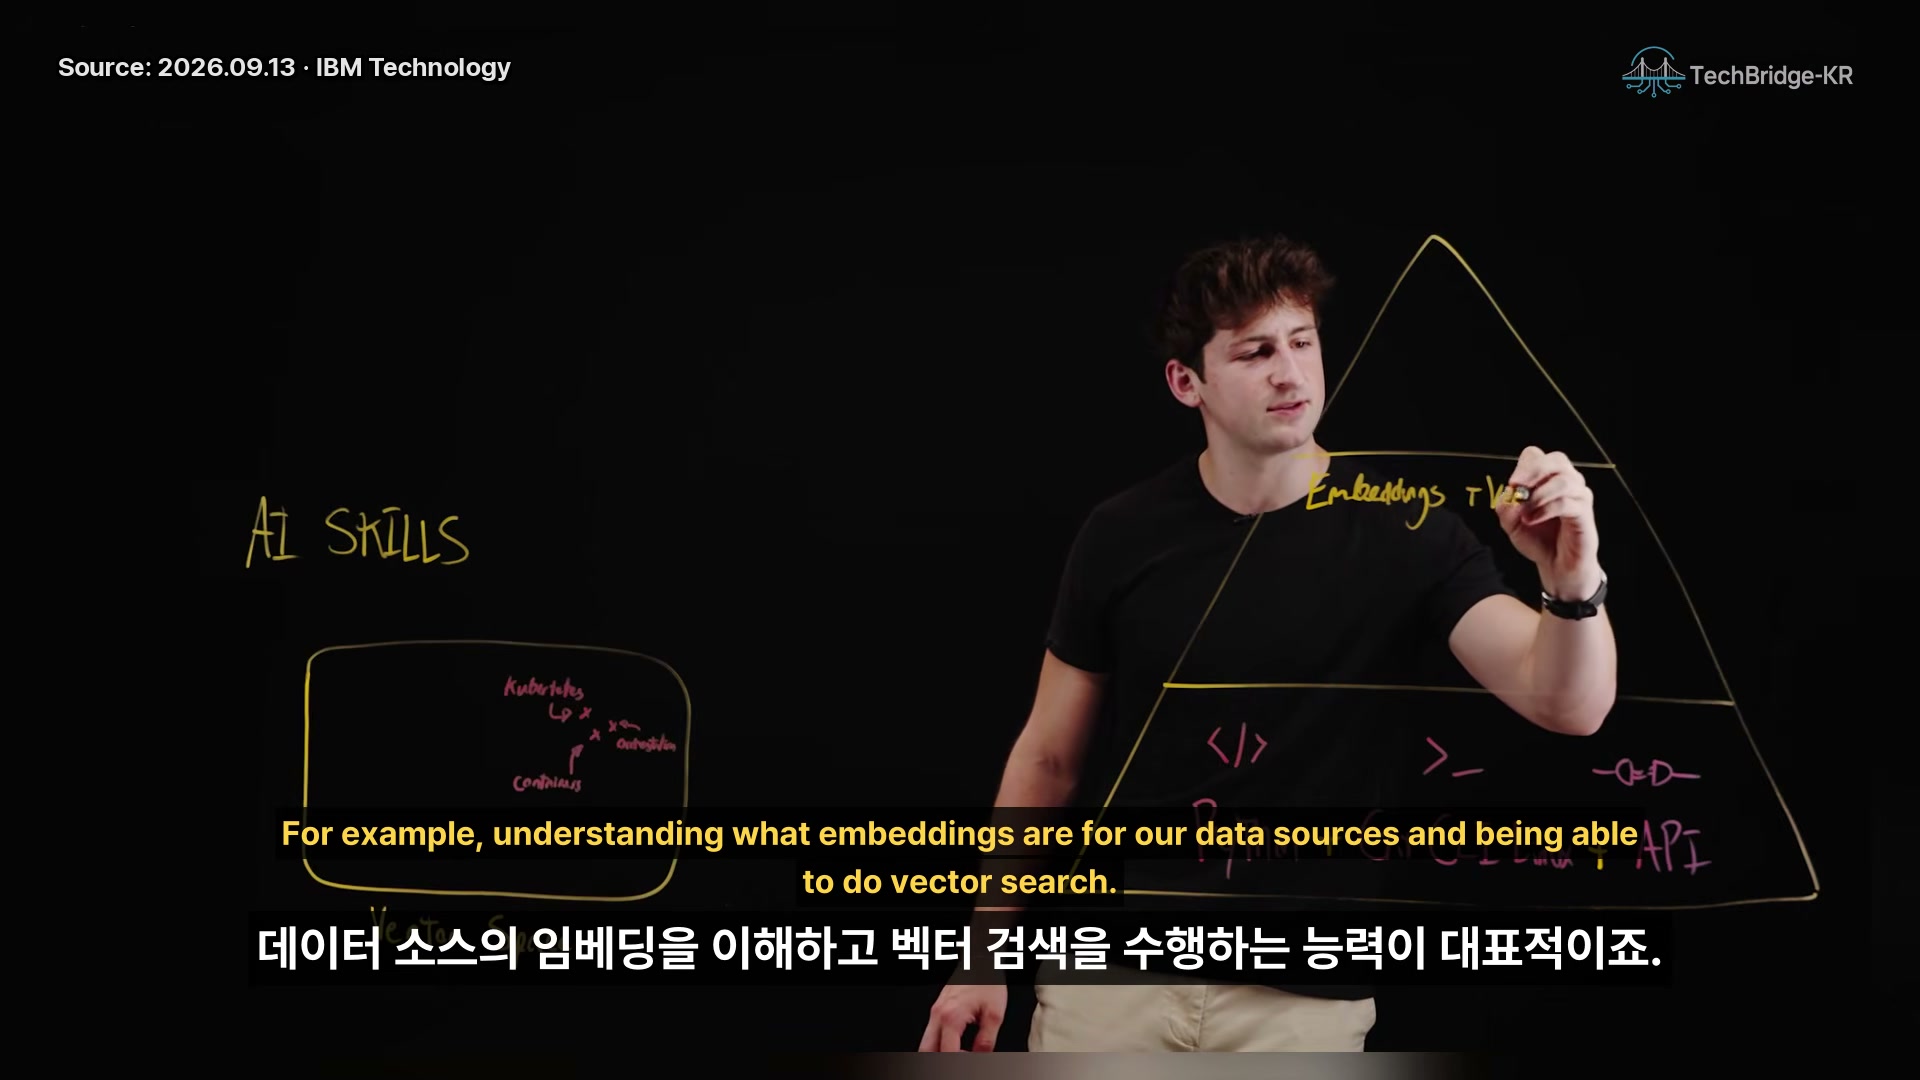
LLM 컨텍스트 윈도우에 근거 정보를 넣어 정확한 답변을 얻기 위한 기반 기술이다. 키워드 매칭이 아니라 의미를 이해하도록 텍스트(PDF 등)를 수치 벡터로 바꾸고 유사도로 검색한다 — Kubernetes가 containers·orchestration과 가깝다는 식의 의미 공간 검색이다. 이게 다음 장면의 RAG로 이어진다.
[06:05] 7. RAG 파이프라인 — Ingest부터 근거 있는 답변까지
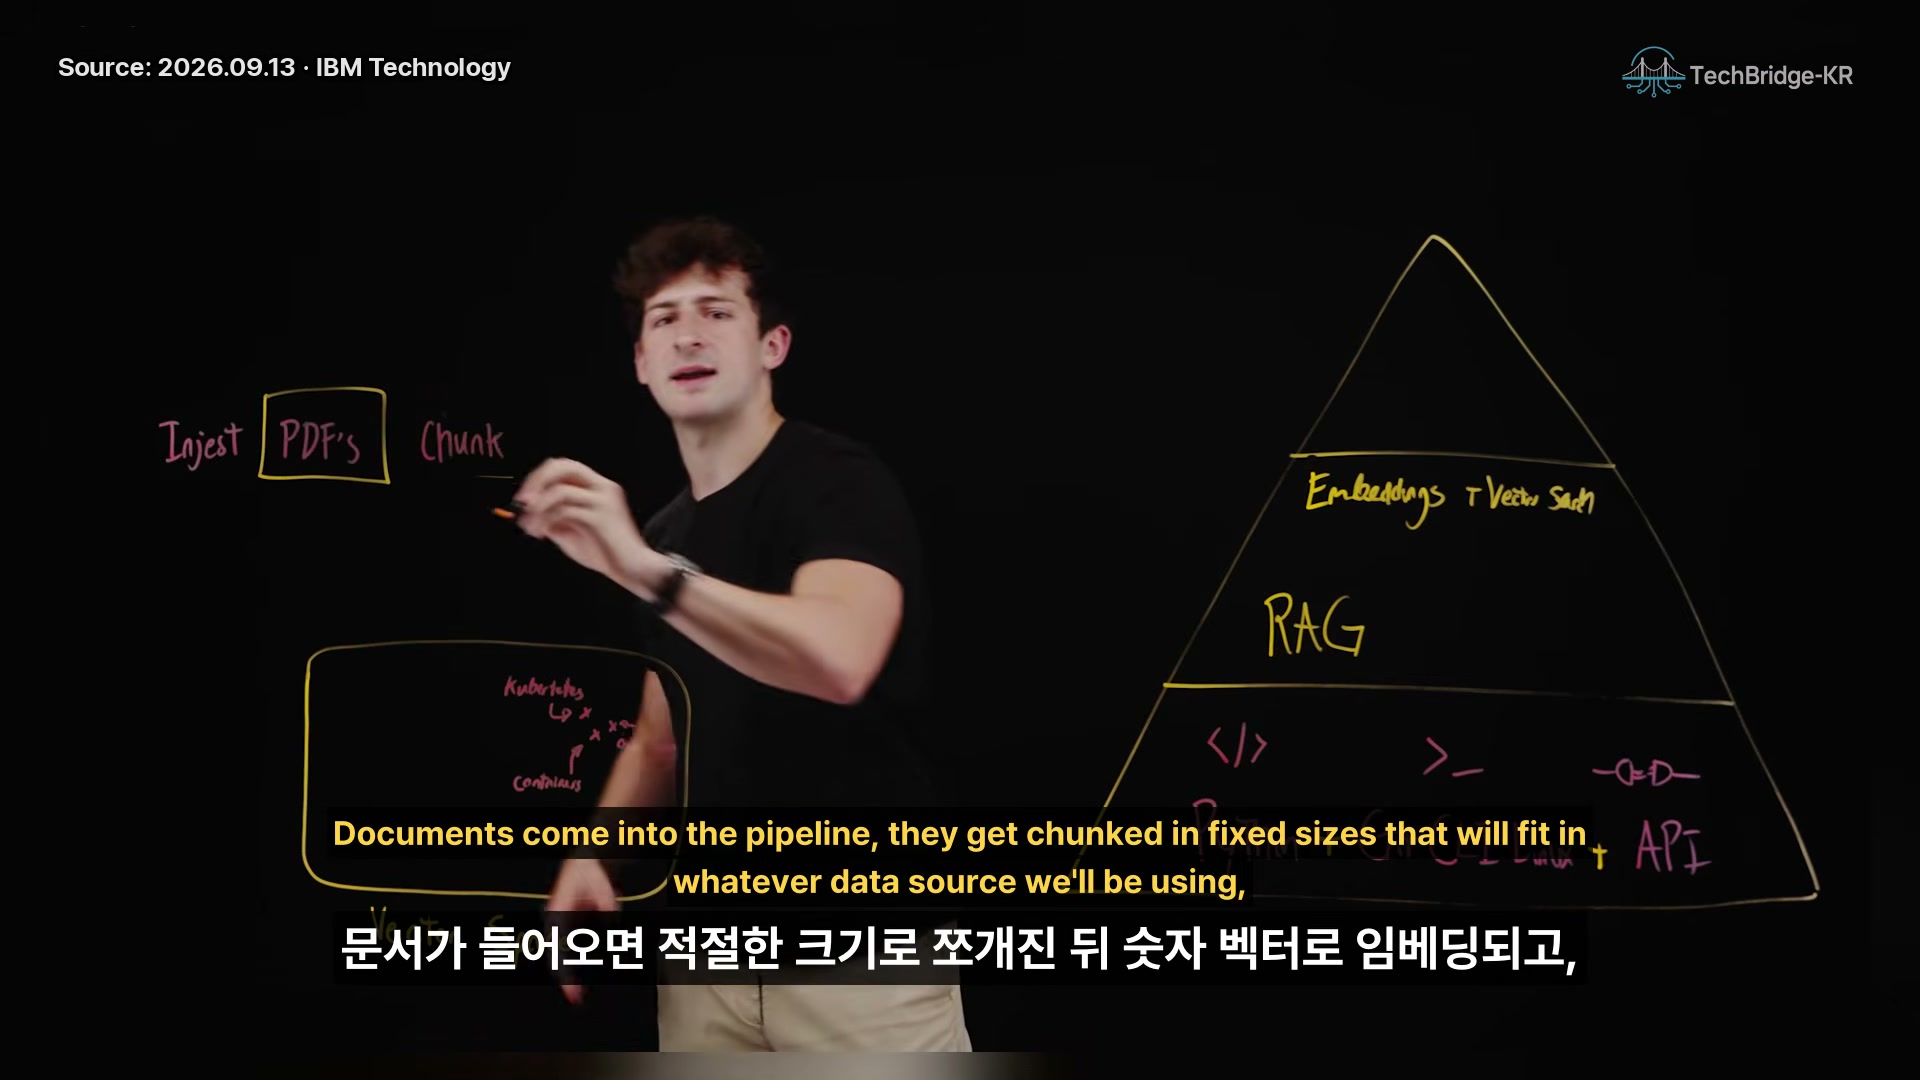
보드의 하이라이트. 윗줄 Ingest: PDF's → Chunk → Embed → Vector DB — 문서가 들어오면 데이터 소스에 맞는 고정 크기로 자르고, 벡터로 임베딩해 DB에 저장한다. 아랫줄 Query: Question → Retrieved INFO → LLM → Answer — 회사 정책·법률 문서 같은 질문이 오면 벡터 소스에서 관련 정보를 검색해 질문과 함께 LLM 컨텍스트에 넣고, 사실에 근거한 자연어 답변을 받는다. 모델이 학습하지 않은 정보에 대한 할루시네이션을 막는 구조다. “AI를 실험하는 거의 모든 회사가 어떤 형태든 RAG를 원한다”는 것이 발표자의 현장 관측. RAG 회의론도 함께 보려면 2026-05-02-rag-is-a-lie-karpathy-llm-wiki를 대조할 것.
[07:10] 8. 에이전트와 도구 — 고정 경로가 아니라 판단 루프다
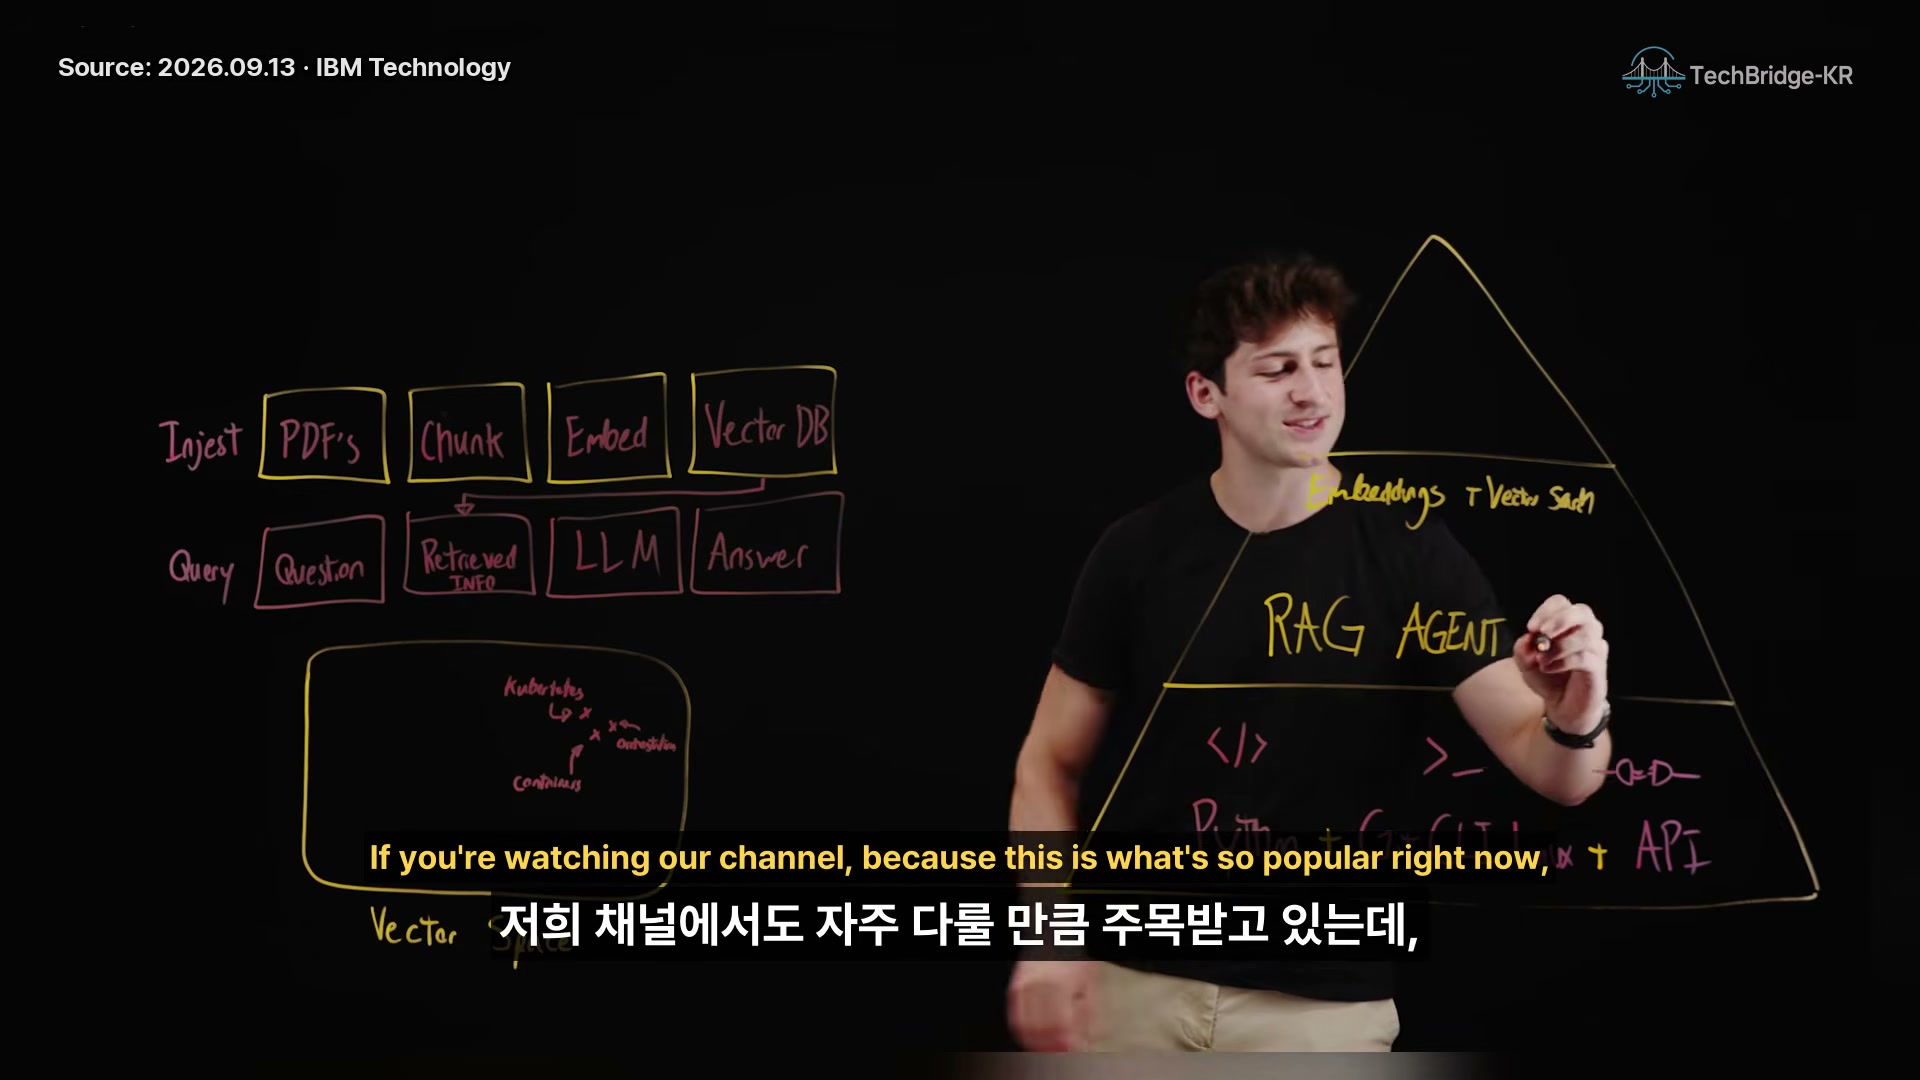
“질문에 답하기”에서 “실제로 일을 하기”로 넘어가게 하는, 지금 가장 수요 높은 응용 스킬이다. 결정적 구분: 워크플로는 A→B→C 미리 정해진 경로를 따르지만, 에이전트는 다음 할 일을 동적으로 정한다 — 필요한 도구를 호출하고 결과를 관찰하며 루프를 돈다. 이 루프를 안정적으로 대규모로 만드는 것이 곧 좋은 AI 엔지니어의 정의다. 채널(Tech Bridge/IBM Technology)에서도 자주 다룰 만큼 주목받는 주제라고 언급한다. moc-ai-agents의 루프·하네스 논의와 연결된다.
[08:00] 9. 3단계 배포 — 노트북을 벗어나 사용자에게
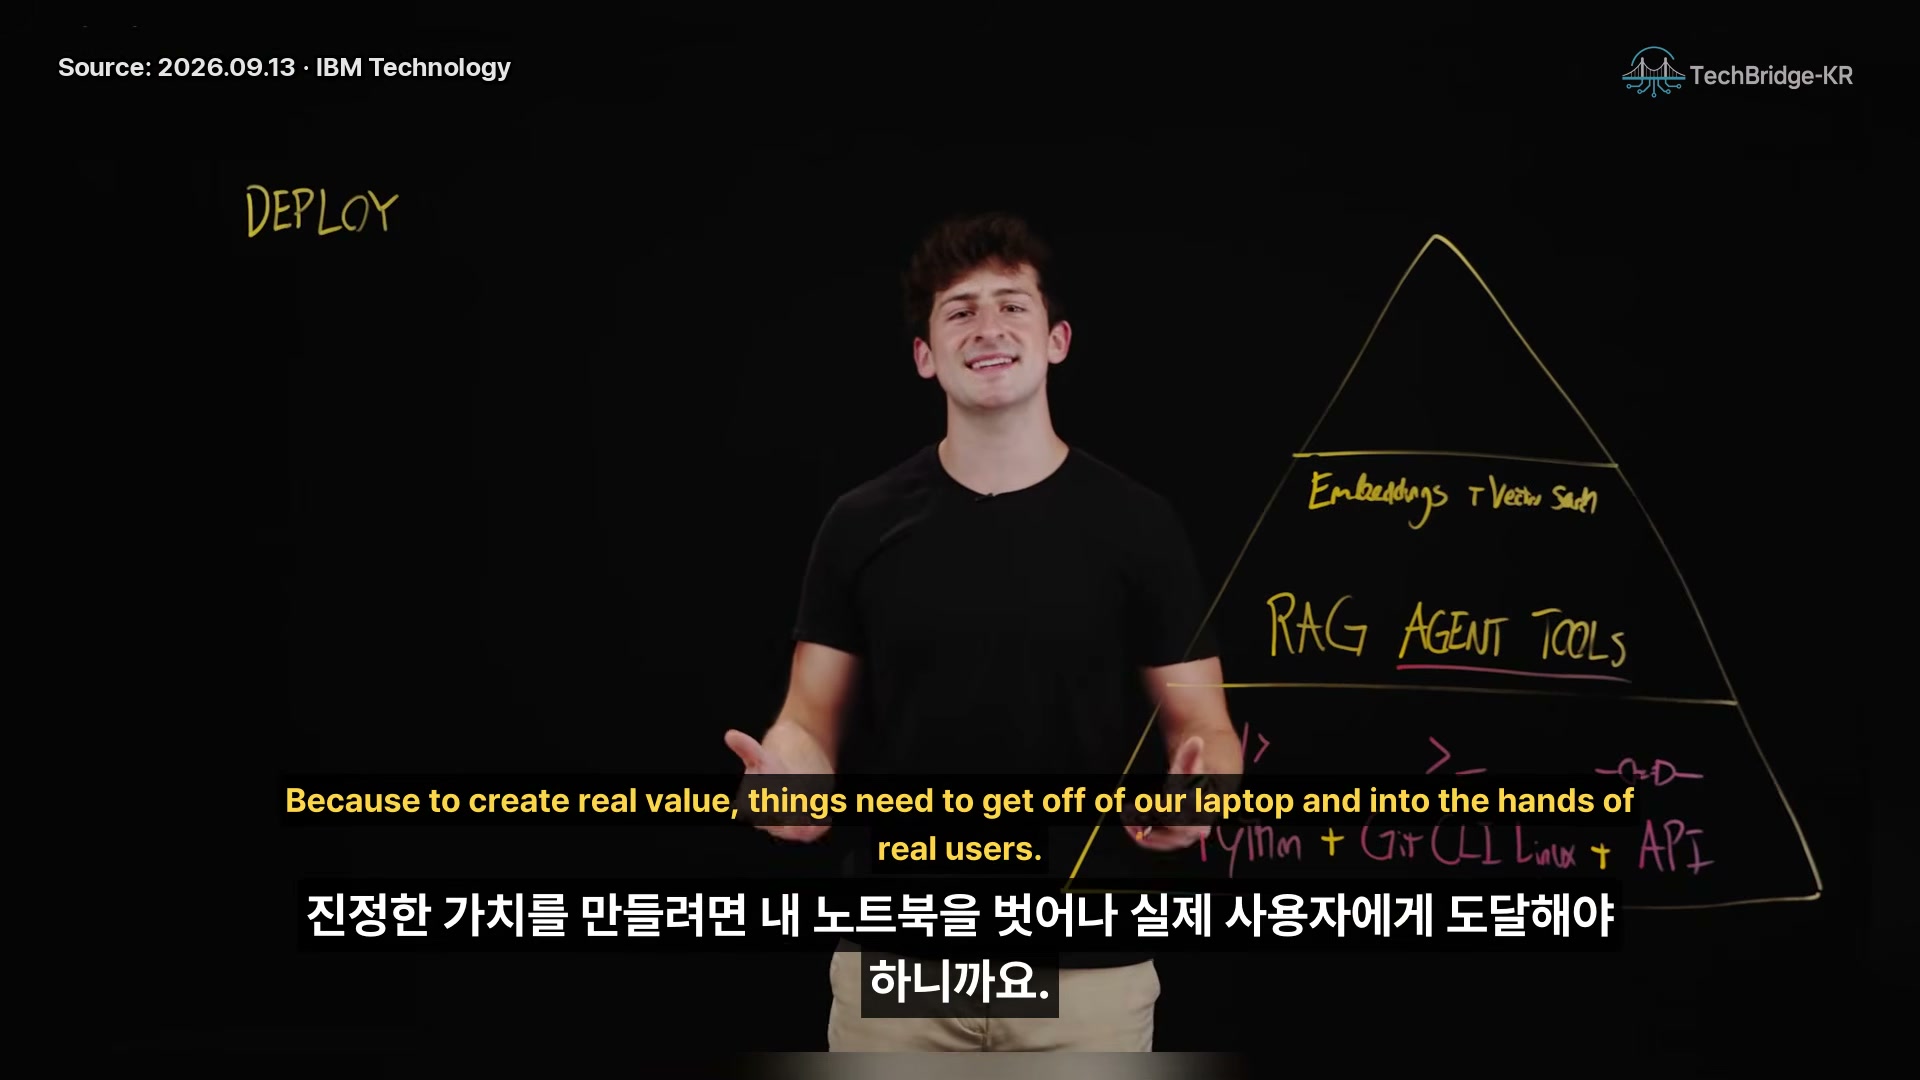
“진짜 가치는 노트북을 벗어나 실제 사용자의 손에 들어가야 생긴다” — 배포와 기본 운영 이해가 마지막 층이다. 필요한 것은 컨테이너화(AI 에이전트, 때로는 모델까지 패키징해 하이브리드 클라우드 여러 환경에 배포 — Kubernetes 포함), 관측가능성(에이전트가 DB를 오가며 내린 최종 결정의 이유를 추적 — AI의 투명성과 신뢰의 기반), 모니터링(토큰 비용 폭증 방지, 보안 등). 베어메탈이든 글로벌 호스티드 서비스든 AI 개발 도구가 이 영역에서도 속도를 크게 올려준다고 덧붙인다.
[09:28] 10. 실전 유스케이스 3종 — 지금 프로덕션에서 쓰이는 곳
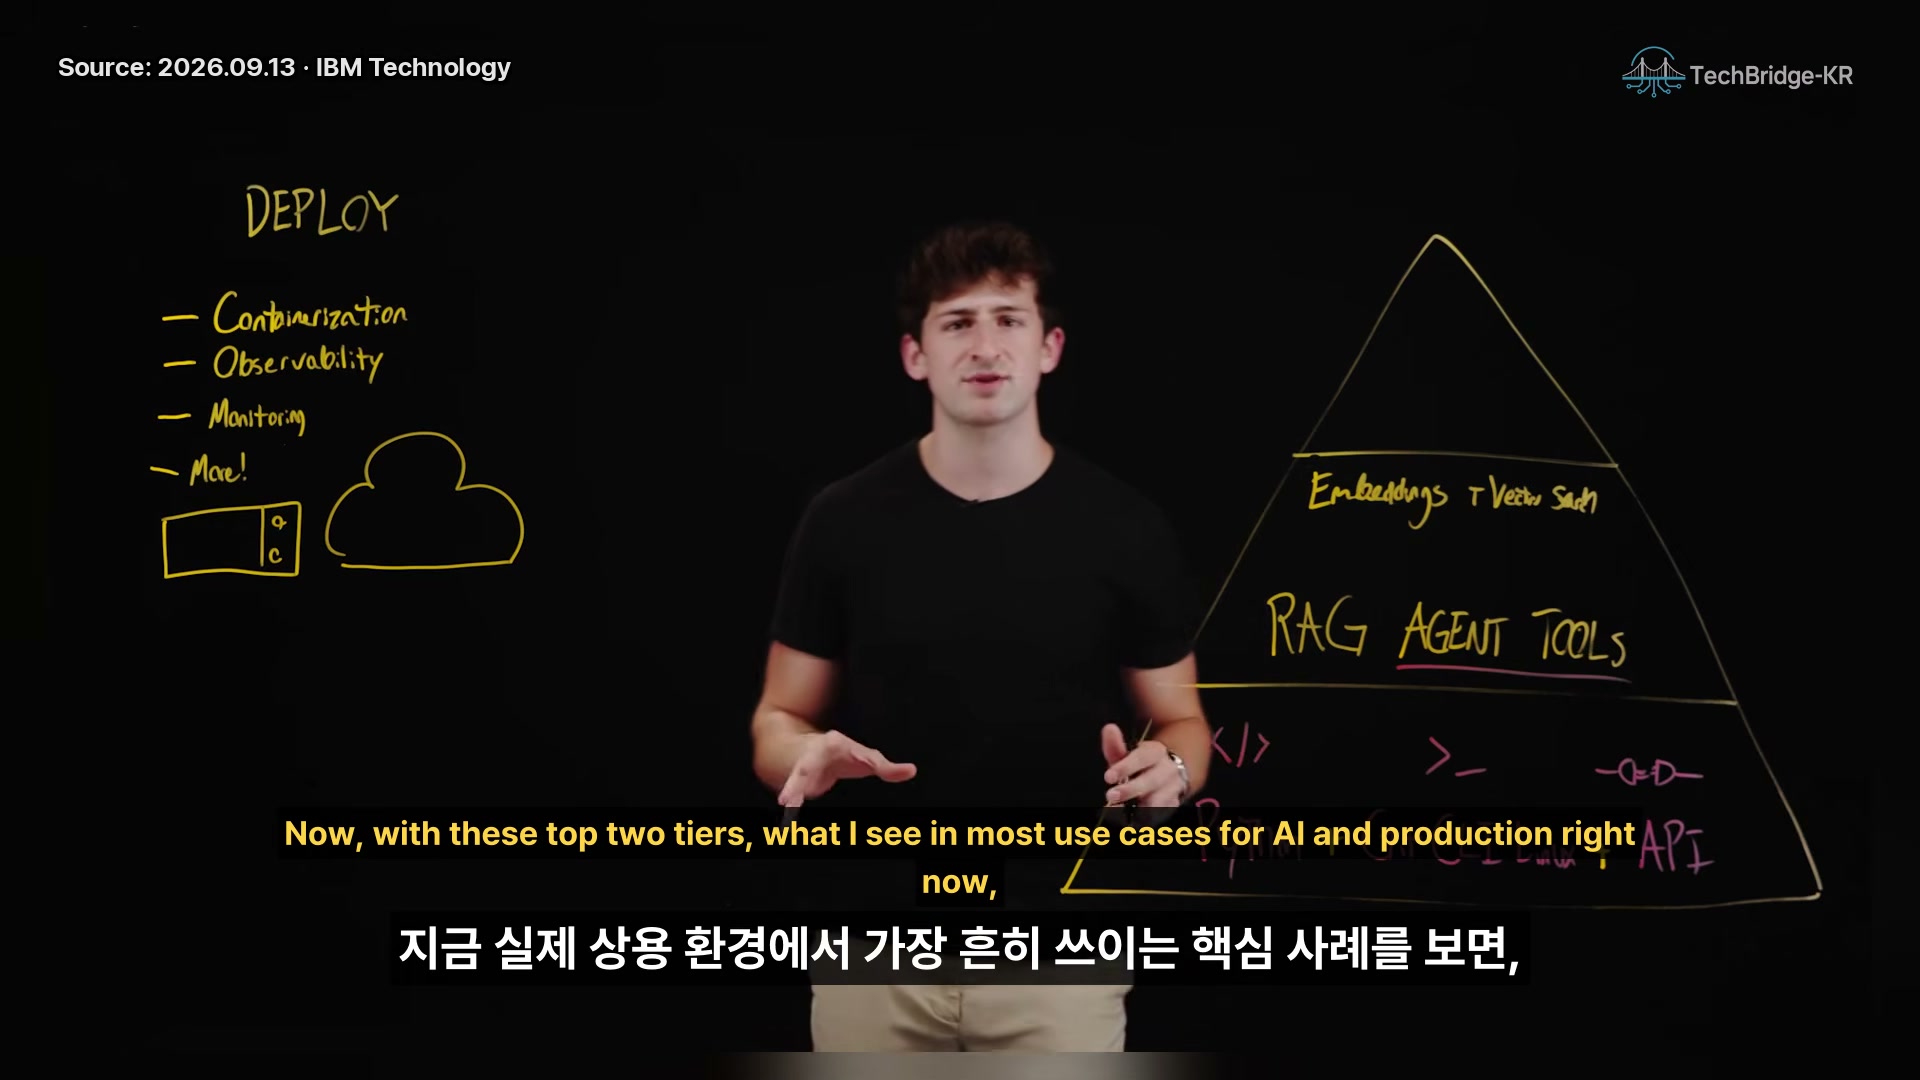
상위 두 층(파운데이션 제외)이 실제로 쓰이는 현장 3종. ① RAG — HR 서비스·병원·온라인 챗봇처럼 사용자와 조직의 질문에 근거 데이터를 돌려주는 지식 시스템. ② 에이전트와 도구 — DB 조회·데이터 시각화까지 해서 기존엔 도메인 전문가만 하던 일을 대신하는 에이전트. ③ 배포된 애플리케이션 지원 — AI 도구로 엔지니어의 코드 출하를 수 주에서 수 시간으로 단축. “자기 관심사와 겹치는 영역에서 직접 만들어보라”는 것이 경력 조언이다 — 만드는 경험이 AI 엔지니어링 경력에 결정적이라는 것.
[10:28] 11. 클로징 — 오늘부터 만들 수 있다
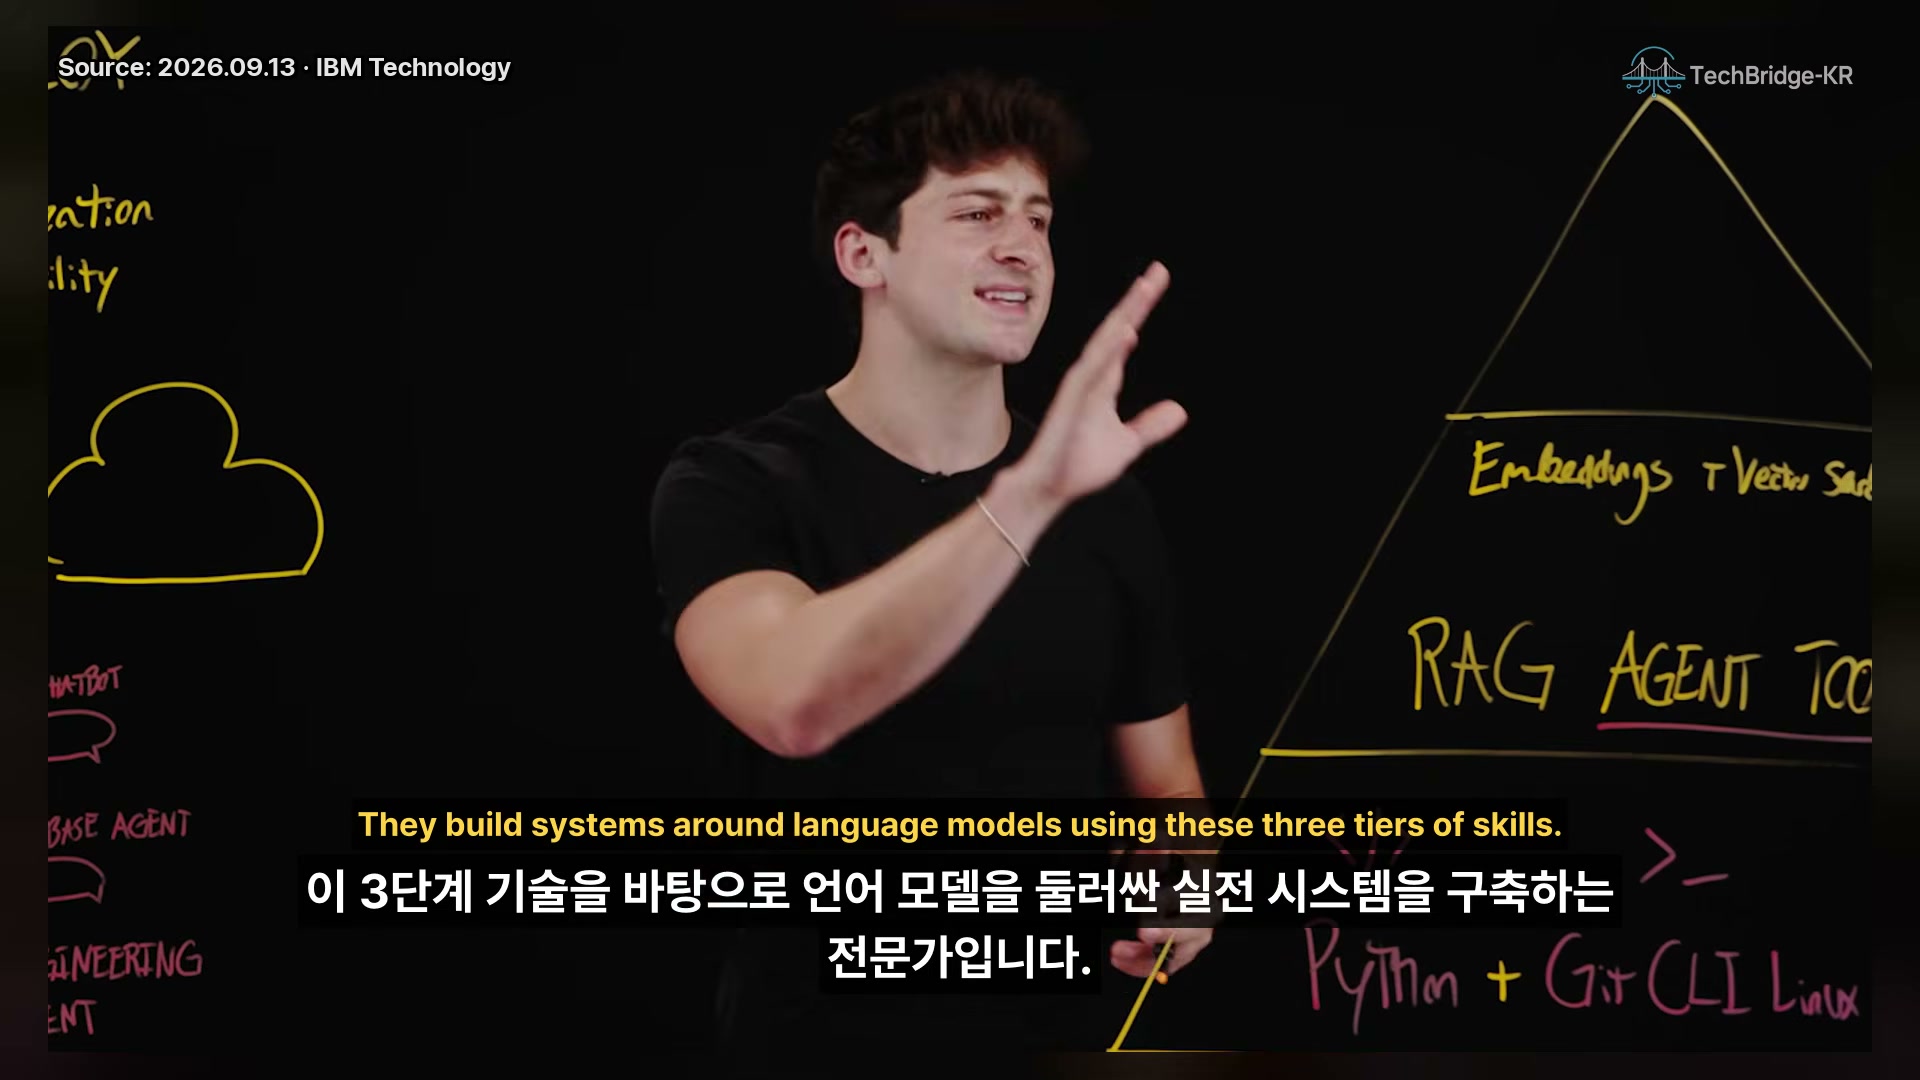
“AI 엔지니어는 3단계 스킬로 언어 모델 주변에 시스템을 만드는 사람”이라는 정의 반복으로 닫는다. “당신도 오늘부터 만들 수 있다”는 말로 끝나며, 영상은 동기 부여형 입문 강연답게 다음 행동(빌드) 촉구 외에 별도 체크리스트는 제시하지 않는다.
부록 — 실전 체크리스트
- Python으로 AI 에이전트가 생성한 코드를 읽고 리뷰할 수 있는지 확인 (Tier 1)
- Git + CLI + Linux 조합으로 작은 프로젝트를 끝까지 공유·배포해보기 (Tier 1)
- 모델 API를 직접 호출해보고 응답·레이트 리밋을 처리하는 스크립트 짜보기 (Tier 1)
- 내 문서 몇 개로 Ingest→Chunk→Embed→Vector DB→Q&A가 도는 최소 RAG 만들어보기 (Tier 2)
- 도구 1~2개를 호출하는 에이전트 루프를 돌려보고 워크플로와 차이 체감하기 (Tier 2)
- 만든 것을 컨테이너로 패키징하고 토큰 비용·호출 로그를 관찰할 수 있게 하기 (Tier 3)
원문 인용 모음
- [00:45] “the code itself isn’t the hard part anymore, but the hard part is judgment”
- [02:19] “if ML researchers are the ones building the engine, then AI engineers are the ones building the car”
- [04:45] “every AI product and solution you’ll eventually build is fundamentally a well structured API call”
- [06:49] “almost every company experimenting with AI wants some version of RAG or retrieval augmented generation”
- [07:34] “an agent can dynamically decide what to do next, so it can call tools that it needs to use, it can observe those results”
- [07:57] “to create real value things need to get off of our laptop and into the hands of real users”
- [10:24] “they build systems around language models using these three tiers of skills and you can start building today too”