출처: AI Frontier Korea EP114 — 도망칠 틈이 없다 길이: 01:34:35 · 채널: AI Frontier Korea (노정석) 녹화: 2026-09-09 · 업로드: 2026-09-12 · 출연: 노정석, 최승준, 박종현 자막: 한국어 자막을 문맥에 맞게 다듬어 정리 원본 자막:
raw/transcripts/2026-09-12-ai-frontier-ep114-no-escape.ko.srt
읽는 법: 이 노트는 한 편의 영상에서 출연자들이 소개하고 해석한 내용을 정리한 것이다. Navier–Stokes 해결 여부, 내부 모델의 구성, 연구 크레디트·학습 데이터 논란, GPT Image 2.5와 Astra의 성능·가격, AlphaGenome Atlas의 규모와 활용 가능성은 영상 시점의 보고 또는 추정이며 여기서 독립 검증하지 않았다. 특히 생명과학 대목은 임상 진단이나 치료 조언이 아니다.
한눈에 보는 요약
- 영상은 수학 연구, 컴퓨터를 쓰는 이미지 에이전트, AI for Science를 하나의 질문으로 묶는다. 모델이 좋아지는 것만이 아니라, 검증 가능한 환경에 더 많은 에이전트와 컴퓨트를 투입하는 방식 자체가 바뀌고 있다는 관점이다.
- 첫 구간에서 출연자들은 영상 시점에 화제가 된 Navier–Stokes 도전 사례를 소개한다. 가설적 형태(ansatz)를 세우고, 여러 그룹이 보조정리와 실패 원인을 공유하며 다시 검증하는 cross-pollination 구조가 핵심으로 제시된다.
- 영상에서 전한 OpenAI 실험의 수치는 약 1만 에이전트, 88시간, Navier–Stokes에만 1,300억 토큰이다. 100억 원대라는 비용 환산도 단순 가정에 따른 계산이며, Clay Mathematics Institute의 공식 해결 선언과는 구분해야 한다.
- 둘째 구간은 GPT Image 2.5의 편집 일관성·streaming·stop-motion 가능성과 Astra의 computer use를 연결한다. 브라우저 예약, 이미지 생성 API 호출, 후보 선택, 자체 수정과 렌더링 반복이 하나의 에이전트 워크플로우가 된다.
- 셋째 구간에서 AlphaGenome Atlas는 유전체 변이별 예측을 미리 계산해 두는 검색면으로 설명된다. 출연자들은 이를 실험을 없애는 도구가 아니라, reference와 variant의 차이를 좁혀 다음 wet-lab 실험을 고르는 도구로 본다.
핵심 한 줄: 도망칠 틈이 없다는 말은 모델 하나의 성능보다, 검증 가능한 문제에 에이전트·도구·데이터를 계속 투입하는 연구 루프가 수학과 생명과학까지 빠르게 번진다는 뜻에 가깝다.
범위와 핵심 용어
이 영상은 세 명의 출연자가 2026년 9월 9일 기준으로 급하게 조사한 뉴스와 직접 사용해 본 사례를 섞어 이야기하는 대담이다. 따라서 공식 발표, 화면에 표시된 데모, 출연자의 개인적 추정, 다른 사람의 SNS 발언이 한 흐름에 함께 등장한다. 아래에서는 영상에서는, 출연자들은, 화면에는이라는 표현으로 그 경계를 남긴다.
- RLVR: 결과의 정답 여부나 조건 충족 여부를 확인할 수 있는 강화학습 환경이라는 설명으로 쓰인다. 이번 사례에서는 수학적 조건과 formalization 검사가 agent의 탐색을 되먹임하는 장치로 소개된다.
- Ansatz: 해가 어떤 꼴일 것이라는 가설적 형태를 먼저 놓고, 그 형태의 변수와 조건을 조정해 가는 수학적 접근으로 설명된다.
- Computer use: 에이전트가 브라우저나 데스크톱 화면을 vision으로 읽고 클릭·입력·탐색하는 사용 방식이다. 영상 속 예약 사례는 결제와 개인정보 위임의 위험도 함께 보여준다.
- AlphaGenome: 영상의 설명상, 긴 DNA sequence를 입력해 세포별 RNA 양·splicing·DNA 접근성 같은 실험 readout을 예측하는 모델이다. AlphaGenome Atlas는 가능한 단일 염기 치환의 예측 결과를 미리 계산해 둔 데이터베이스로 설명된다.
장면별 상세 설명
첫째 구간 - 수학 연구와 대규모 멀티 에이전트
[00:01:45] Euler와 Navier–Stokes를 구분하기
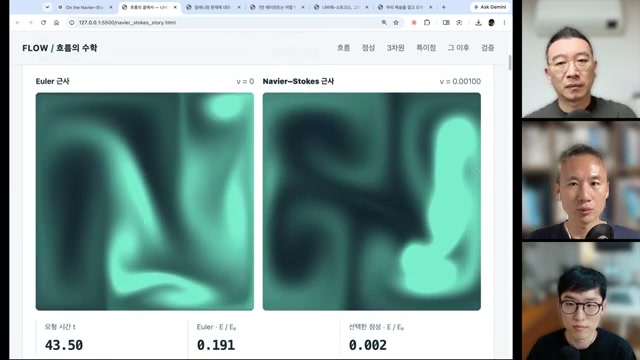
화면은 Euler 근사와 Navier–Stokes 근사를 나란히 놓은 유체 시뮬레이션이다. 출연자들은 Euler 방정식을 점성을 무시하는 경우, Navier–Stokes 방정식을 점성이 있는 유체를 다루는 경우로 설명한다. 이 장면의 화면은 추상적인 방정식 자체보다 두 모델의 시뮬레이션 결과를 비교하는 데 초점을 둔다.
영상에서는 Navier–Stokes가 해석적으로 풀기 어려운 문제이며 2000년에 Clay Mathematics Institute의 Millennium Prize Problems에 포함됐다고 소개한다. 동시에 “풀렸다”는 뉴스가 곧바로 태풍 예측, 자동차·비행기 설계, 난류 시뮬레이션을 바꾼다는 뜻은 아니라고 선을 긋는다. 수학적 정칙성 문제와 이미 공학에서 수치적으로 사용해 온 알고리즘의 실용성은 서로 다른 층위라는 설명이다.
[00:04:55] test-time compute를 늘릴 때 보이는 간격
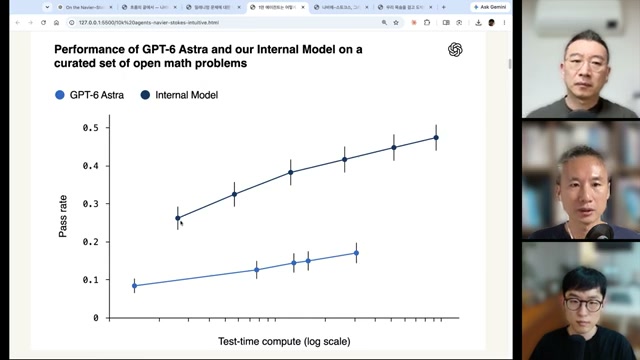
화면에는 Performance of GPT-6 Astra and our Internal Model on a curated set of open math problems라는 제목의 그래프가 보인다. 가로축은 log scale의 test-time compute, 세로축은 pass rate이며 GPT-6 Astra와 Internal Model이 서로 다른 색으로 표시돼 있다. 출연자들은 가로축 한 칸이 10배의 연산량을 의미하므로, 직선처럼 보이는 상승을 선형적인 투자 대비 수익으로 읽으면 안 된다고 설명한다.
그래프에 나타난 내부 모델이 어떤 공개 모델인지, 실제 평가셋과 수치가 어떻게 구성됐는지는 영상에서 검증하지 않는다. 출연자들은 이를 Astra 다음 세대일 가능성이 있는 내부 모델의 사례로 추정할 뿐이다. 여기서 중요한 관찰은 모델의 파라미터 수만이 아니라, 문제를 풀 때 허용하는 test-time compute와 탐색 예산을 별도의 성능 축으로 다룬다는 점이다.
[00:07:20] ansatz와 장애물 제거 루프
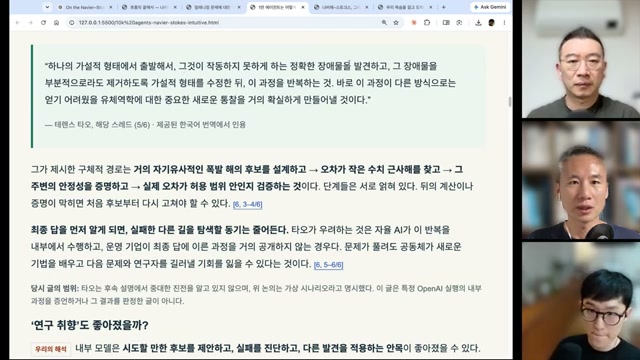
화면의 인용문은 유체역학 문제에 대해 가설적 형태에서 출발하고, 그 형태가 작동하지 못하게 하는 장애물을 찾아내며, 장애물을 부분적으로 제거하도록 가설을 고치는 접근을 설명한다. 출연자들은 이를 ansatz, 즉 해가 어떤 꼴일지 먼저 제안하고 나머지 변수를 맞추는 기법과 연결한다.
이 설명에서 모델의 역할은 정답을 한 번에 내는 계산기가 아니다. 어떤 가설을 세울지, 어느 반례나 막힘이 다음 탐색의 방향을 바꿀 만큼 중요한지 판단하고, 실패한 시도에서 다음 시도로 넘어가는 연구자의 루프를 확장하는 역할에 가깝다. 영상은 이 과정이 Terence Tao가 앞서 상상한 AI 수학 연구 방식과 닮았다고 해석한다.
[00:09:50] Group A와 Group B의 cross-pollination
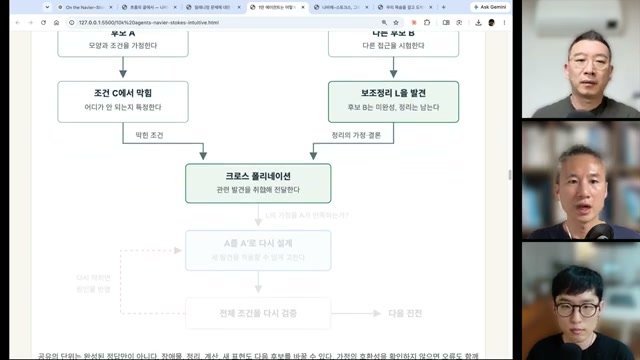
도식은 Group A가 한 ansatz 후보를 만들고 Group B가 다른 접근을 시도한 뒤, 한쪽에서 발견한 보조정리(lemma)를 다른 쪽의 조건에 맞춰 다시 적용하는 흐름을 그린다. 영상에서 말하는 cross-pollination은 그룹 사이의 발견을 취합하고, 가정이 맞는지 확인한 뒤 후보를 조정하는 과정이다.
출연자들의 설명에 따르면 약 1만 개 agent가 모두 하나의 실시간 대화방에서 이야기한 것은 아니다. 여러 그룹이 각자의 탐색을 진행하고 기록을 남기며, 상위 단계에서 관련 발견을 건네받는 구조에 가깝다. 수학적 조건을 다시 검사할 수 있기 때문에 다른 그룹의 lemma를 가져와 후보를 수정하고, 전체 조건을 재검증하는 루프가 가능하다는 것이 RLVR의 의미로 제시된다.
[00:13:55] 1,300억 토큰이라는 비용 환산
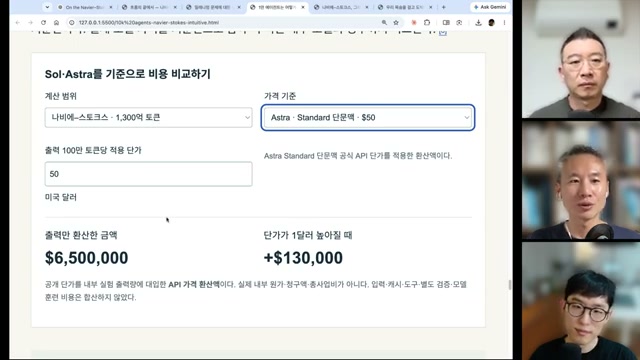
화면의 계산기는 Navier–Stokes에 사용된 양을 1,300억 토큰, Astra Standard의 출력 단가를 100만 토큰당 50달러로 놓고 650만 달러를 표시한다. 영상에서는 long-context 단가를 75달러로 놓으면 더 커지고, 여러 시행착오까지 포함하면 100억 원을 넘을 수 있다고 추정한다.
이 숫자는 영상 속 단순 계산이다. 1,300억 토큰이 모두 과금되는 output token이라고 가정하고, 실제 할인·입력 토큰·내부 compute·실험 실패 비용·환율을 반영하지 않는다. 따라서 “수학 문제 하나의 확정 비용”이 아니라, 검증 가능한 문제에 자본과 추론 예산을 대규모로 투입할 수 있다는 규모감을 보여주는 예시로 읽는 편이 안전하다.
[00:18:35] Anthropic의 선행 연구와 OpenAI의 추격이라는 정황
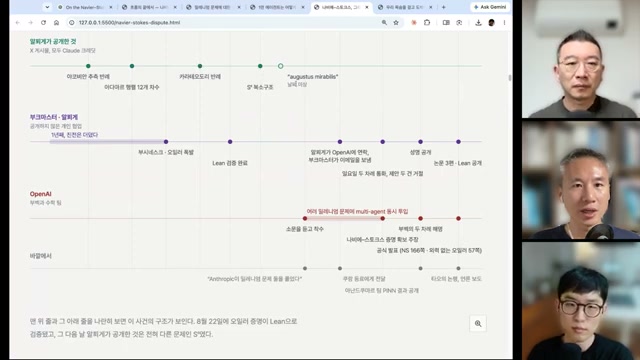
영상은 Anthropic의 수학자 Levent Alpöge와 NYU의 Tristan Buckmaster가 약 1년 동안 AI를 활용해 Euler와 관련된 문제를 탐색해 왔다는 이야기를 소개한다. Alpöge가 8월에 다른 어려운 수학 문제의 진전을 SNS에 올린 것이 소문의 한 출발점이 됐고, OpenAI 쪽 연구자들이 관련 소식을 접한 뒤 내부 모델과 multi-agent를 투입했다는 타임라인으로 설명된다.
다만 이것은 영상 출연자들이 공개된 타임라인과 게시물을 바탕으로 재구성한 정황이다. Anthropic의 공식 연구 프로젝트와 개인 연구, OpenAI가 실제로 어떤 정보를 받아 어떤 경로로 실험을 설계했는지는 이 영상만으로 확정할 수 없다. 크레디트의 문제도 이 구분에서 시작된다.
[00:24:25] 빠른 연구 경쟁과 안전성 우려
화면 캡처는 생략했지만, 이 구간에서 영상은 Jacob Coxon의 퇴사 발언, Evan Hubinger의 동조, OpenAI와 Anthropic이 자기개선형 초지능을 향해 달리며 멈추지 못한다는 우려를 소개한다. 10년 안에 인류가 큰 위험에 처할 가능성을 10% 이상으로 보는 발언도 등장하지만, 이는 특정 연구자의 견해를 영상이 전달한 것이며 이 노트의 확률 판단이 아니다.
출연자들은 수학 문제를 대규모 compute로 푸는 일이 단순한 벤치마크 승리가 아니라, 중앙집권화된 compute와 연구 속도, pacing 합의의 문제를 드러낸다고 연결한다. “더 좋은 모델”이라는 제품 뉴스와 “안전 연구와 거버넌스가 속도를 따라가고 있는가”라는 질문을 분리해서 봐야 한다는 대목이다.
[00:30:55] 암흑의 숲과 연구 공개의 타이밍
영상의 비유는 연구자가 완전히 자기 것으로 만들기 전 결과를 공개하면, 더 많은 자본과 compute를 가진 주체가 그 좌표를 보고 가져갈 수 있다는 “암흑의 숲”이다. 연구 대화를 frontier 모델에 입력했을 때 다음 세대 모델의 학습 데이터나 행동을 자극했는지에 대한 의혹도 이 맥락에서 소개된다.
출연자들은 그 의혹이 결론 난 것은 아니라고 반복한다. 한쪽은 training에 익명화 데이터가 흘러갈 가능성을 완전히 배제할 수 없다고 말하고, 다른 쪽은 그럴 리 없다고 반박하는 식이다. 그러므로 연구용 모델에 핵심 아이디어를 넣을 때는 서비스 약관, 데이터 보존·학습 정책, 대화 trajectory의 공개 범위를 먼저 확인해야 한다는 실무적 경계가 남는다.
둘째 구간 - GPT Image 2.5와 Astra의 컴퓨터 사용
[00:35:25] 편집할수록 무너지던 일관성의 개선
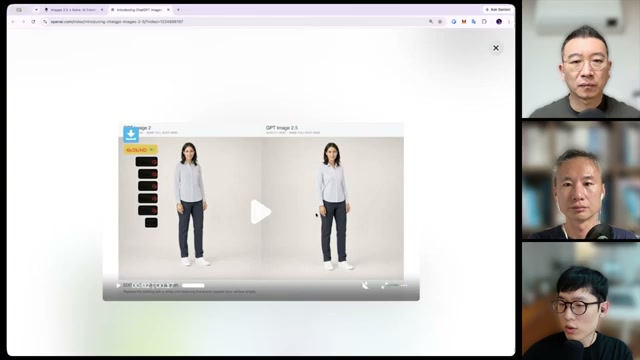
화면은 같은 인물에 옷을 바꿔 입히는 이전 버전과 새 버전의 비교 데모를 보여준다. 출연자들은 이미지 생성에서 가장 고질적인 문제가 여러 번 편집할수록 인물·구도·세부가 조금씩 무너지는 consistency라고 말하며, GPT Image 2.5에서는 그 유지력이 좋아졌다고 평가한다. 이는 영상 속 짧은 테스트와 출연자의 체감이지, 통제된 벤치마크 결과는 아니다.
[00:36:40] streaming과 stop-motion 가능성
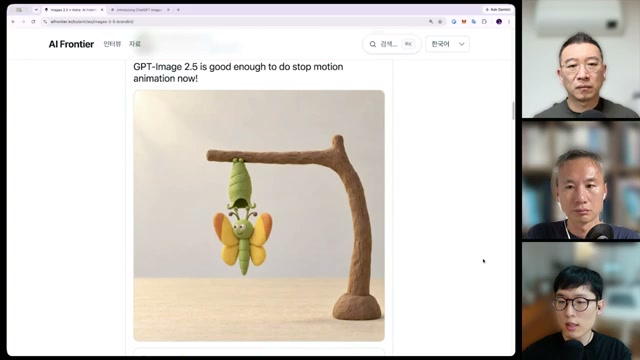
이 장면은 매달린 캐릭터를 이용한 stop-motion 예시다. 배경과 소품은 유지하면서 움직이는 부분만 바뀌어야 하므로, 출연자들은 이 결과가 이미지 consistency의 개선을 직관적으로 보여준다고 본다. GIF, 애니메이션 캐릭터의 표정, CG·VFX 같은 작업으로 확장될 가능성도 함께 언급되지만, “가능성이 보인다”는 수준의 영상 내 해석이다.
또한 이미지 생성 중간 과정이 streaming으로 보인다는 점을 근거로, 단순히 한 번에 diffusion을 수행하는 것보다 중간 상태를 순차적으로 만들고 마지막에 디테일을 다듬는 구조일 수 있다는 추측이 나온다. 이 부분은 연구 구조를 직접 확인한 설명이 아니라 화면 동작에서 유추한 가설이다.
[00:40:55] 썸네일 실험으로 본 품질·가격
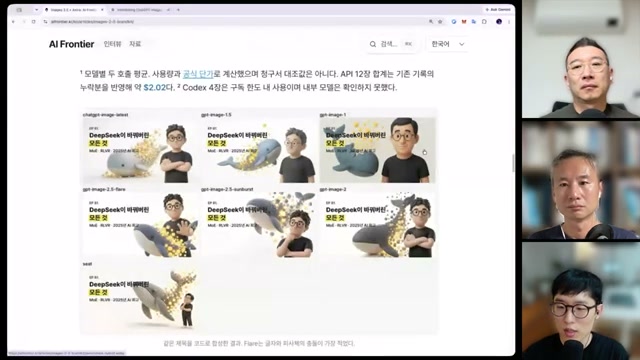
출연자들은 AI Frontier 채널의 기존 썸네일을 참고 이미지로 주고 특정 회차의 썸네일을 만들게 한 뒤, GPT Image 1과 GPT Image 2.5의 결과를 비교한다. 화면에는 같은 스타일을 흉내 낸 여러 결과가 나열되고, 새 모델이 1년 전보다 크게 좋아졌다는 체감이 공유된다. Codex에서 호출한 결과는 API 직접 호출과 다른 스타일로 보였다는 관찰도 있지만, 내부 경로는 확인하지 않는다.
가격에 대해서는 새 모델의 API가 이전보다 싸고, 이미지 한 장이 체감상 약 100원 수준이라는 대화가 나온다. Sunburst와 Flare라는 빠른 버전·표준 버전의 이름과 구독 사용량도 소개되지만, 모두 영상 시점의 출연자 경험과 추정이다. 사업에 적용할 때는 해상도·품질·입력 이미지·재시도 횟수별 실제 단가를 따로 측정해야 한다.
[00:43:55] Astra가 브라우저에서 출장 준비를 맡다
영상 속 Astra 사용기는 단순한 검색이 아니라 지도·호텔·기차·식당 페이지를 직접 돌아다니며 선택하는 computer use 사례로 제시된다. 노정석은 출장 준비를 Astra에 맡기고, 이탈리아어 페이지의 가격과 조건을 읽어 더 나은 동선을 선택하게 했으며, 호텔·레스토랑 예약과 현지 가이드에게 보낼 메시지까지 처리했다고 말한다. 작업은 약 8시간 동안 간헐적으로 진행됐고, 사람이 결정을 내려야 하는 부분은 보류된 상태로 옆에서 확인했다고 설명한다.
결제 번호를 직접 입력한 부분과 Astra가 수행을 거부한 부분이 있었다는 점이 중요하다. 이 사례는 “모든 것을 완전히 자율화했다”는 증명이 아니라, 브라우저 조작 능력이 좋아져도 결제·개인정보·예약 취소처럼 되돌리기 어려운 단계에는 승인과 상한이 필요하다는 사용기다. 실제 숙소와 교통편의 적절성은 출연자가 현장에서 확인하겠다고 했고, 이 노트도 결과를 재검증하지 않는다.
[00:47:58] 이미지 API를 도구로 붙인 이미지 에이전트
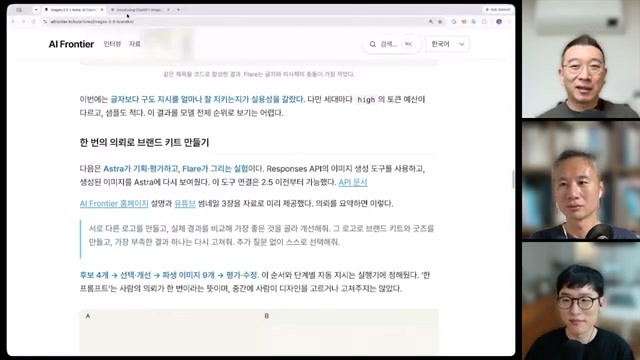
다음 실험에서는 Astra에게 ChatGPT Images를 하나의 도구로 주고, AI Frontier Korea 로고 후보를 여러 개 만들게 한다. Astra가 후보를 눈으로 비교해 하나를 고른 뒤, 색상 팔레트·글꼴·섬유 같은 브랜드 요소를 정하고 티셔츠·모자·스티커·키링·키캡 목업으로 확장하는 흐름이다. 화면은 “한 번의 의뢰로 브랜드 키트 만들기”라는 식의 작업 단위를 보여준다.
출연자들이 확인한 한계는 느낌의 일관성과 픽셀 수준의 동일성은 다르다는 것이다. 로고의 간격과 형태가 조금씩 바뀌고, 굿즈마다 마크가 변형되거나 번지는 문제가 남았다. Astra가 결과를 보고 다시 만들도록 하는 self-refine 반복을 걸면 좋아질 수 있지만, 어떤 세부가 틀렸는지 정확히 판별하는 눈까지 인간과 같다는 뜻은 아니다.
영상에서는 이 이미지 후보 생성·검토·재호출에 API 기준 약 2달러가 들었을 것이라고 추정한다. 구독 환경에서는 별도 API 비용을 그대로 지불하지 않았다고 덧붙인다. 이 역시 실제 청구서나 재현 가능한 실험표가 아니라 출연자의 체감 계산이며, 이미지 에이전트의 경제성은 목표 품질과 반복 횟수까지 포함해 평가해야 한다.
[00:51:20] Mitsuba·Blender와 시각적 hill climbing
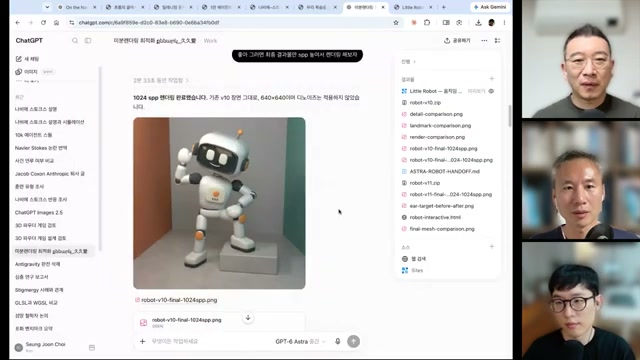
Astra가 Python과 Mitsuba 같은 미분 가능한 renderer를 설치하고, Blender도 실행할 수 있었다는 사용기가 이어진다. 출연자는 이미지를 보고 차이를 비교하게 한 뒤 다시 렌더링하도록 반복하면, 완벽하지는 않아도 목표 이미지 쪽으로 가까워지는 hill climbing 비슷한 최적화가 나타났다고 말한다.
이 실험에서 Chat mode는 가상 CPU 4개, Work mode는 8개를 주고 GPU는 제공하지 않았으며 저장공간은 100GB라는 설명도 나온다. 수치는 영상 시점의 사용 환경에 대한 보고이므로 현재 상품 사양으로 일반화하지 않는다. 핵심은 이미지 모델 하나의 출력보다, 화면을 보고 차이를 판단하고 렌더러를 다시 호출하는 agent loop가 품질을 끌어올리는 방식이다.
셋째 구간 - AlphaGenome Atlas와 AI for Science
[00:53:55] AlphaFold를 발판으로 AlphaGenome 이해하기
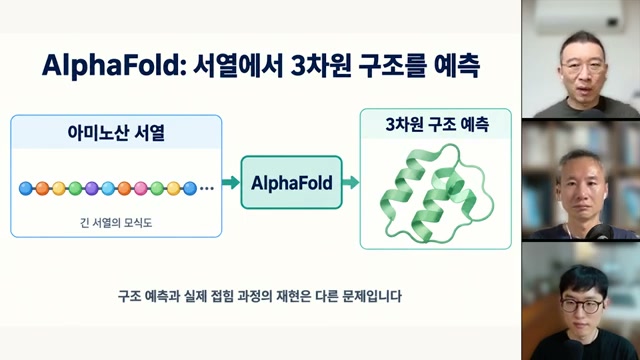
출연자들은 먼저 AlphaFold를 아미노산 서열을 입력해 단백질의 3차원 구조를 예측하는 시스템으로 설명한다. PDB에 쌓인 실험 구조를 학습의 기반으로 삼고, 이후 훨씬 많은 단백질의 구조를 미리 계산해 데이터베이스로 제공했다는 비유가 AlphaGenome Atlas를 이해하는 발판으로 사용된다. 영상의 설명을 쉽게 풀면 “매번 계산하지 말고, 자주 묻는 공간을 미리 계산해 검색하게 한다”는 패턴이다.
AlphaFold가 구조 예측을 빠르게 해 항체·리간드 후보를 in silico에서 고르는 데 도움을 줄 수 있다는 제약 연구의 변화도 언급된다. 다만 예측된 구조나 결합 가능성이 곧 치료제의 효능·안전성·임상 성공을 의미하지는 않는다. 여기서도 실험을 대신한다기보다 실험할 후보의 우선순위를 좁히는 역할로 이해해야 한다.
[00:58:40] 유전체의 98%를 프로그램 영역으로 보는 비유
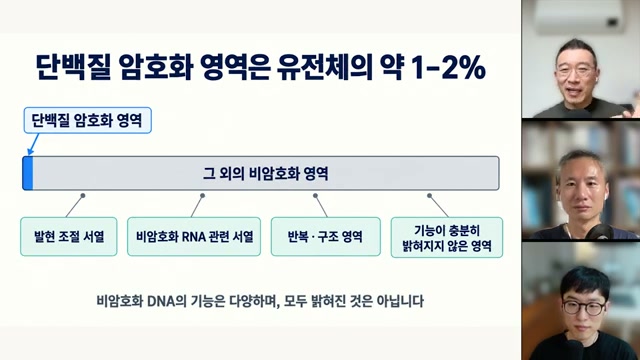
화면은 인간 유전체에서 단백질을 부호화하는 영역이 약 1-2%이고 나머지 비암호화 영역이 훨씬 크다는 설명을 도식화한다. 출연자들은 나머지 영역에도 enhancer·promoter·intron과 같은 조절 요소가 있고, 세포에 따라 DNA가 히스톤에 감기거나 풀리는 정도와 유전자 발현이 달라진다고 설명한다.
이 설명은 생명과학에 익숙하지 않은 시청자를 위한 축약된 비유다. “비암호화”가 “아무 기능도 없음”을 뜻하지 않으며, 특정 염기 서열의 기능을 세포 종류와 실험 조건별로 확인해야 한다는 점이 중요하다. AlphaGenome은 바로 이처럼 DNA sequence와 세포별 실험 readout 사이의 패턴을 학습하는 모델로 소개된다.
[01:01:50] partial reprogramming은 별도의 생명과학 맥락
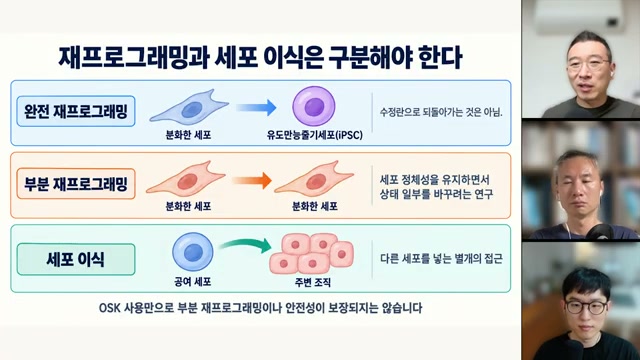
이 장면은 AlphaGenome 자체의 기능이라기보다, 유전자 발현과 세포 정체성을 설명하다가 이어진 longevity 이야기다. OSKM 같은 Yamanaka factor로 체세포를 pluripotent stem cell에 가깝게 되돌리는 완전 재프로그래밍, 정체성을 유지한 채 일부 노화 신호만 되돌리려는 partial reprogramming, 주변 조직에 줄기세포를 이식하는 접근을 구분한다.
출연자들은 완전히 되돌리면 세포가 원래 위치와 무관하게 분화해 종양 위험이 생길 수 있으므로, 부분적·제어된 스위치가 필요하다고 말한다. 이 대목은 AlphaGenome의 변이 예측과 직접 연결되는 기능 설명이 아니라, 유전자 조절과 생물학적 상태가 얼마나 복잡한지 보여주는 배경 설명으로 분리해서 읽는다.
[01:07:45] SNP와 개인별 차이
영상은 인간 유전체의 약 31억 염기쌍 중 사람 사이에서 다른 위치가 소수 존재하며, 한 자리의 A/G/T/C 차이가 SNP라고 설명한다. 출연자들은 사람마다 수백만 개 정도가 다를 수 있고, 단백질 코딩 영역뿐 아니라 조절 영역의 한 글자 차이도 발현과 질병 위험에 영향을 줄 수 있다고 말한다. 여기서 “영향을 줄 수 있다”와 “질병을 확정한다”는 전혀 다른 표현이다.
AlphaGenome Atlas라는 이름과 90억 개 변이를 미리 조회할 수 있다는 소개는 영상에서 전한 뉴스다. 화면에는 Google DeepMind AlphaGenome Atlas의 시각적 소개가 보이지만, 이 노트는 해당 서비스의 실제 API·범위·정확도를 독립적으로 확인하지 않았다.
[01:10:40] 왜 HLA에는 long-read가 유리한가
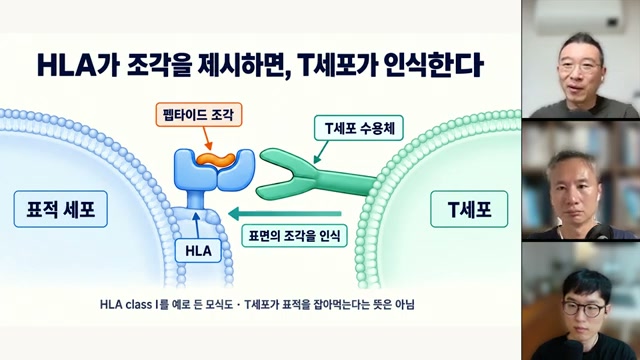
출연자들은 6번 염색체의 HLA를 세포 안에서 만들어진 단백질 조각을 표면에 제시하고 T세포가 자기 세포인지 확인하는 면역 표지자로 설명한다. HLA 영역은 사람과 집단 사이의 변이가 크고 비슷한 서열이 많아 짧게 잘라 읽는 short-read만으로는 어느 위치에서 왔는지 매핑하기 어렵다는 설명이 이어진다.
긴 조각을 읽는 long-read는 주변 문맥을 더 많이 보존하므로 이런 반복·고변이 영역의 위치를 구분하는 데 도움이 된다는 것이 영상의 요지다. 시퀀싱 비용과 정확도, 실제 분석 파이프라인은 플랫폼마다 다르므로 화면의 가격 예시를 일반적인 견적으로 사용하지 않는다.
[01:13:05] AlphaGenome의 입력과 11종 readout
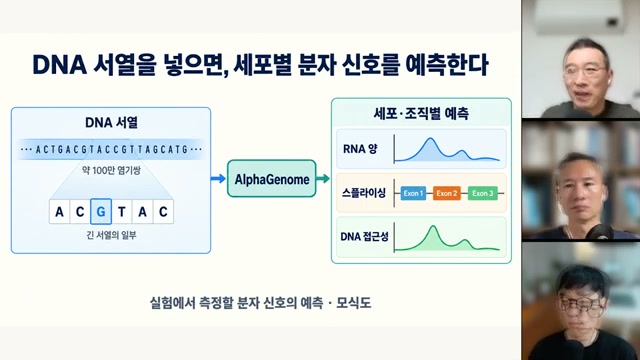
화면은 약 100만 base pair의 DNA sequence를 AlphaGenome에 넣고, 세포·조직별 RNA 양, splicing, DNA 접근성 같은 분자 신호를 예측하는 흐름을 그린다. 영상에서는 ENCODE 같은 프로젝트와 지난 20년의 실험 데이터가 세포별 학습 예시를 제공했다고 설명한다. 실제 목록에서는 11종의 실험 결과를 예측한다고 소개하지만, 이 노트는 그 11개 항목의 공식 정의를 따로 검증하지 않았다.
핵심 사용법은 정상 reference sequence와 변이가 들어간 sequence를 각각 통과시킨 뒤 output vector의 차이를 보는 것이다. 예를 들어 어떤 SNP가 간세포에서 RNA 발현이나 chromatin 접근성에 큰 차이를 만들면, 그 위치가 어떤 후속 실험을 할 가치가 있는 후보인지 추정할 수 있다. 결과 차이는 실험 가설을 세우는 신호이지, 질병 진단이나 원인 확정이 아니다.
[01:18:20] Atlas는 가능한 치환을 미리 계산한 데이터베이스
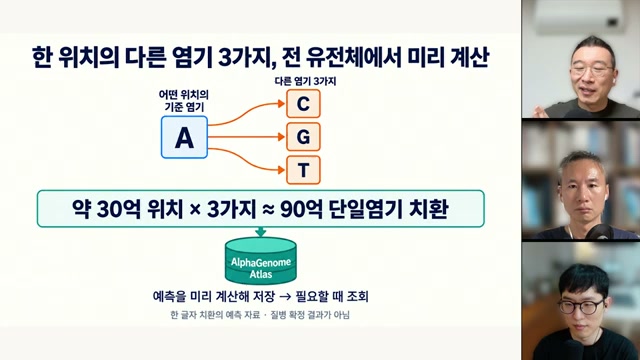
도식은 reference에서 한 위치가 A일 때 나머지 C·G·T로 바꾼 세 경우의 예측을 미리 계산하는 모습을 보여준다. 영상의 산술은 약 30억 위치에 위치별 세 치환을 적용해 약 90억 개의 단일 염기 치환 결과를 만들고, 이를 Atlas에 저장해 필요할 때 조회한다는 것이다.
이 구조는 AlphaFold Protein Structure Database와의 비유로 설명된다. 모델을 매번 직접 돌리는 대신, Google이 가능한 변이 공간을 선계산해 두면 연구자는 자신의 변이 위치를 찾아 reference와 variant의 차이를 빠르게 볼 수 있다는 뜻이다. 데이터베이스에 들어 있는 값의 정확도와 미리 계산하지 않은 조합의 일반화는 여전히 별도 검증 과제다.
[01:23:25] 예측 차이를 희귀질환·암 연구 후보로 쓰기
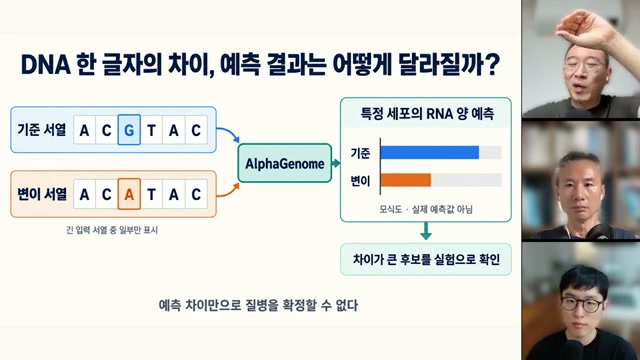
화면은 기준 서열과 한 글자가 다른 변이 서열을 각각 AlphaGenome에 넣고, 특정 세포의 RNA 양 예측이 어떻게 달라지는지 비교한다. 출연자들은 이 차이를 이용해 희귀 유전병에서 promoter·조절 영역·발현 과정의 어느 지점이 어긋났는지에 대한 후보를 좁힐 수 있다고 설명한다.
암에서도 단백질 코딩 영역이 아닌 조절 영역의 변이가 여러 단백질 발현을 바꿀 수 있으므로, 정상 세포와 암세포의 차이를 찾아 표적 후보를 고르는 데 도움이 될 수 있다는 전망이 나온다. 보편적 신약 개발과 개인 맞춤 치료 모두에 연결될 수 있다는 말은 영상의 가능성 제시다. 예측 차이만으로 환자의 치료법이나 질병 확률을 확정할 수 없고, 실제 실험·임상 검증이 필요하다.
[01:27:50] Evo 2와 AlphaGenome은 다른 종류의 생물학 모델
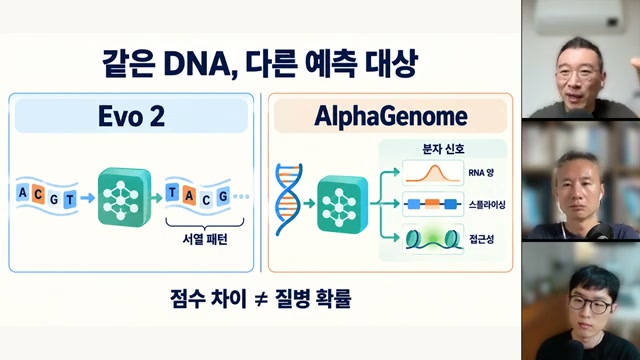
마지막 비교에서 영상은 AlphaGenome을 실험 결과를 label로 삼는 supervised 모델, Evo 2를 여러 종의 염기서열을 대규모로 학습해 다음 sequence를 예측하는 Transformer 계열 모델로 구분한다. Evo 2에서는 reference와 variant를 각각 넣고 다음 토큰의 log probability 차이를 비교해 변이가 자연스러운지 위험 신호가 있는지 가늠할 수 있다는 설명이 나온다.
화면 하단의 “점수 차이 != 질병 확률”이라는 문구가 이 구분을 잘 요약한다. sequence 모델의 점수가 낮다고 어떤 질병이 생긴다는 뜻은 아니며, 어떤 생물학적 기능이 영향을 받는지도 별도 실험 없이는 알 수 없다. AlphaGenome이 세포별 분자 readout을 예측하는 것과 Evo 2가 sequence 패턴을 학습하는 것은 겹치는 부분이 있어도 동일한 문제를 푸는 방식은 아니다.
[01:29:43-01:34:10] wet lab과 computation의 피드백 루프
마무리에서 출연자들은 생명과학이 단순히 실험 결과를 외우는 분야에서 DNA sequence, 발현, 단백질, 표현형 사이의 연결을 계산하는 분야로 이동하고 있다고 말한다. 실험으로 얻은 데이터로 supervised 모델을 만들고, 모델이 다음 실험의 우선순위를 정하며, 그 실험이 다시 데이터셋을 보강하는 순환이다. 데이터가 충분히 쌓이면 self-supervised 학습이 일반적인 규칙을 발견할 가능성도 제시된다.
동시에 cybersecurity와 biosecurity가 함께 거론되는 이유도 남는다. 생물학적 지식과 실험 설계가 더 빠르게 계산 가능해지면 질병·수명 연장 연구가 빨라질 수 있지만, 악용 가능성과 안전한 접근 통제도 같이 커진다. 영상의 결론은 “생물학도 AI를 얻어 신나기 시작한 단계일 수 있지만, 속도가 어디까지 갈지는 아직 모른다”에 가깝다.
부록 - 실전 체크리스트
- 빠른 연구 뉴스는 공식 검증·논문·커뮤니티 추정·출연자 해석을 서로 다른 레이어로 기록한다.
- multi-agent 연구 루프에는 그룹별 기록, cross-pollination 규칙, 전체 조건 재검증, 중단 기준을 명시한다.
- computer use에게 브라우저를 맡길 때 결제·개인정보·예약 취소에는 승인 단계와 금액·사이트 범위의 상한을 둔다.
- 이미지 에이전트는 한 번의 생성보다 후보 생성 -> 시각 비교 -> 수정 -> 재검증의 반복으로 설계하고, 로고·텍스트·간격의 드리프트를 사람이 확인한다.
- AlphaGenome 같은 예측 도구의 output 차이는 실험 후보를 고르는 데 쓰되, 진단·질병 확률·치료 결론으로 과장하지 않는다.
- AI for Science를 따라갈 때는 모델 이름만 좇지 말고, 해당 도메인의 데이터 생성 방식과 verifier가 무엇인지 함께 공부한다.
원문 인용 모음
- [00:00:10] “그래도 이 Navier–Stokes 방정식을 풀었다, 정확하게 풀었다는 게 어떤 의미인지에 대해서는 저도 정확히 알지 못합니다만,”
- [00:07:16] “가설적 형태에서 출발해서 그것이 작동하지 못하게 하는 장애물을 발견하고, 장애물을 부분적으로라도 제거하도록 가설을 수정한 뒤 이 과정을 반복하는 것.”
- [00:09:45] “cross-pollination이라는 용어가 나오거든요. 타화수분이라고 하죠.”
- [00:13:03] “그런데 1만 에이전트가 88시간 만에 그걸 해냈다고 하는데,”
- [00:16:37] “그래서 아직 Clay 쪽에서 이걸 풀렸다고 공식 발표하지는 않았어요.”
- [00:34:05] “computer use를 엄청 잘한다. 컴퓨터 화면을 vision으로 보면서 control하는 걸 잘한다.”
- [00:47:29] “알아서 N개를 만든 다음에 그중에서 Astra가 직접 보고 고르도록”
- [00:51:38] “최적화, 그러니까 hill climbing을 하더라고요.”
- [00:52:59] “AlphaGenome Atlas라는 걸 Google이 발표해서, 90억 개의 모든 변이에 대해서 이제 조회만 해보면 됩니다.”
- [01:18:18] “전부 연산해서 그 연산 결과값들을 데이터베이스에 다 만들어 놓은 거예요.”
- [01:29:43] “genomics라는 것 자체도 점점 데이터베이스가 쌓이면서 computation 쪽으로 넘어오면서 이쪽 발전이 계속 일어나고 있는 거죠.”