출처: AI Frontier Korea EP 112 — AI 반도체 안에서 일어나는 일들: KV Cache부터 Roofline까지 길이: 1:44:10 · 채널: AI Frontier Korea (노정석) 공개: 2026-09-01 · 녹화: 2026-08-30 · 출연: 이진원(HyperAccel CTO), 노정석, 최승준, 박종현 자막: 한국어 수동 자막을 문맥에 맞게 다듬어 정리 원본 자막:
raw/transcripts/2026-09-03-ai-frontier-ep112-kv-cache-roofline.ko.srt주의: 가격·성능·용량·손익분기점 수치는 발표자가 설명하거나 슬라이드에 제시한 특정 사례값이다. 이 노트에서 독립적으로 재현하거나 최신 사양으로 검증한 수치가 아니다.
한눈에 보는 요약
- AI 모델의 발전이 빨라질수록 실제 가치가 포착되는 지점은 모델 자체보다 전력·데이터센터·반도체·서빙 인프라와 애플리케이션 레이어로 이동한다.
- LLM 추론은 입력을 한꺼번에 처리하는 prefill과 토큰을 하나씩 생성하는 decode로 나뉘며, 둘은 서로 다른 병목을 가진다.
- 긴 컨텍스트와 에이전트 세션에서는 모델 가중치보다 KV cache가 더 큰 메모리·전송 비용을 만들 수 있다.
- Roofline의 arithmetic intensity는 같은 데이터를 얼마나 재사용하는지 보여준다. decode는 메모리 대역폭에, 큰 prefill은 연산 처리량에 가까워진다.
- GQA·MQA·MLA, prefix caching, KV 양자화·오프로딩, PagedAttention, chunked prefill, speculative decoding은 서로 다른 위치에서 이 병목을 완화한다.
- vLLM·SGLang 같은 서빙 프레임워크의 핵심은 단순한 모델 실행이 아니라 요청을 iteration 단위로 스케줄링하고 GPU·메모리·네트워크를 함께 관리하는 것이다.
- 결론적으로 하나의 GPU가 모든 일을 맡기보다, Rubin·GPU·Groq LPU 같은 하드웨어를 작업 특성에 맞춰 분업하는 인퍼런스 전용 반도체 시대가 열린다.
핵심 한 줄: LLM 인퍼런스의 경쟁력은 모델의 FLOPs만이 아니라 KV cache를 포함한 데이터를 얼마나 적게, 빠르게, 알맞은 메모리와 칩 사이에서 움직이느냐로 결정된다.
장면별 상세 설명
[00:32] 1. 강연의 질문 — 모델 아래에서 무슨 일이 일어나는가
강연은 모델의 성능만 보는 관점에서 벗어나 Inference Engineering과 AI 반도체의 내부로 내려간다. 노정석은 데이터센터·칩·모델·애플리케이션이라는 레이어 중 모델의 발전이 너무 빨라지면서, 돈을 벌어내는 가치 포착 지점이 아래쪽 인프라와 위쪽 애플리케이션으로 이동하고 있다고 설명한다.
따라서 질문은 “어떤 모델이 더 똑똑한가?”에 그치지 않는다. 전력을 넣어 칩을 구성하고, 그 위에서 학습된 모델을 서비스할 때 어떤 연산과 데이터 이동이 일어나는지, 그리고 인퍼런스 벤치마크의 숫자를 어떻게 읽어야 하는지가 이 강연의 출발점이다.
[05:35] 2. 매출은 10배, 컴퓨트는 3배 — 수요가 만드는 인프라 압력
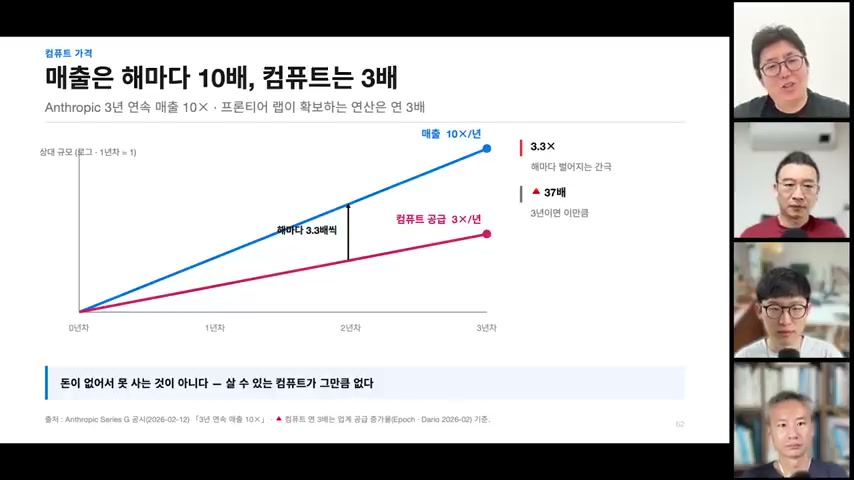
슬라이드는 Anthropic의 3년 연속 매출 10배 성장과 프론티어 랩의 컴퓨트 연 3배 증가를 나란히 놓는다. 출연자는 이 간극을 메우는 방법으로 인퍼런스 마진을 높이거나, 전체 GPU 중 서비스에 쓰는 비중을 늘리거나, 더 효율적인 하드웨어와 아키텍처를 만드는 방식을 든다.
발표자의 논리는 모델 사용량이 줄어들 것이라는 가정과 반대 방향이다. 모델이 업무에 깊이 들어갈수록 요청과 생성 토큰이 늘고, 데이터센터를 짓고 전력을 연결하는 시간도 병목이 된다. 이 때문에 인퍼런스는 연구실의 부속 기능이 아니라 매출과 자본 회수를 좌우하는 산업 시스템이 된다.
[09:30] 3. HyperAccel Bertha — FLOPS보다 tokens/$와 tokens/Watt
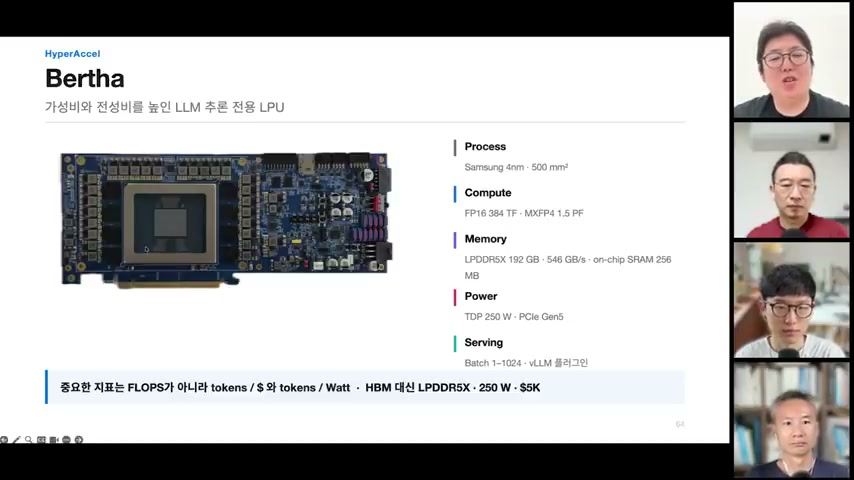
HyperAccel의 Bertha는 “가성비와 전성비를 높인 LLM 추론 전용 LPU”의 사례로 소개된다. 슬라이드에는 Samsung 4nm·500mm², FP16 384 TF와 MXFP4 1.5 PF, LPDDR5X 192GB·546GB/s, 온칩 SRAM 256MB, TDP 250W·PCIe Gen5, batch 1~1024와 vLLM 플러그인이 적혀 있다. 발표자가 강조하는 지표는 최고 FLOPS가 아니라 tokens/$와 tokens/Watt다.
HBM을 쓰는 범용 GPU만이 답은 아니다. 대역폭이 낮아도 모든 애플리케이션이 최고 속도를 필요로 하지는 않으므로, 약 5천 달러 수준의 칩과 큰 메모리 용량으로 비용 효율을 높이는 시장이 있다는 주장이다. 다만 이 가격·성능·전력 수치는 영상 속 제품 설명과 사례값으로 남긴다.
[15:08] 4. LLM 추론은 두 단계 — Prefill과 Decode
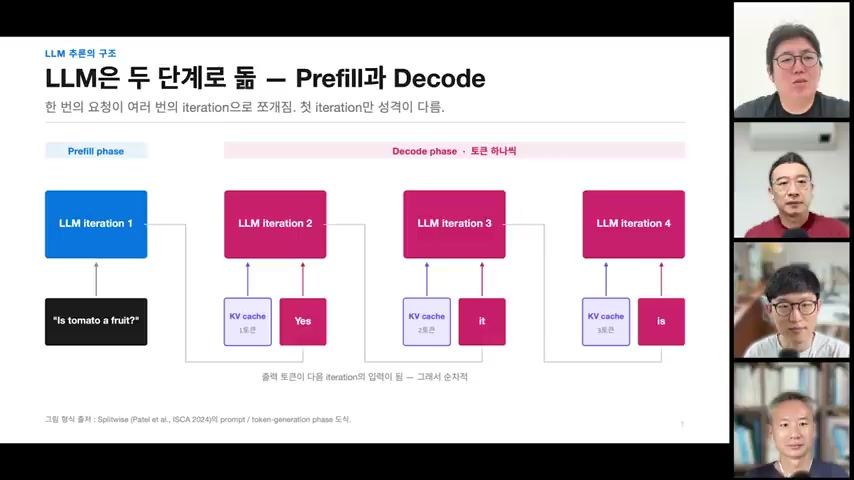
사용자가 “Is tomato a fruit?”라고 입력하면 모델은 먼저 입력 토큰 전체를 한 번에 처리해 첫 출력인 “Yes”를 만든다. 이 단계가 prefill이다. 그 뒤에는 “Yes”를 다시 입력으로 넣어 “it”, “is”처럼 다음 토큰을 하나씩 생성하고 EOS에서 멈춘다. 이 반복 구간이 decode다.
Prefill은 긴 입력을 병렬로 처리할 수 있어 연산량을 크게 태우는 쪽에 가깝고, decode는 한 번에 한 토큰을 만들면서 가중치와 이전 상태를 반복해 읽는다. 에이전트처럼 시스템 프롬프트·도구 설명·이전 대화가 길어지는 사용 사례에서는 두 단계의 차이와 KV cache 비용이 더 커진다.
[20:50] 5. 입력은 3차원, decode 출력은 한 토큰
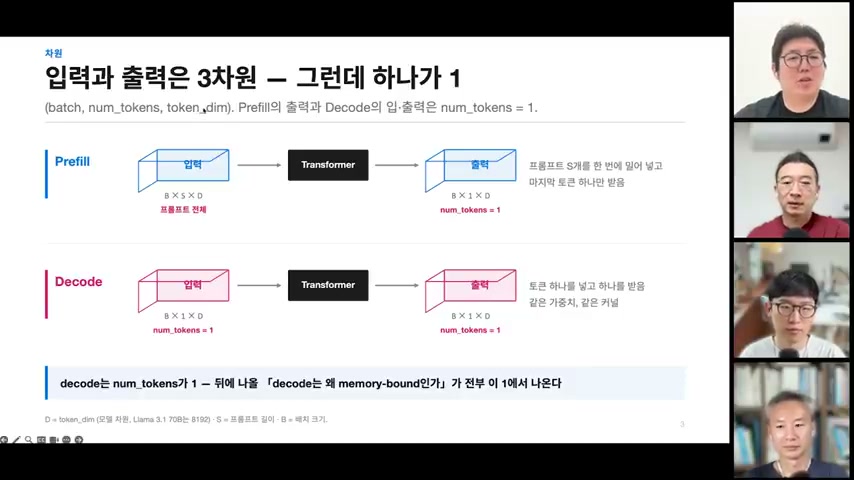
슬라이드는 입력을 (batch, num_tokens, token_dim)의 3차원으로, prefill의 출력은 num_tokens = 1인 형태로, decode는 입력과 출력 모두 한 토큰인 형태로 설명한다. 즉 prefill에서는 여러 사용자의 여러 토큰을 한꺼번에 Transformer에 넣지만, decode에서는 사용자별로 한 토큰씩 다음 토큰을 받는다.
이 차원이 중요한 이유는 같은 Transformer라도 어느 축을 묶어 계산하느냐에 따라 메모리 재사용량과 병목이 달라지기 때문이다. 토큰 ID가 임베딩 벡터가 된 뒤 Query·Key·Value를 만들고, attention과 FFN을 통과해 다음 토큰의 확률을 계산한다. 이 노트는 각 행렬의 세부 구현보다, 이후의 캐시·배치·Roofline 논의를 따라가는 데 필요한 구조만 남긴다.
[27:20] 6. KV cache — 매번 다시 계산하지 않기 위한 상태
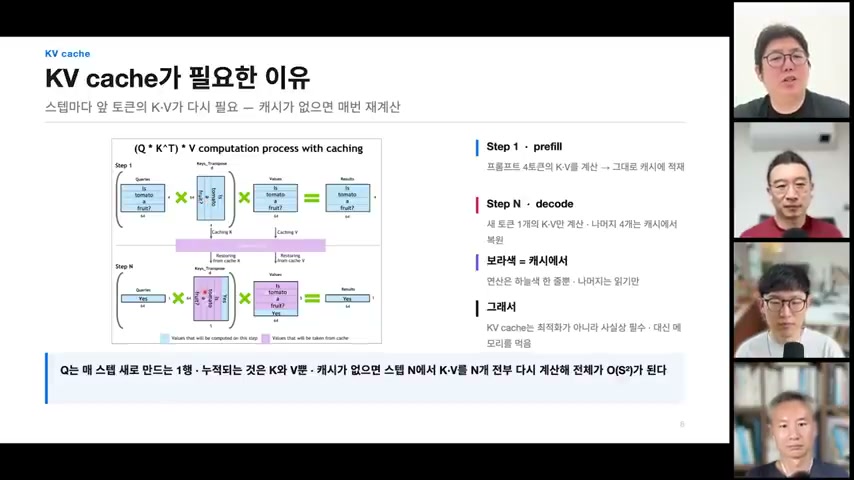
Attention은 Query와 Key를 곱하고 softmax를 거친 뒤 Value와 곱한다. 새 토큰이 추가될 때 이전 토큰의 Key·Value까지 매번 다시 계산하면, 길이가 늘어날수록 같은 작업을 반복하게 된다. 그래서 이미 처리한 토큰의 K와 V를 저장해 다음 decode에서 재사용한다. 이것이 KV cache다.
슬라이드의 요지는 “KV cache는 최적화라기보다 사실상 필수”라는 것이다. 새로 계산하는 것은 한 행이지만, 캐시가 없다면 스텝 N에서 1행부터 N행까지 다시 계산하는 비용이 누적되어 전체 복잡도가 커진다. 캐시는 속도를 높이는 대신 GPU 메모리·CPU 메모리·스토리지·네트워크에 상태를 보관하고 옮겨야 하는 새로운 비용을 만든다.
[32:20] 7. KV 용량을 줄이는 네 갈래
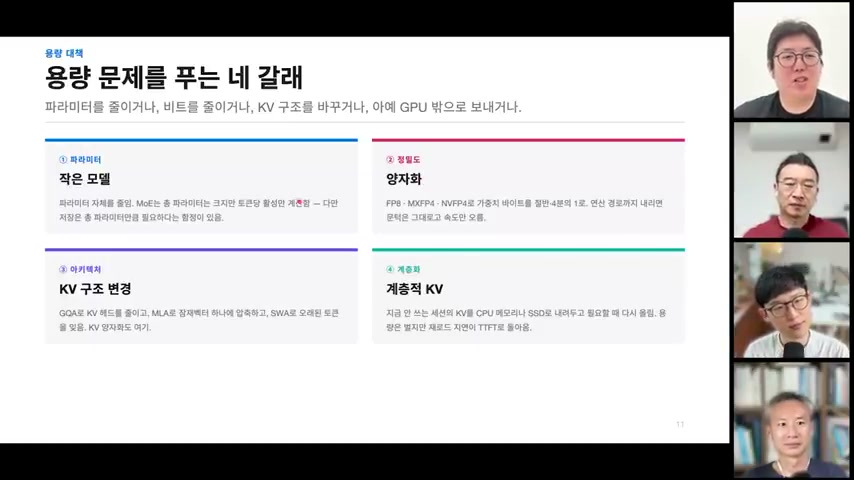
발표자는 KV가 커지는 문제를 네 가지 방향으로 나눈다. 작은 모델을 사용해 파라미터와 상태 자체를 줄이기, 양자화로 비트 수를 줄이기, KV 구조 변경으로 저장해야 할 Key·Value의 양을 줄이기, 그리고 KV를 GPU 밖의 CPU 메모리나 SSD 등으로 보내는 계층적 KV다.
어떤 선택이 항상 우월한 것은 아니다. 양자화는 메모리 사용량과 읽기 비용을 줄이지만 정확도·지연시간·지원 연산의 제약을 가져올 수 있고, 오프로딩은 GPU 메모리를 아끼는 대신 전송 지연을 감수해야 한다. 이후의 GQA·MQA·MLA와 KV 양자화, PagedAttention은 이 네 갈래를 더 구체화한 사례다.
[36:30] 8. xPU 성능을 정하는 두 축 — Compute와 I/O Memory
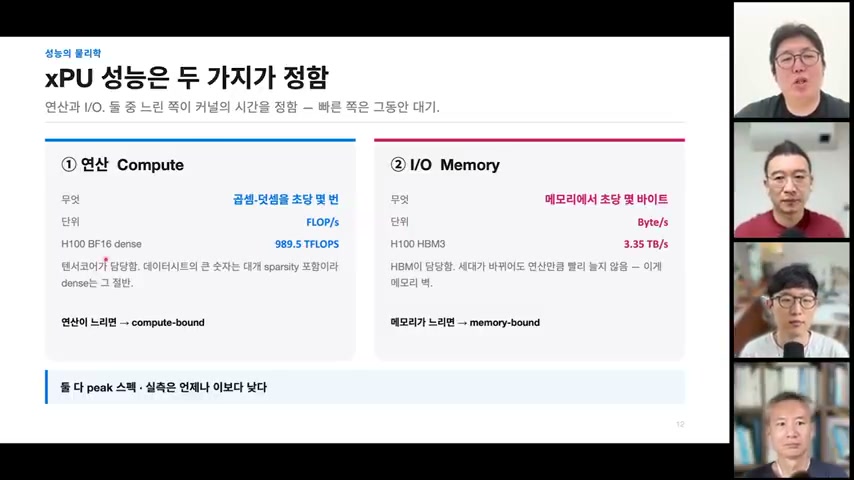
어떤 xPU의 성능은 단순하게 연산을 얼마나 빨리 하는가와 메모리에서 데이터를 얼마나 빨리 공급하는가로 결정된다. 슬라이드는 H100 BF16의 989.5 TFLOPS와 HBM3의 3.35 TB/s를 예로 들며, 앞의 축이 느리면 compute-bound, 뒤의 축이 느리면 memory-bound라고 구분한다.
실제 하드웨어는 데이터를 읽으면서 동시에 이전 데이터를 연산한다. 그래서 한 번의 덧셈을 순서대로 읽고 계산하는 그림만으로는 부족하다. AI는 같은 연산을 대량 병렬로 수행하므로, 피크 스펙보다 특정 모델·배치·메모리 접근 패턴에서 어느 축이 먼저 포화되는지를 봐야 한다.
[41:05] 9. Roofline — 연산 천장과 메모리 천장
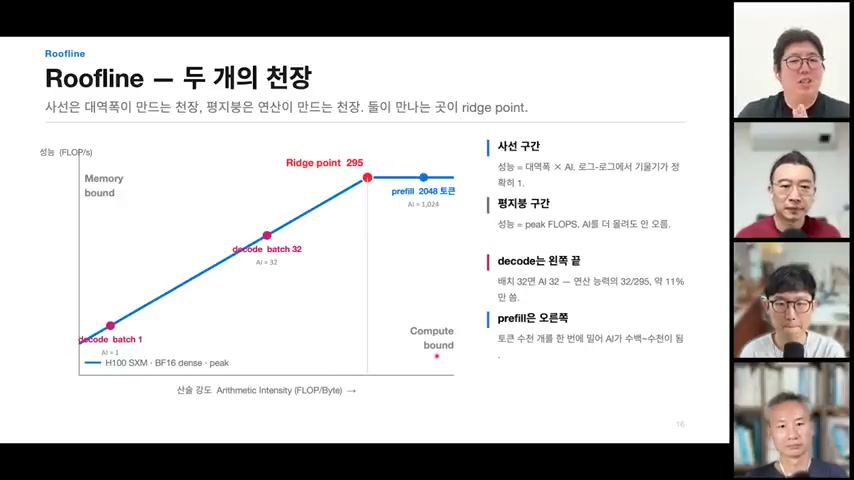
Roofline 그래프의 가로축은 Arithmetic Intensity, 즉 메모리에서 읽은 바이트당 수행한 연산량이고 세로축은 성능이다. 낮은 산술 강도에서는 메모리 대역폭이 만든 사선 천장을 따라가고, 충분히 높은 산술 강도에서는 하드웨어의 peak FLOPS가 만든 수평 천장에 닿는다. 두 선이 만나는 점이 ridge point다.
슬라이드의 H100 예시에서는 ridge point가 295로 표시된다. decode batch 1은 arithmetic intensity가 1에 가까워 왼쪽 memory-bound 영역에 있고, batch 32는 32까지 올라가며, 2,048토큰 prefill은 약 1,024로 compute-bound 영역에 가까워진다. 같은 GPU에서도 prefill과 decode의 위치가 다르므로 둘을 같은 지표로만 평가하면 안 된다.
[45:30] 10. Attention의 산술 강도를 높이는 세 갈래
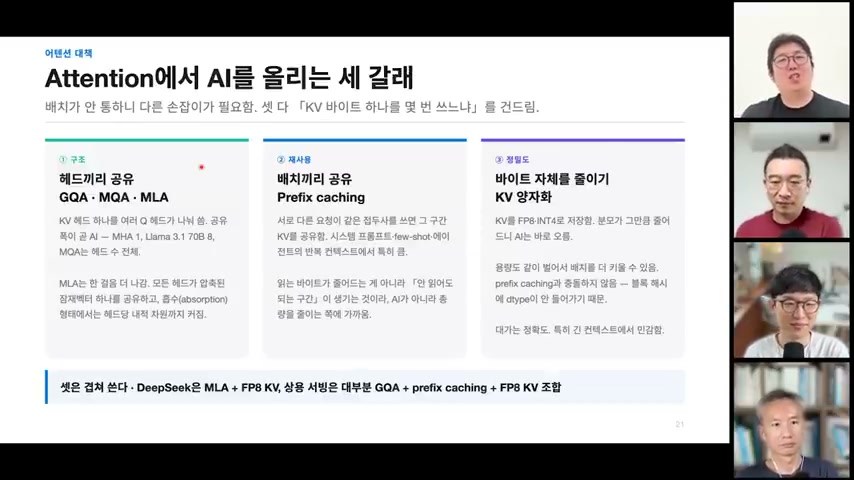
Attention은 사용자마다 자신의 KV를 읽어야 하므로, 단순히 여러 사용자의 Query를 묶는 것만으로는 KV 재사용을 무한히 늘릴 수 없다. 이를 개선하는 첫 번째 갈래가 GQA·MQA·MLA다. 여러 Query head가 하나의 Key·Value를 공유하면 같은 KV를 더 많이 재사용할 수 있고, MLA는 KV 표현 자체를 압축한다.
두 번째는 반복되는 system prompt나 hidden prompt의 KV를 미리 계산해 공유하는 prefix caching이다. 세 번째는 FP8 등으로 KV의 비트 수를 줄이는 KV 양자화다. 슬라이드는 DeepSeek의 MLA+FP8 KV, 상용 서빙의 GQA+prefix caching+FP8 KV를 조합 예로 제시한다. 정확도와 컨텍스트 민감도는 별도의 검증 대상이다.
[50:30] 11. 배치가 커지면 KV가 가중치를 추월한다
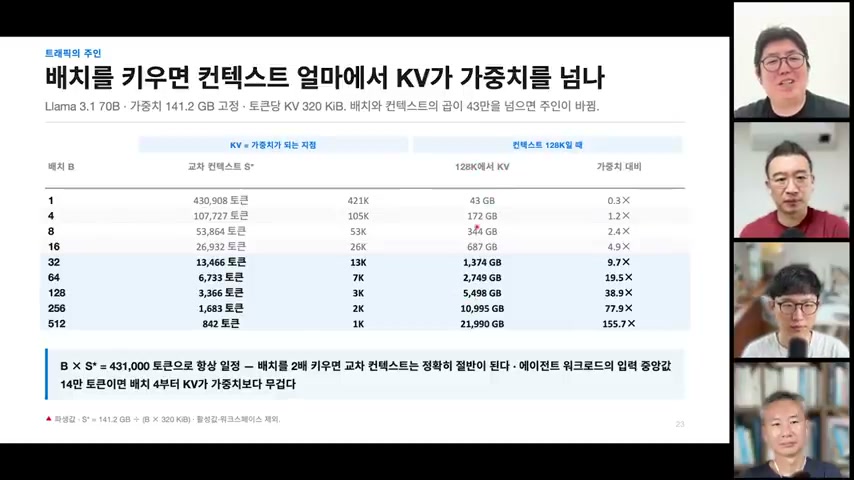
Llama 3.1 70B를 예로 든 표는 가중치 141.2GB와 토큰당 KV 320KiB를 고정하고, 배치와 128K 컨텍스트가 커질 때 KV가 얼마나 늘어나는지 보여준다. 슬라이드의 계산에서는 B × S* = 431,000 토큰 부근에서 KV가 가중치와 비슷해지고, 배치 512·128K 컨텍스트에서는 KV가 약 21,990GB로 가중치의 155.7배까지 올라간다.
여기서 inference의 batch는 training처럼 같은 길이의 문장 묶음만 뜻하지 않는다. 서로 다른 길이의 요청을 동시에 서비스하는 사용자 수에 가까운 개념이다. 사용자가 늘면 각 사용자의 KV를 읽어야 하므로 throughput을 높일 수 있는 대신, 개별 사용자가 느끼는 지연과 메모리 압박이 커진다. 수치는 영상의 가정에 따른 규모감으로 해석해야 한다.
[55:35] 12. Pareto frontier — throughput과 사용자 반응성의 교환
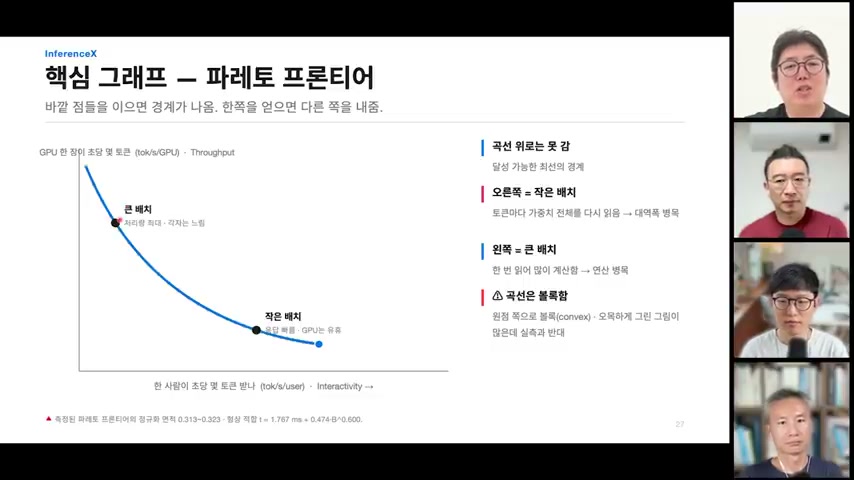
가로축은 사용자당 초당 토큰인 interactivity, 세로축은 GPU 한 장당 초당 토큰인 throughput이다. 큰 배치는 연산을 많이 재사용해 throughput이 높지만 개별 요청은 기다리므로 왼쪽으로 가고, 작은 배치는 사용자 반응성이 좋지만 GPU가 유휴 상태가 되기 쉬워 오른쪽 아래로 내려간다.
이 곡선은 “최고 TPS가 곧 최고의 서비스”라는 생각을 교정한다. 실제 서빙에서는 목표 응답시간을 넘지 않는 범위에서 GPU당 처리량을 최대화해야 하며, 이는 제품의 goodput과 연결된다. 사용자의 체감 품질, 비용, 요청 분포를 함께 넣어 Pareto 경계를 정해야 한다.
[01:00:55] 13. vLLM — 요청 단위에서 iteration 단위로
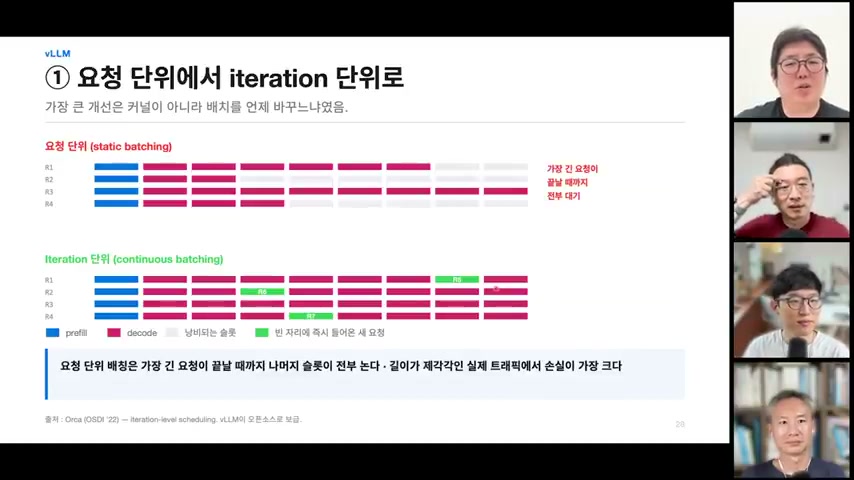
과거의 요청 단위(static batching) 스케줄링은 가장 긴 요청이 끝날 때까지 다른 요청이 기다리게 만들었다. vLLM의 continuous batching은 한 iteration이 끝날 때마다 새 요청을 빈 자리에 넣고, 먼저 끝난 요청을 빼면서 decode 스트림을 계속 채운다. 슬라이드의 파란색은 prefill, 분홍색은 decode, 초록색은 해당 iteration에 새로 들어온 요청을 뜻한다.
이 변화는 모델의 계산식을 바꾸지 않고도 GPU 이용률과 지연 분포를 바꾼다. 무작위로 들어오는 실제 요청을 짧은 iteration 단위로 재배치하는 것이 핵심이며, vLLM·SGLang이 오픈소스 서빙 표준처럼 쓰이는 이유도 이 운영 계층에 있다.
[01:05:20] 14. PagedAttention — KV를 페이지로 관리하기
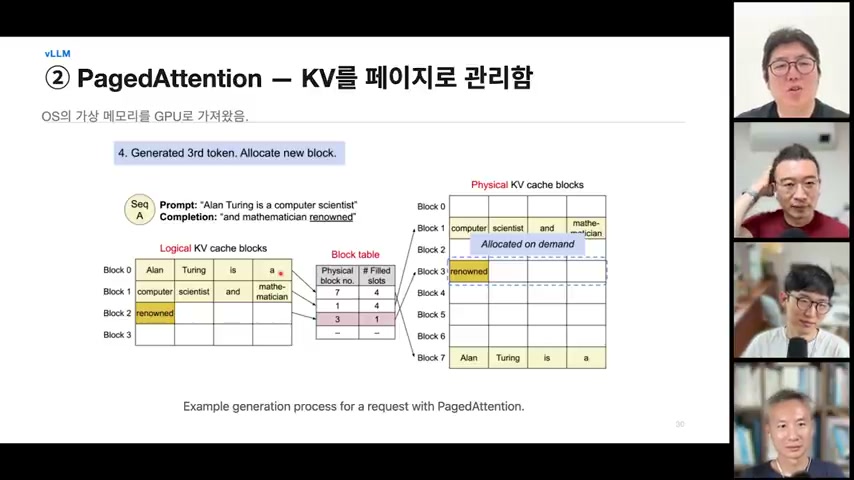
출력 길이를 미리 알 수 없으면 최악의 경우에 맞춰 KV 메모리를 예약해야 한다. 짧은 답변으로 끝나는 요청은 할당받은 공간 대부분을 쓰지 못하므로 메모리 단편화와 낭비가 생긴다. PagedAttention은 운영체제의 가상 메모리처럼 논리 KV 블록과 물리 KV 블록을 분리하고, 필요한 만큼 페이지를 동적으로 할당한다.
슬라이드의 예에서는 “Alan Turing is a mathematician”이라는 시퀀스가 논리 블록으로 나뉘고, page table이 이를 실제 물리 블록에 매핑한다. 이 방식은 여러 요청의 KV를 더 촘촘하게 배치할 수 있게 하지만, 페이지 관리와 블록 이동 자체의 구현 비용이 생긴다.
[01:10:20] 15. Chunked prefill — 긴 입력이 decode를 막지 않게
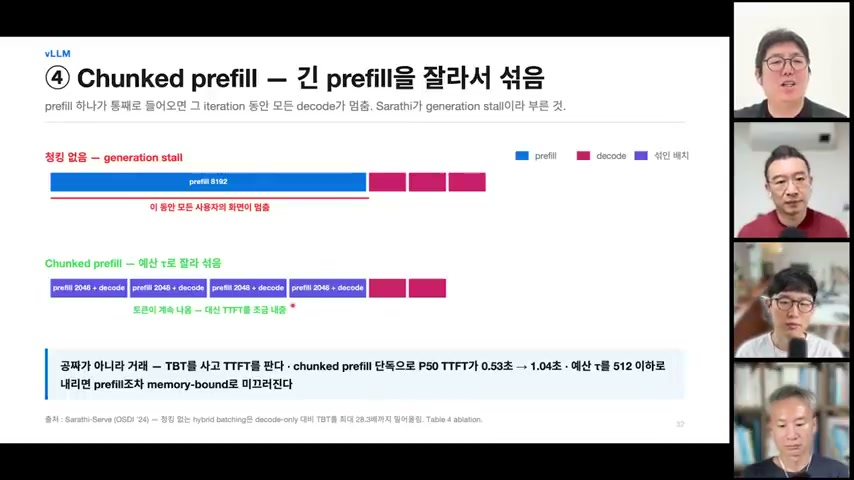
긴 prefill 하나가 통째로 들어오면 그 iteration 동안 모든 decode가 멈추는 generation stall이 발생한다. Chunked prefill은 긴 prefill을 작은 조각으로 나눠 decode 사이에 끼워 넣는다. 일반적으로 decode에 우선권을 주고, 이미 잘린 prefill을 처리한 다음 자리가 남으면 새 요청의 prefill을 태운다.
이 정책은 첫 토큰이 나오는 TTFT를 약간 희생해 토큰 사이 간격인 TBT를 안정화한다. 슬라이드는 prefill 하나를 통째로 넣는 경우와 쪼개서 섞는 경우를 비교하며, “평균 속도”보다 사용자가 응답을 받는 동안 갑자기 멈추지 않는 경험을 중요하게 본다.
[01:15:20] 16. Speculative decoding — 작은 모델로 초안을 만들고 검증
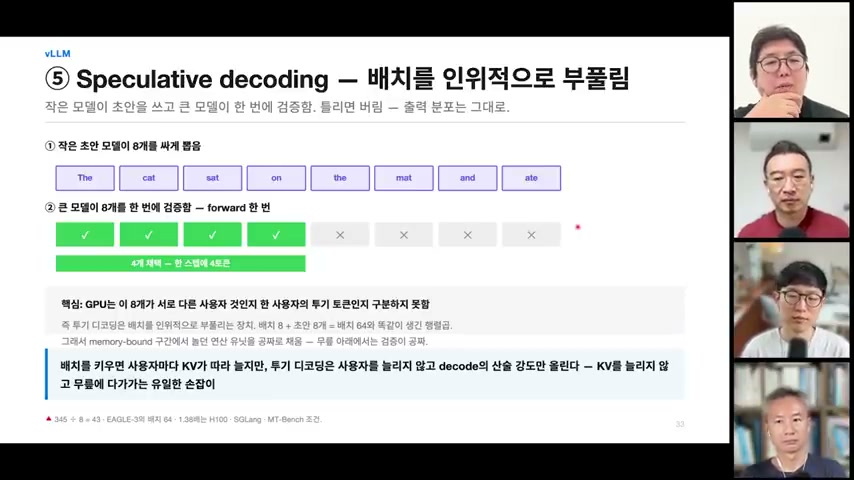
Speculative decoding은 작은 draft 모델이 다음 토큰 여러 개를 먼저 제안하고, 큰 모델이 한 번의 forward에서 묶어 검증하는 방식이다. 예시에서는 8개의 토큰을 제안하고 큰 모델이 앞의 4개를 받아들인다. 잘못된 뒤쪽 토큰은 버리며, accept rate가 높을수록 순차적인 큰 모델 decode 횟수를 줄일 수 있다.
핵심은 GPU가 서로 다른 사용자의 투기 토큰을 구분하지 못하므로, 사용자를 섞는 방식이 아니라 한 사용자의 KV를 늘리지 않고 decode의 순차 단계를 줄이는 것이다. 발표자는 prefill이 decode보다 싸다는 점을 이용해, 싼 모델이 만든 정답 후보를 큰 모델의 prefill에서 검증하는 구조로 설명한다. 모델·언어·작업별 accept rate를 측정하지 않고 평균 TPS만 비교하면 효과를 오해할 수 있다.
[01:20:10] 17. PD disaggregation — Prefill과 Decode를 별도 풀로
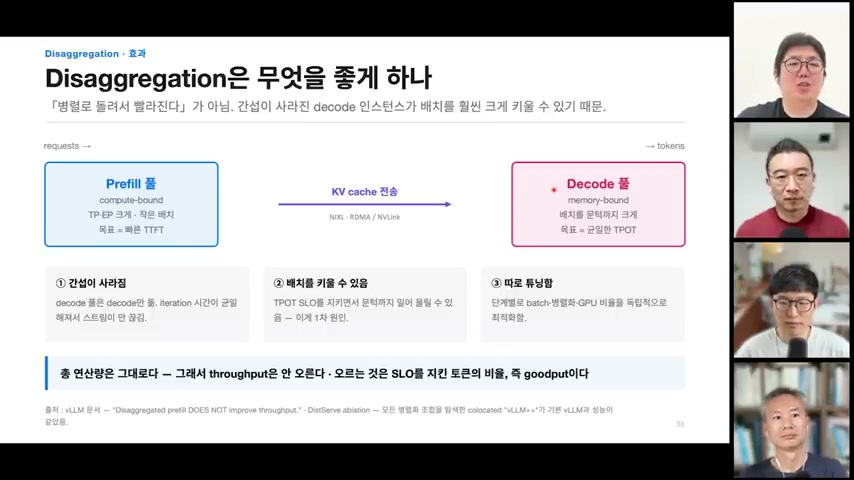
자동차 공장에서 바퀴 조립과 문 끼우기를 다른 작업자가 맡는 것처럼, prefill pool과 decode pool을 분리하는 것이 PD disaggregation이다. Prefill pool은 compute-bound 작업과 빠른 TTFT에, decode pool은 memory-bound 작업과 균일한 TBT에 맞춰 운영한다. prefill에서 만든 KV는 두 풀 사이의 네트워크를 통해 decode pool로 전송한다.
이 구조는 모든 GPU를 100% 활용했을 때 총 token throughput을 마법처럼 늘리는 방법은 아니다. 대신 decode가 긴 prefill에 방해받지 않게 하고, 목표 TBT를 만족하는 goodput을 높이며, 각 풀의 GPU 비율을 독립적으로 조절하게 한다. 규모가 작거나 KV 전송 네트워크가 느리면 분리 비용이 이득을 상쇄할 수 있다.
[01:25:20] 18. 에이전트의 호출 구조 — Session·Request·Step
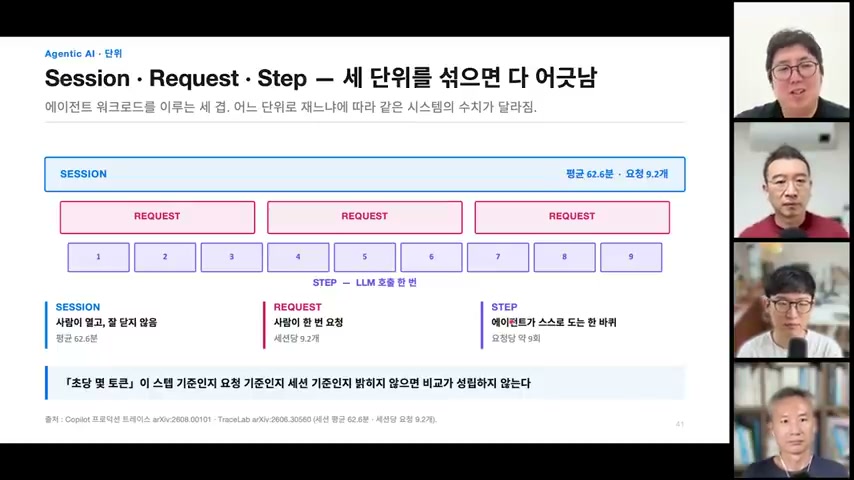
챗봇의 한 번의 질문만 보면 KV cache 문제를 작게 보게 된다. 에이전트 시스템에서는 사람이 시작한 긴 session 안에 여러 request가 있고, 각 request는 에이전트가 도구를 호출하고 결과를 읽고 다시 생각하는 여러 step으로 구성된다. 슬라이드의 사례값은 평균 session 62.6분, session당 request 9.2개다.
이 구조에서는 사람이 한 번 입력한 뒤 에이전트가 루프를 돌며 LLM을 계속 호출한다. reasoning token까지 길어지면 이전 prefix를 읽는 비용이 새로 생성하는 output보다 훨씬 커질 수 있다. 따라서 에이전트 인프라는 단일 prompt의 tok/s가 아니라 session당 호출 수, step 수, prefix 길이와 재사용률을 기준으로 설계해야 한다.
[01:30:20] 19. 에이전트 비용의 대부분은 출력이 아니라 입력 재읽기
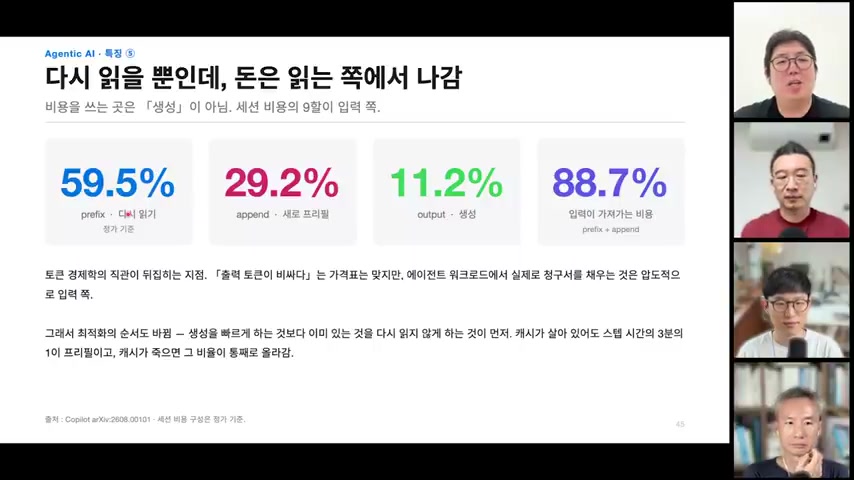
후반 슬라이드는 한 에이전트 워크로드에서 비용이 어디서 발생하는지 보여준다. 예시 분해는 prefix·decode 읽기 59.5%, 새로 붙는 append 29.2%, output 생성 11.2%이며, 입력을 가져오는 비용을 합치면 88.7%로 표시된다. “토큰을 생성하는 서비스”라는 표현과 달리 실제 청구서와 지연의 상당 부분은 이미 계산한 상태를 다시 읽는 데서 나올 수 있다는 주장이다.
그래서 최적화의 순서도 바뀐다. 새 output을 더 빨리 생성하기 전에 prefix를 재사용하고, 캐시를 지우지 않고, 필요하면 CPU DRAM·SSD·고대역폭 플래시로 옮겼다가 다시 가져오는 계층형 메모리를 설계해야 한다. 재계산과 오프로딩 중 어느 쪽이 나은지는 캐시 크기·전송 속도·재방문 확률에 따라 측정해야 한다.
[01:35:15] 20. 한 장의 Roofline 위에 특수 목적 칩을 배치하기
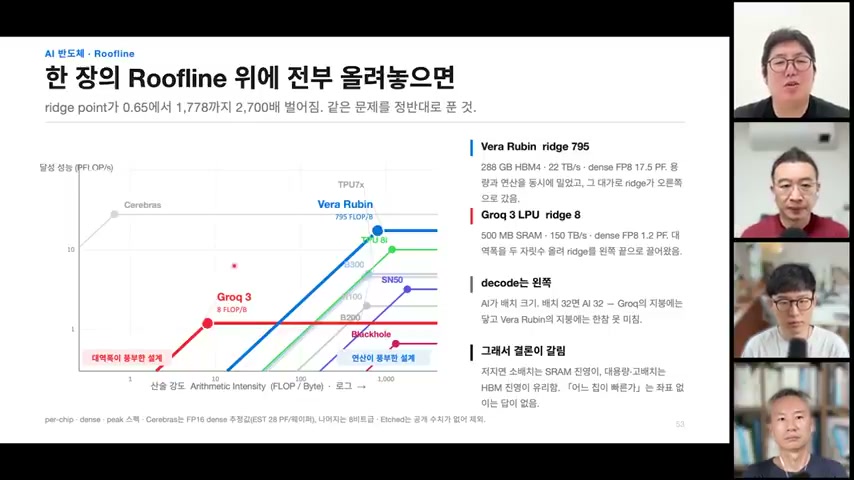
마지막 하드웨어 비교는 모든 작업을 한 칩에 몰아넣는 대신 Roofline 위에서 역할을 나누는 그림이다. 슬라이드는 Vera Rubin ridge 795, Groq 3 LPU ridge 8을 예로 들고, decode처럼 arithmetic intensity가 낮은 memory-bound 영역에는 SRAM 중심의 LPU가 유리할 수 있으며 FFN처럼 상대적으로 연산이 풍부한 부분은 다른 GPU에 맞을 수 있다고 설명한다.
발표자는 PD disaggregation과 결합해 prefill·decode를 Rubin GPU로 처리하되 attention과 FFN을 서로 다른 장치에 배치하는 가능성을 언급한다. MoE에서는 expert별 batch가 작아져 특수 목적 하드웨어의 장점이 생길 수 있다. 결론은 하나의 “최고 GPU”를 찾는 것이 아니라, LLM이라는 하나의 작업도 attention·FFN·KV 이동처럼 쪼개서 각 trade-off에 맞는 칩을 선택하는 시대가 온다는 것이다.
핵심 개념 정리
- Prefill: 입력 토큰 전체를 병렬 처리해 첫 출력 토큰을 만드는 단계. 긴 입력·대규모 batch에서 연산 활용도가 높다.
- Decode: 이전 토큰을 바탕으로 다음 토큰 하나를 순차 생성하는 단계. 가중치와 KV cache를 반복해서 읽으므로 메모리 대역폭과 TBT에 민감하다.
- KV cache: 이미 처리한 토큰의 Key·Value 상태를 저장해 다음 스텝에서 재사용하는 데이터. 컨텍스트·배치·에이전트 루프가 커질수록 주요 비용이 된다.
- Arithmetic intensity: 메모리에서 읽은 데이터 1바이트당 수행하는 연산량. Roofline에서 memory-bound와 compute-bound를 가르는 핵심 축이다.
- Ridge point: 하드웨어의 메모리 대역폭 천장과 peak 연산 성능 천장이 만나는 지점.
- Continuous batching: 요청이 끝날 때까지 묶어 두지 않고 iteration마다 완료 요청을 빼고 새 요청을 넣는 서빙 방식.
- PagedAttention: 논리 KV 블록과 물리 메모리 블록을 분리해 KV를 페이지처럼 동적으로 할당하는 방식.
- Chunked prefill: 긴 prefill을 조각내 decode와 교차 실행해 generation stall을 줄이는 방식.
- Speculative decoding: 작은 draft 모델의 여러 토큰 제안을 큰 모델이 한 번에 검증해 순차 decode 횟수를 줄이는 방식.
- PD disaggregation: prefill pool과 decode pool을 분리하고 KV를 네트워크로 전달하는 구조. 총량보다 지연·goodput·자원 배분을 개선하는 데 목적이 있다.
부록 — 실전 체크리스트
- 모델 비교에서
tokens/s하나만 보지 말고, 실제 작업 완료 시간·실패율·사람 개입 횟수·총 토큰·전력 비용을 함께 측정한다. - 에이전트 도입 전에 session·request·step을 정의하고, prefix 길이·KV 재사용률·재방문 간격을 계측한다.
- 긴 컨텍스트 서비스는 GQA/MQA/MLA, prefix caching, KV 양자화, PagedAttention, 오프로딩을 각각 별도 실험한다.
- prefill과 decode의 TTFT·TBT 목표가 다르면 continuous batching과 chunked prefill을 함께 검토한다.
- PD disaggregation을 도입할 때 KV 전송 대역폭·복사 횟수·장애 시 재배치 비용을 측정한다.
- 특수 목적 칩을 평가할 때 peak FLOPS 대신 대상 workload의 arithmetic intensity와 실제 goodput을 Roofline 위에 표시한다.
- 에이전트의 빠른 인퍼런스에는 권한·네트워크·검증·복구 경계를 함께 설계한다. 빠른 생성은 빠른 오류와 공격도 의미하기 때문이다.
원문 인용 모음
- [00:01:19] “자주 하고 있는 이유는 그게 굉장히 중요하기 때문이겠죠.”
- [00:07:20] “저희가 만드는 칩이 Bertha라고 하는 칩이고요.”
- [00:15:37] “그 과정을 prefill이라고 하고요.”
- [00:16:09] “이렇게 한 token이 들어가서 다음으로 한 token이 나오는 과정을 decode phase라고 부르게 됩니다.”
- [00:27:20] “KV cache가 필요한 이유는 스텝마다 앞 토큰의 K-V가 다시 필요하기 때문입니다.”
- [00:40:51] “메모리에서 데이터를 얼마나 적게 읽고 적게 쓰느냐, 이게 굉장히 중요합니다.”
- [00:40:59] “그래서 Roofline analysis라는 게 나오는데 이게 유명한 David Patterson을 비롯한 몇 분이 2009년에 논문으로 낸 건데요.”
- [00:45:16] “특히 최근에는 context length도 길어지다 보니까 이 부분이 굉장히 큰 병목이 되고 있어요.”
- [01:05:15] “PagedAttention이라고 하는 게 있는데요.”
- [01:09:37] “그다음에 chunked prefill이라고 하는 게 있는데요.”
- [01:16:09] “이 speculative decoding을 하는 이유는 prefill이 decode보다 훨씬 싸다.”
- [01:20:16] “그래서 대신 이 prefill에서 만들어진 모든 key-value는 decode pool로 전송해 줘야겠죠.”
- [01:30:00] “bound라는 표현이 무색하게 그냥 memory work네요. 들고 있기 게임이네.”
- [01:41:09] “특수 목적의 hardware들이 주르륵 나오는 시대가 되지 않을까.”