출처 https://www.youtube.com/watch?v=BJeHhsMVc8A · 채널 Tech Bridge (원본: LangChain, 2026-09-21) · 길이 00:09:14 포맷 LangChain 오픈소스 PM Sydney Runkle의 슬라이드 11장 발표. 코드·다이어그램 슬라이드 중심이다. 원본 자막:
raw/transcripts/2026-09-26-langchain-building-a-harness-with-jev.en.srt(영어 자동자막. 고유명사·수치는 슬라이드와 화면 자막으로 정정) 동반 글: Building a Harness with Jev
한눈에 보는 요약
- 문제: 에이전트 루프는 판단할 때마다 LLM을 한 번 더 호출하므로 느리고 비싸다. 도구 호출과 구조화된 출력이 LLM에 타입을 입혔지만 이 비용은 그대로 남았다.
- Jev: TypeSafe AI의 System One 모델이다. 텍스트를 만들지 않고, state와 질문을 받아 타입이 있는 답과 확률을 돌려준다. 분류형 작업에서 LLM보다 20
200배 빠르고 40400배 싸다(TypeSafe 주장). - 이름의 유래: 카너먼 『생각에 관한 생각』의 빠르고 값싼 직관(System 1)과 느리고 비싼 추론(System 2)을 가져왔다. LLM은 System 2 쪽에 해당한다.
- 질문 3유형: Choice(하나 고르기), Score(척도 위치), Noul(참일 확률). 한 state에 여러 질문을 보내면 병렬로 답한다.
- LangChain 연동:
langchain-typesafe패키지의TypeSafeClassifier하나로 붙인다. 노드·도구·미들웨어 훅 어디서나 호출할 수 있다. - 활용 사례 3가지: ① 요청 난이도에 따라 모델을 고르는 모델 라우팅, ② 위험한 도구 호출을 실행 전에 막는 오토 모드, ③ 루브릭으로 채점하는 온라인 평가 심사위원(Jev as a judge).
핵심 한 줄: 열린 추론과 생성은 LLM(System 2)에, 에이전트 루프 곳곳의 분류·게이트 판단은 Jev(System 1)에 맡겨 속도와 비용을 줄인다.
장면별 상세 설명
[00:12] 1. 복습 — 에이전트의 핵심 루프
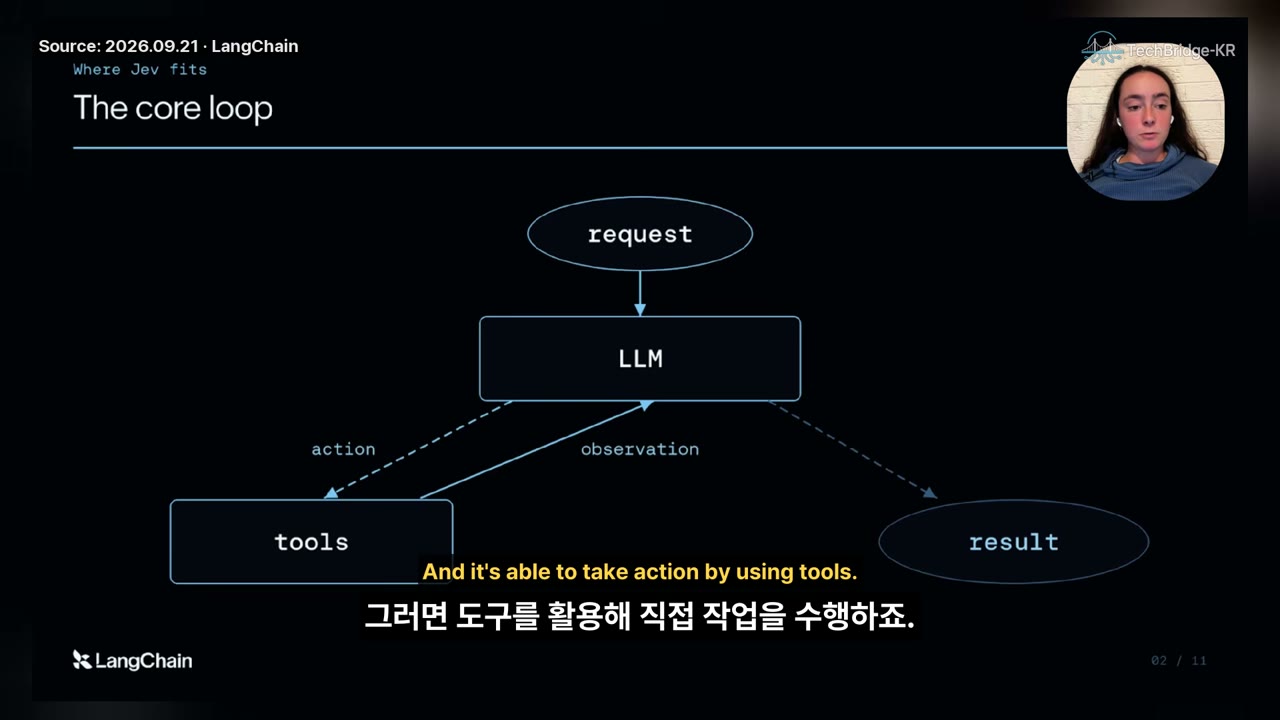
요청(request)이 들어오면 LLM이 도구에 action을 보내고 observation을 받는다. 이 루프를 반복하다가 작업이 끝났다고 판단하면 result를 반환한다. Jev가 들어갈 자리를 설명하려고 먼저 이 루프를 짚는다(슬라이드 부제 “Where Jev fits”).
[01:02] 2. 이미 있던 것 — 도구 호출과 구조화된 출력
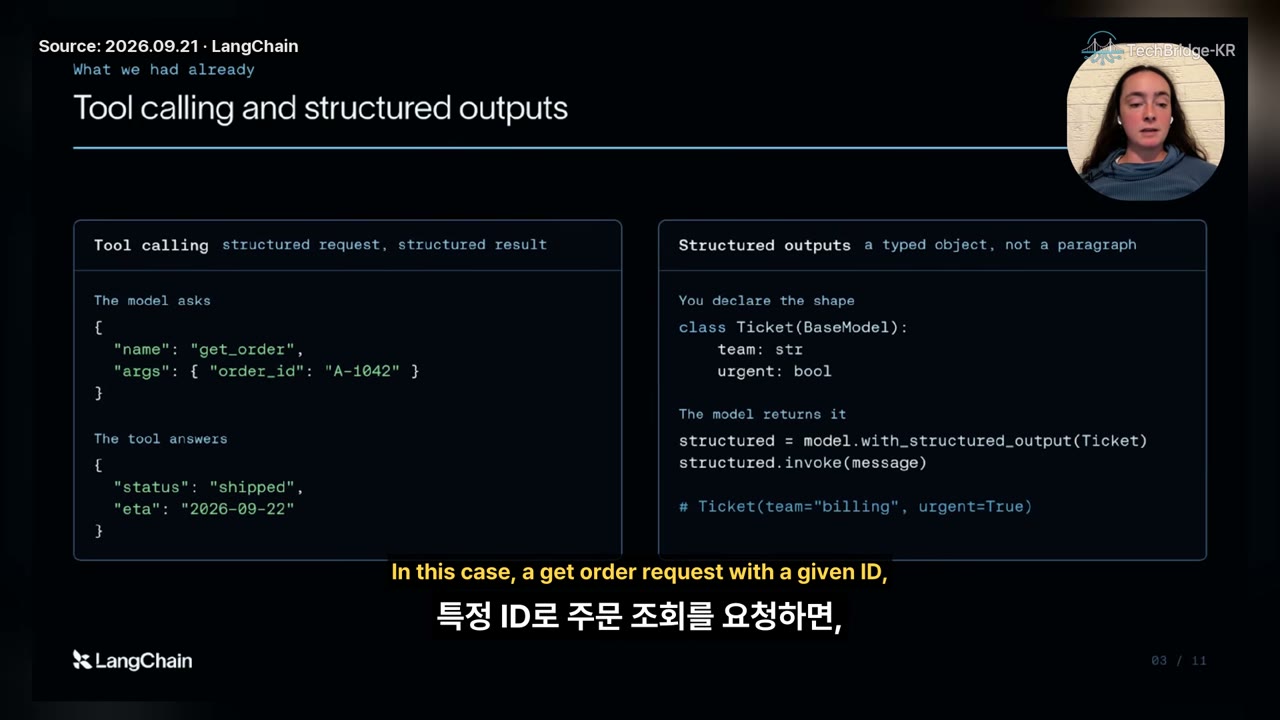
LLM은 텍스트를 받아 텍스트를 내놓아 예측하기 어렵다. 그래서 구조화된 타입에 의존하는 코드 기반 앱에 넣으려고 두 가지 프리미티브가 생겼다.
- Tool calling: 요청도 결과도 구조화된다. 모델이
{"name": "get_order", "args": {"order_id": "A-1042"}}로 요청하면 도구가{"status": "shipped", "eta": "2026-09-22"}를 돌려준다. - Structured outputs: 문단 대신 타입이 있는 객체를 받는다.
class Ticket(BaseModel):
    team: str
    urgent: bool

structured = model.with_structured_output(Ticket)
structured.invoke(message)
# Ticket(team="billing", urgent=True)
[01:38] 3. Jev란 무엇인가 — System One 모델
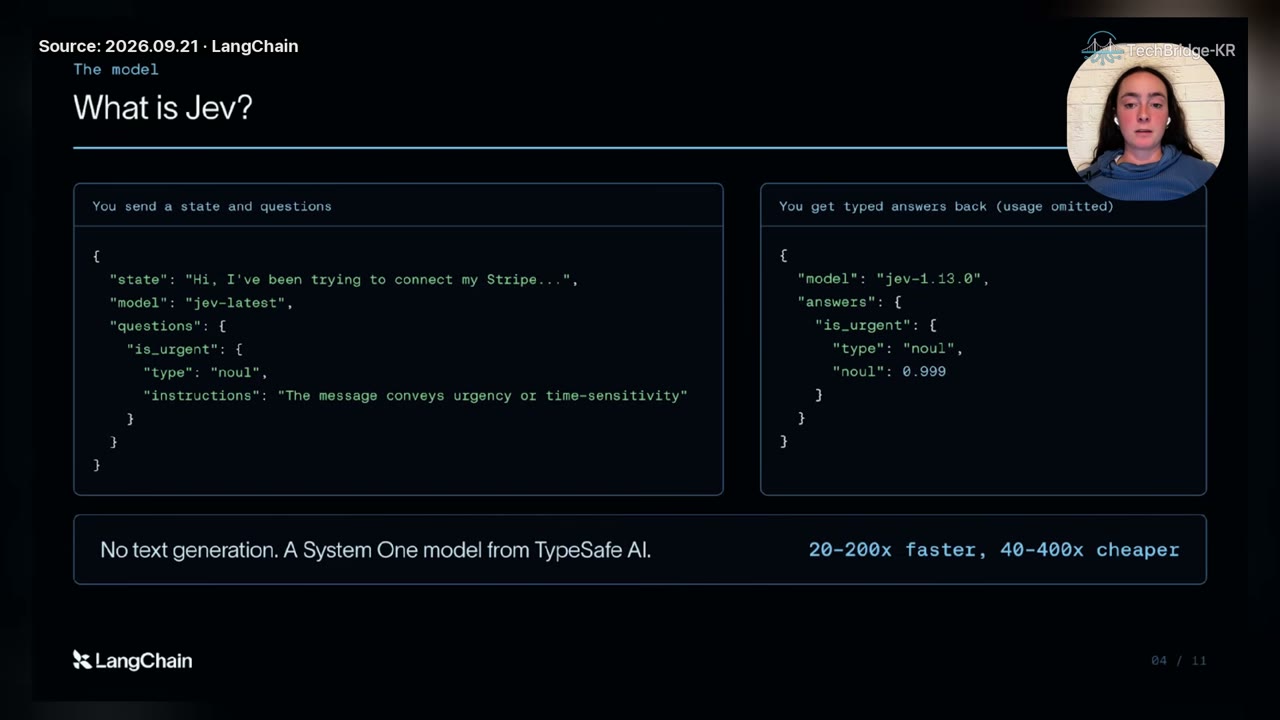
TypeSafe 문서의 정의에 따르면 System One 모델은 “소프트웨어가 바로 쓸 수 있는 빠르고 구조화된 결정을 내리도록 만든 AI 모델”이다. state와 questions를 평가해 타입이 있는 답과 확률을 돌려준다. 슬라이드의 요청과 응답은 다음과 같다(usage 생략).
// 요청
{"state": "Hi, I've been trying to connect my Stripe...",
 "model": "jev-latest",
 "questions": {"is_urgent": {"type": "noul",
   "instructions": "The message conveys urgency or time-sensitivity"}}}
// 응답
{"model": "jev-1.13.0",
 "answers": {"is_urgent": {"type": "noul", "noul": 0.999}}}
슬라이드 하단 문구는 “No text generation. A System One model from TypeSafe AI. / 20-200x faster, 40-400x cheaper”이다. Jev는 LLM을 그대로 대체하지는 못한다. 다만 지금 LLM에 시키는 특화 작업을 훨씬 빠르고 싸게 해낸다.
이름은 Daniel Kahneman의 『Thinking, Fast and Slow』에서 왔다. System 1은 빠르고 값싼 직관이고 System 2는 느리고 비싼 추론이다. TypeSafe는 거의 즉시 타입 있는 결정을 내놓는 Jev를 System 1로, 열린 문제를 단계별로 추론하는 기존 LLM을 System 2로 놓고 의도적으로 대비시켰다.
[03:27] 4. 데모 — 같은 질문에 대한 LLM의 답
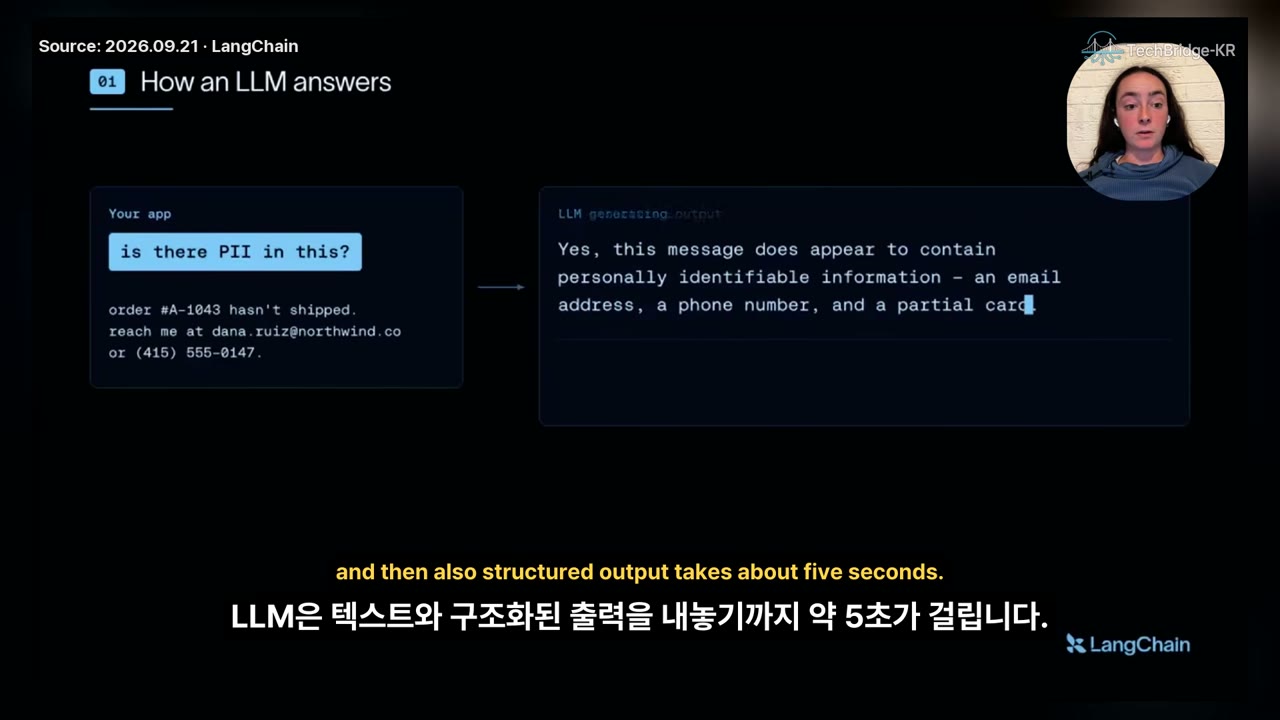
질문은 “이 텍스트에 PII가 있는가?”이고, 텍스트는 주문번호·이메일·전화번호가 든 고객 메시지다. LLM은 “Yes, this message does appear to contain personally identifiable information — an email address, a phone number, and a partial card…” 같은 문장을 생성한 뒤 구조화된 출력까지 만든다. 여기까지 약 5초가 걸린다.
[03:48] 5. 데모 — Jev의 답
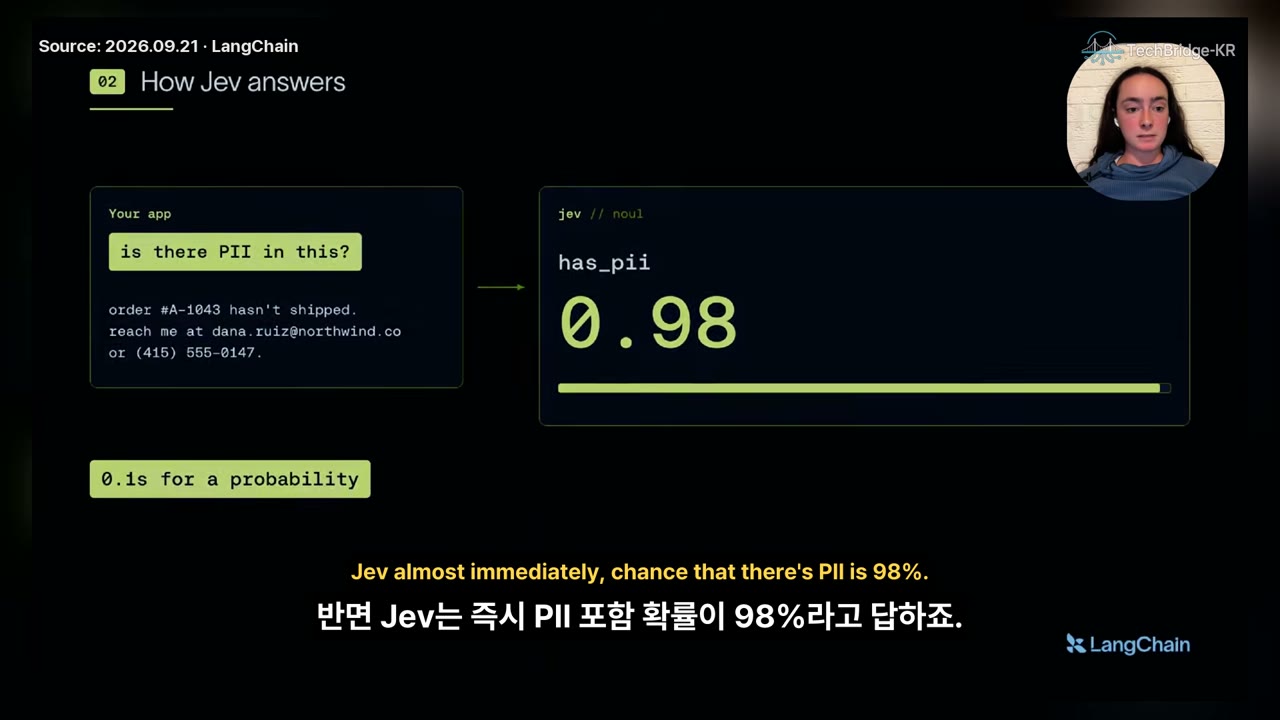
Jev는 거의 즉시 has_pii Noul 값 0.98, 즉 PII가 있을 확률 98%를 내놓는다. 지금 에이전트가 LLM으로 처리하는 분류·결정형 작업은 이런 식으로 속도와 비용 면에서 최적화할 여지가 많다는 것이 발표자의 결론이다.
[04:11] 6. 질문 3유형 — Choice · Score · Noul
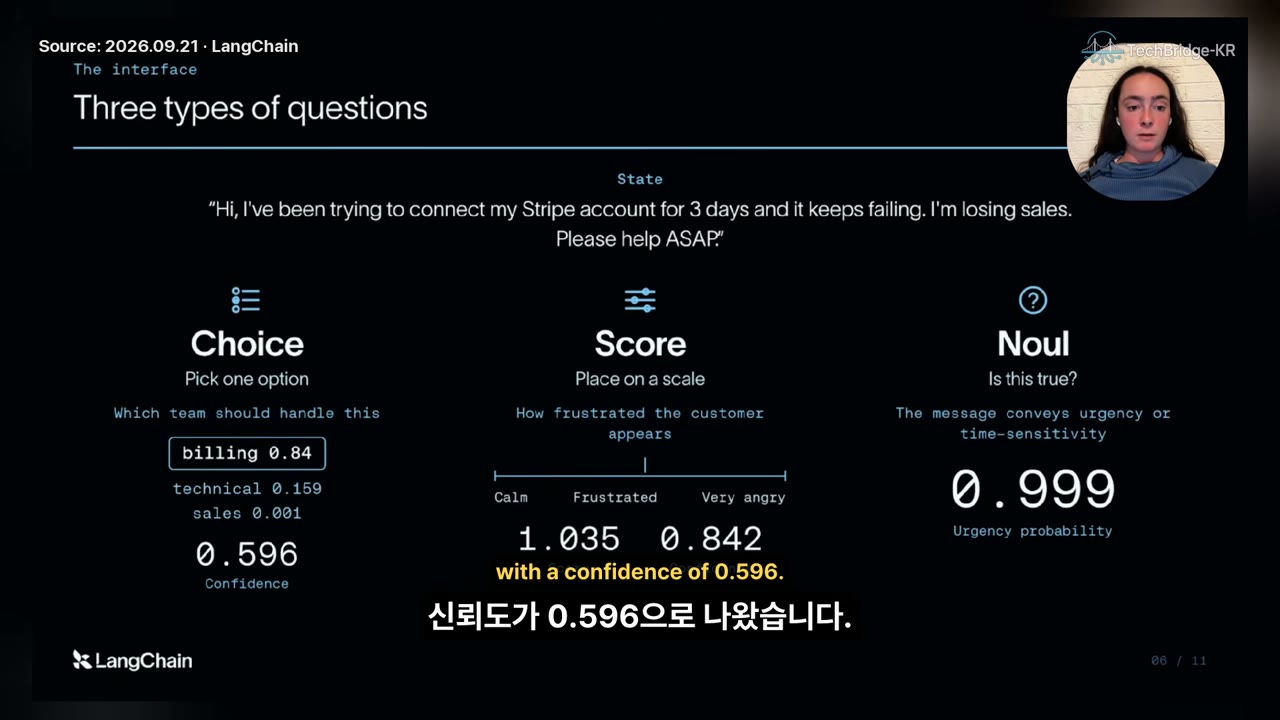
state는 모두 같은 고객 문의다. “Hi, I’ve been trying to connect my Stripe account for 3 days and it keeps failing. I’m losing sales. Please help ASAP.”
| 유형 | 뜻 | 예시 질문 | 결과 |
|---|---|---|---|
| Choice | 선택지 중 하나 고르기 | 어느 팀이 처리해야 하나 | billing 0.84 · technical 0.159 · sales 0.001, confidence 0.596 |
| Score | 순서 있는 척도 위 위치 | 고객이 얼마나 짜증났나 (Calm–Frustrated–Very angry) | 1.035 → 짜증은 났지만 매우 화난 정도는 아님 (화면에 0.842가 함께 표시됨) |
| Noul | 참일 확률(예/아니오형) | 메시지가 긴급함·시간 민감성을 전하는가 | 0.999 (0~1 척도) |
하나의 state에 질문을 여러 개 보내면 Jev가 병렬로 답한다. 질문을 한꺼번에 많이 던질수록 효율이 좋고, 순차적으로 추론하는 LLM과 대비되는 지점이다.
[05:35] 7. LangChain에서 Jev 쓰기
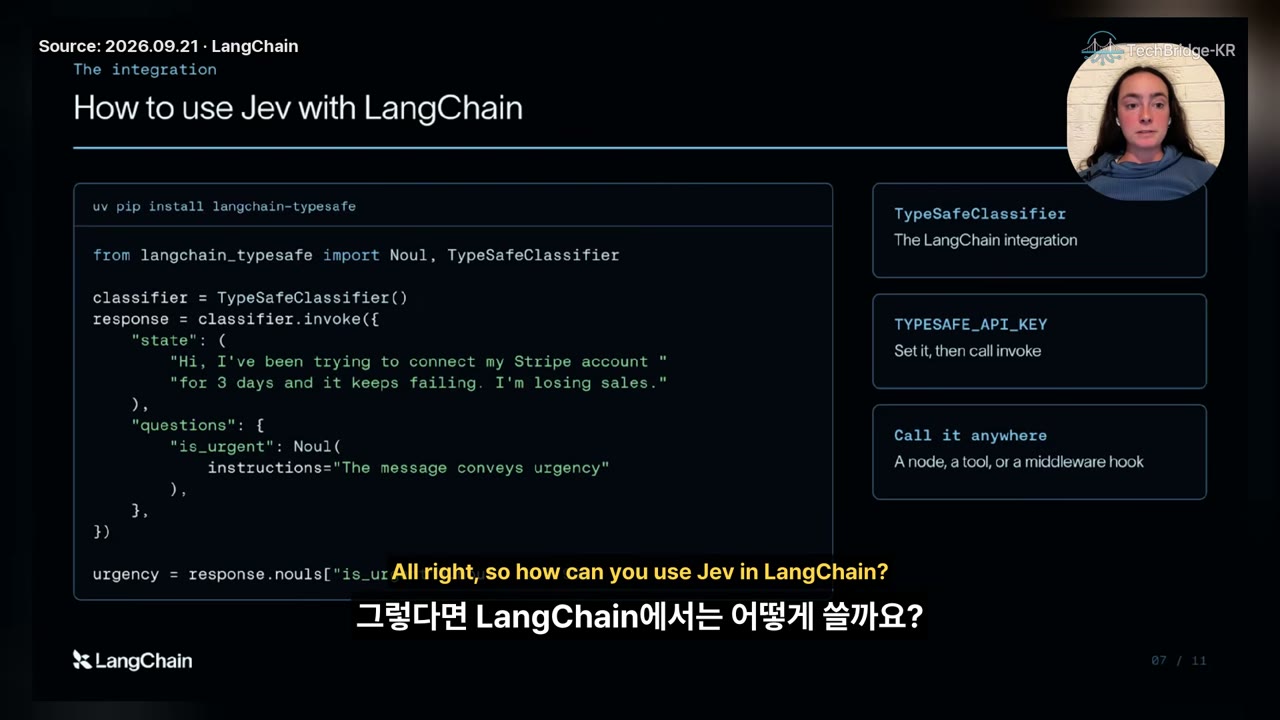
LangChain이 TypeSafe 통합을 새로 냈다. TypeSafe API 키를 받아 TYPESAFE_API_KEY로 설정하고 classifier에 state와 questions를 넘기면, 응답에 질문별 답이 담겨 온다.
# uv pip install langchain-typesafe
from langchain_typesafe import Noul, TypeSafeClassifier

classifier = TypeSafeClassifier()
response = classifier.invoke({
    "state": (
        "Hi, I've been trying to connect my Stripe account "
        "for 3 days and it keeps failing. I'm losing sales."
    ),
    "questions": {
        "is_urgent": Noul(instructions="The message conveys urgency"),
    },
})
urgency = response.nouls["is_urgent"].noul
오른쪽 카드는 세 가지를 안내한다. TypeSafeClassifier가 LangChain 통합 진입점이고, TYPESAFE_API_KEY를 설정한 뒤 invoke하며, 노드·도구·미들웨어 훅 어디서나 호출할 수 있다(Call it anywhere).
[06:04] 8. 활용 1 — 모델 라우팅
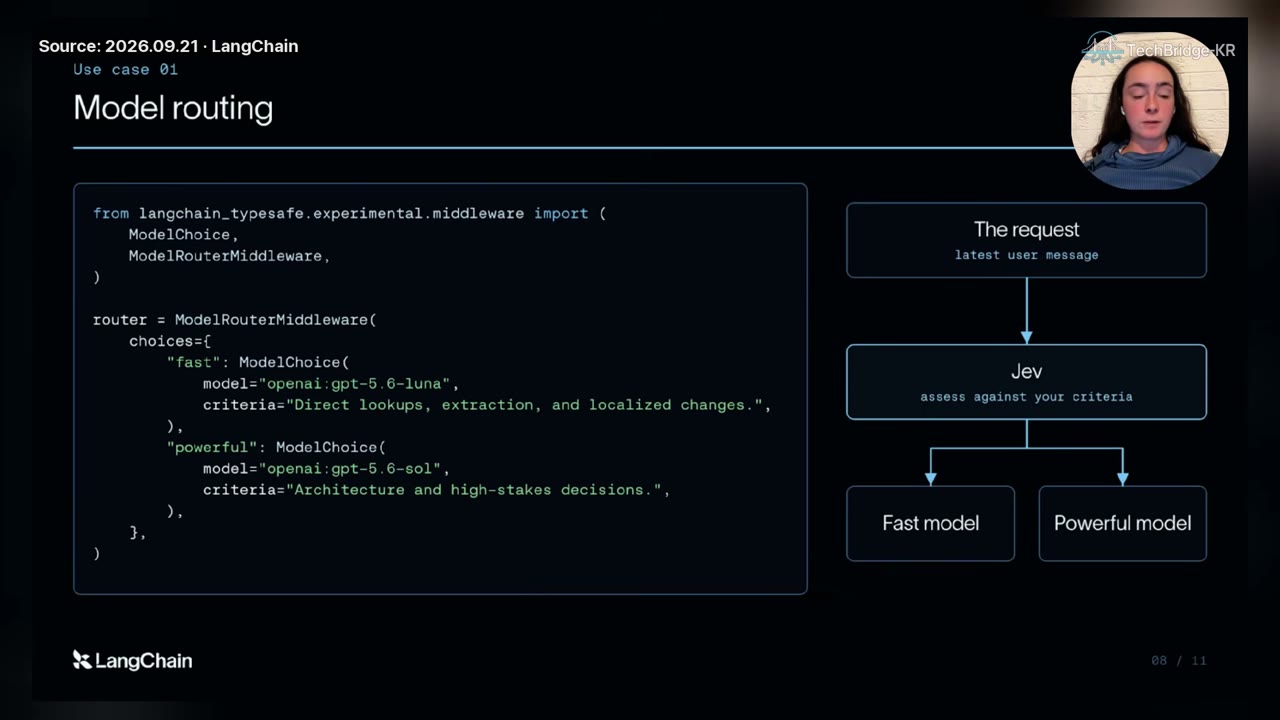
에이전트가 단순한 일과 복잡한 일을 모두 한다면 모든 일에 가장 강력한 모델을 쓸 필요는 없다. LangChain도 사내 코딩 에이전트가 과제의 복잡도에 따라 빠르고 싼 모델과 비싸고 강력한 모델을 오가게 하는 방법을 실험하고 있다. Jev는 최신 사용자 메시지를 기준에 맞춰 평가하고 거의 즉시 모델을 고른다.
from langchain_typesafe.experimental.middleware import ModelChoice, ModelRouterMiddleware

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(
            model="openai:gpt-5.6-luna",
            criteria="Direct lookups, extraction, and localized changes.",
        ),
        "powerful": ModelChoice(
            model="openai:gpt-5.6-sol",
            criteria="Architecture and high-stakes decisions.",
        ),
    },
)
동반 글에 따르면 라우터는 최신 사용자 메시지로 한 번 모델을 고르고 그 실행 내내 같은 모델을 쓴다. 판단 근거인 확률과 confidence는 agent state에 남는다.
[06:47] 9. 활용 2 — 오토 모드(위험한 도구 호출 차단)
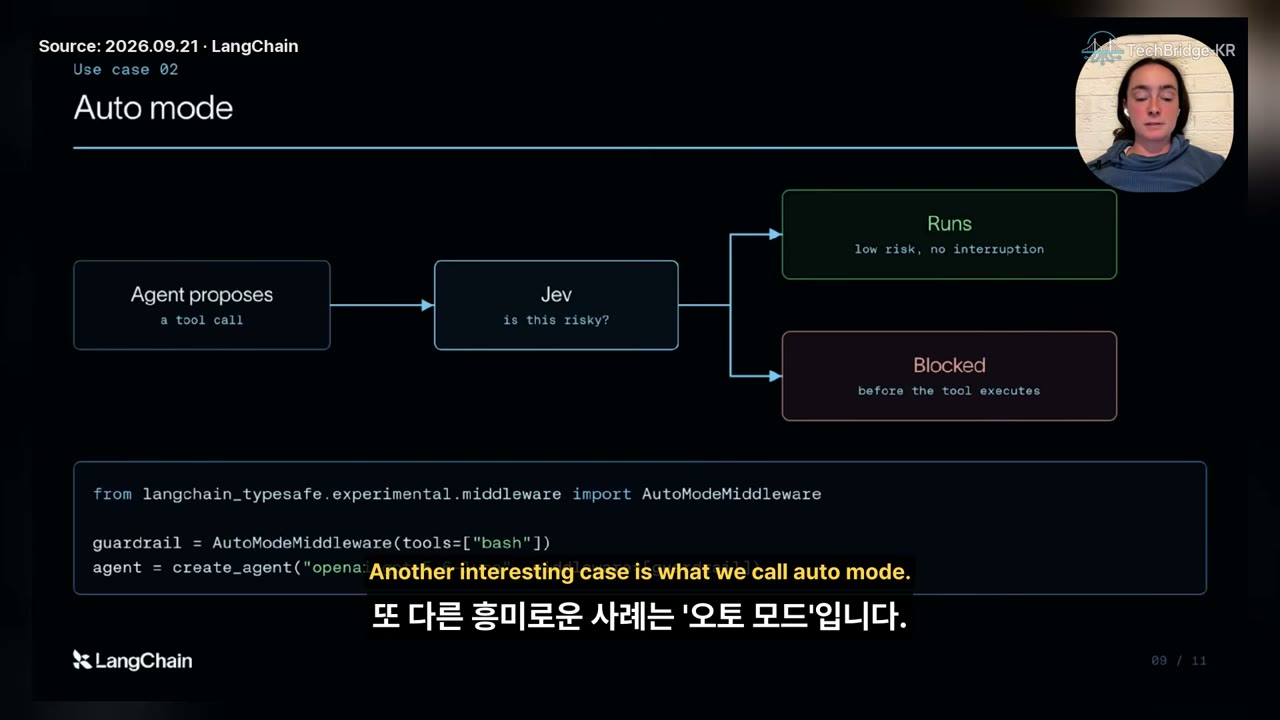
에이전트가 도구 호출을 제안하면 Jev가 “위험한가?”를 판정한다. 위험이 낮으면 끊김 없이 실행하고(Runs), 위험하면 도구가 실행되기 전에 막는다(Blocked). LangChain은 이를 미리 만들어 둔 미들웨어로 제공한다.
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])  # 모델명은 동반 글 기준(화면에서는 가려짐)
발표자는 자기 경험도 덧붙였다. 코딩 에이전트의 오토 모드를 한동안 꺼 두었는데, 도구 호출의 위험 여부를 분류하는 단계가 너무 느려 생산성이 떨어졌기 때문이다. Jev가 즉시 판단하게 되면서 다시 켰다. DB나 중요한 파일을 지우는 도구 호출이라면 Jev가 당연히 위험으로 분류해 막는다.
[07:28] 10. 활용 3 — 온라인 평가 심사위원(Jev as a judge)
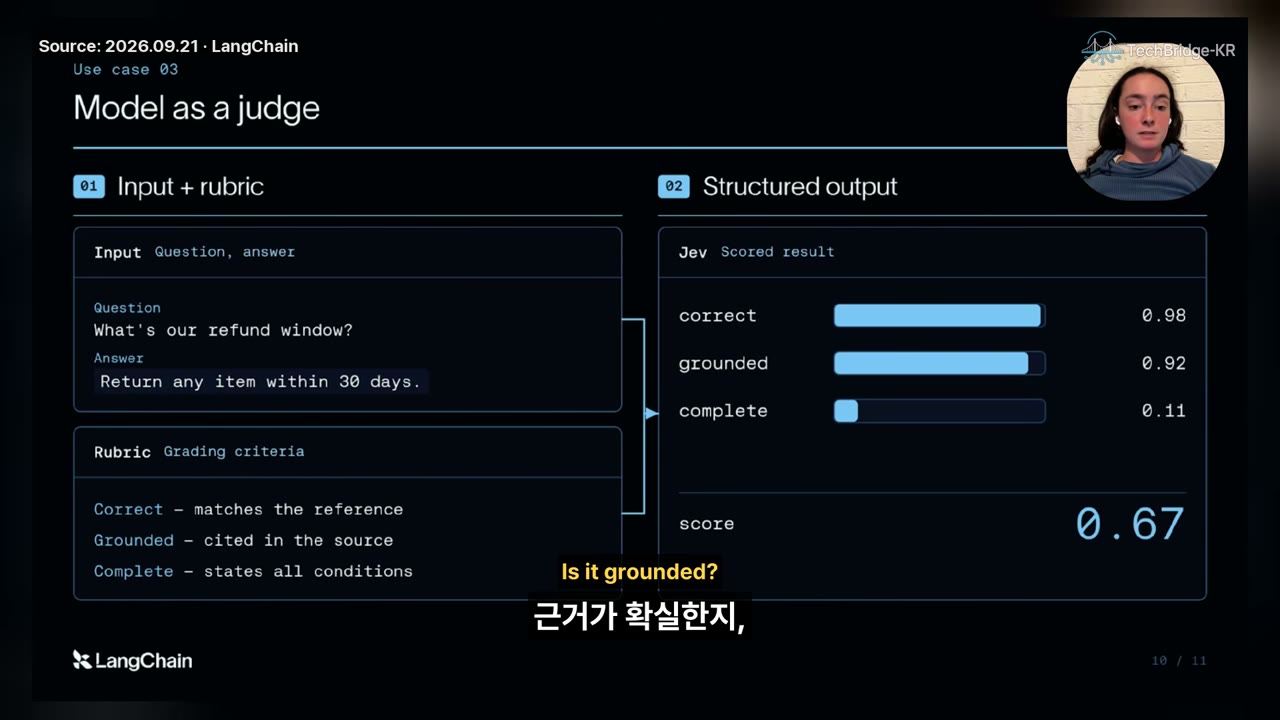
발표자가 가장 기대하는 사례다. 규모 있게 eval을 돌리면 모든 트레이스를 사람이 볼 수 없다. 그렇다고 코드형 평가기만으로는 에이전트가 일을 잘했는지 판단하기에 부족하다. Jev에는 입력(질문과 에이전트의 답)과 루브릭(채점 기준)을 주고 기준별로 점수를 매기게 한다.
- 입력: “What’s our refund window?” → “Return any item within 30 days.”
- 루브릭: Correct(레퍼런스와 일치) · Grounded(출처에 근거) · Complete(모든 조건 명시)
- 결과: correct 0.98 · grounded 0.92 · complete 0.11 → score 0.67
LLM-as-a-judge 온라인 eval은 유용하지만 비싸다. Jev 판정은 그 다음 단계에 해당한다. 발표자에 따르면 LangChain이 함께 낸 글의 결과에서 Jev는 예상대로 훨씬 싸고 빨랐다. 흥미로운 점은 eval 전반에 걸쳐 LLM 대안보다 더 신뢰할 만하고 일관적이었다는 것이다.
[08:47] 11. 시작하기
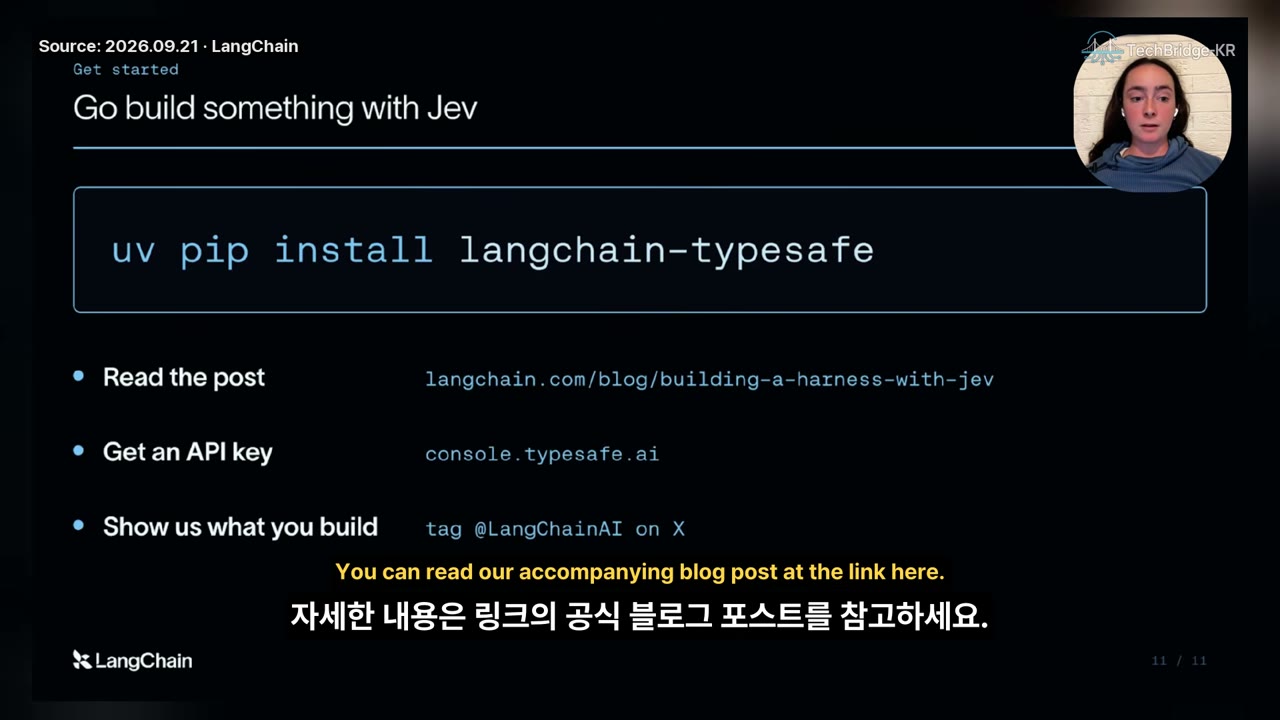
- 설치:
uv pip install langchain-typesafe - 글:
langchain.com/blog/building-a-harness-with-jev - API 키:
console.typesafe.ai - 공유: X에서
@LangChainAI태그
부록 — 실전 체크리스트
- 에이전트 루프에서 LLM을 “판단만” 하려고 부르는 지점(라우팅·게이트·분류·채점)을 목록으로 뽑고, Jev 질문(Choice/Score/Noul)으로 바꿀 수 있는지 표시하기
- 같은 state에 대한 판단은 질문 여러 개로 한 번에 묶어 보내기(병렬 처리라 질문을 늘려도 지연이 거의 늘지 않음)
- 모델 라우팅:
ModelRouterMiddleware의 fast/powerfulcriteria를 우리 작업 유형에 맞게 적고, agent state에 남는 확률·confidence로 오분류를 추적하기 - 오토 모드:
AutoModeMiddleware(tools=[...])를 bash처럼 파괴적일 수 있는 도구부터 적용하기 - 온라인 eval: 기존 LLM-as-a-judge 루브릭을 Jev 채점으로 옮겨 비용·일관성을 나란히 비교하기
원문 인용 모음
- [01:52] “System one models are a class of AI models built to make fast, structured decisions that software can use directly.”
- [02:14] “Jev actually doesn’t take text in and then generate text out like the traditional LLMs that we’re used to.”
- [02:24] “it can be 20 to 200 times faster and 40 to 400 times cheaper on classification style tasks compared to LLMs.”
- [02:35] “Jev is not a drop-in substitute for an LLM, but it can do specialized tasks that we currently ask LLMs to do much faster and much cheaper.”
- [05:16] “you can actually send a single state with many questions that Jev answers in parallel.”
- [07:02] “I actually turned off auto mode in my coding agent recently because the classification step of whether a given tool call was risky was too slow … But, it’s back on now that Jev can make decisions so quickly.”
- [08:31] “much cheaper and much faster, but also interestingly much more reliable and consistent across evals than the LLM alternative.”
관련 노트
- jev — Jev 엔티티(정의·질문 3유형·설계 원칙)
- moc-jev — Jev 생태계 노트 맵
- 2026-09-19-typesafe-use-case-map — 모델 라우팅·가드레일 등 TypeSafe 공식 활용 지도
- 2026-09-20-typesafe-ai-skills — TypeSafe 공식 스킬: System One 설계 원칙과 판단 프리미티브
- 2026-09-20-diogo-almeida-after-rlhf — Jev를 만든 Diogo Almeida의 강연
- harness · langchain-deep-agents — 에이전트 하네스, LangChain 에이전트 스택