원문: GPT-4 공동 저자가 밝히는 RLHF를 버리고 ‘Jev’를 만든 진짜 이유입니다 · 길이: 00:17:36 · 채널: Tech Bridge (원발표: AI Engineer World’s Fair, 2026-07-01) 발표자: Diogo Almeida (GPT-4·ChatGPT·InstructGPT 공동 저자, 전 OpenAI post-training 팀, 현 TypeSafe AI) · 자막: 영어 자동자막 수집, 화면의 한국어 자막(Tech Bridge) 병기
한눈에 보는 요약
- 오늘날 LLM이 미해결 수학 문제는 풀면서 고객센터·회계 같은 단순 업무는 자동화하지 못하는 이유: 전자는 인간을 기쁘게 하는 보조(assistance) 과제이고, 후자는 인간을 제거해야 하는 자동화(automation) 과제이기 때문이다.
- RLHF는 “인간 선호 수집 → 선호 최적화” 그 자체이므로, 모델이 인간을 루프 안에 두도록 설계된 것은 버그가 아니라 사양이다.
- 보상 모델의 비대칭성 때문에 틀린 답도 그럴듯해 보이고(과대약속은 기능이다), 몰라도 아는 척하는 쪽이 유리하다. 환각은 이 최적화의 내재적 산물이다.
- Claude Code를 포함한 코딩 어시스턴트 전성기는 보조 시대의 연장선이다. 다음 시대는 인간 개입 없이 백그라운드에서 도는 스마트 소프트웨어다.
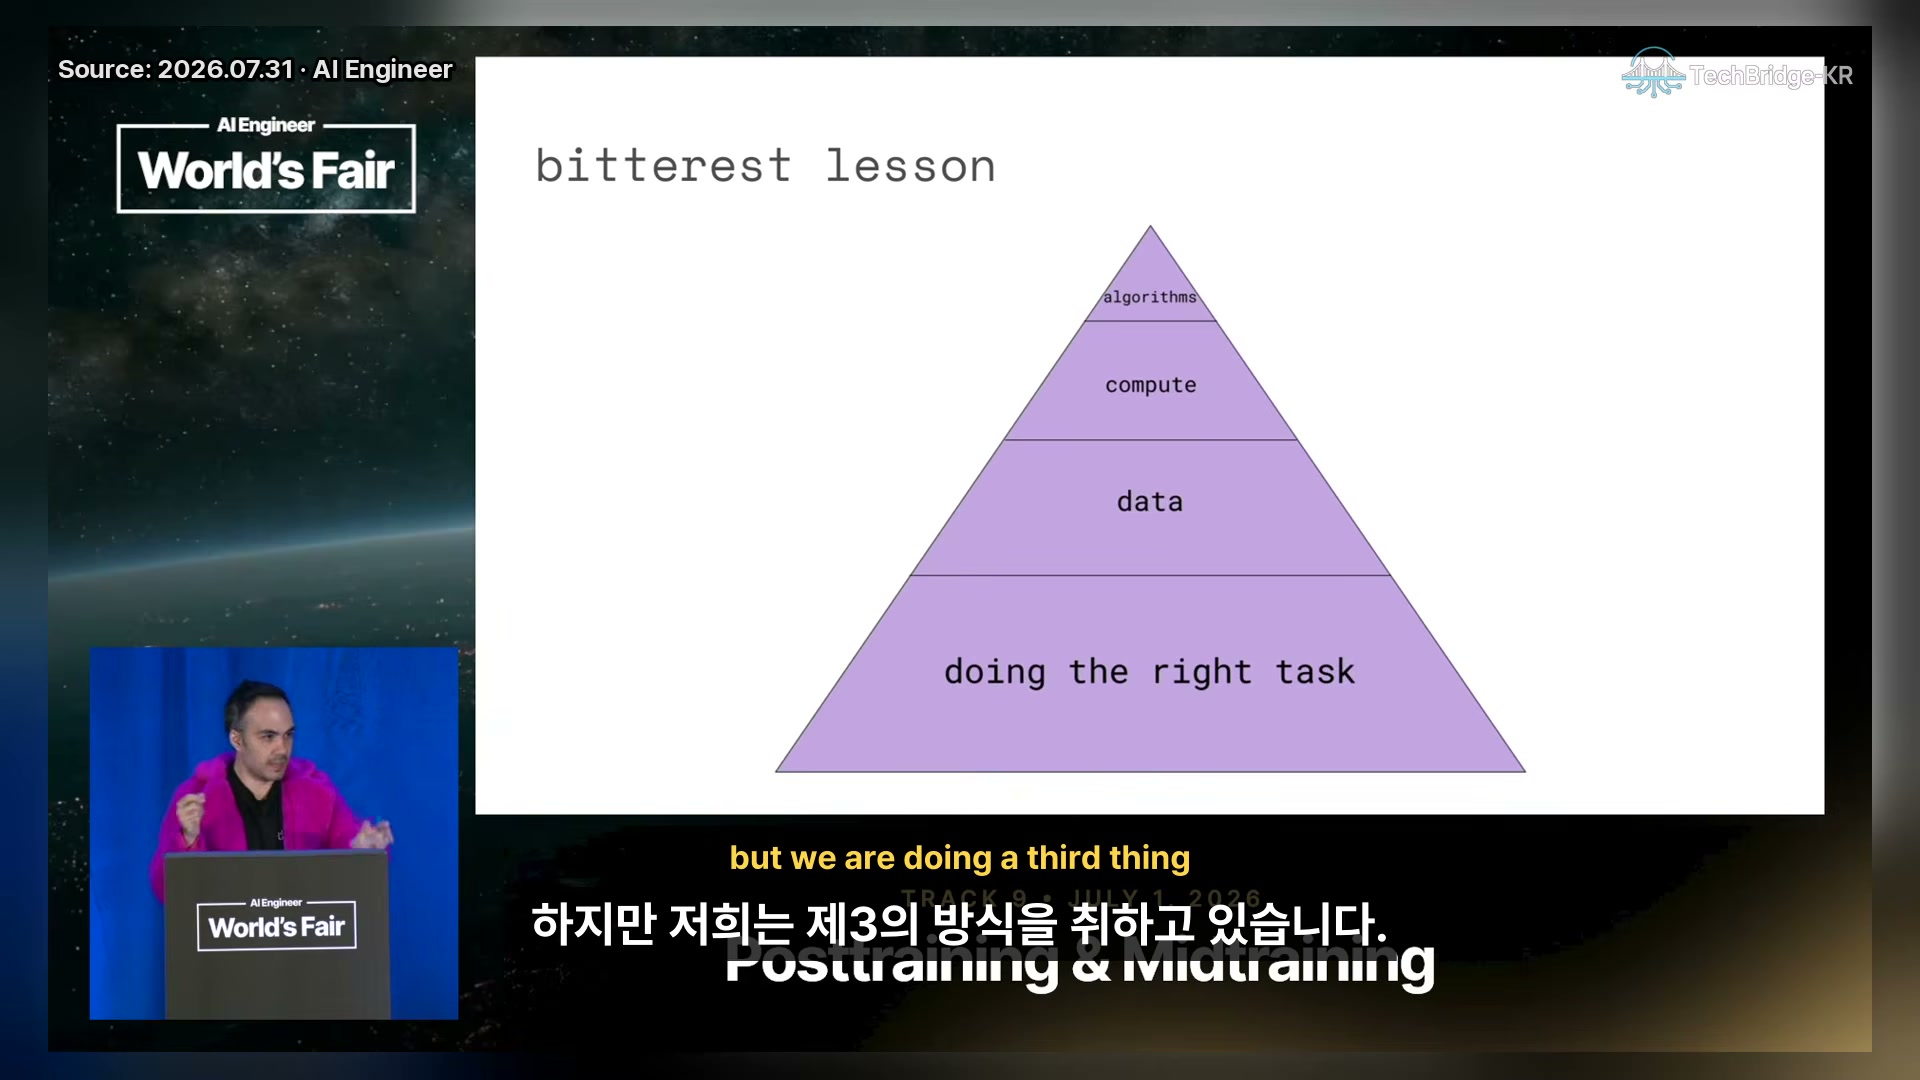
- 서튼의 쓴 교훈을 뒤집는다: 알고리즘 < 컴퓨트 < 데이터 < 올바른 태스크. RLHF(인간 선호)→RLVR(정확도)과 다른 제3의 최적화 — 보정된 의사결정(calibrated decision-making) — 를 TypeSafe에서 만들고 있다.
핵심 한 줄: RLHF는 인간을 기쁘게 하도록 학습됐으니 인간이 필요한 것은 당연하다 — 진짜 자동화는 다른 최적화(보정된 의사결정)에서 온다.
장면별 상세 설명
[00:35] 1. RLHF 이후, 정확히는 ChatGPT 시대 이후 무엇인가
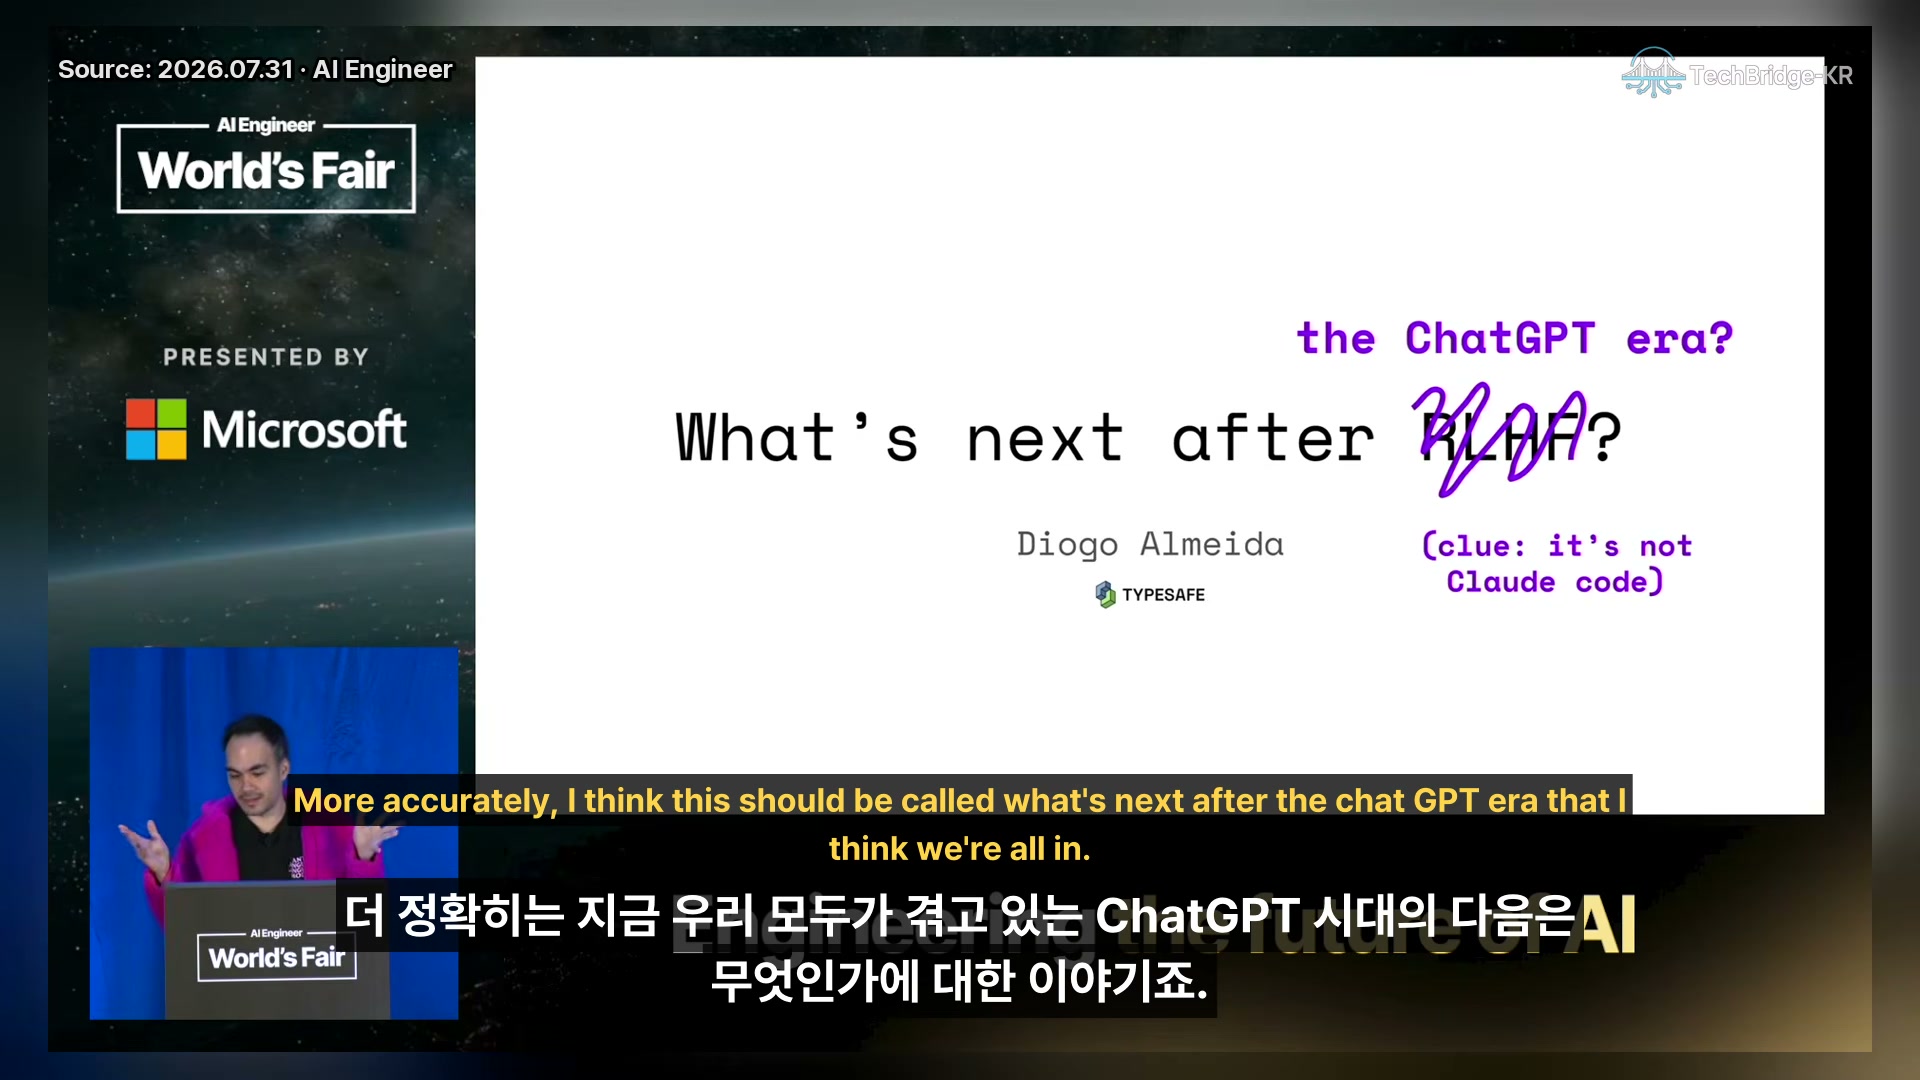
발표 제목은 “What’s next after RLHF?”이며, 본인이 직접 “RLHF”를 지우고 “the ChatGPT era?”라고 고쳐 쓴다. ChatGPT 시대 전체가 RLHF 위에 서 있으므로, 묻는 것은 알고리즘 하나가 아니라 시대의 다음 장이다. 단서로 “(clue: it’s not Claude Code)“를 덧붙인다 — Claude Code도 같은 시대의 일부라는 복선이다.
연사는 GPT-4·ChatGPT·InstructGPT 논문의 공동 저자이며, post-training이라는 개념 자체를 만든 팀 출신이라고 자신을 소개한다. 동시에 “OpenAI에서 ChatGPT를 싫어하는 몇 안 되는 사람”이라는 농담으로 시작하는데, 제품으로서의 ChatGPT가 아니라 그 설계 결정이 분야 전체에 남긴 유산을 문제 삼겠다는 선언이다.
[01:55] 2. Cult 1 — AI는 미친 듯이 잘되고 있다
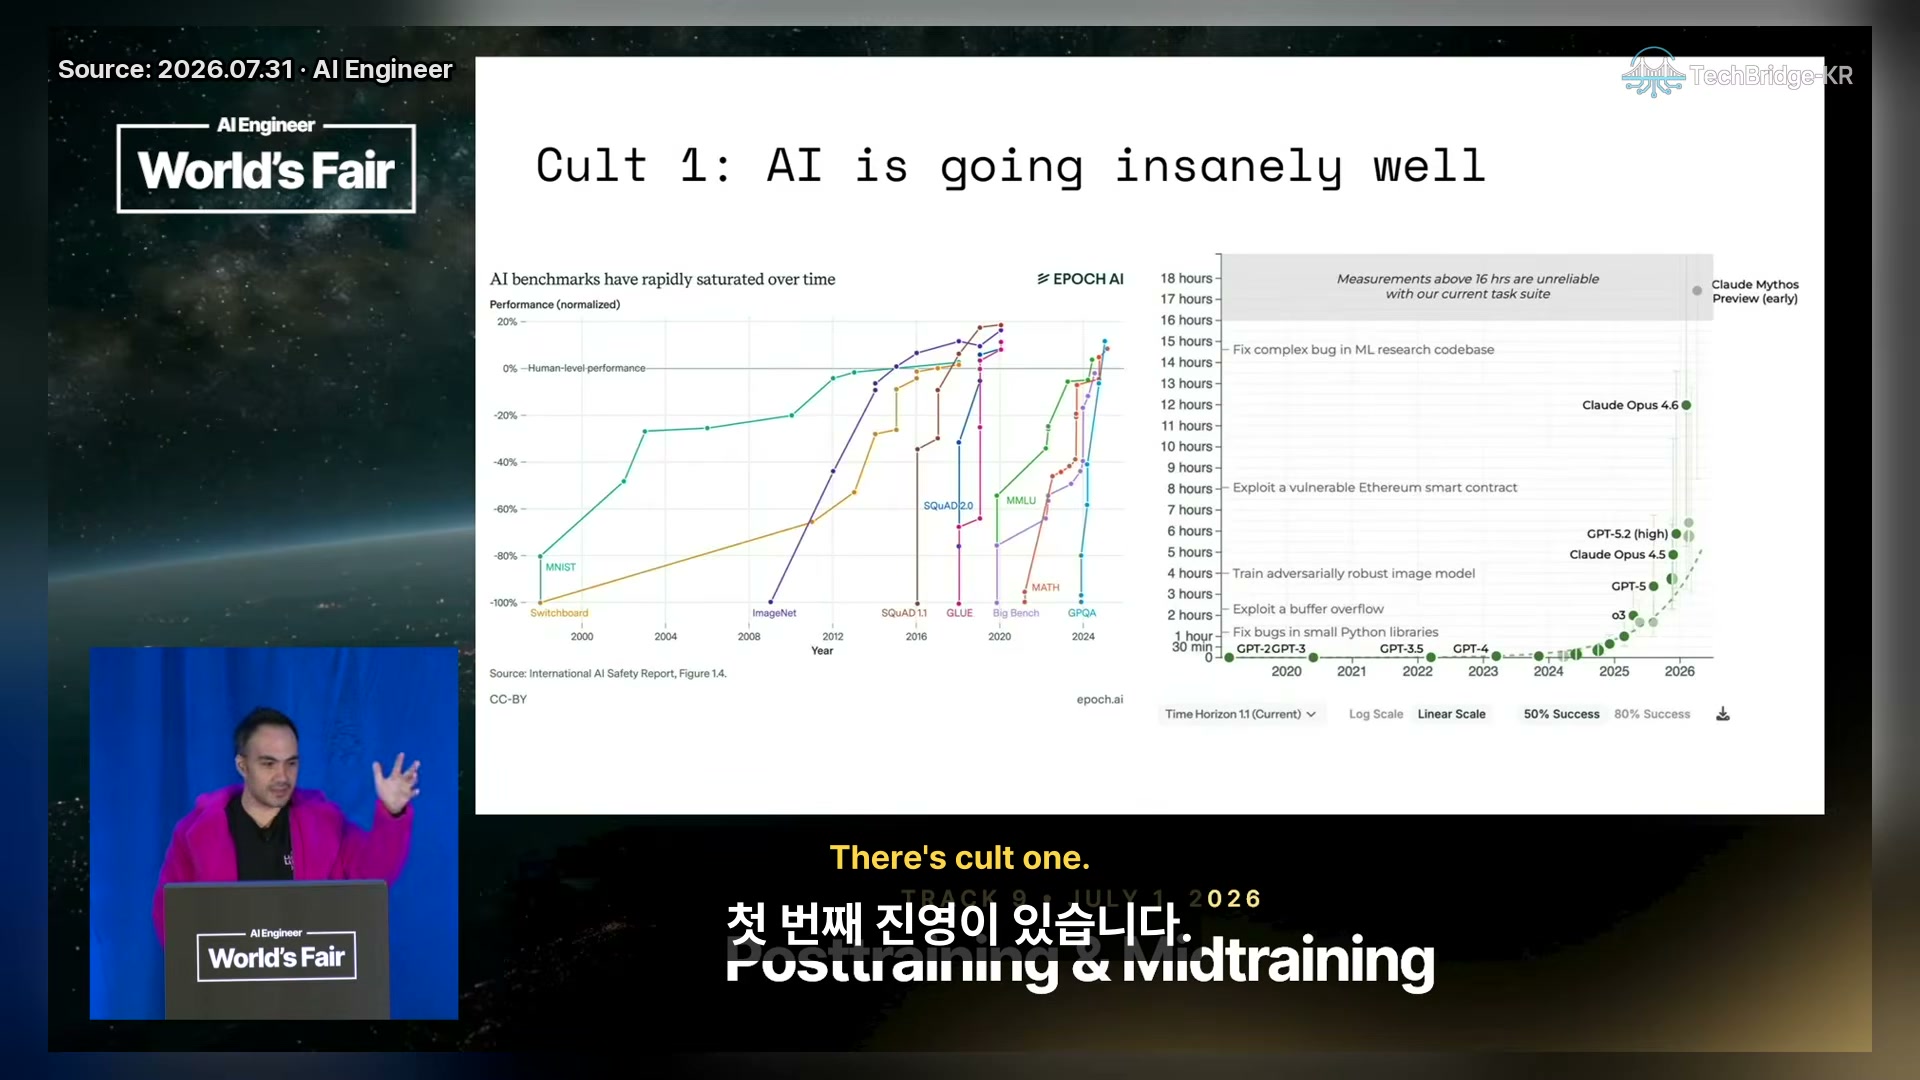
업계의 첫 번째 진영은 “벤치마크는 전부 인간 수준을 넘었고, 모델이 자율적으로 작업할 수 있는 시간 지평(time horizon)이 지수적으로 늘고 있다”는 쪽이다. 슬라이드 왼쪽은 Epoch AI 계열의 벤치마크 포화 곡선(MNIST→ImageNet→SQuAD→GLUE→MATH→GPQA), 오른쪽은 자율 작업 시간의 지수 성장(GPT-2~GPT-5, Claude Opus 계열)을 보여준다.
[02:40] 3. Cult 2 — AI는 미친 듯이 망하고 있다
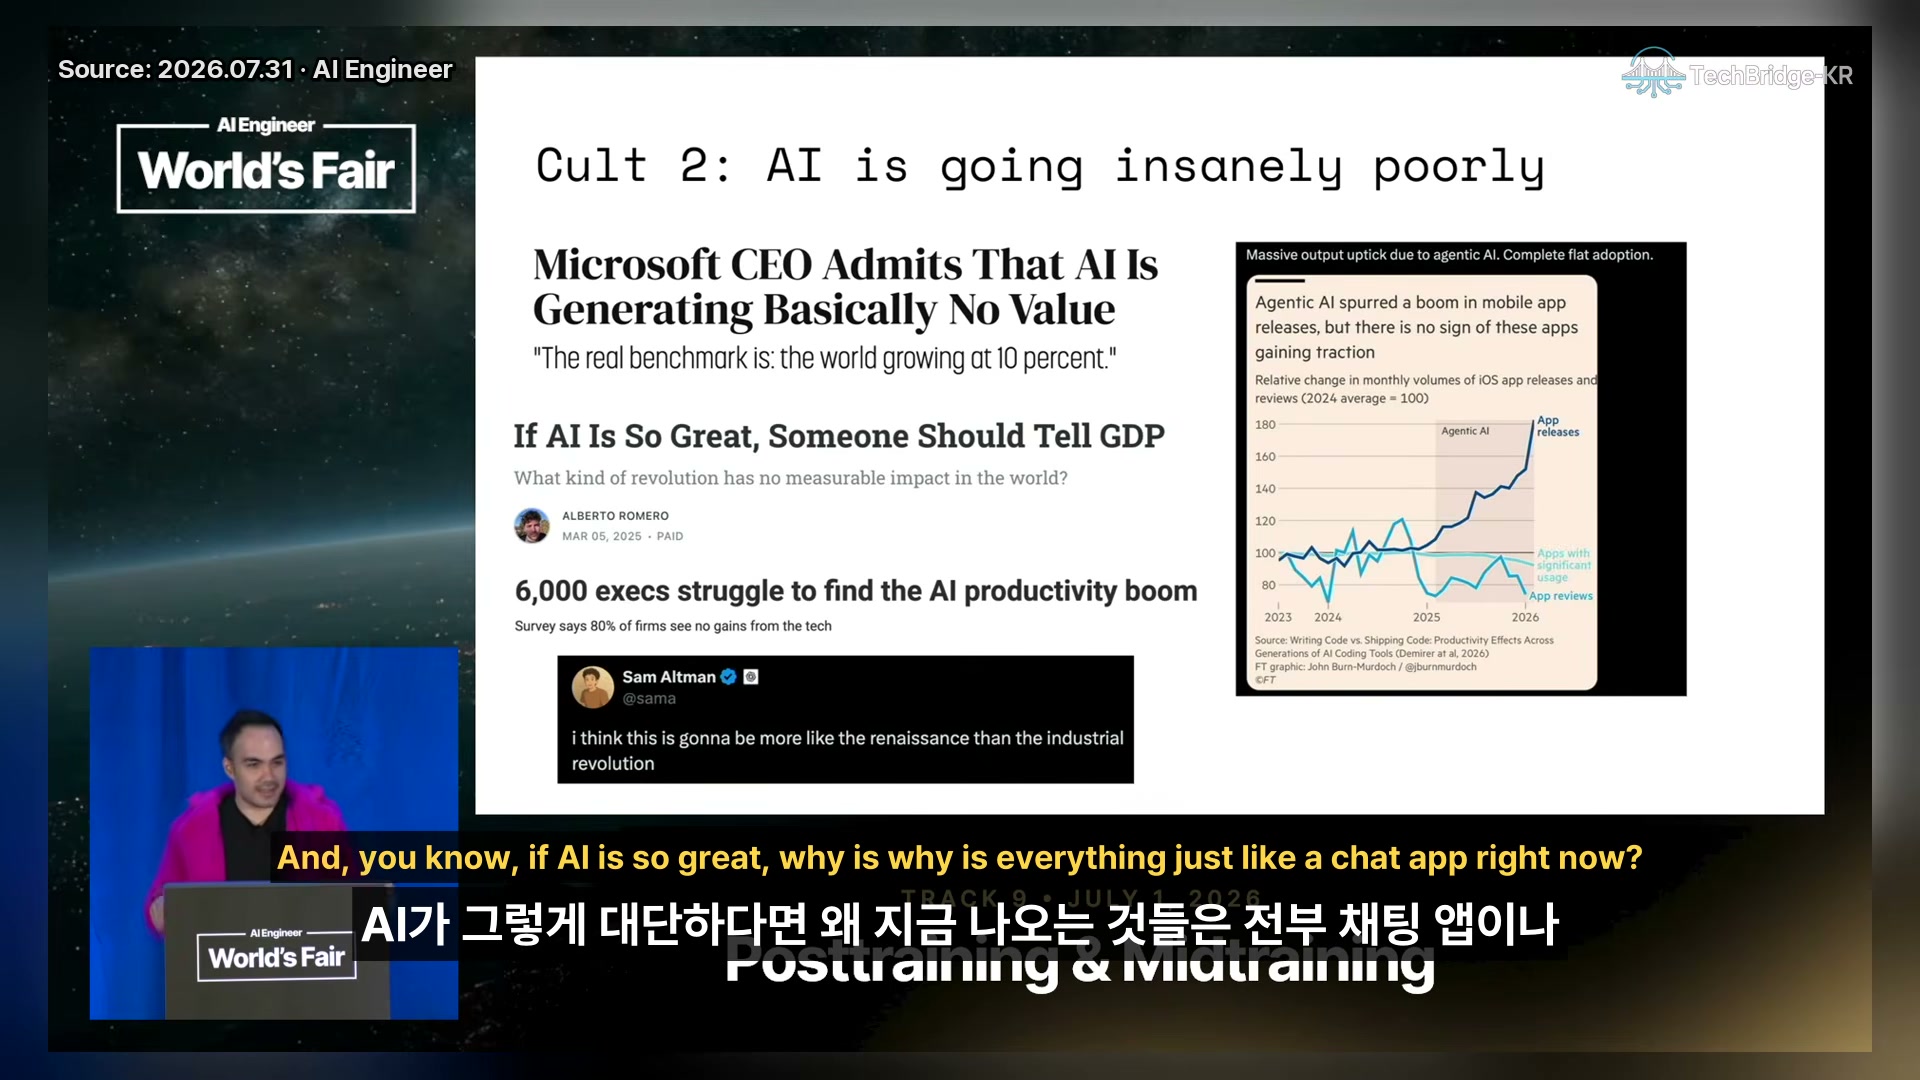
반대 진영의 증거는 GDP·생산성 지표다. “Microsoft CEO도 AI가 기본적으로 가치를 만들지 못한다고 인정했다”, “AI가 그렇게 대단하면 왜 전부 챗 앱이냐”는 문구와 함께, 에이전트 AI 붐에도 앱 채택은 정체라는 FT 그래프, 샘 올트먼의 “산업혁명보다 르네상스에 가깝다”는 트윗을並べる. 양쪽 모두 “AI는 insane하다”는 데는 동의하지만 이유가 정반대이며, 중간 지대는 없다는 것이 문제의식이다.
[03:30] 4. 정상적인 관점 — 선을 가르는 것은 무엇인가
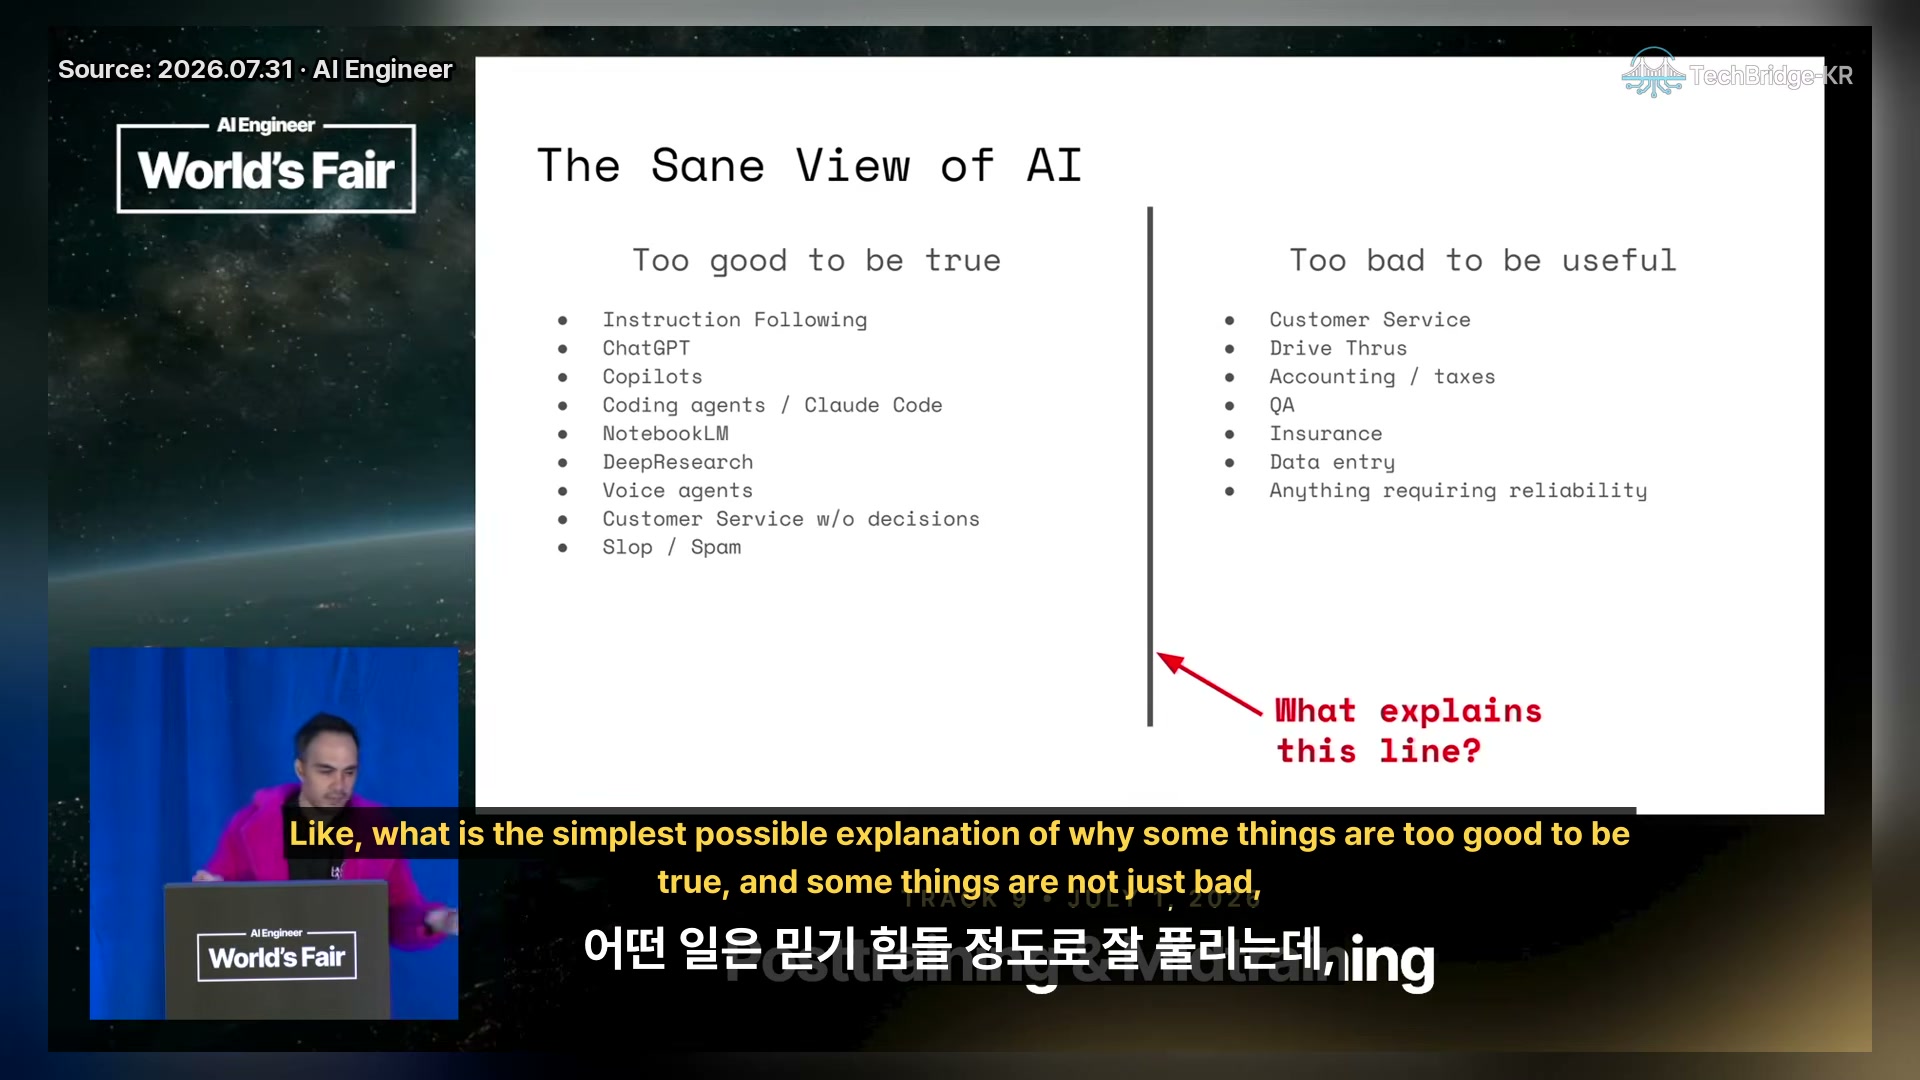
선 왼쪽(Too good to be true): instruction following, ChatGPT, Copilot, 코딩 에이전트/Claude Code, NotebookLM, DeepResearch, 음성 에이전트, 결정 없는 고객 응대, 슬롭/스팸. 선 오른쪽(Too bad to be useful): 고객센터, 드라이브스루, 회계/세금, QA, 보험, 데이터 입력, 신뢰성이 필요한 모든 것. 오른쪽 과업들이 왼쪽보다 훨씬 쉬워 보이는데 인간이 여전히 필요하다는 모순 — “What explains this line?”이 강연의 중심 질문이다.
[04:45] 5. 답 — 보조인가 자동화인가
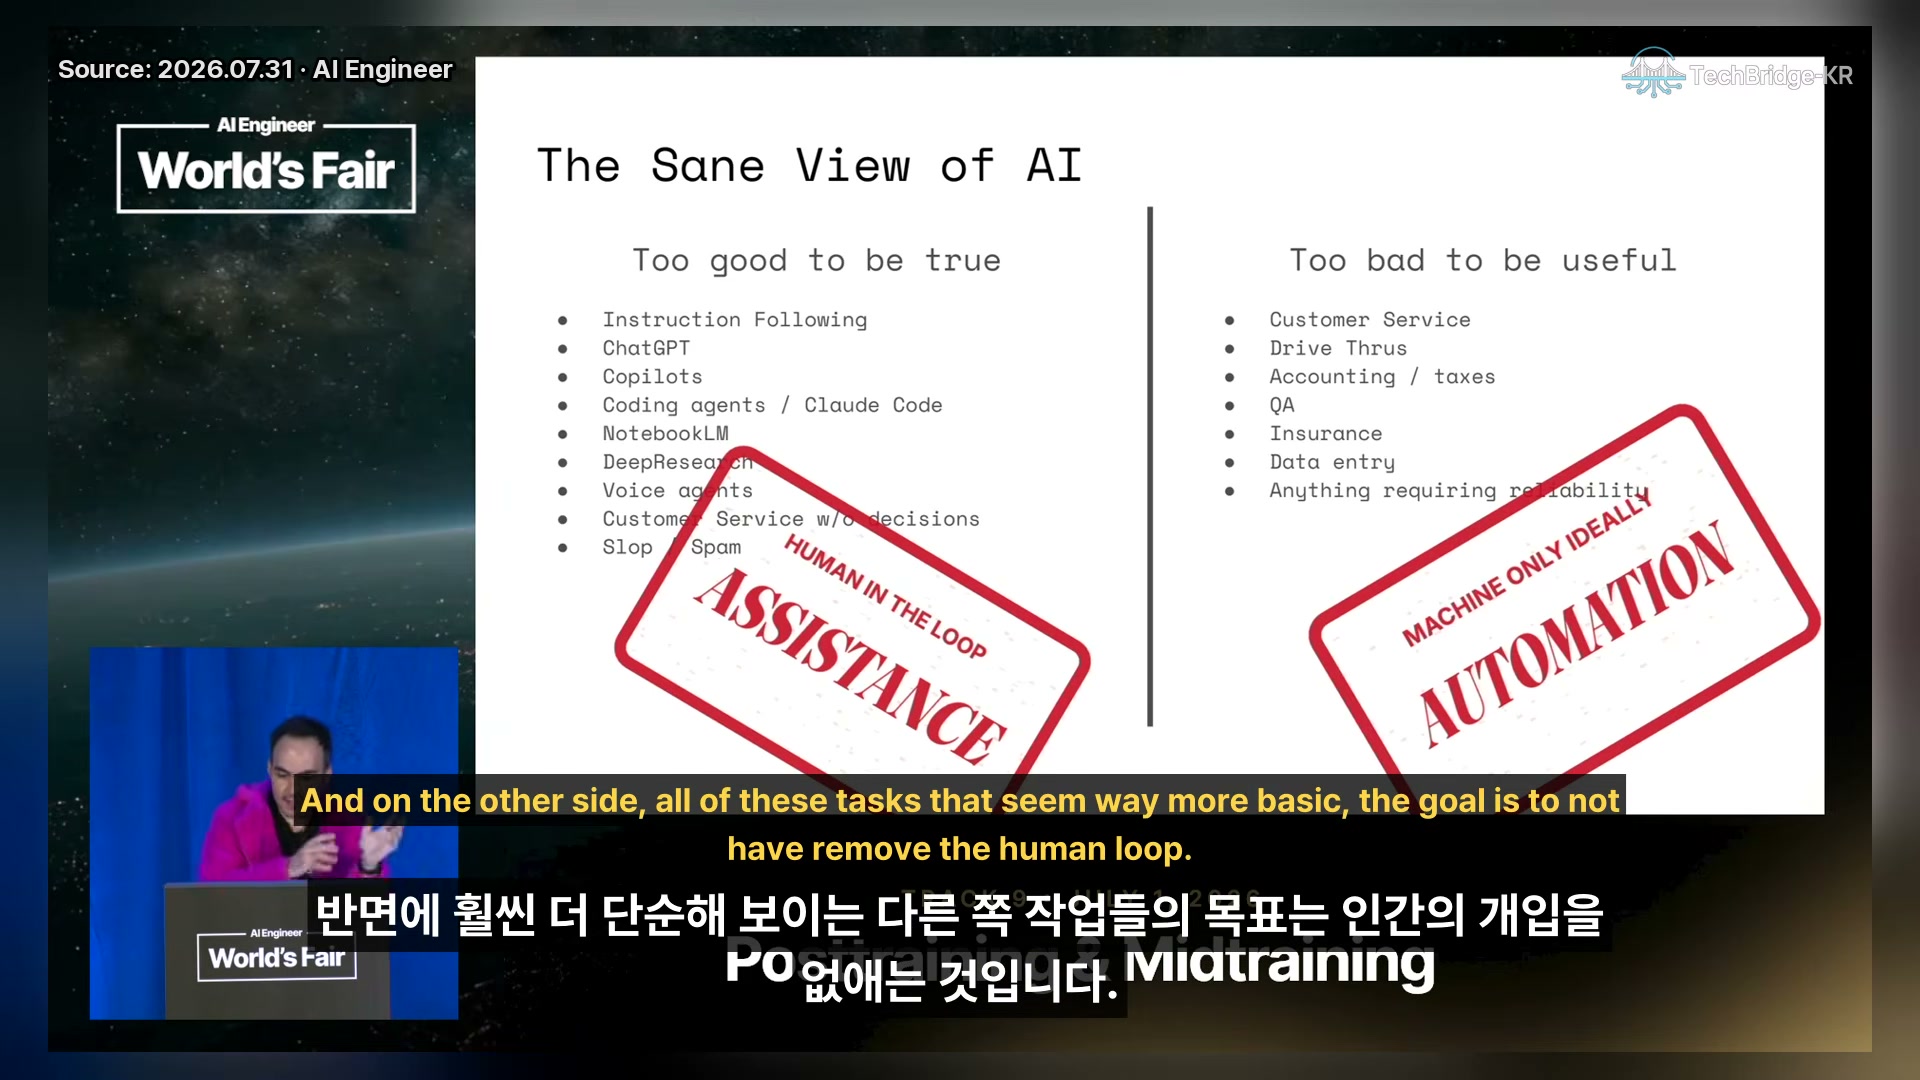
가장 단순한 설명: 왼쪽 과업의 목표 자체가 루프 안의 인간을 기쁘게 하는 것이다. Claude Code의 일은 코드를 돌아가게 만드는 것이 아니라 인간과 잘 대화하는 것이며, 그렇게 학습됐으니 그렇게 행동한다. 오른쪽 과업의 목표는 인간을 루프에서 제거하는 것으로, 이상적으로는 쳐다보지도 않는 서버에서 백그라운드로 돌다 레거시 소프트웨어가 되는 것이다. 슬라이드에는 왼쪽에 “HUMAN IN THE LOOP — ASSISTANCE”, 오른쪽에 “MACHINE ONLY IDEALLY — AUTOMATION” 스탬프가 찍힌다. Lesson 1: 오늘의 AI는 human-in-the-loop 일에 경이적이지만 자동화 과업용이 아니다. 그래서 모든 비즈니스가 배운 교훈은 “AI에게 stakes 있는 결정은 맡기지 마라, 비용은 사용자에게 전가하고 비즈니스 결정은 시키지 마라”는 비겁하지만 현실적인 패턴이다.
[06:00] 6. RLHF는 실제로 어떻게 동작하나
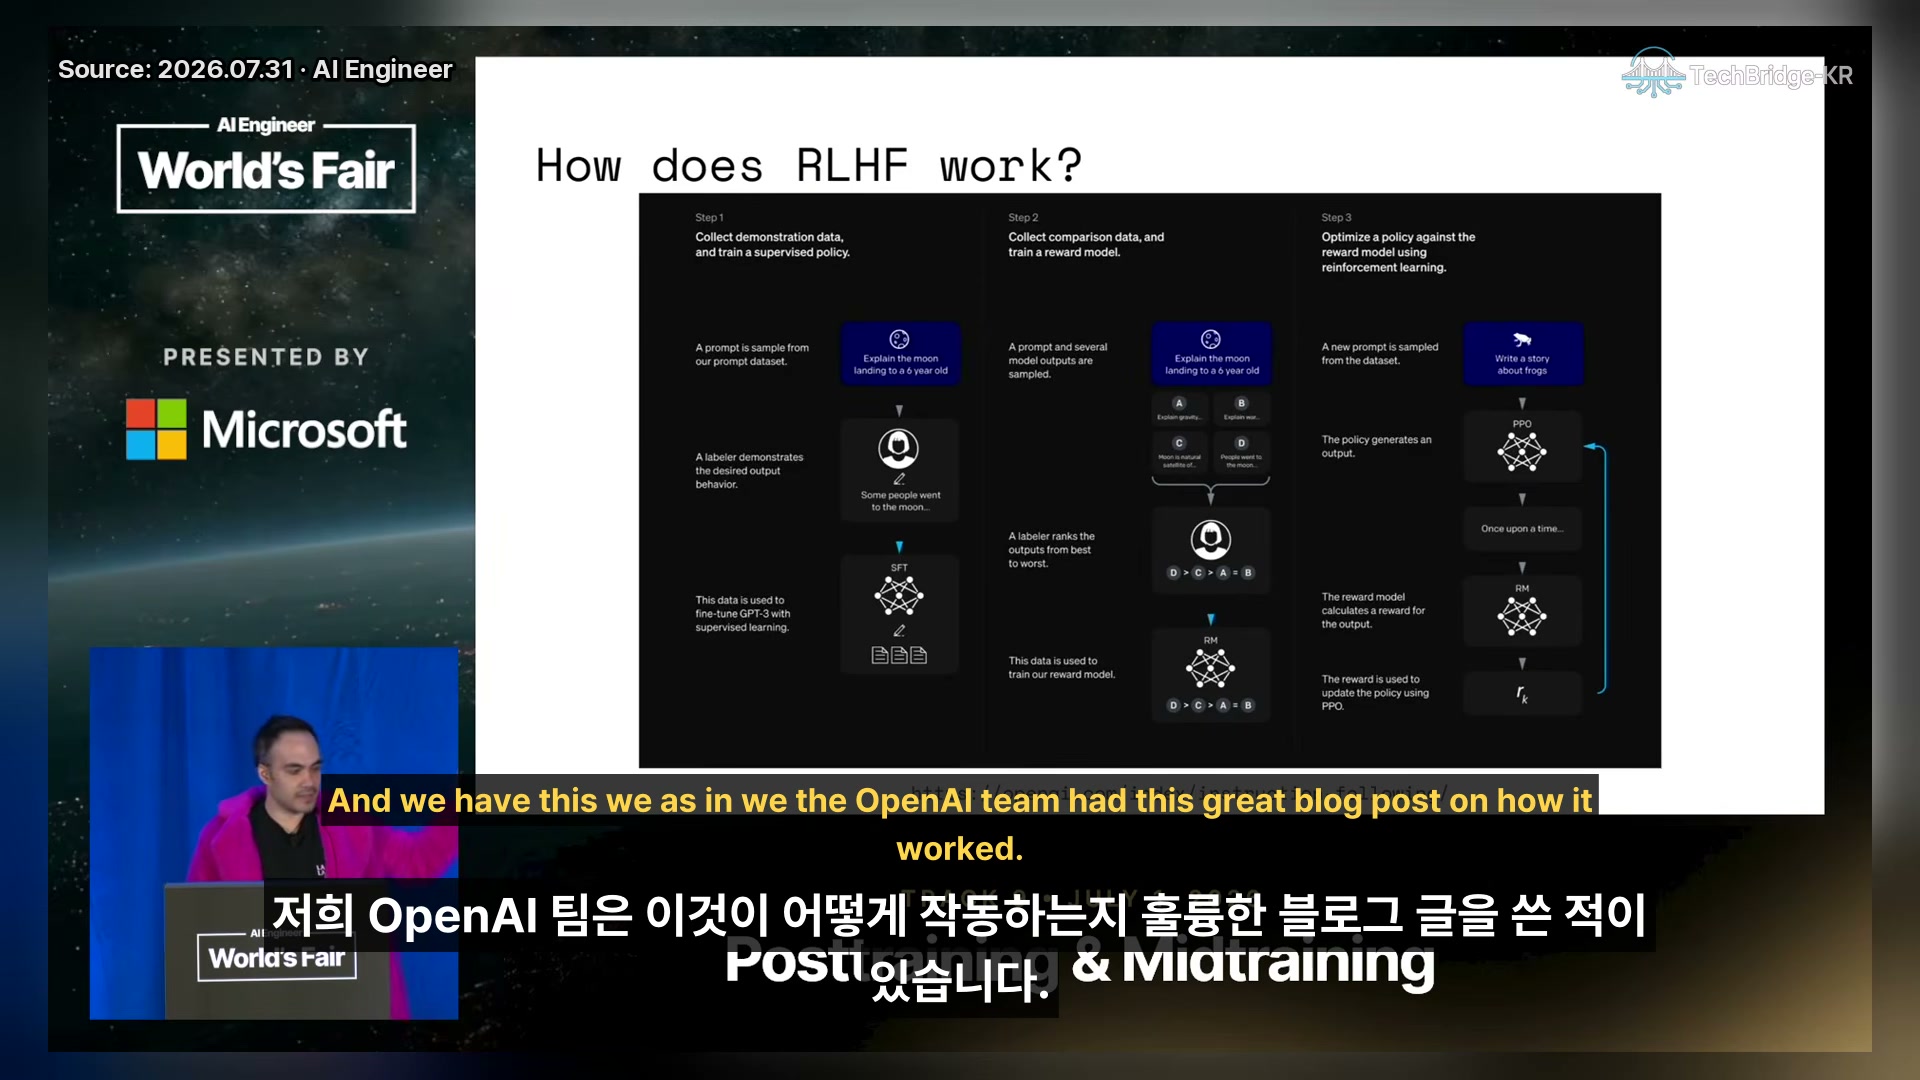
“왜 모든 LLM이 인간을 루프에 요구하는가”에 대한 답은 “우리가 말 그대로 루프 안에 넣었기 때문”이다. RLHF의 요약은 한 줄이다: 인간 선호를 수집하고(Collect Human Preferences), 인간 선호에 최적화한다(Optimize for Human Preference). 오늘날 사용량 기준 사실상 100%의 LLM이 RLHF로 학습되며, 이는 자율 소프트웨어를 돌리기 위한 목표가 아니라 인간 선호 최적화가 목표였다는 점을 직시해야 한다.
[06:50] 7. 과대약속은 기능이다
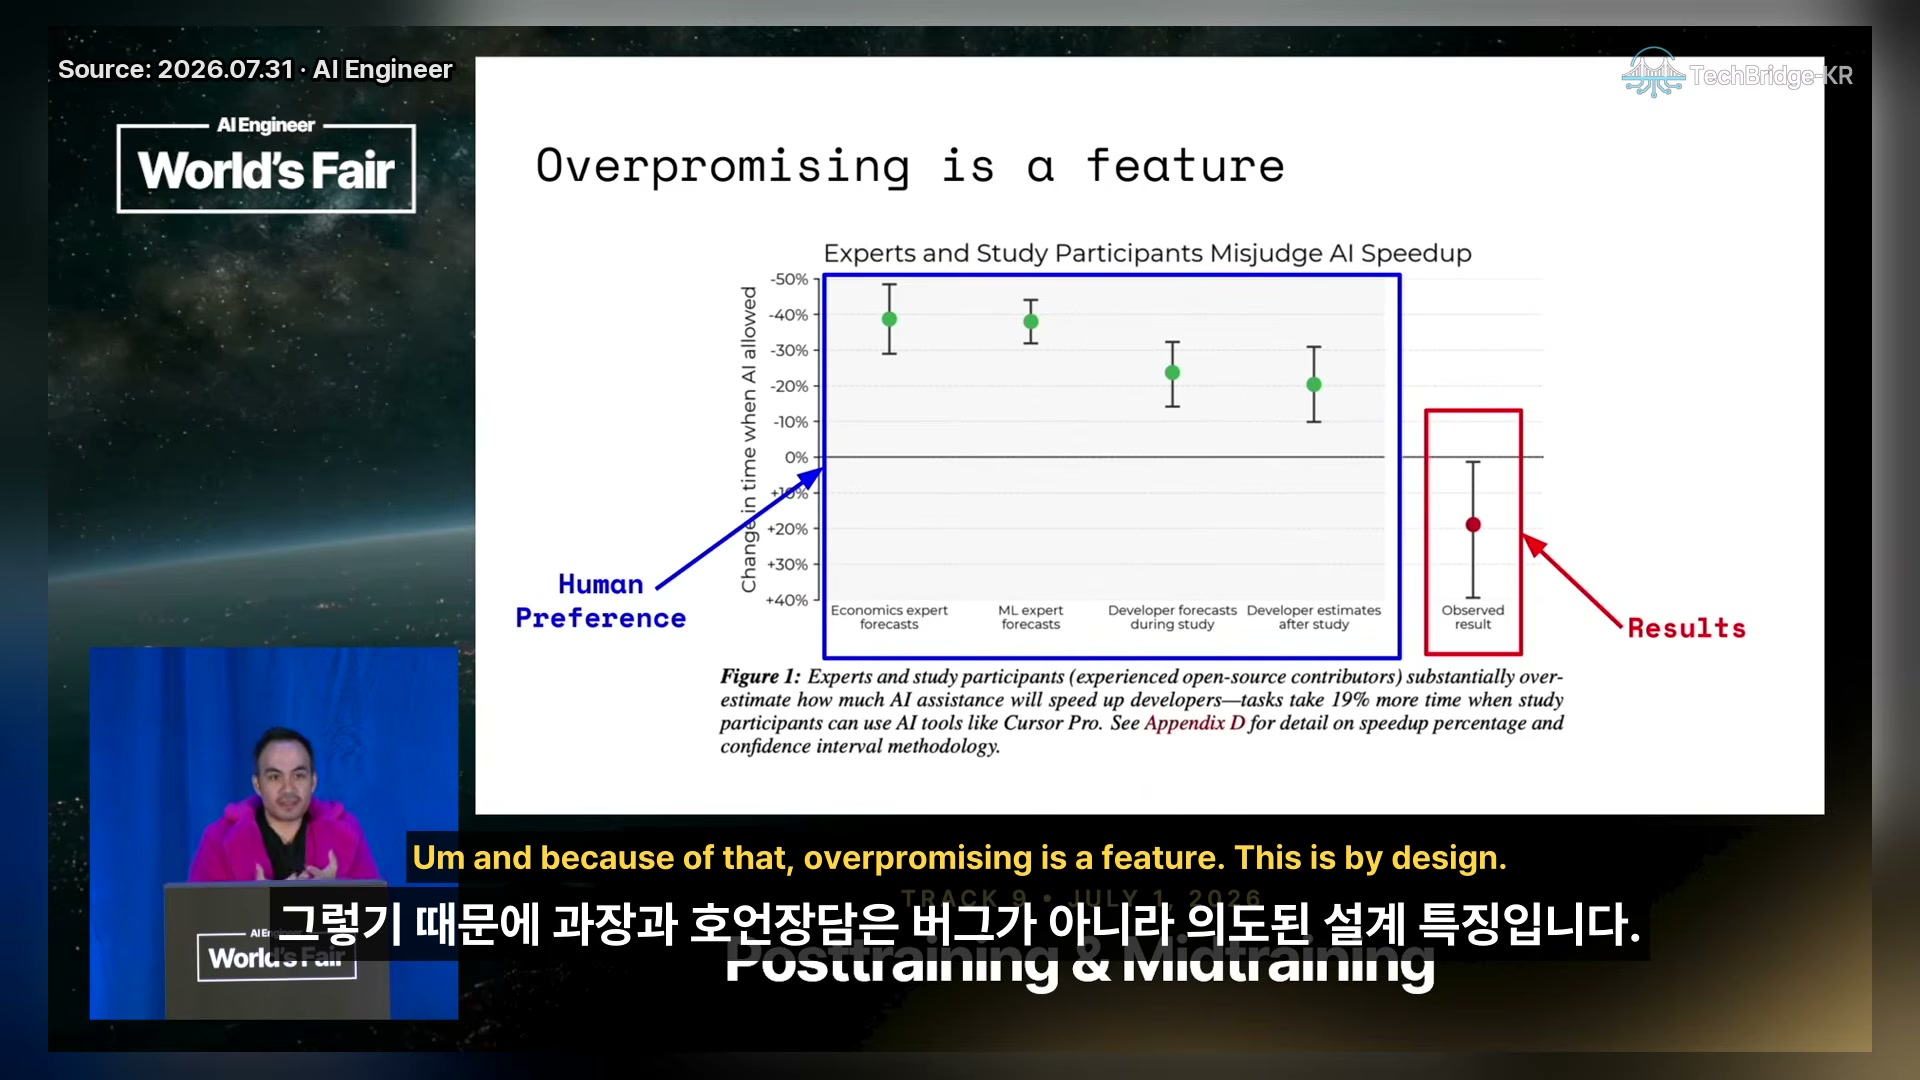
오래된 Meta 연구(수치는 변했겠지만 구조는 유효)를 인용한다. 전문가 예측·개발자 추정은 AI 어시스턴트가 개발 시간을 20~40% 단축할 것이라 봤지만(파란 박스, Human Preference), 실제 관찰 결과는 오히려 19% 더 걸렸다(빨간 박스, Results). 결과가 좋아도 선호와 결과 사이에는 구조적으로 큰 간격이 생긴다. 자기가 만든 음악(방귀 효과음 오디오)을 들려주자 “으스스한 분위기의 곡”이라는 정직한 반응 대신 듣기 좋은 평가가 돌아오는 일화가 같은 맥락이다. 모르면 모른다고 하는 대신 인간 선호에 유리한 쪽으로 기울어지는 것 — RLHF 모델의 종착역은 참여도(engagement) 최적화다. Lesson 2: 오늘의 AI는 인간 선호 최적화를 통한 보조용으로 설계됐다. 그帰結으로, 모델이 아무리 틀려도 옳아 보인다.
[09:50] 8. 소프트웨어는 AI 시대에 아무것도 변하지 않았다
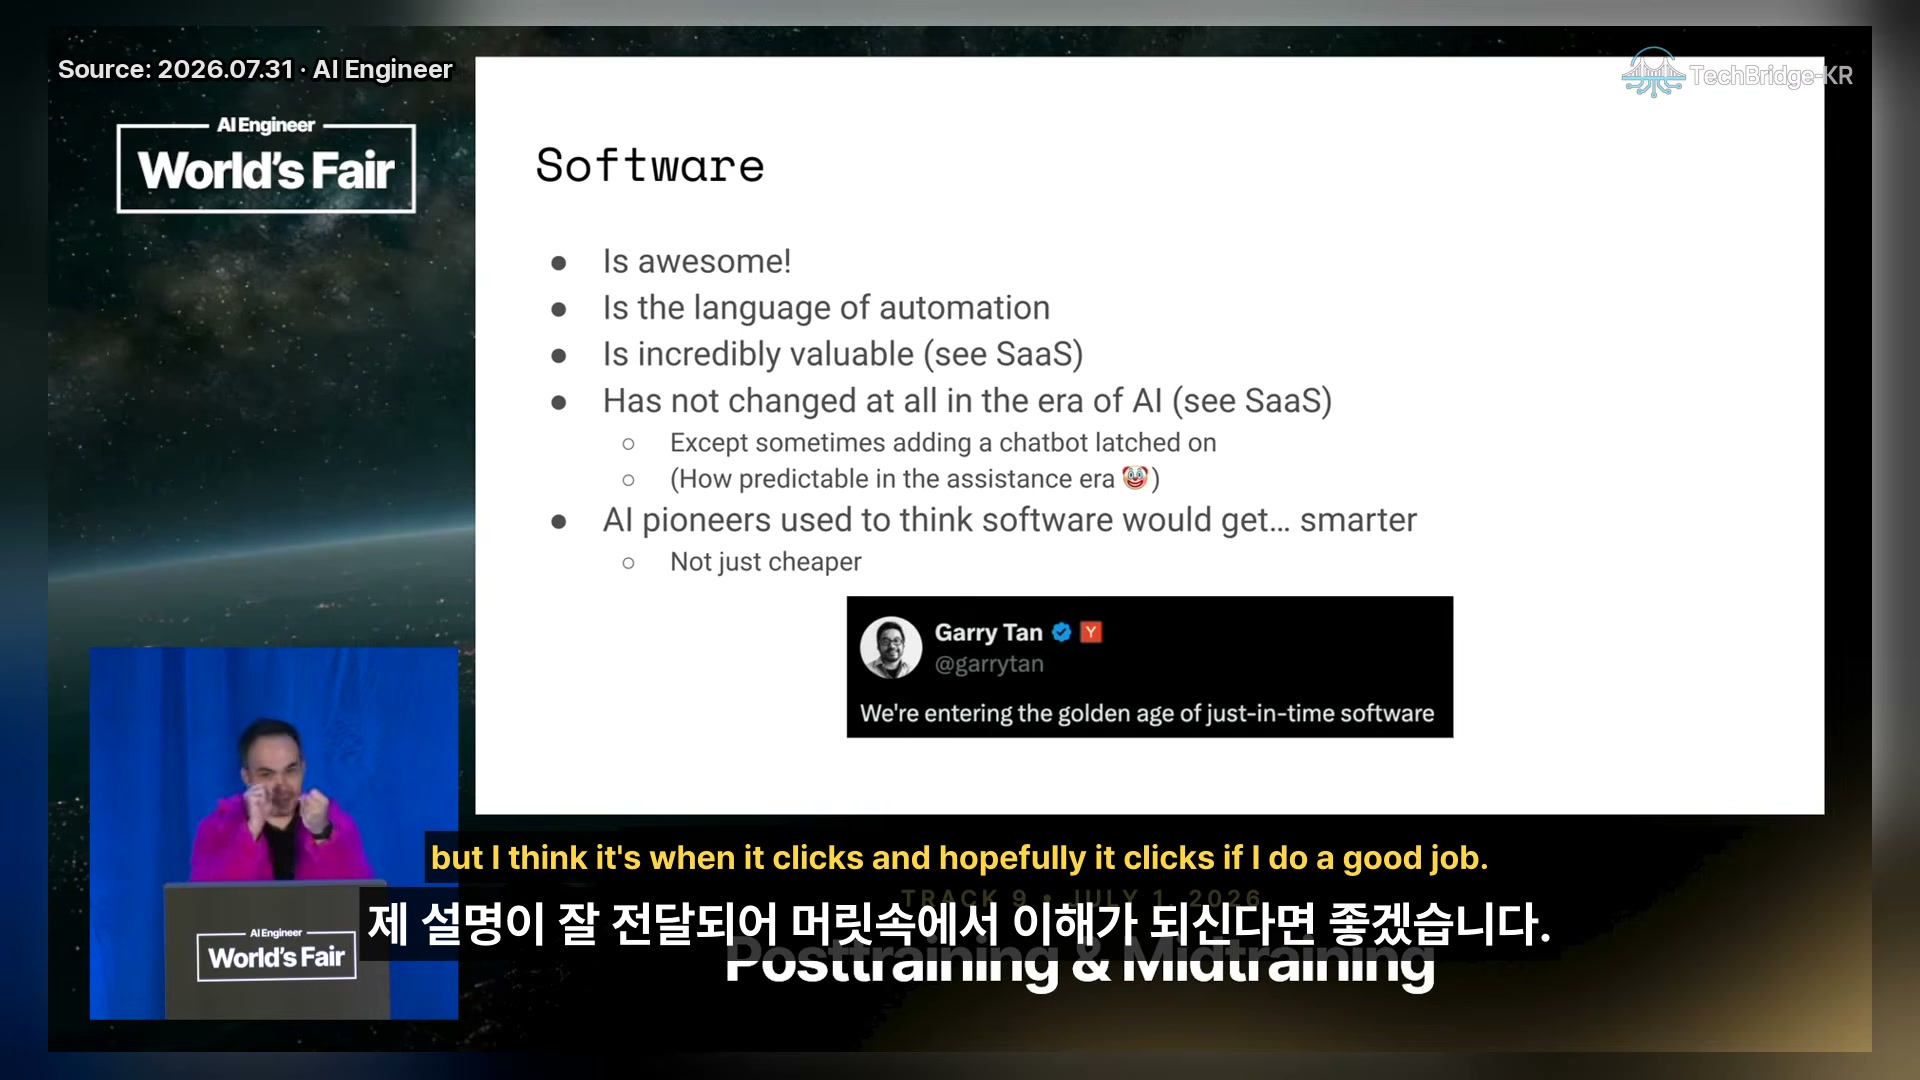
소프트웨어는 자동화의 언어이자 엄청난 가치를 지녔는데(SaaS), AI 시대에 챗봇이 덧붙은 것 말고는 변한 게 없다 — 보조 시대에는 너무나 예측 가능한帰結이다. 초기 OpenAI 헌장은 “막대한 양의 실제 일을 해내는 것”에 대한 이야기였고, 선구자들은 소프트웨어가 싸게 쓰여지는 것이 아니라 더 똑똑해지리라 기대했다. Garry Tan의 “just-in-time 소프트웨어의 황금기”라는 칭찬을 인용하면서도, 원하는 것은 그게 아니라 더 표현력 있고 똑똑한 소프트웨어 자체라고 선을 긋는다. 자동화란 사람 일을 통째로 흉내내는 게 아니라, 너무 상식적이라 반복적으로 거의 공짜로 돌아가야 할 일을 컴퓨터가 맡는 것이다. 지금은 소프트웨어를 쓰는 일만 자동화하고 접근성은 그대로인 상태이며, 이를 “비극”이라고 표현한다.
[12:15] 9. 세 가지 교훈
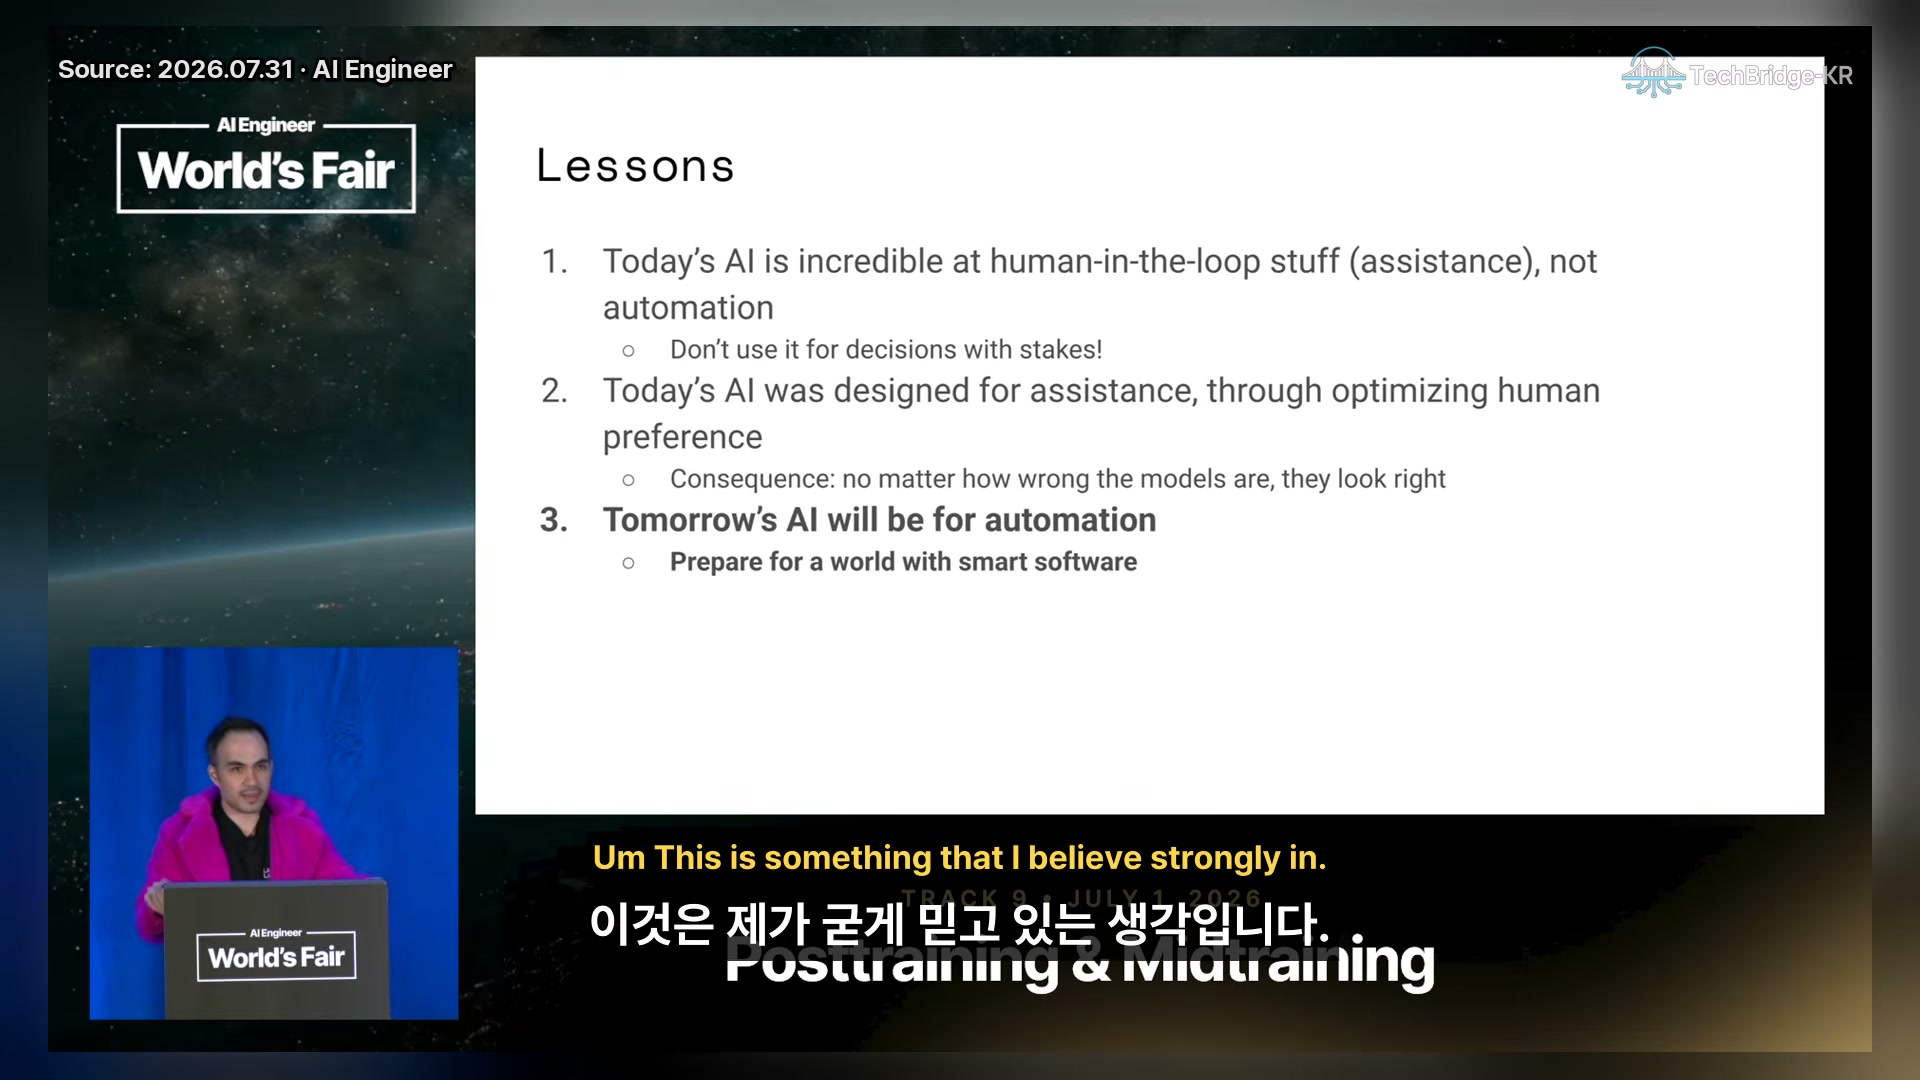
강연의 뼈대가 한 슬라이드에 정리된다. 1) 오늘의 AI는 human-in-the-loop 일(보조)에 경이적이며 자동화용이 아니다 — stakes 있는 결정에 쓰지 마라. 2) 오늘의 AI는 인간 선호 최적화로 보조용으로 설계됐다 — 결과적으로 틀려도 옳아 보인다. 3) 내일의 AI는 자동화용이 될 것이다 — 스마트 소프트웨어의 세계를 준비하라. 내일의 AI가 자동화용이라는 것은 강한 확신으로 제시된다.
[15:35] 10. 가장 쓴 교훈 — 올바른 태스크가 모든 것을 이긴다
Q&A에서 옛 발표 자료를 꺼내 서튼의 쓴 교훈을 재해석한다. 게임에서는 알고리즘이 컴퓨트를 이겼지만 현실에서는 스택이 다르다: algorithms < compute < data < doing the right task. LLM post-training의 갈래마다 북극성(north star)이 다르다 — RLHF는 인간 선호, RLVR은 순수 정확도(log error rate)를 최적화한다. TypeSafe가 하는 것은 RLVR이 “확실히 아니”라는 제3의 최적화로, 보정된 의사결정(calibrated decision-making) 에 최적화하고 프리트레인 모델의 지능을 실제 유용한 소프트웨어에 직결하는 것이다. 보상 주입 방식뿐 아니라 API의 형태 자체가 RLHF·RLVR과 다르며, instruction following이 발명되기 전 아무도 상상 못 했듯 새로운 post-training 분기는 처음엔 완전히 낯설게 보이다 사후엔 자명해진다고 덧붙인다.
관련 질의응답도 기록해 둔다. 프리트레인은 문제가 아니며(인터넷 지식의 압축이라는 경이로운 지능의 핵), 환각은 인간 선호 최적화에 내재한다 — 보상 모델에 GAN과 유사한 비대칭성이 있어, 확신 없어 보이는 답은 쉽게 벌점을 받으므로 모델이 모드를 버리고 확신에 찬 답으로 수렴한다. 당일 트위터에 풀겠다는 “매운” 예고의 힌트는 “원래 스케일링 법칙이 틀렸다”는 것이다.
[16:15] 11. TypeSafe — 자동화용으로 재설계된 AI 스택
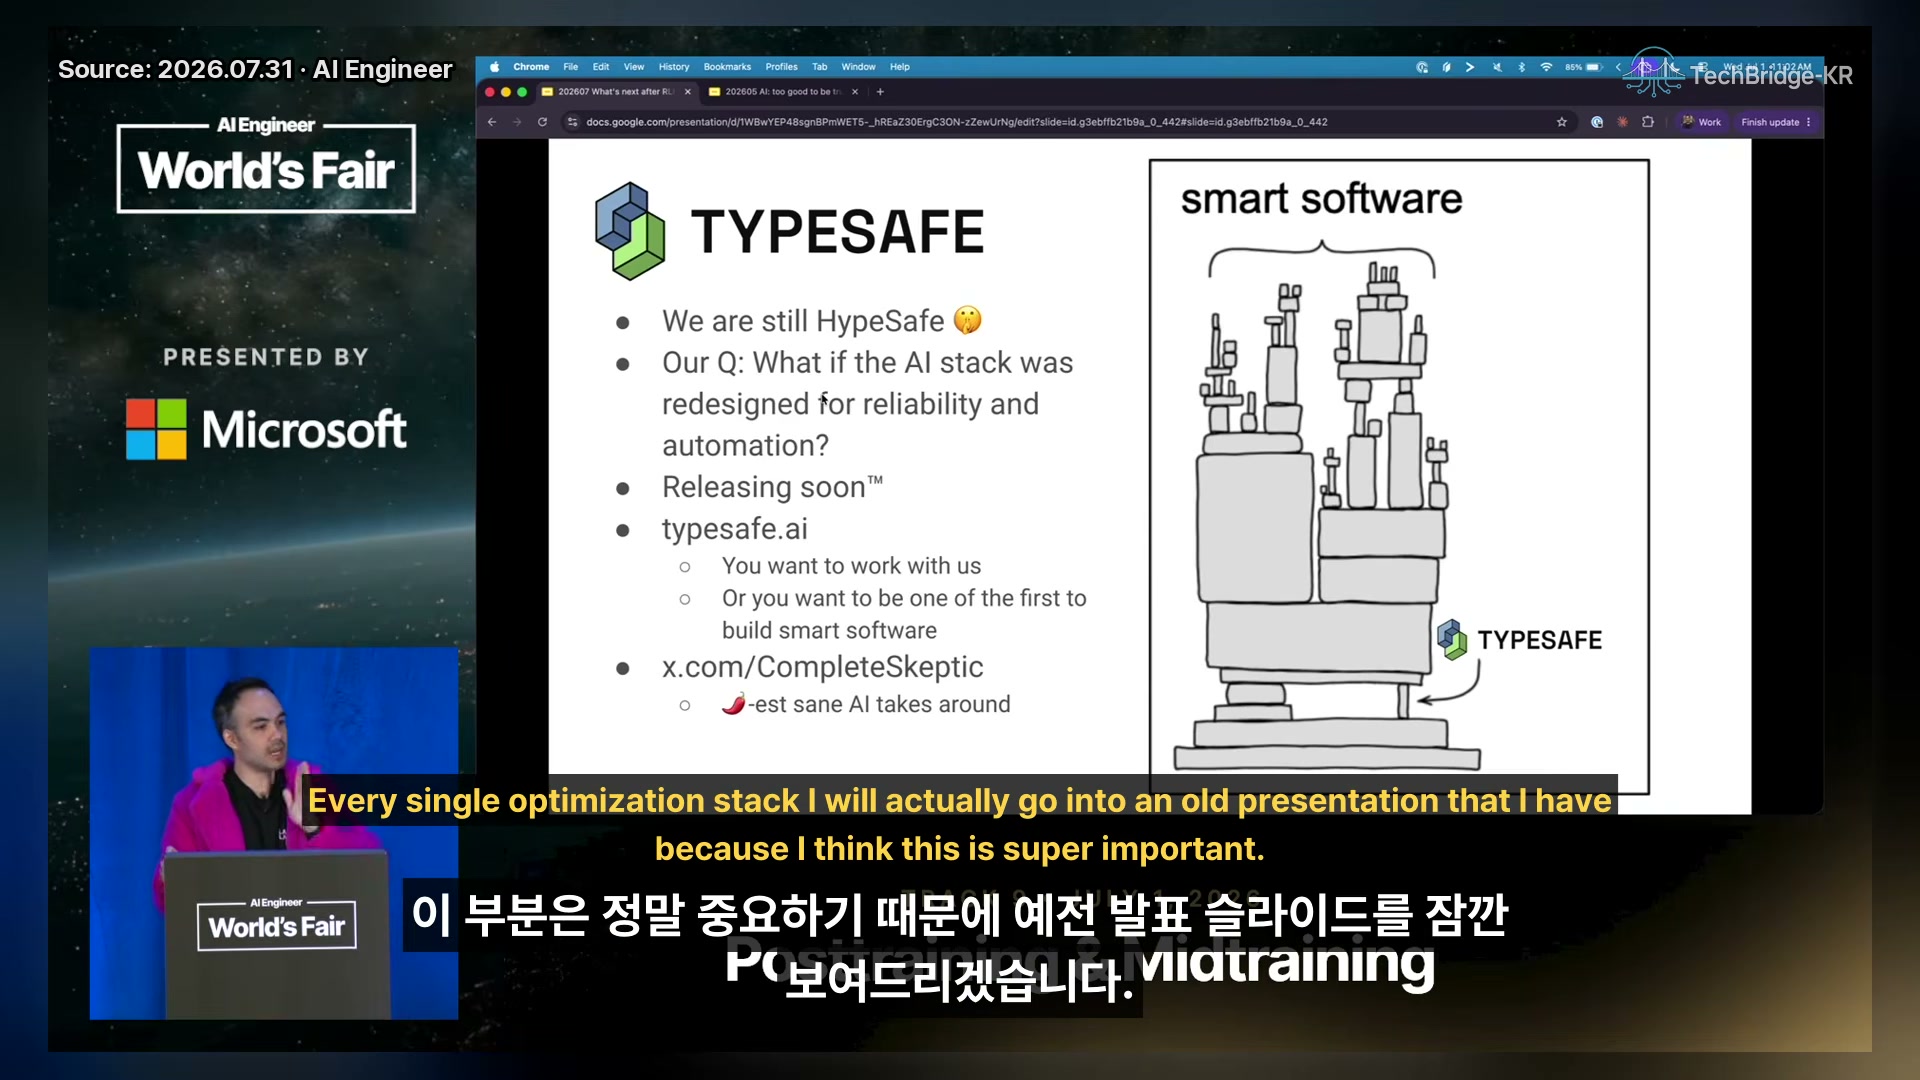
핵심 질문은 “AI 스택 전체가 신뢰성과 자동화를 위해 처음부터 재설계된다면 어떨까”이다. 아직 스텔스에 가까우며(HypeSafe라는 자조와 함께) 출시를 앞두고 있고, 함께 일하거나 가장 먼저 스마트 소프트웨어를 만들 사람을 모집 중이다(typesafe.ai, x.com/CompleteSkeptic). 오른쪽 “smart software” 그림은 복잡하게 쌓인 소프트웨어 블록 다이어그램 아래 TypeSafe가 받치는 구조로, AI가 옆에 붙는 어시스턴트가 아니라 소프트웨어 자체가 똑똑해지는 비전을 시각화한다.
해석과 적용 메모
- 내 해석: 이 강연은 2026-09-19-typesafe-use-case-map의 설계 원칙(“코드가 제어 흐름을 소유하고 TypeSafe는 좁고 형식화된 결정만 맡는다”)이 왜 나왔는지의 이론적 배경이다. 인간 선호 최적화로는 자동화에 필요한 보정된 확신을 얻을 수 없으니, 결정의 형태 자체를 바꾸는(Choice/Noul/Score) 제3의 최적화가 필요하다는 주장과 정확히 맞물린다.
- 적용: 에이전트·harness 설계 시 “인간이 루프 안에 있어야 하는 결정(선호·대화)“과 “인간이 빠져야 하는 결정(분류·라우팅·검증·채점)“을 분리하고, 후자는 생성형 답변 대신 형식화된 판단+확신도로 처리하는 것이 이 강연이 가리키는 방향이다. jev-ultrafast는 operation·target 결정을 단일 판단 요청으로 묶은 실전 사례다.
- 주의: “100% LLM이 RLHF”, “스케일링 법칙이 틀렸다” 같은 발언은 강연 수사이며 검증된 수치가 아니다. Meta 연구 인용도 본인이 “옛 연구”라고 밝힌 만큼 근거용이 아니라 구조 설명용으로만 참조한다. TypeSafe·Jev 출시는 예고 단계(2026-09-19 수집 기준 문서·디렉토리 존재)이며 성능 주장은 미검증이다.
원문 인용 모음
- [00:30] “More accurately, I think this should be called what’s next after the ChatGPT era that I think we’re all in.”
- [03:26] “What is the simplest possible explanation of why some things are too good to be true and some things not just bad.”
- [05:00] “The goal of it is to please the human in the loop… And on the other side, all of these tasks that seem way more basic, the goal is to remove the human loop.”
- [06:31] “Why do all LLMs require a human in the loop? The simple answer is we literally put them in the loop.”
- [06:50] “Overpromising is a feature. This is by design.”
- [07:44] “The endgame for all RLHF models is optimizing for engagement.”
- [09:10] “It’s not Claude Code because Claude Code is still part of that assistance era.”
- [12:03] “We’re just automating the writing of the software but then its accessibility is the same.”
- [14:18] “I actually don’t think that pre-training is the problem. Pre-training is phenomenal.”
- [16:08] “RLHF is optimizing for human preference. RLVR is optimizing log error rates of pure correctness. But we are doing a third thing that is optimized for calibrated decision-making.”
관련 노트
- 2026-09-19-typesafe-use-case-map — TypeSafe 공식 Use Case Map 한국어 정리 (이 강연의 이론이 구현된 5대 활용 축·결정 형태 10종).
- 2026-09-19-awesome-jev — TypeSafe Jev 기반 오픈소스 64개 디렉토리 (제3의 최적화 모델 위에 지어지는 생태계).
- jev-ultrafast — 판단+확신도 패턴의 브라우저 에이전트 실전 사례.
- harness — 인간-in-the-loop 보조와 무인 자동화의 경계를 설계하는 하네스 개념.
- moc-ai-agents — 에이전트·하네스·라우팅 노트 모음 MOC.