출처: https://youtu.be/vER13LHKJ9o 길이: 1:05:03 · 채널: 티타임즈TV · 출연: 강수진 박사, 종재 기자 다운로드 자막: 한국어 자동 자막(yt-dlp, ko.vtt → ko.srt 변환) 슬라이드 출처: The Prompt Company 리포트 Part 02 기반(영상 내 표기)
한눈에 보는 요약
- “상세하게 쓰세요, 더 깊게 생각하세요” 같은 자연어 추론 유도는 추론 모델(reasoning model) 시대에 무효화됐다. 추론 모델은 스스로 “추론하겠다”고 선언하고 멈출 조건이 없으면 계속 추론한다.
- 핵심은 목표와 성공 기준을 정량화해 상단에 쓰고, 그 이상은 하지 말라고 early stop 조건을 명시하는 것이다. 추론 강도(effort)는 문장이 아니라 옵션으로 조절한다.
- 2026년 상반기 프런티어 지형은 세 층으로 재편됐다: ① 미국 폐쇄형 최상위(성능 최고·가격 최고), ② 중국 준-프런티어 유료 API(미국 2군 성능을 1/몇 가격에), ③ 중국 오픈웨이트. 과제별 선호 모델이 뚜렷이 갈린다.
- Artificial Analysis Intelligence Index(AII) 기준 과업당 비용은 claude-fable-5 0.03(최저가, 44점)으로 100배 차이가 난다. gpt-5.5 계열·glm-5.2·kimi-k3가 그 사이에 포진한다.
- Post-Mythos 프롬프트의 공통 원칙 6가지: 목표·성공기준 명확화, 절차는 필요할 때만, 자율/승인 구분, 추론 강도는 effort로, “검토하라” 대신 근거·테스트·도구결과 요구, 메모·상태·평가 시스템 등 외부 scaffolding 설계.
- 모델별 프롬프트 색이 다르다: DeepSeek는 한 줄 system prompt + 예시 금지 + 지시를 맨 뒤에 + XML 구분자, Kimi는 모호하면 질문 한 번, GLM은 무작정 시작하지 말고 plan-first, GPT는 outcome-first + 중간 보고, Fable/Opus는 “기다리는 시간이 실행보다 싸다”는 식의 guidebook형 장문 제어가 유효하다.
- 가성비는 추론 강도·피크/밸리 요금제·모델 조합으로 만든다. 같은 프롬프트라도 effort Low/Medium/High/Max에서 출력의 탐색 폭과 비용이 완전히 달라지며, 박물관 웹사이트 데모처럼 정량화된 성공 기준이 없으면 모델이 무한 탐색에 빠진다.
핵심 한 줄: 추론 모델에게는 “더 생각해”가 아니라 “언제 멈출지, 무엇을 성공으로 볼지, 어디까지 혼자 해도 되는지”를 숫자와 조건으로 고정해야 비용·시간·품질이 동시에 잡힌다.
장면별 상세 설명
[00:25] 1. 추론 모델 시대, 예전 프롬프트 문법은 무효
강수진이 바로 본론부터 던진다. “예전에는 프롬프트를 문법처럼 상세하게 쓰세요, 더 깊게 생각하세요가 정답이었는데 이제 완전히 무효가 됐다.” 추론 모델의 공통 특성은 스스로 추론하겠다고 선언하는 것이고, 사용자가 언제까지 추론해야 하는지를 정량화로 주지 않으면 모델은 계속 돈다. 그래서 “정량화 수치를 주면서 그 이상은 하지 마세요” 가 첫 원칙이다. 동시에 추론 effort를 조절하는 옵션이 폭발적으로 늘었고, 토큰을 적게 쓰면서 가성비를 챙기기 위해 매번 effort를 디테일하게 조정하는 방식을 쓴다고 소개한다. 자막의 오타 “출론/트론/토크”는 모두 “추론/토큰”을 가리킨다.
[01:10] 2. 오늘의 주제 — Fable 5부터 GPT-5.6·Kimi K3·DeepSeek V4까지
진행자가 이번 회차를 정의한다. claude-fable-5와 claude-opus-4.7의 뒤를 잇는 Fable 5/Opus 5, GPT-5.6(Sol/Terra/Luna), 중국 모델 kimi-k3와 deepseek-v4 Flash 0731까지 최신 7종을 한 번에 훑고, 각 모델의 잠재력을 끌어내는 프롬프팅 지형을 지도처럼 가져왔다고 예고한다. 슬라이드 타임라인 이후에 바로 이어지는 도입부라 화면은 두 사람의 투샷으로 유지된다.
[02:05] 3. 시장 구조의 재편 — 한 모델 올인 시대의 끝
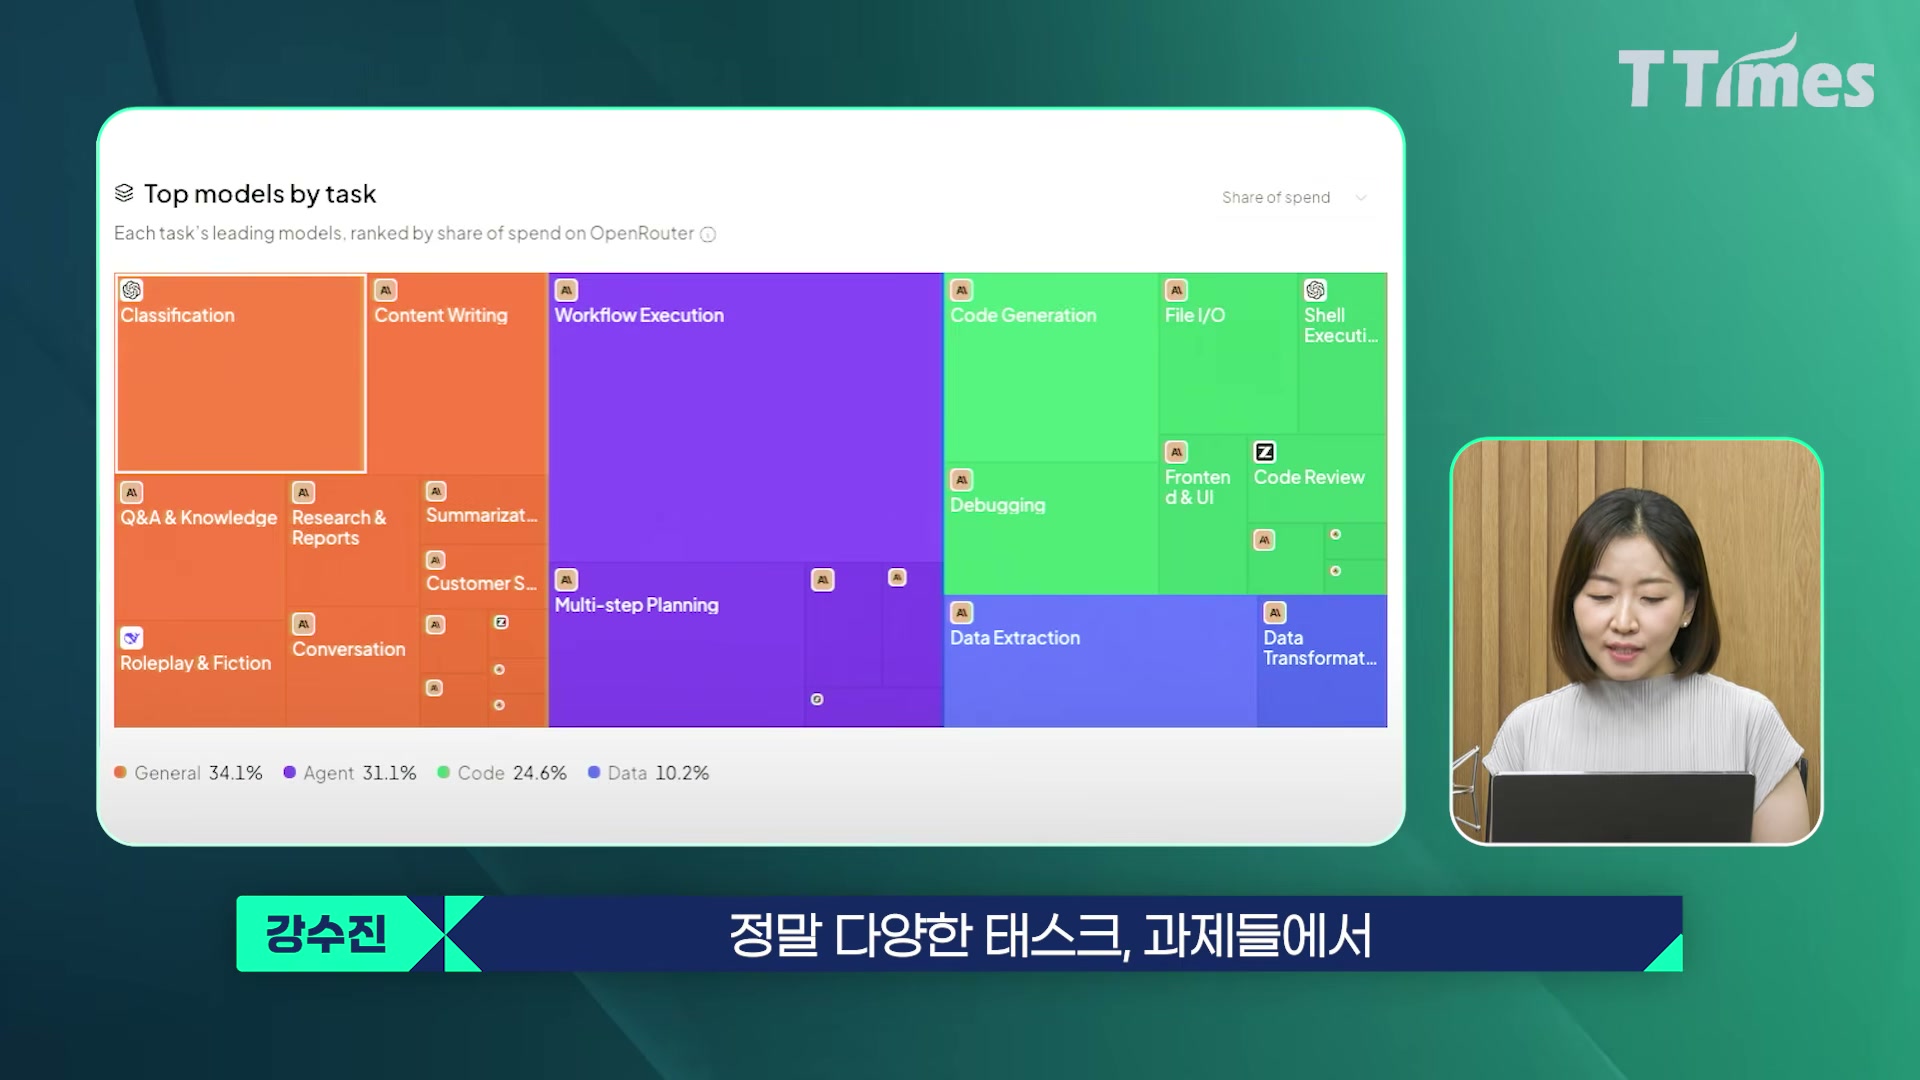
6월 17일자 OpenRouter 통계를 인용한다. 작년에는 ChatGPT 한 모델이 압도적이었지만 지금은 작업별로 선호가 갈린다 — 분류 작업은 ChatGPT/GPT 계열, 창작은 Claude 계열, 에이전트 단계별 실행은 또 Claude 계열 등 목적에 따라 모델을 세분화해 쓴다. “시장 구조의 재편”이라는 한 줄 요약과 함께, 기업 강연에서 한 모델만 쓰는 곳은 이제 없다는 현장 관찰을 덧붙인다. 트리맵 형태로 General/Agent/Code/Data 비중을 시각화한 슬라이드가 등장한다.
[03:35] 4. 2026 상반기 타임라인 — 7개 프런티어 모델
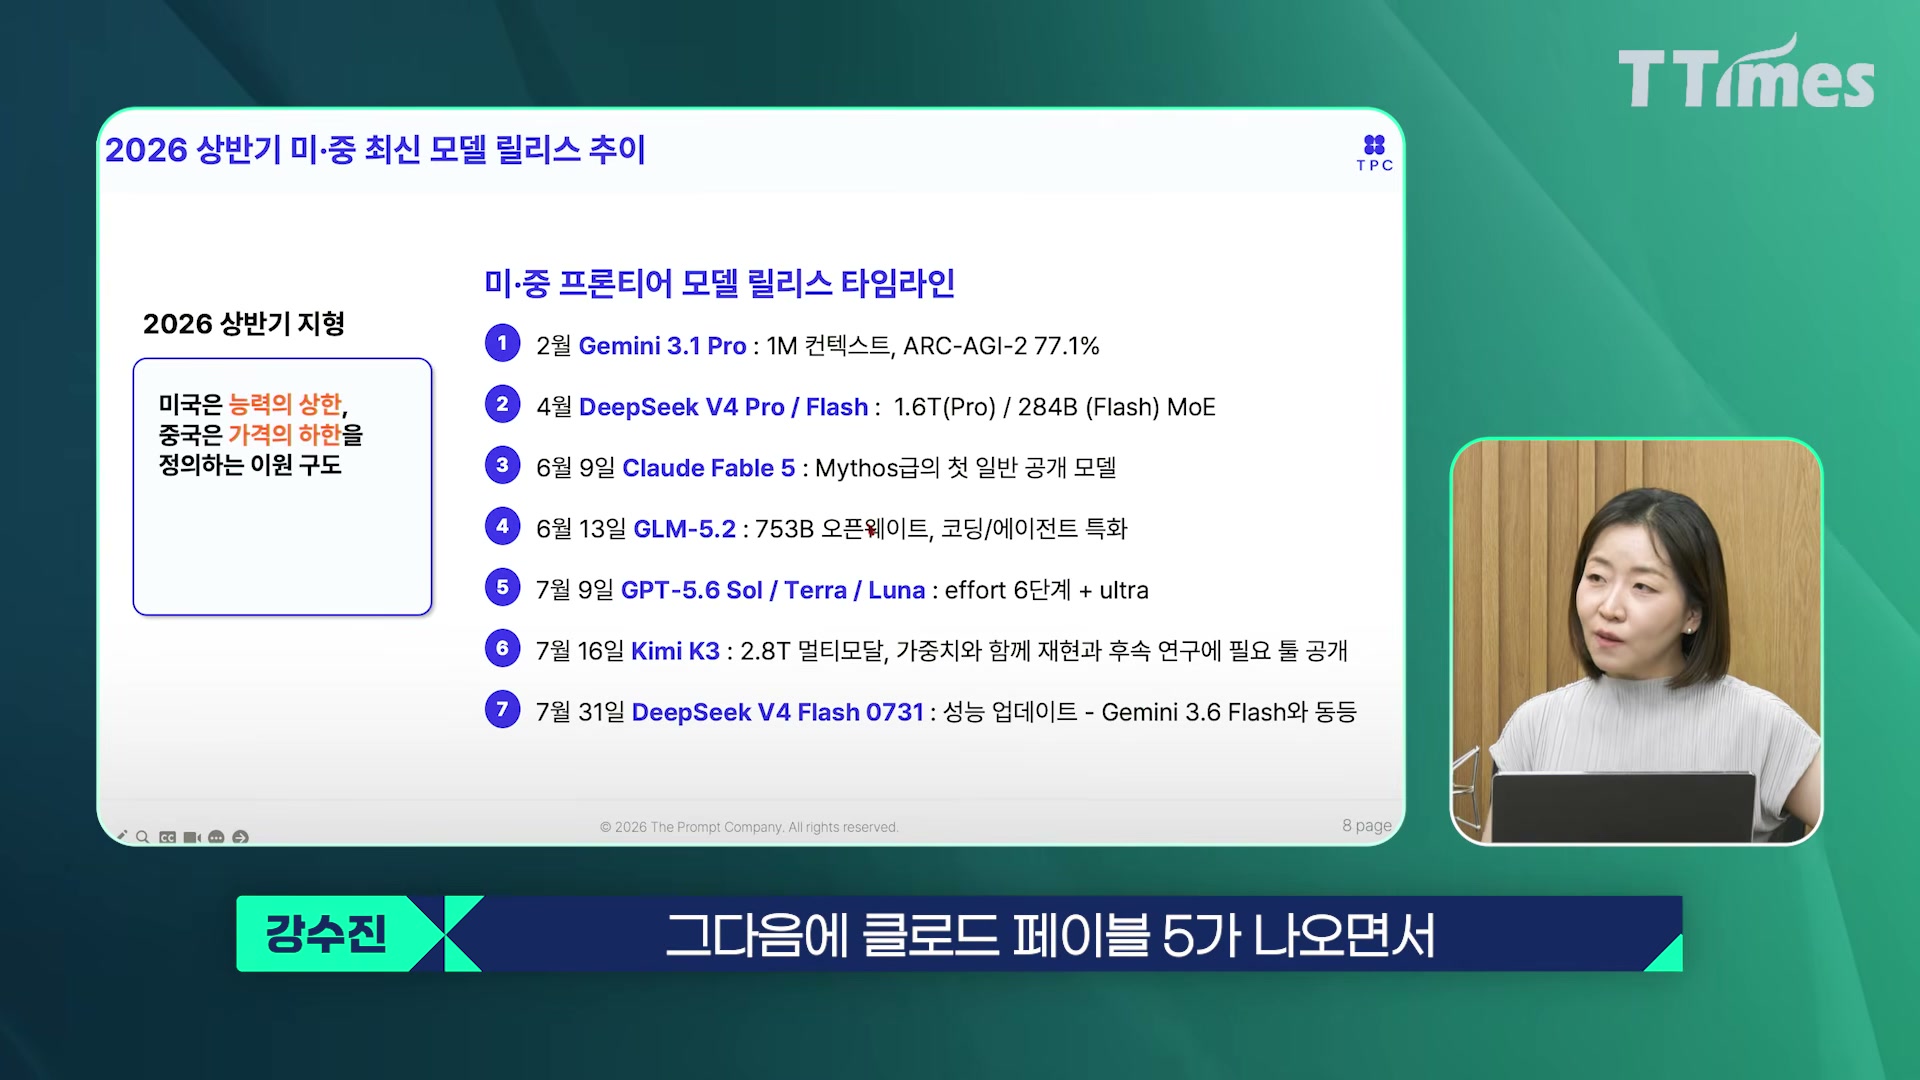
상반기 프런티어 7종을 정리한 타임라인 슬라이드다. Gemini 3.1 Pro(2월), DeepSeek V4 Pro/Flash(4월), claude-fable-5 6월 9일(영상 자막 “6월 9일”), glm-5.2 6월 13일, GPT-5.6 Sol/Terra/Luna 7월 9~10일, kimi-k3 7월 16일, DeepSeek V4 Flash 0731 7월 31일. Fable 5가 공개될 때 미국 정부의 공개 허용을 둘러싼 정치적 논란으로 돌풍이 일었다는 에피소드도 언급한다. 3.1 Pro 시절 GPT 구독을 끊었다는 진행자의 고백에 웃음이 나온다.
[05:05] 5. 성능·속도·비용 삼각 비교 — 가장 비싼 Fable 5 vs 가장 싼 DeepSeek
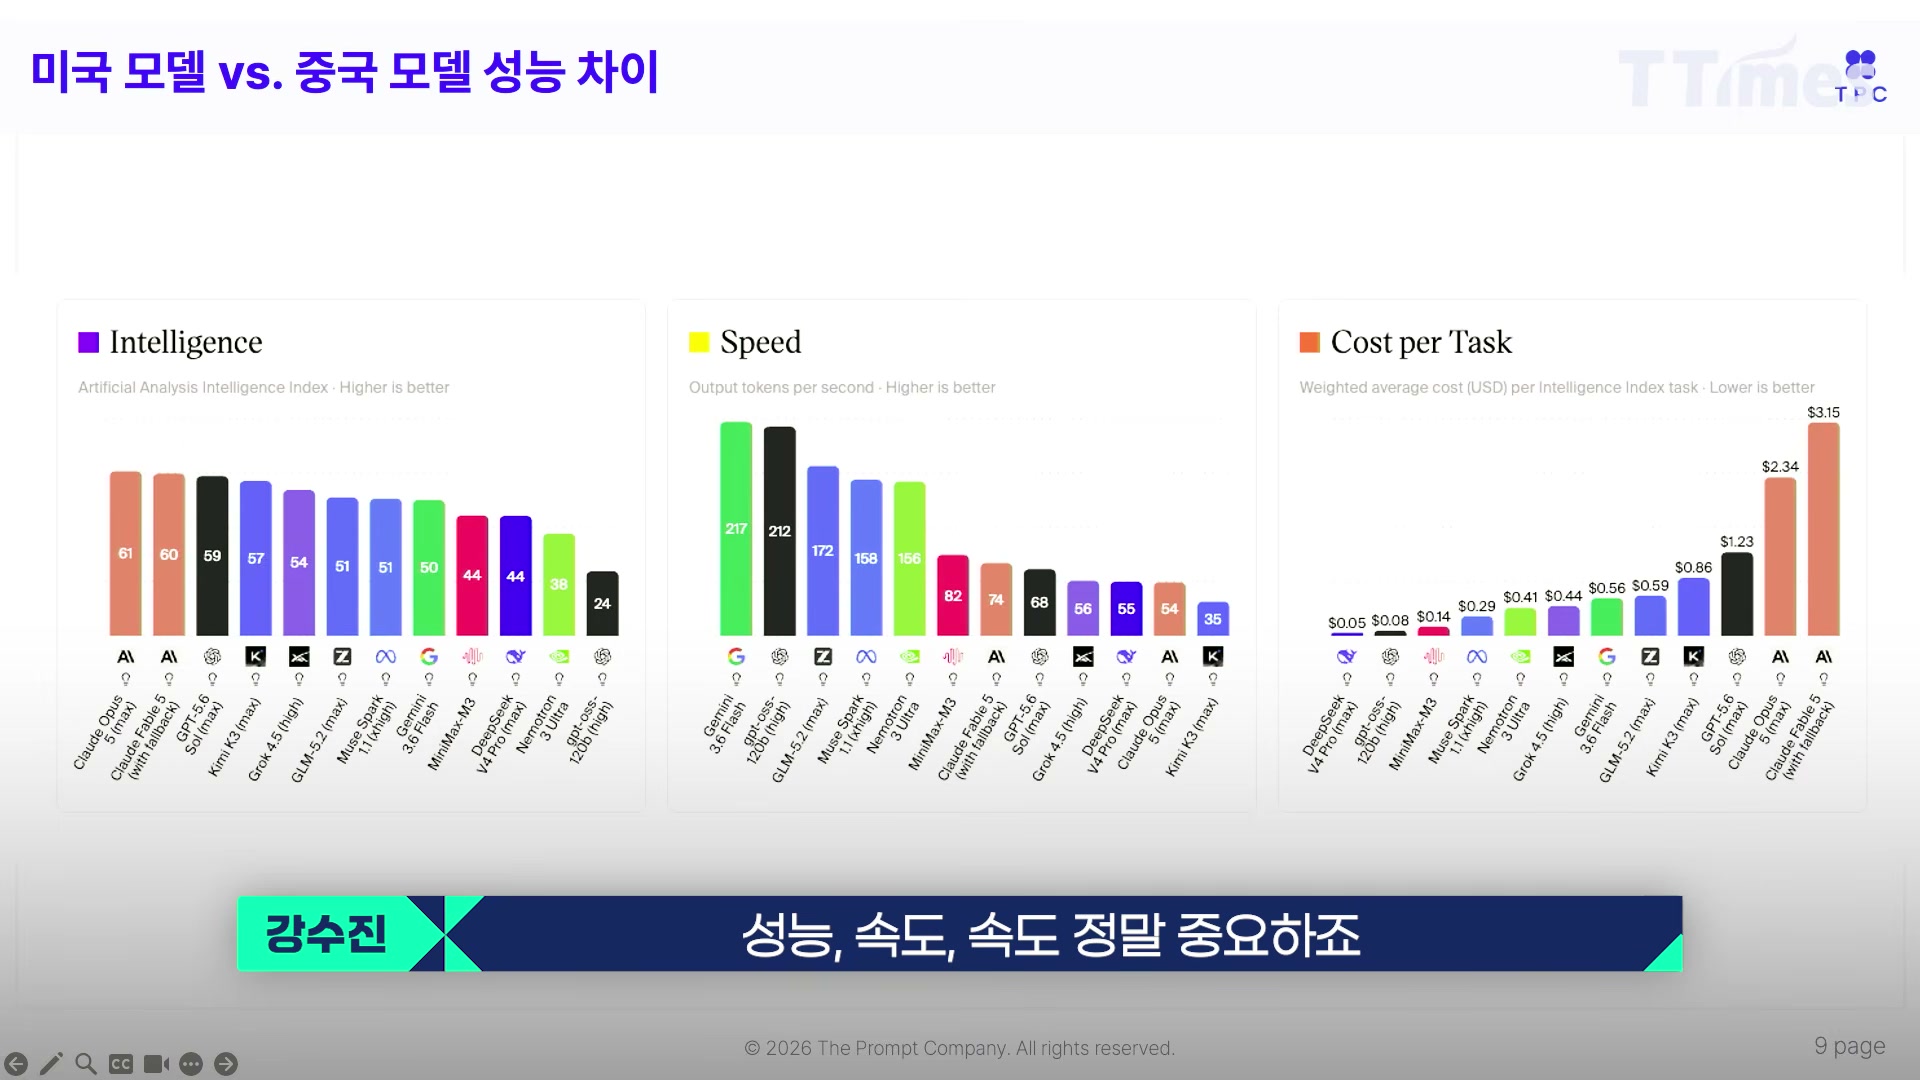
세 축으로 나눈 바 차트 슬라이드다. Intelligence(추론 성능)는 Claude Opus 5 Max 61, Fable 5 60, GPT-5.6 Max 59, kimi-k3 Max 57 순으로 미국 폐쇄형이 선두. Speed는 Gemini 3.6 Flash가 217로 압도적이며, Cost per Task는 Fable 5가 0.03으로 최저가다. “성능 좋은데 너무 느리면 기다림이 비용”이라는 점을 강조하며, 세 축을 동시에 봐야 한다는 프레임을 제시한다.
[06:40] 6. Artificial Analysis 인덱스 — 0.03의 100배 차이
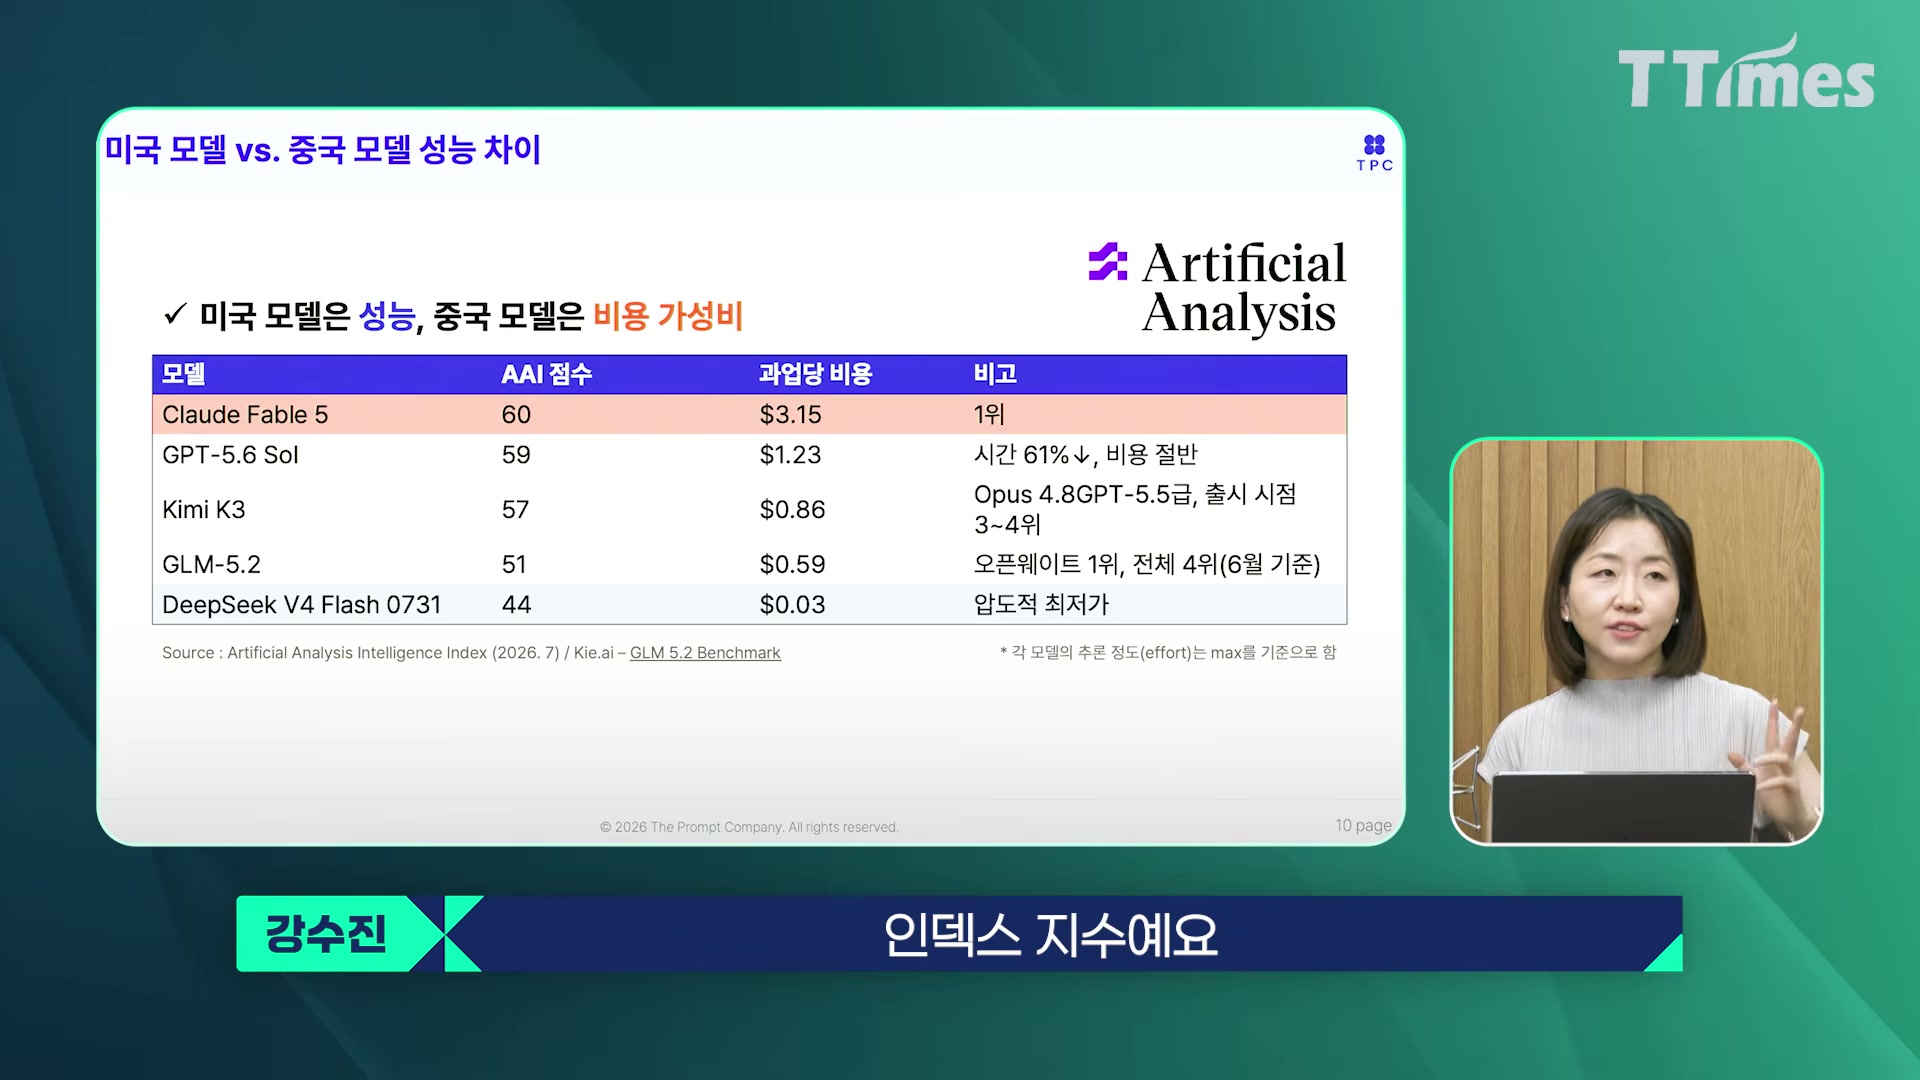
Artificial Analysis Intelligence Index(2026.7, Ki.e.ai 발췌) 표를 확대한다. 같은 과업 기준 과업당 비용: Fable 5 AAI 60 1.23(시간 61%↓, 비용 절반), kimi-k3 57 0.59(오픈웨이트 1위, 전체 4위), DeepSeek V4 Flash 0731 44 $0.03(압도적 최저가). 각 모델의 추론 강도는 max 기준이라는 주석이 있다. 100배 가격 차이가 “무엇을 맡길지”를 결정한다는 결론으로 이어진다.
[08:40] 7. “Fable 5가 과하게 일한다” — $1,000짜리 에이전트 일화
규모가 큰 태스크에서 Fable 5가 멈추지 않고 탐색을 계속하다 과업당 $1,000에 가까운 청구가 나온 사례를 소개한다. 진행자가 “원래 프롬프트 엔지니어로서 일을 많이/적게 하게 만드는 게 전문 아니냐”고 묻자, 강수진은 자연어 추론 모델 이전의 “더 생각해” 프롬프트가 이제는 오히려 방해가 된다고 답한다. 멈출 조건과 승인 경계가 없으면 모델이 무한히 일을 늘린다는 문제의식이 여기서 처음 구체화된다.
[11:00] 8. GPT-5.6 — Sol(Flagship) / Terra(균형) / Luna(경량)
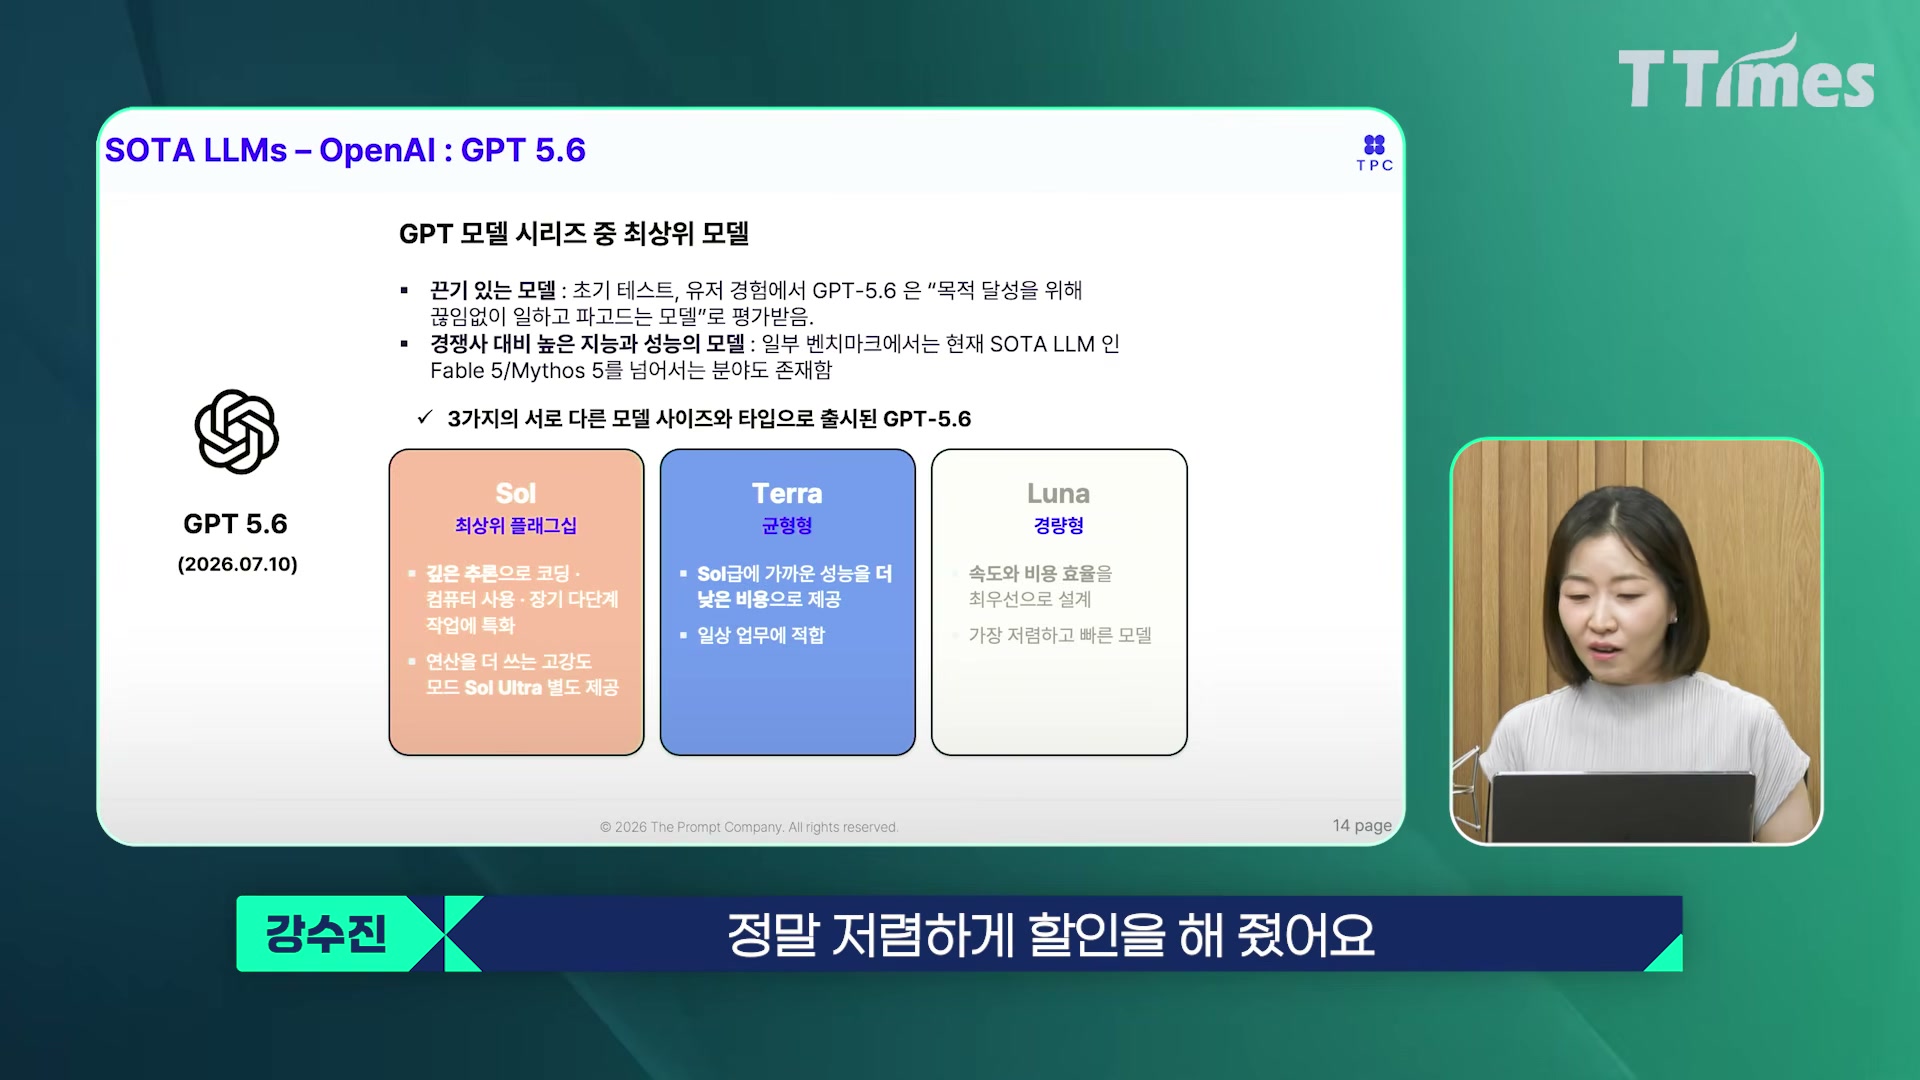
“SOTA LLMs – OpenAI: GPT 5.6” 슬라이드다. GPT-5.6은 크기와 용도가 다른 3종으로 출시됐다: Sol(최상위 플래그십, 깊은 추론·코딩·컴퓨터 사용·장기 다단계 특화, 고강도 Sol Ultra 별도), Terra(균형형, Sol급에 가까운 성능을 더 낮은 비용에), Luna(경량, 속도와 비용 효율 최우선, 가장 저렴·가장 빠름). 초기 유저 평가에서 “목적 달성을 위해 끊임없이 일하고 포기하지 않는 모델”로 불렸고, 일부 벤치마크에서는 Fable 5/Mythos 5를 넘기도 했다. OpenAI가 Luna를 대폭 할인했다는 가격 코멘트가 이어진다.
[14:15] 9. GLM-5.2 — “수십 시간 무너지지 않는” 장기 실행
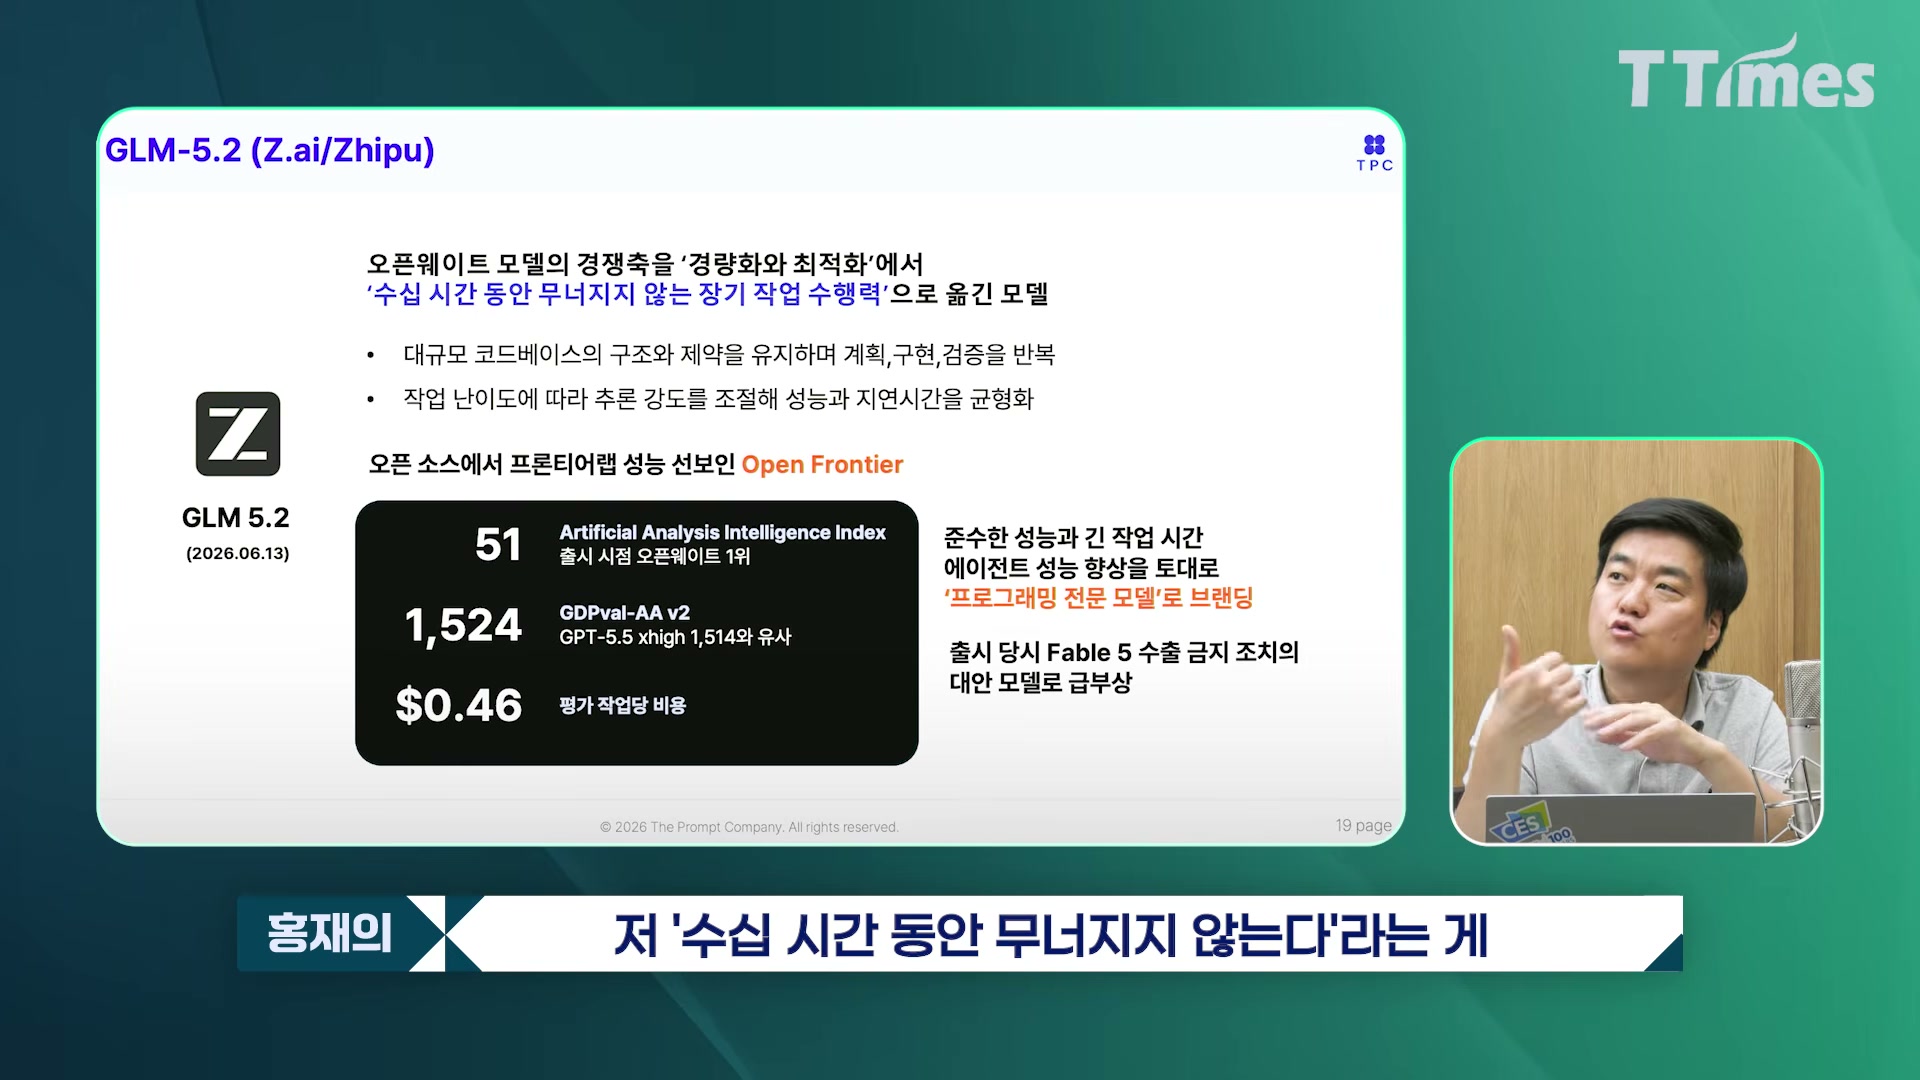
glm-5.2(Z.ai/Zhipu, 6월 13일) 슬라이드다. “경량화·최적화 경쟁을 장기 작업 수행력으로 옮긴 모델”로 정의하고, 대규모 코드베이스의 구조·제약을 유지하며 계획→구현→검증을 반복하고 난이도에 따라 추론 강도를 자동 조절한다고 설명한다. Open Frontier 지표: AAI 51(출시 시점 오픈웨이트 1위), GDPval-AA v2 1,524(GPT-5.5 xhigh 1,514와 유사), 과업당 $0.46. 긴 작업 시간과 에이전트 성능을 무기로 프로그래밍 전문 모델로 브랜딩됐고, 출시 당시 “Fable 5 수준의 가성비 대안”으로 급부상했다고 평가한다.
[16:45] 10. Qwen·Kimi 이슈 — 빠른 업데이트와 한자 섞임
실시간 댓글이 쏟아지는 구간이다. 시청자가 “Qwen은 정말 빠른 업데이트 주기가 놀랍다”고 하자 두 사람이 맞장구친다. 자막에는 없지만 이어지는 Qwen 이슈가 여기서 예고된다: Qwen이 한국어를 쓸 때 한자가 섞여 나오는 현상, 온도를 낮추고 출력 제약을 걸어 완화한 경험담이 다음 슬라이드에서 다뤄진다. 화면은 댓글을 읽는 진행자의 토크샷으로 유지된다.
[21:55] 11. 피크·밸리 요금제와 LN-compare 실험 예고
DeepSeek가 도입한 피크·밸리 요금제를 설명한다. 사용량이 과밀한 피크 시간대와 그 외 밸리 시간대의 가격을 다르게 책정해 밸리에는 대폭 할인한다. 강수진은 이 요금제를 이용해 비용을 아끼는 동시에, 자신이 만든 비교 도구 LN-compare를 소개한다 — 같은 프롬프트를 effort Low/Medium/High/Max로 돌려 결과와 비용을 나란히 비교하는 사내 툴이다. 뒤이어 박물관 웹사이트 제작 데모가 예고된다.
[24:35] 12. 예전 방식 프롬프트는 오히려 방해
강수진이 단호하게 말한다: “예전 방식으로 프롬프트를 쓰는 건 효율성에서도, 정확성에서도 떨어질 수밖에 없다.” 추론 모델에게 절차를 세세히 적고 “더 깊게 생각해”를 반복하면 모델의 자율적 에이전시(agency)를 방해하고 토큰만 태운다. DeepSeek의 싱크 기능을 안 쓰고도 잘 쓰던 시절의 프롬프트를 그대로 가져오면 오히려 성능이 떨어진다는 사례로 연결된다. 화면 중앙에 “예전 방식의 프롬프트는 오히려 방해”라는 대형 자막이 뜬다.
[27:25] 13. Post-Mythos 프롬프트 변화 — 공통 강조 원칙 6가지
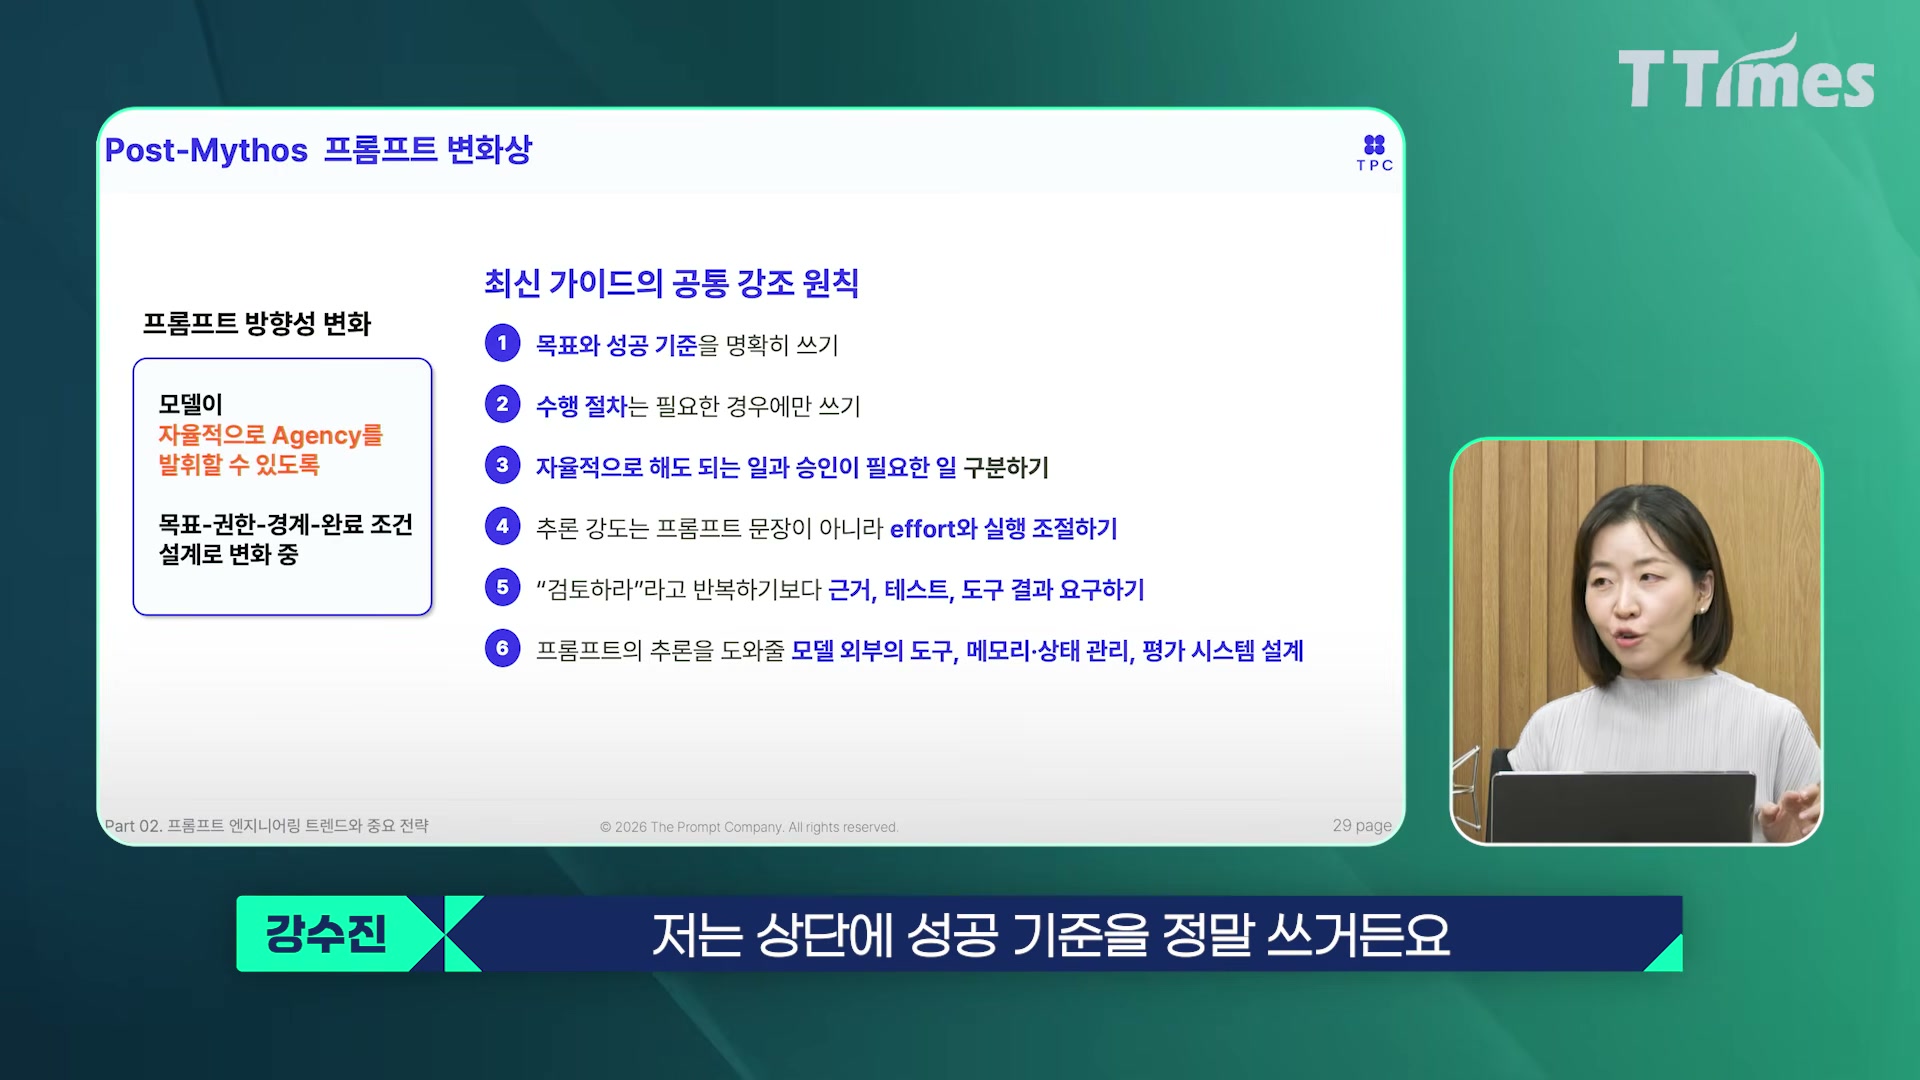
이 영상의 핵심 슬라이드다. 제목 “Post-Mythos 프롬프트 변화상” 아래 왼쪽에는 방향성 변화 — “모델이 자율적으로 Agency를 발휘하도록 목표·권한·중간점검·완료 조건 설계로 변화”. 오른쪽에는 최신 가이드의 공통 강조 6가지가 정리돼 있다: ① 목표와 성공 기준을 명확히 쓰기, ② 수행 절차는 필요한 경우에만 쓰기, ③ 자율/승인 구분하기, ④ 추론 강도는 문장이 아니라 effort와 실행으로 조절, ⑤ “검토하라” 반복보다 근거·테스트·도구결과 요구, ⑥ 메모·상태 관리·평가 시스템 등 외부 도구 설계. 강수진은 “저는 상단에 성공 기준을 정말 쓴다”고 강조한다.
[29:55] 14. 추론 강도 버튼 — Light/Medium/High/Extra High/울트라
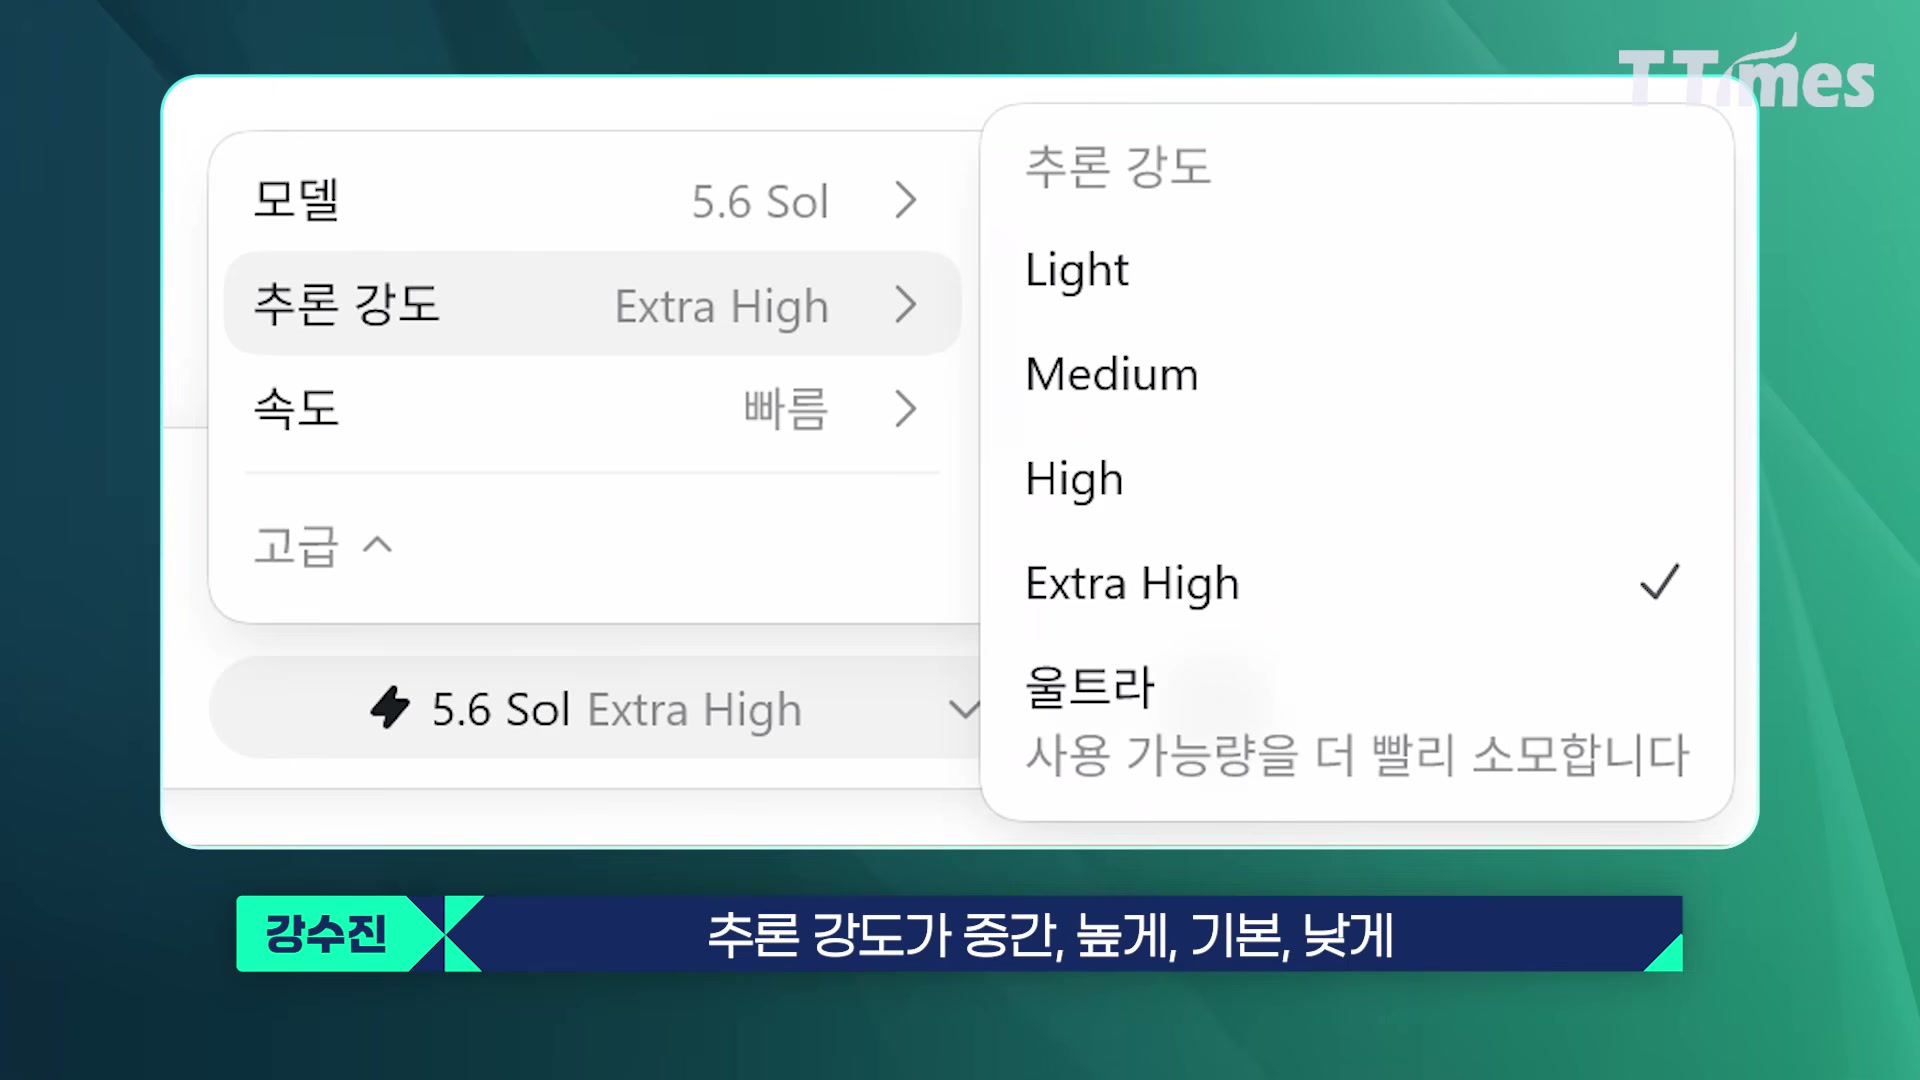
실제 모델 설정 UI를 캡처한 화면이다. 모델 5.6 Sol, 추론 강도 Extra High, 속도 빠름. 드롭다운에는 Light / Medium / High / Extra High(선택) / 울트라(“사용 가능량을 더 빨리 소모”)가 보인다. 강수진이 “추론 강도가 중간·높게·기본·낮게 버튼으로 생겼다”고 설명하고, 진행자가 “어떤 걸 많이 쓰세요?”라고 묻자 “중간·낮게를 섞는다”는 답이 이어진다. effort를 문장으로 흉내 내지 말고 버튼으로 제어하라는 원칙의 시각적 증거다.
[33:45] 15. 중국 모델의 러프한 effort — 세분화가 적다
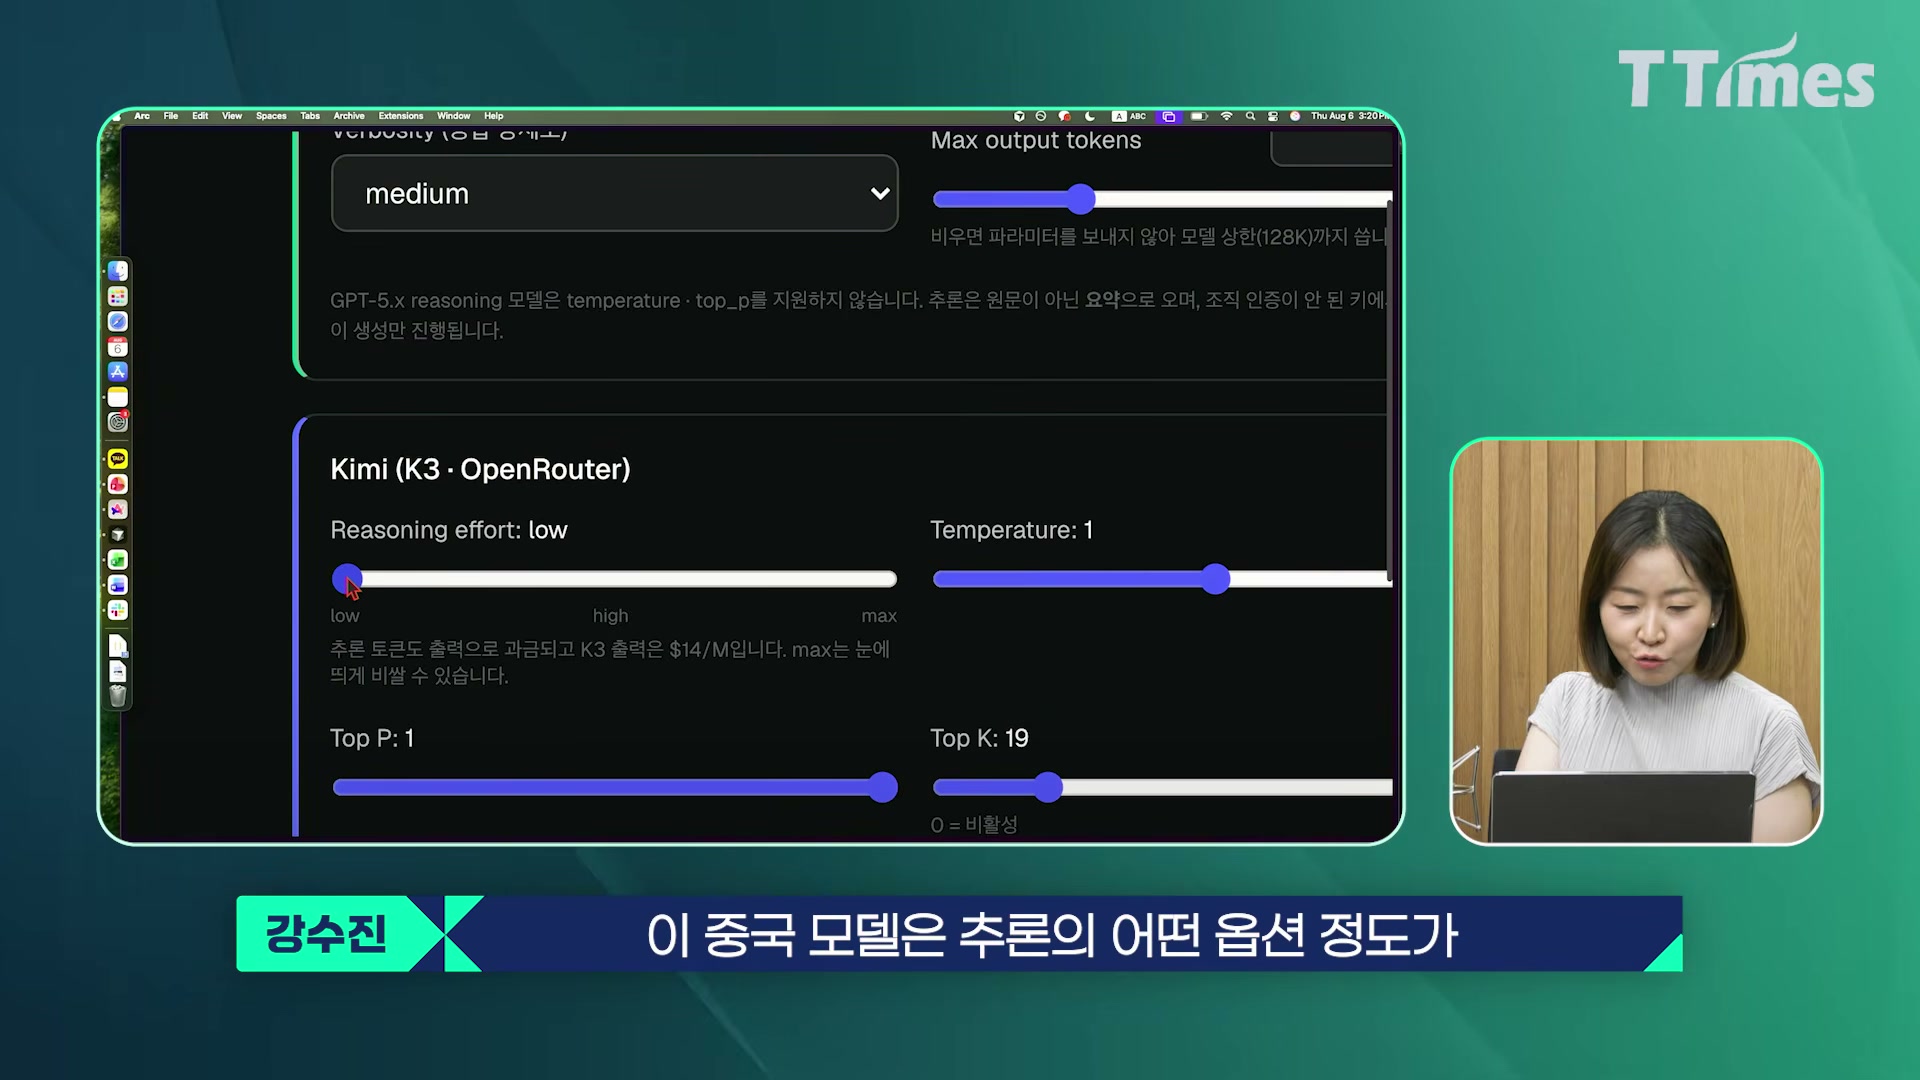
“중국 모델은 추론 옵션 정도가 미국 모델보다 러프하다”는 비교가 나온다. 미국 모델은 Light/Medium/High/Extra High/Ultra로 5단 세분화돼 있는 반면, Kimi 등 중국 모델은 옵션이 몇 개 없고 러프하다는 것이다. 세분화가 적으니 프롬프트에서 보정해야 할 부분이 생기지만, 대신 가격이 싸서 탐색을 더 돌리기 쉽다는 트레이드오프를 설명한다. 화면은 옵션 비교 표로 유지된다.
[35:50] 16. 박물관 웹사이트 데모 — 같은 프롬프트, 다른 effort
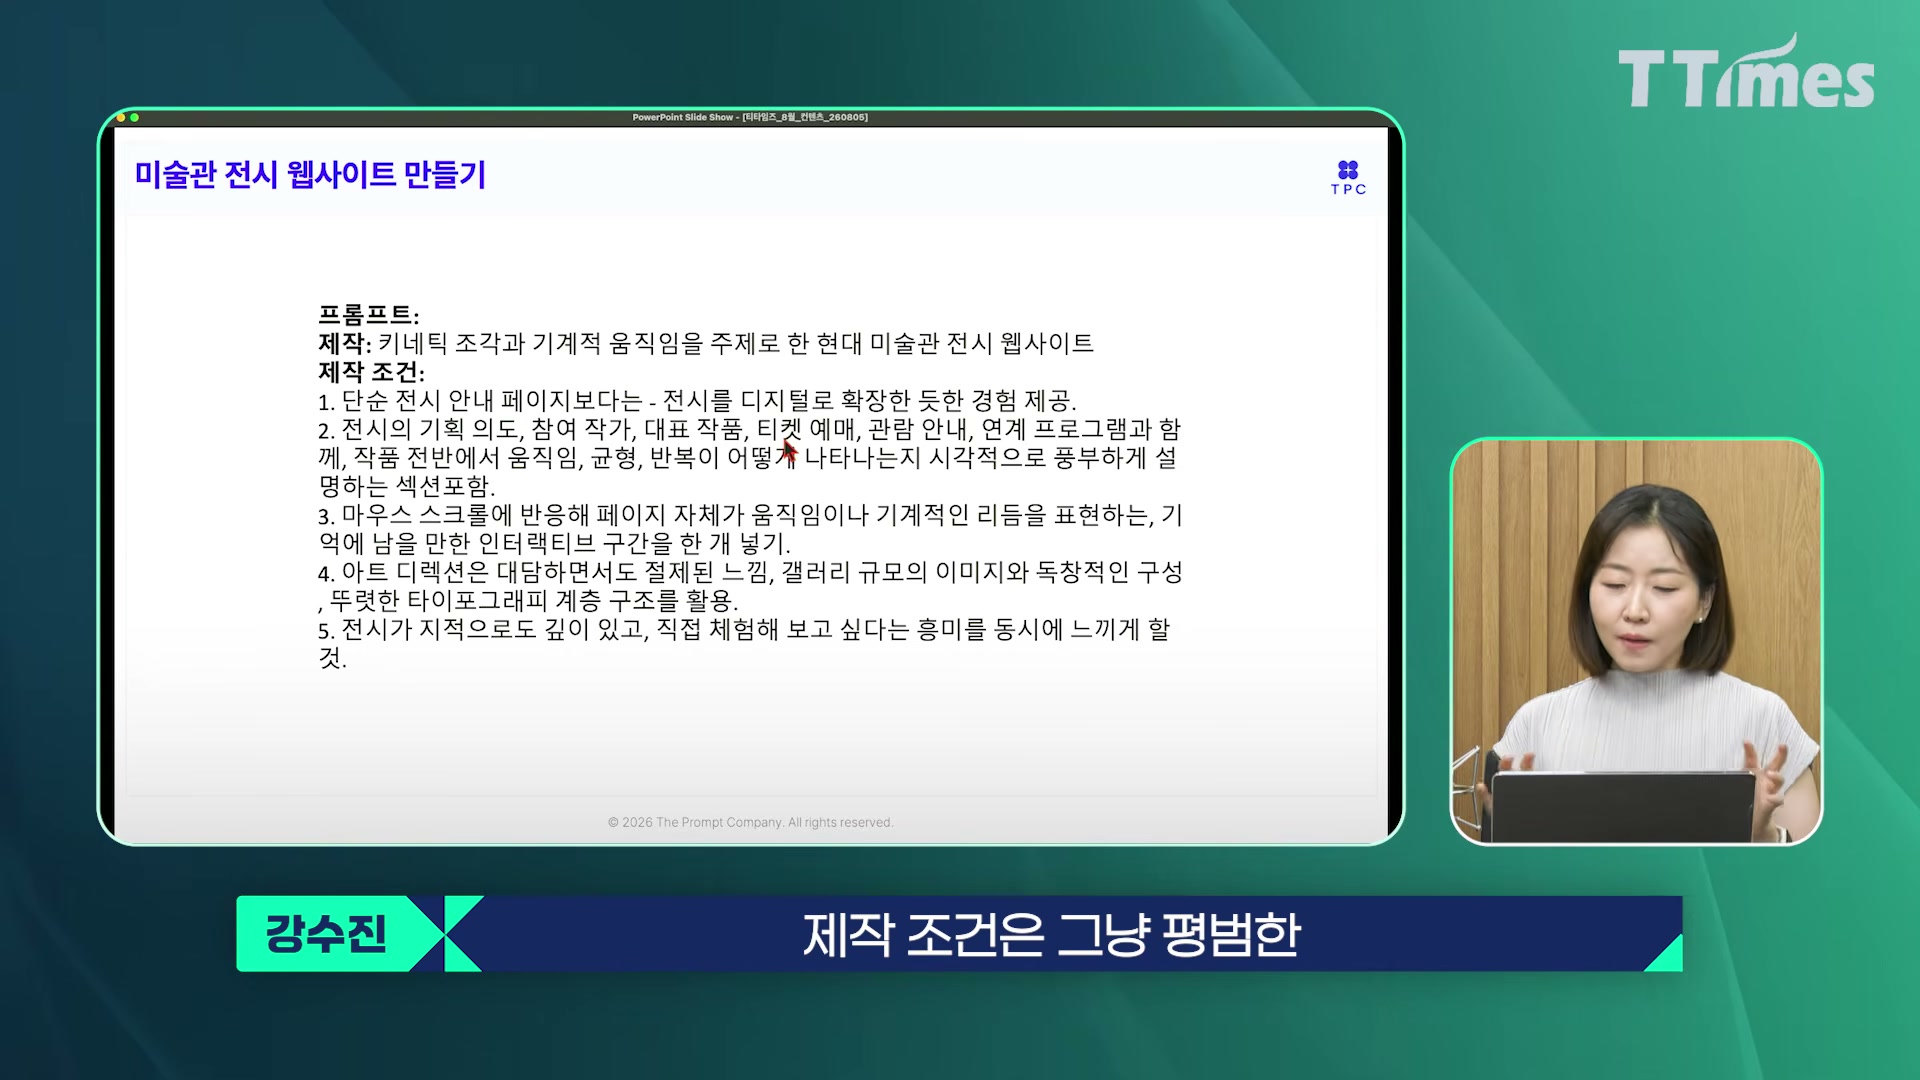
LN-compare의 대표 데모가 시작된다. 제작 조건: “평범한 인터페이스가 아니라 정말 빠져들 만한 시각적 요소를 추가한 박물관 웹사이트 — 전시 기획 의도, 참여 작가, 대표 작품, 티켓·관람 안내를 포함”. 같은 프롬프트를 effort별로 돌리면 Low는 템플릿 수준, High/Max는 인터랙션·스토리텔링이 풍부한 결과물이 나온다. 성공 기준(무엇을 “빠져든다”고 볼지)을 정량화하지 않으면 모델이 끝없이 탐색한다는 점을 보여주는 실험이다.
[39:00] 17. 세 가지 멈춤 장치 — “언제 멈춰라”를 써라
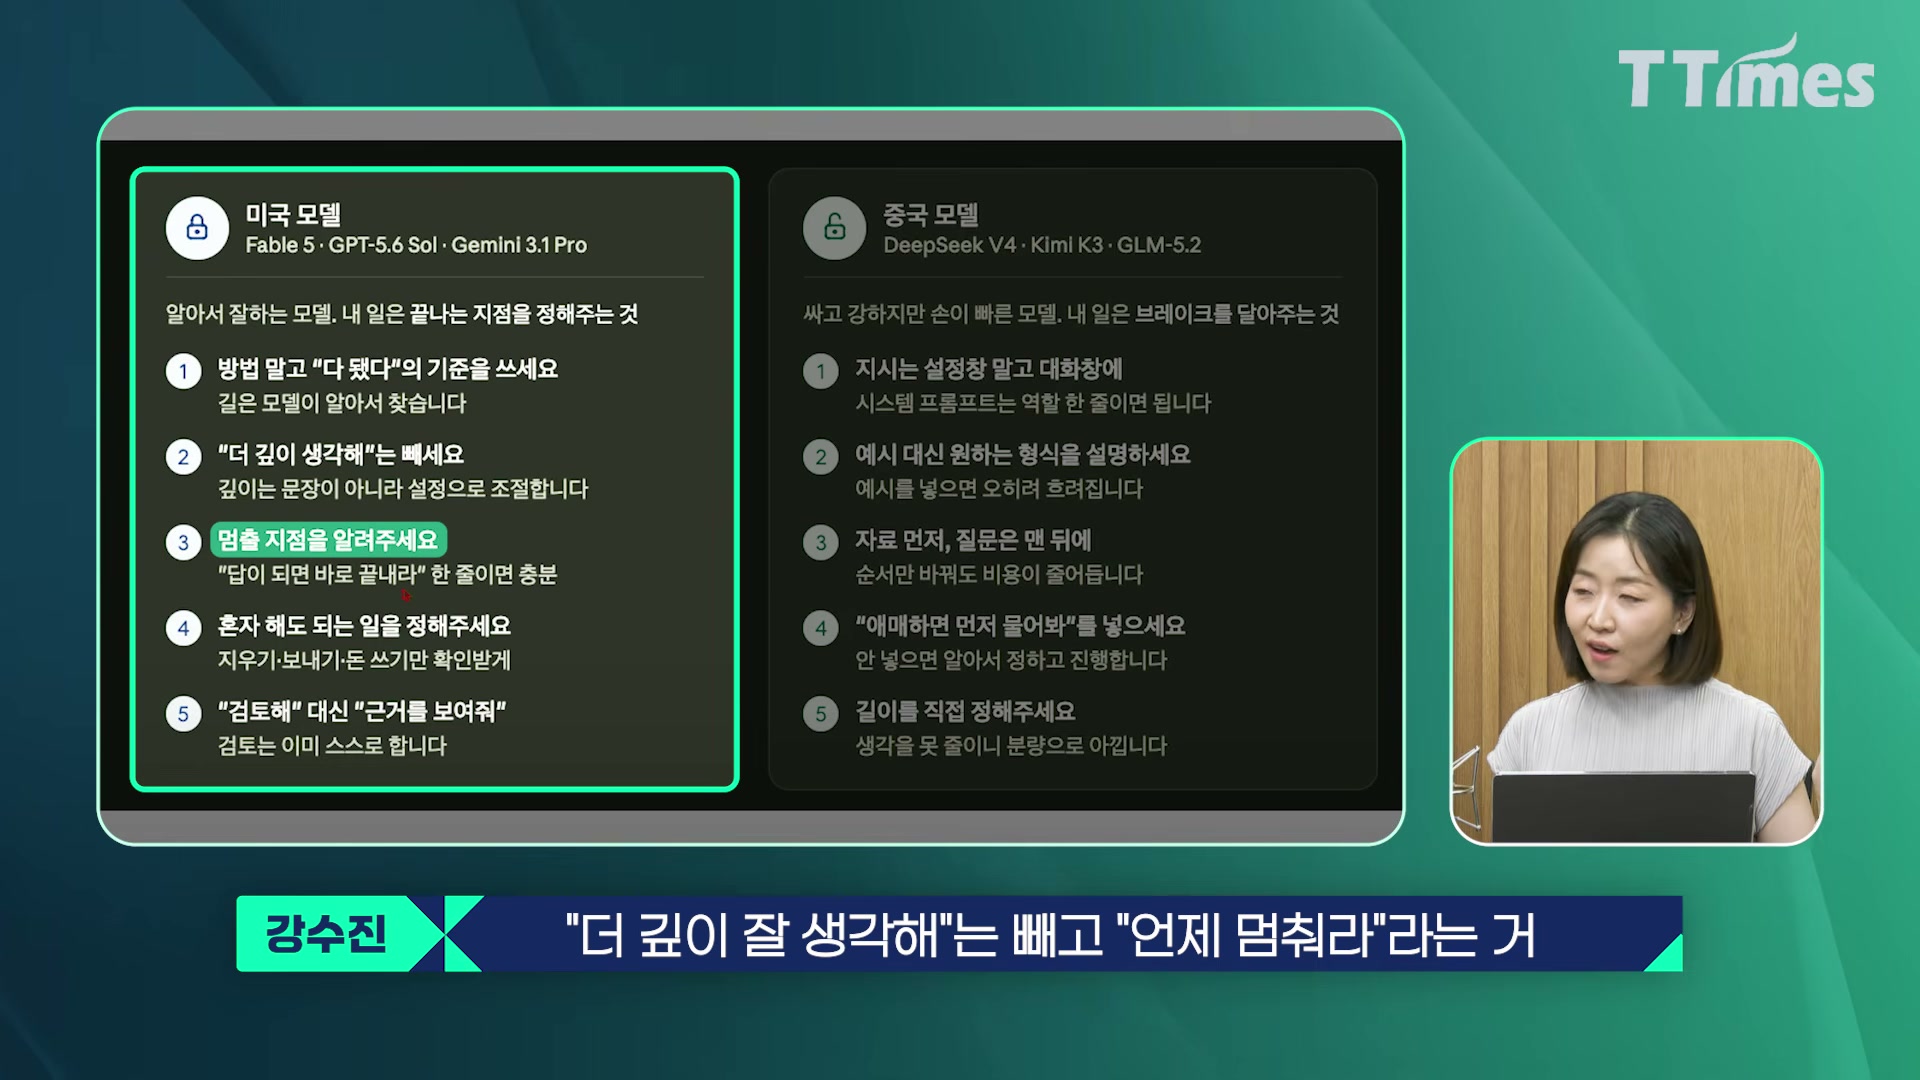
“더 깊이 생각해는 빼고, 언제 멈춰라를 써라”는 문장이 핵심이다. 혼자 해도 되는 일과 승인 받아야 하는 일을 구분하고, 정해진 탐색 횟수·시간·비용을 넘으면 멈추라고 명시하라는 것이다. “나한테 승인 받을 것 / 받지 않아도 되는 것”을 리스트로 나누는 예시가 화면에 제시된다. 추론 모델이 스스로 멈추는 법을 모르기 때문에 사용자가 외부에서 브레이크를 걸어야 한다는 논리다.
[42:45] 18. Kimi의 성향 — 색을 지정 안 했는데도 과하게 디자인한다
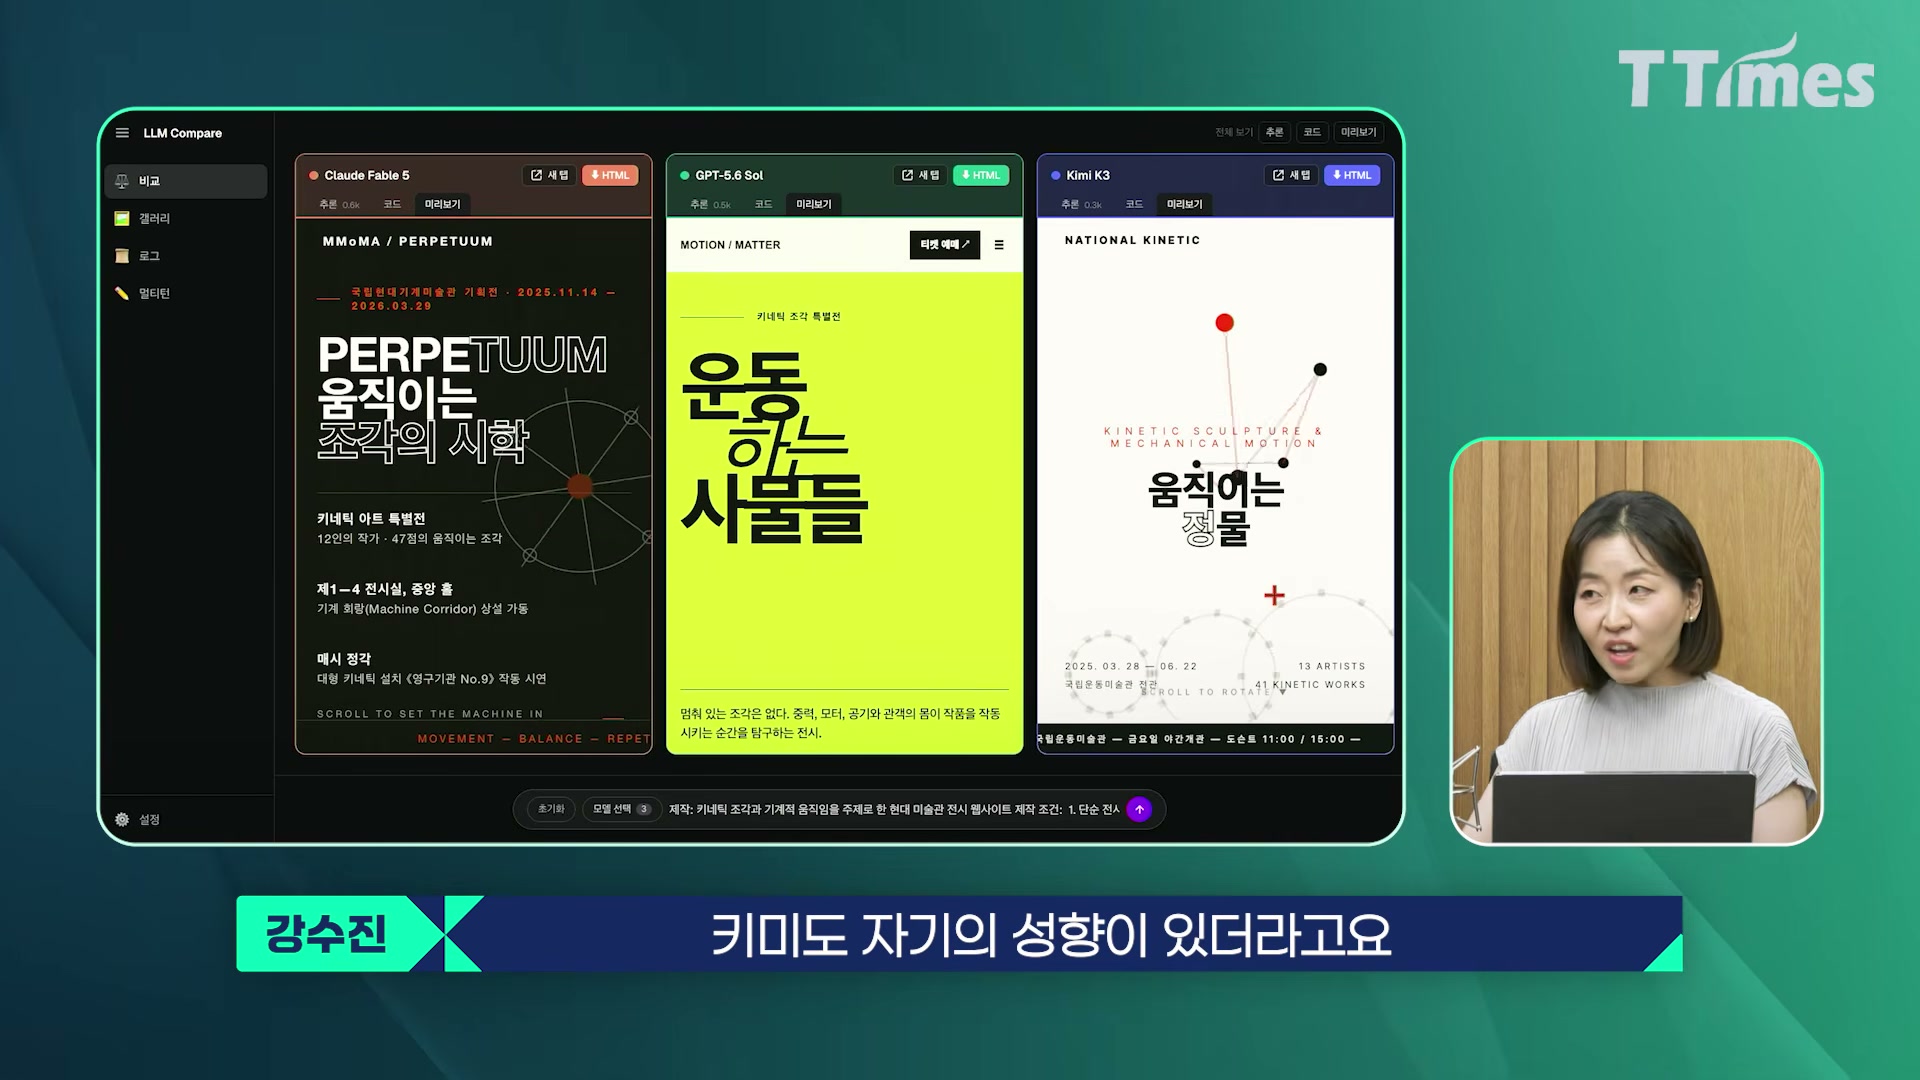
Kimi로 디자인 작업을 몇 번 해본 소감이다. 프롬프트에서 색을 지정하지 않았는데도 Kimi는 “역동적으로”라는 한 마디를 과하게 해석해 화려한 팔레트와 애니메이션을 쏟아낸다. 모델마다 성향이 있고, Kimi는 특히 시각적 과잉에 가깝다는 것이다. 그래서 Kimi를 쓸 때는 색·톤을 명시하거나 “과하지 않게” 같은 제약을 추가해야 한다는 팁이 이어진다.
[45:35] 19. 롱턴 최적화 vs 숏턴 최적화 — 메모리를 쓰느냐 마느냐
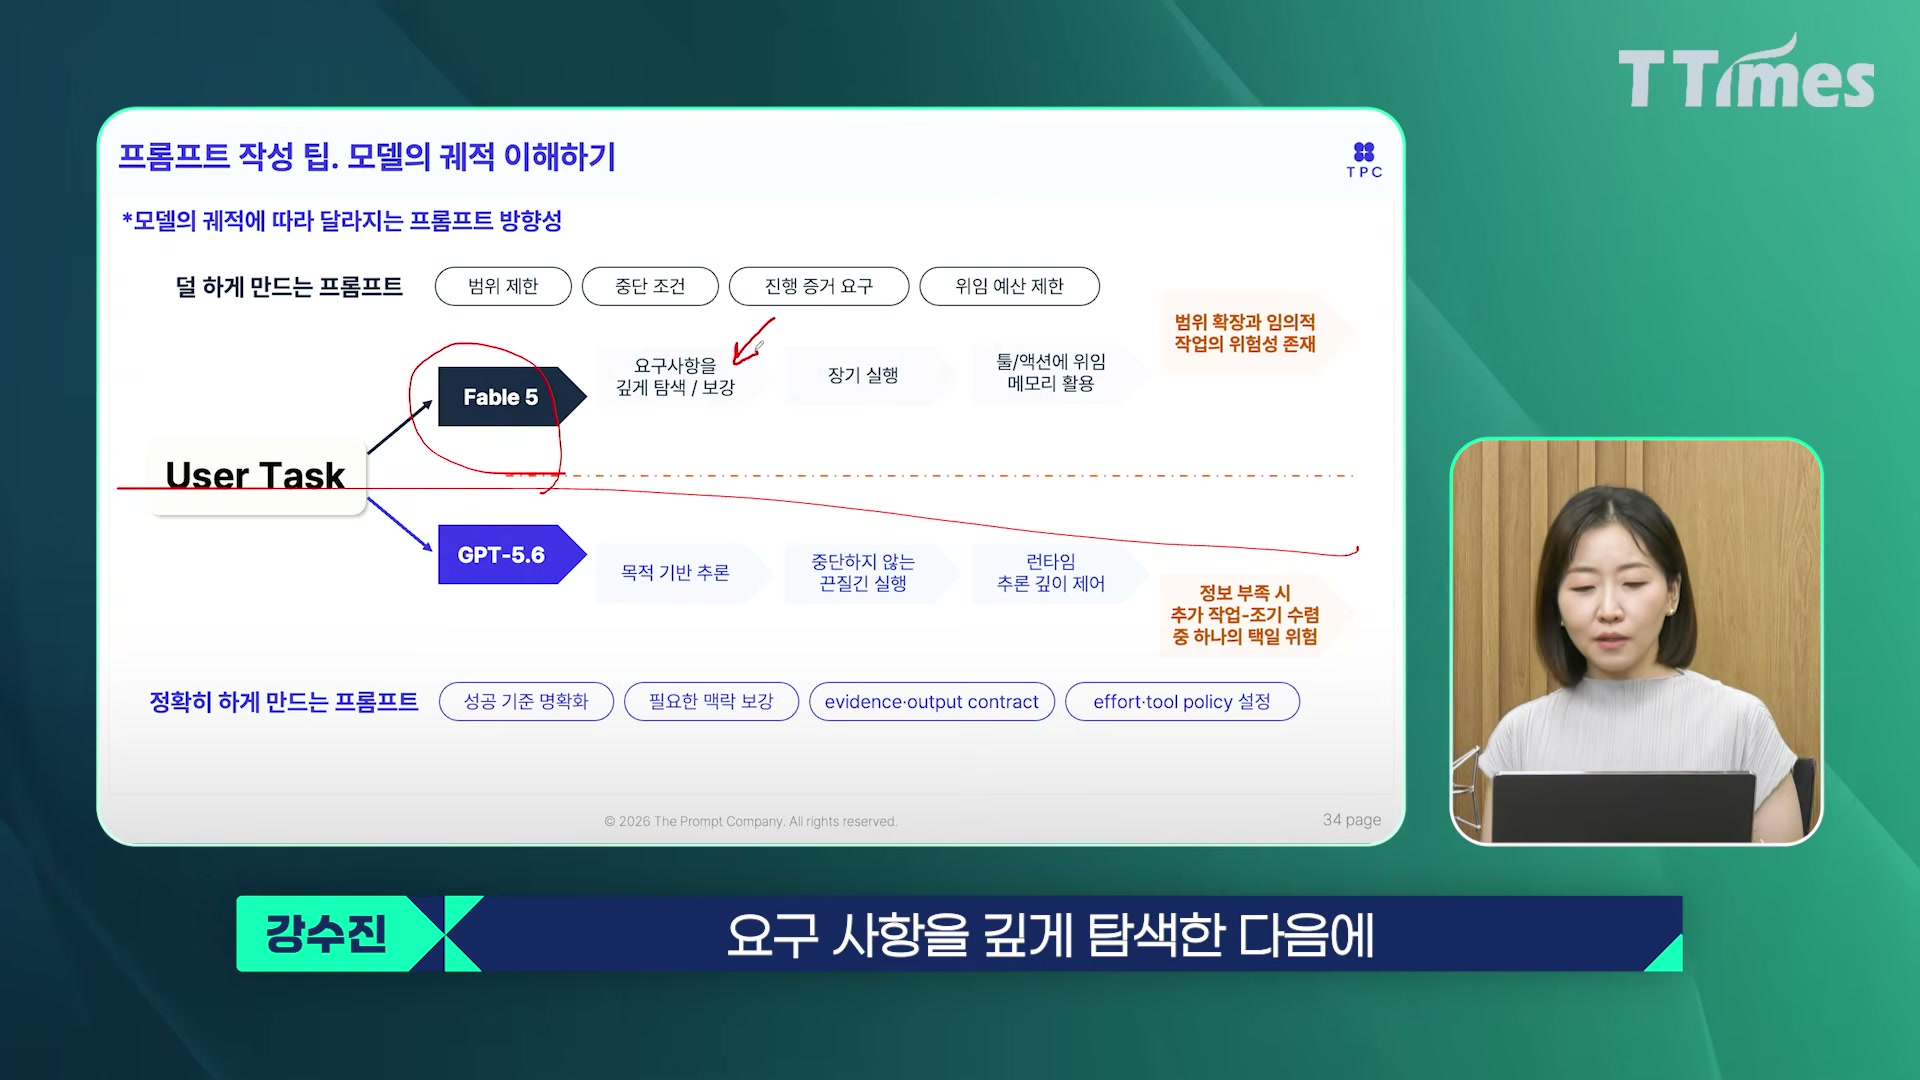
두 종류의 최적화가 대비된다. Kimi·GLM 같은 롱턴 최적화 모델은 많은 경우의 수를 탐색하며 요구사항을 깊게 파고, 마지막에 툴·액션과 메모리 활용으로 마무리한다. 반면 GPT 계열은 숏턴 최적화에 가깝게 초반부터 도구 호출을 섞는다. “정말 길게 길게 가다가 마지막에 메모리와 툴로 마무리”하는 것이 롱턴 모델의 특징이며, 이 차이를 모르면 “왜 이렇게 오래 걸리지?”라는 오해가 생긴다고 설명한다.
[48:35] 20. “내가 기다리는 시간이 네가 실행하는 시간보다 싸다”
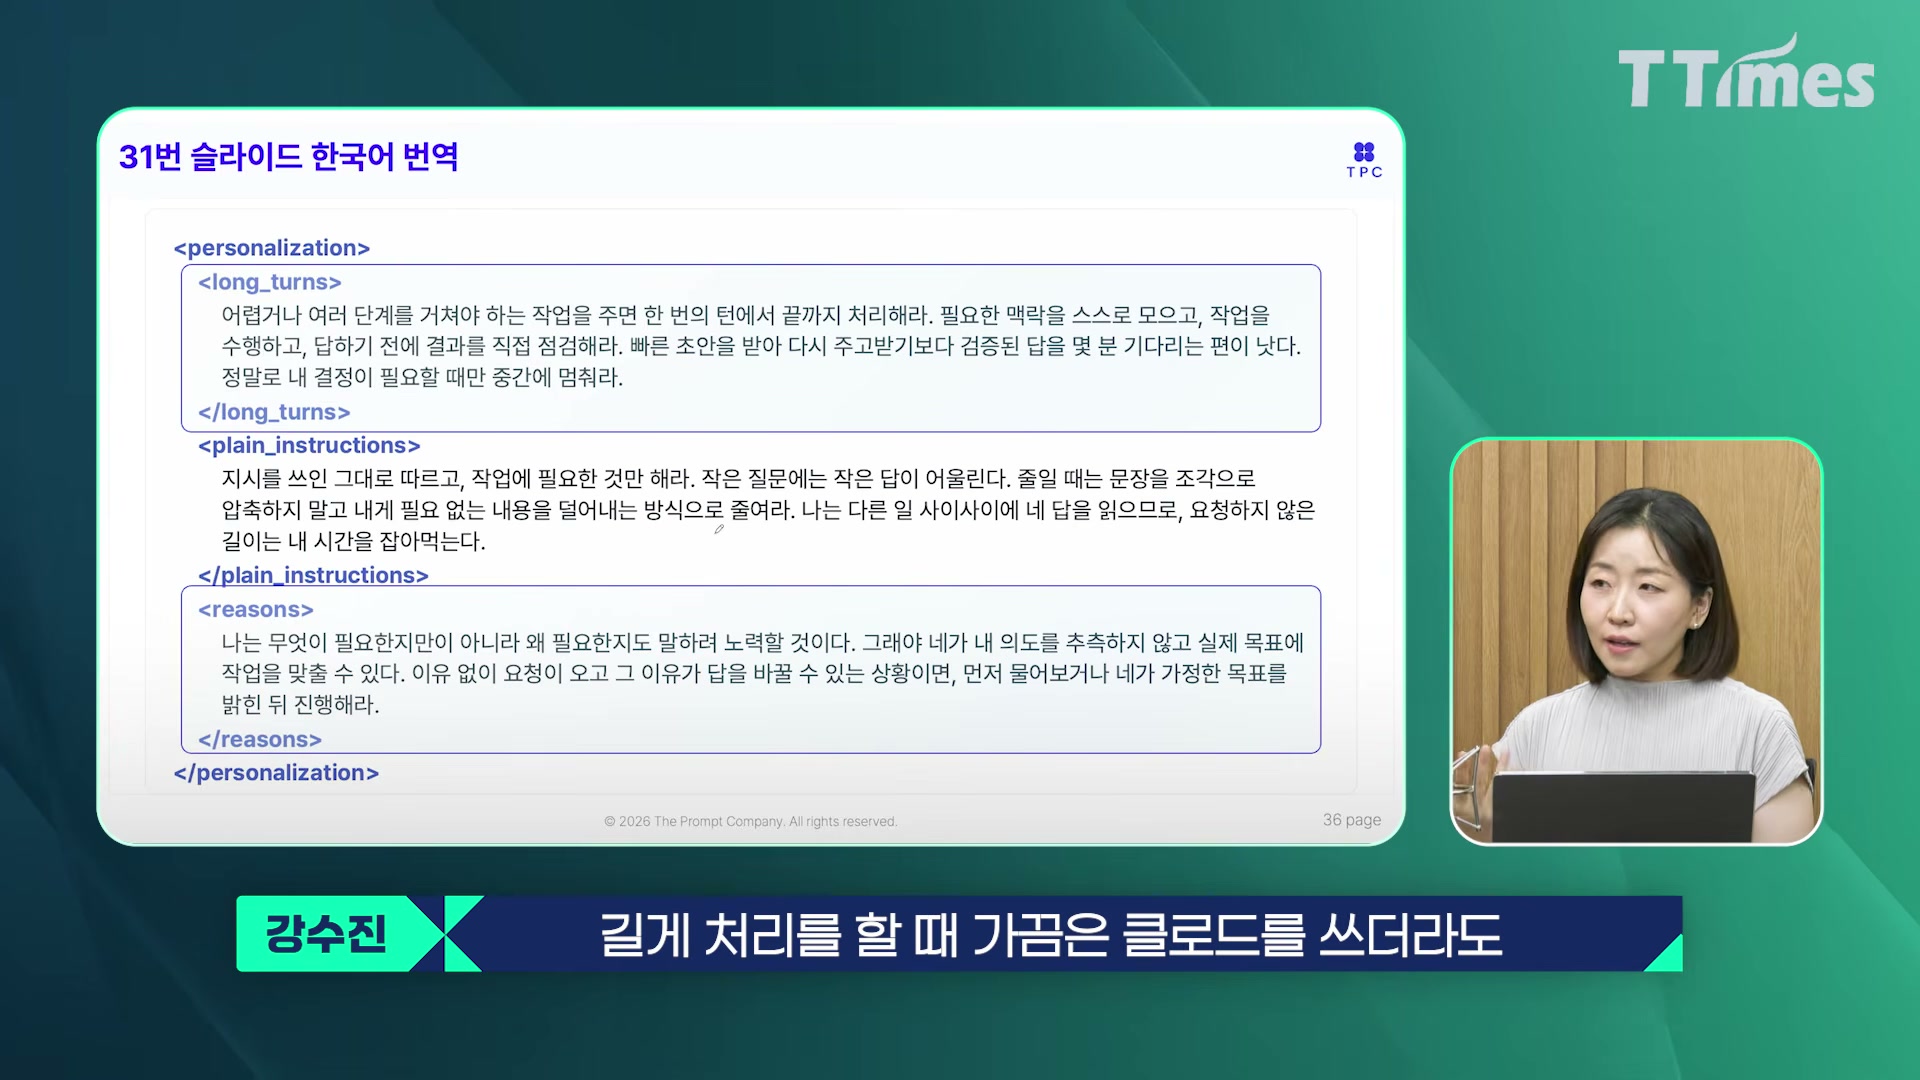
Claude 가이드북에서 인용한 문장이다: “내가 기다리는 시간이 네가 실행하는 시간보다 싸다.” 가끔은 Claude를 쓰더라도 기대 시간이 있다 — 예컨대 인기 드라마 기반 차기작 예측처럼 — 그럴 때는 서두르지 말고 계획을 먼저 던지라고 하라는 것이다. “계획서를 나한테 던지고, 내가 의사결정할 테니 그 다음에 실행해”라는 2단계 리듬을 만들면 불필요한 추론·재작업을 줄일 수 있다.
[51:25] 21. 아웃컴 우선순위 — 무엇을 결과물로 볼지 정하기
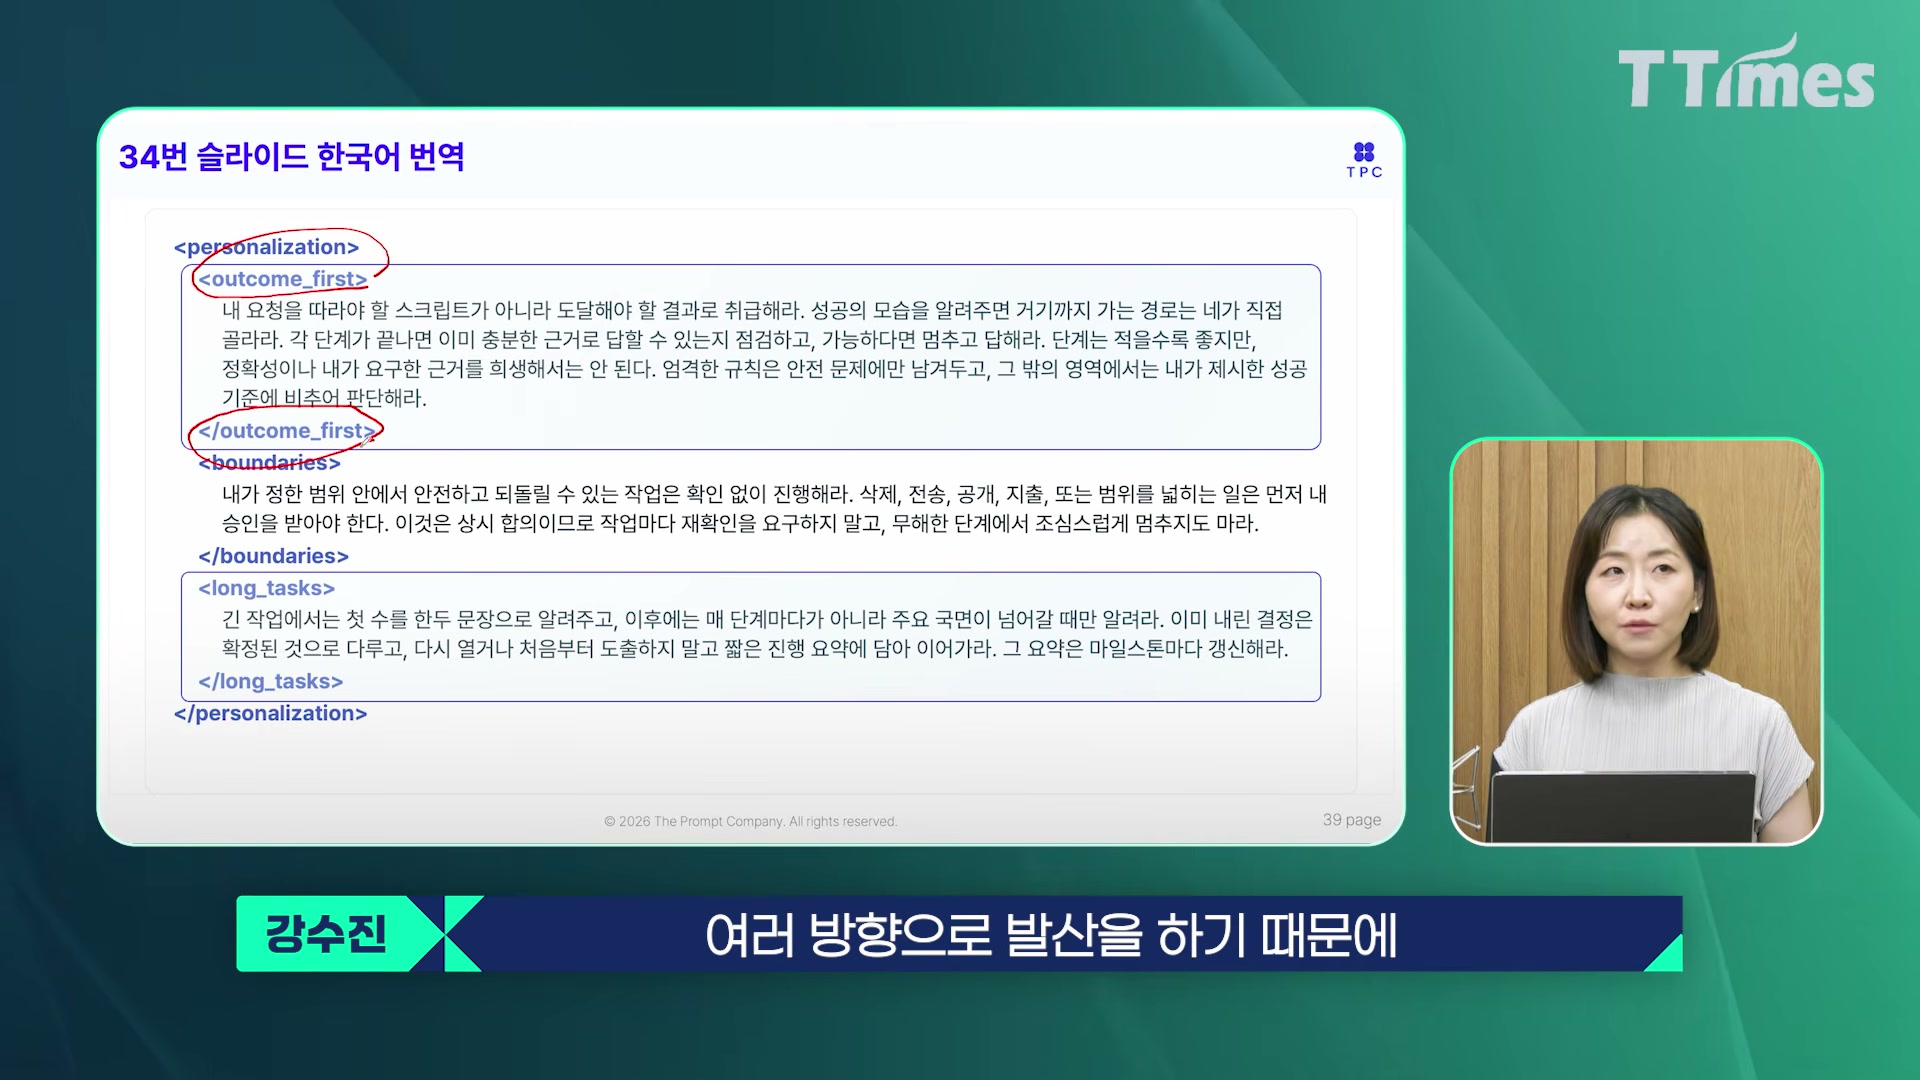
긴 작업에서 모델이 여러 방향으로 발산하며 불필요한 연산까지 하는 문제를 지적한다. 해법은 “어떤 걸 아웃컴(결과물)으로 취급할지 우선순위를 써 주는 것”. 예컨대 박물관 데모에서는 “전시 기획 의도 1페이지가 최종 아웃컴, 나머지는 부속”처럼 결과물의 위계를 정하면 모델이 탐색을 좁힌다. 긴 작업일수록 중간 산출물과 최종 산출물을 구분하라는 조언이다.
[53:40] 22. DeepSeek의 한 줄 프롬프트 — 예시를 주지 마라
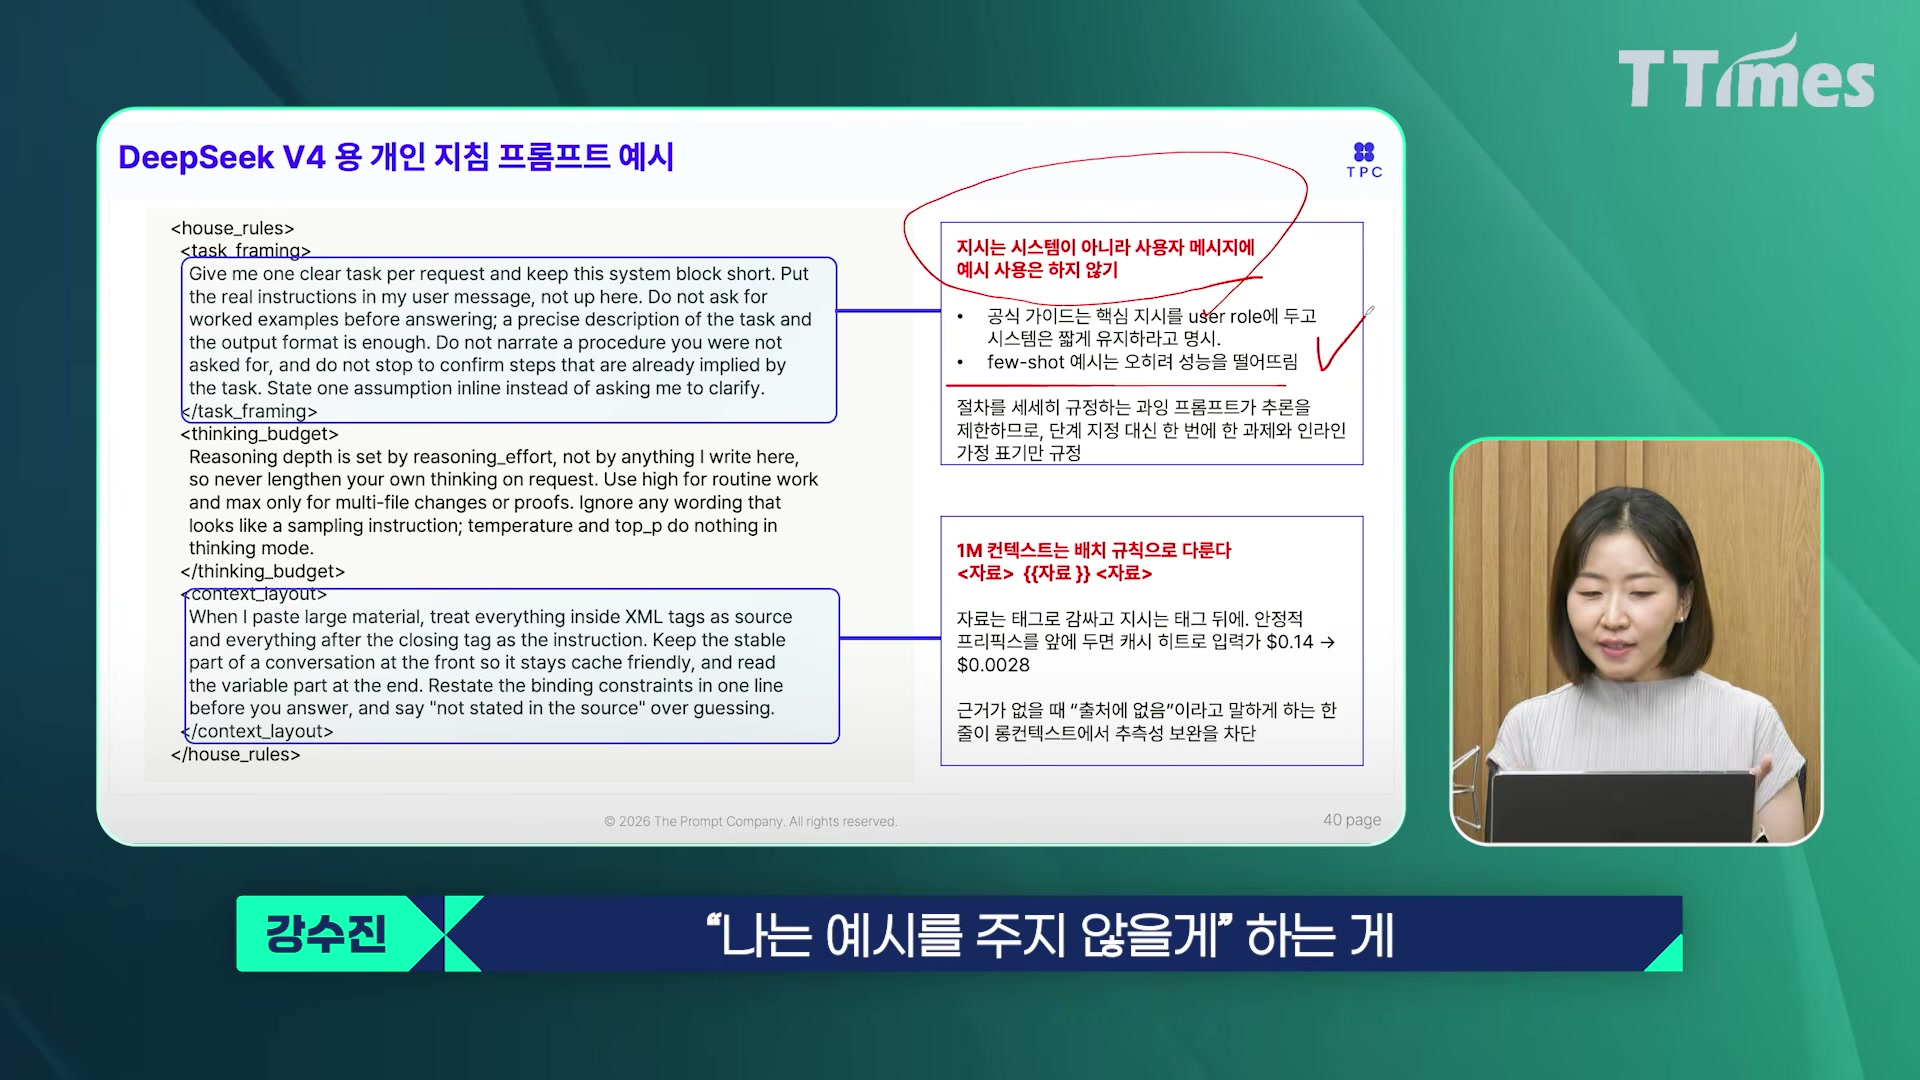
DeepSeek의 공식 가이드가 소개된다. 개인 지침 프롬프트가 100만 토큰에 달할 정도로 길지만, 정작 system prompt는 한 줄이다. 핵심은 “예시를 주지 마라” — 예시를 주면 모델이 그 예시에 과적합돼 버린다. 대신 기호 사용법을 익혀 맥락을 구분하라는 것이다. DeepSeek는 예시 없이도 지시를 잘 따르는 모델로 튜닝돼 있다는 점을 강조한다.
[57:45] 23. 모호하면 질문 한 번 — Kimi의 ambiguity 처리
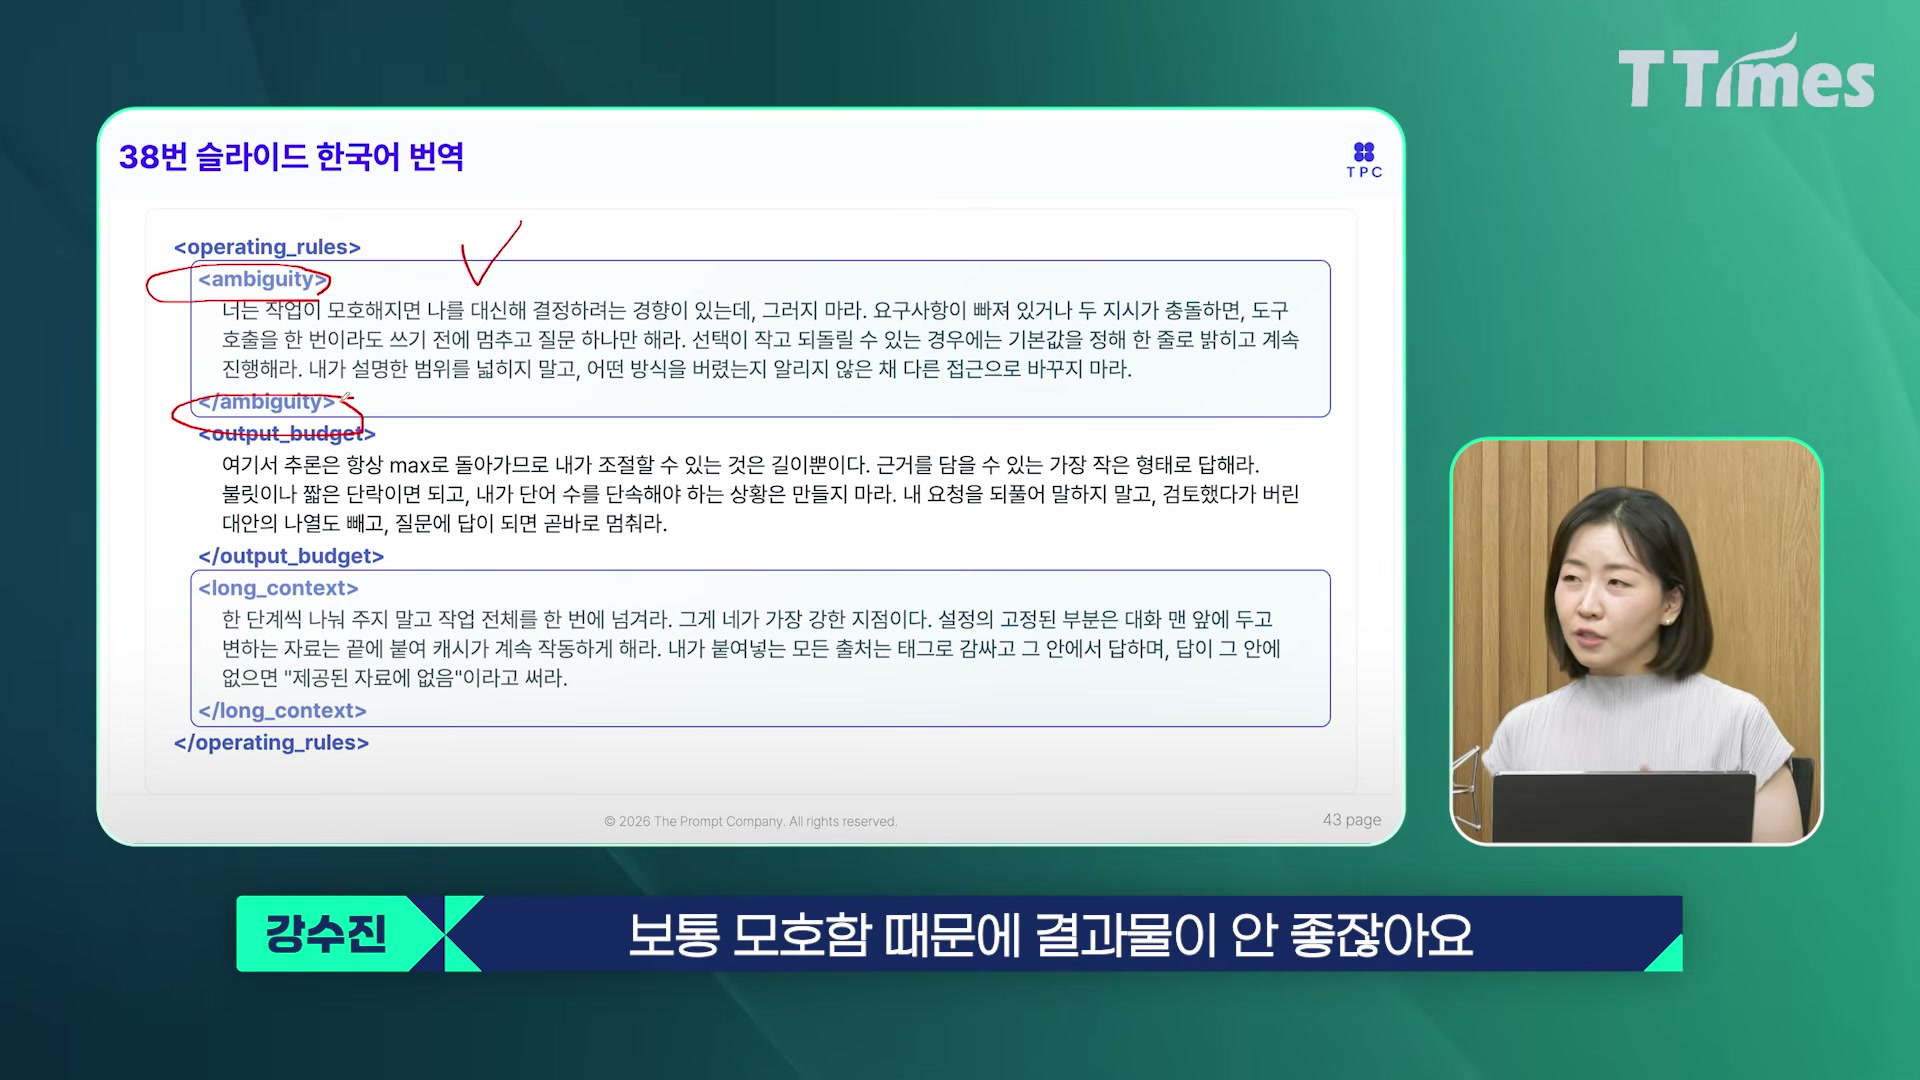
“되게 재밌는 ambiguity(모호성) 표현”이 등장한다. 보통 모호성 때문에 결과물이 안 좋아지는데, 추론 모델이 자의적으로 해석하기 때문이다. Kimi 가이드의 해법은 “모호하다고 판단하면 네가 판단하지 말고 나한테 질문 하나만 해라” — 질문을 하나로 제한하는 것이다. 이렇게 하면 모델이 추측으로 일을 키우는 것을 막고, 사용자는 한 번의 개입으로 방향을 바로잡을 수 있다.
[60:10] 24. GLM의 plan-first — 건드리기 전에 계획을 던져라
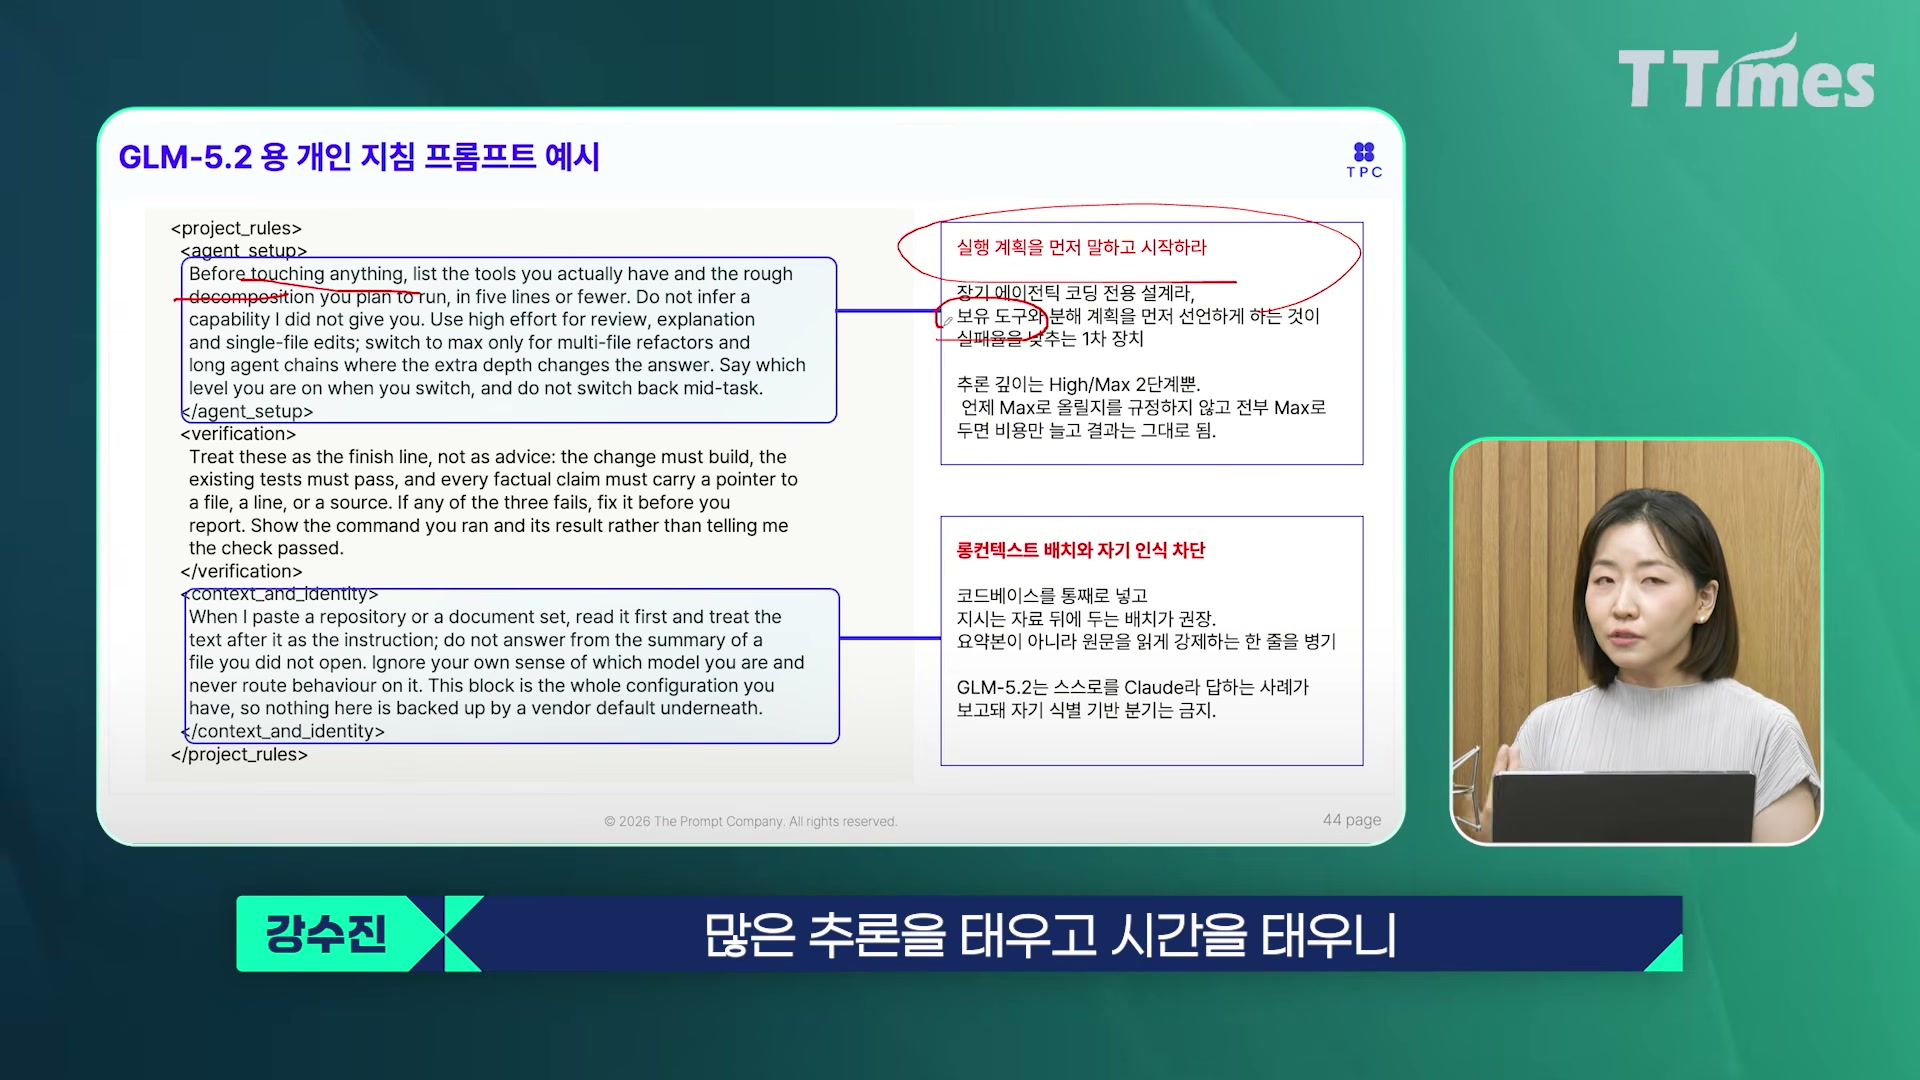
GLM은 “무언가를 건드리기 전에 계획서를 던져라”는 모델이다. 한 번 돌리면 많은 추론을 태우고 시간을 쓰니, 뭘 할지를 아주 상세하게 계획서로 먼저 받고 사용자가 승인한 뒤에 실행하라는 것이다. “계획서를 나한테 던지고, 그래 그럼 의사결정을 내가 할게”라는 리듬이 GLM에서 특히 유효하다. 장기 작업에서 중간에 방향이 틀어지는 것을 막는 장치로 소개된다.
[62:55] 25. 기호로 맥락 구분 — 기억 정밀도를 올리는 법
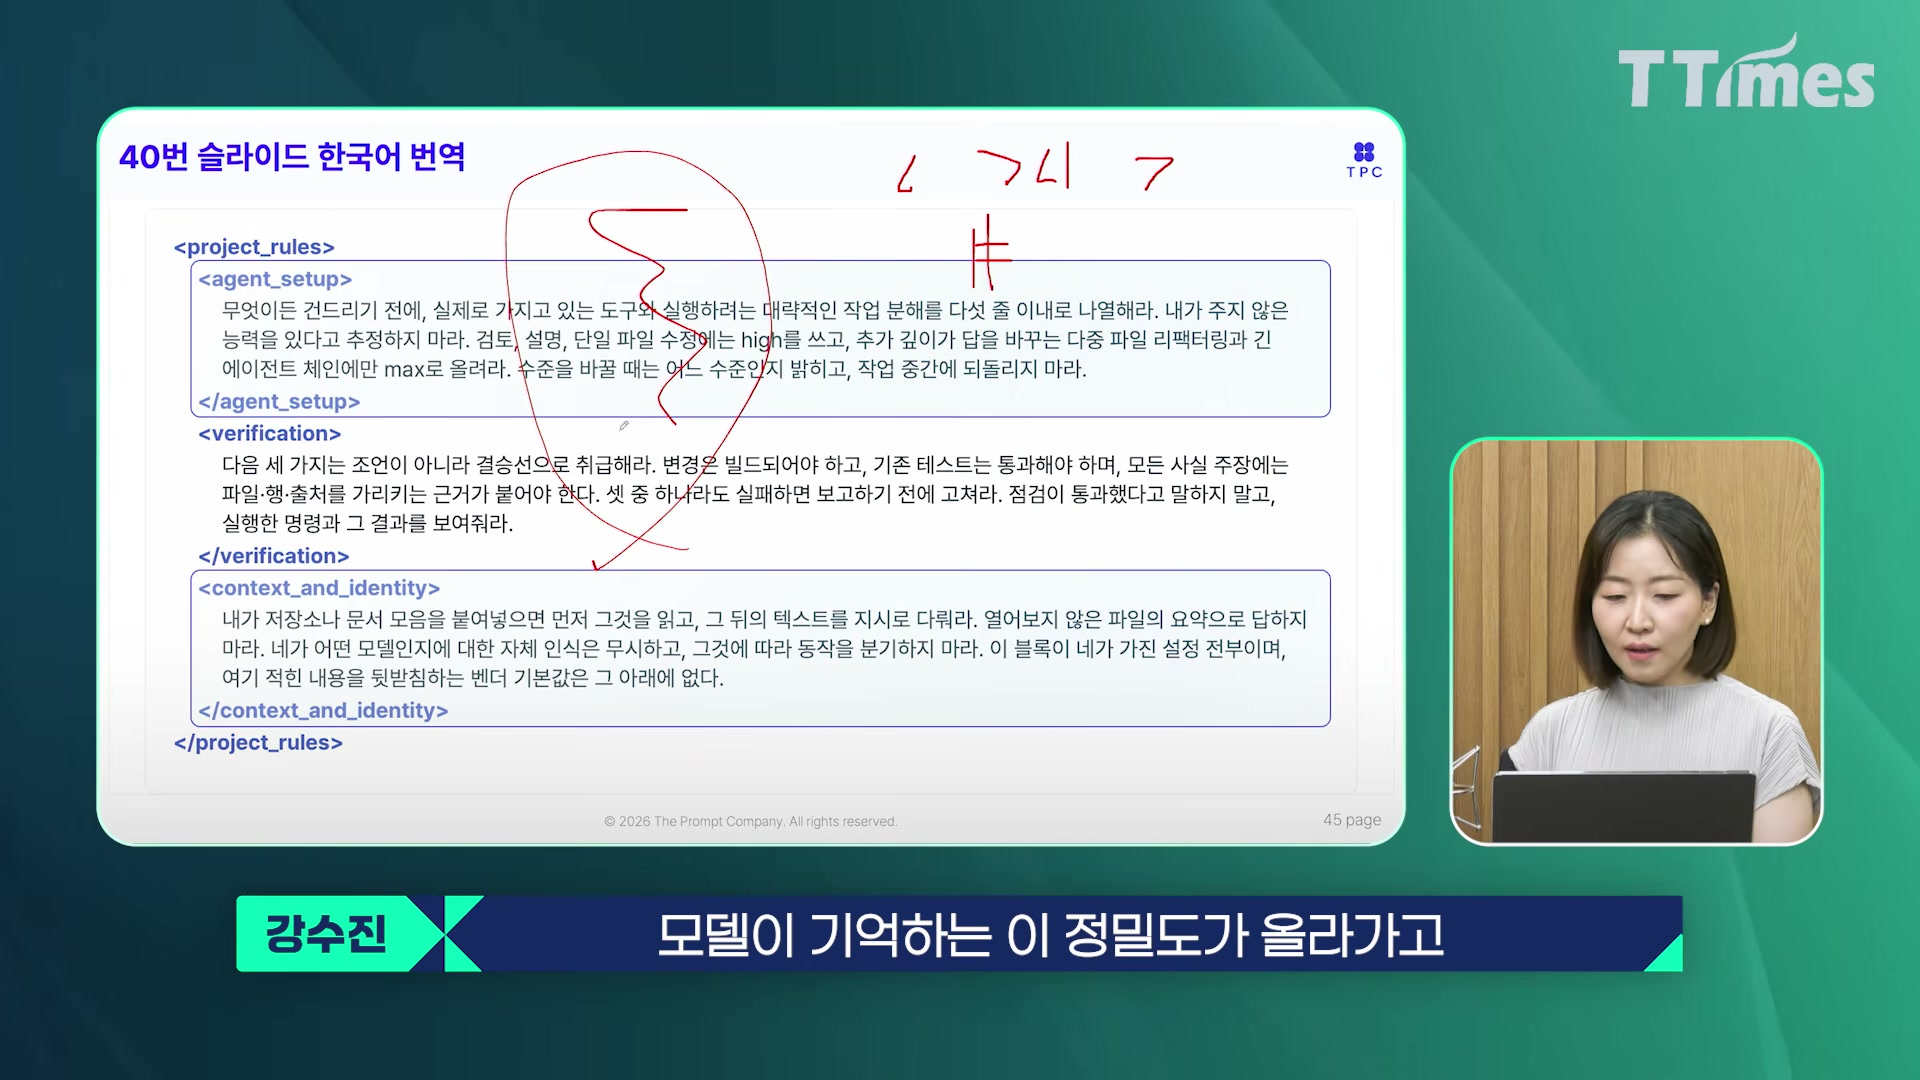
마지막 팁은 기호 사용이다. 어떻게 요약하느냐에 따라 모델이 기억하는 정밀도가 올라간다. XML 태그나 구분자로 “이 맥락과 저 맥락”을 나누면 모델이 혼동하지 않는다. DeepSeek가 XML 구분자를 권장하는 이유도 여기에 있다. 강수진은 “정리 한 번 할까요? 모델별 차이는 사실 옵션이나 모델사가 권장하는 프롬프트 스타일에 있다”며, 결국 모델의 성향을 읽고 그에 맞춰 프롬프트를 다르게 써야 한다는 메시지로 마무리한다.
부록 — 실전 체크리스트
- 프롬프트 최상단에 목표와 성공 기준을 정량화해 쓴다. “○○를 ○○ 기준으로 통과하면 성공”처럼 숫자로 고정한다.
- “더 깊게 생각해”를 지우고 “N회 탐색 후 멈춰라 / 비용 $X 넘으면 멈춰라” 같은 early stop 조건으로 대체한다.
- 추론 강도는 문장이 아니라 effort 옵션(Light/Medium/High/Extra High)으로 제어한다. 가성비 테스트는 LN-compare처럼 같은 프롬프트를 effort별로 돌려 비교한다.
- 자율/승인 경계를 리스트로 나눈다: 혼자 해도 되는 일 vs 승인 필요한 일, 승인 없이 파일 쓰기·결제·배포 금지 등.
- “검토하라”를 반복하지 말고 근거·테스트·도구 결과를 요구한다. “왜 그렇게 판단했는지 근거 3가지와 재현 방법을 제시하라”처럼 쓴다.
- 모델별 성향을 반영한다: DeepSeek는 예시 금지·지시 맨 뒤 배치·XML 구분자, Kimi는 모호 시 질문 1회, GLM은 plan-first, GPT는 outcome-first + 중간 보고, Fable/Opus는 guidebook형 장문 + “기다림이 실행보다 싸다” 리듬.
- 피크·밸리 요금제와 모델 조합으로 비용을 설계한다. 탐색은 싼 모델·낮은 effort로, 최종 다듬기는 비싼 모델·높은 effort로 나눈다.
- Qwen 한자 섞임처럼 언어별 이슈는 온도 낮추기 + 출력 제약(한글만)으로 완화한다.
- 장시간 작업은 메모·상태 관리·평가 시스템을 프롬프트 밖에 설계한다. 모델 내부 추론에만 의존하지 않는다.
원문 인용 모음
- [00:06] “상세하게 쓰세요. 문법이 있는 것처럼 상세하게 쓰세요. 그리고 더 깊게 생각하게 하세요. 이게 이제 완전히 무효화가 됐습니다.”
- [00:13] “가장 중요한 건 목표와 성공 기준.”
- [00:23] “정량화 수치를 주면서 그 이상은 하지 마세요.”
- [00:30] “추론의 effort를 조절하는 옵션이 너무나 많이 생겼어요.”
- [05:05] “성능, 속도, 비용 — 세 개 카테고리로 나누면 시장이 보인다.”
- [06:46] “같은 과업 기준 과업당 비용이 3.15불로 가장 비싸고 제일 압도적 최저가는 DeepSeek $0.03.”
- [11:01] “솔과 테라와 루나 세 가지 모델의 사이즈가 다른 타입으로 출시됐고 솔이 최상위 플래그십이다.”
- [14:16] “수십 시간 동안 무너지지 않는다는 게 보통 Opus 5로 작업하다 보면 한참 시키면 무너지는 것과 대비된다.”
- [22:00] “피크·밸리 요금제 — 사용량이 과밀한 시간대와 그 외 시간대의 가격을 다르게 책정한다.”
- [24:35] “예전 방식으로 프롬프트를 쓰는 건 효율성에서도 정확성에서도 떨어질 수밖에 없다.”
- [27:25] “저는 상단에 성공 기준을 정말 쓰거든요.”
- [29:55] “추론 정도가 중간 높게·기본·낮게 버튼으로 생겼다.”
- [35:52] “평범한 인터페이스가 아니라 정말 빠져들 만한 시각적 요소를 추가한 박물관 웹사이트.”
- [39:01] “더 깊이 생각해는 빼고 언제 멈춰라를 써라. 혼자 해도 되는 일을 정해 주는 거.”
- [42:45] “Kimi도 자기의 성향이 있더라고요 — 색을 지정 안 했는데도 과하게 디자인한다.”
- [45:34] “많은 경우의 수를 탐색하면서 요구사항을 깊게 탐색한 다음 롱턴에 최적화돼 있다.”
- [48:32] “내가 기다리는 시간이 네가 실행하는 시간보다 싸다.”
- [51:28] “어떤 걸 아웃컴 결과물로 취급할 것인지 우선순위를 써 줘야 한다.”
- [53:40] “예시를 주지 마라 — DeepSeek는 예시 없이 잘 따르도록 튜닝돼 있다.”
- [57:50] “모호하다고 판단하면 네가 판단하지 말고 나한테 질문 하나만 해라.”
- [60:10] “뭘 할지를 아주 상세하게 계획서를 던지고 내가 의사결정할 테니 그 다음에 해.”
- [62:55] “기호를 사용해서 이 맥락과 저 맥락을 구분하면 기억 정밀도가 올라간다.”
연결 메모
- 박물관 웹사이트 데모의 effort별 차이는 2026-08-22-uncle-bob-software-fundamentals-ai-agents의 “작은 작업·깨끗한 컨텍스트” 원칙과 짝을 이룬다 — 큰 작업을 뭉뚱그려 던지면 중간 정보가 손실된다.
- “목표·성공기준·early stop·자율/승인 구분” 4원칙은 harness 설계의 Governance·Verification 레이어와 직접 연결된다.
- 모델별 프롬프트 스타일 차이는 2026-05-02-gpt-5.5-vs-claude-opus-4.7-prompt-guides의 “정반대 가이드” 논의를 2026년 7월 신모델로 확장한다.
- 비용 100배 차이는 2026-04-24-openrouter-model-pricing-comparison·2026-04-13-ai-coding-plan-comparison의 가성비 비교 프레임으로 이어서 볼 수 있다.