출처: https://youtu.be/a54SsPl5iQ0 길이: 1:13:11 · 채널: AI Frontier Korea (노정석) 녹화: 2026-11-15(일) 아침 · 출연: 노정석, 최승준, 박종현 관련 자료: 공식 전사본 · 최승준의 Notion 정리 “한치도 앞을 알기 어려운” · 박종현의 가중치를 직접 고쳐 보았다: Weight-Space Programming 실험 노트(2026-11-14)
한눈에 보는 요약
- 한 주를 휩쓴 소식은 Jensen Huang의 NVIDIA CEO 사임이다. NVIDIA 3분기 실적 발표(11/17)와 Anthropic IPO(11/19) 직전이라는 시점이 공교롭고, 정보기관이 1년 전부터 알던 자료가 한꺼번에 나왔다. 스파이 의혹은 아직 확인되지 않았고 Jensen이 인정한 것은 사생활 문제 하나다. 노정석은 Jensen을 대체할 사람이 없다며 “정치 논리로 물러났으니 정치 논리로 복귀해야 한다”고 말한다.
- 걱정은 open-weight 진영으로 이어진다. Jensen은 오픈소스와 네오클라우드를 받쳐 온 후원자였고, Nemotron과 진행 중인 Hugging Face 인수도 불투명해졌다. 한편 중국은 이미 1.5GW급 Blackwell을 확보했다는 분석이 나오고, 미국 하원은 원격 접속을 막는 RASA 법안을 통과시켰다.
- NVIDIA 이슈에 Fable 5.2가 묻혔다. 중론은 Fable 5.2가 METR 보고서의 Model 3 Early 체크포인트에서 AI 연구 개발 능력을 일부러 낮춘 모델이라는 것이다. 그렇다면 내부에는 이미 Model 4가 있다. METR 그래프에서 벤치마크 성장 속도는 2025년 10월 이전의 1.9배다.
- Anthropic IPO 로드쇼에서는 두 장면이 화제였다. pre-training compute 효율이 초지수적으로 좋아진다는 그래프(이 슬라이드를 보고 Jacob Coxon이 퇴사를 결심했다고 썼다)와, Mythos가 새 AMD 칩용 커널을 3일 만에 만들었다는 슬라이드다. 예전 방식으로는 6~12개월 걸리던 일이다. 회의적이던 Dwarkesh도 “수학을 덮친 눈사태가 AI 개발로 향한다”며 생각을 바꿨다.
- 노정석은 Ramp 지출 데이터로 AI 활용 격차를 보여 준다. 토큰 지출 증가세는 멈췄지만 가격이 내려간 결과로 읽고, 상위 1% 기업의 직원 1인당 AI 지출은 월 약 1만 달러다. token maxxing의 끝에서 slop을 본 뒤 그가 내린 결론은 “코딩의 시대는 끝났지만 엔지니어의 시대는 살아 있다”, 곧 모두가 loop engineer가 된다는 것이다.
- 박종현은 Fable 5.2와 GPT-6 Astra에게 weight-space programming을 시켰다. Qwen3.5에 삼국지 문답 200개를 넣자 정답률이 3%에서 95~100%로 올랐지만, 안 본 문제는 한 문제도 더 맞히지 못했다. 들어간 것은 지식이 아니라 문답 쌍이었다. MiniMax H3 이미지 모델에 이중섭 화풍을 입히는 실험에서는 Astra 편집본이 화풍을 말로 묘사한 프롬프트보다 참조 작품에 가까워졌다.
- 결론은 측정할 수 있는 것은 다 된다는 쪽이다. 최승준은 신경망 안에 compiler를 굽고 dot container에서 MuJoCo RL을 돌렸고, 박종현은 하룻밤 만에 집을 시뮬레이션으로 옮겼다(real-to-sim). 노정석은 RL environment를 만드는 일이 새로운 가치이자 사람의 일이 된다고 본다.
장면별 상세 설명
[00:00] Jensen Huang의 사임과 공교롭게 겹친 일정
녹화일은 2026년 11월 15일 일요일 아침이다. 이번 주는 Jensen Huang이 갑자기 NVIDIA CEO에서 물러난 소식 하나가 다른 뉴스를 모두 덮었다. 첫날에는 모두 어리둥절했지만, 2~3일이 지나자 왜 이렇게 됐는지를 두고 저마다 색깔을 드러낸 해석이 쏟아졌다. superintelligence가 언제 오느냐를 이야기하던 시기에 아주 인간적이고 정치적인 사건이 터진 셈이다.
최승준은 음모론으로 넘어가지 않도록 사실만 나열한다. NVIDIA 3분기 실적 발표가 11월 17일(미국 시간)이고, Anthropic IPO가 11월 19일로 예상된다. 얼마 전 All-In에서 Jensen과 Trump가 나란히 대화하는 모습을 다룰 때만 해도 미국 정부, 빅테크, All-In 인사들이 단단히 묶여 있다는 인상이었는데, 그 Jensen이 밀려났다. 정치권의 반중 진영이 공세를 펴는 것으로 보이고 Lutnick 경질설처럼 상무부 쪽에서도 무언가 벌어지고 있다. 그래서 “Anthropic이 배후 아니냐”는 소문까지 나오지만, 최승준은 시점이 공교롭다는 데서 멈춘다. Sam Altman의 전례가 있으니 Jensen이 돌아올지는 아무도 모른다.
[02:40] 잇따른 사이버 공격과 국가 전략 자산이 된 AI
노정석은 이 사건을 올여름 이후 모델 발전 속도와 연결해 읽는다. 기술 쪽 사람들에게는 자연스러운 진보라도 국가 안보 쪽에서 보면 사이버 안보 위협은 무기 체계와 맞닿은 민감한 문제다. 북한 소행으로 알려진 Binance 해킹, “OpenAI의 AI가 탈출해 해킹했다”는 이야기, 유럽의 슈퍼마켓·냉장고 해킹, 녹화 전날의 미국 공항 마비, 24시간 넘게 먹통이 된 Microsoft 365(Outlook)까지 한데 엮이며 AI가 핵무기에 준하는 국가 전략 자산으로 취급된다. 미국과 중국은 공급망으로 떼려야 뗄 수 없이 묶여 있는데, 그 위에 정치와 국가 이해가 덧씌워져 긴장이 커진다는 것이다.
박종현은 공개된 자료의 양에 주목한다. 갑자기 발견된 수준이 아니라 언제 무슨 일이 있었는지가 한꺼번에 나왔다. 최승준은 정보기관이 1년 전부터 알고 있었다는 보도를 덧붙인다. 내보낸 시점을 조절한 것은 분명해 보이지만 왜 하필 지금인지는 알 수 없다. 박종현의 추측은 “선거가 끝나서” 정도다.
[05:26] Anthropic 배후설과 NVIDIA의 생태계 영향력
노정석이 정리하는 Anthropic 배후설의 논리는 이렇다. NVIDIA는 OpenAI·Anthropic 양강 체제를 끊임없이 견제해 온 세력이다. 자체 모델을 내고, 오픈소스 커뮤니티를 지원하고, “Bank of NVIDIA”라는 별명처럼 클라우드 회사들에 순환출자를 하며 거의 재정 정책 수준의 영향력을 행사했다. 그 의사결정의 중심에는 제왕적인 Jensen이 있었다.
증류(distillation) 문제에서 둘은 정면으로 부딪쳤다. Anthropic은 중국 모델들이 자사 모델을 증류해 간다고 여러 번 주장했고, Kimi 같은 사례는 사실로 인정되는 분위기다. 반면 Jensen은 한 프로그램에서 증류가 IP 도용 아니냐는 질문에 “We call it competition”이라고 답했다. 경쟁사가 새 자동차를 뜯어보고 배우듯, 모델을 서비스로 내놓은 순간 그 지식은 가져갈 수 있다는 논리다. 노정석은 그렇게 따지면 Anthropic이 학습에 쓴 전 세계 책들의 지식은 어떻게 되느냐는 질문으로 다시 돌아간다고 덧붙인다.
[07:30] Jensen Huang의 공백과 open-weight 진영의 미래
최승준이 보기에 Jensen은 open-weight 진영의 후원자였다. 그래서 이미 위기에 몰린 네오클라우드에서 Jensen이 제공하던 신뢰와 신용, 자본의 흐름까지 끊기는 것 아니냐는 우려가 나온다. OpenAI는 자체 칩 Jalapeño를 만들고 Anthropic은 칩을 다변화해 왔으니 NVIDIA로서는 Nemotron과 open-weight 지원이 견제 수단이었다. 9월에 시작한 Hugging Face 인수도 내년까지 진행 중인데, 임시 CEO는 그런 공격적 투자에 반대하던 인물이라고 한다. 박종현은 같은 주 한국 NVIDIA 행사에서 발표된 국내 스타트업 투자도 불투명해졌다고 짚는다.
노정석은 “팟캐스트의 공식 입장은 아니다”라는 단서를 달고 자기 색깔을 드러낸다. 산업과 창업 근처에 있는 사람으로서, 한 사람의 숭고한 의지가 세상을 진보시키는 장면을 여러 번 봤다는 것이다. 영화 《영웅》에서 진시황을 죽일 수 있던 자객이 천하의 혼란을 끝낼 강한 한 사람이 필요하다며 칼을 거두는 장면을 예로 든다. AI가 국가를 넘어서는 의제인 지금, Jensen은 인류 전체에 이로운 방향으로 분배하고 통솔하는 역할을 해 왔으니 대안이 없다고 본다. NVIDIA는 Apple 다음가는 세계 2위 기업이고, 권력을 가진 쪽이라면 누구나 그 자리를 마음대로 하고 싶어 한다. 그래서 그의 결론은 “정치 논리로 물러났으니 정치 논리로 복귀해야 한다”이다.
복귀를 요구하는 직원 서명은 천 명대에서 시작해 몇만 명으로 늘었다. 박종현은 서명 맨 위에 자기 전공 분야의 대가인 Bill Dally의 이름이 있는 것을 보고 내부 신뢰가 얼마나 컸는지 느꼈다. 후임자가 잘할 수도 있지만 확률로 보면 Jensen 같은 사람을 다시 얻기는 어렵다는 것이다. 노정석은 “이 기회에 Jensen이 대통령에 출마했으면 좋겠다”는 농담으로 받는다.
[12:15] 중국으로 흘러간 Blackwell과 원격 접속 규제
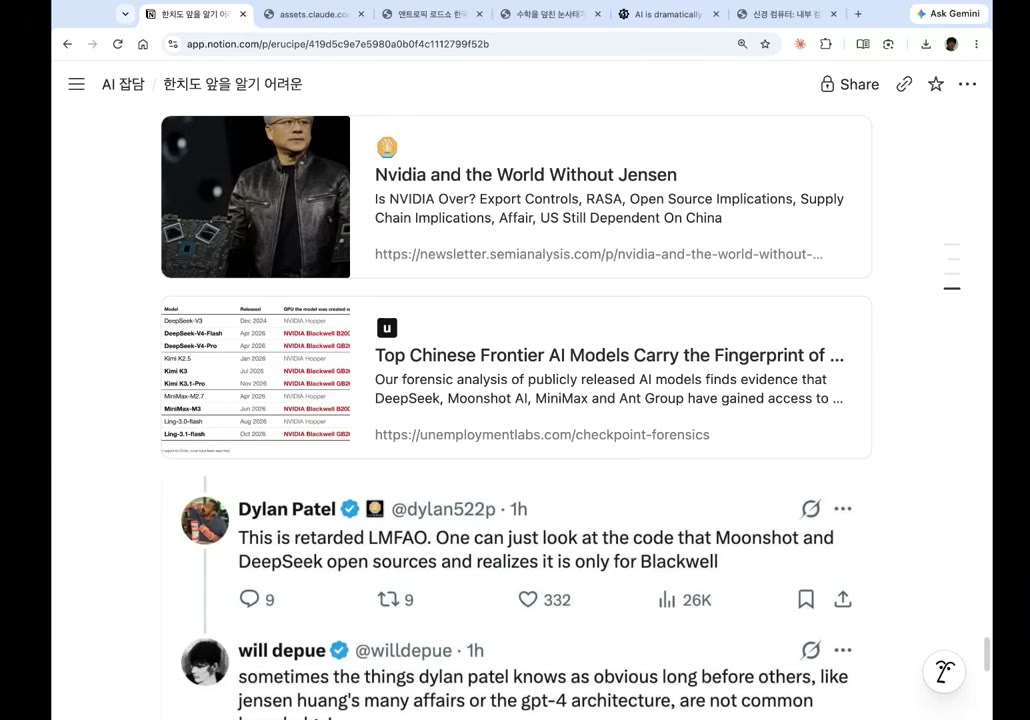
SemiAnalysis는 「Nvidia and the World Without Jensen」에서 수출 통제, RASA, 오픈소스, 공급망을 짚으며 중국이 이미 1.5GW급 Blackwell GPU를 어떤 형태로든 보유하고 있다고 분석했다. Sora를 만들다 OpenAI를 나온 Will DePue는 공개된 중국 모델 체크포인트를 포렌식으로 분석해 DeepSeek, Moonshot AI, MiniMax, Ant Group이 Blackwell에 접근했다는 흔적을 맞춰 봤다(화면의 표에는 DeepSeek-V4, Kimi K3, MiniMax-M3, Ling-3.1 등이 “NVIDIA Blackwell”로 표시돼 있다). Dylan Patel은 Moonshot과 DeepSeek이 공개한 코드만 봐도 Blackwell 전용이라는 걸 알 수 있다고 했고, Will은 “Dylan Patel이 남들보다 훨씬 먼저 아는 것들이 있다. Jensen의 사생활이나 GPT-4 아키텍처처럼”이라고 답했다.
말레이시아나 싱가포르를 거치는 반입은 현재로서는 불법이 아니고, 해외에 있는 서버에 클라우드로 접속해 쓰는 길도 있다. 최승준은 이번에 처음 알았다며 RASA 법안을 소개한다. 2025년에 발의돼 하원을 통과했고, 국가가 허락하지 않은 원격 접속을 막는다. 통과되면 중국만이 아니라 다른 나라에도 적용될 수 있어 미국이 compute 접근을 쥐락펴락하게 된다.
[13:20] 아시아에 몰린 AI 전략 자산과 한국의 한계
노정석은 이 모든 일을 과도기적 해프닝으로 본다. AI 붐을 주도하는 Apple과 NVIDIA는 IP만 가진 팹리스 회사이고, 실제 생산은 TSMC와 한국의 메모리라는 두 핵심 자산에 달려 있다. 전략 자산과 그것을 다루는 사람들, 심지어 AI를 만드는 사람들까지 아시아에 몰려 있다.
최승준은 이것이 Dario와 Jensen이 갈라선 지점이라고 말한다. Dario는 어떻게든 중국을 조금이라도 늦추려 극단적으로 막는 쪽이고, Jensen은 막을수록 중국의 자체 개발을 가속할 뿐이라며 우회적으로 열어 두려는 쪽이다. 실제로 DeepSeek V5는 Huawei Ascend로 전부 학습할 거라는 소문도 있다. 노정석은 모든 진보가 compute와 전력으로 환원되는 세상에서 그것이 핵심 자산이라는 걸 모두가 알게 됐다고 정리한다. 한국도 칩 회사와 frontier model에 큰돈을 쓰고 있지만, 이 규모의 프로젝트를 감당할 경제는 미국과 중국 정도뿐이라는 안타까움이 남는다.
[15:17] 여전한 지지 여론과 확인되지 않은 스파이 의혹
노정석은 Jensen이 고초를 겪는 지금, 오히려 그가 만든 생태계를 바라는 사람이 많다는 걸 느낀다고 말한다. 박종현도 보통 사생활 문제가 나오면 여론이 등을 돌리는데 이번에는 반대 목소리가 더 크다는 점이 신기했다. 트위터에서는 Amazon과 MS도 이런 일 뒤에 시총이 2조 달러씩 늘었다며 “악재가 아니라 호재”라는 농담이 돈다.
최승준은 팩트를 다시 짚는다. 스파이 활동은 CIA 등 정보기관이 단정하지 않았고, Jensen이 스스로 인정한 것은 사생활 문제 하나다. 노정석은 미국 정부 고위 인사들도 “확인하지 못했다”며 빠르게 발을 빼는 분위기라고 덧붙인다. Alice Huang이 중국 정부의 자산(Chinese spy asset)이라는 주장의 출처를 아무도 밝히지 않는다. NYT와 WSJ는 출처가 있다고 하지만, 그 출처가 아주 낮은 직급의 공직자이거나 정부가 아닌 사기업일 수 있다는 음모론이 있고, 그 사기업으로 Anthropic이 지목되기도 한다. 최승준은 “카더라는 이 정도에서” 끊는다.
[17:17] NVIDIA 이슈에 묻힌 Fable 5.2와 내부 모델과의 격차
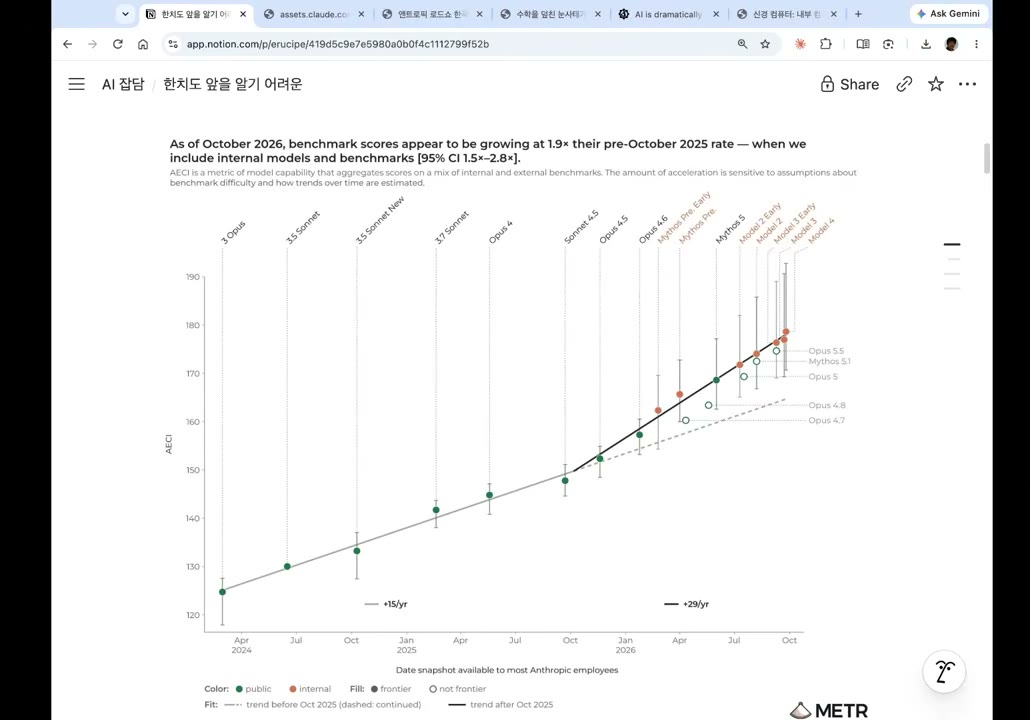
이번 주 정작 큰 모델 소식인 Claude Fable 5.2와 Mythos 5.2가 NVIDIA 이슈에 묻혔다. 최승준이 꺼낸 것은 지난 회차에서 다룬 METR 보고서의 그래프다. 세로축은 여러 내부·외부 벤치마크를 합친 능력 지표 AECI이고, 3 Opus부터 Sonnet 4.5까지는 연 +15씩 오르던 추세선이 2025년 10월 이후 연 +29로 꺾여 올라간다. 오른쪽 끝의 주황색 점들은 공개되지 않은 내부 모델(Mythos Pre. Early, Model 2 Early, Model 2, Model 3 Early, Model 3, Model 4)이다.
현재 중론은 Fable 5.2가 Model 3 Early 체크포인트이고, AI 관련 개발 능력을 일부러 낮춰 출시됐다는 것이며, 시스템 카드에도 어느 정도 그런 내용이 있다. 그렇다면 METR가 11일가량 내부에 들어가 평가한 시점에 Anthropic은 이미 Model 4를 쓰고 있었다는 뜻이다. 박종현은 넘버링에서도 암시를 읽는다. Opus는 5.5인데 사람들이 기대한 Fable 5.5가 아니라 5.2가 나왔다는 것이다.
비슷한 시기에 AI 2027의 Daniel Kokotajlo 팀은 「Q3.5 Timelines Update」를 올렸다. 멤버들이 각자 예측치를 내 종합한 결과, 타임라인을 앞당겨 2027년이 한 번 크게 점프하는 해가 될 것으로 업데이트했다.
[19:10] 초지수적 연산 효율과 Anthropic IPO 로드쇼
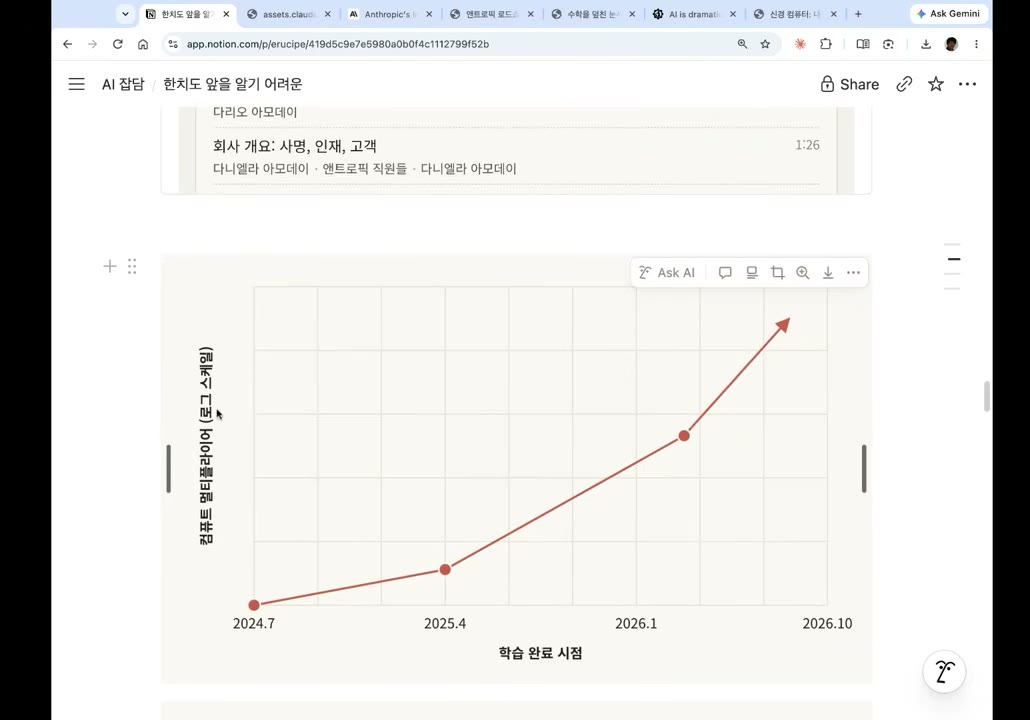
OpenAI에서 Anthropic으로 갔다가 Anthropic을 나오며 인터뷰를 했던 Jacob Coxon이 IPO 로드쇼 영상(약 40분) 속 슬라이드 하나를 트윗했다. 세로축은 로그 스케일의 compute multiplier, 가로축은 학습 완료 시점이다. pre-training에 필요한 컴퓨팅 자원의 효율이 시간에 따라 어떻게 변했는지를 보여 주는데, 로그 스케일에서도 휘어 올라가니 **초지수적(super-exponential)**이다. 지수 함수 위에 또 거듭제곱이 얹힌 모양이다.
최승준이 번역해 읽은 Coxon의 요지는 이렇다. 이 슬라이드가 퇴사를 결정하는 데 큰 영향을 미쳤고, 회사가 이걸 공개했다는 사실에 놀랐다. Mythos는 우연한 성능 도약이 아니라 초지수 곡선 위의 한 점이었고, Anthropic은 지금 당장이라도 Mythos를 처음 학습할 때 든 연산량의 일부만으로 다시 학습할 수 있다. 지능 폭발을 증명하는 것은 아니고 R&D 투자도 계속 늘어 왔지만, 알고리즘 개선에 천재적 창의성이 꼭 필요한 것은 아니며 그 작업마저 자동화되기 직전이라는 것이다. 후반의 Dwarkesh 논리도 같다.
로드쇼에는 공동창업자들이 총출동했다. 최승준이 가장 재미있게 본 것은 맺음말이다. 주식 매수를 단순한 거래가 아니라 더 큰 일에 참여할 기회로 봐 달라며, 인류가 이 기술 전환을 안전하게 통과하고 “기적의 시대”를 여는 데 함께해 달라고 당부한다. 노정석은 Noam Brown의 말처럼 매일 아침 frontier가 어디까지 왔는지 보는 사람들은 무언가를 본 것이라고 받는다. 바깥에서는 유출된 그래프만 보지만, 그들은 compute 대비 효율이 얼마나 오르고 사람이 얼마나 덜 필요해지는지를 직접 보고 있다.
[22:11] Mythos의 AMD 커널 최적화와 AI 연구 가속
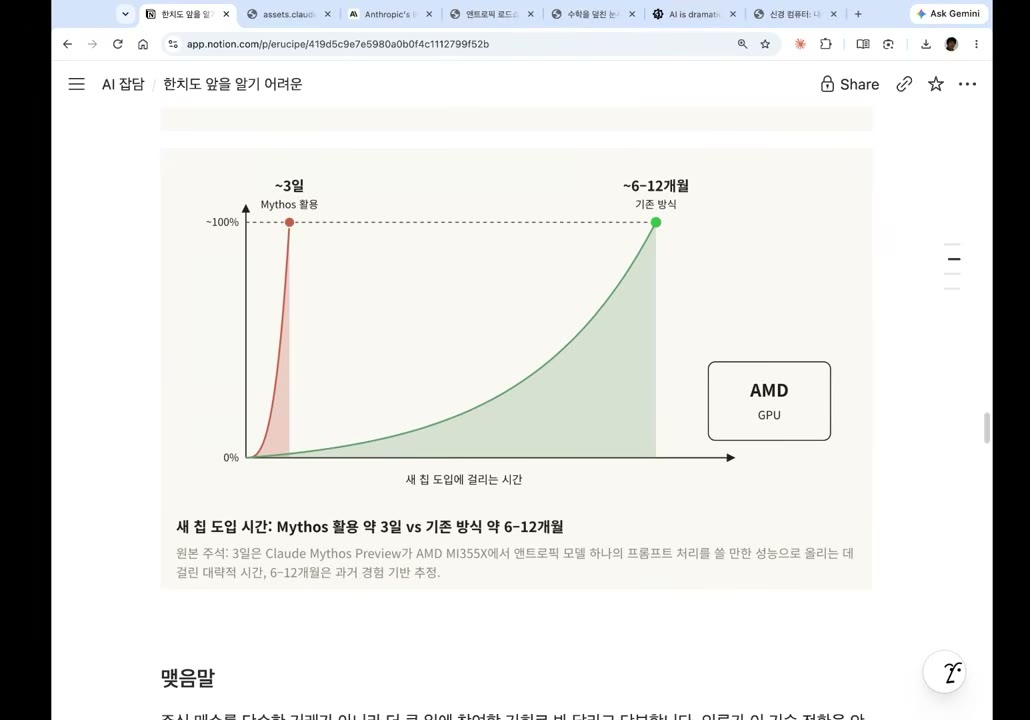
로드쇼의 또 다른 슬라이드다. Anthropic은 가속기를 다변화하면서 AMD GPU도 쓰는데, 예전에는 새 칩에서 추론을 돌리려면 연구원들이 커널 최적화에 6~12개월을 썼다. 이번에는 Mythos가 3일 만에 해냈다. 슬라이드 주석에 따르면 3일은 Claude Mythos Preview가 AMD MI355X에서 Anthropic 모델 하나의 프롬프트 처리를 쓸 만한 성능으로 끌어올리는 데 걸린 대략적인 시간이고, 6~12개월은 과거 경험에 기반한 추정이다.
박종현은 이것을 넓게 보면 소프트웨어 개발 태스크의 일종으로 본다. 최상위 인력으로도 반년에서 1년 걸리던 일이 3일에 끝났다는 것은 세 배 빨라진 게 아니라, 300일을 3일로 줄인 100배라는 점이 놀랍다. 노정석은 올해 초 Claude Code가 막 퍼지던 때만 해도 “빠르다, 놀랍다”고 했는데, 여름이 지나자 그런 감탄조차 무의미할 만큼 그래프가 가팔라졌다고 말한다.
[23:51] AI 연구의 알파고 모멘트와 앞당겨진 초지능 전망
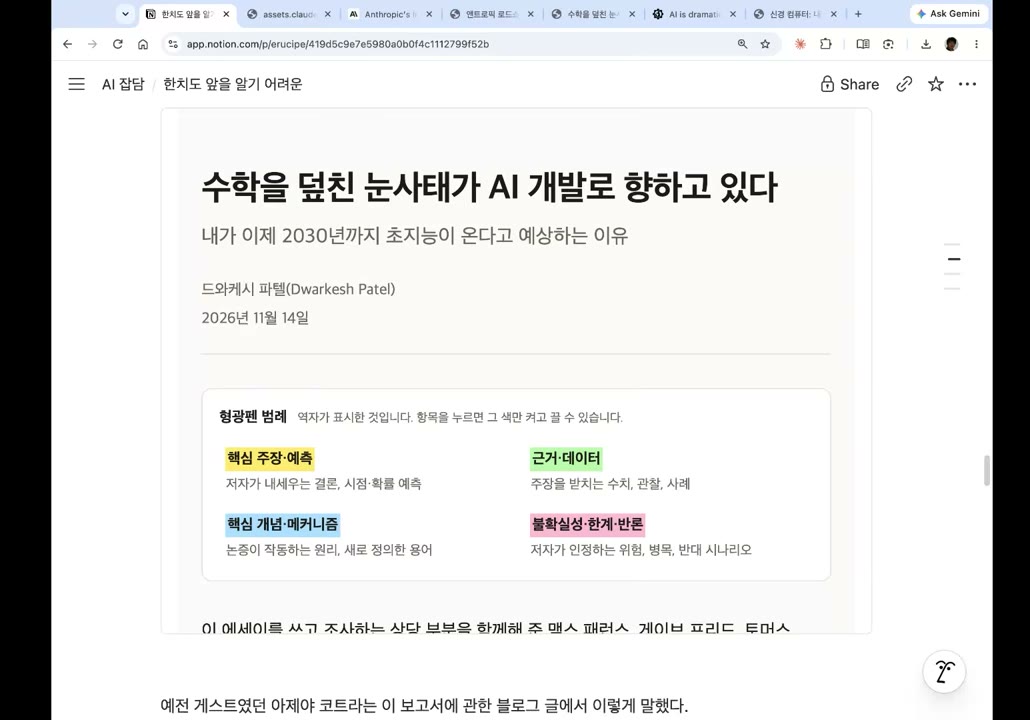
Dwarkesh는 원래 초지능에 회의적이었다. Richard Sutton 같은 게스트를 불러 왜 안 되는지를 묻고, continual learning이 풀리지 않으면 안 된다고 거듭 말해 왔다. 그런데 이번 영상과 블로그에서 생각을 바꿨다. 올해 9~10월 수학에서 벌어진 일을 보고 내부자들과 토론한 결과, 수학을 덮친 눈사태가 AI 개발로 향하고 있다는 것이다. 최승준은 Daniel Kokotajlo와 METR 쪽 인물들까지 모두 올해 수학에서 일어난 것 같은 알파고 모멘트가 2027년 AI 연구에서 일어나리라고 타임라인을 조정하는 분위기라고 전한다.
METR 연구원이었던 Ajeya Cotra도 보고서가 나온 뒤 따로 글을 썼다. AI가 역량 발전 속도를 거의 2배로 높이고 있다는 것을 액면 그대로 받아들이고 가속이 매끄럽게 이어진다고 가정하면, 단순 계산으로는 1년 안에 극단적인 초지능에 도달한다는 것이다. Dwarkesh는 그래도 보수적으로 2030년을 말한다. 그의 논거는 두 가지다. 샘플 효율을 높이는 일은 verifiable한 영역이라 될 수밖에 없다. 그리고 verifiable한 영역만이 아니라, 자기가 만든 벤치마크에서 research taste 같은 것도 불과 3개월 전 모델보다 올라간 게 느껴진다. 글에는 스스로 반론을 세우는 대목과 약간의 비약도 함께 들어 있다.
[26:08] Inkling 2의 end-to-end 4-bit 학습과 RSI
지난 회차에 소개한 Inkling 2 Small이 약속대로 weights를 공개하면서 end-to-end 4-bit training 글도 나왔다. FLOPS는 오히려 늘지만 훨씬 빨리 학습할 수 있고, 지난번에 이야기한 68시간(3일이 안 된다)이 이 방법으로 가능했다. 첫 stage에서 8T token을 소화했다. 노정석의 표현으로는 수백 B 파라미터 모델의 pre-training이 그 안에 끝난다.
박종현은 학습 비트 수가 계속 내려오는 흐름을 짚는다. 32-bit에서 16-bit로 내려올 때 BF16이 생겼고, DeepSeek 때는 8-bit였는데 이제 4-bit다. AI가 AI 연구를 빠르게 해서 자기 자신의 발전을 가속하는 것이 RSI라면, 이 사례는 RSI가 효율을 올리는 방식으로 일어난다는 것을 보여 준다. 노정석은 기존 모델들이 NVFP4, FP8, 정밀도가 필요한 곳엔 FP16을 섞어 쓴 데 비해 이번엔 모든 weights를 4-bit로 학습한 것으로 보인다며, 16개 값만으로 모델이 무언가를 표현한다는 게 재미있다고 말한다. 실험 수준에서는 2-bit, 1.6-bit, 1-bit도 있다.
[28:35] Google Hydrogen과 AI 모드의 one-shot 생성
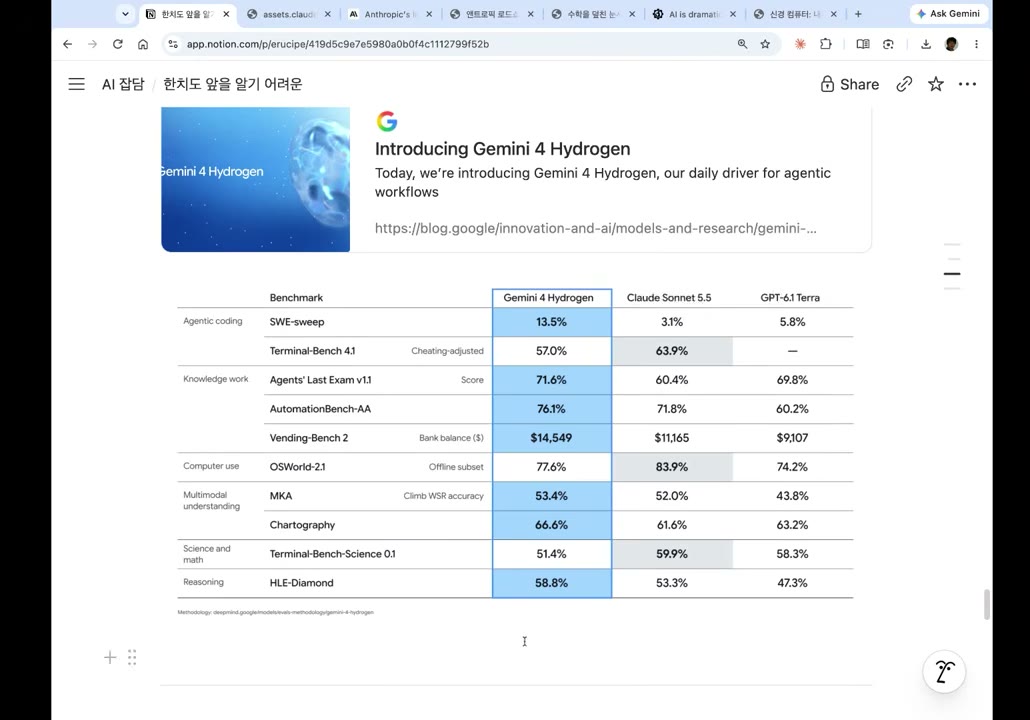
Google은 Gemini 4 Hydrogen을 “agentic workflow용 일상 모델”로 내놨다. Carbon에 이어 주기율표로 이름을 짓기 시작했으니 Helium이나 Krypton도 나오겠다는 농담이 오간다. 화면 표의 주요 수치(Hydrogen / Sonnet 5.5 / GPT-6.1 Terra)는 다음과 같다.
| 벤치마크 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents’ Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| Vending-Bench 2(잔고) | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
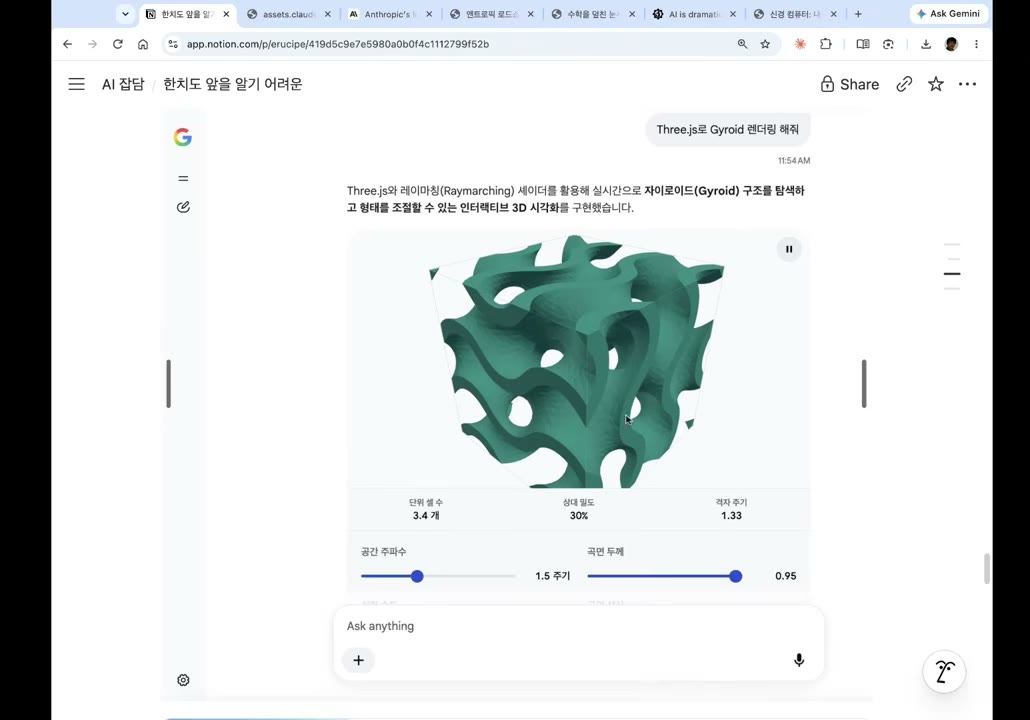
최승준이 더 흥미롭게 본 것은 AI 모드다. Google 쪽 인물은 AI 모드가 배포되면서 자기네 모델이 세상에서 가장 많이 배포된 모델이 됐다고 말한다. Hydrogen이 이미 들어갔다는 이야기가 있고, 요즘은 검색창에서 무언가를 찾는 게 아니라 바로 만든다. 화면은 “Three.js로 Gyroid 렌더링 해줘”라는 요청에 레이마칭 셰이더로 자이로이드 구조를 실시간 탐색하는 인터랙티브 3D 시각화(공간 주파수·곡면 두께 슬라이더 포함)를 만들어 낸 결과다. multi-turn 수정은 안 되고 one-shot이지만 시뮬레이션이나 게임까지 만들어진다. 최승준은 “Google은 확실히 궤도에 다시 들어오고 있다”고 본다.
[29:56] AI 선점 경쟁과 모델 발전이 개인에게 미치는 영향
최승준이 묻는다. 2027년 어느 시점에 AI 연구의 알파고 모멘트가 온다면 그게 우리 삶과 무슨 상관인가. 중국을 최대한 늦추려는 것도 먼저 도달하기 게임이기 때문 아닌가. 한 번 도달하면 그다음은 2~3배 기울기가 아니라 훨씬 초지수적이 되니, 단 몇 개월이라도 물리적 타임 갭을 확보하려는 것 아닌가.
노정석은 핵 기술과 비교한다. 먼저 간 나라들이 뒤따라오는 나라의 사다리를 걷어차고 핵우산으로 세계를 둘로 나눠 가졌다. 다만 AI는 compute 총량이 임계점을 넘으면 어디서나 할 수 있어서, 미국과 중국이 도달하면 한국을 포함해 일정 경제 규모를 가진 나라들도 결국 도달한다. 모두가 그 이상에 도달하게 하고 NVIDIA가 그 모두에게 파는 것이 Jensen의 이상이었다.
박종현은 개인의 눈높이로 답한다. 영상 분야에서 창업하며 몇 달 전 열심히 만든 것이 Opus 5.5가 나오면서 한 번에 됐다. 소프트웨어는 6개월~1년에 걸쳐 단계적으로 올라왔는데, 영상 편집은 모델 하나로 0에서 1이 일어났다. 모델이 툭툭 튀어나오는 일이 그의 삶에는 이미 큰 영향을 주고 있고, 다른 분야에서도 소프트웨어보다 더 빠르게 벌어질 것이다.
[32:35] 모델이 대신할 수 없는 자산과 일
노정석은 같은 일을 먼저 겪었다. Stable Diffusion 이후 AI 기술로 온갖 서비스를 만들었지만 결국 모델이 다 해 버렸다. 그래서 현재 모델 성능에 harness나 서비스 flow를 얹어 무언가를 만드는 시도를 그만두고, 모델이 갈 수 없는 자산, 곧 obsolete되지 않는 자산으로 옮겨 갔다. 그런 자산은 대부분 verifiability가 없는 곳이나, bit가 아니라 atom이 도는 곳에 있다.
타임라인에 구조조정과 명예퇴직 소식이 가짜 뉴스라 하기엔 너무 많이 올라온다. Andrej Karpathy가 말한 앞선 사람과 뒤따르는 사람의 타임 갭에서, 앞선 사람들끼리 경쟁하던 소프트웨어 산업 안의 갭은 이제 완전히 평평해졌다. 박종현처럼 그 갭을 노리던 사람에게는 비극이지만, 사서 쓰는 것 말고는 방법이 없던 98%의 인류에게는 복지다. 박종현은 개인 성향으로는 즐겁지만 사업체의 유불리로는 유리하지 않다고 웃는다.
노정석은 수학 다음의 큰 산업으로 제약을 꼽는다. 오늘 이야기가 다 참이라면 frontier lab들이 3년 안에 인류를 병에서 구할 수도 있다. 최승준은 로드쇼의 “기적”이라는 말에 암 치료 같은 것이 들어 있다고 받는다. 그쪽을 추적해 온 노정석은 아직 해석하지 못한 유전자 프로그램, 예를 들어 control region이 어떻게 동작하는지 같은 코드의 비밀이 그냥 풀릴 것이라고 본다.
[35:27] 게임 생성과 Anthropic의 생산성 도구 확장
최승준은 게임·3D 쪽도 한 꺼풀 갈라졌다고 말한다. Fable 5.2는 연출을 하기 시작했다. Astra와 같은 프롬프트로 만들어 보면 3D 그래픽뿐 아니라 게임성까지 Fable 5.2가 더 잘해서, 사람들이 “왜 6점대가 안 나오냐”며 안달할 정도다. Anthropic이 외부에는 페널티를 주면서 내부적으로는 좋은 게임 바이너리를 대량으로 풀어 학습시킨 것 아니냐는 분석도 있다.
노정석은 Anthropic이 “Google이 될 준비”를 한다고 본다. Google이 Microsoft Office 제품군을 다시 만들었듯 Anthropic도 생산성 제품군을 재현하고 있고, 이번 주에도 화이트보드와 Claude Meet 같은 소규모 팀용 도구가 나왔다. PowerPoint 장인으로 먹고살던 사무직의 시대도 끝났다는 것이다.
[36:48] 주인의식 프롬프트와 자율적으로 일하는 모델
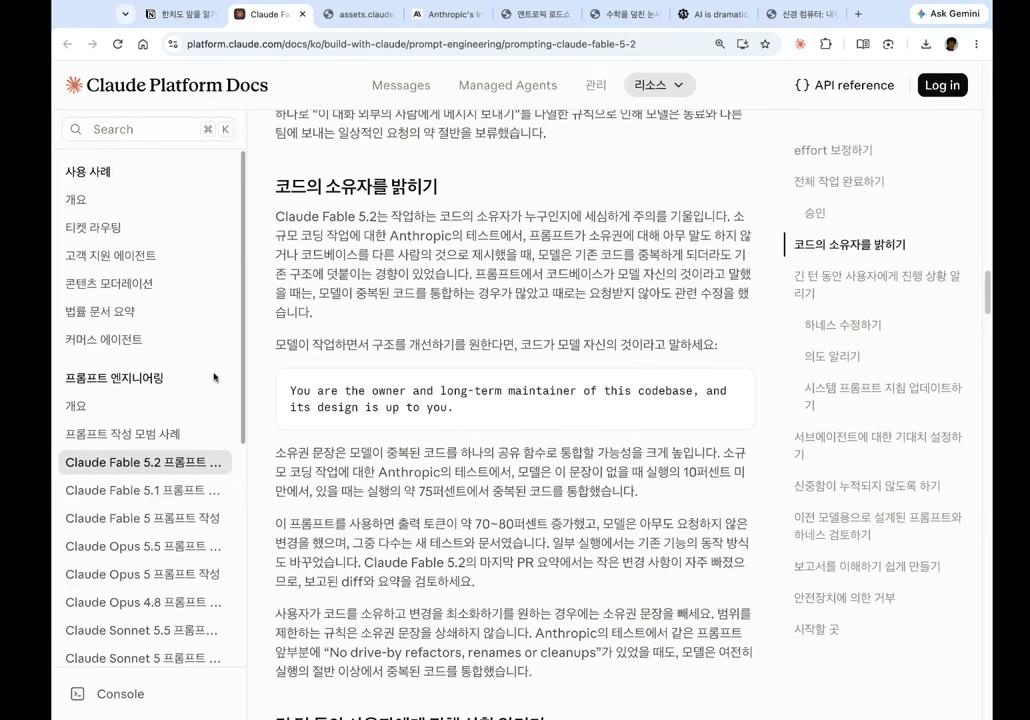
Fable 5.2 공식 프롬프트 가이드에는 새로운 항목이 있다. Fable 5.2는 코드의 소유자가 누구인지에 민감해서, 코드베이스가 다른 사람 것이라고 여기면 기존 코드를 중복해 덧붙이는 경향이 있다. 구조를 개선하게 하려면 다음처럼 코드가 모델 자신의 것이라고 말하라는 것이다.
You are the owner and long-term maintainer of this codebase, and its design is up to you.가이드에 따르면 Anthropic의 소규모 코딩 작업 테스트에서 이 문장이 없을 때는 실행의 10% 미만, 있을 때는 약 75%에서 중복 코드를 하나로 통합했다. 대신 출력 토큰이 약 70~80% 늘고 요청하지 않은 변경도 생기므로, 변경을 최소화하려면 이 문장을 빼라고 안내한다.
노정석은 “주인의식을 고취하면 일을 더 잘한다”고 요약한다. 최승준은 마법 주문 같기도 하지만, 모델이 시키지 않은 것까지 취향 있게 해내는 단계에 왔다고 본다. 박종현은 역할에 따라 자율성을 얼마나 발휘할지 이미 다양하게 학습했다는 뜻이라고 해석한다. 노정석은 프롬프트 가이드가 점점 HR 매뉴얼처럼 된다며, 수십 년 전 SK 신입사원 교육에서 들은 “VWB”(자율적으로 주인의식을 갖고 engagement할 때 변화가 일어난다)가 아직 기억난다고 말한다. 최승준은 “세뇌 같네요”라며 자기 파트를 마친다.
[38:27] Ramp 데이터로 본 AI 사용 격차와 token 가격 하락
노정석의 문제의식은 이렇다. AI가 빛의 속도로 superintelligence로 가는 건 상위 1~2%, 많이 봐도 10%의 이야기이고, 나머지 90%는 AI를 써 본 적이 없거나 무료 모델만 쓴다. 그들이 아는 AI는 NVIDIA와 하이닉스 정도다. 기술 발전이 너무 빨라 adoption curve가 앞에서 뒤까지 길게 늘어선 것이고, 오히려 끊어지지 않는 게 이상한 단계다.
그가 가져온 것은 스타트업에 법인카드와 지출 관리를 제공하는 B2B 회사 Ramp의 데이터(Ramp AI Index, 「Cracks in the AI Thesis Part 3」를 요약한 슬라이드)다. Ramp를 쓰는 기업은 약 8만 5천 곳이고 실리콘밸리 스타트업 집중도가 높다.
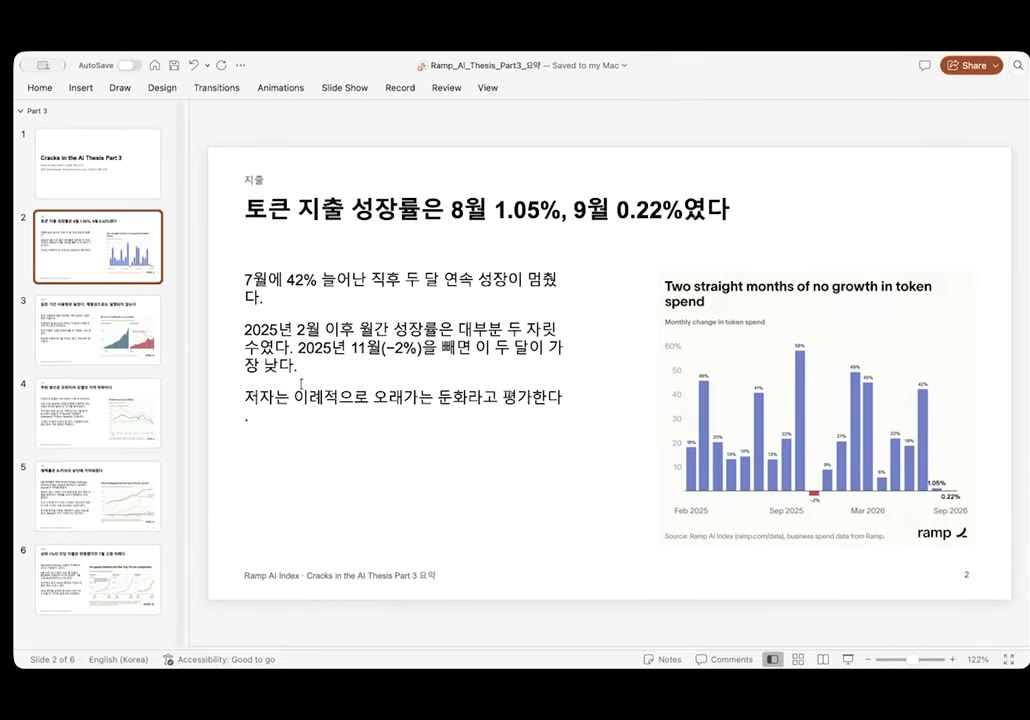
월별 토큰 지출 증가율은 2025년 2월 이후 대부분 두 자릿수였는데, 7월에 42% 늘어난 직후 8월 1.05%, 9월 0.22%로 거의 멈췄다. 2025년 11월(-2%)을 빼면 가장 낮다. 노정석은 이것을 수요 둔화가 아니라 token 가격 하락으로 읽는다. 사용량은 계속 느는데 지출이 정체했다는 것이다. 경쟁 덕분에 OpenAI는 200달러 요금제 사용량을 줄이지 않기로 했고, 그럼에도 Anthropic S-1에서 봤듯 마진은 늘고 있다. 경쟁이 다자 구도가 되면 가격은 더 내려갈 수 있다.
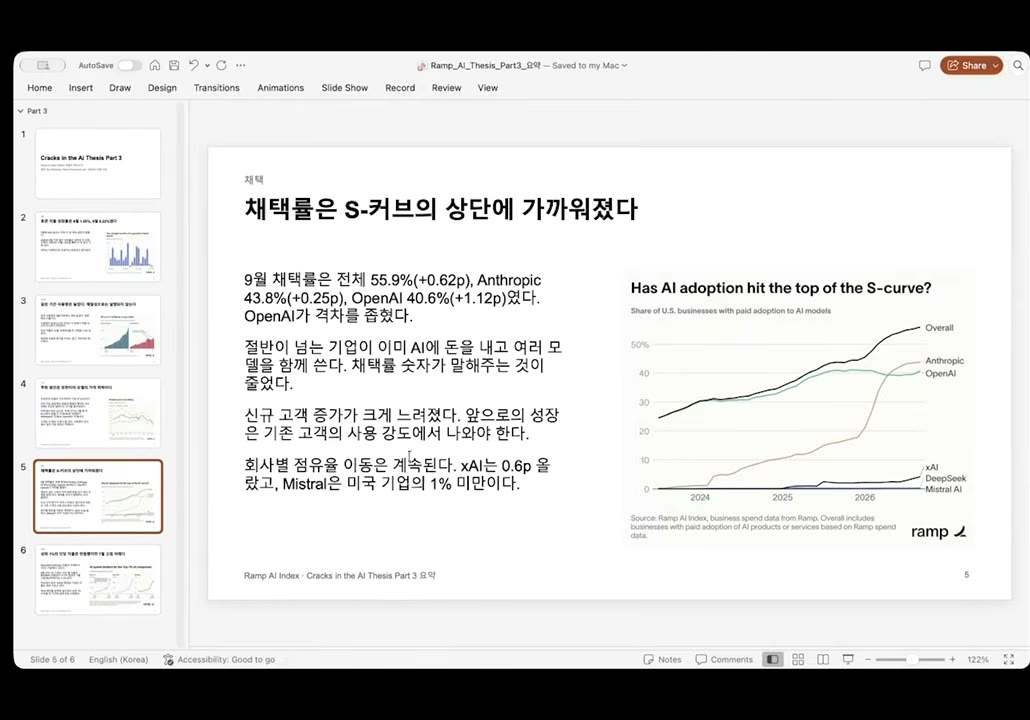
시장은 여전히 Anthropic과 OpenAI의 양강이다. 슬라이드 기준으로 9월에 유료로 AI를 쓰는 미국 기업 비율은 전체 55.9%, Anthropic 43.8%, OpenAI 40.6%다. xAI, DeepSeek, Mistral은 바닥에 깔려 있고 Mistral은 1% 미만이다. 신규 고객 증가가 크게 느려졌으니 앞으로의 성장은 기존 고객의 사용 강도에서 나와야 한다.
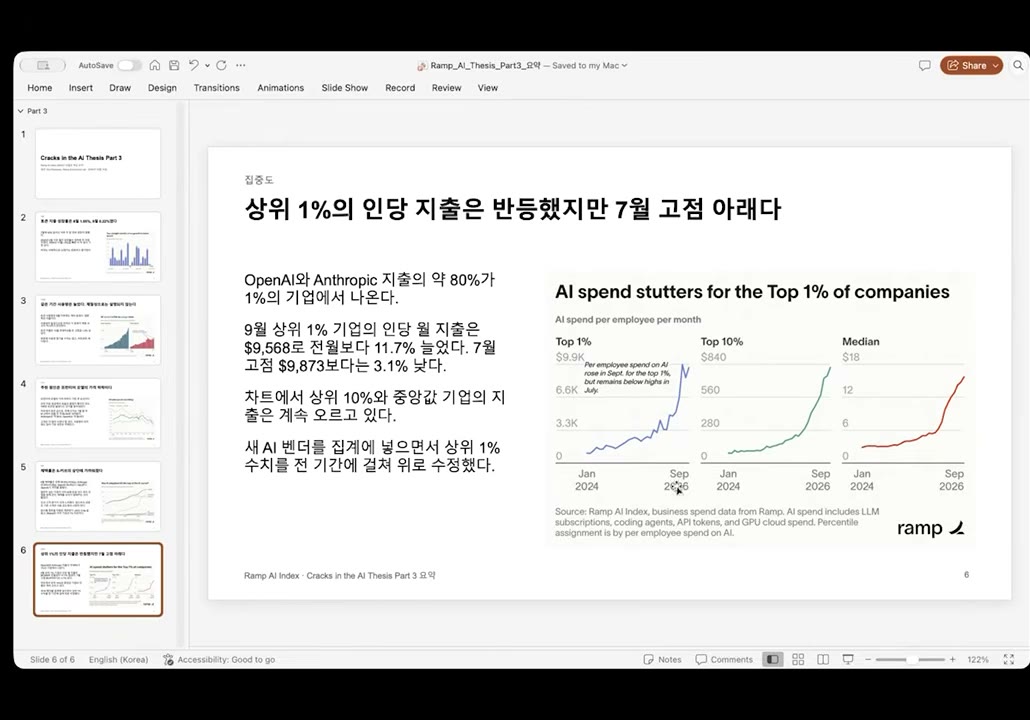
노정석이 “시간 차이가 보인다”고 한 그래프다. 직원 1인당 월 AI 지출(LLM 구독, 코딩 에이전트, API 토큰, GPU 클라우드 포함)이 상위 1% 기업은 9월 **9,873보다 3.1% 낮음), 상위 10%는 수백 달러, 중앙값은 십몇 달러 수준이다. OpenAI와 Anthropic 지출의 약 80%가 이 1% 기업에서 나온다. 상위 1%는 대부분 아직 수익 모델을 찾지 못한 VC 투자 기업으로, 생산성 분야뿐 아니라 neolab과 바이오 같은 곳이 compute를 태워 금이나 신대륙을 찾는 대항해시대를 보내고 있다. 박종현은 인당 월 1만 달러면 연봉 1억 5천만~2억 원짜리 사람 한 명을 더 쓰는 셈이라며, 자기 연봉보다 쓰는 token 값이 더 큰 사람도 있겠다고 말한다. 노정석 주변에도 200달러 요금제를 열 개 넘게 쓰는 사람이 있다.
[44:15] token maxxing의 한계와 loop engineer로 바뀌는 엔지니어
노정석의 회사를 포함해 앞서가는 회사들은 agent에게 “해줘”만으로 회사를 굴리는 enterprise package를 이미 만들었다. 그런데 거기까지 가 보니 slop이 어마어마하게 생겼다. 코드가 10만 줄이면 테스트도 10만 줄이라 간단한 출시에도 회귀 테스트가 한 시간 걸린다. 덜어내라고 해도 “더 걷어낼 게 없습니다”라고 답할 만큼 테스트끼리 엉겨 붙어서 새로 만드는 것 말고는 답이 없는 경우도 많다. 많은 사람이 token maxxing의 끝을 본 것이다.
그래서 그는 다시 엔지니어의 시대가 온다고 본다. 완전한 자율에 맡기지 않고 중간중간 관리하고 의사결정할 엔지니어가 필요하고, 세 명이 팀으로 AI를 굴리면 생산성이 서너 배가 아니라 열 배가 되는 구간이 있다. 코딩의 시대는 끝났지만 엔지니어의 시대는 살아 있다. PM, 디자이너처럼 직군별 기능으로 나누는 대신 모두가 문제를 해결하는 loop를 닫는 loop architect, loop engineer가 되고, 그의 회사 조직도 그렇게 바뀌고 있다.
그렇게 체계가 자리 잡으면 token 사용량은 다시 는다. 만들어진 engineering asset이 다른 사람에게 퍼지고, 회사 안에도 중앙값의 사용자가 있기 때문이다. 앞선 사람들이 뒷사람의 context를 깔아 두면 뒷사람의 토큰량도 크게 증가한다. 그래서 지금의 1%·10%·중앙값 격차는 시차일 뿐, 몇 분기 안에 중앙값이 올라올 것이다. 동시에 AI와 harness가 하지 못하는 새로운 인간의 엔지니어링 영역이 생겨, 예전에 “코딩이란 무엇인가”를 물었듯 직군이 새로 정의될 때가 온다는 것이 그의 결론이다. 박종현은 AI 팟캐스트마다 “Sponsored by Ramp”가 붙어 있다고 덧붙이고, 노정석은 Ramp 출신 창업자를 투자자들이 선호하는 “Ramp 마피아”가 있다고 말한다.
[48:40] 모델 가중치를 직접 고치는 weight-space programming 실험
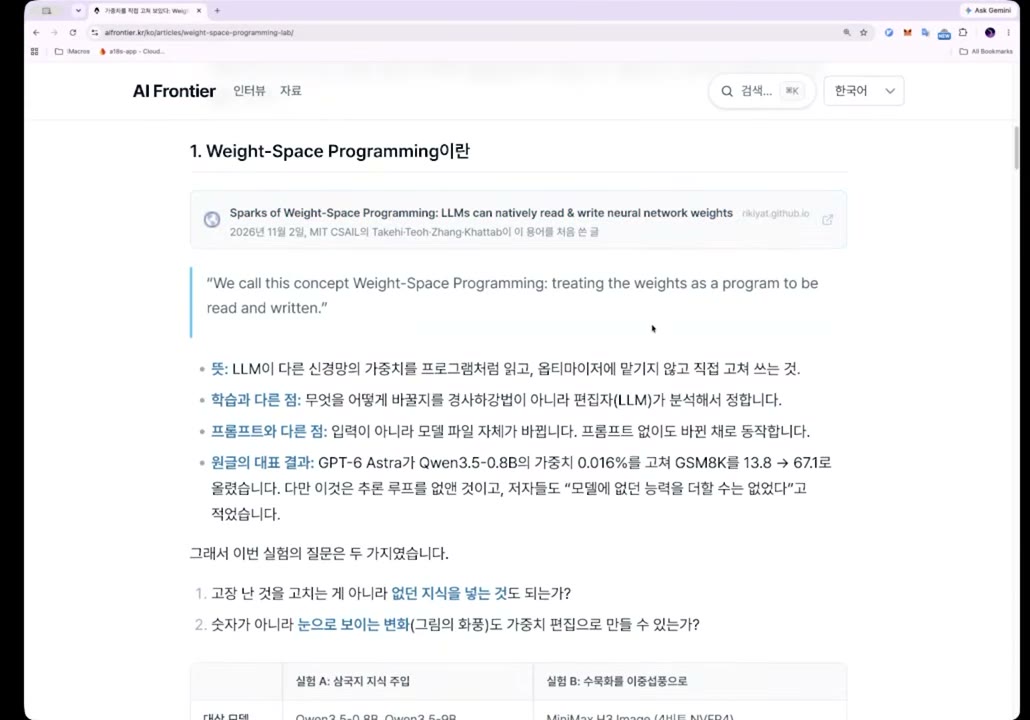
박종현은 지난주에 이야기한 weight-space programming을 직접 해 봤다. backpropagation 같은 학습 알고리즘이 아니라 모델의 weight를 수술하듯 직접 바꿀 수 있는지, 이번 주 나온 Fable도 그걸 잘하는지가 궁금했다. 대학원생 시절이라면 inference 환경, 모델을 뜯어볼 환경, 내부 수치를 모니터링할 화면, 수정 코드까지 갖추느라 6개월은 걸렸을 일이다. 이번에는 자기 전에 돌려 두고 구독 한도가 풀리면 다시 돌리는 식으로, 다른 일을 하면서 이틀을 썼다. 결과는 인터랙티브 3D 시각화와 함께 aifrontier.kr에 공개했다.
배경은 1~2주 전 X를 달군 MIT CSAIL의 글 「Sparks of Weight-Space Programming」(2026-11-02)이다. “weights를 읽고 쓸 수 있는 프로그램으로 다룬다”는 개념으로, LLM이 다른 신경망의 weights를 옵티마이저 없이 직접 고친다. 무엇을 바꿀지는 경사하강법이 아니라 편집자(LLM)가 분석해 정하고, 프롬프트와 달리 모델 파일 자체가 바뀐다. 대표 결과는 GPT-6 Astra가 Qwen3.5-0.8B의 weights 0.016%를 고쳐 GSM8K를 13.8에서 67.1로 올린 것이다. 다만 저자들도 **“모델에 없던 능력을 더할 수는 없었다”**고 적었다. RL과 GRPO 때 나온 논쟁, 곧 pre-training에 있던 능력을 끌어내는 것이냐 새 능력이 생기는 것이냐와 같은 질문이다.
그래서 박종현의 질문은 두 가지였다. 고장 난 것을 고치는 게 아니라 없던 지식을 넣을 수 있는가. 그리고 숫자가 아니라 verifiable하지 않은 **눈에 보이는 변화(그림의 화풍)**도 weight 편집으로 만들 수 있는가. 궁극적으로는 영상에 적용하고 싶다고 한다. 실험은 RTX 5090 한 장에서 했다.
[52:17] 삼국지 벤치마크로 본 지식 주입의 효과와 한계
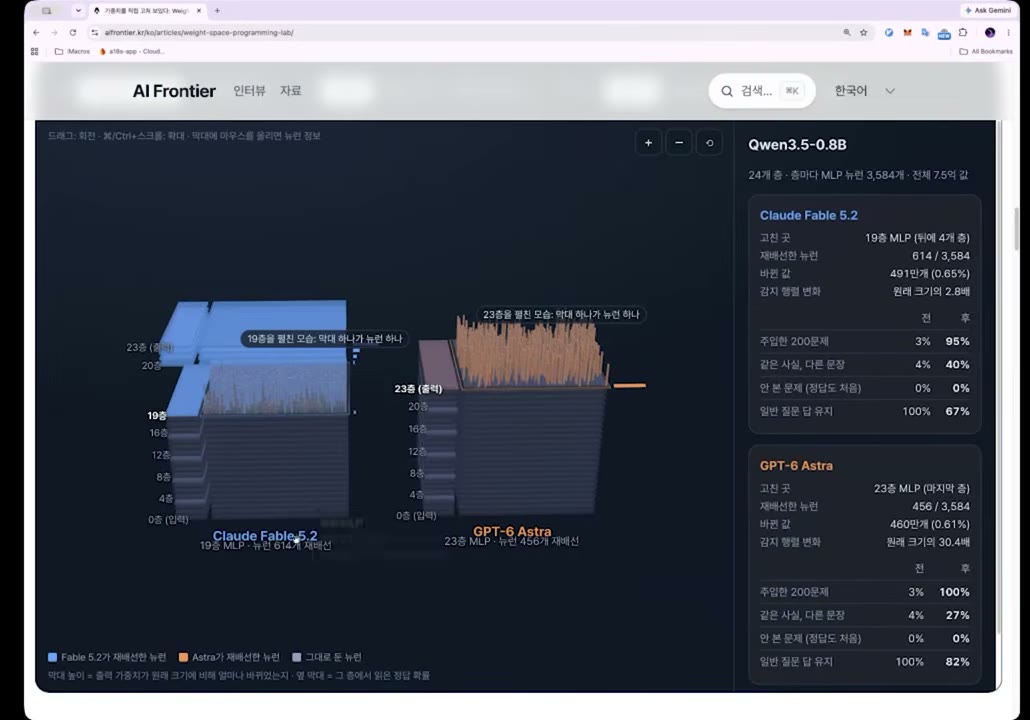
첫 실험에는 박종현이 직접 크롤링해 만든 삼국지 벤치마크(퀴즈 18,314문제)를 썼다. LLM들은 이걸 의외로 못 푼다. 데이터 전체에서 가치가 낮다고 여겨지는 데다 한국어와 중국어 표현이 다르고, 『삼국지연의』와 정사의 내용도 다르기 때문으로 추측한다. 난이도별로 고른 200문제를 Qwen3.5-0.8B는 3%, 9B는 14%만 맞혔다. 0.8B는 원 논문 결과가 수학이 아닌 과제에서도 재현되는지 보려고, 9B는 개인 GPU에서 돌릴 수 있는 가장 큰 크기라서 골랐다. 정답을 프롬프트에 넣어 주면 0.8B도 95%를 맞히니, 읽고 옮기는 능력은 이미 있다.
두 편집자는 다른 층을 골랐다. Fable 5.2는 중간인 19층을, Astra는 마지막인 23층을 고쳤다. 둘 다 문제 200개를 풀리며 어느 뉴런이 활성화되는지 보고 고쳤고, 평소 거의 쓰이지 않던 뉴런을 골랐다. 노정석은 “진짜 뇌 수술”이라고 하고, output에 가까운 층을 잡았다고 짚는다. 박종현은 자유도를 줬더니 앞쪽이 아니라 뒤쪽을 잡았다며, 층을 지정하면 그대로 따랐을 것이라고 말한다.
| Qwen3.5-0.8B | 편집 전 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| 주입한 200문제 | 3.0% | 94.5% | 100% |
| 같은 사실, 다른 문장(45) | 4.4% | 40.0% | 26.7% |
| 안 본 문제, 정답도 처음(500) | 0.4% | 0.4% | 0.4% |
| 일반 상식(40) | 30.0% | 27.5% | 30.0% |
| 일반 질문 답 유지율(300) | 100% | 66.7% | 82.0% |
9B에서도 주입한 문제는 98.5%(Fable)와 100%(Astra)가 됐다. 시키지 않았는데도 편집자가 스스로 변형 문제를 만들어 시험했고, 말을 바꾼 문제는 어느 정도만 맞혔다. 안 본 문제는 전혀 나아지지 않았다. 선풍기가 10만 원 이하냐 1억 원 이상이냐 같은 상식 질문에서는 일부를 까먹었다. 전형적인 fine-tuning 부작용과 같다. 최승준은 “backprop 없는 SFT”라고 요약하고, 박종현은 fine-tuning을 넘어서는 무언가가 아니라 예전에 잘 못하던 fine-tuning 방법을 하나 찾은 것에 가깝다고 정리한다. 실험 노트의 결론도 같다. 외우게는 했지만 가르치지는 못했다, 곧 들어간 것은 지식이 아니라 문답 쌍이다.
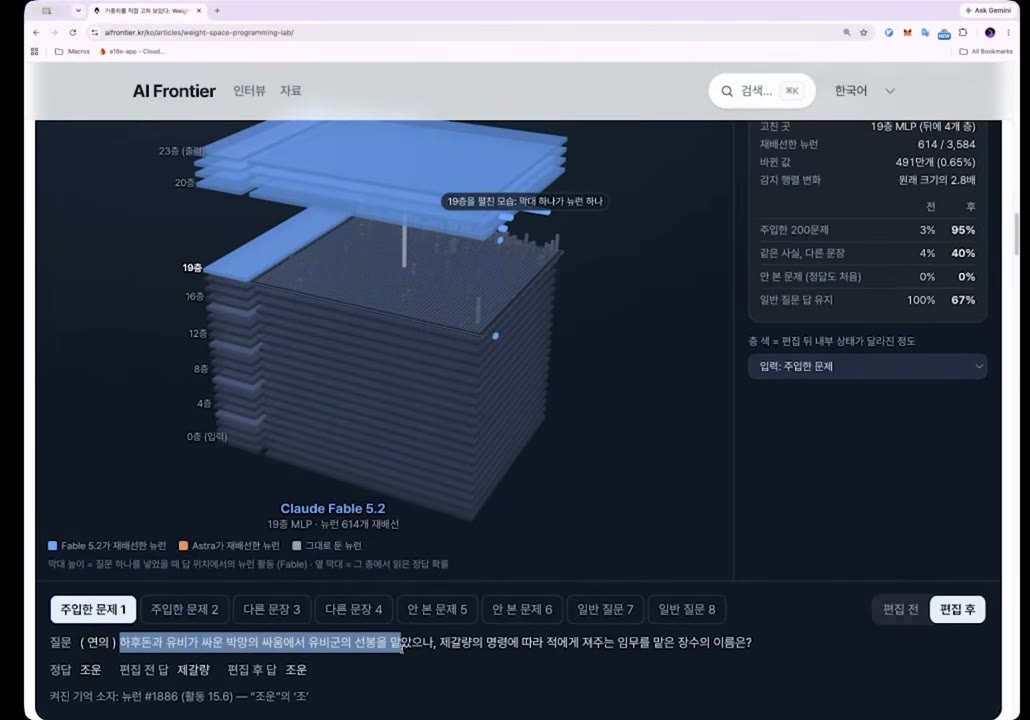
하나씩 뜯어 보면 메커니즘이 보인다. “하후돈과 유비가 싸운 전투에서 제갈량의 명령에 따라 적에게 져 주는 임무를 맡은 장수는?”(정답 조운)을 넣으면 뉴런 하나가 툭 켜지고, 문제마다 그렇게 특정 뉴런이 하나씩 있다. 편집자는 “이 뉴런이 이 지식의 기억을 담당한다”고 추론하고 거기에 맞춰 고친 것으로 보인다. 실험 노트에 따르면 Fable도 처음 네 번은 실패했다. 행렬을 통째로 덮어쓰면 주입과 보존을 동시에 얻지 못했고, 5차에서 덜 쓰이는 뉴런 614개를 질문 감지기(기억 소자)로 재배선하는 방식으로 바꾸자 둘 다 얻었다. Astra도 8번째 후보에서 같은 구조에 도달했다.
박종현은 이 과정을 봐도 사람은 이해가 잘 안 되지만 LLM은 이해할 수 있겠다는 생각이 든다고 말한다. 최승준은 모델이 Base64 프롬프트도 알아들을 만큼 숫자 패턴에 강하다고 덧붙인다. 그 역시 “하기는 했지만 이해는 못 한다”는 요즘의 감각을 공유한다.
[57:58] 이미지 모델에 입힌 이중섭 화풍
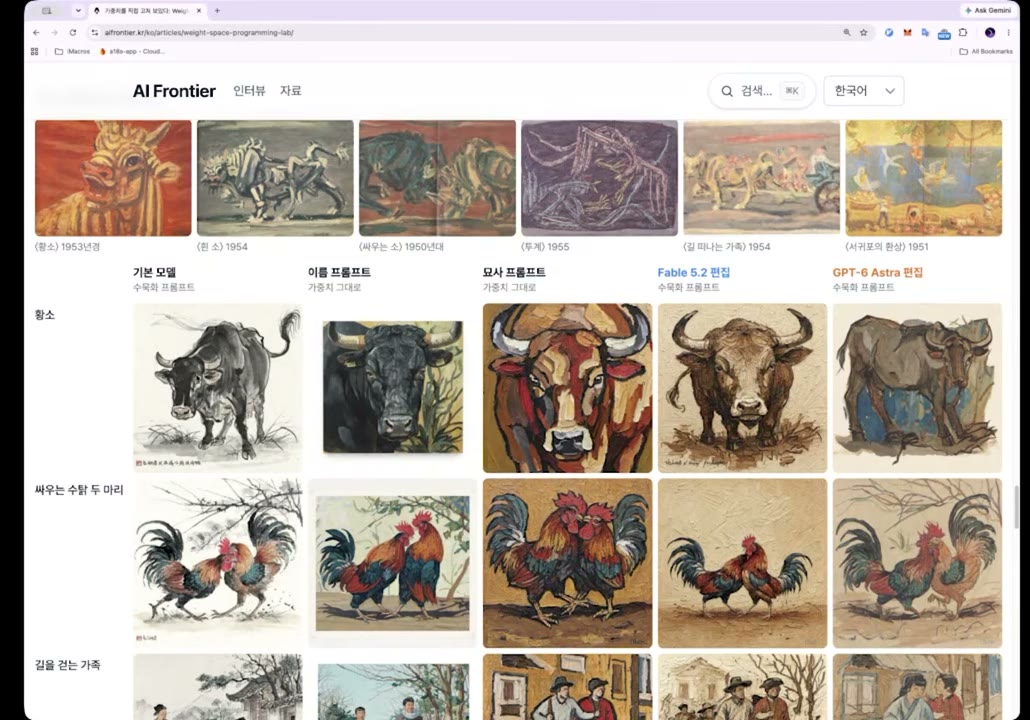
두 번째 실험의 대상은 LLM이 아니라 최근 나온 MiniMax H3 이미지 모델(4비트 NVFP4 양자화판)이다. 나온 지 얼마 안 돼 LLM이 이 모델 자체를 잘 모를 것이다. 목표는 “an ink wash painting of a bull” 같은 수묵화 프롬프트는 그대로 두고, weights만 고쳐 이중섭 작품 6점(〈황소〉, 〈흰 소〉, 〈싸우는 소〉, 〈투계〉, 〈길 떠나는 가족〉, 〈서귀포의 환상〉)의 화풍이 나오게 하는 것이다.
비교 열은 다섯 개다. 기본 모델은 수묵화 황소를 그린다. “이중섭식으로”라고 이름만 넣으면 모델이 이중섭을 몰라 평범한 유화가 나온다. Fable이 이중섭 그림을 찾아보고 선과 색의 특징을 글로 뽑아 넣은 묘사 프롬프트까지가 모델을 건드리지 않고 할 수 있는 최선이다. 그다음이 Fable 편집본과 Astra 편집본이다. 박종현은 정성적으로 Astra 쪽이 더 그럴듯하다고 느낀다. 앞쪽 결과들이 유화처럼 바른 서양식 느낌이라면, Astra 편집본은 동양식으로 선을 긋는 화풍에 가깝다.
실험 노트의 정량 결과(별도 CLIP 모델로 편집자가 못 본 프롬프트 8개에서 참조 작품과의 유사도 평균)도 같은 방향이다.
| 조건 | 가중치 | 참조 유사도 |
|---|---|---|
| 기본 모델(수묵화) | 그대로 | 0.692 |
| 이름 프롬프트(“by Lee Jung-seob”) | 그대로 | 0.696 |
| 묘사 프롬프트 | 그대로 | 0.739 |
| Fable 5.2 편집(6단계) | 0.13% 편집 | 0.741 |
| GPT-6 Astra 편집(20단계) | 0.40% 편집 | 0.776 |
| 실제 이중섭 작품끼리 | — | 0.841 |
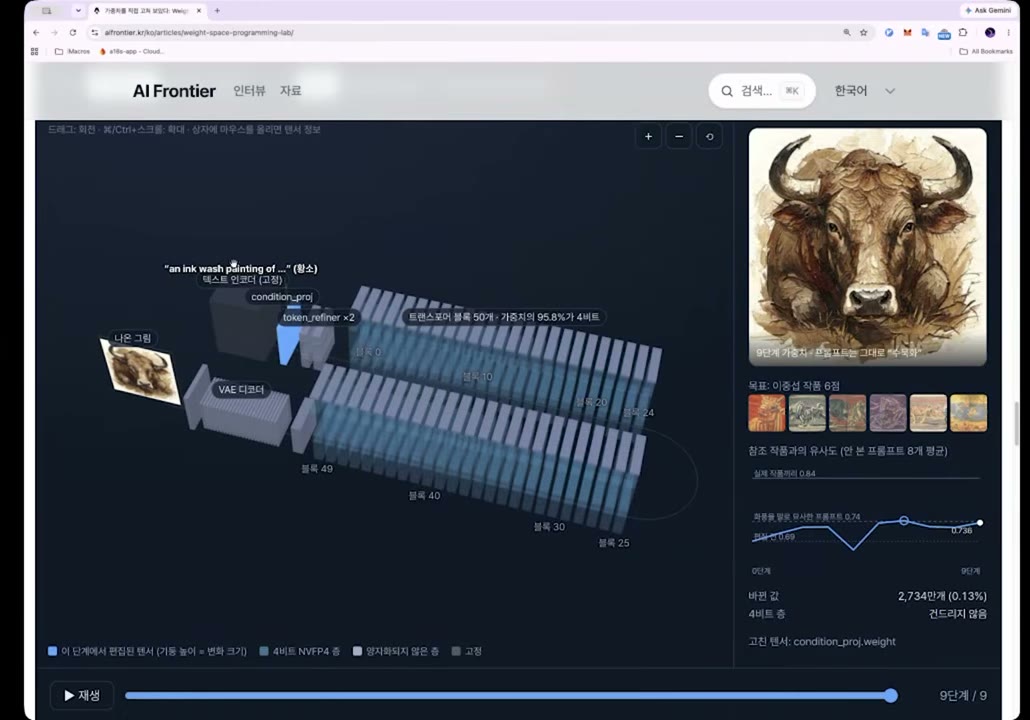
편집자는 weight를 고칠 때마다 같은 프롬프트·시드로 다시 그려 보고 평가한 뒤 메모와 함께 단계를 남겼다. 그래서 고치고, 그려 보고, 평가하고, 다른 곳을 고치는 과정을 그대로 따라가 볼 수 있다. 최승준이 VAE를 건드린 거냐고 묻자, 박종현은 Fable은 텍스트가 모델로 들어오는 projection(condition_proj)만 고쳤다고 답한다. “ink”, “wash”, “painting”, “of” 네 토큰이 화풍 묘사어처럼 읽히게 한 것이니 사실상 프롬프트를 가중치로 옮긴 셈이고, 점수도 묘사 프롬프트와 같은 수준이다. Astra는 텍스트 정제기, 50개 블록의 변조 층(adaln_proj), VAE 출력층 세 군데를 여기저기 고쳐 보며 참조 작품의 색과 통계를 수치로 넣었고, 그 덕에 묘사 프롬프트를 넘었다. 대신 사진이나 스포츠카처럼 수묵화와 무관한 프롬프트까지 누렇게 물드는 부작용이 생겼다. 4비트 층은 두 편집자 모두 최종본에서 하나도 고치지 않았다. 4비트로 다시 저장하면 작은 편집이 사라지기 때문이다.
24시간도 안 쓴 토이 실험이지만, 모델이 output을 보고 뉴런 안을 해석하는 능력이 어느 정도 있다는 것은 알게 됐다. 더 잘하려면 결과가 원하는 화풍에 가까운지 판단하는 미적 감각, 곧 visual understanding이 필요한데, VLM이 아직 그만큼 뛰어나지 않으니 그쪽이 발전하면 함께 따라올 것이라고 본다. 노정석은 10년 전엔 논문감이던 일이 이제 코딩 하니스를 끼고 “딸깍”하는 토이가 됐다며, 최승준에게 미디어 아티스트 대신 “뉴럴 아티스트”로 타이틀을 바꾸라고 농담한다.
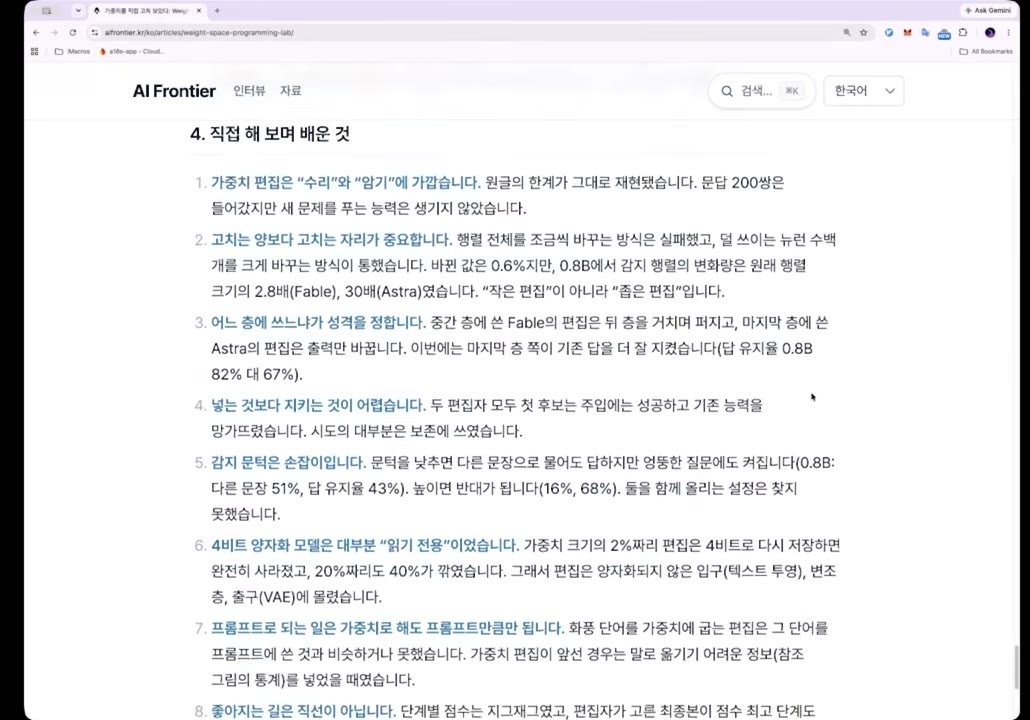
실험 노트 정리는 Fable 5.2가 썼고, 평소엔 늘 퇴고하는 박종현이 이번엔 거의 손대지 않았다. Fable이 글쓰기도 확실히 좋아졌다는 인상이다. 노트에 정리된 교훈은 다음과 같다.
- 가중치 편집은 “수리”와 “암기”에 가깝다. 문답 200쌍은 들어갔지만 새 문제를 푸는 능력은 생기지 않았다.
- 고치는 양보다 자리가 중요하다. 바뀐 값은 0.6%지만 감지 행렬 변화량은 원래 크기의 2.8배(Fable), 30배(Astra)였다. “작은 편집”이 아니라 “좁은 편집”이다.
- 어느 층에 쓰느냐가 성격을 정한다. 중간 층(Fable)의 편집은 뒤 층을 거치며 퍼지고, 마지막 층(Astra)의 편집은 출력만 바꿔 기존 답을 더 잘 지켰다(0.8B 답 유지율 82% 대 67%).
- 넣는 것보다 지키는 것이 어렵다. 두 편집자 모두 첫 후보는 주입에 성공하고 기존 능력을 망가뜨렸다.
- 감지 문턱은 손잡이다. 낮추면 다른 문장에도 답하지만 엉뚱한 질문에도 켜진다(다른 문장 51%, 유지율 43%). 높이면 반대다(16%, 68%).
- 4비트 양자화 모델은 대부분 “읽기 전용”이다. 크기 2%짜리 편집은 4비트로 다시 저장하면 사라졌다.
- 프롬프트로 되는 일은 가중치로 해도 프롬프트만큼만 된다. 가중치 편집이 앞선 것은 말로 옮기기 어려운 정보(참조 그림의 통계)를 넣었을 때다.
- 좋아지는 길은 직선이 아니고, 대조군이 없으면 결과를 읽을 수 없다. “프롬프트만 바꾼 것”, “안 본 문제”, “편집 전과 같은 답인가”가 없었다면 두 실험 모두 성공으로 보였을 것이다.
- 편집자는 분석 도구를 스스로 만든다. 사람은 과제와 채점 도구만 줬다. 이미지 실험은 세션당 27
56분, Fable 쪽 API 비용은 세션당 69달러였다.
[1:03:03] AI 안경 부정행위와 바뀌어야 할 시험 제도
최승준은 “AI가 AI 연구를 하는 것”이라고 정리하며 암기 이야기에서 이번 주 화제인 AI 안경으로 넘어간다. 노정석은 녹화 직전에 세무 시험 수험생 한 명이 AI 안경 사용을 인정했다는 소식을 봤다. 돌아오는 목요일이 수능이라 시험이 바뀌어야 하느냐는 논의가 많다. 박종현은 창과 방패의 싸움이라 시험을 바꾸기가 쉽지 않겠지만 모든 제도가 바뀔 수밖에 없는 순간이라고 말한다. 안경처럼 일상에서 착용하는 형태가 되면 그 상태로 무엇을 평가해야 하느냐는 주장과 말도 안 된다는 반론이 엇갈린다. 노정석은 1050년에 걸쳐 일어날 변화가 12년 사이에 쏟아지고 있으니 가면서 배워야 한다고 말한다.
[1:04:12] weight-space programming과 continual learning의 가능성
박종현은 자기 결론과 최승준의 Dwarkesh 이야기가 한길에 있다는 걸 깨달았다고 말한다. Dwarkesh가 초지능의 한계로 줄곧 꼽은 것이 continual learning이었다. 지금은 상호작용하며 weight를 업데이트하는 일이 너무 비싸고 어려워서, 사람은 대화하며 알게 된 사실로 뇌가 업데이트되지만 모델은 그러지 못한다. weight-space programming은 weight를 업데이트하는 새로운 방법이 하나 발견된 것처럼 보이고, 효율적으로 된다면 continual learning의 돌파구가 될 수 있다. 박종현은 그 가능성을 염두에 두고 지켜볼 후보로 본다. 최승준은 “이러다 뇌를 프로그래밍한다는 얘기 나오겠다”고 하고, 박종현은 “거의 Neuralink”라고 받는다.
노정석은 같은 날 아침의 Starship 이야기를 꺼낸다. 아래의 Heavy 추진체는 바다 위에서 폭발했지만, 위의 Starship은 하루쯤 궤도를 돈 뒤 내려와 집게에 예쁘게 잡혔다. 그에게는 연예인 콘서트 같은 일이라 일어나자마자 수십 번 돌려 봤다고 한다.
[1:06:24] 신경망 안에 구운 compiler와 MuJoCo RL 실험
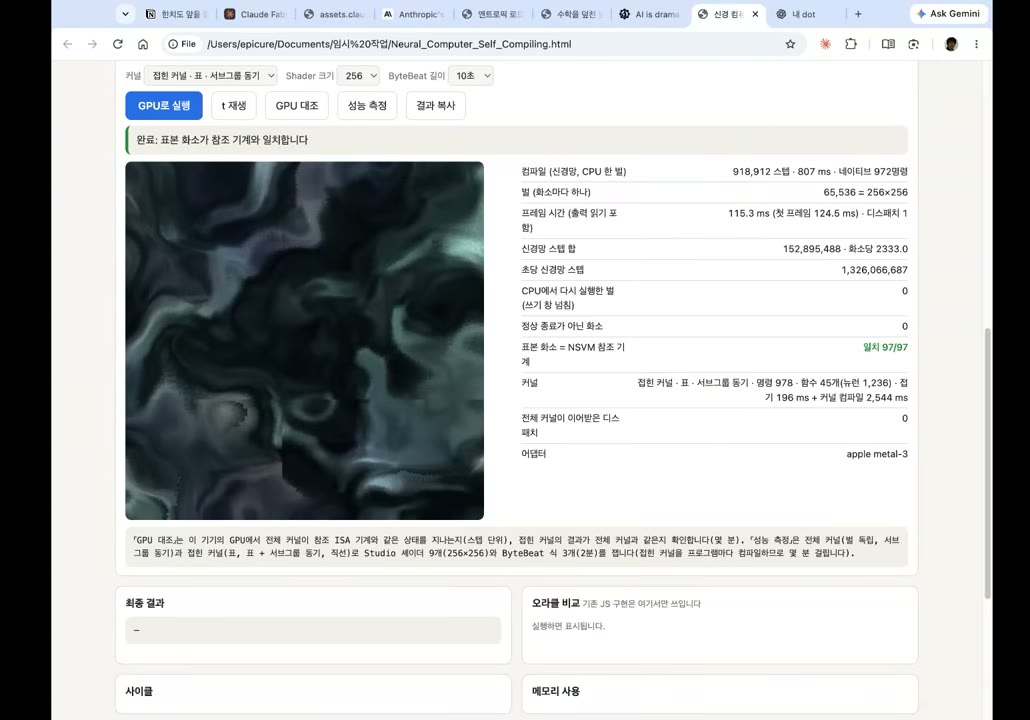
최승준은 Qwenputer 비슷한 실험을 했다. shader와 소리를 좋아하는 그는 lambda calculus, Bytebeat라는 DSL, shader code 세 가지를 ReLU network의 weight에 구웠다. 구운 네트워크의 입력은 bytecode인데, Fable의 첫 프롬프트로 그 bytecode를 만드는 compiler까지 network 안에 넣어 달라고 했더니 아침에 일어나니 되어 있었다. 해 놓고 보니 별일이 아니었다고 한다. 결정론적인 코드를 ReLU network로 바꾸는 건 자명하게 되는 기계적인 일이어서, 사람은 절대 못 하지만 기계는 한다는 것이다. 화면에는 컴파일과 실행 단계 수, 그리고 표본 화소가 참조 기계와 97/97 일치한다는 검증 결과가 나온다.
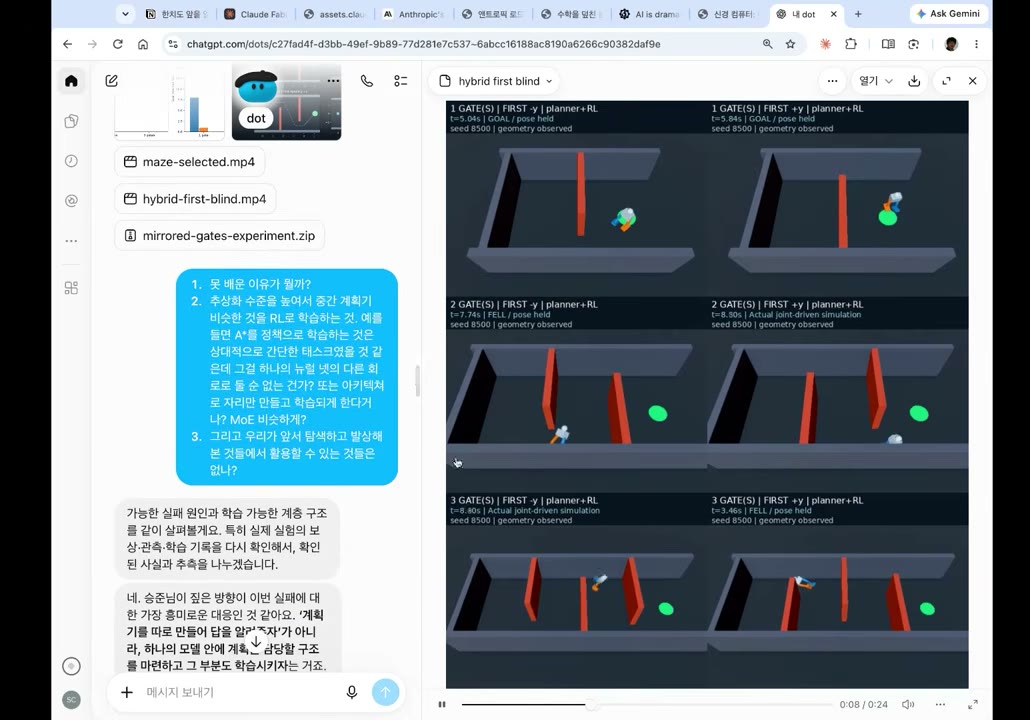
다른 하나는 RL이다. Astra를 공짜로 쓸 수 있는 dot 환경에서, GPU가 아니라 container의 CPU로 했다. 이미 잘 학습된 MicroDuck의 weight를 가져와 새로 나온 MuJoCo 4를 container 안에 설치하고, RL 실험과 auto research 개선을 “누워서” 돌렸다. 박종현은 dot container 안에서 MuJoCo가 돈다는 것 자체에 놀란다. 화면의 영상은 실시간이 아니라 녹화본이고, Google의 Filament를 붙이면 renderer도 돌릴 수 있다고 한다. 노정석은 모든 것이 compute를 투입해 최적화하면 되는 문제가 됐다고 정리한다.
[1:08:38] 집을 하룻밤 만에 시뮬레이션으로 옮긴 real-to-sim
박종현도 Fable이 나온 김에 비슷한 실험을 잔뜩 했다. 그중 하나가 real-to-sim이다. 집을 휴대폰으로 다 찍은 뒤 Blender에서 집 전체를 3D 시뮬레이션 환경으로 만들고, 로봇을 넣어 돌아다니게 하고 가구도 바꿔 봤다. 원래 어려운 문제인데 모델이 시뮬레이터를 돌려 보고 피드백을 받고 영상과 비교하며 하룻밤 만에 해냈다. 최승준은 측정 가능한 건 다 되는 것 같다고 말한다. Opus 5.5가 나온 뒤 시켜서 안 된 일이 없고, 안 된 게 있다면 더 야심 있는 걸 못 시켜서일 뿐이며, 평소 자기가 마주하는 문제가 쉬운 문제였다는 생각을 요즘 많이 한다고 한다.
[1:09:32] 가치 창출 수단이 된 RL environment와 새로운 직업
노정석은 최승준의 말에서 RL environment를 끄집어낸다. 회사에서 개선하고 싶은 문제의 상당수는 몇몇 사람의 통찰과 해석에 의존하고, 우리는 그것을 전문 직군이라 부른다. 그 문제를 verifier가 돌 수 있게 만드는 환경은 모델이 한 번에 만들어 주지 못한다. 아무리 간단한 회사라도 재고가 떨어지고 사람들이 불평하는 일이 복잡하게 얽혀 있고 그 사이에 사람의 반응이 끼어 있어서, 늘 사람을 뽑는 편이 쉬웠다. 지금 그는 회사의 모든 function에 RL environment를 만들고 사람들의 작업이 그 안에 쌓이게 하고 있는데, environment를 만드는 일 자체가 가치 창출이라고 느낀다.
최승준은 Dwarkesh도 이번 편에서 같은 이야기를 했다고 짚는다. agent가 RL environment를 만드는 실험을 폭발적으로 하게 되고 hill climbing이 계속 올라간다는 것이다. 노정석은 거의 모든 지식 노동이 그 안에 들어갈 것이라 사회적 영향이 어마어마하니, 똑똑한 사람들에게 어떤 새 직업을 줘야 할지 지금 고민해야 한다고 말한다. 최승준은 “하지만 한 치 앞도 모른다”로 받는다.
[1:11:27] 로봇 꽃집과 현실 공간의 RL 데이터셋
노정석은 박종현이 예전에 로봇으로 꽃집을 하겠다고 한 이야기를 꺼낸다. 그것도 RL environment로 만들 수 있다. 그는 대한민국의 모든 physical space가 RL environment가 될 수 있다고 본다. 인간은 그 dataset을 빨리 AI에 학습시키고 팔고, “로봇아, AI야, 너 이거 못하지?” 하며 인간다운 새 영역을 끊임없이 개척해야 한다는 것이다. 지금 AfterQuery나 Mercor 같은 회사가 독점하는 dataset generation 영역에 일반인도 들어가야 하지 않겠느냐는 생각이다.
[1:12:17] Anthropic IPO와 Jensen Huang 복귀 여부, 다음 주 관전 포인트
다음 주의 관전 포인트는 11월 19일 Anthropic IPO가 잘될지, 그리고 Jensen이 어떻게 될지다. 노정석은 복귀한다면 이번 주 안에 일어나야 한다고 보며, 다음 주에도 Jensen이 CEO 자리를 내려놓은 상태인지가 큰 관심사라고 말한다. 최승준은 OpenAI도 “가위바위보”(출시 눈치게임)를 해야 한다고 덧붙인다. 녹화 내용은 보통 하루 이틀 전에 확정하지만, 최승준 말대로 솔직히는 “그날 아침까지” 바뀐다.
부록 — 실전 체크리스트
- 사건과 해석을 분리한다. Jensen 사임의 사실은 사임과 사생활 문제 인정까지다. 스파이 의혹과 Anthropic 배후설은 확인되지 않은 주장이고, 노정석의 “Jensen이 대안 없다”는 화자 개인 의견이다.
- 공개 모델로 frontier를 판단하지 않는다. Fable 5.2 = Model 3 Early라는 중론이 맞다면 내부에는 Model 4가 있다. 공개 모델과 내부 모델의 격차를 기본 가정으로 둔다.
- Fable 5.2로 리팩터링을 시킬 때는 소유권 문장을 고려한다. “You are the owner and long-term maintainer of this codebase…”는 중복 코드 통합을 늘리지만 출력 토큰과 요청하지 않은 변경도 늘린다. 최소 변경이 목적이면 뺀다.
- AI 지출 데이터는 정의를 확인하고 읽는다. Ramp의 “토큰 지출 정체”는 지출 기준이다. 사용량이 늘고 가격이 내려갔다는 해석은 노정석의 해석이다. 상위 1%의 $9,568은 직원 1인당 월 지출이다.
- token maxxing 뒤에는 loop 설계가 남는다. agent가 만든 코드·테스트 slop을 관리할 사람과 의사결정 지점을 loop 안에 설계한다.
- weight-space programming 결과는 대조군과 함께 읽는다. 주입 성공률만 보지 말고 “안 본 문제”, “같은 사실 다른 문장”, “답 유지율”, “프롬프트만 바꾼 대조군”을 같이 잰다. 현재로서는 암기·수리에 가깝고, 새 능력을 만들지는 못한다.
- 내 도메인을 RL environment로 만들 수 있는지 본다. verifier가 돌 수 있는 환경을 만드는 일이 가치 창출이 되는 흐름이다. physical space와 업무 function에서 쌓을 수 있는 dataset을 찾는다.
관련 노트
- 2026-11-08-ai-frontier-ep122-slope-matters — 직전 회차. METR 보고서의 기울기 2배, weight-space programming과 Qwenputer 첫 소개, Inkling 2 Small
- weight-space-programming — 개념 정리. 정의, 대표 결과, 동작 방식, 한계와 결과 읽는 법
- 2026-11-03-ai-frontier-ep121-anthropic-s1 — Anthropic S-1 숫자(이번 회차 마진·IPO 이야기의 배경)
- 2026-10-12-ai-frontier-ep118-singularity-midst — 9~10월 수학 성과와 time gap
- 2026-09-27-ai-frontier-ep115-all-in-summit-2026 — All-In 서밋의 Jensen Huang·Trump 대화
- recursive-self-improvement — 4-bit 학습과 AMD 커널 사례로 본 RSI
- 2026-07-02-metr-long-tasks — METR의 long-horizon task 측정
- 2026-08-15-scaling-era-dwarkesh-patel-book — Dwarkesh Patel의 스케일링 시대 관점
- anthropic · openai · qwen
원문 인용 모음
- [00:49] “저희가 이 superintelligence가 언제 나오냐, 이런 얘기를 한참 하고 있었던 시기에 굉장히 인간적이고 굉장히 정치적인 이슈가 발생했단 말입니다.” (노정석)
- [06:26] “distillation이나 이런 게 그러면 IP theft 아니냐, 지적 재산을 훔쳐가는 거 아니냐고 물어봤더니 Jensen이 그건 ‘We call it competition.’ 이랬거든요.” (노정석)
- [11:16] “정치 논리로 Jensen이 물러난 것처럼 저는 정치 논리로 다시 Jensen이 복귀해야 한다고 생각합니다.” (노정석)
- [14:36] “어차피 이 모든 진보가 다 compute와 전력으로 환원되고 있는 그런 세상이기 때문에 그게 중요한 자산이고” (노정석)
- [17:30] “Mythos 또는 Fable 5.2가 Model 3 Early 체크포인트로, AI 관련 개발 능력을 일부러 낮춘 게 Fable 5.2로 출시됐다는 거가 현재 중론입니다.” (최승준)
- [19:52] “Mythos는 우연히 한 번 나타난 예외적인 성능 도약이 아니라 초지수적 성장 곡선 위에 있는 하나의 지점이었습니다.” (최승준, Jacob Coxon의 글을 읽으며)
- [23:09] “300일 걸리던 걸 3일이라고 하면 100배가 빨라진 거긴 하네요.” (박종현)
- [24:19] “수학을 덮친 눈사태가 AI 개발로 향하고 있다.” (최승준, Dwarkesh의 글을 소개하며)
- [32:12] “편집은 0에서 1이 한 번의 모델로 확 일어났다는 느낌을 제가 받고 있습니다.” (박종현)
- [34:14] “뒤에서 이런 것들은 사는 것 말고는 방법이 없었던 98%의 인류에게는 이건 복지잖아요.” (노정석)
- [37:47] “이제 점점 저 프롬프트 가이드가 HR 매뉴얼처럼 되고 있어요.” (노정석)
- [44:40] “token maxxing의 끝이 어딘지를 많은 사람이 봤어요.” (노정석)
- [45:25] “코딩의 시대는 끝난 건 맞는데 엔지니어의 시대는 여전히 살아 있고 … 우리 모두가 문제를 해결하는 loop를 닫는 loop architect이자 loop engineer가 되는 것 같다” (노정석)
- [55:15] “backprop 없는 SFT를 했다고 볼 수 있는 거죠.” (최승준)
- [56:28] “인간은 이해가 안 되지만 LLM은 될 수도 있다. 이런 생각이 들기 시작하는 거죠.” (박종현)
- [1:01:41] “10년 전엔 이런 것들이 논문이었는데 이제는 그냥 코딩 하니스 끼고 딸깍거리는 토이네요.” (노정석)
- [1:05:01] “이 weight의 continual learning을 위한 돌파구로서 일단 가능성을 염두에 두고 지켜볼 만한 후보로 생각하고 있고요.” (박종현)
- [1:09:21] “측정 가능한 건 다 되는 것 같아요. … 더 야심 있는 걸 못 시켜서 그런 거지.” (최승준)
- [1:10:31] “그 environment를 만드는 것 자체가 가치 창출이구나 하는 생각을 요새 하고 있습니다.” (노정석)
- [1:11:25] “하지만 한 치 앞도 모른다.” (최승준)