출처: https://youtu.be/eO8brZguMpU 길이: 1:20:26 · 채널: AI Frontier Korea (노정석) 녹화: 2026-10-24(토) 아침 · 출연: 노정석, 박종현(최승준 불참) · 편집: 김유진 관련 자료: 노정석의 X 소개 글(“지난 2주동안 했었던 생각실험을 한번 정리해 봄”, 원문) · 공식 전사본 · 발표 덱 PDF(57쪽)
한눈에 보는 요약
- 한국 메모리 반도체주가 고점 대비 40% 넘게 빠지고 CoreWeave의 채권 수익률·CDS spread가 치솟으며 거품론이 다시 나왔다. 노정석은 이를 수요가 꺾인 결과가 아니라 금리·공매도·만기 불일치라는 금융 환경의 충격으로 본다. build-out은 아직 끝나지 않았고, 이번 일은 거품 붕괴가 아니라 “재채기(hiccup)“라는 것이다.
- 렌즈는 하나다. 가치는 leak하지 않는 scarcity(새지 않는 희소성)로 간다. value chain에서 margin은 얼마나 희소하냐로 정해지고, 공급자가 많아지면 commodity가 된다.
- Frontier Lab을 지탱하는 compute·data·talent 중 새지 않는 것은 compute뿐이다. data는 데이터 회사가 되팔고 talent는 이직과 “맥주 한 잔”으로 퍼진다. 그래서 Near Frontier Lab(Kimi·DeepSeek)과의 time gap은 닫히고 모델은 utility(범용재)가 된다. Kimi K3.1 Pro는 coding에서 Opus 5.5와의 격차를 약 6주로 줄였다.
- Lab은 verifiable·digital·큰 domain부터 data를 사서 닫는다(coding → 회계·법률 같은 ‘사’ 자 직업 → physical·규제). 끝까지 남는 것은 label 자체가 operation 밖에 존재하지 않는 unbuyable signal이다. 결론은 둘이다: Frontier Lab이 되거나, domain의 operation loop 소유자가 되거나.
- 2x2 시나리오(가로: frontier gap 닫힘/유지, 세로: 매출 > / < 감가+이자)에서 그의 개인적 확률은 S1(local correction + utility화) 약 50%, S2(credit crunch) 25%다. 화면의 한 줄은 “weight 소유는 감가, signal 소유는 복리”다.
- 투자는 frontier lab 지분을 “보험”으로 들고, 사업은 lab이 오지 않는 곳에 operation loop를 짓는다. 시장 타이밍은 spot–contract spread, payback period, open-weight gap, RSI 첫 관측 같은 일곱 가지 지표로 1~2주마다 판독한다.
장면별 상세 설명
[00:00] 반도체 급락과 너무 빨리 온 비관론
녹화일은 2026년 10월 24일 토요일 아침이다. 2주 동안 한국 메모리 반도체 회사 주가가 고점 대비 40% 넘게 빠졌고, a16z 같은 곳이 통계를 쏟아내며 시각이 갈렸다. 노정석의 진단은 두 가지다. 첫째, build-out이 과투자됐고 수요가 부풀려지고 중복됐다는 불안 심리가 지배하지만 비관론이 너무 빨리 왔다. 둘째, 주변 사람이 모두 하이닉스·삼성전자·미국 주식 창을 띄워 놓을 만큼 들어올 자본은 이미 다 들어왔다. 받쳐 줄 수요가 없는 상태에 비관론이 겹치면 공매도 세력에게 좋은 시기가 되고, 실제로 CoreWeave·Nebius의 공매도 잔고가 어마어마하다.
그는 이번 변화가 철도·통신·인터넷·모바일과 비교할 수 없이 빠르고, 한 layer가 아니라 assembler부터 Python level까지 layer 전체가 동시에 바뀌는 변혁이라고 본다. 그래서 금융·AI·비전문가 관점이 서로 싸우는 시기이고, 절대적인 결론을 말하기는 어렵다고 단서를 단다.
[04:16] 대항해시대 비유와 아직 오지 않은 video
박종현은 결국 “사람들이 AI를 계속 더 쓸 것이냐”로 수렴할 것이고, GPU 회사들은 여전히 수요가 넘친다고 말한다고 전한다. 노정석은 지금을 대항해시대에 비유한다. 위험한 항해를 견디면 신약·신물질·노화 해결 같은 신대륙을 통째로 얻을 수 있어서, outcome이 워낙 크기 때문에 VC가 돈을 쏟아부을 동기가 아직 한참 남아 있다는 것이다. 전통적인 B2B·B2C 소프트웨어 관점에서만 보면 수요가 안 따라온다고 말할 수는 있다.
신정규에게 비관론을 내밀면 그는 “아직 video가 오지 않았잖아요”로 답을 끝낸다. 지금은 text와 이미지 몇 장이 오가는 수준인데, video modality가 입력과 출력으로 오면 규모가 달라진다. 인터넷 초창기에도 bandwidth가 남는다고 했지만 그 위에서 Netflix와 YouTube가 생겼다.
[07:21] 오르지 않는 모델 가격과 value chain의 희소성
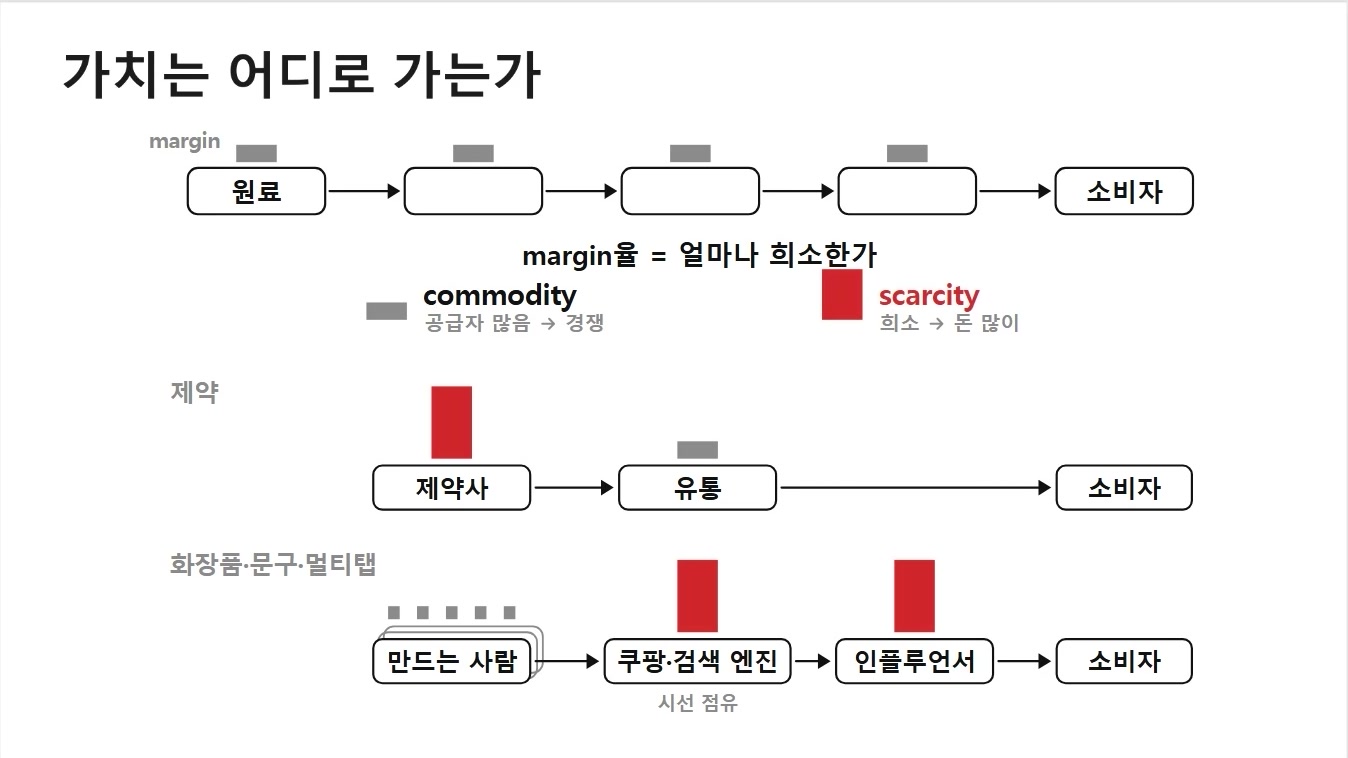
2주 전 회차(2026-10-12-ai-frontier-ep118-singularity-midst)의 domain gap·time gap 이야기를 심화한 편이다. 노정석은 Claude·ChatGPT와 여러 bot으로 자료를 조사하고 Fable과 에세이를 써 덱을 만들었다. 출발점은 작년 말의 “모델이 좋아지면 3천 달러·만 달러 요금제가 나온다”는 thesis가 틀렸다는 관찰이다. GPU 가격은 오르는데 단위 능력당 token 가격은 계속 떨어진다. 그날 아침 나온 Kimi K3.1과 그 주의 DeepSeek V4.1 Flash도 “써도 써도 token이 줄지 않는다”는 말이 돈다.
화면은 value chain 그림이다. 원료에서 소비자까지 단계마다 margin을 떼는데, margin율 = 얼마나 희소한가다. 공급자가 많으면 경쟁이 생겨 commodity가 되고, 희소하면 돈을 많이 번다. 제약은 앞단의 제약사가 가장 많이 벌고 유통은 적게 번다. 화장품·문구·멀티탭은 만드는 사람이 너무 많아서 소비자의 시선을 점유한 쿠팡·검색 엔진과 인플루언서가 가져간다. 다음 슬라이드의 결론은 “value capture → 희소한 곳”이고, 그 희소함(IP·moat·경쟁력)은 새지 않아야 하므로 **“leak 하지 않는 scarcity”**가 된다.
[11:33] Near Frontier Lab의 추격, Frontier Lab이 가격을 못 올리는 이유
Frontier lab이 가격을 못 올리는 이유를 묻자 박종현은 “중국 모델들이 너무 잘 올라와서 희소하지 않게 됐다”고 답한다. 노정석은 미국 안에서도 Muse·Grok·Google이 따라오고 Microsoft·Amazon도 잠재 참여자이며, 중국에는 몇십 개 수준의 lab이 있다고 보탠다. Kimi K3.1의 Terminal-Bench 성적이 Opus 5.5에 근접했다. OpenAI·Anthropic 뒤의 lab을 Quasi Frontier Lab 또는 Near Frontier Lab이라 부르는데, 그 격차가 확 줄었다.
박종현은 비디오 쪽에서 Canva가 자체 모델을 내고, HeyGen이 순위권 모델을 내고, DeepMind에서도 새 시각 모델이 나오는 흐름을 짚는다. 새 모델 사업자(NeoLab)까지 뛰어들면서 모델이 점점 희소해지지 않는다. 노정석은 이들이 Frontier Lab이 data를 사들여 자기 domain을 exploit하는 것에 존재의 위협을 느껴 vertical을 지키려는 것이라고 해석한다.
그리고 결론부터 말한다. 새지 않는 희소성은 크게 보면 Frontier Lab으로 간다. 나머지는 Frontier Lab이 못 가져가는 곳, 즉 operation이 내 소유권 안에 있고 lab이 거기서 나오는 signal을 가져가려면 큰 희생을 치러야 하는 서비스로 간다. 그는 덱을 공개할 테니 각자 모델 context에 넣어 재료로 쓰라고 권한다.
[14:49] 인프라 과투자와 조정 이후 열리는 애플리케이션 시대
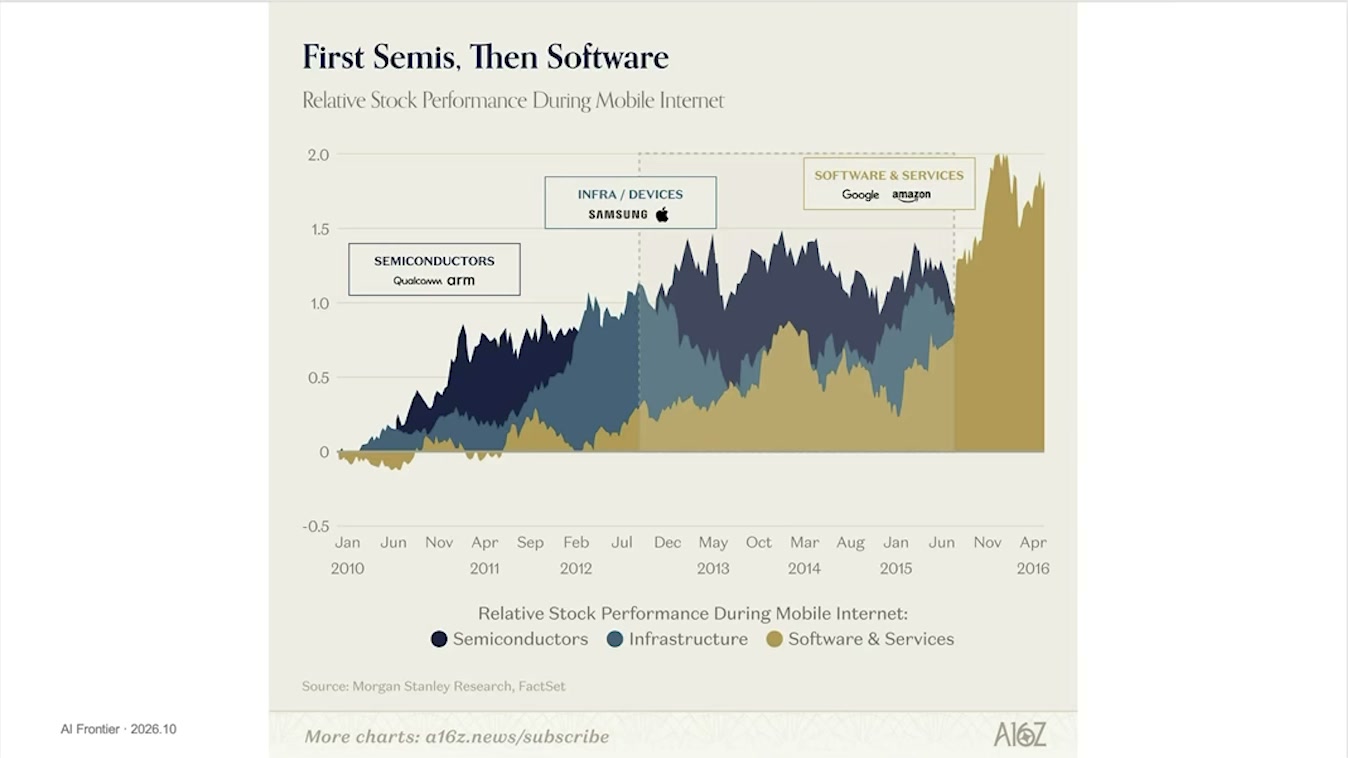
a16z 차트(출처 Morgan Stanley Research·FactSet)는 2010~2016년 모바일 인터넷 시기의 상대 주가다. 반도체(Qualcomm·Arm)가 먼저 오르고, 인프라·디바이스(Samsung·Apple)가 뒤를 잇고, 마지막에 소프트웨어·서비스(Google·Amazon)가 2.0배 가까이 치고 나간다. 모든 cycle에서 infrastructure buildout 뒤에 큰 장이 섰다는 주장이다(관련: 2026-10-10-news-hada-35094-a16z-state-of-markets-ii).
다음 슬라이드는 단순화한 선 그래프다. Infra buildout에서 오르고, 조정으로 꺾였다가, After infra buildout에서 다시 오르고, New paradigm으로 넘어간다. buildout은 미래 기대를 과장한 채 일어나서 과투자가 생긴다. 뉴욕–시카고에 노선 하나면 될 것을 세 개씩 깐 철도가 예다. 조정이 폭망을 뜻하지는 않는다. 구조적으로 과투자된 자산의 주인이 바뀌고, 손익 구조가 다른 다음 투자자가 훨씬 낮은 비용으로 운영하면서 “누군가의 시체를 즈려밟고” 애플리케이션과 서비스의 시기가 꽃핀다. 지금은 인프라 buildout의 거의 끄트머리이고, 과투자 때 투자자·채권자가 손해를 보는 것은 “국룰”이다. 그 위에 부가가치 사업자가 더 크게 가져가거나, 편익이 사회 전체로 퍼진다.
[18:31] Anthropic 매출 급증과 지식 노동자 확산의 시차
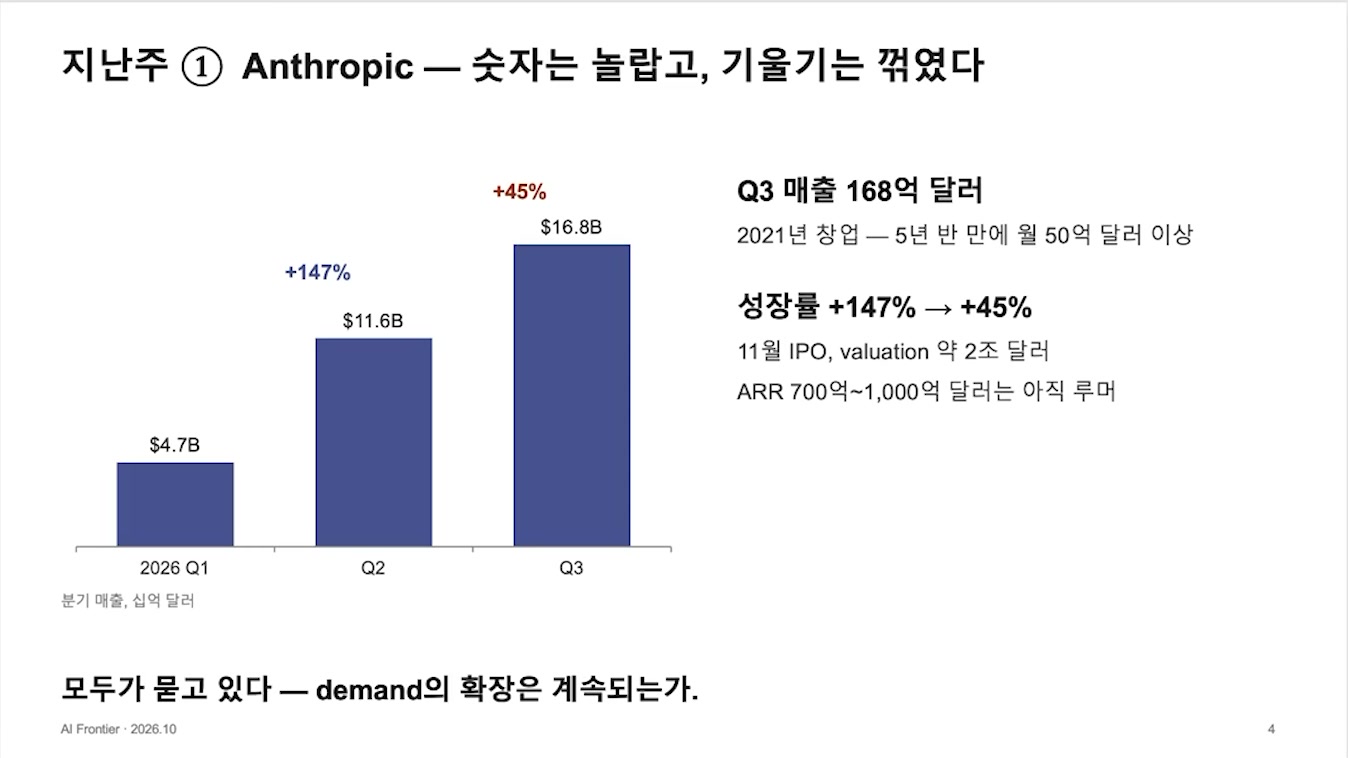
슬라이드 제목은 “지난주 ① Anthropic — 숫자는 놀랍고, 기울기는 꺾였다”이다. 분기 매출은 2026 Q1 11.6B(+147%) → Q3 $16.8B(+45%)다. 옆에는 “2021년 창업 — 5년 반 만에 월 50억 달러 이상”, “11월 IPO, valuation 약 2조 달러”, “ARR 700억~1,000억 달러는 아직 루머”가 적혀 있다. 노정석은 2026년 1분기 매출이 2025년 전체보다 컸고 그 중심에 Claude Code가 있었다고 말한다.
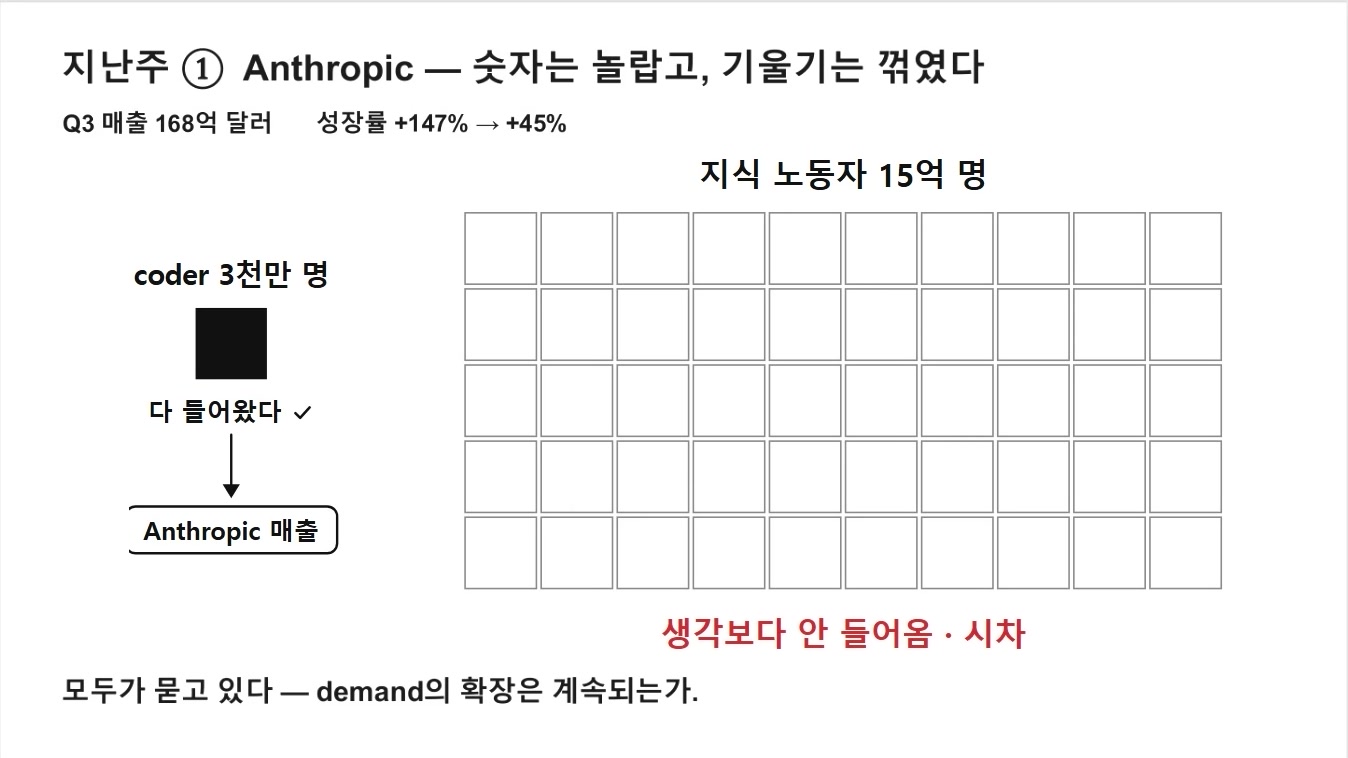
a16z에 따르면 전 세계 coder는 약 3천만 명이고 지금쯤 거의 다 들어왔다. 지금의 Anthropic 매출은 이들이 만든 숫자다. coder가 아닌 지식 노동자는 약 15억 명인데, 이들이 들어오면 TAM이 얼마나 커지느냐가 지금까지의 가정이었다. 그런데 생각보다 안 들어오고 시차가 있어서 Q3 성장률이 꺾였다. 노정석은 Q4 성장률이 많은 걸 의미하게 될 것이라고 본다. 기업들은 아직 AI를 어떻게 써야 하는지 관점조차 없어서 한 번은 “평지를 지나는 구간”이 있을 수 있다.
박종현은 Q2→Q3 45% 성장도 엄청난데 이걸 보고 기대가 꺾였다고 하니 기대가 얼마나 컸는지 알겠다고 받는다. 노정석은 그 기대가 5년 된 회사의 valuation 2T를 만든다고 말한다. 매출은 Meta·Google보다 훨씬 작은데 그 가치를 인정받는다는 건 시장이 이 부문의 성장을 예측한다는 뜻이고, 예측이 깨지면 valuation을 정당화하기 어렵다.
[22:02] CoreWeave의 데이터센터 금융 구조
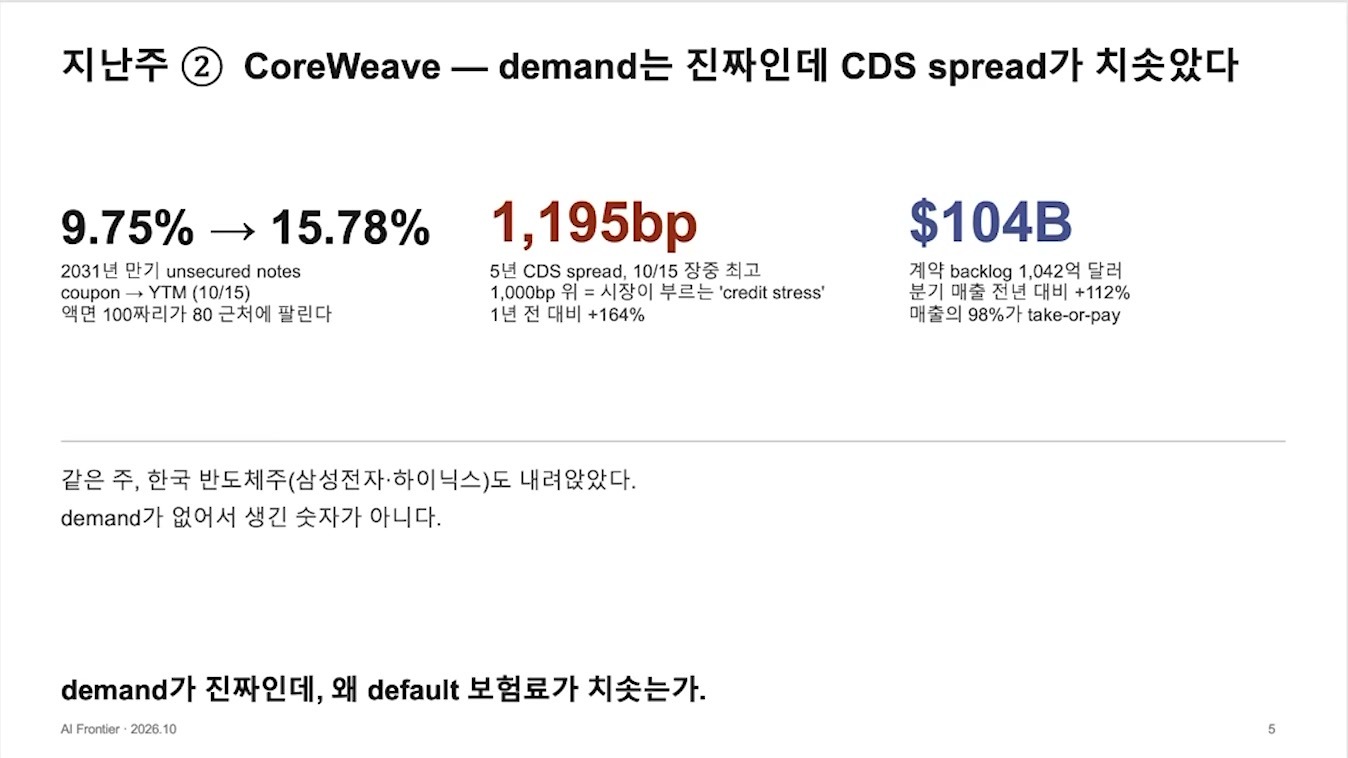
“지난주 ② CoreWeave — demand는 진짜인데 CDS spread가 치솟았다”의 세 숫자는 이렇다.
| 숫자 | 의미 |
|---|---|
| 9.75% → 15.78% | 2031년 만기 unsecured notes의 coupon → YTM(10/15). 액면 100짜리가 80 근처에 팔린다 |
| 1,195bp | 5년 CDS spread, 10/15 장중 최고. 1,000bp 위 = 시장이 부르는 ‘credit stress’. 1년 전 대비 +164% |
| $104B | 계약 backlog 1,042억 달러. 분기 매출 전년 대비 +112%, 매출의 98%가 take-or-pay |
하단에는 “같은 주, 한국 반도체주(삼성전자·하이닉스)도 내려앉았다. demand가 없어서 생긴 숫자가 아니다.”라고 적혀 있다.
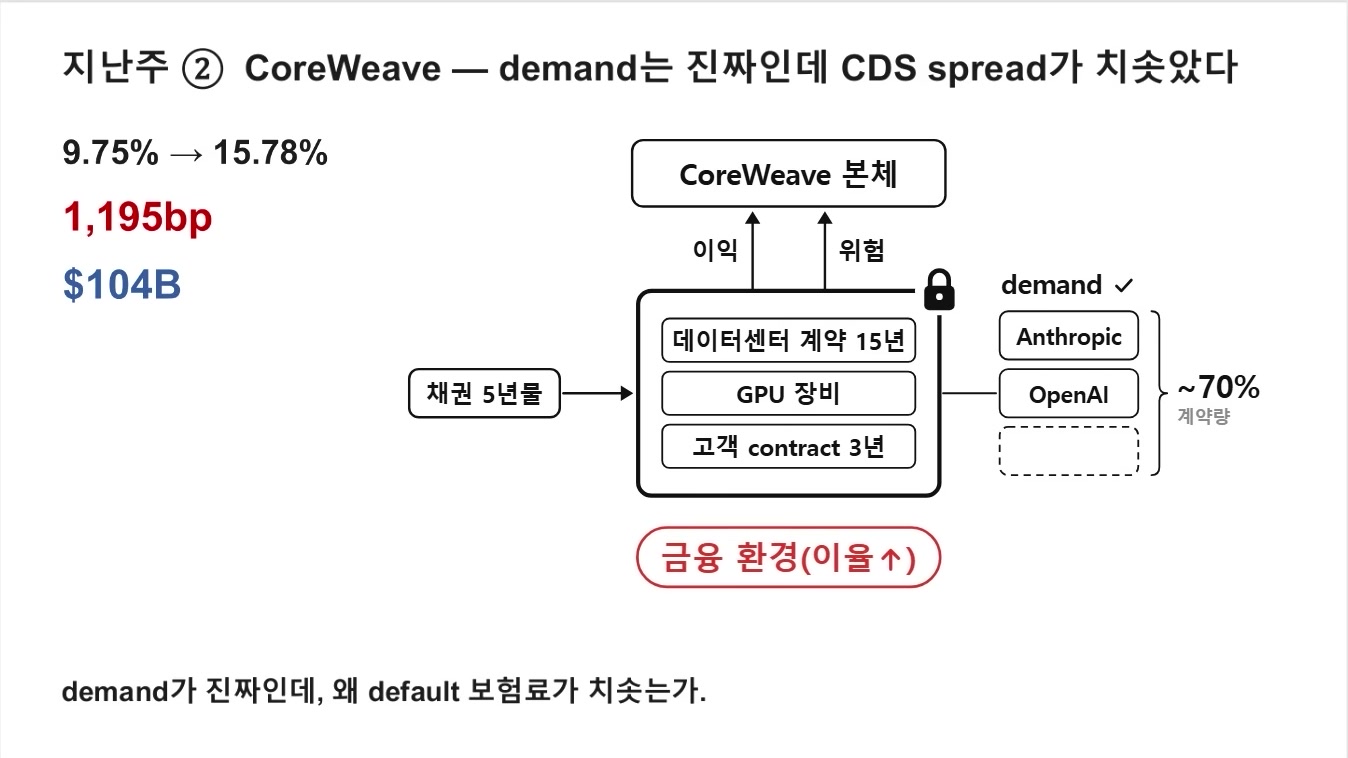
노정석이 CoreWeave CEO의 설명으로 그린 구조다. 박스 하나에 데이터센터 15년 계약, GPU 장비, 고객 contract 3년을 넣고 5년물 채권으로 부채를 조달해 가둔다. 박스는 hyperscaler와 Anthropic·OpenAI 같은 고객이 사 가는데, 세 회사가 계약량의 약 70%다. 어떤 채권은 고객이 반드시 산다고 보증해서 박스의 위험을 낮추고 조달 금리를 떨어뜨린다. 비용과 금융 비용을 상계하고 남는 이익과 위험은 위의 CoreWeave 본체에 쌓인다. 화면의 숫자(채권·CDS)는 이 본체의 것이다.
[24:01] 채권 수익률과 CDS spread가 말하는 위험
무담보·후순위채인 2031년 만기 5년물은 올해 초 국채 금리 4%대에 spread 5%를 얹은 9.75%로 발행됐다. 이번 주 만기 수익률이 15.78%라는 건 100원짜리 채권을 약 80원에 살 수 있다는 뜻이다. 쿠폰 9.75%에 할인분 20원을 더해 수익률이 맞춰진다.
CDS(credit default swap)는 채권 부도에 대비한 보험이다. 1,100bp면 매년 원금의 11%를 보험료로 내야 하고, 채권과 CDS를 묶으면 무위험 상품이 된다. 그 보험료가 치솟았다는 건 시장이 이 사업을 매우 위험하게 본다는 뜻이다. 박종현의 요약은 이렇다. “CoreWeave는 돈을 빌려 GPU 공장을 짓고 그걸로 돈을 버는데, GPU가 안 팔리면 망한다. 망할 것 같다고 생각하니 이율이 오르고 보험료가 치솟는다.”
[25:52] 수요가 아니라 금융 환경이 흔드는 인프라 사업
핵심은 demand가 여전히 견실하다는 데 모두 동의한다는 점이다. 흔드는 건 금융 환경이다. 국채 금리가 지난주 5%대까지 갔다. 인프라 투자기에는 금융 기법으로 arbitrage를 만드는 사업이 흔한데, 이런 사업을 망치는 건 수요보다 갑자기 높아진 금리와 다음 채권 발행이 막히는 것이다. 그때 default가 난다. 그래도 산업이 멈추지는 않고 주인이 구조조정 형태로 바뀔 뿐이다. 시장에서는 저금리(4%) 시기에 설계된 CoreWeave가 10년물 국채 6%를 넘으면 무너진다고 말한다.
노정석은 Excel로 파산 여부를 따지지는 않았다며, 이번에도 거품이 터지는 과정이 아니라 hiccup으로 보고 가격이 회복될 것이라고 말한다. 금융사들이 리포트를 돌려 sentiment를 만들고 꼬리가 몸통을 흔드는 경우도 많다.
[28:25] 이번 주: CDS·공매도·월가·Kimi K3.1 Pro
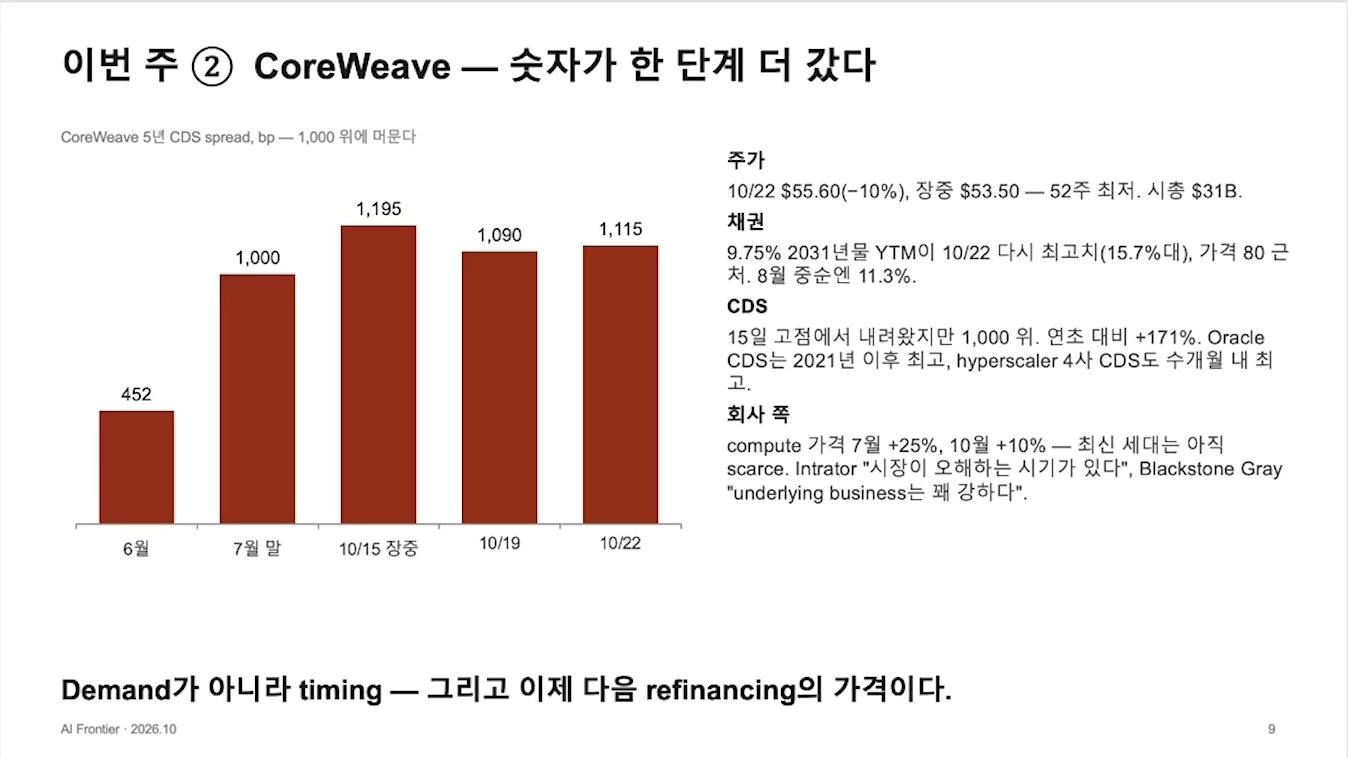
이번 주 숫자는 더 나빠졌다. CDS는 6월 452bp에서 7월 말 1,000, 10/15 장중 1,195로 정점을 찍고 10/19 1,090, 10/22 1,115bp다. 주가는 10/22 53.50으로 52주 최저이고 시총은 $31B다. 9.75% 2031년물 YTM은 10/22 다시 최고치(15.7%대)를 찍었다. 회사 쪽에서는 compute 가격이 7월 +25%, 10월 +10% 올라 최신 세대는 아직 scarce하다고 말한다. 슬라이드의 결론은 “Demand가 아니라 timing — 그리고 이제 다음 refinancing의 가격이다.”이다.
이어 넘어간 슬라이드의 숫자는 덱 PDF로 확인했다.
- 이번 주 ① 시장: Nasdaq 10/22 −2.6%(6월 이후 최대 하락), 10년물 국채 4.95%(5% 아래로, AI 주식에서 국채로 피난), CoreWeave −10%(6월 고점 $138.25 대비 −60%).
- 이번 주 ③ 공매도 — 시장이 먼저 판 것은 AI가 아니라 leverage다: neocloud 5사(CoreWeave·Nebius·IREN·Applied Digital·Core Scientific) 공매도의 10월 평가이익 17B(free float의 20~26%), CoreWeave 공매도 비중 23.7%. 노정석은 말로 “거의 30%“라고 했다. 공매도가 몰린 곳은 Nvidia도 hyperscaler도 아니라 빌린 돈으로 GPU를 깔아 임대하는 중개자들이다.
- 이번 주 ④ 월가는 둘로 갈렸다: Goldman Buy 51, JPMorgan은 은행 exposure가 각 $1~3B로 ‘제한적 위험’이라고 봤다. 노정석은 Citadel의 Ken Griffin은 거품이라 하고 Goldman은 공격적 long이라며 관점이 다 다르다고 정리한다.
- 이번 주 ⑥ Lab — funding이 숫자로 드러났다: Anthropic S-1의 향후 7~10년 취소 불가 cloud 지급 의무 80.7B(그중 1.4T → $1.25T(FT)로 재협상되고 있다.
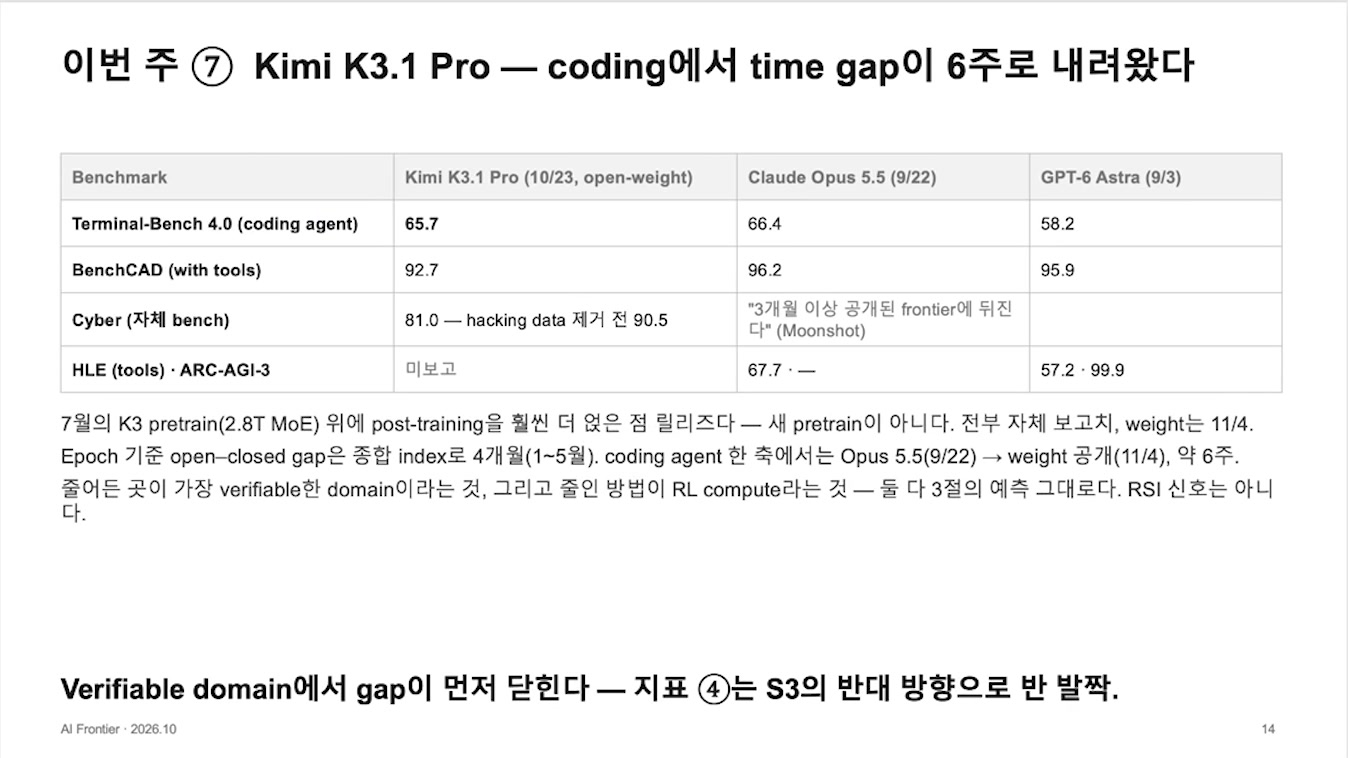
| Benchmark | Kimi K3.1 Pro (10/23, open-weight) | Claude Opus 5.5 (9/22) | GPT-6 Astra (9/3) |
|---|---|---|---|
| Terminal-Bench 4.0 (coding agent) | 65.7 | 66.4 | 58.2 |
| BenchCAD (with tools) | 92.7 | 96.2 | 95.9 |
| Cyber (자체 bench) | 81.0 (hacking data 제거 전 90.5) | — | — |
| HLE (tools) · ARC-AGI-3 | 미보고 | 67.7 · — | 57.2 · 99.9 |
슬라이드 주석에 따르면 K3.1 Pro는 7월 K3 pretrain(2.8T MoE) 위에 post-training을 더 얹은 점 릴리스이고, 수치는 전부 자체 보고치이며 weight는 11/4 공개다. Epoch 기준 open–closed gap은 종합 index로 4개월이지만, coding agent 한 축에서는 Opus 5.5(9/22) → weight 공개(11/4)로 약 6주다. 줄어든 곳이 가장 verifiable한 domain이고 줄인 방법이 RL compute라는 점에서 RSI 신호는 아니라고 덧붙인다(관련: 2026-10-24-x-kimi-k3-1-pro, kimi-k3).
[30:30] Time gap과 domain gap, 모델 안에 박히는 domain feature
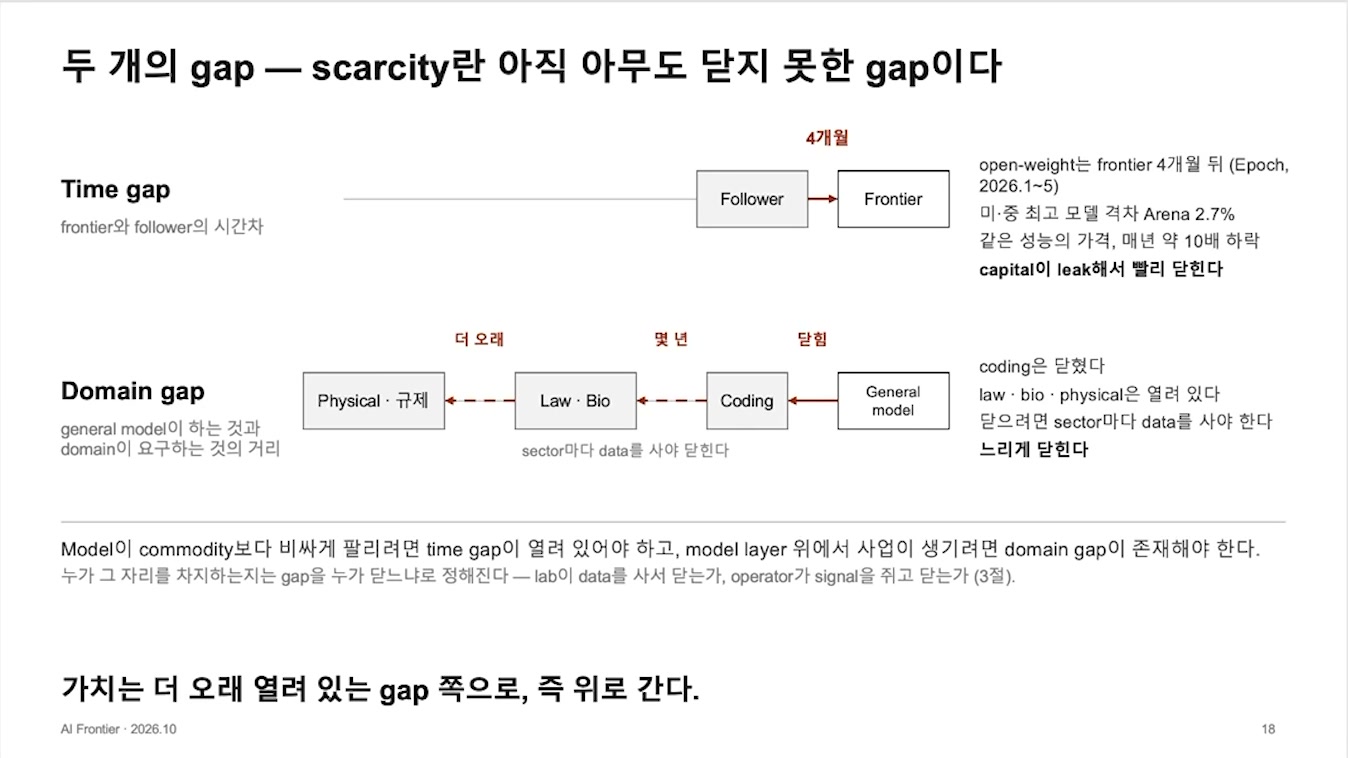
노정석은 이 국면이 telecom bubble보다 railroad boom의 cycle에 가깝다고 본다. 화면의 두 gap은 이렇다.
- Time gap(frontier와 follower의 시간차): open-weight는 frontier 4개월 뒤(Epoch, 2026.1~5)이고, 미·중 최고 모델 격차는 Arena 2.7%, 같은 성능의 가격은 매년 약 10배 떨어진다. capital이 leak해서 빨리 닫힌다.
- Domain gap(general model이 하는 것과 domain이 요구하는 것의 거리): coding은 닫혔고, law·bio는 몇 년, physical·규제는 더 오래 열려 있다. sector마다 data를 사야 해서 느리게 닫힌다.
결론 줄은 “가치는 더 오래 열려 있는 gap 쪽으로, 즉 위로 간다”이다. lab 사이의 time gap은 줄지만, 우리 같은 lab이 아닌 쪽이 frontier 능력을 아직 모르는 사람들에게 파는 time gap은 여전히 크다. domain gap은 모델이 다 하고 있다. Opus 5.5가 비디오 편집을 잘하면 Kimi도 잘한다. 누군가 RL dataset을 Anthropic에 먼저 팔고 뒤의 사업자에게 다시 팔기 때문이다. 새 차가 “엉따·cruise control·자동 에어컨”을 feature로 내세우듯 domain이 모델 feature로 박혀 마케팅 재료가 된다. reward signal이 digital에서 강하게 나오는 coding·수학부터 시작해 어려운 쪽으로 간다. 박종현은 데이터 판매 업체가 지금 어떤 데이터를 모아 어디에 파는지를 보면 다음 domain을 미리 알 수 있다고 보탠다.
[33:12] 모델이 commodity가 되면 이동하는 가치
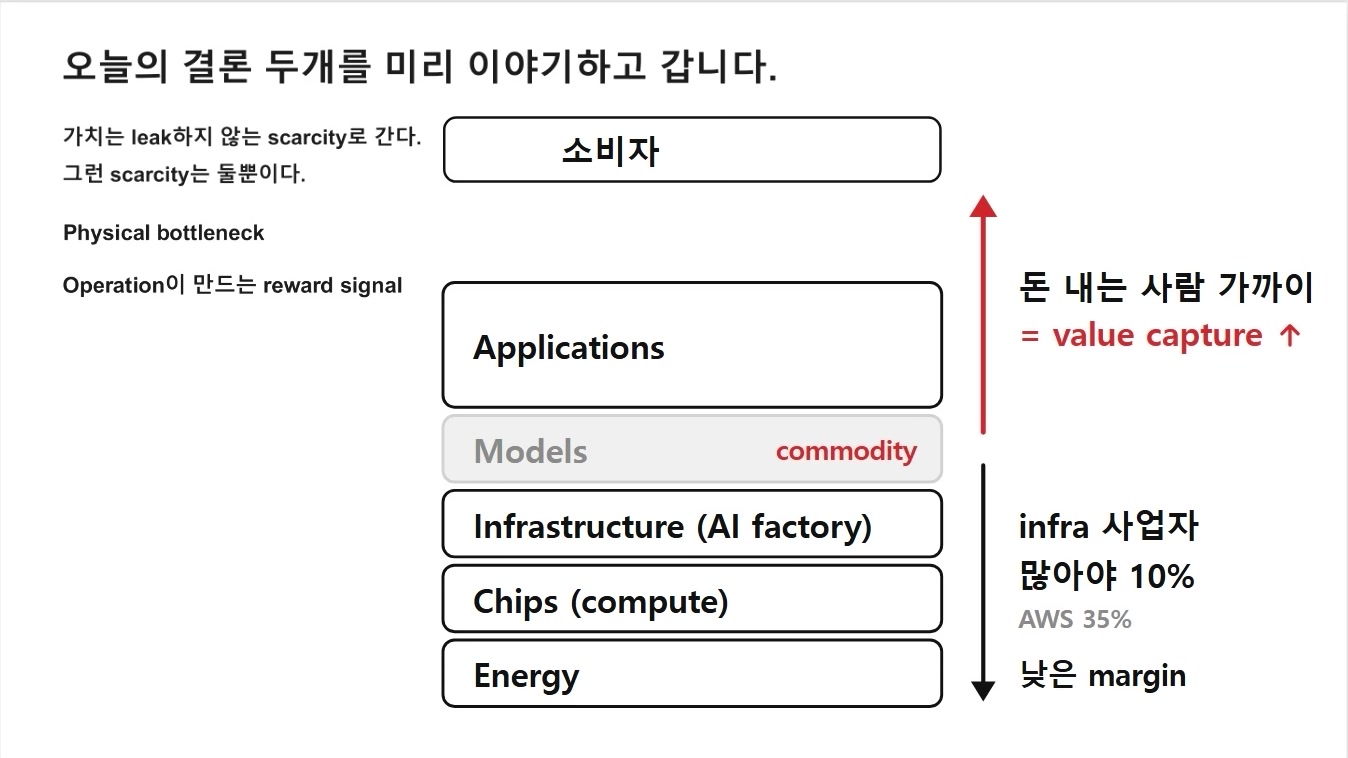
“오늘의 결론 두 개”는 **“가치는 leak하지 않는 scarcity로 간다. 그런 scarcity는 둘뿐이다.”**이다.
- Physical bottleneck: 전력·부지·supply chain. build-out 국면에 돈이 된다.
- Operation이 만드는 reward signal: outcome이 현실에서 드러나야 생기는 신호. 그 뒤에 돈이 된다.
젠슨의 스택(Energy → Chips → Infrastructure → Models → Applications)에서 모델이 commodity가 되면 그 value는 어딘가로 이동한다. 아래로 가면 인프라 사업자가 먹지만 이들은 많아야 10% margin이다(AWS 35%는 예외). 대부분은 돈 내는 사람 가까이, 위로 간다. 위까지 전부 commodity가 되면 누구도 value capture를 못 하고 편익이 낮은 가격으로 소비자에게 간다. 철도·전기처럼 이런 산업은 많다.
노정석은 Anthropic과 OpenAI가 action을 하면 세상이 reaction하는 장세라며, lab들이 무엇을 하는지가 정말 중요하다고 말한다. 다만 “수학 끝나는 거 봐”라는 지금의 성능 gain은 아직 RSI가 아니라고 본다.
[35:07] Scaling law와 계속되는 compute 경쟁
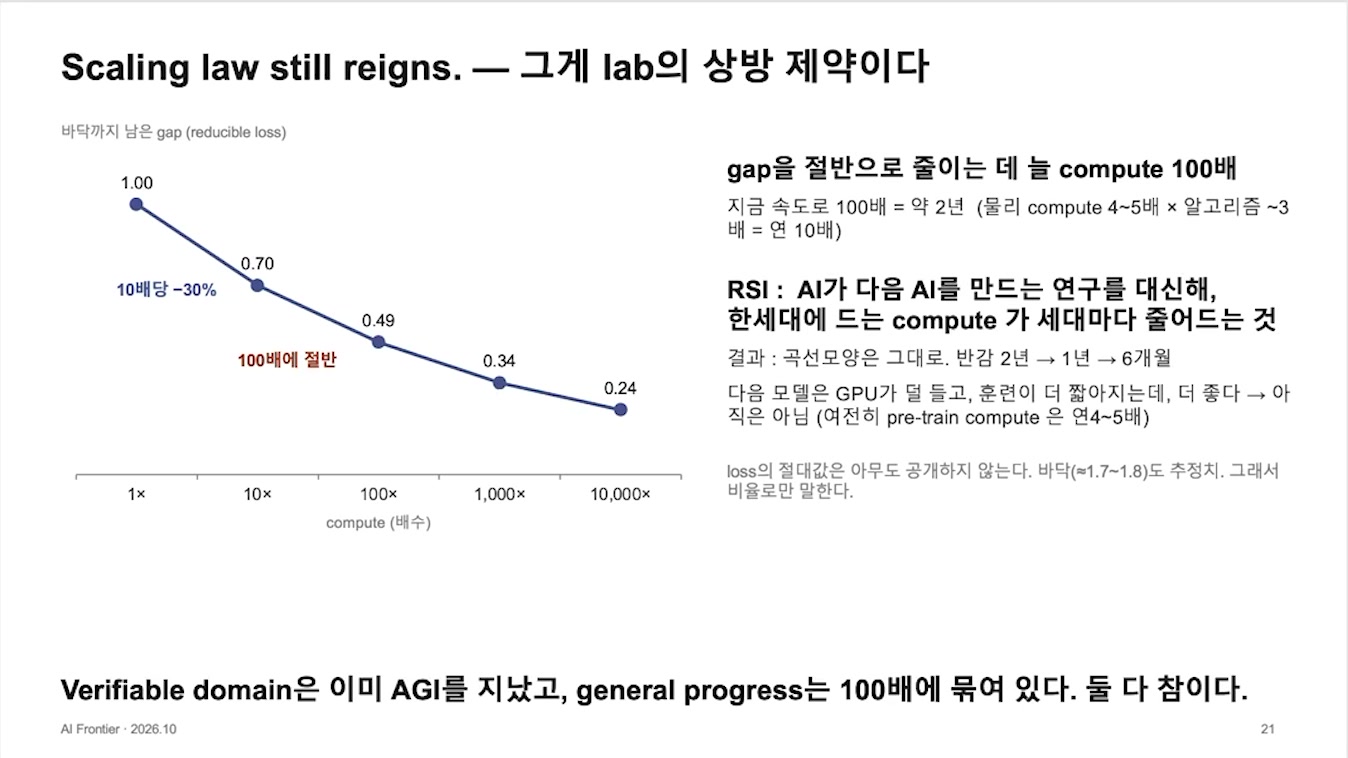
RSI라면 모델이 스스로 모델을 개발해 compute 투입으로 얻는 gain 이상을 만들어야 한다. 아직은 compute와, DeepSeek·Kimi가 잘하는 KV 캐시 같은 알고리즘 efficiency의 조합이다. 화려한 성능은 대부분 compute를 더 넣은 결과다. 요즘은 1GW급으로 한 분기 pre-training하면 한 세대다.
차트는 바닥까지 남은 gap(reducible loss)이 compute 1× → 10× → 100× → 1,000× → 10,000×에서 1.00 → 0.70 → 0.49 → 0.34 → 0.24로 줄어드는 그림이다. 10배당 −30%, 100배에 절반이다. 지금 속도로 100배는 약 2년(물리 compute 45배 × 알고리즘 1.8)도 추정치라 비율로만 말한다고 적었다. 하단 문장은 “Verifiable domain은 이미 AGI를 지났고, general progress는 100배에 묶여 있다. 둘 다 참이다.”이다.3배 = 연 10배)이 걸린다. 슬라이드의 RSI 정의는 “AI가 다음 AI를 만드는 연구를 대신해 한 세대에 드는 compute가 세대마다 줄어드는 것”이다. 그러면 곡선 모양은 그대로지만 반감기가 2년 → 1년 → 6개월로 짧아진다. 아직은 아니다(pre-train compute는 여전히 연 45배). 발화에서는 Chinchilla 논문의 lower bound 1.68을 언급했고, 슬라이드는 바닥(≈1.7
체감으로는 compute 10배에 성능 2배다. 박종현도 loss가 준다고 일반인이 푸는 task가 배로 늘지는 않고, 출시 주기도 추세대로 간다고 느낀다. 노정석은 그래서 compute가 남아돌 일은 없다고 미리 말해 둔다. superintelligence가 우리를 “강아지로 만들 때까지” 경쟁은 끝나지 않는다.
[38:30] 희소한 compute와 새어 나가는 data·talent
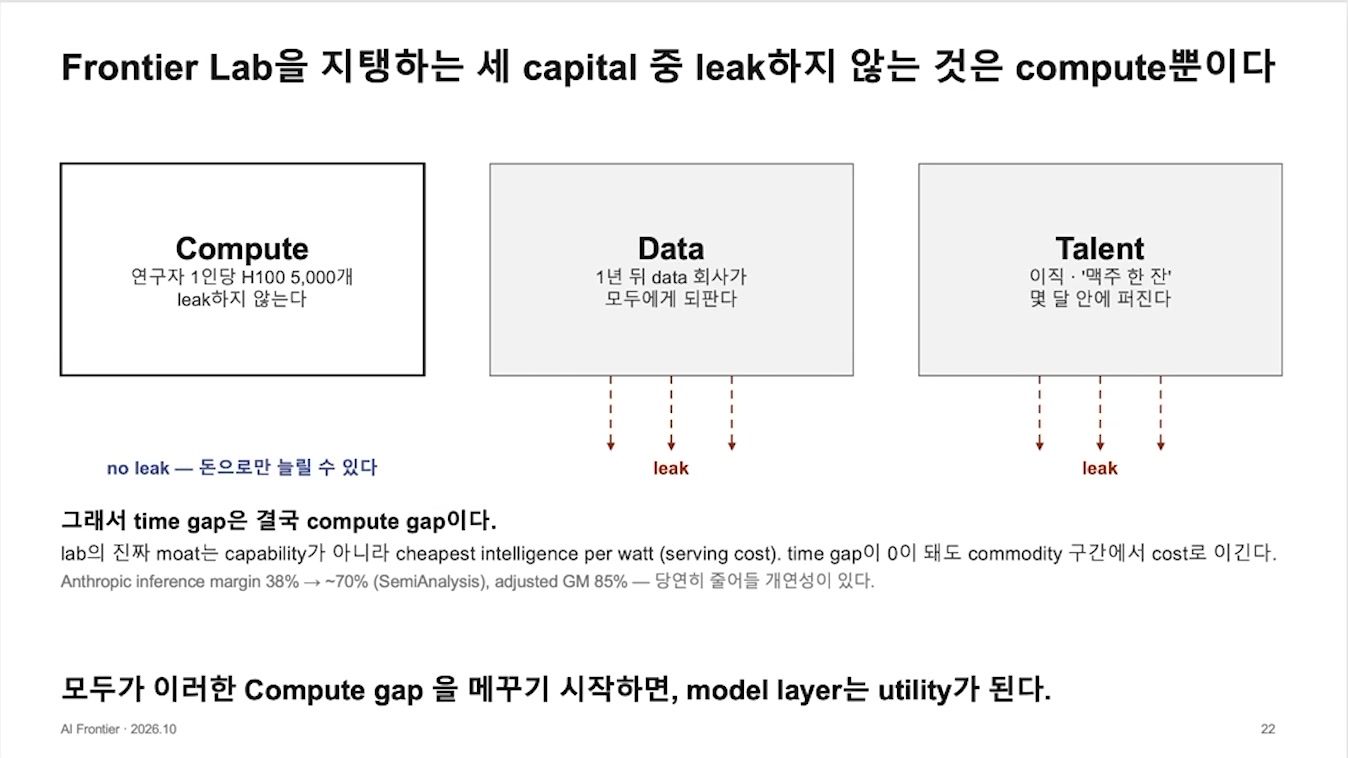
세 상자는 이렇게 적혀 있다.
- Compute: 연구자 1인당 H100 5,000개. leak하지 않는다. 돈으로만 늘릴 수 있다.
- Data: 1년 뒤 data 회사가 모두에게 되판다(leak).
- Talent: 이직·‘맥주 한 잔’, 몇 달 안에 퍼진다(leak).
그래서 time gap은 결국 compute gap이다. 슬라이드는 lab의 진짜 moat가 capability가 아니라 cheapest intelligence per watt(serving cost)이고, time gap이 0이 돼도 commodity 구간에서 cost로 이긴다고 적는다. Anthropic inference margin은 38% → ~70%(SemiAnalysis), adjusted GM은 85%다. 노정석은 SF에서 친구들과 밥만 먹어도 “어느 산에 가면 뭐가 된다”는 방향이 다 샌다고 말한다. 천재 한 명으로 time gap을 만드는 시대가 아니고, Ilya Sutskever도 잘못 베팅했다는 게 그의 판단이다. 그래서 lab들은 누군가 하나가 죽을 때까지 compute 경쟁을 멈출 수 없고, 데이터센터가 새로 가동될 때마다 가격 불문 사러 온다.
1GW 슬라이드(덱 23쪽)의 요지는 이렇다. Blackwell GB300 NVL72 기준 GPU 약 40만45만 개, capex 약 35B)다. 칩은 2년마다 갈아 끼우지만 전력은 남아서 계약 단위가 GW다. 발화로는 “40만50만 개, 500억~800억 달러”라고 했다. 청바지와 곡괭이 장사가 돈을 벌고 있지만, 이번에는 SF의 모든 회사가 자기 모델을 만들며 영역을 발굴하고 방어할 인센티브가 있어서 수요가 다른 곳에서 끊임없이 생성될 수 있다는 점이 예전과 다르다.
[41:20] 수요를 대체하는 AI에서 창조하는 AI로
박종현은 지금까지 AI가 사람이 하던 일을 대체해 왔고, 다 효율화하면 수요가 끝난다고 짚는다. 하지만 coding은 개발자를 대체하고 끝나지 않고 전체 코드 생산량을 폭증시켰다(slop도 넘친다). 다른 분야에서도 그러면 수요가 상방으로 뚫고 올라갈 것이다. 노정석은 이를 연예기획사에 비유한다. 이효리 한 명의 outcome이 워낙 커서 그 뒤에 수만 명의 연습생이 똑같이 연습량(=compute)을 투입한다. “수요는 창조되고 있는 중”이라는 게 새로운 관점이다.
[43:16] Lab의 attention 순서와 buyable data로 자동화되는 ‘사’ 자 직업
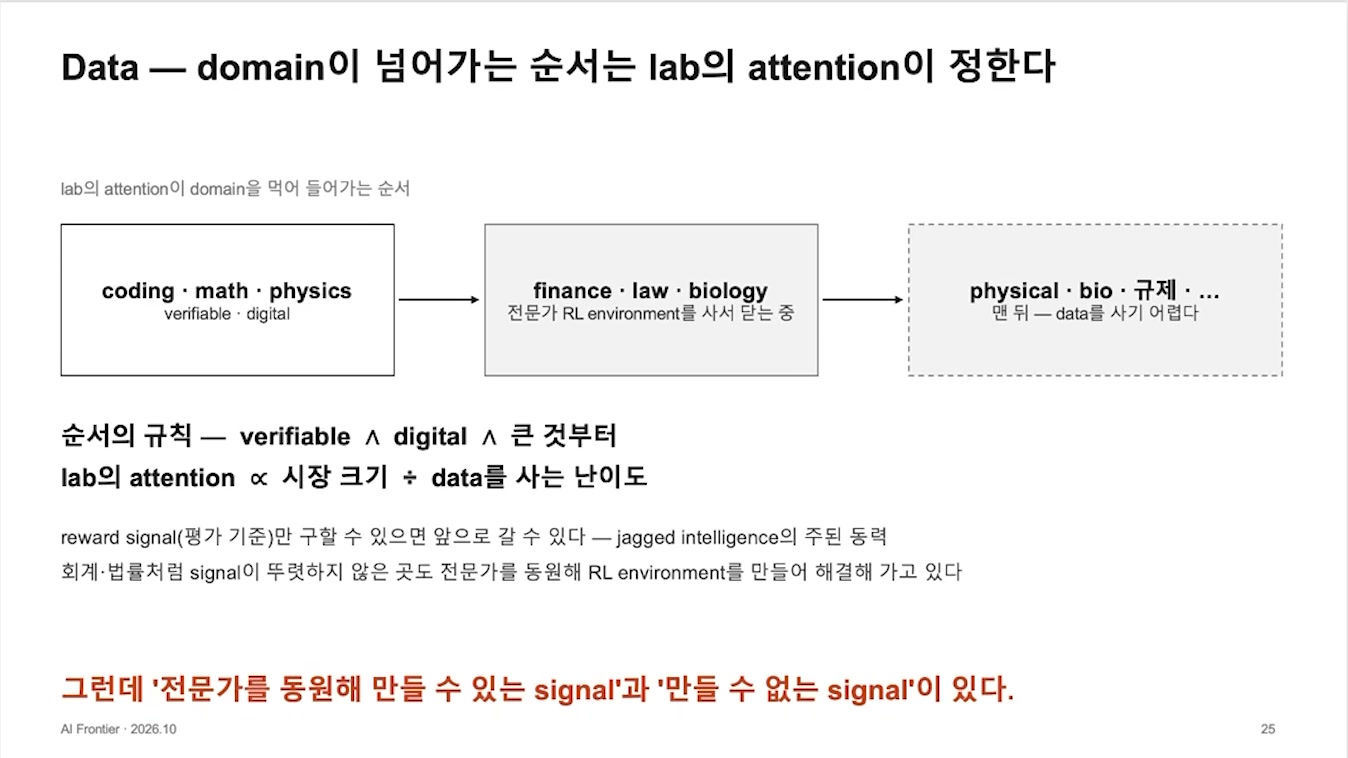
순서는 coding·math·physics(verifiable·digital) → finance·law·biology(전문가 RL environment를 사서 닫는 중) → physical·bio·규제(맨 뒤, data를 사기 어렵다)다. 규칙은 두 줄이다.
순서의 규칙 — verifiable ∧ digital ∧ 큰 것부터
lab의 attention ∝ 시장 크기 ÷ data를 사는 난이도
Frontier lab이 domain을 털러 가면 그 사업은 하면 안 된다. 그 순서에 회계사·변호사·의사부터 보험설계사까지 ‘사’ 자 직업이 모여 있다.
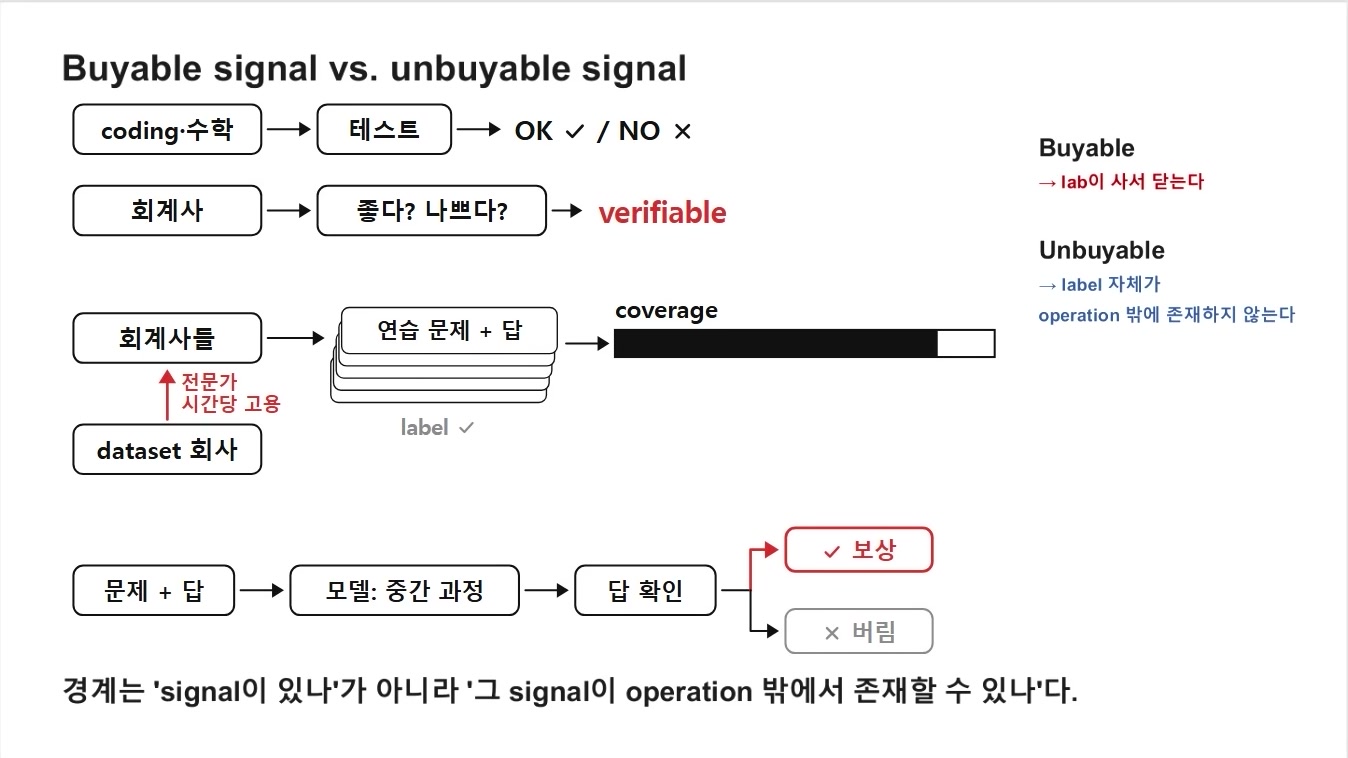
coding·수학은 테스트로 OK/NO가 나온다. 회계사 업무는 좋다/나쁘다를 판단해야 해서 non-verifiable해 보이지만, dataset 회사가 회계사들을 시간당 고용해 모든 경우의 연습 문제와 답(label)을 생산하면 그때부터 verifiable해진다. coverage의 문제다. 모델이 중간 과정을 풀고, 답이 맞으면 보상하고 틀리면 버린다. 이게 대규모로 일어나면 “모든 지식 산업은 끝난다”는 가정이 현실이 된다.
덱의 구분은 이렇다. Buyable은 화면 앞의 제3자가 그 자리에서 판정할 수 있는 signal(법률 문서·회계 계산·코드 테스트)이고, lab이 사서 닫는다. Unbuyable은 outcome이 현실에서 시간을 두고 드러나야 생기는 signal(다시 샀는가, 처방으로 좋아졌는가, 수리가 90일을 버텼는가, 이 batch의 수율)이고, label 자체가 operation 밖에 존재하지 않는다. 하단 문장은 “경계는 ‘signal이 있나’가 아니라 ‘그 signal이 operation 밖에서 존재할 수 있나’다.”이다. 박종현은 데이터 업체의 전문가 채용 공고가 엄청 많고, OpenAI는 직접 고용도 많이 한다는 소문을 전한다.
[45:50] Frontier Lab의 공격 경로 셋과 퍼지는 frontier recipe
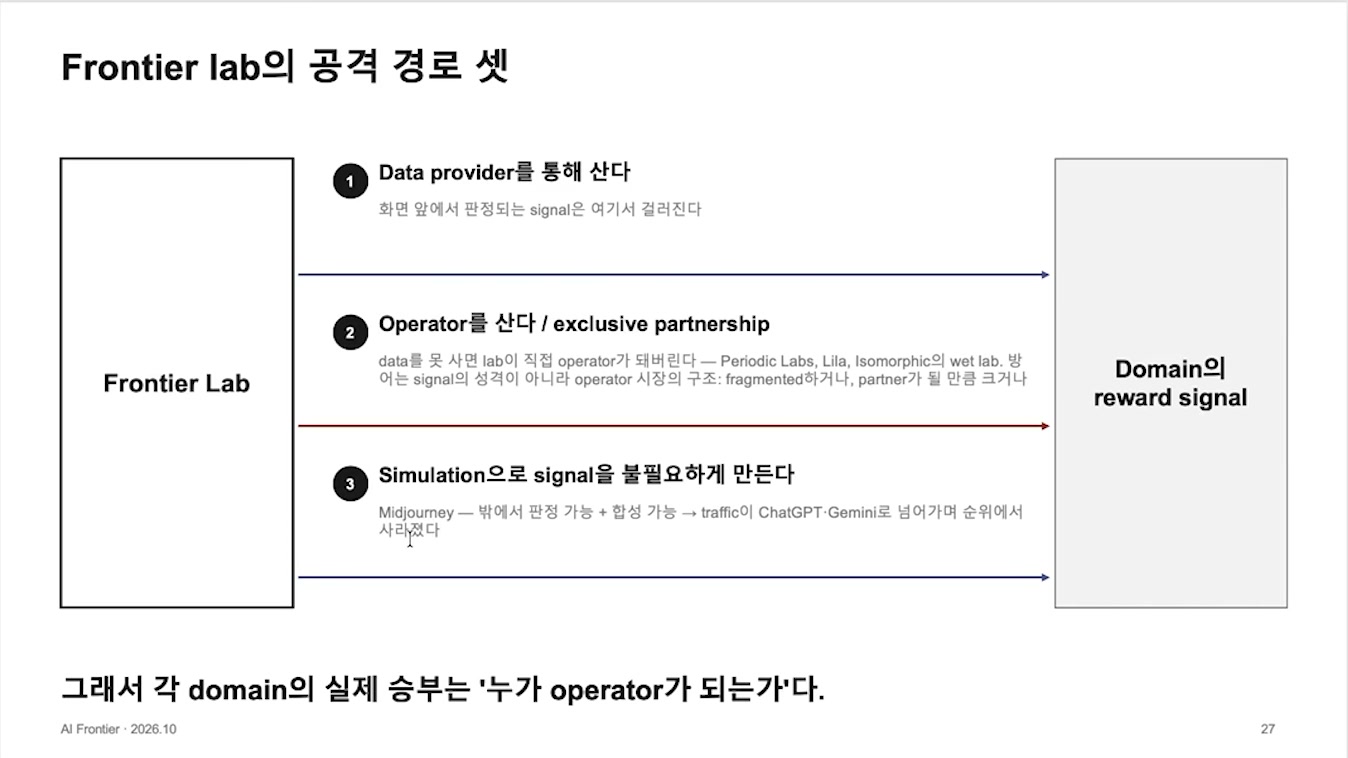
사람이 들어가 digital dataset으로 coverage를 만들 수 있는 domain은 시간문제일 뿐 결국 모델 feature가 된다. 남는 곳은 규제가 있거나, 너무 작거나, 특허로 보호받는 “자잘한 데”다. lab의 공격 경로는 셋이다.
- Data provider를 통해 산다: 화면 앞에서 판정되는 signal은 여기서 걸러진다.
- Operator를 산다 / exclusive partnership: data를 못 사면 lab이 직접 operator가 된다. 예로 Periodic Labs, Lila, Isomorphic의 wet lab이 있다. 노정석은 biology·제약처럼 기댓값이 큰 곳은 reward signal을 얻는 wet lab을 SF에 직접 차린다고 말한다.
- Simulation으로 signal을 불필요하게 만든다: Midjourney가 예다. 밖에서 판정할 수 있고 합성할 수 있어서 traffic이 ChatGPT·Gemini로 넘어가며 순위에서 사라졌다. 동영상 생성 vertical도 “골리앗이 열차를 몰고 오고 있어서” 없어질 것이라고 본다.
결론 줄은 “그래서 각 domain의 실제 승부는 ‘누가 operator가 되는가’다.”이다. talent 슬라이드는 “방법은 비밀이 아니고, 비율만 비밀”이라고 적는다. recipe는 DeepSeek·Kimi·MiMo 논문과 팟캐스트 한두 편으로 퍼지고, 20~30개 회사가 좋은 모델을 만든다. Noam Brown이 하면 다른 데서도 할 수 있는 사람이 많다. Kimi·DeepSeek은 “앞구르기 한두 번”이면 Frontier Lab이 될 것이다.
[47:46] Near Frontier Lab의 moat는 규제, 오픈웨이트는 loop가 끊긴다
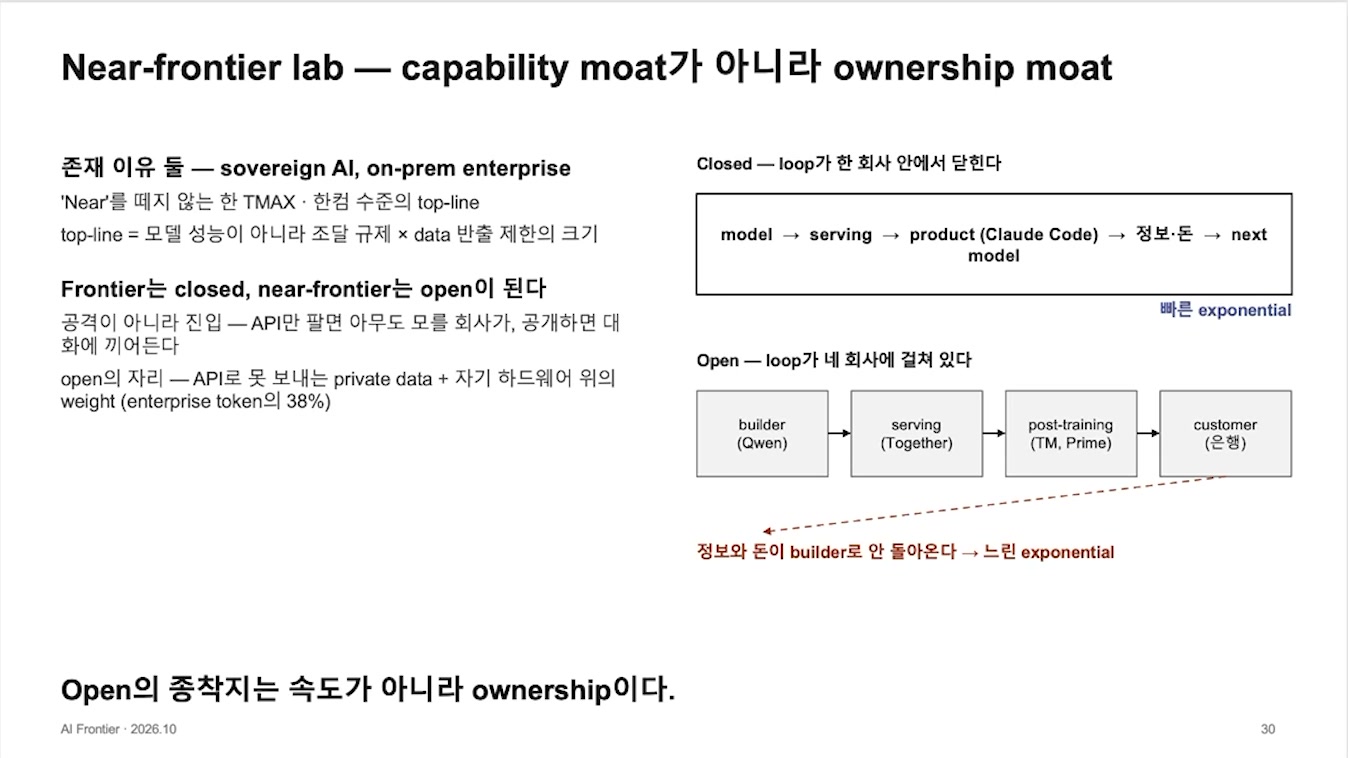
‘Near’를 떼지 못하는 lab의 moat는 규제와 정치, 즉 sovereign이다. 존재 이유는 sovereign AI와 on-prem enterprise 둘이고, top-line은 모델 성능이 아니라 “조달 규제 × data 반출 제한의 크기”로 정해진다. 그래서 TMAX·한컴 같은 공공 조달 회사 수준의 매출이 될 경우가 많다.
오른쪽 그림은 loop의 구조를 비교한다. Closed는 model → serving → product(Claude Code) → 정보·돈 → next model이 한 회사 안에서 닫혀 빠른 exponential을 만든다. Open은 loop가 builder(Qwen) → serving(Together) → post-training(TM, Prime) → customer(은행)의 네 회사에 걸쳐 있어서, 정보와 돈이 builder로 안 돌아오고 느린 exponential이 된다. 노정석은 고객이 쓰는 data와 새 intent가 곧바로 다음 세대 pre-/post-training의 연습 문제로 돌아가야 하는데 오픈웨이트는 그게 끊겨 있다고 설명한다. 하단 문장은 “Open의 종착지는 속도가 아니라 ownership이다.”이다.
[48:52] 편중된 token 소비와 일반 사용자 수요의 gap
지표 ① 슬라이드(덱 32쪽)는 token 소비가 극단적으로 편중돼 있다고 보여 준다. 상위 1%가 매출의 20%, 상위 10%가 50%이고, 결제자는 전체의 4.5%다(a16z 7판). compute도 1%의 회사가 90%를 쓰는데, 그것도 VC 돈이거나 큰 회사의 돈이다. 소비자 사용도 coding·생산성·동영상 생성에 몰려 있다. 쇼핑·소셜·엔터테인먼트처럼 시간을 쓰는 category에는 AI native 승자가 없다. 슬라이드 결론은 “App의 시대는 아직 오지 않았다.”이다. 노정석은 일반 기업과 소비자가 못 따라오는 건 100% 확실하다며, 최승준이 “이 바닥을 살짝만 벗어나면 말할 사람이 없어 외롭다”고 했던 말을 전한다.
[50:40] Spot과 contract 가격으로 보는 GPU 수요
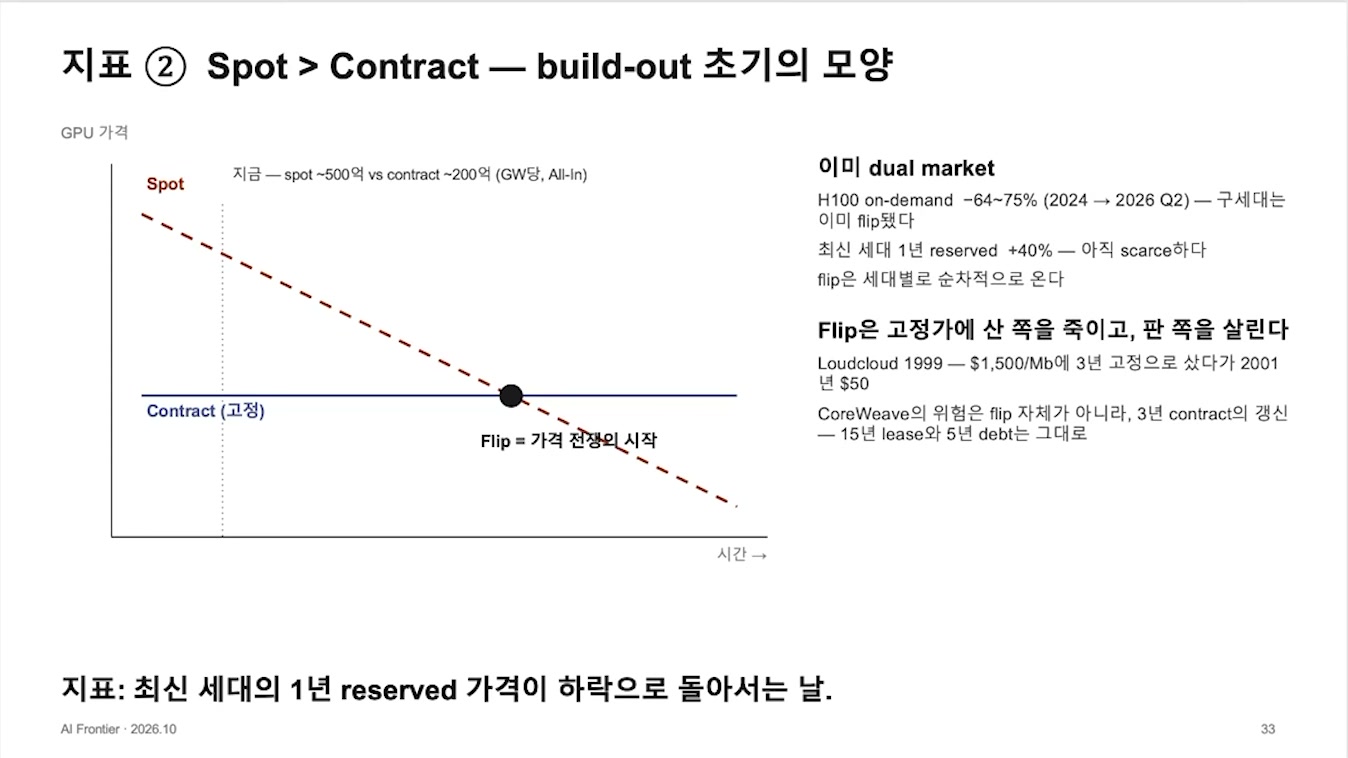
xAI(SpaceX)는 약 3GW의 데이터센터를 지어 compute를 장기 contract가 아니라 spot으로 판다. Nebius·CoreWeave는 3년 계약으로 묶어 낮은 고정가(contract)에 판다. spot은 비싸게 팔 수 있지만 수요가 없으면 논다. 지금은 spot이 contract보다 훨씬 비싸서(화면: GW당 spot ~500억 vs contract ~200억, All-In) AWS Spot Instance도 거의 못 쓴다. 박종현도 GPU spot은 아예 빌릴 수가 없다고 말한다.
화면에 따르면 이미 dual market이다. H100 on-demand는 −64~75%(2024 → 2026 Q2)로 구세대는 이미 flip됐고, 최신 세대 1년 reserved는 +40%로 아직 scarce하다. flip은 세대별로 순차적으로 온다. Flip은 고정가에 산 쪽을 죽이고 판 쪽을 살린다. Loudcloud는 1999년 bandwidth를 50이 됐다. CoreWeave의 위험은 flip 자체가 아니라 3년 contract의 갱신이다. 15년 lease와 5년 debt는 그대로 남는다. 노정석은 이 뒤집힘이 올지 말지가 중요한 분기점이라고 본다. 지표는 “최신 세대의 1년 reserved 가격이 하락으로 돌아서는 날”이다.
[52:07] CoreWeave의 금리 민감도와 만기 mismatch
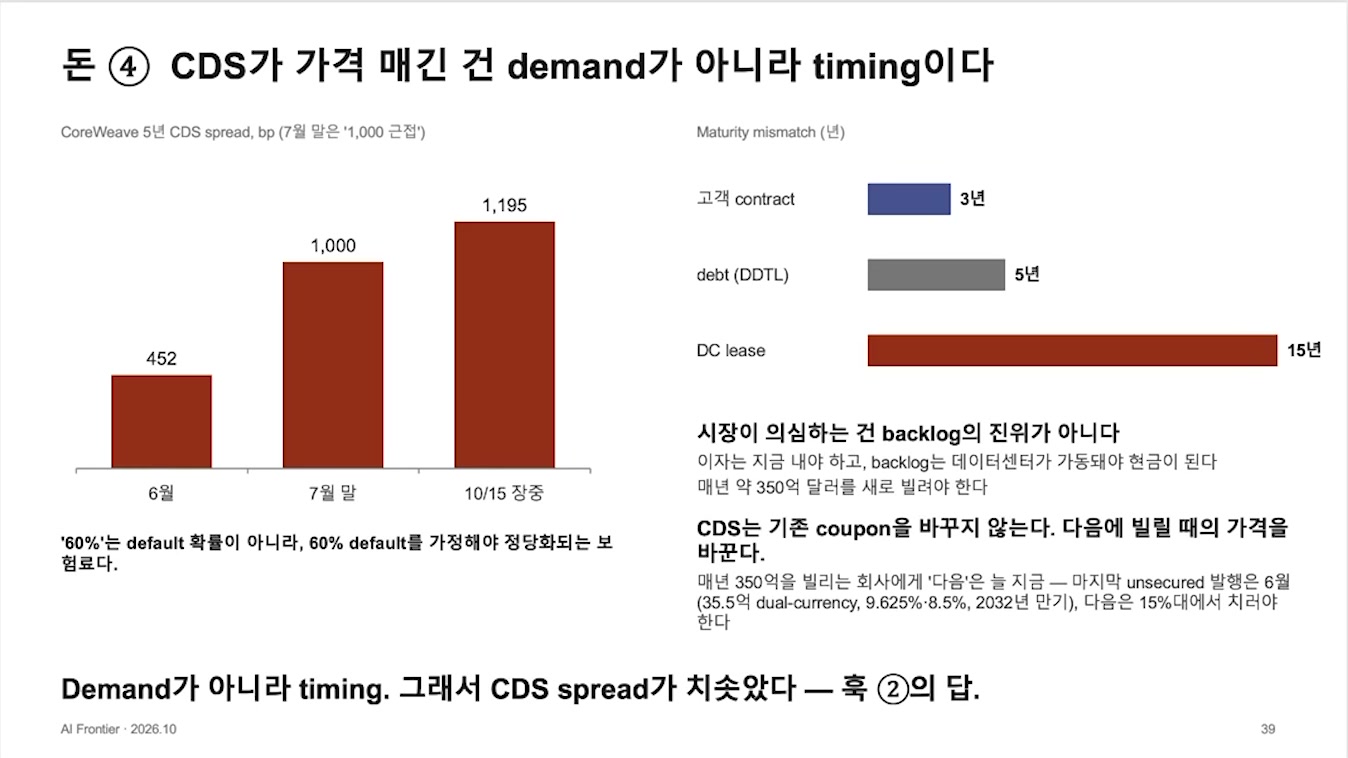
CoreWeave는 계약마다 SPV(Special Purpose Vehicle)를 만들고, 박스별 조건(채권 조달액, 뒷받침하는 hyperscaler)에 따라 남는 손익이 모회사 가치를 이룬다. 그는 이를 “매우 전형적인 구조”라고 부른다. 철도 붐 때도 조달 금리 예상치를 두고 박스를 짠 사업들은 금리가 오르자 다 망했다.
Fable이 찾아온 논점은 돈에 구멍이 나는 게 아니라 타이밍이 안 맞는다는 것이다. 고객 contract 3년, debt(DDTL) 5년, DC lease 15년이 mismatch다. 화면은 “이자는 지금 내야 하고, backlog는 데이터센터가 가동돼야 현금이 된다. 매년 약 350억 달러를 새로 빌려야 한다”고 적는다. CDS는 기존 coupon을 바꾸지 않고 다음에 빌릴 때의 가격을 바꾼다. 마지막 unsecured 발행은 6월(35.5억 dual-currency, 9.625%·8.5%, 2032년 만기)이었고, 다음은 15%대에서 치러야 한다. 왼쪽 아래 주석은 “‘60%‘는 default 확률이 아니라, 60% default를 가정해야 정당화되는 보험료”다. 노정석의 판단은 다음 조달에 실패할 확률이 있더라도 그 원인은 compute 수요 수축이 아니라 금융 환경 변화라는 것이다.
[54:34] Hyperscaler부터 neocloud까지 데이터센터 위험 지도
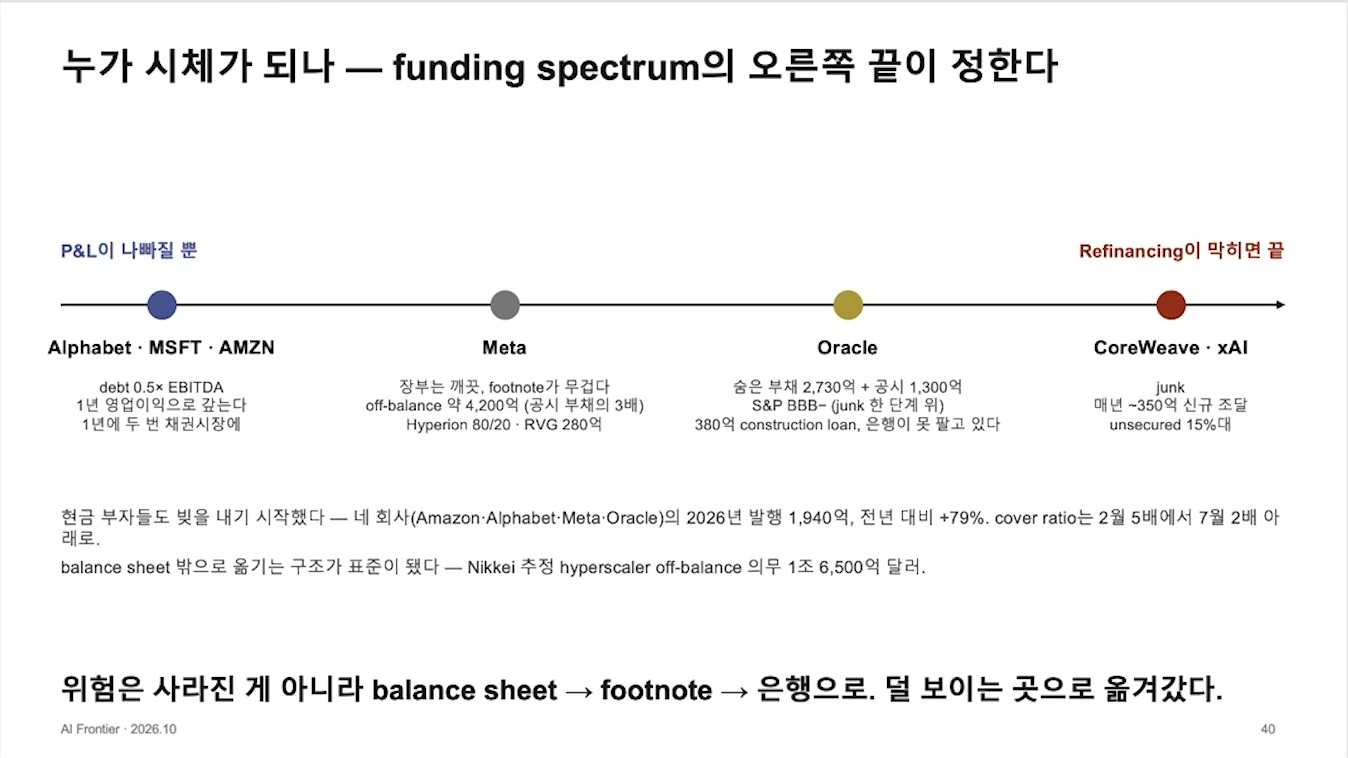
왼쪽 “P&L이 나빠질 뿐”에서 오른쪽 “Refinancing이 막히면 끝”까지 위험 순서다.
| 위치 | 화면 내용 | 발화 보충 |
|---|---|---|
| Alphabet·MSFT·AMZN | debt 0.5× EBITDA, 1년 영업이익으로 갚는다, 1년에 두 번 채권시장에 | 영업이익으로 지어 왔는데, 올해 Google이 처음 채권을 발행해 화제가 됐다 |
| Meta | 장부는 깨끗, footnote가 무겁다. off-balance 약 4,200억(공시 부채의 3배), Hyperion 80/20·RVG 280억 | Hyperion은 Meta가 20%, 대형 인프라 사모펀드(발화로는 “Blue Owl인가 하는”)가 80%를 대고, Meta는 몇 년 임대 보장과 안 되면 보증하는 계약을 붙인다. 잠재 지급 의무는 장부가 아니라 주석에 쓰인다 |
| Oracle | 숨은 부채 2,730억 + 공시 1,300억, S&P BBB−(junk 한 단계 위), 380억 construction loan을 은행이 못 팔고 있다 | 은행 빚을 신디케이트로 쪼개 팔려는데 안 팔려 은행 장부에 잠재 손실로 남아 있다 |
| CoreWeave·xAI | junk, 매년 ~350억 신규 조달, unsecured 15%대 | 10%를 넘으면 junk라 부른다. xAI도 높은 금리로 많이 빌렸지만 SpaceX 상장 같은 가치 상승분을 equity로 돌리는 “일론의 마법”이 있다 |
하단에는 네 회사(Amazon·Alphabet·Meta·Oracle)의 2026년 발행이 1,940억 달러로 전년 대비 +79%, Nikkei 추정 hyperscaler off-balance 의무가 1조 6,500억 달러라고 적혀 있다. 결론 줄은 “위험은 사라진 게 아니라 balance sheet → footnote → 은행으로. 덜 보이는 곳으로 옮겨갔다.”이다. 덱의 ‘돈의 결론’ 슬라이드는 “Spread로 사는 marginal builder는 어느 국면에서도 loser다”이다. 노정석은 실리콘밸리의 꿈의 크기와 큰 목표가 인재와 돈을 끈다는 박종현의 말을 받아 “배워야 한다”고 말하고, 박종현은 낙관주의가 지배적이며 SpaceX는 이미 우주 산업보다 GPU 임대로 더 많이 번다고 덧붙인다.
[58:19] Toyota 아니면 Ferrari: 네 가지 시나리오
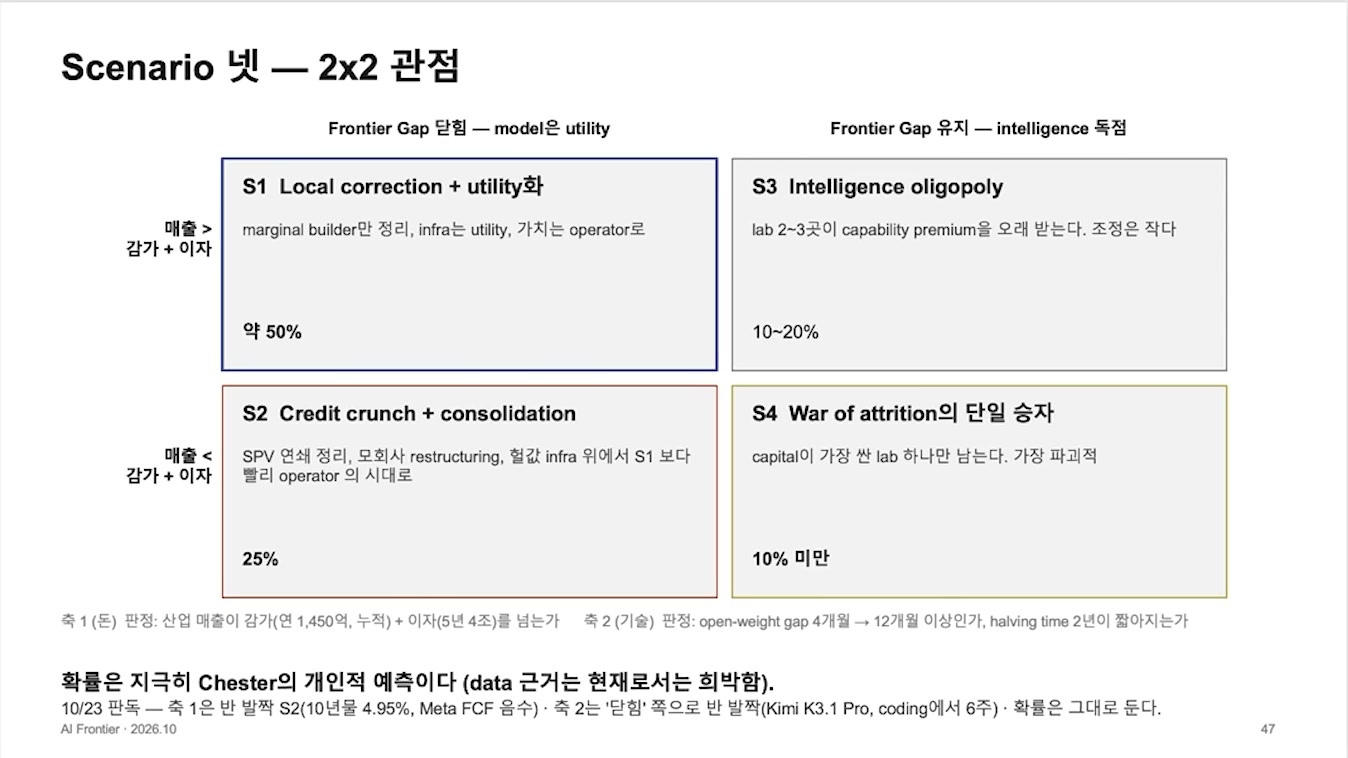
“이제는 현대·Toyota가 되든지 Porsche·Ferrari가 되든지 두 개만 남았고 중간은 다 죽었다”는 말처럼, AI에서도 Frontier Lab이 되든지 domain specific한 operation loop의 소유자가 되든지 둘뿐이다. 금리가 오르면 위험 지도의 오른쪽부터 무너지지만 왼쪽까지 전염되지는 않을 것이고, 그래서 “거품이 진짜 터지는 건가”에 대한 그의 결론은 “아닌 것 같다”이다.
| Frontier Gap 닫힘 — model은 utility | Frontier Gap 유지 — intelligence 독점 | |
|---|---|---|
| 매출 > 감가 + 이자 | S1 Local correction + utility화: marginal builder만 정리, infra는 utility, 가치는 operator로 · 약 50% | S3 Intelligence oligopoly: lab 2 |
| 매출 < 감가 + 이자 | S2 Credit crunch + consolidation: SPV 연쇄 정리, 모회사 restructuring, 헐값 infra 위에서 S1보다 빨리 operator의 시대로 · 25% | S4 War of attrition의 단일 승자: capital이 가장 싼 lab 하나만 남는다. 가장 파괴적 · 10% 미만 |
축 판정 기준도 적혀 있다. 축 1(돈)은 산업 매출이 감가(연 1,450억, 누적) + 이자(5년 4조)를 넘는지, 축 2(기술)는 open-weight gap이 4개월에서 12개월 이상으로 벌어지는지와 halving time 2년이 짧아지는지다. 10/23 판독은 축 1이 반 발짝 S2 쪽(10년물 4.95%, Meta FCF 음수), 축 2가 ‘닫힘’ 쪽으로 반 발짝(Kimi K3.1 Pro)이고 확률은 그대로다. 화면에는 “확률은 지극히 Chester의 개인적 예측이다(data 근거는 현재로서는 희박함)“라고 적혀 있다.
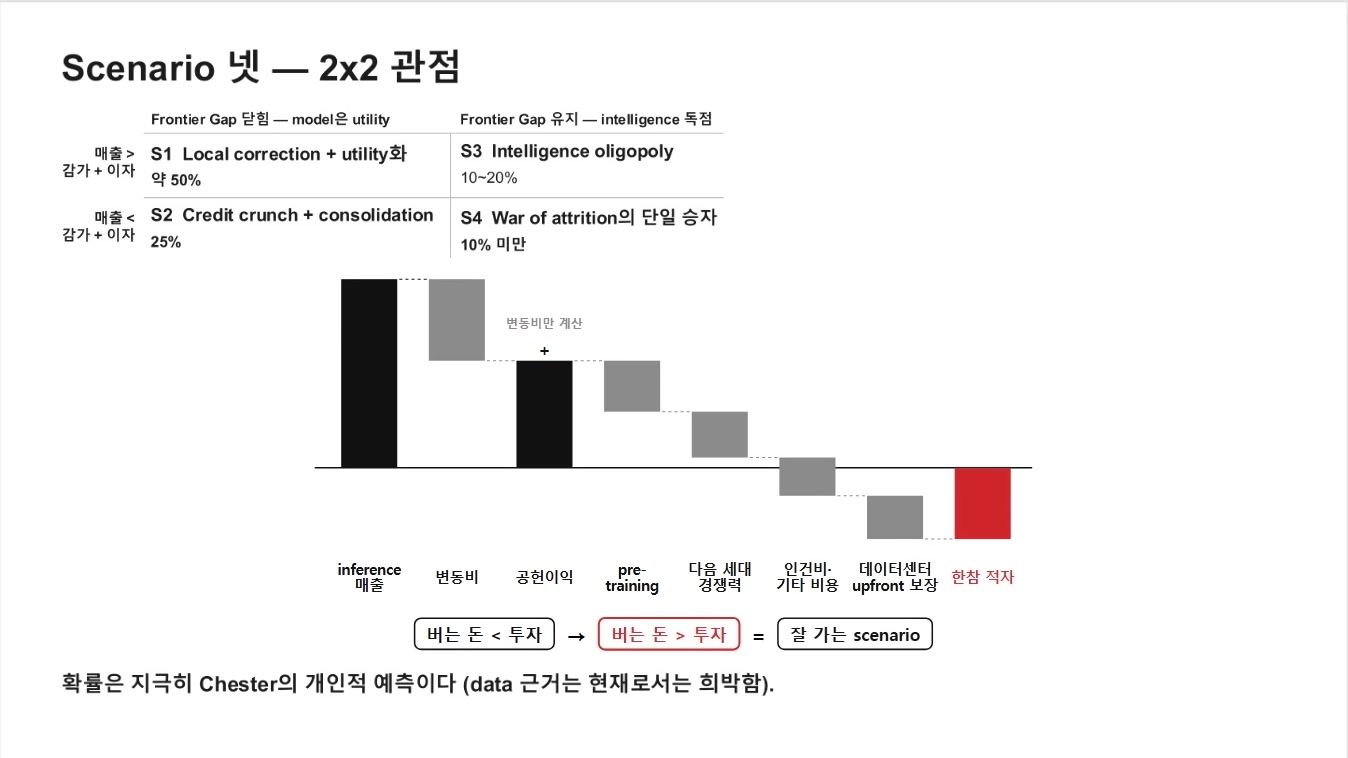
세로축의 뜻은 waterfall로 설명한다. Anthropic이 말하는 inference margin은 변동비만 뺀 공헌이익이다. pre-training, 다음 세대 경쟁력, 인건비·기타 비용, 데이터센터 upfront 보장을 빼면 한참 적자다. “버는 돈 < 투자”에서 “버는 돈 > 투자”로 넘어가야 잘 가는 scenario다. 지금은 감가상각비와 이자가 매출보다 훨씬 크다.
OpenAI·Anthropic이 가장 원하는 사분면은 S3(지능의 독점 인프라 사업자)다. 노정석은 gap이 닫혀 frontier lab 수가 많아지는 S1이 가장 유력하다고 본다. best practice에 도달하거나 투자를 많이 받거나 점유율을 확보한 Google·Meta·Anthropic·OpenAI는 살아남고, 투입보다 산출이 적은 “marginal builder”는 망해서 어딘가로 흡수된다. 금융적으로 재밌는 건 아래 사분면 S2다. 박종현이 닷컴 버블이 S2냐고 묻자, 노정석은 산업이 S2처럼 보이다가 불확실성이 걷히면 S1으로 올라간다고 답한다. 발화로는 S1과 S2를 더하면 “거의 80%“라고 했다(화면은 약 50% + 25%). 가장 큰 변수는 매출이 감가상각과 이자를 넘는 변곡점이 언제 오느냐는 timing이고, S4는 거의 일어나지 않을 것으로 본다.
[1:02:16] 모델의 범용화와 operation loop로의 가치 이동
frontier model이 utility가 되면 가치는 lab에 쌓이지 않고 위아래로 흐른다. 아래로는 Nvidia, 전력 발전소, 냉각탑이 여전히 희소한 자원이라 margin을 꽤 먹는다. 다만 칩은 전 세계가 inference 칩과 Nvidia 대체에 달려들고 있어 희소성에서 벗어날 것 같다. 대부분은 위로, operation loop를 가진 곳으로 간다. lab들이 operation loop마저 dataset 구매와 자체 lab으로 exploit하고 그 안에서도 경쟁이 붙으면 그것도 commodity가 되어 편익은 소비자에게 간다. “superintelligence가 0원이 되는 시대”다.
[1:05:48] Weight 소유는 감가, signal 소유는 복리
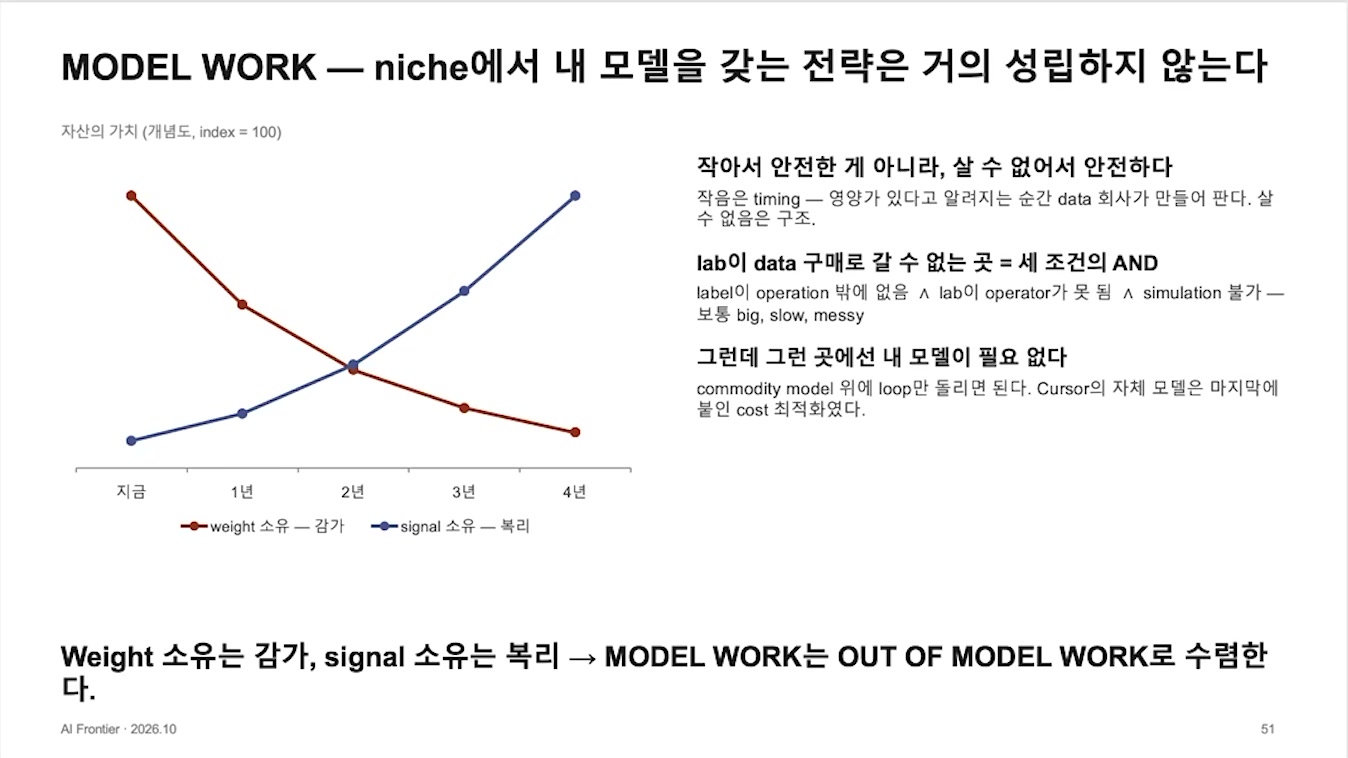
operation loop를 소유한 사업자가 꼭 자기 모델(model work)을 가져야 하는 건 아니다. 노정석은 몇 개 회사에서 이미 증명하고 있다고 말한다. near-frontier 오픈웨이트 모델을 꽂고 compute를 꽂는 것만으로 해결되는 경우가 많다. 내가 소유한 loop는 지능이 아니라 다른 control plane에 있고, 그 데이터는 모델을 학습시킬 만큼 크지도 않다. 뒤따르는 lab은 attention을 얻으려고 weight라도 내놔야 하니 경쟁은 높은 지능의 오픈웨이트 쪽으로 간다.
개념도는 지금부터 4년 동안 weight 소유의 자산 가치(빨강)는 떨어지고 signal 소유(파랑)는 올라 2년 즈음 교차하는 그림이다. 오른쪽 문구는 이렇다. “작아서 안전한 게 아니라, 살 수 없어서 안전하다.” lab이 data 구매로 갈 수 없는 곳은 세 조건의 AND다(label이 operation 밖에 없음 ∧ lab이 operator가 못 됨 ∧ simulation 불가). 보통 big, slow, messy하다. “그런데 그런 곳에선 내 모델이 필요 없다.” commodity model 위에 loop만 돌리면 되고, Cursor의 자체 모델도 마지막에 붙인 cost 최적화였다. 이 문구는 노정석이 쓴 게 아니라 모델이 쓴 것이라고 밝힌다. frontier lab과 경쟁하려면 model work를 해야 하지만, frontier model이 오지 못하는 operation 영역에 loop를 짓는다면 하지 않아도 된다.
[1:08:01] 지혜의 압축체로서의 operation signal
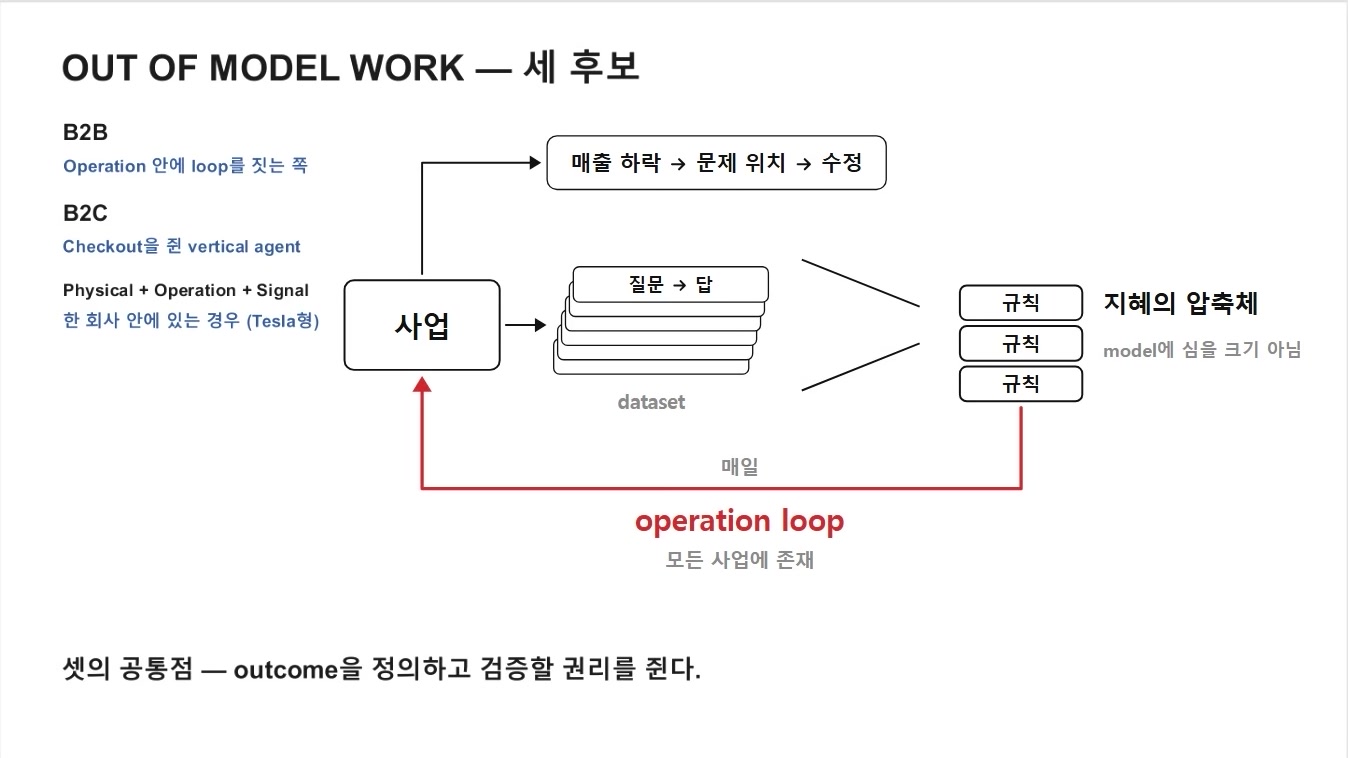
박종현이 signal이 무엇이냐고 묻는다. 노정석도 아직 규정하는 중이라며 예를 든다. 모든 회사에는 “매출이 이렇게 빠지면 어디가 문제고, 그러니 이걸 수정해야 한다” 같은 판단이 있다. 이 질문과 답이 쌓이면 dataset이 되고, 끝에 가서는 몇 개의 규칙으로 압축된다. 그게 지혜이자 rule base다. 모델에 심을 크기는 아니지만 지혜의 압축체이고, 그 규칙을 꺼내려면 사업에서 signal이 매일 발생해야 한다. 이것이 그가 말하는 operation loop이고, 모든 사업에 존재한다.
같은 업계에서 점유율 70%인 회사는 transaction이 많아 operation signal도 많다. 그 loop를 AI와 잘 결합하면 frontier lab도 못 건드리고 efficiency gain도 얻어 다음 세대로 진화한다(다음 화면: “잘 나가는 회사 + AI → frontier lab도 못 건드림 ✓ · efficiency gain ✓ · 다음 세대 사업자”). 그렇지 못하면 이 렌즈에 눈뜬 스타트업이 공격하러 온다.
[1:10:06] B2B·B2C workflow 재설계와 AI agent 경쟁
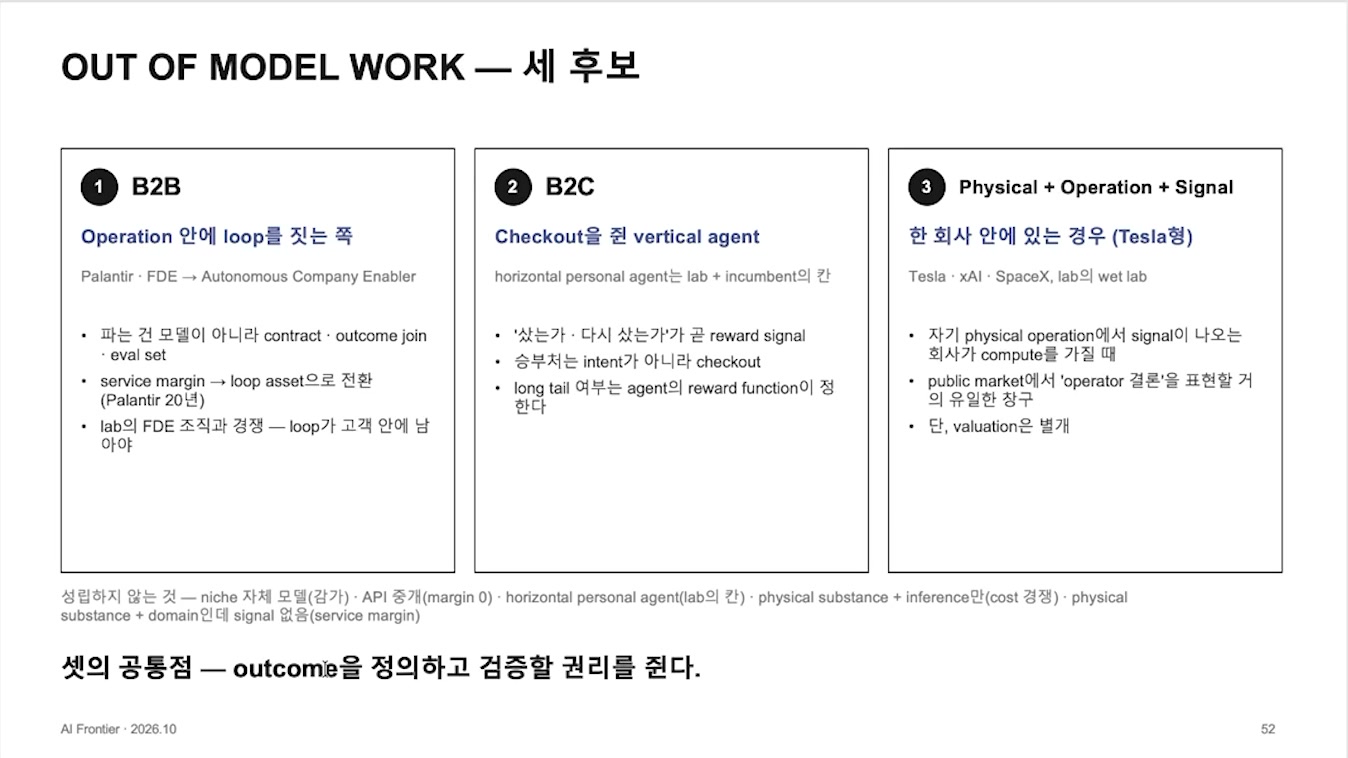
- B2B — Operation 안에 loop를 짓는 쪽(Palantir·FDE → Autonomous Company Enabler): 파는 건 모델이 아니라 contract·outcome join·eval set이다. service margin을 loop asset으로 전환하고(Palantir 20년), lab의 FDE 조직과 경쟁하되 loop가 고객 안에 남아야 한다. 노정석은 기업들이 아직 무엇을 만들어야 할지 전혀 모른다고 본다. 지금은 지식 노동자의 일을 AI로 바꿔 그 사람만 편해질 뿐 회사 전체의 생산성 증가는 없다. workflow를 AI에 맞춰 새로 찾아야 하는 시기이고, Palantir와 OpenAI·Anthropic의 B2B FDE 조직이 그 자리를 노린다.
- B2C — Checkout을 쥔 vertical agent: horizontal personal agent는 lab과 incumbent의 칸이다. Muse Spark, Gemini Spark, Grokbot이 그렇고 카카오·네이버·SK텔레콤도 다 만들 것이다. 소비자 눈앞을 잡는 싸움이다. 노정석은 Google PM 시절 경험으로 승자를 coverage × comprehensiveness로 본다. 레스토랑 예약부터 자잘한 일, 질의응답, 이탈리아행 비행기 표까지 하는데 “삼다수를 못 사주면” coverage가 빠진다. 각 일을 얼마나 비범하게 하느냐가 comprehensiveness이고, 여기에 시장 진입 시점이 더해진다. 화면은 “‘샀는가·다시 샀는가’가 곧 reward signal, 승부처는 intent가 아니라 checkout”이라고 적는다.
- Physical + Operation + Signal — 한 회사 안에 있는 경우(Tesla형): Tesla·xAI·SpaceX, lab의 wet lab이 예다. 밖에서 필요한 기술은 빌리고 밑에서 위까지 수직계열화해 그 안에서 signal loop가 돌게 한다. 그는 팟캐스트 시작부터 Tesla를 이상향으로 삼았다. Elon은 결국 xAI로 frontier lab까지 가졌다.
하단의 “성립하지 않는 것”은 niche 자체 모델(감가), API 중개(margin 0), horizontal personal agent(lab의 칸), physical substance + inference만(cost 경쟁), physical substance + domain인데 signal 없음(service margin)이다. 결론 줄은 “셋의 공통점 — outcome을 정의하고 검증할 권리를 쥔다.”이다.
[1:13:05] 수직계열화와 보험으로서의 Frontier Lab 투자
투자 결론은 frontier lab 주식은 보험으로 가져야 한다는 것이다. flipping point가 언제일지 모르고, lab 한두 곳의 과점 확률은 높지 않다고 보지만, OpenAI·Anthropic·SpaceX(그리고 상장한다면 DeepSeek)은 intelligence 인프라가 되어 인플레이션을 방어하는 자산이 될 것이라는 이유다. 사업은 그들이 안 하는 곳 중 가장 큰 곳으로 가거나, operation loop가 이미 있는 회사에 빨리 가서 필요한 것을 만들어 준다. 노정석 자신도 B2B enterprise AI 회사를 하나 차리려 한다고 밝힌다.
덱의 “그래서 우리는 ① 투자 — exposure의 순서”(54쪽)는 이렇게 정리한다. build-out 국면(spot > contract)에는 physical bottleneck(전력·부지·HBM·packaging·칩)과 앞으로 1년 새 compute의 60%를 가져가는 두 lab에 노출되고, flip 뒤(spot < contract)에는 operator로 옮긴다. 어느 국면에서든 spread business(neocloud 보통주·unsecured notes)는 피한다. “Lab 지분은 bet이 아니라 보험”이고, 크기는 “이 thesis가 틀릴 확률”로 정한다. 투자 자문이 아니라 thesis가 말하는 순서라는 단서가 붙어 있다.
[1:14:24] AI 시장 타이밍을 읽는 일곱 가지 지표
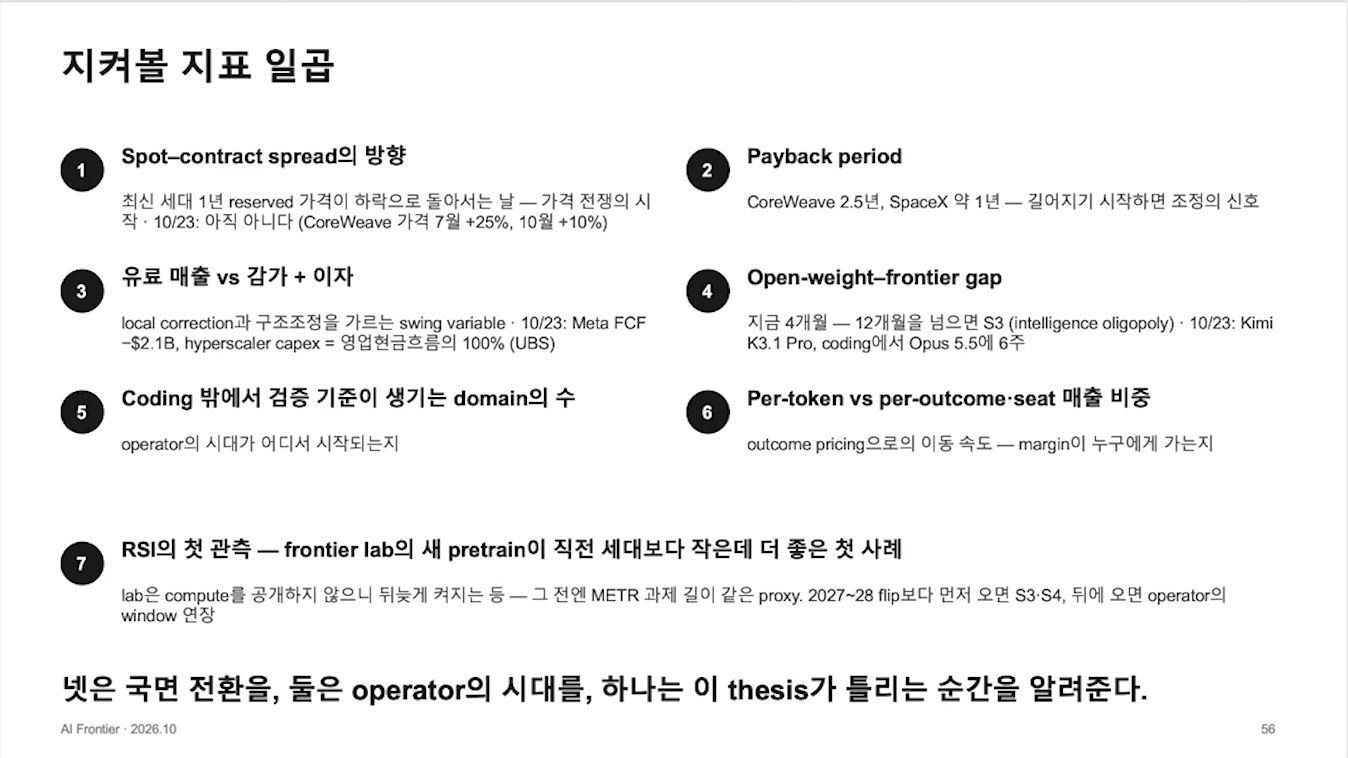
정량 지표는 아니고, 미디어를 추적해 1~2주에 한 번씩 돌려 보는 자기만의 측정 기준이다.
| # | 지표 | 화면 설명(10/23 판독) |
|---|---|---|
| 1 | Spot–contract spread의 방향 | 최신 세대 1년 reserved 가격이 하락으로 돌아서는 날 = 가격 전쟁의 시작. 아직 아니다(CoreWeave 가격 7월 +25%, 10월 +10%) |
| 2 | Payback period | CoreWeave 2.5년, SpaceX 약 1년. 길어지기 시작하면 조정의 신호 |
| 3 | 유료 매출 vs 감가 + 이자 | local correction과 구조조정을 가르는 swing variable. Meta FCF −$2.1B, hyperscaler capex = 영업현금흐름의 100%(UBS) |
| 4 | Open-weight–frontier gap | 지금 4개월. 12개월을 넘으면 S3. Kimi K3.1 Pro는 coding에서 Opus 5.5에 6주 |
| 5 | Coding 밖에서 검증 기준이 생기는 domain의 수 | operator의 시대가 어디서 시작되는지 |
| 6 | Per-token vs per-outcome·seat 매출 비중 | outcome pricing으로의 이동 속도, margin이 누구에게 가는지 |
| 7 | RSI의 첫 관측 | frontier lab의 새 pretrain이 직전 세대보다 작은데 더 좋은 첫 사례. 그 전엔 METR 과제 길이 같은 proxy. 2027~28 flip보다 먼저 오면 S3·S4, 뒤에 오면 operator의 window 연장 |
발화로 보충한 내용은 이렇다. 2번은 GPU를 3년 쓰고 불용 처리하느냐 8년 쓰느냐에 따라 완전히 달라진다. 감가상각이 끝난 뒤에도 자산이 계속 돌면 그때부터 순이익이다. 박종현은 퇴역했다고 생각한 A100에서도 compute 부족으로 매출이 계속 나온다고 전한다. 4번의 미·중 gap은 4개월에서 2개월 안쪽으로 줄어드는 것 같다. 6번은 FDE 컨설팅 프로젝트에서 token 값이 그 회사가 취한 margin보다 큰지 작은지의 비율이다. 7번이 오면 “우린 죽었다고 생각하는 게 맞을 수도” 있다. 이 모든 지표의 최대 리스크는 superintelligence가 연내에 나와서 끝나 버리는 것이다. 화면의 요약은 “넷은 국면 전환을, 둘은 operator의 시대를, 하나는 이 thesis가 틀리는 순간을 알려준다.”이다.
[1:17:16] RSI 변수와 마무리
박종현은 이 모든 설명이 현재 흐름이 이어진다는 가정 위에 있다고 짚는다. Ilya Sutskever가 베팅한 것처럼 continuous learning 같은 새 research breakthrough가 나오면 흐름이 완전히 바뀔 수 있으니 계속 모니터링해야 한다는 것이다. 노정석의 정리는 세 줄이다. Frontier Lab을 잘 살피고, 그들이 못하는 곳을 보고, 그 사이에서 타이밍이 어떻게 바뀌는지를 본다. 이런 생각실험은 결정적인 시기에 1년에 한두 번 해 보는 것이고, “생각이 다르시다면 여러분 의견이 맞습니다”라고 덧붙인다. 마지막으로 최승준이 일산에서 운영하는 AI 유치원(한미유치원)을 소개하며 녹화를 마친다.
덱 마지막 장(57쪽)의 한 문단 결론은 이렇다. “Leak하지 않는 scarcity는 둘이다. Physical bottleneck은 사서 들고, operation의 reward signal은 만들어서 들어라. Spread business는 어느 국면에서도 피하고, lab은 thesis가 틀릴 때를 위한 보험으로만 들어라. Operator의 시간은 정리가 끝난 뒤가 아니라, 지금이다.”
부록 — 실전 체크리스트
- 사업 아이템 거르기: lab의 attention 순서(verifiable ∧ digital ∧ 큰 시장)에서 앞쪽이면 피한다. 남길 후보는 ① label이 operation 밖에 없고 ② lab이 operator가 될 수 없고 ③ simulation으로 우회할 수 없는 domain이다. 데이터 판매 업체가 무엇을 모으는지(전문가 채용 공고)를 보면 다음 차례가 보인다.
- 자체 모델 여부: frontier와 경쟁할 게 아니면 model work를 하지 않는다. 오픈웨이트 commodity 모델 위에 loop(contract·outcome join·eval set)를 짓고, 모델은 분기마다 갈아 끼우는 부품으로 둔다.
- operation signal 수집: “문제 → 원인 → 조치” 판단을 질문–답으로 계속 기록해 규칙(지혜의 압축체)으로 압축한다. 점유율 높은 기존 사업자가 유리하다.
- 인프라·금융 기사 읽는 법: CDS·YTM 급등을 수요 붕괴로 바로 읽지 않는다. 만기 구조(고객 3년 · debt 5년 · lease 15년), 다음 refinancing 금리, funding spectrum상 위치(P&L 악화 vs refinancing 차단)를 먼저 본다.
- 타이밍 판독: 일곱 지표(특히 최신 세대 1년 reserved 가격, payback period, open-weight gap, 유료 매출 vs 감가+이자)를 1~2주 간격으로 갱신한다. 모두 화자 개인의 정성 지표라는 점을 염두에 둔다.
관련 노트
- 2026-10-12-ai-frontier-ep118-singularity-midst — time gap × domain gap 시장 지도, 철도·광통신 과투자 비유, “가치는 희소한 곳으로”(이번 회차가 심화한 2주 전 회차)
- 2026-10-23-ai-frontier-ep119-video-as-code — 직전 회차, AI가 판단하지 못하는 희소한 곳
- 2026-10-24-x-kimi-k3-1-pro · kimi-k3 — 이번 회차가 time gap 근거로 쓴 Kimi K3.1 Pro
- 2026-10-10-news-hada-35094-a16z-state-of-markets-ii — a16z 시장 데이터 정리(같은 시기 a16z 자료)
- 2026-07-26-aifrontier-kr-podcast-site — AI Frontier 팟캐스트 사이트와 공식 전사본
- anthropic · openai
원문 인용 모음
- [03:16] “느낌상 지금은 build-out 국면이 아직 끝난 건 아니고 앞으로 수요가 조금은 더, 어쩌면 한참은 더 지속될 것 같은데 비관론이 너무 빨리 왔다는 생각이 하나 있고”
- [10:09] “value chain상에서 가치는 어디로 가는가라고 질문해 보면 답은 언제나 정해져 있어요. 희소한 곳으로 가요. Value capture는 희소한 곳으로 갑니다.”
- [10:46] “leak이 없다는 게 moat가 있다는 것과 똑같은 말이겠죠. 그래서 제가 leak하지 않는 scarcity로 간다고 한 거죠.”
- [20:57] (박종현) “Q2와 Q3 사이가 45% 성장인데 이것도 엄청 큰 거잖아요. 그런데 이걸 보고 기대가 꺾였다는 게 얼마나 기대가 컸었나”
- [25:56] “근데 중요한 포인트는 demand는 여전히 견실하다고 다 보고 있어요. … 그 사업을 망치는 거는 수요라기보다는 금융 환경이 가장 커요.”
- [27:37] “저는 이번에도 거품이 터지는 과정이라기보다는 그냥 재채기, hiccup 정도로 보고 있어요.”
- [37:50] “compute가 남아돌 일은 없을 거라는 얘기는 미리 해야 할 것 같아요. 계속 희소한 상태로 갈 겁니다.”
- [37:50] “data랑 talent는 새는 자원이에요. talent는 이직해서 새고요. … 친구들이랑 밥 먹으면 새요.”
- [42:21] “그러니까 이거 수요가 없는 거 아니야? 아니요. 수요는 창조되고 있는 중이라는 게 새로운 관점이죠.”
- [44:34] “회계사들 불러다 놓고 모든 경우의 연습 문제를 다 풀고 거기에 대한 label을 생산해 버리면 그 문제는 그때부터 verifiable해져요. coverage의 문제인 거죠.”
- [53:27] “사람들이 지금 의심하고 있는 거는 돈에 구멍이 날 거라는 게 아니라 타이밍이 안 맞는다는 거예요.”
- [58:21] “Frontier Lab이 되든지, 아니면 domain specific한 operation loop의 소유자가 되든지. 두 개 말고는 없는 거죠.”
- [1:07:00] “weight의 소유는 감가, signal의 소유는 복리.”
- [1:08:01] “model에 심어야 될 정도의 크기는 아닌데 지혜의 압축체가 되는 것들이 있어요. … 이게 제가 얘기하는 operation loop예요.”
- [1:12:07] “frontier lab 주식은 갖고 있어야 된다. 보험이에요.”
- [1:18:25] “Frontier Lab을 잘 살피는 게 제일 중요하다. 걔들이 못하는 곳이 어딘지를 보는 게 중요하다. 그다음에 그 사이에서 타이밍들이 어떻게 바뀌는지를 보는 게 중요하다.”