출처: https://youtu.be/ZvgmMilxFkY 길이: 1:57:15 · 채널: 테디노트 TeddyNote (라이브, 2026-10-21 20:56 KST) 출연: 테디(진행) · 김동규(마커 AutoRAG 개발팀 리더, AutoRAG·K-skill 개발자, 해커하우스 NomaDamas 리더) 관련 자료: Marker-Inc-Korea/AutoRAG (Apache-2.0, npm
@autorag/librarian) · Dazzi 앱 소스 NomaDamas/AutoRAG-app (FSL-1.1-MIT) · dazziapp.com
한눈에 보는 요약
- 2년 전 테디노트 라이브 첫 게스트로 AutoRAG(RAG 파이프라인 자동 최적화 도구, 약 5천 스타)를 소개했던 김동규가 같은 저장소를 AutoRAG 2.0 — 개인용 사서(librarian) 에이전트로 통째로 다시 만들어 공개했다. 예전 Python AutoRAG는
legacy/폴더에서 유지보수만 한다. - 출발점: 에이전트는 한 번에 검색하지 않는다(탐색→근거 확인→문서 대조→최신본 판별→재탐색). retrieve→generate 한 번으로 끝나는 파이프라인을 튜닝하는 일은 의미가 줄었지만, “내 파일 어딘가에 있는 정보”를 빠르고 정확하게 찾는 문제는 여전히 풀리지 않았다.
- 세 가지 원칙: ① Never migrate your data to search it — 카톡·슬랙·메일·노션을 한 벡터 DB로 옮기지 않고 소스별 인덱스를 에이전트가 돌아다니며 찾는다. ② Just works — 파이프라인 튜닝·벡터 DB 운영·원격 임베딩 키가 필요 없다. ③ Fast by design — 느린 멀티에이전트 계층 대신 모델 하나가 검색·원문 판독·큐레이션 루프 전체를 맡는다.
- 하네스의 핵심은 빠른 답 → 검증 2단계다. 10~30초 안에 먼저 답하고, 그 뒤 원문을 열어 검증해 정정(델타)을 덧붙인다. Hermes처럼 확신할 때까지 몇 분씩 답이 안 나오는 경험이 계기였다.
- 벡터 검색은 죽지 않았다: 하이브리드(BM25+시맨틱) 검색으로 히트한 파일·폴더에서 파일 기반 탐색을 시작하게 해 Claude Code식 전수 탐색보다 빠르다. 같은 DeepSeek V4.1 Flash로 비교하면 전용 하네스 > MCP 연결 > 맨 하네스 순으로 빨랐다.
- 엔진은 여러 오픈소스의 조립이다: LanceDB(로컬 벡터 DB), Jikji(파일 지도), MinSync(증분 인덱싱+한국어 BM25), mailcrawl(메일 검색), dupey(문서 중복·버전 판별), jev(라우팅·판정).
- 사무직을 위한 GUI로 Dazzi(Electron, “진짜 AI 파일 탐색기”)를 함께 냈다. 탭·분할, 최신본 묶기, 근거 가상 폴더, 이미지 변환을 갖췄고 약 3주 만에 처음부터 만들었다. 첫 수익 모델은 호스팅 모델 구독 Dazzi Models다.
장면별 상세 설명
[00:00] 오프닝 — 2년 사이에 바뀐 것
김동규는 2년 전 라이브 이후를 “KTX였다면 올해 제트 엔진을 단 느낌”이라고 했다. 올해 초 Opus 4.5가 나오며 에이전트 성능이 뛰었고, 그 뒤로는 RAG를 잘하는 법 하나만 보던 시기가 지나 “다음엔 무엇을 해야 하나”를 두고 다들 눈치 게임을 하는 국면이라고 봤다. 동기는 단순하다. 만드는 게 재미있고, 오픈소스로 내면 별과 피드백을 쉽게 받는다. 다만 한국에서 오픈소스로 비즈니스를 만든 사례가 거의 없으니 그 사례를 만들어 보고 싶다는 욕심도 생겼다고 했다. 이번 개편은 테디의 브레인크루·마커 등 컨소시엄이 정부 지원 과제로 준비한 결과물이다.
[12:40] 1. 완전히 새로워진, Agent 시대의 AutoRAG
발표 덱은 Opus가 만든 것이라 말투가 조금 어색할 수 있다고 양해를 구하고 시작했다. 덱 첫머리에서 NomaDamas 해커하우스(새벽 1시에도 AI 오픈소스를 만드는 사람들이 모인 곳)를 짧게 소개했다.
[14:40] 2. 문제 정의 — “작년 3분기 클라우드 계약, 뭐가 바뀌었지?”
RAG는 보통 기업 단위 프로젝트로 구축하지만, 김동규는 개인에게도 늘 필요하다고 느꼈다. “분명히 내 파일 안에 있는데 어디였지?” 하며 사업자등록증을 매번 몇 분씩 찾는 식이다. 맥 Finder 검색은 특히 한글에 약하고, 대부분은 폴더 정리를 하지 않는다(정리 안 된 다운로드 폴더를 그대로 보여 줬다). 오픈소스 시도는 많고 Claude Code·Codex도 어느 정도 되지만 만족스럽지 않아서, 내 파일 어딘가에 있는 질문에 빠르고 정확하게 답하는 에이전트를 AutoRAG라는 이름으로 제대로 만들기로 했다.
[17:20] 3. AutoRAG 1.x — RAG AutoML
RAG AutoML. 내 데이터에 맞는 RAG 파이프라인을 자동으로 찾아주는 도구. 50개 이상의 모듈 조합을 평가하고 최적 조합을 고른다.
2024년 “advanced RAG” 시절에는 리랭커·쿼리 분해·임베딩 모델·프롬프트를 어떻게 고를지가 큰 고민이었고, 그 실험 도구로 만든 것이 AutoRAG였다. 다음 슬라이드의 별 수는 5,126개(Marker-Inc-Korea/AutoRAG)였고, 해외와 여러 회사에서도 쓰였다. 하지만 김동규 스스로 “이제 deprecated된, 옛날 시절의 것”이 됐다고 느꼈다. 덱의 다른 슬라이드는 “v0.1.0은 이미 2024년에 쓰였습니다. 그래서 바로 v2.0.0. 기존 Python AutoRAG는 legacy/에서 계속 유지보수합니다.”라고 정리한다.
[21:30] 4. 에이전트는 한 번에 검색하지 않는다
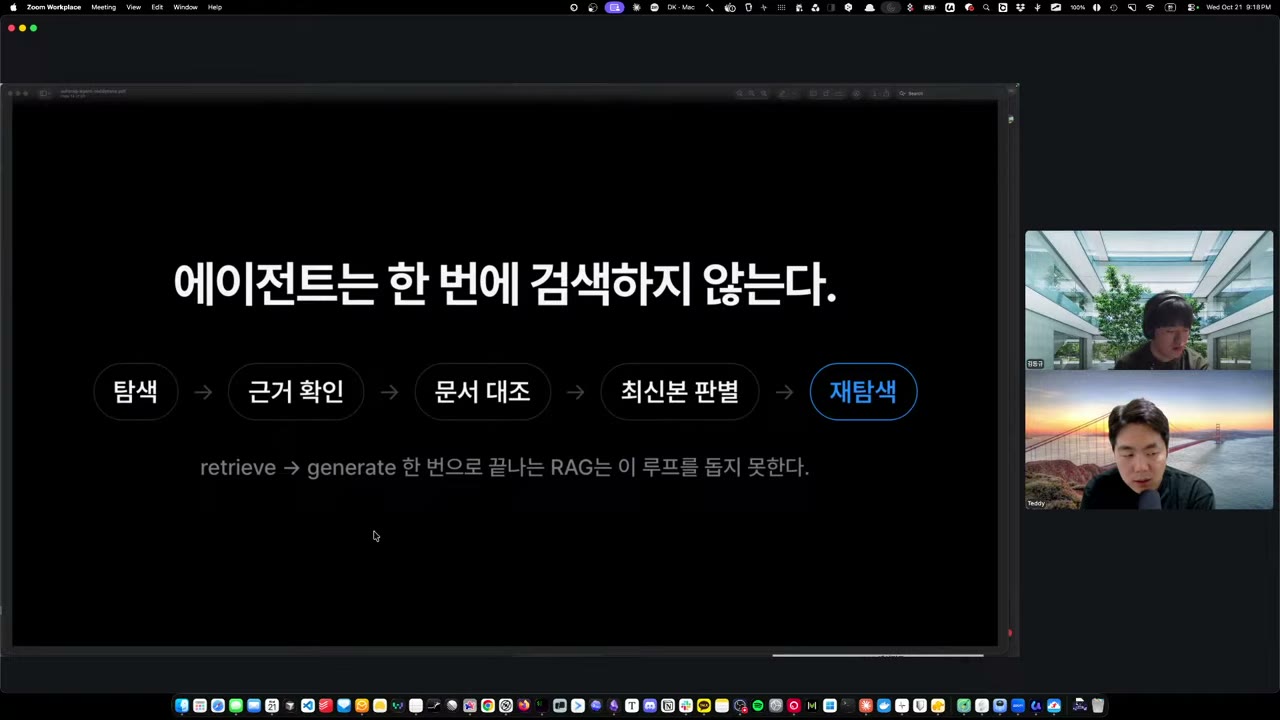
에이전트는 한 번에 검색하지 않는다. 탐색 → 근거 확인 → 문서 대조 → 최신본 판별 → 재탐색 retrieve → generate 한 번으로 끝나는 RAG는 이 루프를 돌지 못한다.
전통 RAG는 벡터 DB를 한 번 검색해 답을 냈다. 에이전트는 tool calling으로 어떤 쿼리로 어디를 검색할지 스스로 정하고, 파일을 열어 대조하고, 최신본인지 확인하고, 없으면 다시 검색한다. 테디는 이 차이를 실무 경험으로 뒷받침했다. 예전에는 첫 검색의 recall이 안 나오면 뒤에서 할 수 있는 게 없었고 컨텍스트도 4K 수준이라 압축에 매달렸다. 지금은 컨텍스트 리콜이 65~70%여도 에이전틱 RAG가 재검색으로 나머지를 보강한다. Claude Code가 가능했던 것도 “한 번 때려 보고 없으면 다른 데서 또 찾는” 반복 덕분이라는 데 둘 다 동의했다.
그래서 “RAG는 죽었는가?”라는 질문에 두 사람은 아니라고 답한다. Claude Code도 검색 방식이 벡터에서 파일 기반으로 바뀌었을 뿐 RAG를 하고 있다. 김동규는 “기술이 죽었다”는 말을 싫어한다고 했다. 기술은 적재적소에 고르는 것이고, 그 예로 jev를 들었다. 본질은 BERT류 분류기인데, LLM judge가 대세일 때 나오자 혁신처럼 받아들여졌다. 판단이 100%가 아니어도 되는 곳에서는 토큰 효율과 속도가 좋아서 AutoRAG Agent에도 기본 탑재했다. 테디는 Jev로 버튼 클릭 여부를 객관식으로 빠르게 판단해 브라우저를 조작하는 오픈소스를 보고 감탄한 사례를 보탰다. (채팅에는 Jev 최신 버전이 이미지를 지원한다는 시청자 제보도 올라왔다.)
[32:30] 5. 다 옮기라고요? — 첫 번째 원칙
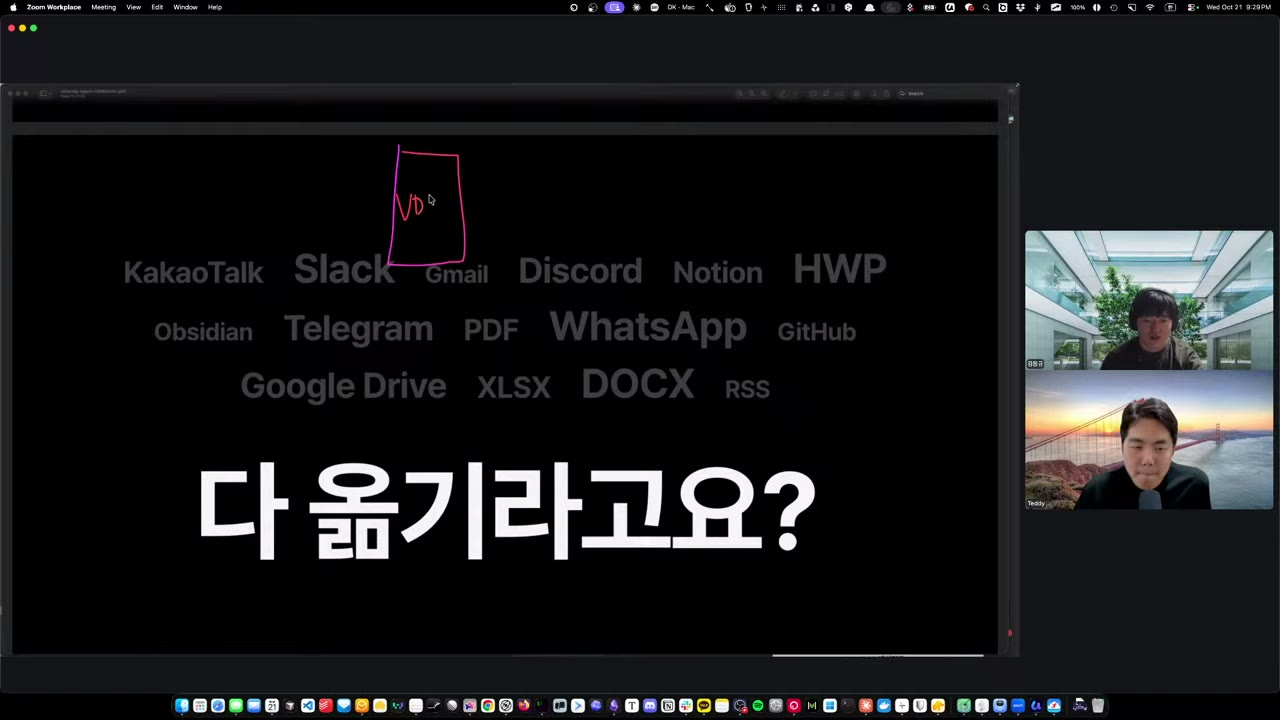
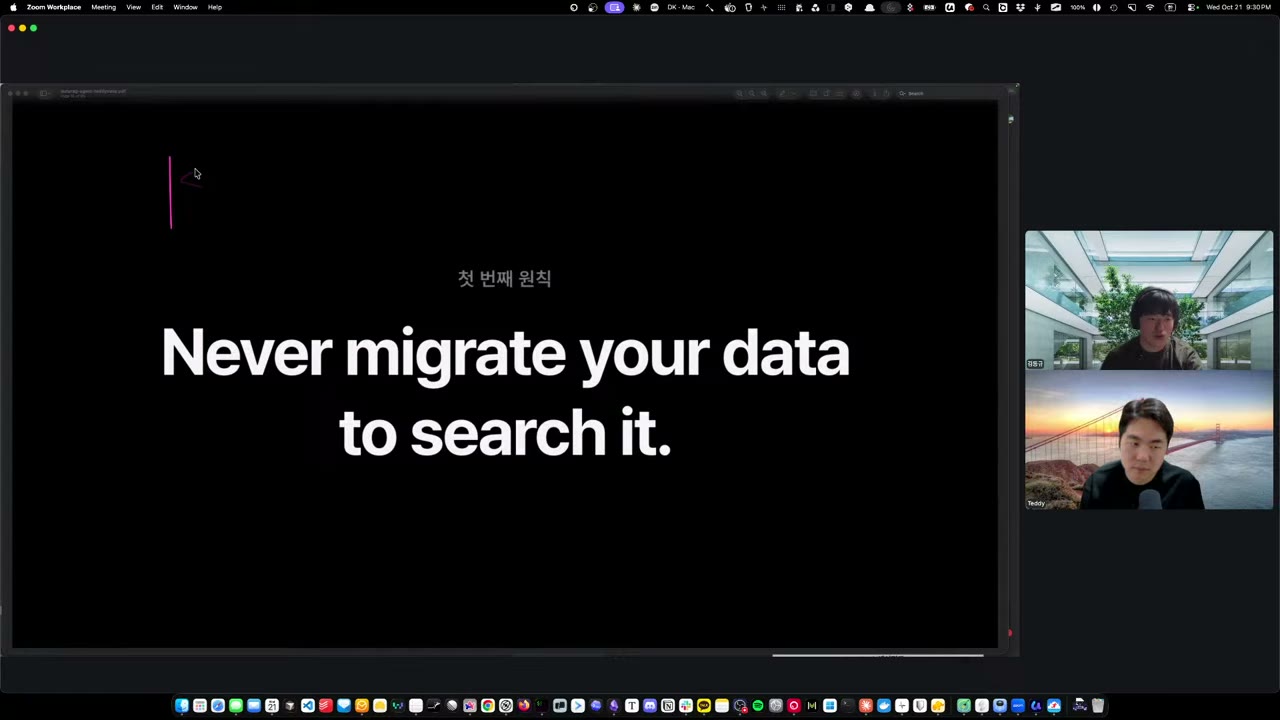
AutoRAG Agent의 정의는 개인용 사서 에이전트다. 파일뿐 아니라 카톡·슬랙·메일·캘린더·GitHub·한글 파일·노션을 한 번에 검색하는 것이 목표다. 기존 RAG는 이 모든 것을 데이터 파이프라인으로 하나의 큰 벡터 DB(화면에 그린 “VD” 상자)에 옮겨 인덱싱했다. 김동규는 그 이유를 “에이전트가 없었기 때문”이라고 본다. 한 번만 검색하니 무조건 한 곳에 모여 있어야 했다.
에이전트라면 옮길 필요가 없다. 카톡 DB, 노션, 텔레그램을 각각 둔 채 에이전트가 하나씩 가 보면 된다. 사람이 “카톡에 있었나? 노션인가? 메일인가?” 하며 찾는 방식과 같다. 이점도 있다. 동기화 파이프라인을 만들고 유지하는 공수가 사라지고, DB 하나가 커질수록 떨어지는 검색 품질 문제도 피한다. 소스별로 나뉜 DB는 각자 준수한 성능을 낸다. README는 이를 결과에 /kakao/..., /slack/... 같은 소스 고유 경로를 유지해 접근 제어와 프라이버시를 지키는 “in-place federation”으로 설명한다.
[36:20] 6. 기억하는 사서, 근거가 달린 답
AutoRAG Agent는 세 가지를 합친 특화 에이전트다. 하이브리드 검색 엔진(시맨틱+렉시컬), 찾은 것을 정리해 기억하는 사서 메모리, 그리고 직접 뒤지는 리서치 에이전트다. 상정한 페르소나는 파일과 정보를 많이 다루는 사무직이다. 지금은 “찾기”에 집중했지만 보고 쓰는 일, 실제 액션(정리·이름 변경·이동·편집)까지 붙이고 있다. README에 따르면 메모리는 Jev가 “답을 실제로 뒷받침한다”고 판정한 인용 근거만 ~/.autorag/memory.json에 저장하고, 이후 검색에는 순위를 바꾸지 않는 참고 정보로만 넘긴다.
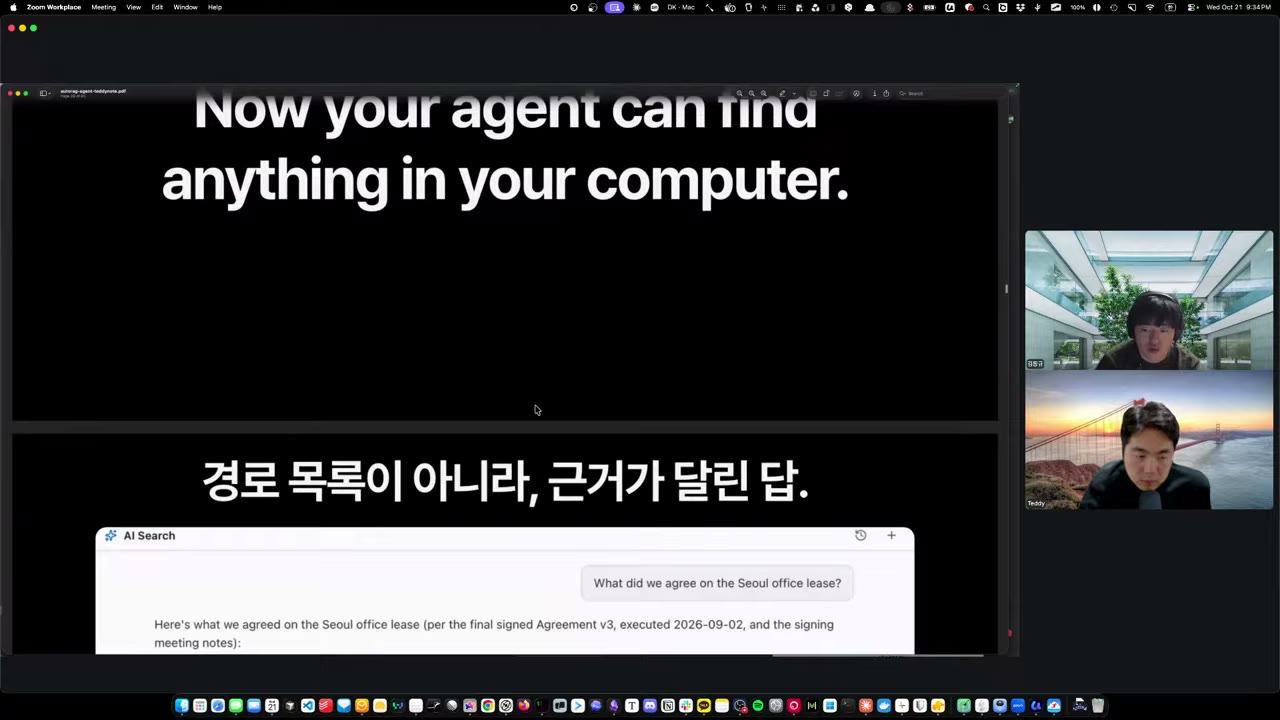
Now your agent can find anything in your computer. 경로 목록이 아니라, 근거가 달린 답. (예: “What did we agree on the Seoul office lease?” → 최종 서명본 Agreement v3 기준으로 번호 달린 근거와 함께 답변)
이 지점에서 다음 주 수요일(10/28) 저녁 역삼 센터필드에서 열리는 첫 AutoRAG 밋업(브레인크루·마커 주최, Luma 신청, 약 80명) 안내가 끼어들었다.
[41:30] 여담 — 김동규의 개발 환경
터미널은 Ghostty를 쓴다. 테디가 아끼는 Herdr는 김동규 환경에서 한국어가 갑자기 안 보이고 외장 SSD 쓰기 권한을 잡아 잠그는 버그가 있어 쉬고 있다고 했다. 테디는 Herdr를 원격 맥에 띄워 두고 붙어 쓰는 방식, 그리고 터미널 세션끼리 대화하며 정보를 넘기는 기능을 오케스트레이션의 장점으로 꼽았다. 여러 구독 계정은 CLIProxyAPI 관리 콘솔로 해커하우스 서버에 묶어 하나의 엔드포인트로 나눠 쓴다(Claude·Codex·Gemini·Grok·Devin 등의 쿼터를 한 화면에서 본다). 김동규도 약관 문제에 민감한 사람은 알아보고 쓰라고 덧붙였다.
[48:20] 7. 데모 — TUI 검색 진행 표시
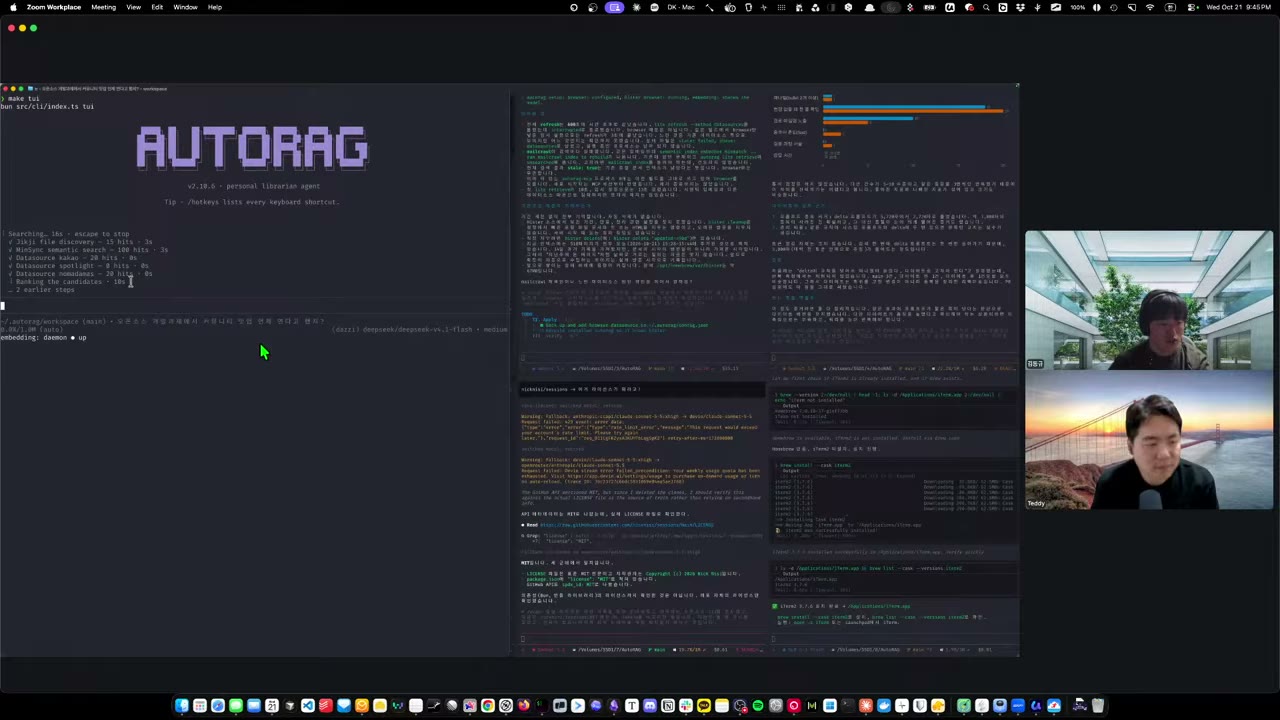
autorag tui(v2.10.6, “personal librarian agent”)에서 “오픈소스 개발과제에서 커뮤니티 밋업 언제 연다고 했지?”를 물었다. 진행 위젯에 단계가 한 줄씩 찍힌다.
✓ Jikji file discovery · 15 hits · 3s
✓ MinSync semantic search · 100 hits · 3s
✓ Datasource kakao · 20 hits · 0s
✓ Datasource spotlight · …
✓ Datasource nomadamas · …
… Ranking the candidates · 10s
리랭커가 이 데모에서 가장 오래 걸렸다. 테디가 요즘 에이전트에서는 리랭킹을 잘 안 쓴다고 하자, 김동규도 뺄지 고민 중이라고 했다(README 기준 지금은 opt-in이다). 라이브 데모는 이른바 데모병으로 느려서, 미리 녹화한 영상을 뒤에 따로 보여 줬다.
[52:40] 8. Fast by design — 빠른 답, 그다음 검증
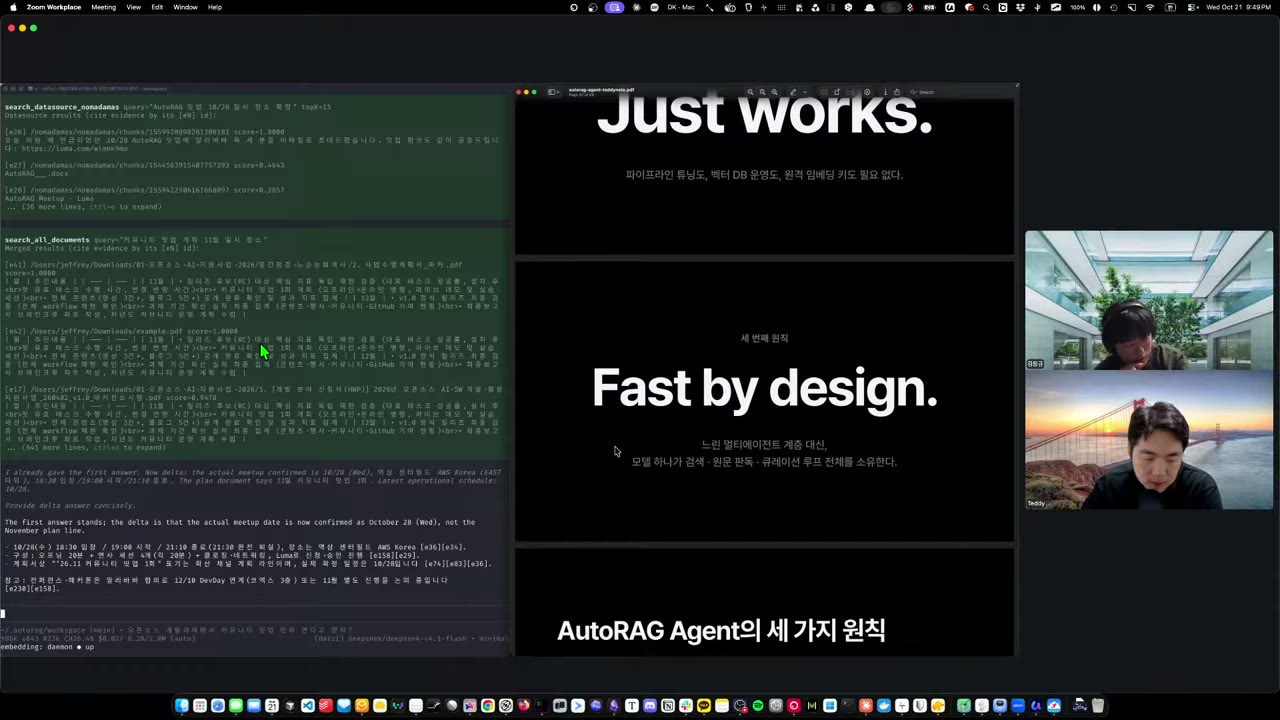
두 번째 원칙 — Just works. 파이프라인 튜닝도, 벡터 DB 운영도, 원격 임베딩 키도 필요 없다. 세 번째 원칙 — Fast by design. 느린 멀티에이전트 계층 대신, 모델 하나가 검색·원문 판독·큐레이션 루프 전체를 소유한다.
두 번째 규칙은 “답이 빨리 나와야 한다”였다. 회의 중 Hermes에게 파일을 찾아 달라고 했더니 1분이 지나도 안 나오고, 중간에 Python 코드를 짜다가 10분 넘게 지나서야 “찾았습니다” 하던 경험이 계기였다. 그래서 30초, 욕심내면 10초 안에 일단 **빠른 답(fast answer)**을 내고, 에이전트답게 더 찾아 최종 답을 내도록 하네스를 설계했다. 김동규는 이것이 다른 에이전트에 없는 AutoRAG만의 특징이라고 본다. 화면 왼쪽 터미널에도 “I already gave the first answer. Now delta: …”라는 검증 단계 출력이 보인다.
테디의 질문은 이랬다. 코드는 함수·변수 체계와 LSP가 있는 반정형 데이터라 파일 기반 검색이 통하지만, 수백 쪽짜리 PDF 수십 개가 다운로드 폴더에 있으면 어떻게 빨리 찾나? 답은 인덱싱에는 오히려 벡터 검색이 필요하다는 것이었다. 시맨틱+BM25 하이브리드 검색으로 시작해, 정답이 아니어도 비슷한 것이 히트하면 그 파일과 그 파일이 속한 폴더에서부터 탐색을 시작하게 했다. 테디는 회사에서 전사 검색을 만들며 같은 결론(파일 기반 검색만으로는 답이 없으니 벡터 DB와 섞는다)에 도달했다고 맞장구쳤다.
소스마다 인덱스 형태는 다르다. AutoRAG Agent는 하나의 소프트웨어가 아니라 여러 오픈소스의 조합이고, 김동규가 한 일은 “기존 것들의 빠진 나사”를 채우는 것이었다. WhatsApp·Telegram·Discord 검색은 OpenClaw를 만든 Peter Steinberger의 *crawl 계열 도구를 쓰는데, 한국어 BM25가 안 되거나 시맨틱 검색이 없거나 SQL LIKE로만 찾는 것도 있었다. 그래서 모든 소스에 증분 인덱싱 · 한국어가 되는 BM25 · 시맨틱 임베딩 세 가지를 갖추게 만들었다. 라이선스는 Apache-2.0이다.
[59:40] 9. 녹화 데모 — 전용 하네스 vs MCP vs 맨 하네스
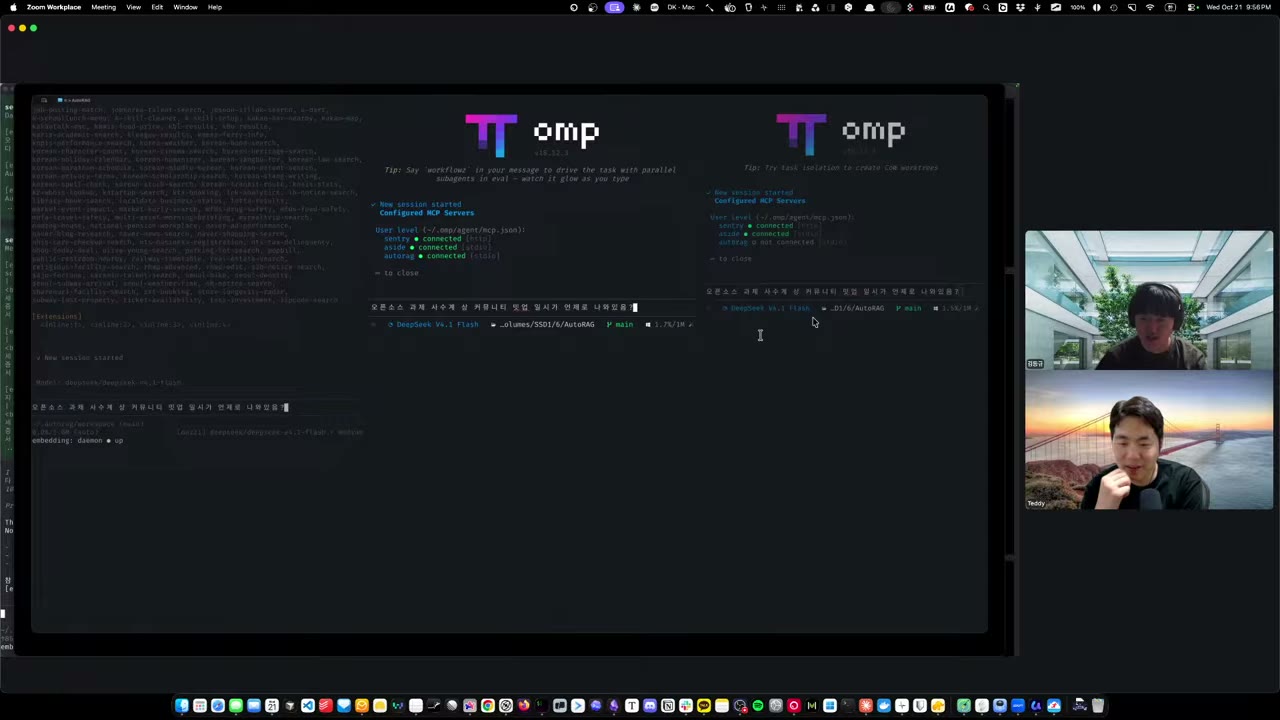
세 창에 같은 질문(“오픈소스 과제 사업계획서상 커뮤니티 밋업 일시가 언제로 나와 있음?”)을 던지고, 모델은 모두 DeepSeek V4.1 Flash(약 260 TPS)로 맞췄다. 왼쪽은 AutoRAG Agent CLI, 가운데는 AutoRAG MCP 서버를 붙인 oh-my-pi(omp, Claude Code·Codex 같은 하네스), 오른쪽은 아무것도 안 붙인 omp다. 1배속 영상인데 AutoRAG Agent가 약 10초 만에 먼저 끝났고, MCP 쪽은 조금 헤매다가 그다음, 맨 하네스가 가장 오래 걸렸다.
차이는 하네스에서 나온다. MCP는 도구를 쥐여 줄 뿐 “이걸 어떻게 써라”는 구체적 지시를 담을 수 없고, 모델이 원하지 않으면 안 쓸 수도 있다. 그래도 시맨틱 검색으로 파일을 먼저 특정할 수 있어 맨 하네스보다는 빨랐다. 260 TPS라 1분 안에 끝났지 30~40 TPS 모델이었다면 일곱 배쯤 느렸을 거라고 했다. 김동규는 이런 간단한 작업에서 DeepSeek V4 Flash를 유용하게 쓰고 있다고 했다. MCP 서버를 쓰면 Claude Code·Codex 등 각자 쓰는 에이전트에 이 검색 기능을 붙일 수 있다.
[01:04:40] 10. 엔진을 이루는 오픈소스들
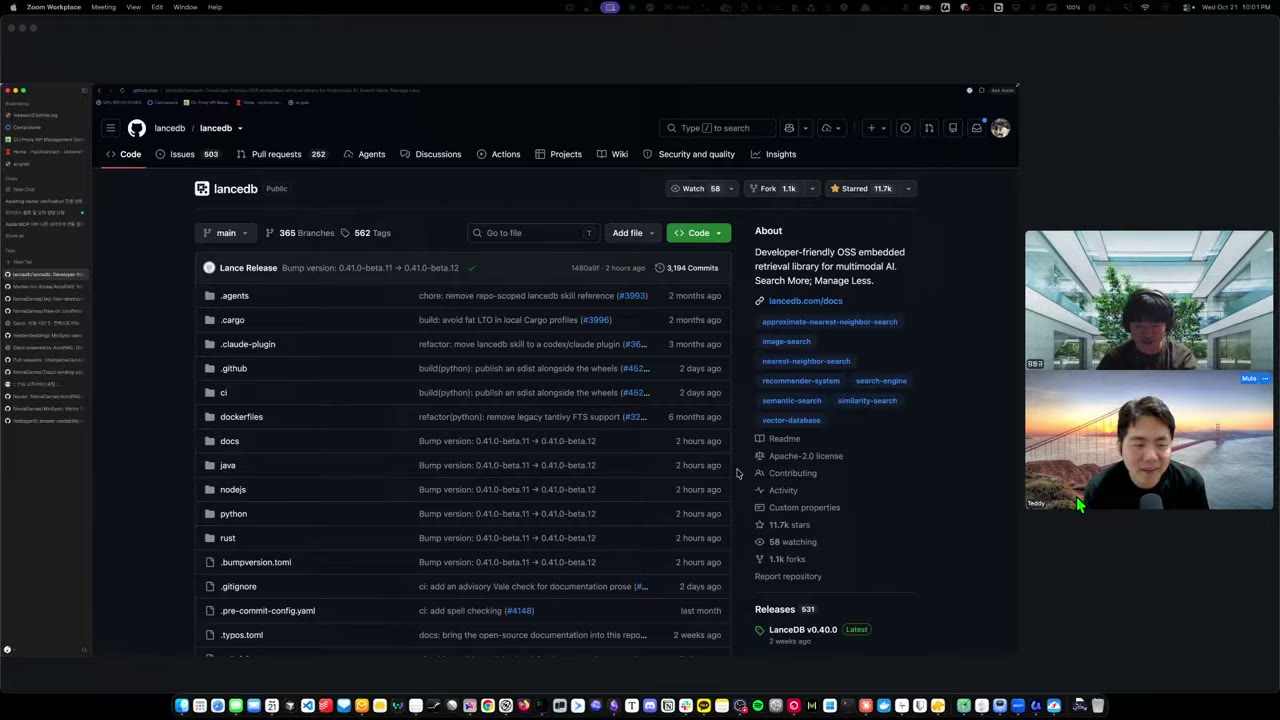
로컬 파일용 벡터 DB는 LanceDB다. Rust라 빠르고 멀티모달을 지원하며, 바이너리로 바로 넣을 수 있다. Postgres처럼 설치가 까다로우면 개인용 “딸각 설치”가 불가능하다는 판단이었다. 직접 DB를 만들 생각은 없냐는 질문에는 “이보다 잘 만들 자신이 없다”고 답했다. 소스별 DB는 조금씩 다르다.
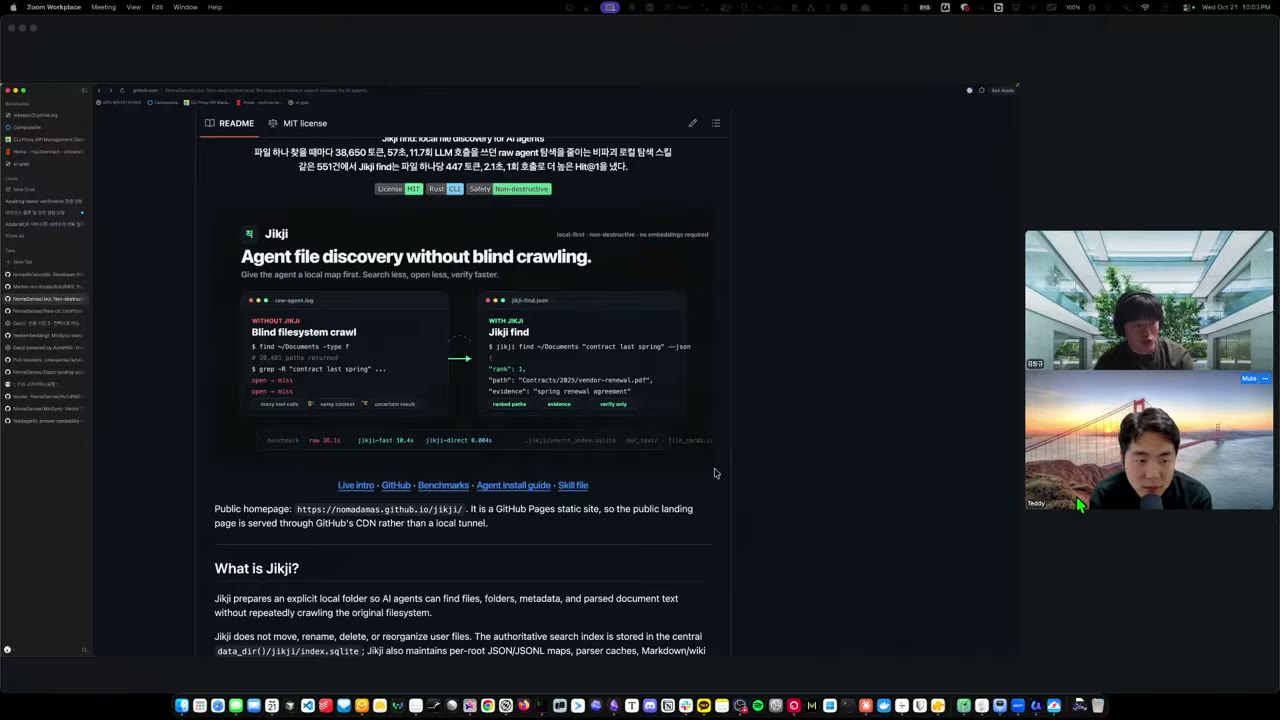
Jikji(직지, 김동규가 알기로는 직지심체요절에서 딴 이름)는 마커 대표가 직접 만든 파일 맵이다. 에이전트가 파일을 탐색하기 전에 폴더·파일 요약이 담긴 목차를 미리 그려 둬서 일일이 열지 않고 바로 찾아가게 한다. README 상단 문구는 “파일 하나 찾을 때마다 38,650 토큰, 57초, 11.7회 LLM 호출을 쓰던 raw agent 탐색을 줄이는 비파괴 로컬 탐색 스킬. 같은 551건에서 Jikji find는 파일 하나당 447 토큰, 2.1초, 1회 호출로 더 높은 Hit@1을 냈다”이다(MIT, Rust CLI). Hermes가 너무 느려서 만들기 시작했지만 Hermes 하네스에 붙여도 여전히 빠르지 않았고, AutoRAG Agent에 붙였을 때 시너지가 났다고 했다.
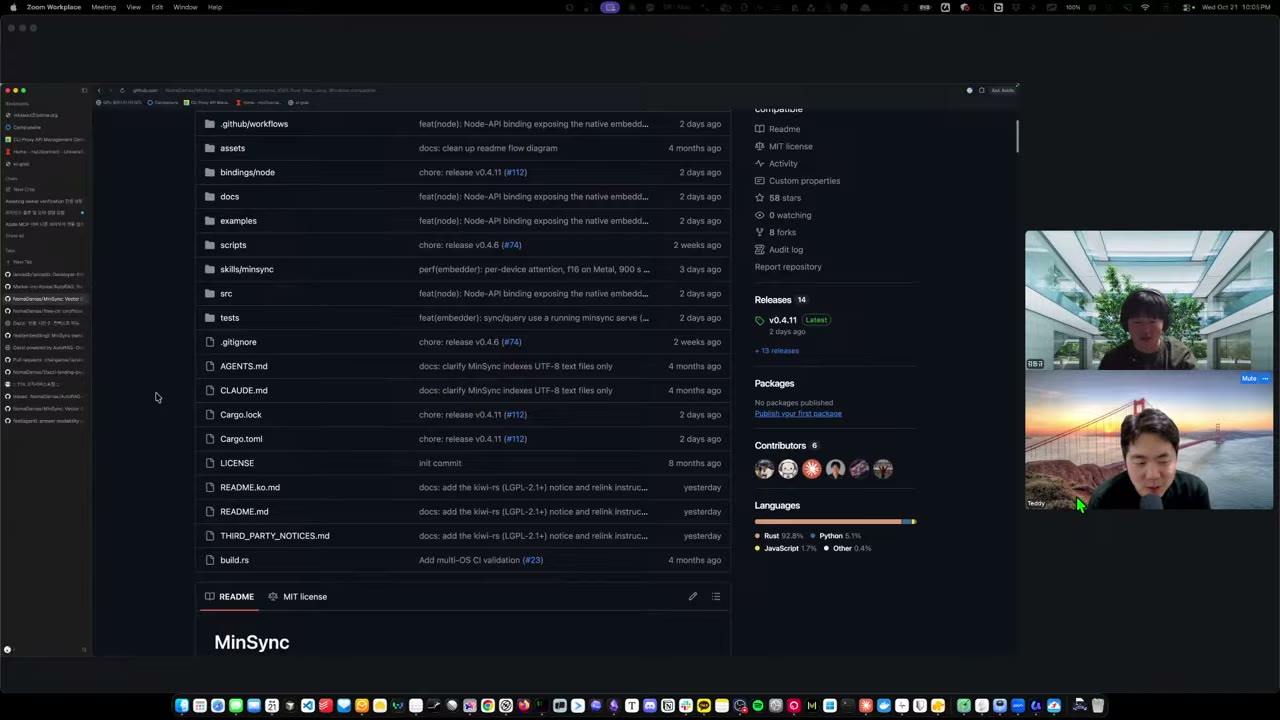
MinSync는 AutoRAG Agent의 핵심 라이브러리다(“Vector DB version control, 100% Rust, Mac, Linux, Windows compatible”). 로컬 파일 증분 인덱싱(바뀐 것만 다시 임베딩)과 시맨틱·렉시컬 검색을 맡고, 증분 인덱싱 코어를 Rust로 만들어 크로스 OS 버그를 많이 잡았다. README 기준 로컬 Qwen3-Embedding-0.6B(1024차원)로 임베딩하고, BM25는 Kiwi 형태소 분석으로 한국어를 처리한다.
mailcrawl은 이메일 RAG다. Hermes Agent의 메일 클라이언트로 쓰이는 CLI 메일 관리 오픈소스 himalaya로 메일을 받아 오고, 그 위에 증분 인덱싱·시맨틱/렉시컬 검색·한국어 BM25를 얹었다. 이름은 Peter Steinberger의 *crawl 시리즈(slacrawl·discrawl 등)에 대한 헌정이다.
[01:12:30] 11. Dazzi — 진짜 AI 파일 탐색기
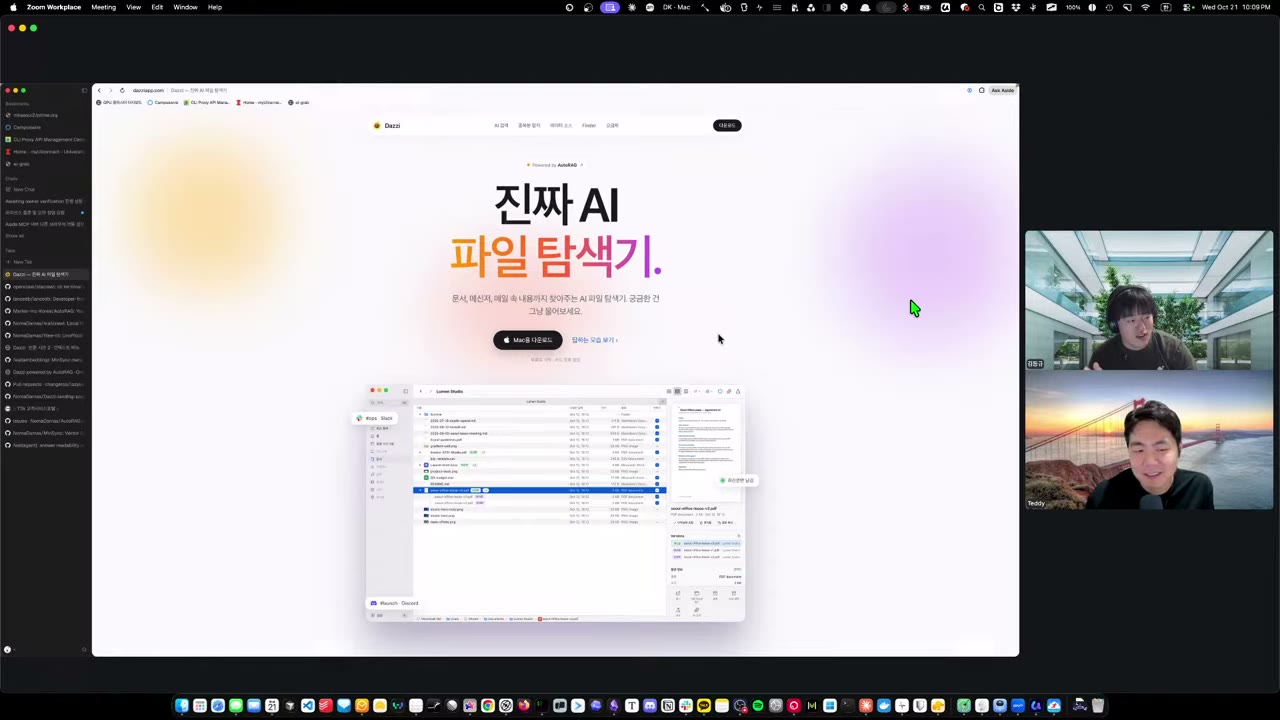
진짜 AI 파일 탐색기. 문서, 메신저, 메일 속 내용까지 찾아주는 AI 파일 탐색기. 궁금한 건 그냥 물어보세요. (Powered by AutoRAG)
TUI는 비개발자가 열지 않을 거라는 생각에서 출발했다. 처음엔 Codex 앱 같은 채팅 앱을 고민하다가, 아예 맥 Finder를 대체하는 AI 파일 탐색기를 만들기로 했다. 이름 Dazzi는 김동규가 좋아하는 뉴진스 다니엘에게서 따왔다. Electron이라 Windows도 되지만 아직 QA 중이고(테디: “Windows 없으면 민심 절반을 잃는다”), 개발용 빌드는 지금 내려받을 수 있다. Ubuntu도 다듬으면 될 것이라고 했다.
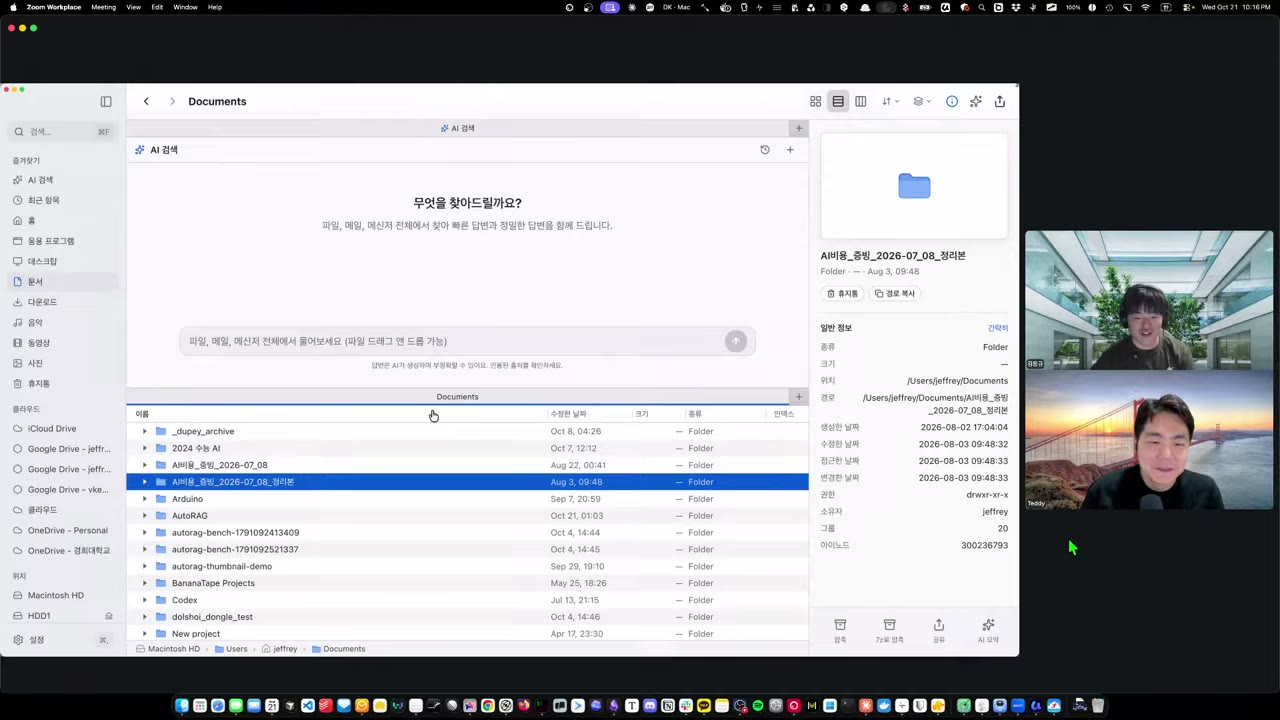
Finder에서 가장 불편했던 것이 탭이라 탭과 분할 창부터 만들었다. 탭을 가장자리로 끌면 분할되고, 폴더와 대화를 나란히 둘 수 있다. AI 검색 패널은 “파일, 메일, 메신저 전체에서 찾아 빠른 답변과 정밀한 답변을 함께 드립니다”라고 안내한다. 이후 데모에서 보여 준 기능은 다음과 같다.
- 최신본 판별:
최종본,최최종본,파일 (1)처럼 흩어진 같은 문서를 한 행으로 묶고 최신본 / 유사본 / 동일본 태그를 단다. - 빠른 파일명 검색: Finder에서 한참 걸리고 한글은 사실상 포기해야 했던 파일명 검색이 바로 나온다. Windows의 Everything을 참고했다(README: macOS는 fsearch-cli, Windows는 Everything 번들). 경로로 바로 이동하는 기능도 넣었다(Finder의 ⌘⇧G에 해당).
- 스페이스바 미리보기: Quick Look처럼 바로 본다. README 기준 HWP/HWPX도 한컴오피스 없이 rhwp로 렌더링한다.
- 파일 작업: 이미지 편집(HEIC→PNG 변환, 픽셀 줄이기), 압축, AI 요약.
- 준비 중: 폴더 정리(2주 안), 경로 AI 자동완성 탭, “이 폴더에 파일이 추가되면 이 액션을 하라”는 루틴(PR 진행 중, AutoRAG Agent에 먼저 탑재).
테디는 아이디어를 보탰다. 검색 히트가 계속 0인 파일을 소프트 삭제(아카이브)했다가 정리해 주는 기능, 근거 가상 폴더를 즐겨찾기처럼 고정하는 기능, 앱 안에 의견 남기기 칸을 두고 GitHub Discussions로 자동 전송하는 기능이다. 김동규는 이 형태까지 3주가 걸렸고(골격은 2주), 사람이 손으로 코딩했다면 1년이 넘었을 것이고 아예 도전하지도 않았을 거라고 했다. 파일 탐색기 부분은 기존 소스 없이 처음부터 만들었다.
[01:24:40] 12. dupey — 문서 가족 판별
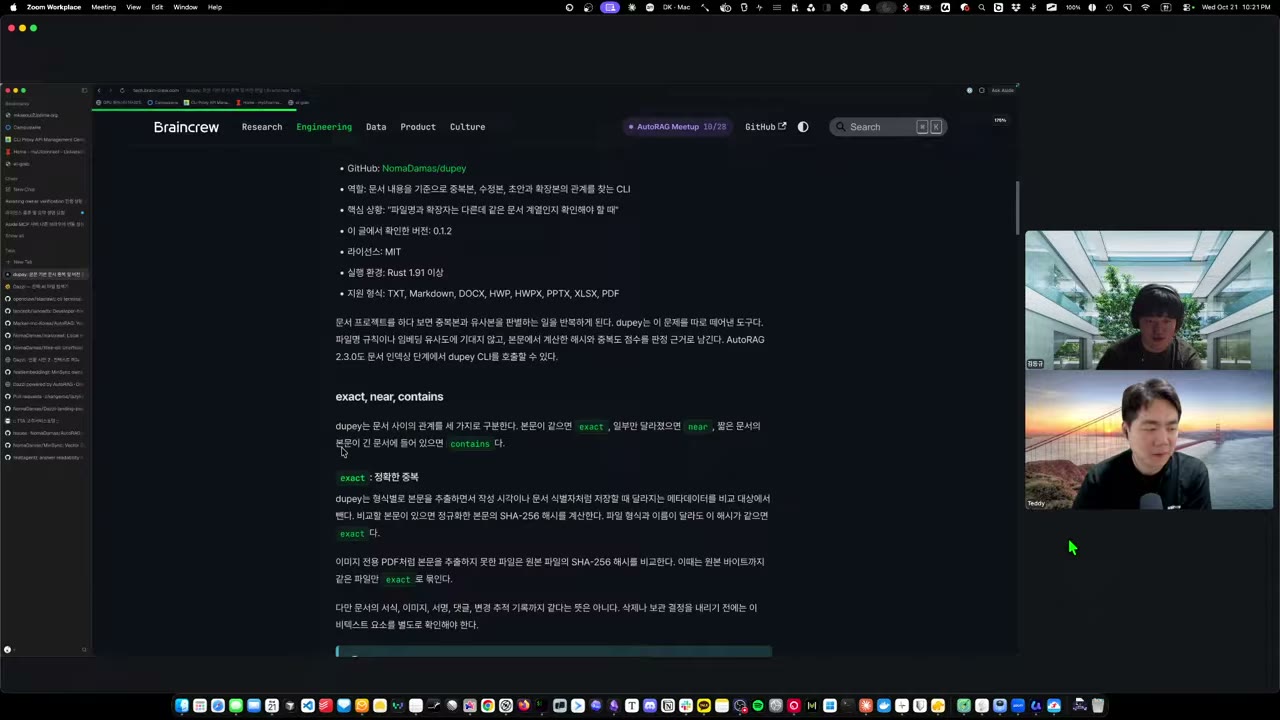
최신본 묶기는 따로 오픈소스로 떼어 둔 dupey(NomaDamas/dupey)가 맡는다. 브레인크루 블로그에 따르면 문서 내용을 기준으로 중복본·수정본·초안과 확장본의 관계를 찾는 CLI다(MIT, Rust 1.91+, TXT·Markdown·DOCX·HWP·HWPX·PPTX·XLSX·PDF 지원). 관계는 세 가지로 구분한다.
exact: 정규화한 본문의 SHA-256이 같다. 파일 형식과 이름이 달라도 된다. 본문을 추출하지 못한 이미지 PDF는 원본 바이트 해시를 비교한다.near: 일부만 다르다.contains: 짧은 문서의 본문이 긴 문서에 들어 있다.
AutoRAG Agent에서 “중복본 정리해 줘”라고 해도 같은 알고리즘을 쓴다. 시청자는 이 기능이 있으면 Beyond Compare를 버릴 수 있겠다는 반응을 남겼다.
[01:29:50] 13. Dazzi AI 검색 — 빠른 답과 검증 델타
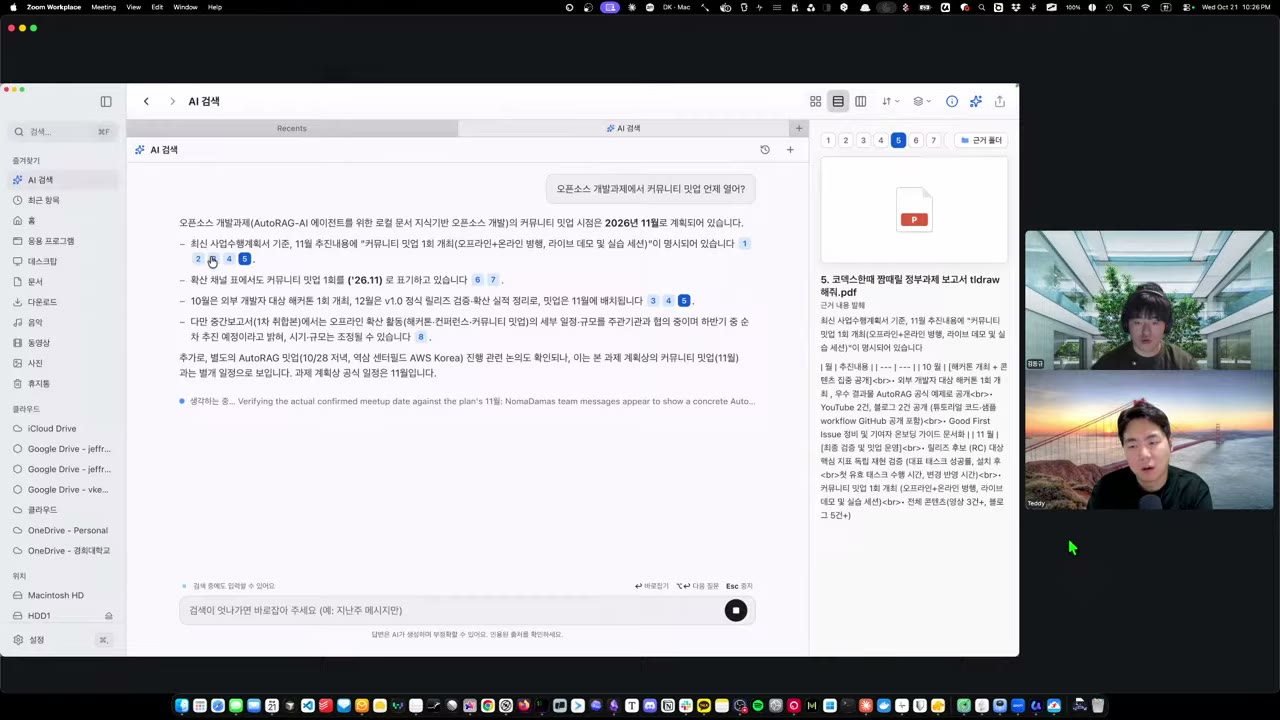
같은 질문을 Dazzi에 던지자 먼저 빠른 답이 나왔다. 사업수행계획서 기준으로 커뮤니티 밋업은 2026년 11월에 계획돼 있다는 답이다. 오른쪽에는 번호 달린 근거 카드가 붙고, 근거로 쓴 파일들을 임시 가상 폴더(“근거 폴더”)로 모아 보여 준다. 가상 폴더에서도 스페이스바 미리보기와 복사·이동이 된다. 아래에는 “생각하는 중… Verifying the actual confirmed meetup date against the plan’s 11월”이 돌고, 입력창에는 “검색이 엇나가면 바로잡아 주세요” 안내가 있다. README는 이를 진행 중인 검색에 정정을 끼워 넣는 steering 기능으로 설명한다.
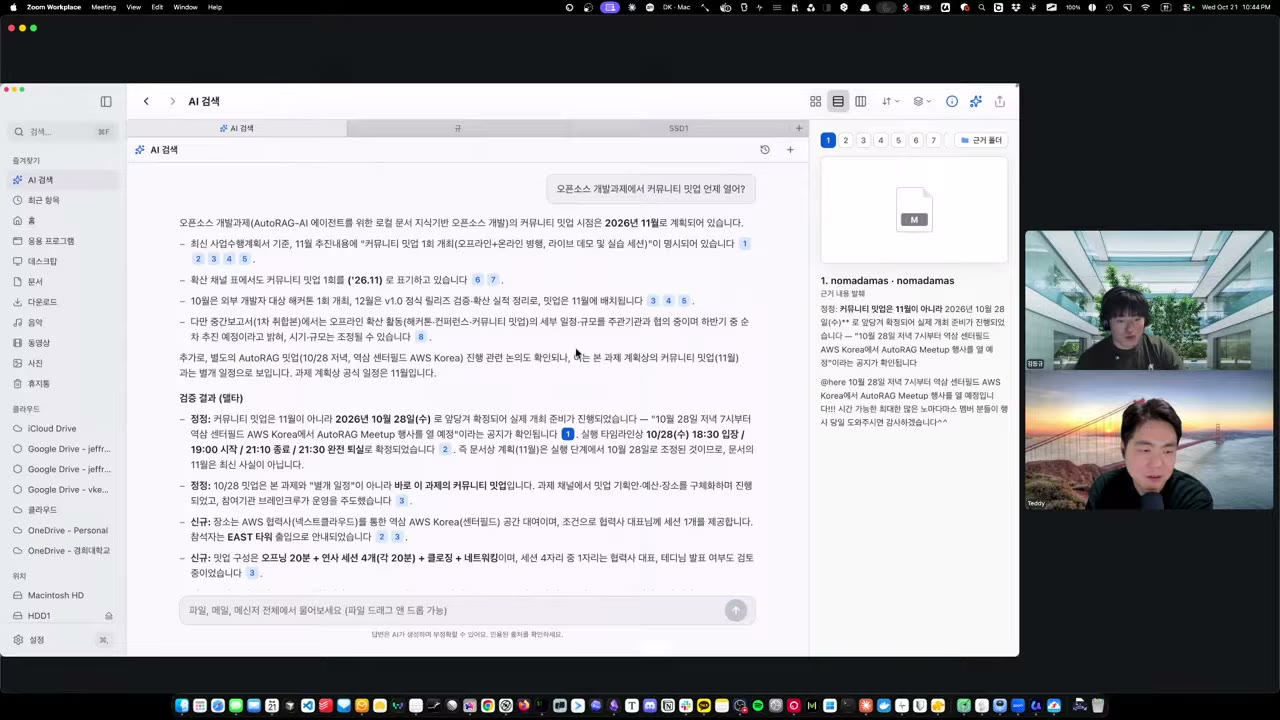
검증 단계가 끝나자 **검증 결과(델타)**가 붙었다. “정정: 커뮤니티 밋업은 11월이 아니라 2026년 10월 28일(수)로 앞당겨 확정되었습니다”라는 내용으로, 근거는 NomaDamas 팀 메신저 공지(“10월 28일 저녁 7시부터 역삼 센터필드 AWS Korea에서 AutoRAG Meetup”)다. 문서상 계획(11월)과 실제 운영 일정이 다를 때 빠른 답만으로는 틀리고, 원문 대조로 최신 사실을 찾아낸다는 앞의 “최신본 판별·재탐색” 루프가 그대로 시연된 셈이다.
수익 모델도 소개했다. Jev·리랭커·임베딩 모델을 일일이 연결하기 번거로운 사람을 위해 호스팅 구독 Dazzi Models를 마련했다. 자기 provider 키를 넣어도 된다. 테디는 Maccy처럼 “가격은 원하는 만큼” 후원 방식도 참고해 보라고 권했고, 원타임 결제라면 앱스토어에서 사겠다고 했다. AI 앱은 사용자가 앱 값과 별도로 토큰 값을 내야 하는 부담이 있어서 구독으로 묶었다는 것이 김동규의 설명이다.
[01:48:35] 14. 설계 슬라이드 — Pi 위에 올라탄다는 것, 그리고 질문 하나가 지나가는 길
이 구간에서는 대화가 이어지는 동안 발표 덱의 나머지 슬라이드가 설명 없이 스크롤됐다. 아래 내용은 슬라이드와 README의 내용이다.
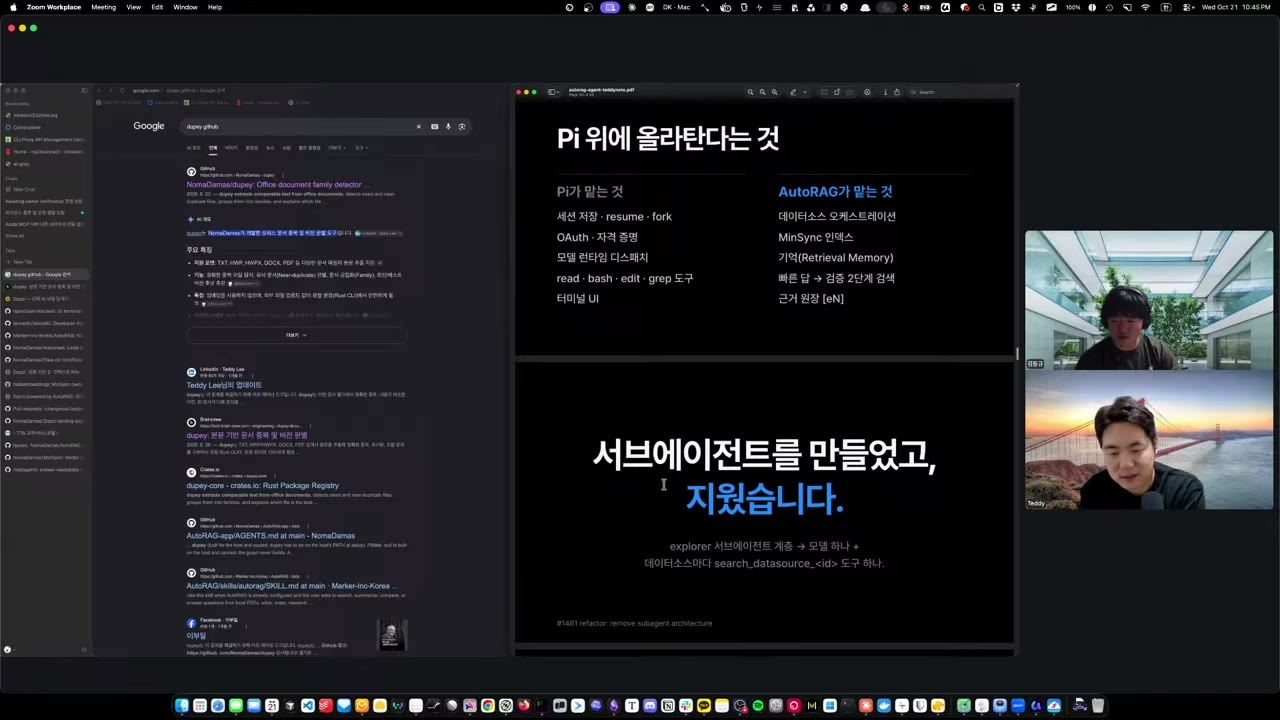
| Pi가 맡는 것 | AutoRAG가 맡는 것 |
|---|---|
| 세션 저장 · resume · fork | 데이터소스 오케스트레이션 |
| OAuth · 자격 증명 | MinSync 인덱스 |
| 모델 런타임 디스패치 | 기억(Retrieval Memory) |
| read · bash · edit · grep 도구 | 빠른 답 → 검증 2단계 검색 |
| 터미널 UI | 근거 원장 [eN] |
AutoRAG Agent는 Pi 에이전트 프레임워크(@earendil-works/pi-coding-agent)를 런타임 호스트로 쓰고, 자기 도메인 도구와 오케스트레이션만 얹는다. 다음 슬라이드는 **“서브에이전트를 만들었고, 지웠습니다.”**다. explorer 서브에이전트 계층을 걷어 내고 모델 하나와 데이터소스마다 search_datasource_<id> 도구 하나로 바꿨다(#1461 refactor: remove subagent architecture). 세 번째 원칙 “Fast by design”의 실제 근거다.
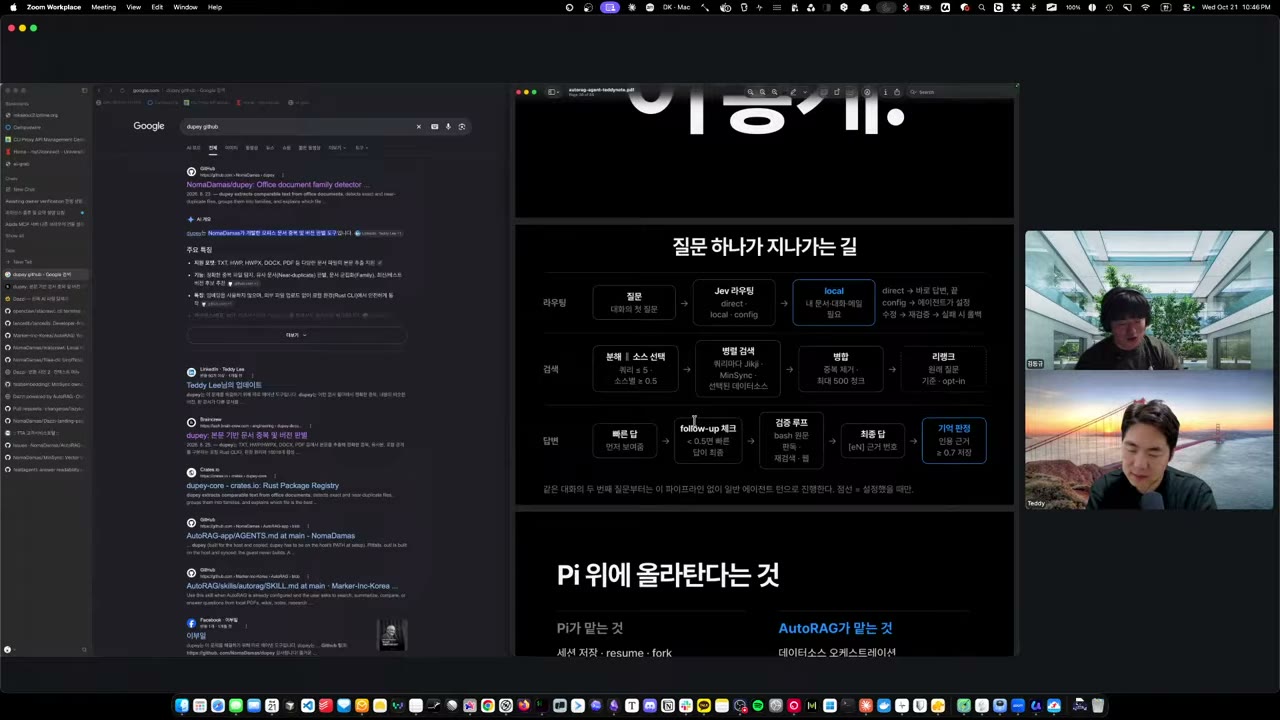
| 단계 | 흐름 |
|---|---|
| 라우팅 | 질문(대화의 첫 질문) → Jev 라우팅(direct · local · config) → local(내 문서·대화·메일 필요). direct는 바로 답변하고 끝, config는 에이전트가 설정 수정 → 재검증 → 실패 시 롤백 |
| 검색 | 분해 ‖ 소스 선택(쿼리 ≤ 5, 소스별 ≥ 0.5) → 병렬 검색(쿼리마다 Jikji · MinSync · 선택된 데이터소스) → 병합(중복 제거, 최대 500청크) → 리랭크(원래 질문 기준, opt-in) |
| 답변 | 빠른 답(먼저 보여 줌) → follow-up 체크(< 0.5면 빠른 답이 최종) → 검증 루프(bash 원문 판독 · 재검색 · 웹) → 최종 답([eN] 근거 번호) → 기억 판정(인용 근거 ≥ 0.7 저장) |
같은 대화의 두 번째 질문부터는 이 파이프라인 없이 일반 에이전트 턴으로 진행한다(점선은 설정했을 때만 동작).
[01:49:30] 마무리 — 어디서든 같은 사서
AutoRAG Agent는 MCP·CLI·TUI·Dazzi 앱으로 쓸 수 있고 Telegram·Discord 연동으로 휴대폰에서도 질문할 수 있다. 엔진이 TypeScript라 크로스 OS도 어렵지 않다고 했다. Dazzi의 기능은 AutoRAG Agent에도 그대로 들어간다. 테디는 “코딩 어시스턴트에서 파일 검색을 정복하고 싶은 AutoRAG”라고 정리했고, 2년 전 RAG 성능을 쥐어짜던 ‘너드’에서 사람들이 원하는 것을 제품으로 만드는 메이커로 달라졌다고 평했다. 다음 주 밋업 뒤에는 해커톤도 예고됐다. 김동규는 Windows 버전을 들고 다시 오겠다고 했다.
부록 — 실전 체크리스트
- 개인 문서 검색 하네스를 설계한다면: 데이터를 중앙 벡터 DB로 옮기지 말고, 소스별 인덱스(증분 인덱싱 + 한국어 BM25 + 시맨틱)를 갖춘 뒤 에이전트에게 소스별 검색 도구를 준다.
- 에이전트 응답 지연이 문제라면: 빠른 답을 먼저 내고 검증 루프를 뒤에 붙여 델타로 정정하는 2단계 구조를 검토한다. 사용자는 기다리지 않고, 정확도는 검증이 책임진다.
- 벡터 검색과 파일 탐색을 섞는다: 하이브리드 검색 히트를 탐색 시작점(파일·상위 폴더)으로 쓰면 전수 탐색보다 빠르다. Jikji 같은 파일 맵(목차)도 탐색 비용을 크게 줄인다.
- MCP만으로는 한계가 있다: 도구를 노출하는 것과 “언제·어떻게 쓰라”는 하네스 설계는 다르다. 같은 모델에서도 전용 하네스 > MCP > 맨 하네스 순으로 빨랐다.
- 분류형 판단은 작은 모델에: 라우팅·근거 판정처럼 100% 정확하지 않아도 되는 판단은 jev 같은 분류 모델로 토큰과 지연을 줄인다.
- 써 보기:
npm install -g @autorag/librarian(Node ≥ 24 또는 Bun) →autorag tui. 기존 코딩 에이전트에는 AutoRAG MCP 서버를 붙인다. GUI는 dazziapp.com(현재 macOS).
관련 노트
- jev — AutoRAG Agent의 라우팅·기억 판정에 쓰는 분류형 판단 모델
- hermes-agent — “찾을 때 너무 느리다”는 비교 대상, himalaya를 메일 클라이언트로 탑재
- openclaw — Peter Steinberger의
*crawl계열 메신저 검색 도구 출처 - deepseek-v4 — 데모에 쓴 DeepSeek V4.1 Flash
- 2026-03-26-k-skill — 김동규의 또 다른 오픈소스 K-skill
- 2026-08-02-herdr-agent-multiplexer · 2026-07-12-cliproxyapi-gpt-in-claude-code — 여담에 나온 개발 환경 도구
- 2026-07-11-braincrew-teddynote-hiring-live-2026 — 같은 채널의 브레인크루 라이브
- moc-ai-agents-harness
원문 인용 모음
- [21:30] “에이전트는 한 번에 검색하지 않는다. 이게 너무 좋은 문구네요. 요것 때문에 저는 Claude Code가 있을 수 있었다라고 생각이 드는 게”
- [24:30] “RAG는 죽었는가는 RAG 나오고 나서 계속 있었던 질문이었던 거 같아. … Claude Code도 어떻게 보면은 RAG의 일환이잖아요.”
- [25:00] “저는 모든 기술이 죽었다, 절대 안 쓰인다라는 말을 되게 안 좋아해요. 왜냐면은 기술이라는 거는 적재적소의 상황에 알맞게 골라다가 써야 하는 거잖아요.”
- [32:30] “RAG에 보통 접근이 왜 그랬냐라고 하면은 저는 에이전트가 없었기 때문이라고 보거든요. 왜냐면 한 번만 검색해야 되니까.”
- [33:00] “데이터를 검색을 하기 위해서 옮기지 않겠다.”
- [51:00] “30초 이내, 좀 더 욕심을 냈던 10초 이내에 이런 식으로 일단 정답을 내라. … 빨리 fast answer를 내고 그다음에 이제 또 더 찾아서 final answer를 내는 식으로 하네스를 디자인을 했습니다.”
- [53:00] “그 부분에서 저는 오히려 벡터 서치가 필요하다라고 느꼈던 거든요.”
- [01:01:30] “MCP를 쓰면 사실 AutoRAG 에이전트에서 쓸 수 있는 도구를 쥐여 주는 것 정도니까, 이거를 어떻게 써야 할지에 대해서 구체적인 지시라든가 같은 거는 하네스를 만들 수가 없는 거죠.”
- [01:15:00] “AI 기능을 탑재하는 거에 Finder 거지 같은 걸 더 잘 만들겠다라는”
- [01:28:00] “사람이 손코딩한다 그러면 이걸 굳이 내가 왜 만들어요? … 도전조차 안 했을 거 같아.”
- [01:41:00] “하루에 8시간씩 잘 잡니다. 왜냐면은 잘 때 일하는 에이전트들이 많기 때문에.”