개요
@cc.dev_가 Threads에서 소개한 NVIDIA의 오픈소스 에이전트 하네스 연구 결과물 harness — SoL-Pi(NVlabs/SoL-Pi, “Scaling Auto-Research Loops for Efficient Agent Harnesses”)다. 장기 실행 코딩 에이전트에서 반복되는 토큰 낭비(읽은 로그 재독·수정/검증 분리 실행·완료 작업의 컨텍스트 잔류)를 하네스 차원에서 줄이는 것이 목표다. Pi(@earendil-works/pi-coding-agent 0.84.2) 위에 얹는 standalone 확장이며, 네 가지 메커니즘은 전부 opt-in(기본 비활성화)이다.
게시물 요지
- 문제 제기: 오래 도는 AI 코딩 에이전트는 이미 본 로그를 또 읽고, 수정과 테스트를 따로 실행하고, 끝난 작업까지 컨텍스트에 남겨 토큰을 계속 소모한다.
- NVIDIA가 이 낭비 자체를 줄이는 방향으로 Agent Harness를 연구했고 결과를 오픈소스로 공개했다 — SoL-Pi, https://github.com/NVlabs/SoL-Pi.
SoL-Pi 실체 확인 (GitHub)
- 저장소: NVlabs/SoL-Pi, MIT 라이선스, TypeScript. GitHub REST 조회 시점(2026-09-12) stars 1028·forks 76·open issues 14, 생성 2026-09-02, 최근 push 2026-09-11 — 게시 직후 빠르게 스타를 모으는 초기 프로젝트다.
- 캐치프레이즈: “Spend less without making the agent do less useful work.” 토큰 트래픽·추론 작업·에이전트 턴을 줄이되, 조기 종료·검증 생략·증거 은폐는 하지 않는 제약 효율(constrained efficiency)을 내세운다.
- 네 가지 메커니즘 (Pi 공개 확장 API로 합성, Pi 소스 벤더링 없음):
- Action Fusion (도구): edit/write가 후속 검증 명령을 같은 도구 호출에서 함께 실행.
- ObservationPack (관찰): 반복되는 대형 텍스트 결과를 안정 핸들로 바꾸고 정확한 페이징 회수로 대체.
- Evidence-Preserving Reducer (위임): 긴 진단 로그를 보관 원본과 인용이 정확히 일치할 때만 간결한 receipt로 축소. 실패 시 원본 결과 유지.
- Online Context Compact (컨텍스트): 완료된 플랜 단계를 Pi 네이티브 compaction 후보로 넘기고, 성공 시 새 턴에서 작업 계속.
- 설정:
sol-pi.json단일 유효 설정(프로젝트.pi/우선, 없으면 사용자~/.pi/agent/). 보수적 초기값은 추가 모델 호출이 없고 실행을 멈추지 않는 Action Fusion + ObservationPack만 켠다. - 보안 경계: ObservationPack·Reducer 아카이브는 세션 디렉터리 하위
sol-pi/<session-id>/에 로컬 보관되며 세션 종료 후 자동 삭제되지 않는다. Reducer는 설정된 모델로 진단 로그를 전송할 수 있어 원격 축소 전 SECURITY.md 검토가 필요하다 — 로컬 유지가 필요한 로그에는 켜지 말 것.
블로그 대조: auto-research 정량 결과 (2026-09-12)
원문 raw/articles/2026-09-12-nvlabs-sol-pi-blog.md (https://nvlabs.github.io/SoL-Pi/ , HTTP 200·259394 bytes HTML에서 텍스트 추출)에 적힌 auto-research 과정의 정량 결과는 다음과 같다. 평가는 전부 최고 reasoning-effort 설정(xhigh)에서 수행됐다.
- 파이프라인: 152개 제안 방향(proposal pool) → 독립 auto-research loop → 최종 하네스에 4개 메커니즘 생존. 탈락 148개의 아이디어 ID(C/P/T/D/R/M 계열)도 블로그에 공개돼 있다.
- 목표는 constrained efficiency: capability-preservation 기준을 사전 선언하고, (1) 모든 capability 지표가 허용오차 내 + (2) 효율 지표 최소 1개 개선의 2단계 게이트를 통과한 nondominated 후보만 유지한다. 조기 종료·검증 생략·증거 은폐로 아끼는 후보는 탈락한다.
- 종합 효율(EdgeBench, 51태스크 long-horizon executable suite, held-out 평가): 조립 하네스는 양쪽 모델 백엔드에서 Pi 평균 점수의 약 94%를 유지하고, GPT-5.6 Sol에서는 모델 네이티브 Codex 하네스를 상회한다. Pi 대비 토큰 45–49% 감소·비용 약 1/3 감소, 모델 네이티브 하네스 대비 토큰 35–64% 감소·비용(list-price API 기준) 50–54% 감소.
- 시간당 절감(전문 연구자가 1개 문제를 푸는 기준, 공식 API-equivalent 가격 환산): 네이티브 Codex·Claude Code 하네스 대비 시간당 4.36–5.71.
- Action Fusion: Oracle Analysis에서 cross-turn 전이 중 edit/write→command 인접 후보가 12.3%, 그 다음 액션의 85.1%가 Bash임을 확인하고 융합 대상으로 삼았다. Baseline Build에서 적격 호출 중 uptake 87.7%·invalid 0으로 안정화, 프롬프트 탐색 10배치 끝에 Iteration 10에서 trigger 100%·task score 87.0을 기록했다. 궤적 기반 반사실(실측 rerun 아님): 관측된 149개 cross-turn 후보가 전부 발동했다면 모델 턴 1,386→1,237(−10.8%), 총 토큰 32.38M→28.64M(−11.5%).
- ObservationPack: 8개 설정 sweep에서 V2(2,048바이트 head + 1,536바이트 tail + projection 전 2회 full send)만 quality gate를 통과해 선정됐다. EdgeBench paired A/B(11태스크 × 2개 arm, 동일 클러스터 동시 실행): provider bill −23.58%, 응답당 비용 −23.73%, 정규화 점수 +22.92%, 응답 수는 +0.20%로 사실상 유지 — 응답량을 줄인 게 아니라 응답 단가를 낮춘 것이다.
- Terminal-Bench 4 (63 CPU-only 태스크): Codex 18해결/286.45, SoL-Pi 15/15.13/14.07). GPU 의존 태스크는 NVIDIA 내부 평가 인프라가 장기 실행을 지원하지 않아 제외됐다.
- Swarm 실험(Anthropic 오리지널 performance take-home, 커널 최적화, 조건당 2시간 × 3조건, GPT-5.6 Sol 코디네이터 1 + Luna 워커 20): SoL-Pi 스웜 1,127 cycles/39.20, stock Pi 스웜 1,366 cycles/$82.12 — stock Pi 스웜 대비 cycles −17.5%·비용 −26.8%. 다만 조건당 1회 비무작위 trial이고 SoL-Pi trial 중 네트워크·인증 수리로 3회 일시정지(정지 시간은 2시간 예산에서 제외, 저하 구간은 포함)됐으며 대조군은 수리된 설정으로 시작했으므로 인과 효과 추정치로 읽을 수 없다. 표기된 8/8·7/8은 속도 임계치 통과 수이지 정답률이 아니다.
스크린샷 (블로그 figures, 2026-09-12 아카이브)
EdgeBench 평균 점수 — SoL-Pi가 Pi의 약 94%를 유지하고 GPT-5.6 Sol에서 네이티브 Codex를 상회한다는 주장의 근거 차트.
EdgeBench 공식 API-equivalent 비용 — Pi 대비 약 1/3 감소 주장의 근거 차트.
EdgeBench 총 토큰 — Pi 대비 45–49% 감소 주장의 근거 차트.
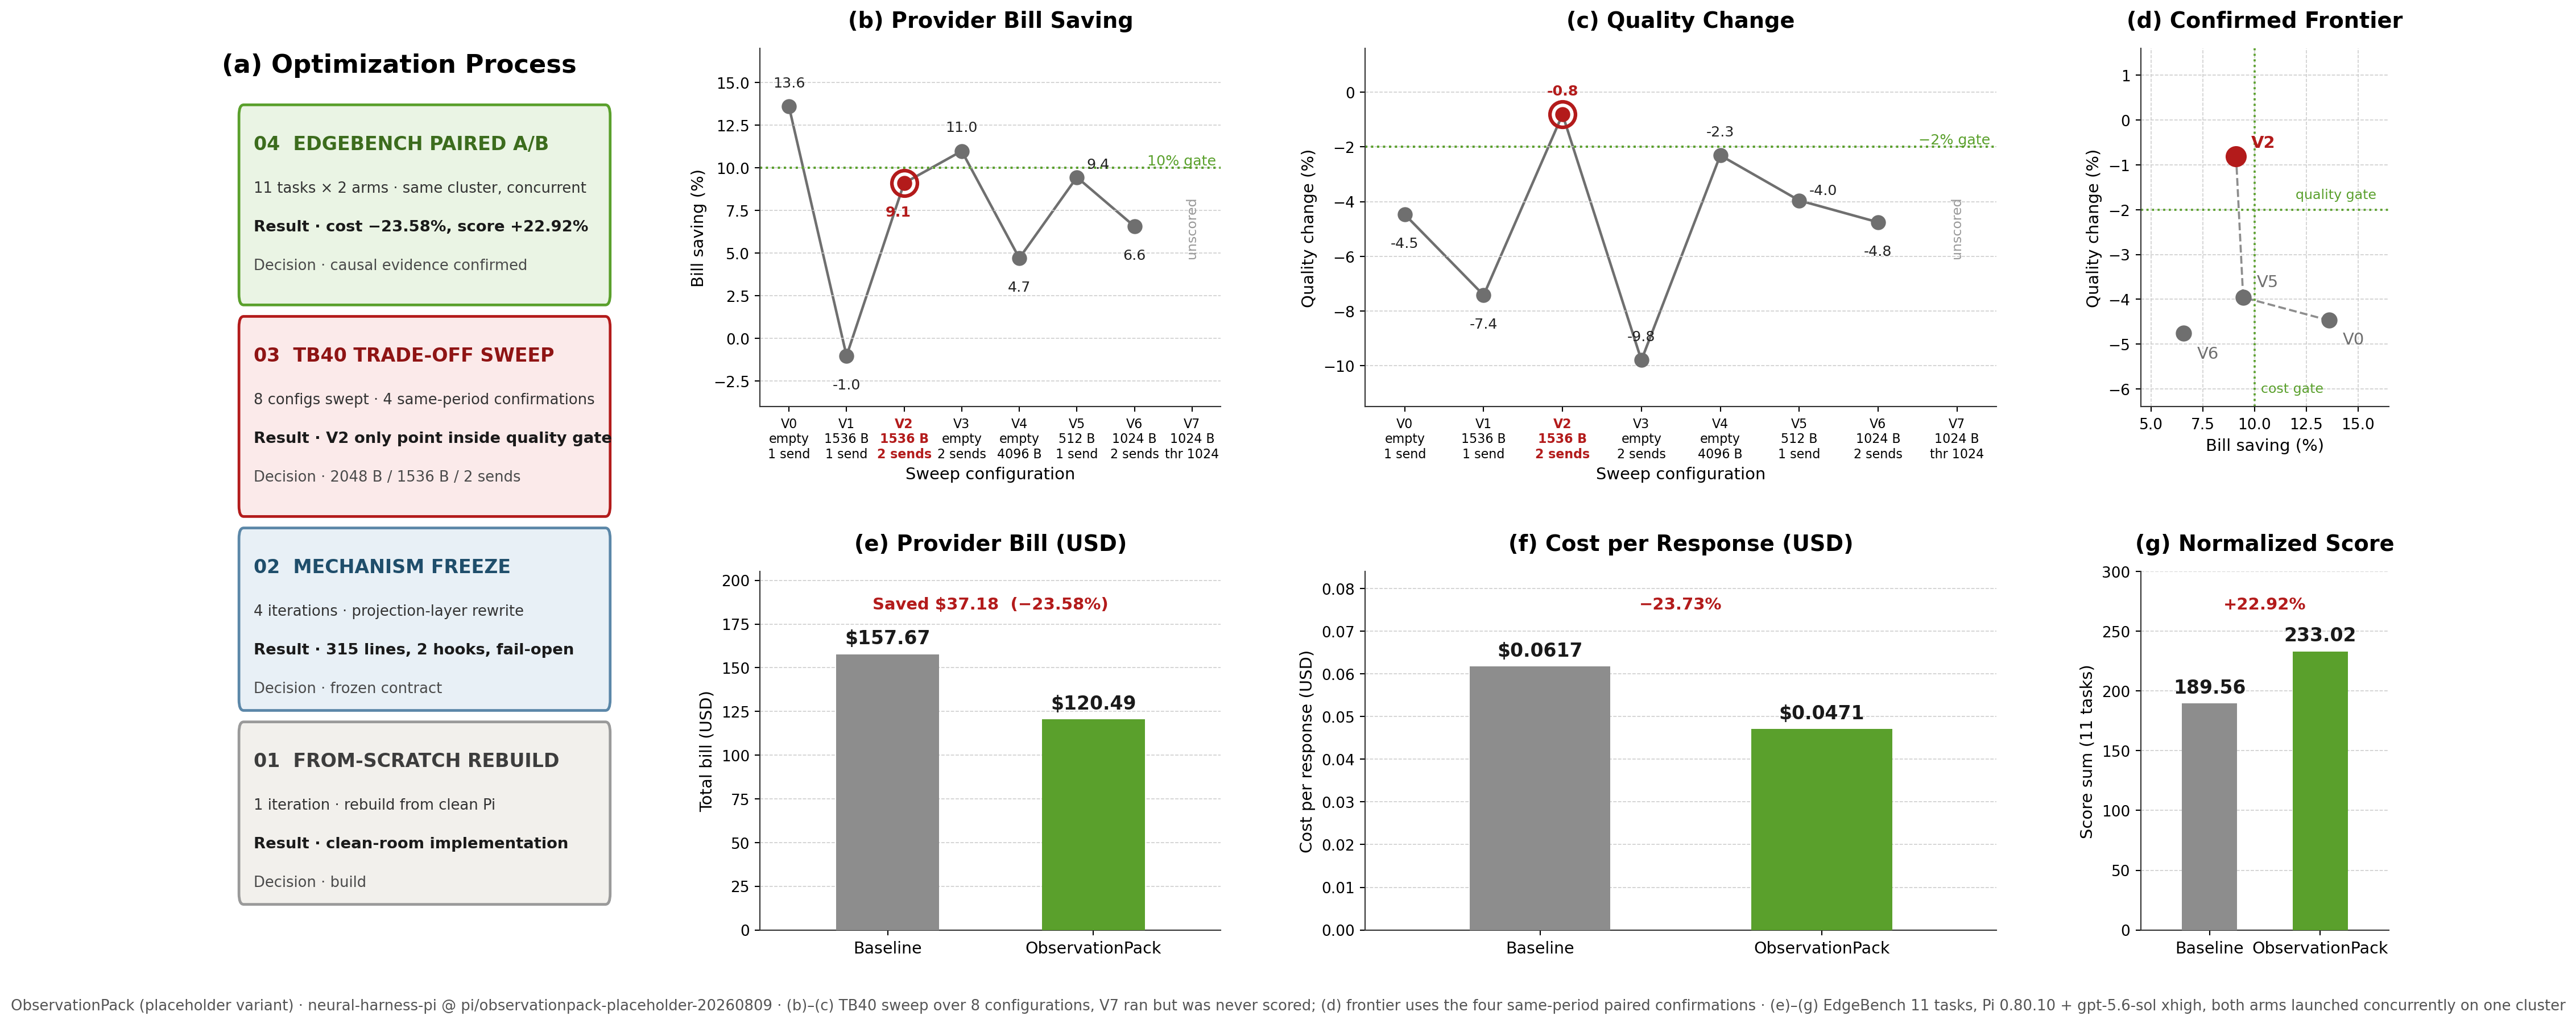
ObservationPack 연구 과정 개요 — clean-room 재구현 → 315줄·2훅 freeze → 8설정 sweep(V2만 gate 통과) → 11태스크 paired A/B 검증 흐름.
블로그 OG 히어로 이미지 — SoL-Pi 캐치프레이즈 “Spend less without getting less done.”
확인 범위와 한계
- Threads 본문은 8줄 소개글이 전부라 기술 근거는 GitHub README·설정 문서로 보완했고, auto-research 정량 결과는 위 블로그 대조 섹션으로 해소했다.
- 블로그에서 Evidence-Preserving Reducer·Online Context Compact의 개별 정량 수치(게이트 통과율·절감 기여도 등)는 별도 수치 섹션으로 발췌되지 않았다 — Action Fusion·ObservationPack처럼 4단계 탐색 기록이 figure로 공개된 항목 위주로 인용 수위를 유지한다.
- 스타·포크·push 시점은 조회 시점 값으로 변한다. 로컬 설치·
npm run check·Pi 연동 실행은 하지 않았다.
관련 위키
- harness — 에이전트 하네스 상위 개념
- moc-ai-agents-harness — 하네스·자가개선 MOC
- 2026-09-10-pi-agent-workbench — Pi 작업대 확장 6종 (SoL-Pi와 같은 Pi 확장 생태계)
- 2026-09-11-astra-token-saving-strategies — Astra 토큰 절약 6축 종합 (운용 주체 절약 vs 하네스 자체 효율의 대비)
검증
- Threads share URL을 2026-09-12에 직접 fetch해 og:description에서 본문 verbatim을 확보했다. 원문은
raw/articles/2026-09-12-threads-nvidia-sol-pi.md에 보존했고 SHA-256을 기록했다. - GitHub REST API와
main브랜치 README 전문(8555 bytes)을 같은 날 fetch해 메커니즘·설치·보안 경계를 대조했다. - 블로그(
https://nvlabs.github.io/SoL-Pi/)를 2026-09-12에 직접 fetch해(HTML 259394 bytes) auto-research 정량 결과를 대조했다. 원문 텍스트는raw/articles/2026-09-12-nvlabs-sol-pi-blog.md에 보존했고(SHA-256 기록), 정적 figure 5종(EdgeBench 3종·ObservationPack 연구 개요·OG 히어로)은summaries/assets/2026-09-12-threads-nvidia-sol-pi/에 아카이브해 본문에 임베드했다.