개요
에이전트 비용은 모델이 비싸서가 아니라 같은 난이도의 토큰을 반복해서 사기 때문에 생긴다는 주장을 129장 슬라이드로 풀어낸 패스트캠퍼스 세미나(2026년 8월)다. 1부는 비용이 새는 구조를, 2부는 작업 난이도별로 모델을 나눠 품질을 지키며 비용을 줄이는 방법을 다룬다. 결론은 한 줄이다. “비용은 모델을 바꿔서가 아니라 작업을 나눠서 줄어든다.”
발표 속 단가·절감 수치(예: $3,400 청구서, 69% 절감)는 발표자 환경의 예시값이다. 경향을 읽는 용도로만 쓰고, 실제 판단은 자체 Eval로 재현해야 한다.
1부 — 비용은 구조에서 나온다
에이전트는 LLM + 반복 루프 + 도구 + 메모리이고, 네 요소 모두 토큰을 더 쓰는 방향으로 작동한다. 원인은 세 갈래로 정리된다.
| 원인 | 내용 |
|---|---|
| 구조 | 루프가 호출을 곱한다. 한 요청이 수십 번의 LLM 호출로 전개된다(ReAct·Reflexion·ToT 모두 성능을 호출 횟수로 산다). |
| 누적 | 모델은 상태가 없어 이전 대화·도구 스키마·실행 로그를 매 턴 다시 입력으로 청구한다. 후반 턴일수록 한 호출이 비싸진다. |
| 품질 | 실패하면 누적 컨텍스트에 실패 기록까지 얹은 채 재시도한다. 실패 비용은 배수로 붙는다. |
20턴짜리 코딩 세션 한 건의 비용 구성 예시를 보면 입력이 대부분이다. 그래서 캐싱과 컨텍스트 관리가 첫 번째 레버가 된다.
| 항목 | 비중 | 대응 |
|---|---|---|
| 시스템 프롬프트·도구 스키마 | 14% | 매 턴 반복 → 캐싱 |
| 대화 이력 재전송 | 40% | 압축·세션 분리 |
| 도구 실행 결과(파일·로그) | 37% | 요약해서 넘기기 |
| 모델 출력(사고 + 코드) | 9% | 단가는 높지만 양은 적음 |
그 밖의 근거로는 다음이 제시된다.
- 추론 레벨: Prefill은 O(n²) 연산이라 비용을, Decode는 메모리 대역폭이라 속도를 결정한다. 긴 컨텍스트는 비용을 확실히 올리지만 품질은 보장하지 않는다(Lost in the Middle).
- 멀티에이전트: Anthropic은 자사 리서치 에이전트가 일반 채팅 대비 약 15배 토큰을 쓴다고 보고했다.
- 실패 패턴: MAST 분류를 현장에 옮기면 무한 루프, 컨텍스트 오염, 도구 오용(레포 전체 읽기), 환각 경로, 과잉 검증, 무의미한 승급(쉬운 작업까지 최상위 모델이 처리)이 반복된다. 마지막이 가장 흔한 낭비다.
- 싼 모델의 함정: 싼 모델을 잘못 배치하면 재시도 비용이 절감분보다 커진다. “아무 데나 싼 모델”은 답이 아니다.
2부 — 비용을 줄이는 세 개의 레버
| 레버 | 방법 | 적용 범위 |
|---|---|---|
| 1. 컨텍스트를 줄인다 | Prompt Caching, 컨텍스트 압축·요약, 세션 분리, Batch API, 도구 개수 정리 | 같은 모델 그대로 |
| 2. 모델을 나눈다 | 난이도 분류, 라우팅·캐스케이드, 서브에이전트 분리, 폴백 설계 | 세미나의 주제 |
| 3. 서빙을 최적화한다 | 양자화(GPTQ·AWQ)·증류, vLLM·PagedAttention, Speculative Decoding | 자체 호스팅 시 |
레버 1은 리스크가 가장 낮아 먼저 적용한다. 캐시 규칙은 “고정된 것은 앞으로, 변하는 것은 뒤로”다. 프롬프트 앞에 타임스탬프 하나만 있어도 그 지점부터 캐시가 무효화된다. 다만 대부분의 팀은 레버 1만 쓰다가 절반쯤에서 멈춘다.
라우팅·캐스케이드 연구
모델 간 출력 단가는 한 자릿수 배가 아니라 수백 배 차이가 난다(프론티어 최상위 75 대 로컬 0.1, 상대값). 연구들의 공통 전제는 “모든 요청이 같은 난이도가 아니다”이다.
| 연구 | 핵심 아이디어 | 판단 시점 | 보고된 효과 |
|---|---|---|---|
| FrugalGPT (2023) | 저가 모델부터 순차 시도, 신뢰도가 낮으면 승급 | 실행 후 검증 | 최대 98% 비용 절감 |
| Hybrid LLM (ICLR 2024) | 난이도 + 품질 저하 허용치로 사전 배정 | 실행 전 예측 | 품질 손실을 통제하며 절감 |
| RouteLLM (2024) | Chatbot Arena 선호 데이터로 라우터 학습 | 실행 전 예측 | GPT-4 성능 95% 유지, 85% 이상 절감(MT-Bench) |
| Mixture-of-Agents (2024) | 여러 오픈소스 모델 응답을 층층이 정제 | 다층 집계 | AlpacaEval 2.0에서 GPT-4o 상회(65.1% 대 57.5%) |
연구들이 공통으로 말하는 것은 비용이 “싼 모델”이 아니라 **“배정 기준”**에서 줄어든다는 점이다.
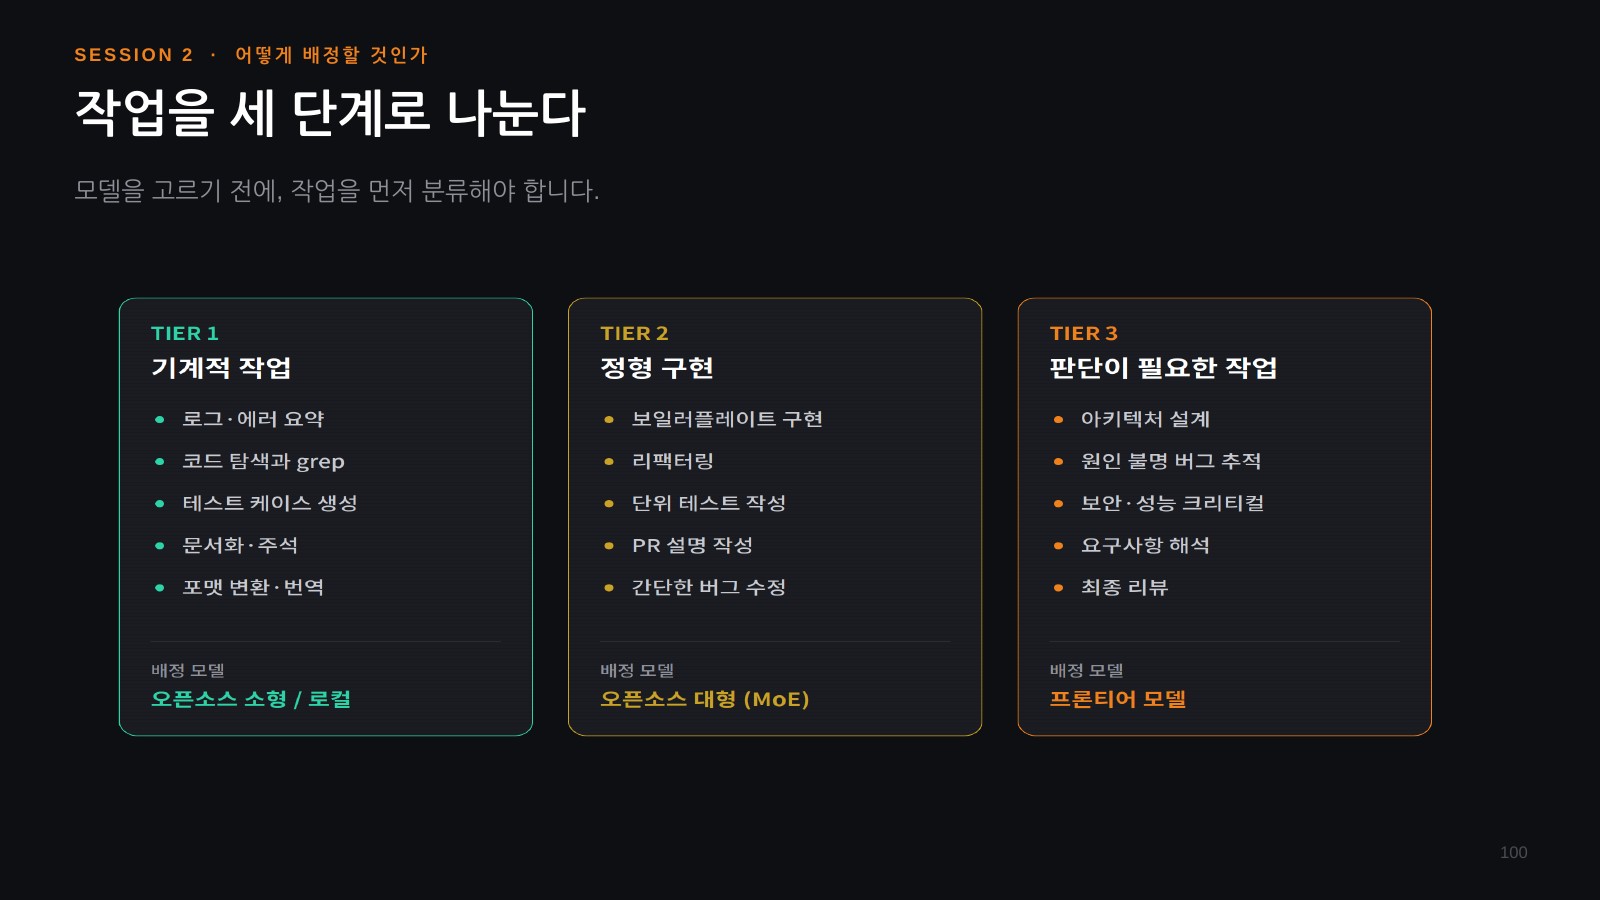
작업을 Tier로 나눠 배정한다
| Tier | 작업 예 | 배정 |
|---|---|---|
| 1 — 기계적 | 로그·에러 요약, 코드 탐색, 문서화, 포맷 변환·번역 | 오픈소스 소형/로컬 |
| 2 — 정형 구현 | 보일러플레이트, 리팩터링, 단위 테스트, 간단한 버그 수정 | 오픈소스 대형(MoE) |
| 3 — 판단 | 아키텍처 설계, 원인 불명 버그, 보안·성능 크리티컬, 최종 리뷰 | 프론티어 모델 |
“어렵다/쉽다”는 감이 아니라 판정 가능한 질문으로 나눈다.
- 정답이 하나로 정해지는가?
- 틀렸을 때 테스트가 자동으로 잡아내는가? 잡아낸다면 낮은 Tier로 내려도 안전하다.
- 되돌리기 비싼가? 마이그레이션·스키마 변경은 무조건 Tier 3이다.
- 맥락을 얼마나 넓게 봐야 하는가? 파일 하나면 Tier 1~2, 시스템 전체면 Tier 3이다.
- 사람이 최종 리뷰하는가? 리뷰가 있으면 한 단계 낮춰도 된다.
Tier는 작업 종류보다 작업 단계에 적용할 때 효과가 크다. 요청 하나도 탐색(소형) → 설계(프론티어) → 구현(대형) → 검증(소형)으로 쪼갤 수 있다. 실제 구성(Claude + DeepSeek/Qwen/GLM)에서도 Tier 3은 어느 조합에서든 내리지 않는다. 절감은 Tier 1~2에서 나온다.
라우팅 설정의 핵심은 모델 목록이 아니라 fallback 조건이다. 예를 들어 tool_call_error나 test_failed_twice일 때만 프론티어로 승급한다. 승급 판정은 실행 결과(테스트·컴파일·린트) → 규칙(스키마·필수 필드) → LLM-as-a-Judge 순으로 신뢰한다. Judge를 쓸 때는 판정기 자체에 저가 모델을 쓴다.
품질을 숫자로 정의해야 절감을 증명할 수 있다
“비슷한 퀄리티”는 기능 정확도(pass@k), 작업 완주율, 재시도 횟수, 리뷰 수정량, 회귀 발생, 총 소요 비용 중 무엇을 지켰는지로 바꿔 말해야 한다. 자체 Eval의 최소 구성은 이렇다.
- 내 레포에서 실제 작업(이슈·PR·버그) 20~50건을 뽑는다.
- 각 건의 통과 판정(테스트·린트·함수 존재 여부)을 자동화한다.
- 같은 태스크를 모델 구성별로 5회씩 돌려 pass^k로 일관성까지 측정한다.
- 성공률, 평균 시도 횟수, 총 비용, 소요 시간을 함께 기록한다.
발표자 환경의 예시 결과(기능 추가 + 테스트 작성, 각 5회)는 다음과 같다.
| 구성 | 성공률 | 평균 시도 | 총 비용 | 소요 시간 |
|---|---|---|---|---|
| 프론티어 단독 | 5/5 | 1.2회 | 100 | 100 |
| + 캐싱·컨텍스트 정리 | 5/5 | 1.2회 | 58 | 94 |
| + 티어 라우팅 | 5/5 | 1.4회 | 31 | 112 |
| 오픈소스 단독 | 3/5 | 2.8회 | 22 | 186 |
라우팅 구성은 성공률을 유지하며 비용을 3분의 1로 낮췄다. 다만 저가 모델의 생성 속도와 승급 왕복 때문에 소요 시간은 늘었다. 오픈소스 단독은 가장 싸지만 재시도가 절감분을 잠식했다.
흔한 실패와 도입 순서
라우팅 도입에 실패하는 팀은 대체로 셋 중 하나다. Eval 없이 모델부터 내리거나, 승급 조건을 만들지 않거나, 설계·최종 리뷰(Tier 3)까지 저가 모델로 내린다.
| 주차 | 할 일 | 판단 기준 |
|---|---|---|
| 1주차 | 작업 유형별 토큰·비용 로깅 | 비용 상위 3개 유형은? |
| 2주차 | 캐싱·도구 정리·컨텍스트 압축 | 품질 변화 없이 몇 % 줄었나 |
| 3주차 | 자체 Eval 20건 + 자동 판정 | 현재 구성의 기준선 확보 |
| 4주차 | Tier 1만 저가 모델로 전환 | 성공률·재시도가 유지되는가 |
Tier 2 전환은 4주차 결과를 본 뒤 판단한다. 로깅은 호출 단위(모델·토큰·캐시·지연), 작업 단위(유형·호출 수·비용·성공·재시도), 라우팅 단위(배정 Tier·승급 여부·사유)의 세 층으로 남긴다. 그래야 “어느 작업 유형에서 승급이 잦은가”가 보이고, 그 답이 다음 개선 지점이 된다.
관련 노트
- model-routing-switchyard — 요청별 모델 라우팅 개념과 NVIDIA Switchyard 구현
- 2026-09-12-claude-code-codex-hybrid-workflow — 이 세미나가 안내하는 후속 강의(Claude Code + DeepSeek·Qwen·GLM 조합)를 바탕으로 한 실전 구성
- openrouter — 여러 모델을 하나의 OpenAI 호환 엔드포인트로 쓰는 게이트웨이
- deepseek-v4, qwen, glm-5.2 — 세미나에서 Tier 1~2 후보로 다룬 오픈 모델 계열
- moc-ai-agents — 상위 MOC