출처: https://youtu.be/M5oLcLGq0hU · 길이: 18:45 · 채널: Tech Bridge · 게시: 2026-08-22
발표 원출처: AI Engineer World’s Fair 2026, Christopher Lovejoy(Anthropic)·Saul Howard(Anterior) 발표
다운로드 자막: 영어 자동 자막 999 cue + 한국어 자동 번역 자막 900 cue
포맷: A형 — 발표자 화면과 슬라이드·아키텍처 도식이 함께 나오는 엔터프라이즈 AI 설계 발표다. 아래 장면은 본편에서 직접 추출해 자막 구간과 화면을 대조했다.
한눈에 보는 요약
- AI 에이전트 POC는 빠르게 높은 정확도를 보여줄 수 있지만, 프로덕션 단계에서 감사 추적·민감 데이터·승인·통합 요구가 한꺼번에 드러난다.
- 일반 개발자 로그는 법적·컴플라이언스용 감사 기록이 아니다. 모든 입력·도구 호출·권한·출력과 데이터 접근을 남기는 불변 append-only 이벤트 로그가 필요하다.
- 오케스트레이션 이벤트와 PHI 같은 민감 데이터를 분리하고, 스키마 기반 객체 저장소와 point-of-use 토큰으로 접근을 통제하면 개발자에게 데이터 원문을 노출하지 않고 디버깅할 수 있다.
- 인간과 LLM을 같은 에이전트 인터페이스로 모델링하면, 예측하기 어려운 순간에도 사람에게 동적으로 에스컬레이션하고 동일한 컨텍스트를 재사용할 수 있다.
- 재생 가능한 이벤트, 인간-에이전트 동등성, 격리된 객체 저장소가 갖춰지면 평가(evals)를 별도 부착물이 아니라 프라이버시를 보존하는 시스템의 부산물로 만들 수 있다.
- 결론은 POC에 엔터프라이즈 제약을 나중에 덧대지 말고, 처음부터 프로덕션 규모의 제약을 아키텍처 프리미티브로 삼은 뒤 POC 수준의 정확도를 향해 올라가라는 것이다.
핵심 한 줄: 에이전트의 어려움은 모델 호출 자체보다, 규제 환경에서 행동·데이터·승인·평가를 재현 가능하게 만드는 시스템 경계에 있다.
장면별 상세 설명
[00:40] 1. 헬스케어는 규제 산업의 축소판이다
Christopher Lovejoy는 Anthropic의 deployed engineer로서 기업 조직 안에 들어가 AI 에이전트의 실제 가치를 만드는 일을 한다고 소개한다. Saul Howard는 미국 건강보험사를 대상으로 AI를 제공하는 Anterior의 엔지니어링 부문을 맡고 있다.
두 사람은 헬스케어가 AI를 개발·배포하기 어려운 이유로 프로세스, 컴플라이언스, 규제 요구, 그리고 결과가 사람의 삶에 직접 영향을 미친다는 점을 든다. 여기서 얻는 교훈은 금융·방위·정부처럼 절차 준수가 중요한 다른 규제 산업에도 확장된다.
[02:22] 2. 성공한 POC도 엔터프라이즈 스택 위에 올라간다
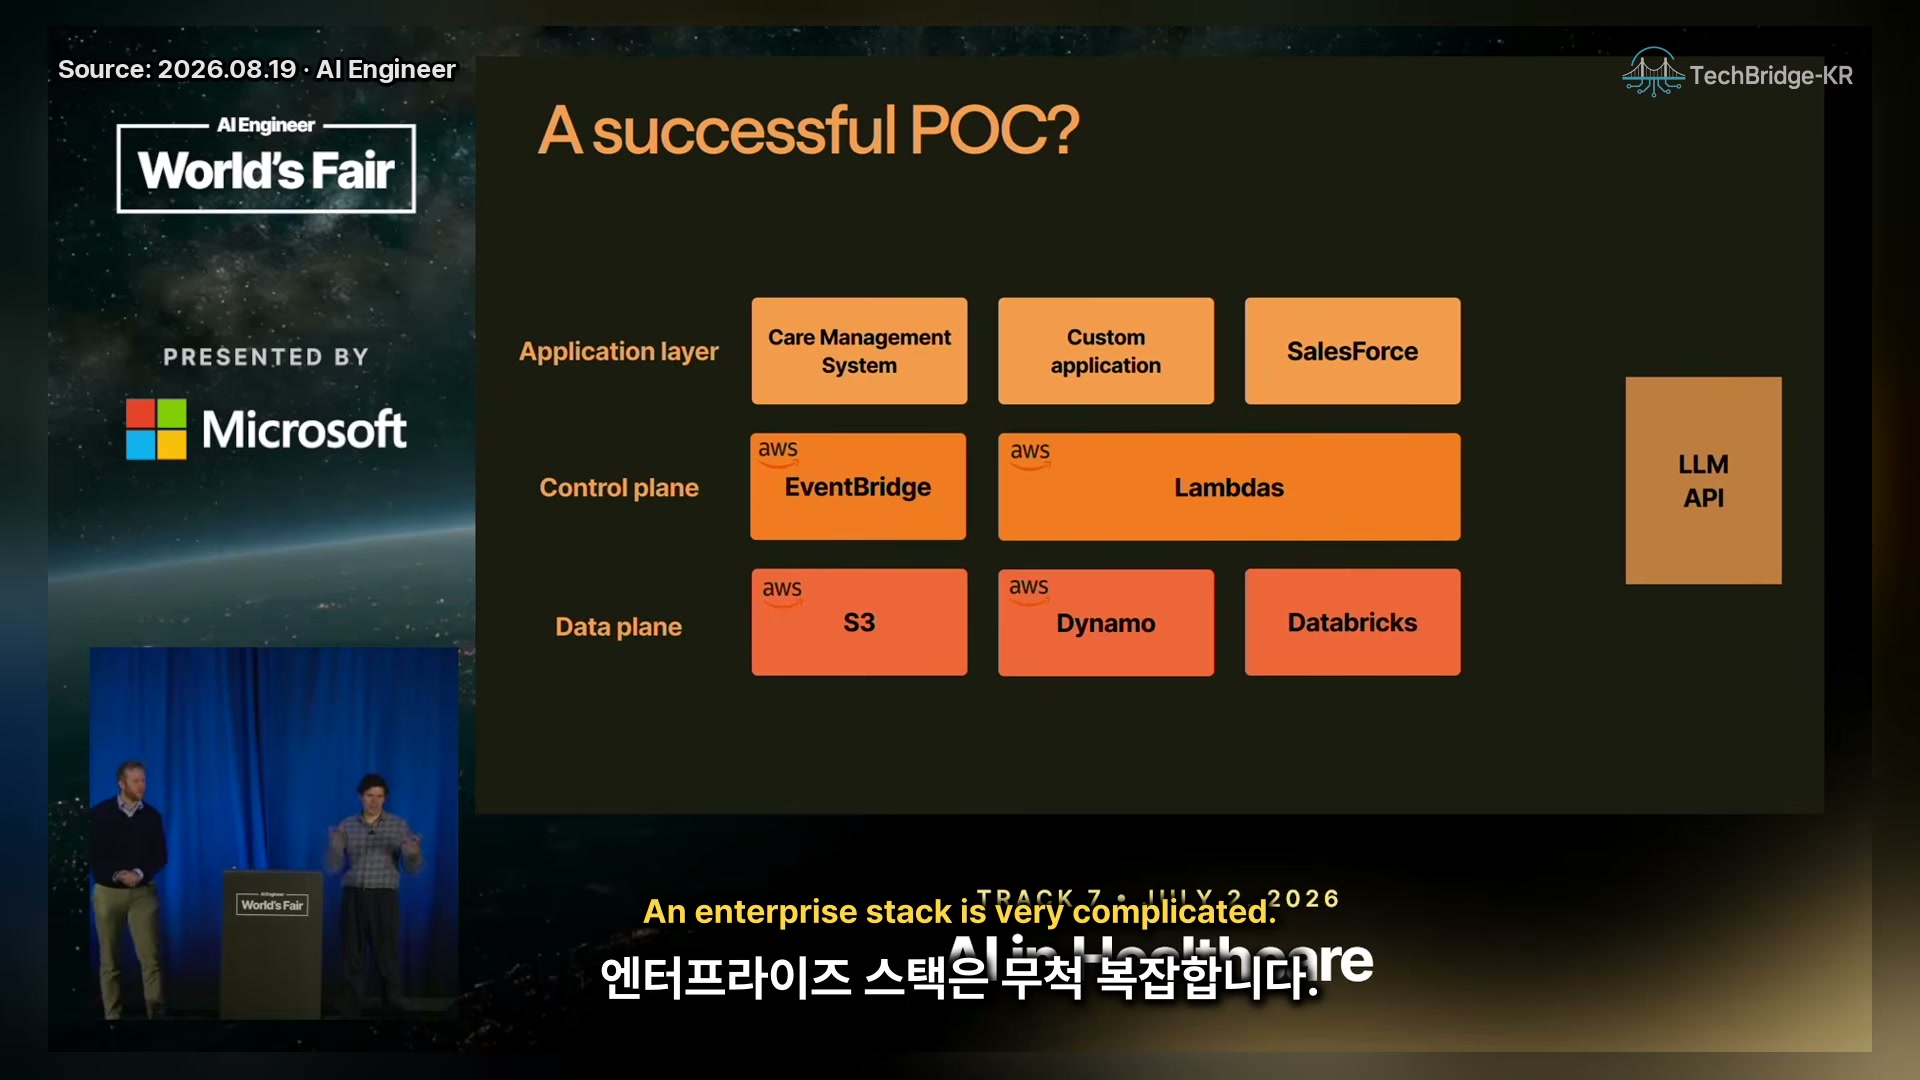
전형적인 POC는 고객과 우선 사용 사례를 정하고, 두 명의 엔지니어가 약 4주 동안 만들고, 미리 정한 성능 지표를 통과하는 흐름으로 시작한다. 결과가 빠르고 저렴하며 정확하면 모두가 성공했다고 생각하기 쉽다.
하지만 실제 배치는 단일 모델 호출이 아니다. 화면의 예시는 애플리케이션 레이어(Care Management System·커스텀 앱·Salesforce), 컨트롤 플레인(EventBridge·Lambda), 데이터 플레인(S3·Dynamo·Databricks), 그리고 LLM API를 함께 보여준다. 에이전트는 이 여러 레이어에서 데이터를 읽고 결과를 다시 밀어 넣어야 하므로, 모델 바깥의 통합면이 곧 핵심 난제가 된다.
[03:50] 3. 프로덕션 회의에서 진짜 요구사항이 나타난다
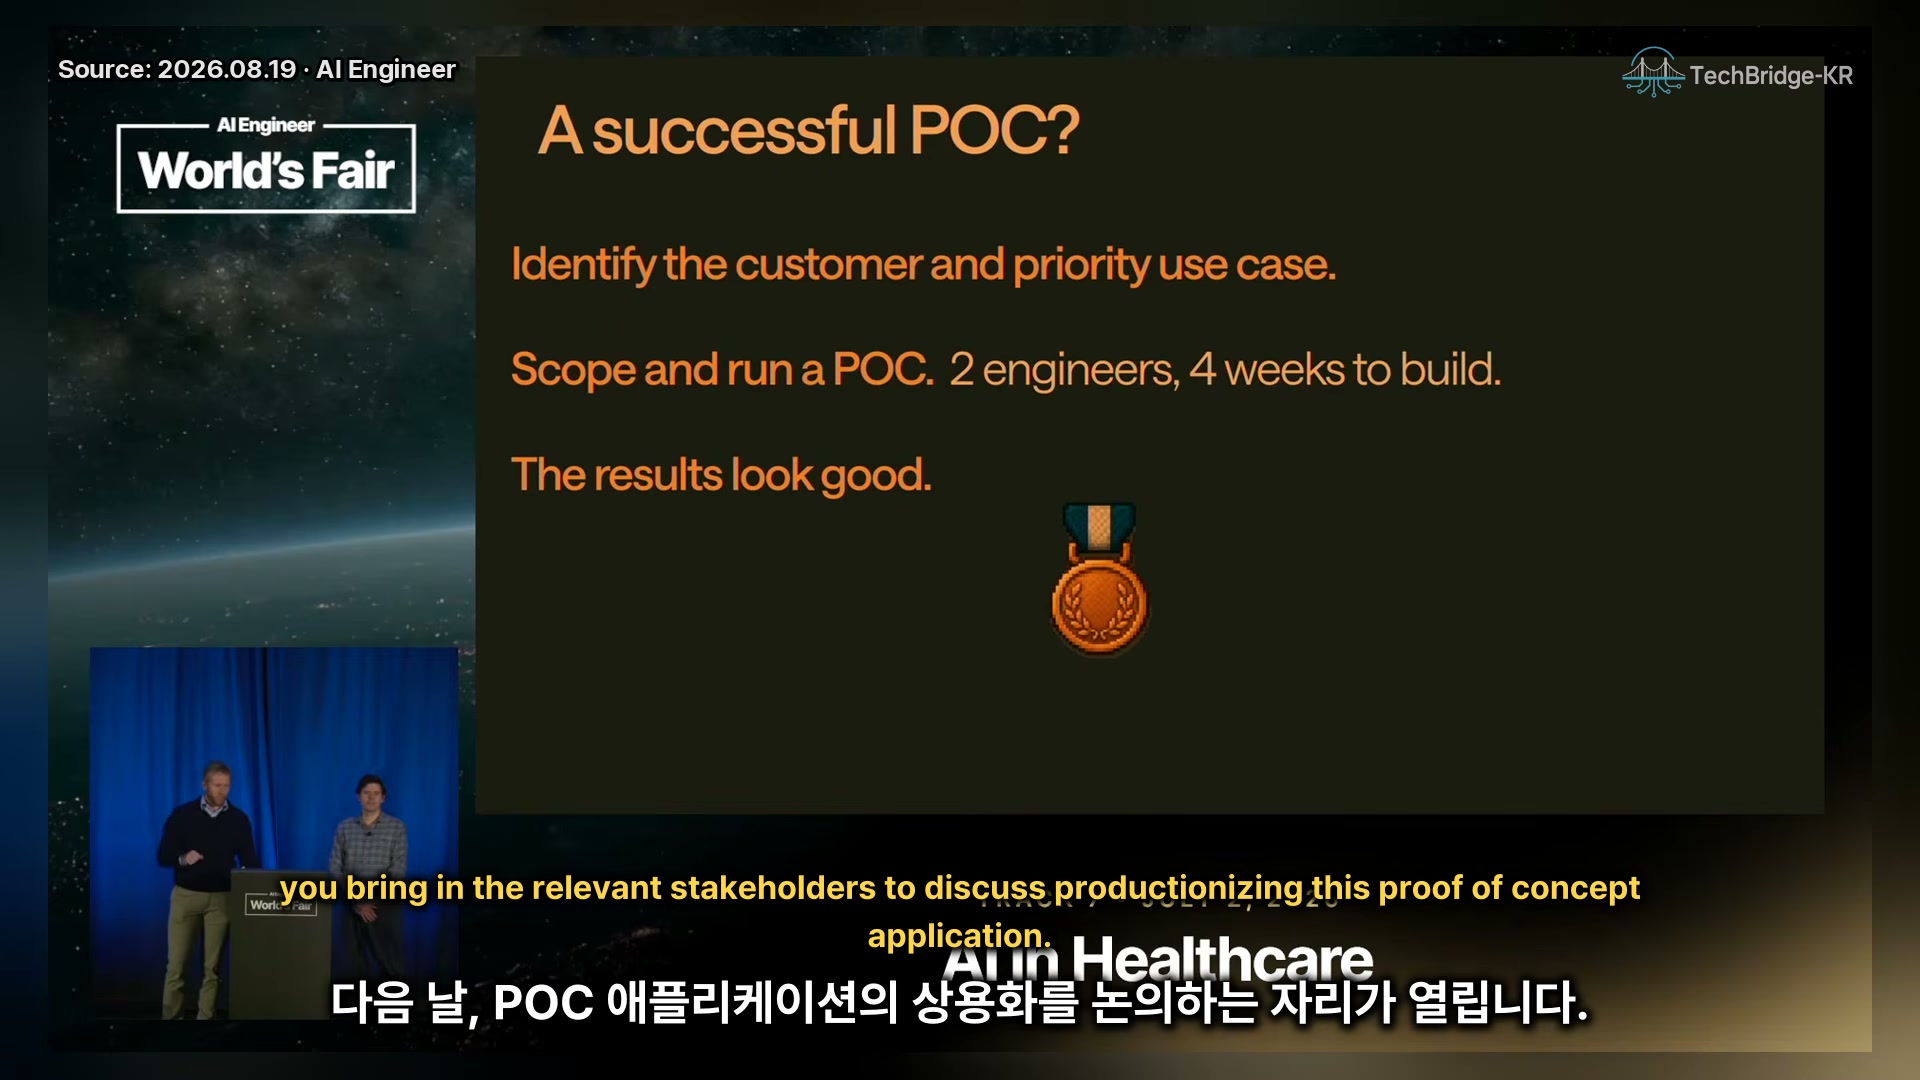
POC 결과가 좋아 다음 날 상용화를 논의하는 회의가 열리면, 각 이해관계자가 서로 다른 질문을 던진다. 재무 책임자는 예산 영향을, 의료 책임자는 정확도를, 영업 책임자는 웹사이트에 “Powered by AI”를 언제 붙일 수 있는지를 묻는다.
곧 보안·컴플라이언스 팀은 모든 에이전트 행동과 데이터 접근을 볼 수 있는가, 민감한 데이터가 어디로 이동하는가, 누가 결정을 승인하는가를 묻는다. 이어서 비신뢰 데이터의 prompt injection, 지속적인 성능, Epic·Salesforce 같은 기존 시스템 통합까지 등장한다. 이 발표는 그중 감사 추적, 민감 데이터 처리, 인간 에스컬레이션, 평가라는 네 질문에 집중한다.
[05:17] 4. 감사 추적은 Datadog 로그보다 훨씬 크다
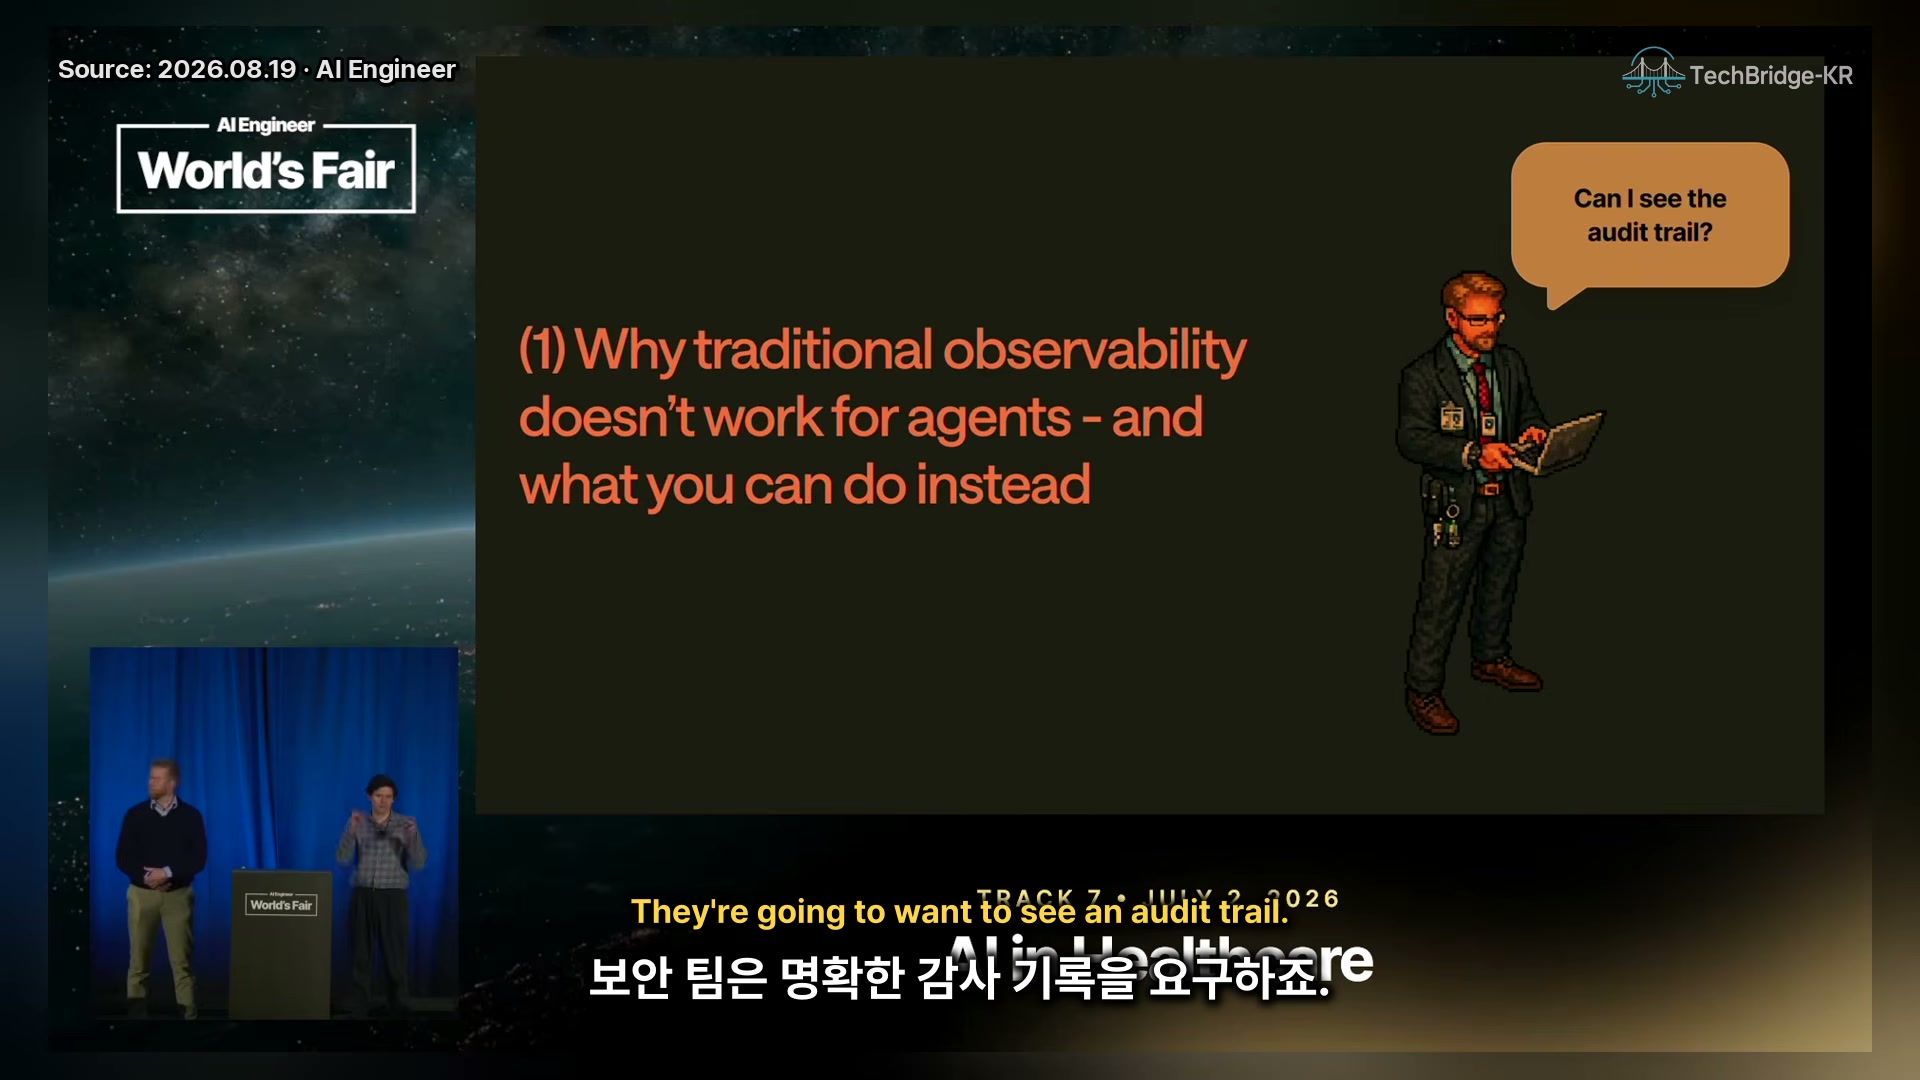
개발자가 먼저 떠올리는 audit trail은 보통 Datadog에 남는 애플리케이션 로그다. 그러나 SOC 2, HITRUST, HIPAA 같은 엔터프라이즈 보안·규제 프레임워크에서 요구하는 기록은 훨씬 더 완전해야 한다. 에이전트가 취한 모든 행동, 접근한 모든 데이터, 행동을 허용한 권한을 함께 기록해야 하며, 나중에 법정에서 판단의 근거를 설명할 수 있어야 한다.
따라서 질문은 “에러가 있었는가?”가 아니라 “특정 시점에 왜 이 행동을 했고, 어떤 데이터와 권한을 사용했는가?”가 된다. 감사 가능성을 관측 도구의 사후 기능으로 붙이기보다 데이터 저장 방식 자체의 성질로 만드는 것이 발표의 방향이다.
[06:42] 5. 불변 이벤트 로그를 시스템의 원장으로 삼는다
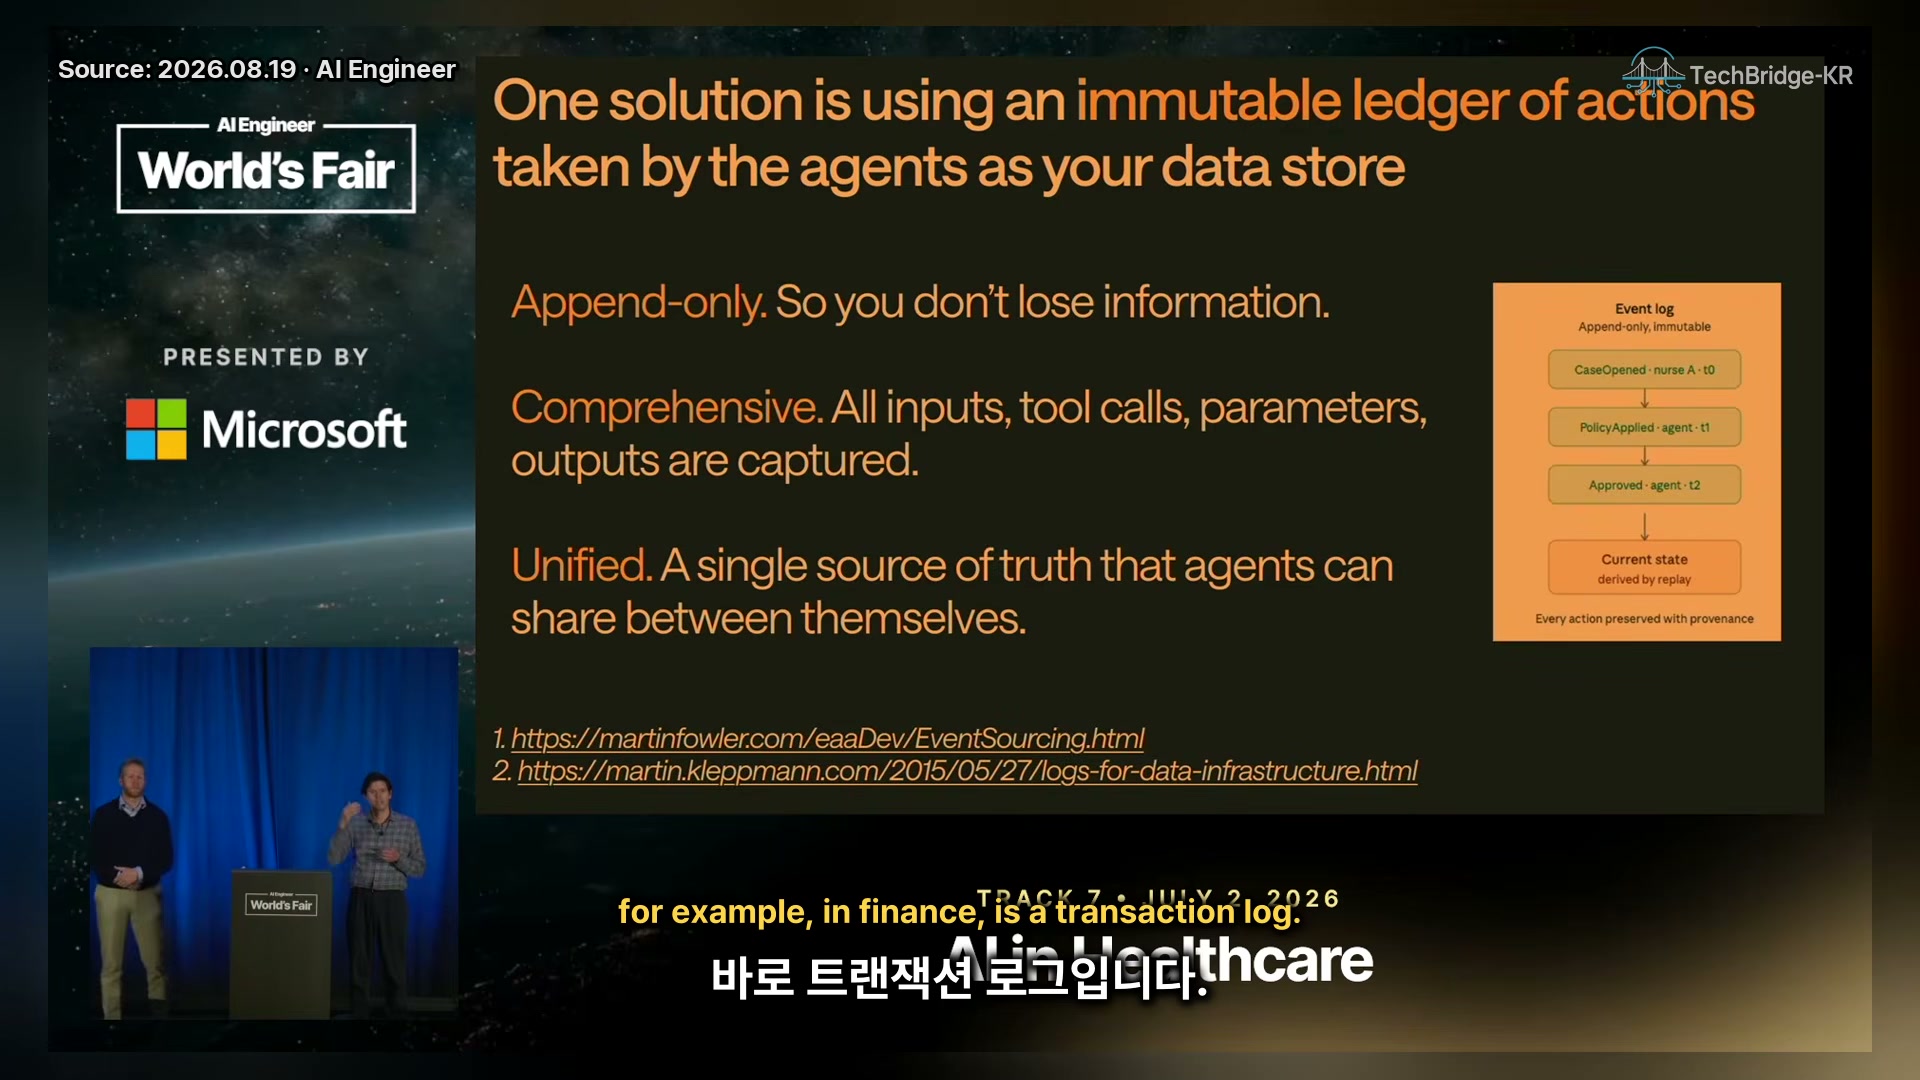
첫 번째 해법은 에이전트 행동을 불변 이벤트 원장(immutable ledger) 에 저장하는 것이다. 이벤트는 append-only라 기존 정보를 잃지 않고, 입력·도구 호출·파라미터·출력을 포괄하며, 여러 에이전트가 공유하는 단일 진실 공급원(source of truth)이 된다. 현재 상태는 이벤트를 재생(replay)해 계산한다.
이 방식은 금융의 transaction log 또는 event sourcing과 닮았다. 쓰기는 이벤트 하나를 추가하면 되므로 단순하지만, 읽기는 전체 이벤트를 순회해 뷰를 재구성해야 하므로 더 어렵다. 캐시와 스냅샷으로 읽기를 최적화할 수 있지만 비용은 남는다. 대신 이벤트가 원본이면 나중에 새로운 사건이 추가됐을 때 헬스케어 여정의 해석을 새 projection으로 다시 계산할 수 있고, 특정 시점의 시스템 상태를 정확히 되돌릴 수 있다.
[08:41] 6. 민감 데이터는 “어디로 흐르는가”부터 설계한다
PHI(Protected Health Information)는 필요한 사람이 필요한 시점에만 써야 하며, 에이전트도 예외가 아니다. 헬스케어 데이터는 계층 구조를 엄격히 따르지 않고 구조화·비구조화 형태가 섞이며, 한 덩어리가 1MB를 넘을 수 있고, 사람과 에이전트 모두에 엄격한 RBAC가 적용된다. 고객에 따라 데이터가 온프레미스 VPC 밖으로 나가는 것 자체가 허용되지 않을 수도 있다.
이런 환경에서 에이전트가 모든 원문을 들고 시스템 곳곳을 돌아다니게 하면 권한 경계와 추적 가능성이 동시에 무너진다. 데이터의 형태·크기·민감도·보관 위치를 먼저 정하고, 에이전트는 필요한 시점에 필요한 객체만 토큰으로 가져가게 해야 한다.
[10:18] 7. 오케스트레이션 인접 객체 저장소로 원문과 실행 흔적을 분리한다
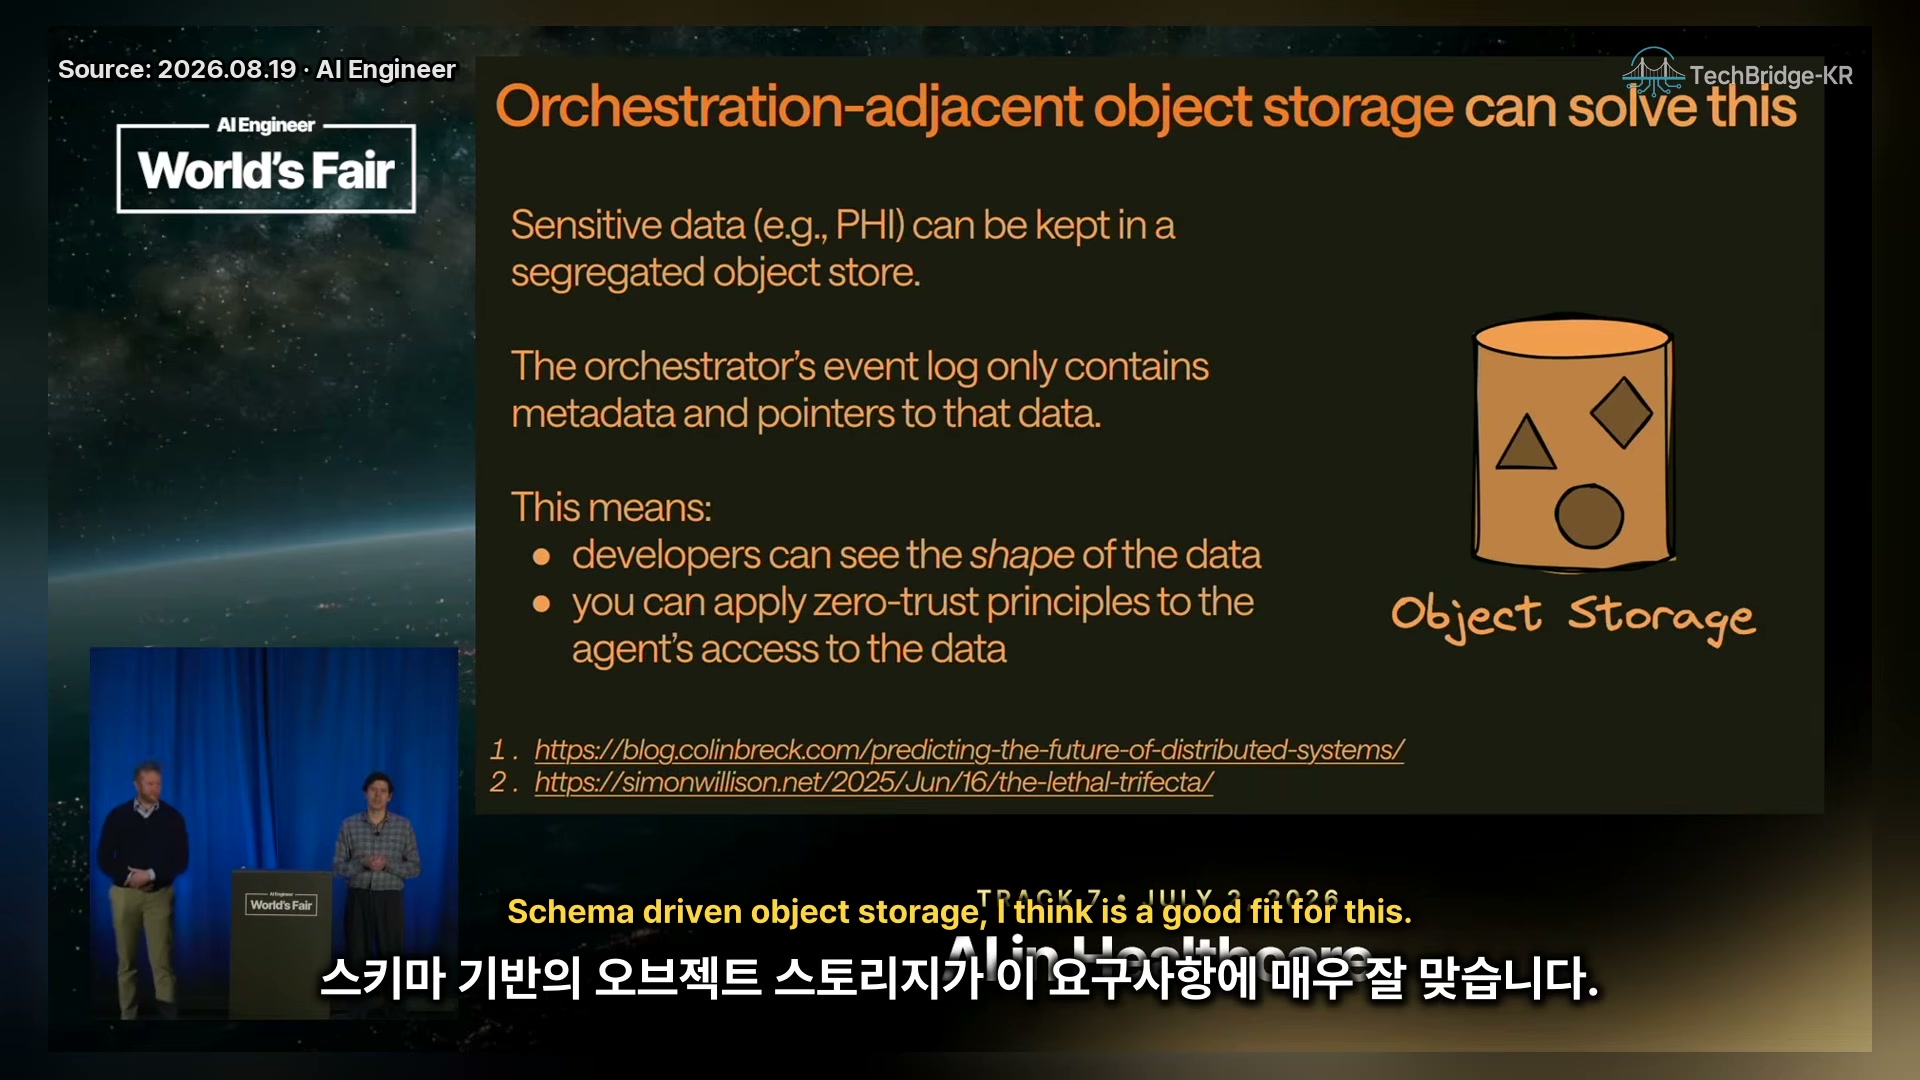
두 번째 핵심 프리미티브는 오케스트레이션 인접(schema-driven) 객체 저장소다. PHI 원문은 격리된 객체 저장소에 불변으로 보관하고, 오케스트레이터의 이벤트 로그에는 원문 대신 메타데이터와 포인터만 남긴다. 그러면 “무슨 일이 있었는가”와 “그때 어떤 데이터가 사용됐는가”를 각각 추적할 수 있다.
개발자는 데이터 원문을 보지 않고도 스키마와 shape를 확인해 디버깅할 수 있다. 에이전트는 point of use에서만 토큰으로 객체에 접근하고, 데이터가 프로세스와 시스템 사이를 자유롭게 흘러다니지 않게 한다. 이 분리는 observability·orchestration·instrumentation을 민감한 의료 데이터에서 떼어 놓으면서도, zero-trust 원칙과 데이터 재현성을 함께 얻는 방법이다.
[13:03] 8. 사람과 LLM을 같은 에이전트 인터페이스로 다룬다
세 번째 질문은 “누가 결정을 승인하는가?”다. 에이전트가 확신하지 못할 때, 규칙상 특정 금액·치료 수준을 넘었을 때 등 에스컬레이션 조건은 실행 중에 동적으로 발생한다. 따라서 처음부터 언제 사람에게 넘길지 모두 예측해 고정하기 어렵다.
해법은 플랫폼에서 human과 LLM을 모두 agent로 정의하는 것이다. LLM이 수행할 수 있는 행동은 사람도 수행할 수 있게 동일한 메서드와 공유 컨텍스트로 표현한다. 그러면 실행 도중 사람에게 넘겨도 이후 단계는 앞선 행동의 주체가 사람인지 모델인지 신경 쓰지 않는다. 같은 컨텍스트를 에이전트용 prompt와 사람용 UI로 각각 투영할 수 있다는 점도 중요하다. LLM은 많은 텍스트를 처리하지만 사람은 그렇지 않으므로, “동일한 상태”와 “각 사용자에게 맞는 표현”을 분리해야 한다.
[14:40] 9. Evals는 데이터 대표성과 시간 변화 때문에 어렵다
네 번째 질문은 “에이전트가 계속 잘 작동하는지 어떻게 아는가?”다. LLM은 비결정적이어서 출력 변화의 정확한 원인을 고정하기 어렵고, 오프라인 평가 데이터가 실제 프로덕션 데이터를 대표하지 않을 수 있다. 시간이 지나면 데이터 drift도 생긴다.
발표자들이 제안하는 관점은 eval을 별도의 부착물로 추가하지 않는 것이다. 앞서 만든 불변 이벤트 원장, 인간-에이전트 동등성, 격리 객체 저장소가 있으면 행동을 재생하고, 사람의 판단과 비교하고, 고객 환경의 실제 데이터로 평가할 수 있는 기반이 이미 생긴다.
[15:45] 10. 재생·인간 비교·비노출 프로덕션 데이터가 평가가 된다
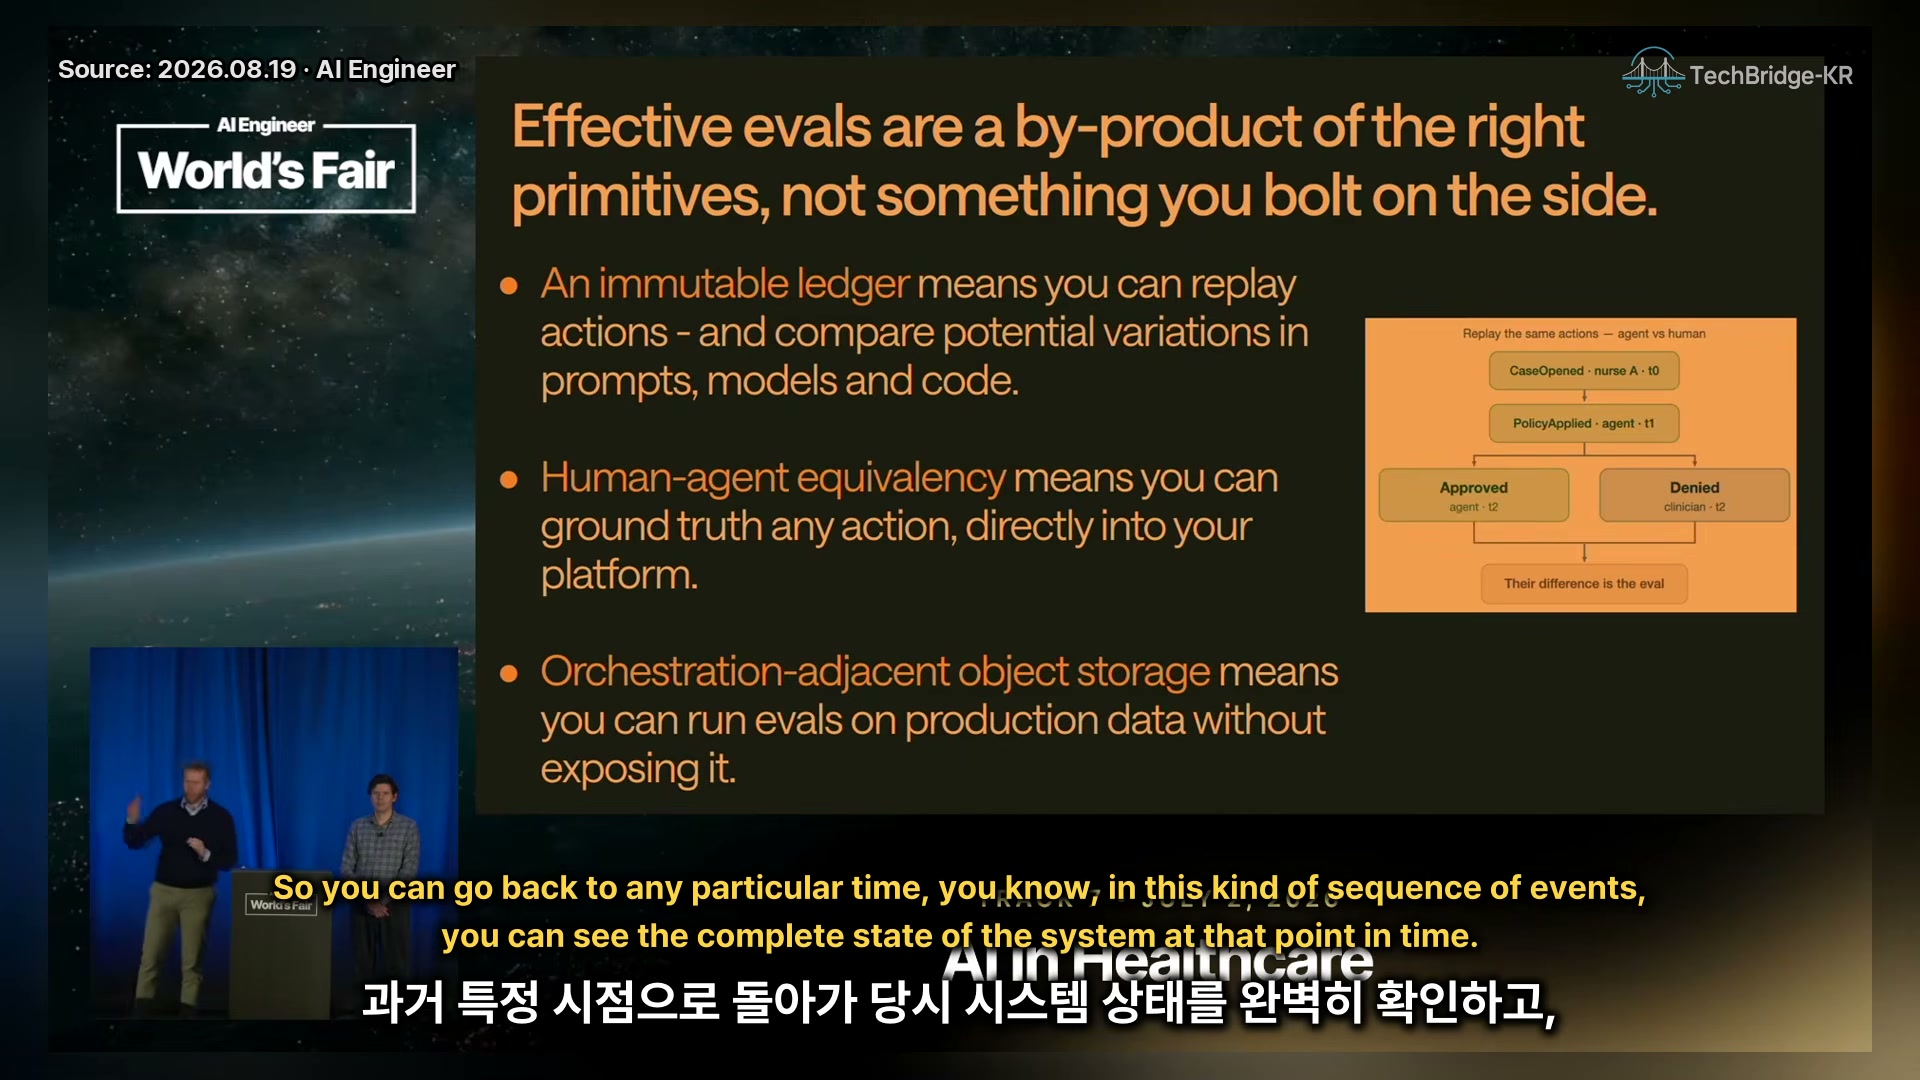
불변 원장이 있으면 과거의 특정 시점으로 돌아가 같은 행동을 재생할 수 있다. 그 상태에서 prompt·모델·코드를 하나씩 바꾸고 정확한 직접 효과를 비교할 수 있다. 인간-에이전트 동등성이 있으면 같은 작업을 LLM과 사람이 각각 수행하고 그 차이를 eval score로 삼을 수 있다.
객체 저장소는 고객 환경 안에서 원문을 꺼내지 않은 채 평가를 실행할 수 있게 한다. 민감한 데이터는 고객 경계 안에 남고, 실행 결과와 점수만 바깥으로 나오므로 프라이버시를 보존한 프로덕션 평가와 지속적인 회귀 검사가 가능해진다.
[16:42] 11. 네 가지 원칙과 최종 방향
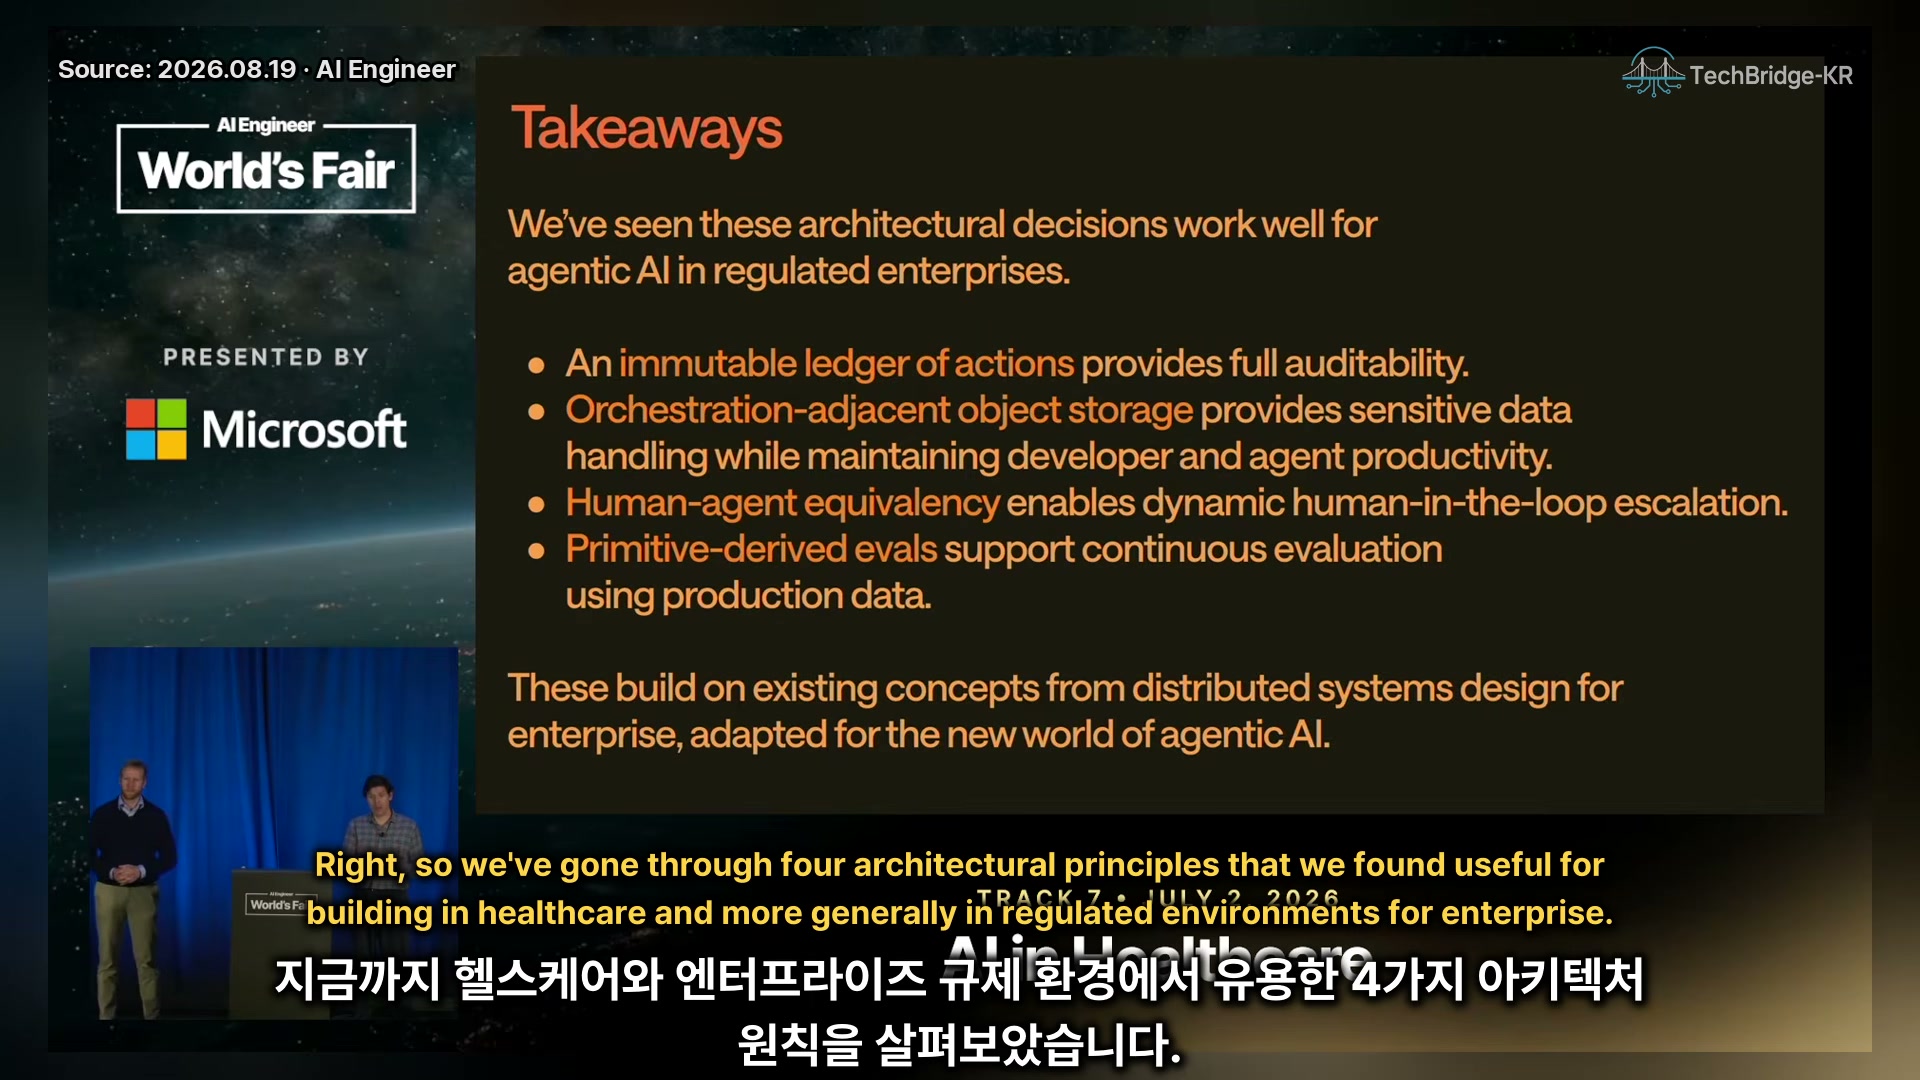
발표의 네 가지 결론은 다음과 같다.
| 원칙 | 시스템에서 쉬워지는 것 |
|---|---|
| 불변 행동 원장 | 완전한 감사 가능성, 시점별 상태 재현 |
| 오케스트레이션 인접 객체 저장소 | 민감 데이터 보호와 개발자·에이전트 생산성의 양립 |
| 인간-에이전트 동등성 | 동적 human-in-the-loop 에스컬레이션 |
| 프리미티브에서 파생되는 eval | 원문 비노출 프로덕션 데이터의 지속 평가 |
발표자들이 본 실패 패턴은 정확도가 좋았던 초기 point solution에 보안·eval·감사 기능을 나중에 덧대는 것이다. 그러면 시스템은 brittle해지고 다른 사용 사례로 일반화하기 어려워진다. 반대로 프로덕션-ready한 규모와 제약을 처음부터 진지하게 받아들여 기반을 설계하고, 새 프리미티브 위에서 POC 수준의 정확도를 다시 쌓으면 규제 요구가 시스템의 본질적인 장점이 된다.
부록 — 실전 체크리스트
- POC 시작 전에 보안·컴플라이언스·재무·도메인 책임자가 물을 질문을 목록화한다.
- 에이전트 입력·도구 호출·권한·데이터 포인터·출력을 append-only 이벤트로 남기고 시점별 replay를 검증한다.
- 민감 원문과 오케스트레이션 로그를 분리하고, 스키마·RBAC·point-of-use 토큰·zero-trust 경계를 설계한다.
- 사람과 LLM을 같은 행동 인터페이스로 모델링해 언제든 사람에게 넘길 수 있게 한다.
- prompt·모델·코드 변형을 과거 이벤트로 재생하고, 인간 결과와 비교하는 eval을 만든다.
- 고객 환경 안에서 원문을 반출하지 않고 프로덕션 데이터의 평가·drift 검사를 실행한다.
- 보안·감사·평가를 POC 뒤에 붙이는 플러그인으로 취급하지 말고 초기 아키텍처 제약으로 반영한다.
관련 노트
- moc-ai-agents-harness — 에이전트 실행 루프·컨텍스트·검증·보안 경계를 다루는 하네스 지도
- moc-ai-agents-orchestration — 에이전트 오케스트레이션과 실행 인프라 관련 노트
- etclovg-o-observability — 실행 흔적·관측 데이터와 eval의 연결
- etclovg-v-verification — 재현 가능한 실행·검증·평가 계층
- 2026-07-02-anthropic-demystifying-evals-for-ai-agents — 에이전트 평가 용어와 설계 원칙
원문 인용 모음
- [02:22] “An enterprise stack is very complicated.”
- [05:13] “Can I see the audit trail?”
- [16:42] “Effective evals are a by-product of the right primitives.”