원문: Granite(@Granite0x)의 X 아티클 · 게시일: 2026-07-24 “Every node in the graph is an agent running a loop. The graph coordinates the fleet. The loop makes each one trustworthy.”
Granite는 README가 아니라 실제 코드(스케줄러, 훅, 루프 함수)를 읽고, Claude Code 에이전트 시스템을 “그래프(graph) 레이어 + 루프(loop) 레이어” 로 구성하는 10개 오픈소스 레포를 소개한다. “Everyone online builds the graph or the loop. Nobody wires both.” — 둘을 연결하는 것이 이 글의 주장이다.
핵심 요지
- 그래프는 누가 언제 실행할지를 결정하고, 루프는 그 결과를 믿을 수 있는지 결정한다. 신뢰할 수 있는 루프로 그래프를 짓지 않으면, 버그를 더 빨리 배포하는 장치만 만들 뿐이다.
- 두 레이어를 잇는 줄: “그래프의 모든 노드는 루프를 도는 에이전트다.” 오케스트레이션만 다루는 글과 루프(프롬프트 루프)만 다루는 글이 각각 별개로 떠도는데, 실무에서는 항상 함께다.
- 수치 하나: Claude Code는 아무것도 입력하지 않아도 기본 제공 도구 설명만으로 컨텍스트 약 16,000토큰을 소모한다(편집 불가). L3(serena)가 이 토큰을 되찾는 레포다.
- 단일 시험: “시스템이 done을 되돌릴 수 있는가?” 게이트 실패를 거부하고, 태스크를 not-ready로 되돌리고, 리뷰 훅이 종료를 취소하고, eval이 실패한 트레이스를 잡아내야 한다. 승격만 가능한 시스템은 “버다운 차트에 스텝만 늘어난 것”이다.
지도 — 10개 레포
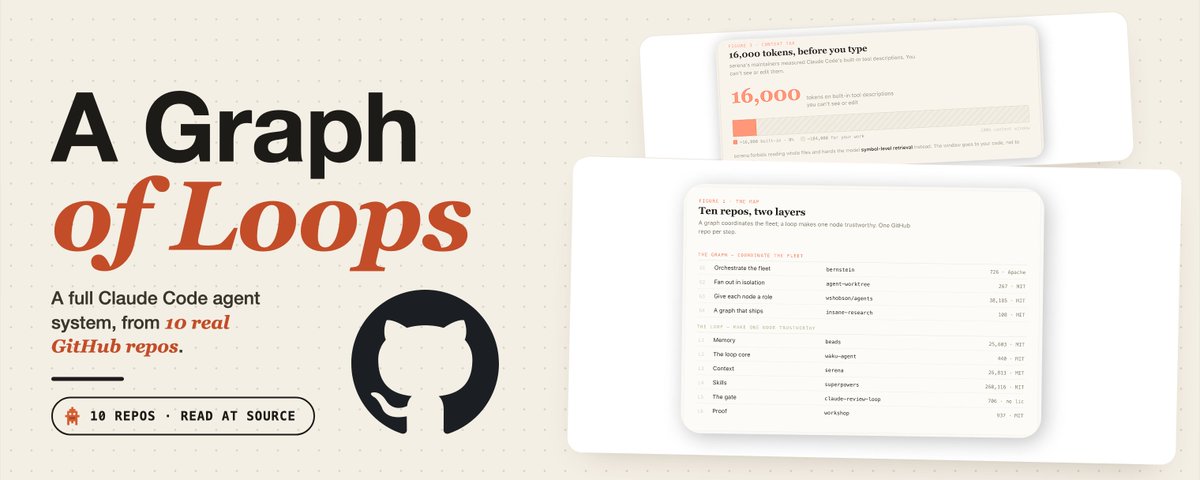
그래프 레이어 (플릿 조율)
| 구분 | 레포 | ★ | 라이선스 | 역할 | 함정 |
|---|---|---|---|---|---|
| G1 | sipyourdrink-ltd/bernstein | 726 | Apache-2.0 | 태스크 DAG 스케줄러 (모델 없는 순수 Python 조율) | 무거움: 1,765개 파일, 자체 .sdd/ 워크스페이스, DAG를 직접 작성해야 함 |
| G2 | nekocode/agent-worktree | 267 | MIT | git worktree 1개/에이전트, dry-run 머지로 안전 귀환 | 스케줄러가 아닌 프리미티브 — 몇 개를 띄울지는 G1의 몫 |
| G3 | wshobson/agents | 38,185 | MIT | 203개 전문 서브에이전트 × 94개 플러그인 마켓플레이스 (Opus/Haiku 티어) | 203개를 전부 주입하면 L3가 지킨 컨텍스트를 소진 |
| G4 | fivetaku/insane-research | 108 | MIT | 7단계 리서치 그래프 — 팬아웃을 코드 게이트가 검증 | 검증 단계를 건너뛰면 신디시스가 인용할 게 없음 |
루프 레이어 (노드 하나를 신뢰 가능하게)
| 구분 | 레포 | ★ | 라이선스 | 역할 | 함정 |
|---|---|---|---|---|---|
| L1 | gastownhall/beads | 25,603 | MIT | 버전 관리 SQL 그래프 메모리 (bd ready/remember/prime) | .beads/가 iCloud/Dropbox에 있으면 디스크 I/O 522 — DB가 깨짐 |
| L2 | ShenSeanChen/waku-agent | 440 | MIT | 에이전트 루프 전체가 agent.py 한 파일 ~95줄 | 도구 오류를 문자열로 삼켜 조용히 잘못된 결과처럼 보임 → L5가 필요한 이유 |
| L3 | oraios/serena | 26,813 | MIT | 심볼 레벨 검색(MCP), 16k 도구 설명 토큰 회수 | 검증은 안 함 — 강한 리팩터는 유료 JetBrains 백엔드 필요 |
| L4 | obra/superpowers | 260,116 | MIT | TDD “Iron Law” 스킬 방법론 | 설득(persuasion)이지 syscall 아님 — assert True로 속을 수 있음, 진짜 집행은 L5 |
| L5 | hamelsmu/claude-review-loop | 706 | 라이선스 없음 | Stop 훅 — 종료 시 Codex 리뷰어 4명(병렬)이 리뷰 파일을 만들 때까지 block (fail-open) | LICENSE 없음, 리뷰 파일 존재만 확인(이의·생략 허용) |
| L6 | raindrop-ai/workshop | 937 | MIT | 실제 실행 트레이스를 재생해 툴 콜을 diff하는 eval 루프 (SQL assertion) | 재생 진입점을 깨끗하게 추출하지 않으면 프로덕션 DB·결제·이메일을 건드릴 수 있음 |
조립
bernstein이 작업을 DAG로 컴파일해 태스크당 노드를 띄우고 → agent-worktree가 노드마다 격리 트리를 주고 → wshobson/agents가 역할을 부여한다. 그 안의 모든 노드에서 루프가 돈다: beads가 기억하고, waku가 반복하고, serena가 건드리는 코드만 주입하고, superpowers가 수를 두고, claude-review-loop가 두 번째 모델의 승인까지 종료를 막고, workshop이 증명한다.
G4 insane-research는 전체 형태를 오늘 실행할 수 있는 한 개의 플러그인이다: 팬아웃 → 코드로 검증 → 신디시스. “스레드가 도는 것”과 “시스템”의 차이는, 그래프를 그리고 노드가 잘되길 바라는 것과, 거짓으로 done을 말할 수 없는 루프로 그래프를 짓는 것이다.
적용 메모
- 루프부터 먼저 보라. 그래프를 그리기 전에 노드 하나의 신뢰성을 L1–L6로 채우는 게 이 글의 권장 순서다.
- L3(serena)와 L2(waku) 조합은 가장 저렴한 실험. 16k 토큰 회수 + 95줄짜리 루프는 하루 안에 검증 가능하다.
- L5의 “리뷰 파일 존재만 확인” 한계를 인지하고 쓰자. spec 기반 대안으로
npx cc-sdd@latest(3,581★, MIT)가 태스크당 독립 리뷰어를 돈다는 언급도 있다. - G4의
validate_ledger.py패턴(코드가 검증을 소유)은 다른 시스템에 이식할 가치가 있다. 모델이 아닌 코드가 무엇이 살아남을지 결정하는 게이트. - L1 beads는 메모리 계층에서 code-native-memory 관점의 실용 구현체 — 클라우드 동기화만 피하면 된다.
관련 노트
- 2026-05-21-superpowers — L4 superpowers의 기존 정리
- code-native-memory — L1 beads를 포함한 코드-네이티브 메모리 기법
- 2026-07-08-claude-code-getting-started-with-loops — Claude Code 팀의 공식 루프 분류(트리거·정지 조건·프리미티브)
- insane-search — G4와 같은 fivetaku 조직의 스크래퍼 플러그인
- moc-ai-agents-orchestration — 멀티 에이전트 오케스트레이션 MOC
- moc-ai-agents — AI 에이전트 전반 MOC