출처: Garry Tan: Own Your Intelligence · 길이: 42:08 · 채널: Y Combinator · 공개: 2026-08-06 자막: YouTube 영어 원본 자동자막(
en-orig). 한국어 자동번역 자막은 HTTP 429로 내려받지 못해 영어 자막을 바탕으로 번역·정리했다.
개요
Garry Tan은 AGI를 어느 날 갑자기 도착하는 단일 시스템이 아니라, 개인의 인프라에서 실행되고 개인의 기억·절차·스킬을 매일 축적하는 에이전트로 해석한다. 구독형 챗봇처럼 모델과 기억을 빌려 쓰는 대신, 자신이 통제하는 저장소와 키에 맥락을 쌓고 에이전트가 반복 업무를 실행하도록 만들자는 주장이다.
발표의 실천 처방은 작다. 로컬 에이전트 하나를 고르고, 자신의 메모·프로젝트·사람에 관한 Markdown 라이브러리를 만들고, 싫어하는 주간 업무 하나를 스킬 파일로 적고, 반복 작업으로 연결한 뒤 매번 배운 절차를 다시 스킬화한다. 이렇게 하면 모델은 임대하는 범용 부품이고, 고유한 맥락과 스킬은 소유하는 지능 자산이 된다.
한눈에 보는 요약
- AGI는 데이터센터의 단일 사건이 아니라 터미널, Markdown 파일, 에이전트 작업처럼 개인의 일상에 분산되어 이미 시작됐다는 관점이다.
- 개인 AGI는 내 인프라에서 실행되고, 내가 소유한 기억을 읽으며, 내가 작성한 절차를 실행하고, 사용할수록 더 많은 맥락을 축적하는 에이전트다.
- 인간의 작업 기억은 7±2개 수준이지만, 에이전트는 거대한 라이브러리에서 필요한 “책”을 골라 여러 자료를 합성할 수 있다. 핵심은 라이브러리뿐 아니라 어떤 자료를 열지 결정하는 사서다.
- Markdown 스킬은 자연어로 작성된 실행 절차다. 모델이 판단해야 하는 일은 latent space에, 산술·SQL·대규모 일정 계산은 코드·데이터베이스 같은 deterministic space에 둬야 한다.
- 시작 방법은 로컬 harness 선택 → 개인 라이브러리 생성 → 첫 스킬 파일 작성 → 반복 작업 예약 → 일회성 작업을 스킬로 환원하는 5단계다.
- 발표의 결론은 생산성보다 소유권에 가깝다. 자신의 지식과 스킬을 자신이 통제하는 저장소에 보관해야 에이전트 시대에도 “자기 힘 아래” 머물 수 있다.
핵심 한 줄: 더 좋은 모델을 빌리는 것보다, 나만의 맥락과 스킬을 축적해 내 일을 실행하는 에이전트를 소유하는 것이 개인 AGI의 출발점이다.
장면별 상세 설명
[00:35] 1. 스피노자의 conatus를 창업자의 엔진으로 읽기
발표는 스피노자의 파문 이야기로 시작한다. 영상의 서술에 따르면 스피노자는 23세에 공동체에서 완전히 추방됐고, 침묵하는 대가로 상당한 연봉을 제안받았지만 거절했다. 이후 렌즈를 갈아 정밀한 광학 기구를 만들면서 밤에는 생전에 출판할 수 없었던 책을 썼다.
Tan이 가져오는 개념은 conatus, 즉 살아 있는 것이 계속 나아가고 자신의 행동 능력을 키우려는 추진력이다. 창업자에게 필요한 것은 직함이나 이력서가 아니라, 아무도 허락하지 않아도 정밀한 도구와 위험한 아이디어를 계속 만들어 가는 힘이라는 비유다. 이 역사적 일화와 수치는 영상의 설명을 옮긴 것이며 별도 사료 검증은 하지 않았다.
[05:42] 2. AGI는 미래의 사건이 아니라 내 방의 인프라다
Tan은 사람들이 AGI를 어느 날 발표될 “데이터센터의 신”처럼 기다리지만, 실제로는 이미 터미널 창과 Markdown 폴더, 잠든 사이 끝나는 작업의 형태로 방 안에 들어왔다고 말한다. 그가 말하는 개인 AGI는 모두를 위한 하나의 초지능이 아니라 한 사람을 위한 일반 지능이다.
구독형 챗봇이나 일정만 아는 비서와의 차이는 소유권과 축적성이다. 개인 AGI는 내 인프라에서 실행되고, 내가 가진 기억을 읽고, 내가 쓴 절차를 실행하며, 사용할수록 내 삶에 관한 맥락을 더 많이 안다. 기업 제품은 회사가 업데이트할 때만 좋아지지만, 개인 시스템은 내가 기록하고 고칠 때마다 자산으로 성장한다.
[08:24] 3. 같은 모델보다 맥락이 만드는 레버리지
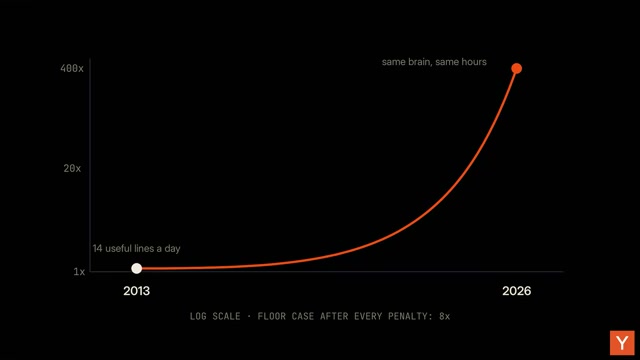
화면의 로그 스케일 차트는 2013년 하루 14개의 유용한 코드 라인에서 2026년 “같은 뇌, 같은 시간”의 400배 지점으로 올라가는 곡선을 보여준다. 하단에는 과장과 장황한 코드에 불리한 페널티를 적용해도 최저 8배라는 문구가 있다. Tan은 자신이 2013년과 같은 두뇌·시간을 쓰면서도 현재는 약 400배의 산출을 낸다고 주장하고, 코드뿐 아니라 디자인·제품·성장 등 모든 지식 노동에 같은 배수가 적용될 수 있다고 확장한다.
다만 이 수치는 발표자의 자기 측정과 영상 속 사례다. Tan 자신도 코드 라인 수가 생산성의 완전한 척도가 아니며, YC 포트폴리오의 성장과 AI 생성 코드 사이의 인과를 증명할 수 없다고 선을 긋는다. 그가 강조하는 결론은 같은 모델·클라우드·컨텍스트 창을 써도 결과를 가르는 것은 관련성 높은 맥락을 올바른 단계에 주는가라는 점이다.
[12:42] 4. 인간의 일곱 자리와 에이전트의 라이브러리
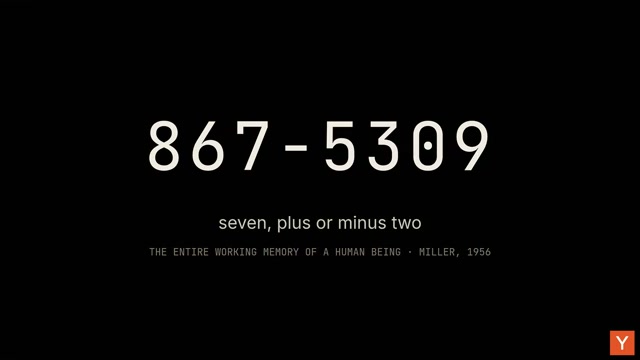
화면은 Miller의 1956년 연구를 가리키며 전화번호 867-5309와 “seven plus or minus two”를 보여준다. Tan은 인간이 한 번에 붙잡는 작업 기억이 대략 일곱 가지이기 때문에 체크리스트·조직도·파일링 캐비닛·스탠드업 미팅 같은 제도가 그 한계를 보완하는 인공 기관으로 발달했다고 설명한다.
반대로 에이전트는 약 백만 토큰, 대략 천 페이지를 동시에 다루고 그 안에서 필요한 내용을 찾아 합성할 수 있다고 말한다. 그러나 개인의 삶은 세 권의 책이 아니라 이메일·회의·결정·관계·실패가 쌓인 라이브러리다. 따라서 중요한 것은 라이브러리의 크기만이 아니라 지금 어떤 세 권을 책상 위에 펼칠지 고르는 사서(librarian)다. Tan은 자신의 공개 지식 위키가 약 22만 개의 Markdown 페이지와 25년치 기록으로 구성됐다고 설명하지만, 이 수치는 영상 발표 내용이다.
[16:38] 5. 개인 시스템은 라이브러리 위에 놓인 동료다
Tan이 설명하는 하루의 흐름은 “받은 편지를 분류하는 비서”보다 “내가 아는 것을 함께 아는 동료”에 가깝다. 에이전트는 잠자는 동안 받은 편지를 처리하고, 곤란한 창업자의 과거 대화와 비슷한 문제를 겪은 다른 회사의 해결 사례를 찾아 아침 브리핑으로 만든다. 회의 전에는 지난 대화·변경 사항·물어볼 질문을 모은 준비 문서를 만들고, 밤중에 관심을 둔 연구도 읽어 둔다.
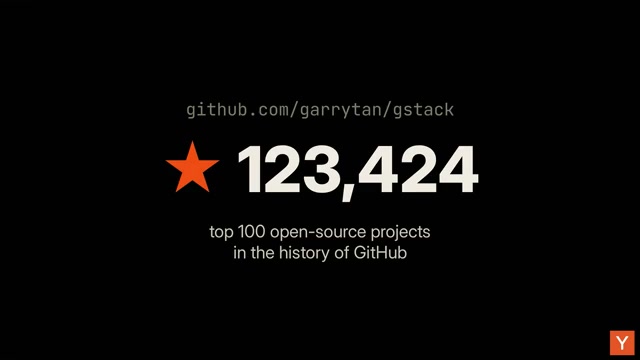
화면은 github.com/garrytan/gstack과 당시 123,424 스타, “GitHub 역사상 상위 100개 오픈소스 프로젝트”라는 주장을 보여준다. Tan은 이 시스템을 fat skills, thin harness라고 요약한다. 즉 거대한 마법 프레임워크보다 지식·절차를 담은 스킬 파일, 에이전트가 조작할 브라우저, 세상에 작용할 실행 수단이 핵심이다. 스타 수와 순위는 영상 속 시점의 주장으로 별도 확인하지 않았다.
[17:20] 6. Markdown은 자연어로 쓰는 코드다
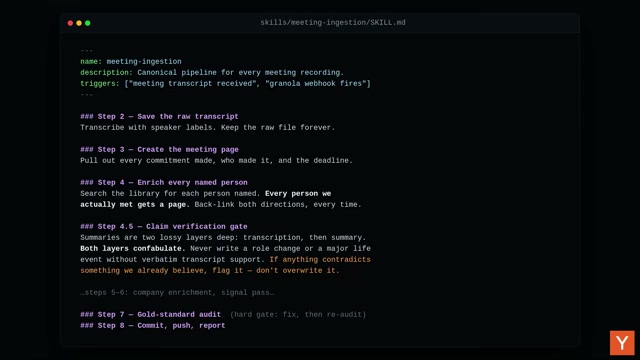
화면의 스킬 파일은 회의 녹음이 들어오면 화자 라벨로 전사하고, 약속·담당자·기한을 추출하고, 이름을 라이브러리와 대조하고, 요약과 전체 전사를 정해진 위치에 저장하라고 지시한다. 이미 믿고 있는 사실과 모순되면 덮어쓰지 말고 표시하라는 검증 규칙도 들어 있다.
Tan의 테스트는 간단하다. 똑똑한 인턴이 따라 할 수 있는 설명이면 에이전트도 실행할 수 있다. 그는 Markdown을 실제 코드로 보고, 언어 모델을 그 문장을 실행하는 컴파일러에 비유한다. 영상에서는 터미널을 열지 않던 YC의 미디어·행사·재무 담당자가 스킬과 예약 작업을 만들고, 한 재무 담당자가 약 100개의 Excel 통합문서를 하나의 내부 앱으로 묶었다는 사례도 제시한다.
[18:36] 7. 판단은 latent space, 계산은 deterministic space
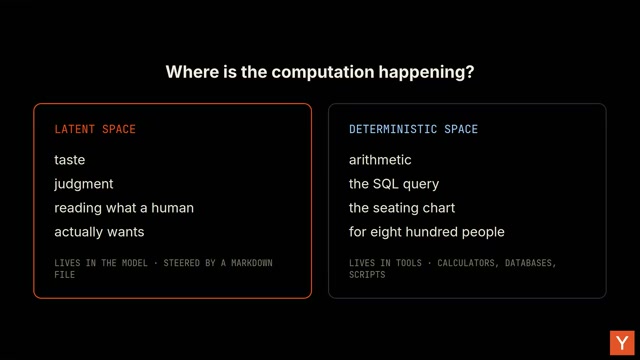
화면은 “Where is the computation happening?”이라는 질문 아래 두 영역을 나눈다. latent space에는 취향·판단·모호한 요청에서 사람이 실제로 원하는 것을 읽는 일이 들어가며, 모델과 Markdown 지시가 담당한다. deterministic space에는 산술, SQL 쿼리, 800명의 좌석 배치처럼 같은 입력에 같은 결과를 내야 하는 일이 들어가며, 도구·계산기·데이터베이스·스크립트가 담당한다.
작은 좌석 배치는 모델이 처리할 수 있어도 수천 명의 일정과 좌석을 만들 때는 모델이 코드를 작성해 결정론적 시스템을 호출해야 한다. 이 구분은 모델을 덜 똑똑하게 만드는 장치가 아니라, 사람이 직관으로 처리할 부분과 계산기로 처리할 부분을 나누는 설계 원칙이다. 모델이 사람처럼 틀리는 영역을 인정하고, 계산 가능한 부분은 외부 시스템에 맡겨야 한다.
[20:10] 8. 1,500쪽을 무대용 이야기로 바꾸는 compendium skill
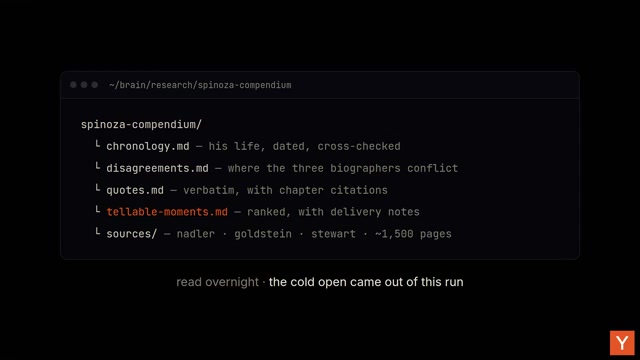
Tan은 발표 5일 전에 에이전트에게 스피노자 전기 세 권, 약 1,500쪽을 읽히고, 연대기·전기 작가 사이의 불일치·장 인용이 포함된 원문 문구·말하기 좋은 장면 순위를 만들게 했다고 설명한다. 화면에는 chronology.md, disagreements.md, quotes.md, tellable-moments.md, sources/가 보인다.
이 결과가 밤새 “무대에서 편집할 수 있는 이야기”가 됐고, 발표의 첫 장면도 이 작업에서 나왔다고 한다. Tan은 이를 일반적인 요약보다 더 깊은 compendium skill로 부른다. 여러 출처를 읽고 핵심을 재구성하는 일뿐 아니라, 서로 다른 주장과 출처 위치를 함께 보존해야 나중에 다시 검토할 수 있다는 사례다.
[21:32] 9. resolver.md는 한 사람의 조직도다
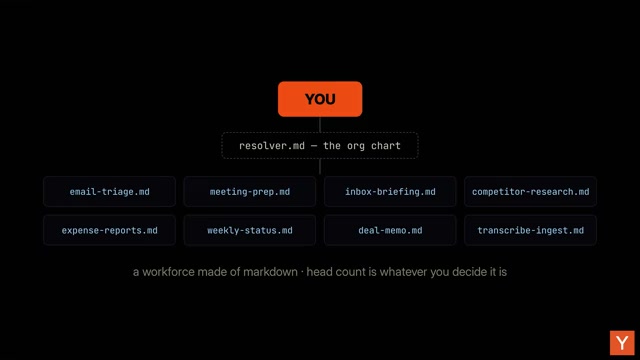
개인 라이브러리는 처음부터 거대한 시스템으로 시작하지 않는다. Tan의 설명에 따르면 처음에는 함께 일하는 회사와 자주 이메일을 주고받는 사람을 적은 Markdown 파일 몇 개뿐이었고, 매일 조금씩 커졌다. 중요한 것은 정보의 총량보다 각 작업이 어떤 파일과 절차를 불러야 하는지 정하는 구조다.
화면의 resolver.md — the org chart는 email-triage.md, meeting-prep.md, inbox-briefing.md, competitor-research.md, expense-reports.md, weekly-status.md, deal-memo.md, transcribe-ingest.md를 한 사람 아래에 배치한다. 여기서 “조직”은 실제 직원 수가 아니라 업무별로 분리된 실행 단위의 수다. 한 창업자가 여러 전문 에이전트를 조합해 일하는 회사의 형태를 보여준다.
[24:40] 10. 개인 AGI를 만드는 첫 세 단계
Tan은 다음 6분을 따라 하면 시청자 대부분보다 앞설 수 있다고 말하며 다섯 단계를 제시한다. 첫째, OpenClaw·Hermes Agent·Claude Code·Codex 등 자신의 컴퓨터에서 실행할 harness 하나를 고른다. 특정 제품이 정답이라는 뜻이 아니라, 모델을 기억·도구·절차와 연결할 실행면을 먼저 만들라는 의미다.
둘째, 이번 주말에 거대한 아카이브가 아니라 Markdown 폴더 하나를 만든다. 프로젝트와 사람마다 실제로 알고 있는 것, 함께 만드는 것, 상대가 중요하게 여기는 것, 내가 갚아야 할 것, 지난번에 들은 말을 한 페이지씩 적는다. 셋째, 매주 가장 싫어하는 업무 하나를 골라 똑똑한 동료에게 설명하듯 스킬 파일로 쓴다. 에이전트가 틀리면 예외와 규칙을 계속 추가해 그 페이지를 실행 가능한 직원으로 만든다.
[26:50] 11. 반복 작업을 예약하면 하루가 작업 단위가 아니다
넷째, 만든 스킬을 반복 작업으로 연결한다. “매일 아침 7시에 이것을 해라”, “매주 금요일에 저것을 요약해라”처럼 예약하면, 잠자는 동안 일이 끝난 경험이 작업의 단위를 바꾼다. Tan이 말하는 전환은 더 열심히 하루를 채우는 것이 아니라, 내가 상상하고 만들고 싶은 목표를 중심으로 에이전트의 시간을 배치하는 것이다.
다섯째 단계로 넘어가기 전 중요한 운영 원칙은, 한 번의 성공을 일회성 성공으로 끝내지 않는 것이다. 자동화가 실제로 반복될수록 예외·실패·검증 규칙이 드러나며, 그 정보가 다음 스킬 버전의 재료가 된다.
[28:42] 12. “Never do one-off work” — 배운 것을 스킬화하기
다섯째, 한 번의 작업을 끝낸 뒤 에이전트에게 방금 한 일을 스킬로 만들라고 요청한다. Tan은 이를 skillify라고 부르며, 스킬 파일을 추출하면 같은 문제를 다시 만났을 때 처음부터 맥락을 설명할 필요가 없다고 말한다. YC식 표현으로는 “무언가를 두 번 요청해야 한다면 이미 실패한 것”이다.
이 원칙의 핵심은 자동화 개수보다 학습의 잔존성이다. 작업이 끝날 때마다 입력·판단·예외·출력 검증을 남기면, 다음 작업은 새 대화가 아니라 누적된 시스템의 다음 버전이 된다.
[29:50] 13. 스킬 파일은 외부화된 인지이고, 소유권은 별도 문제다
Tan은 스킬 파일을 단순한 문서가 아니라 머릿속에서 추출해 기록하고 실행 가능하게 만든 인지라고 정의한다. 지원 엔지니어 Maya가 2년 동안 P0 장애 대응, 이탈 위험 고객의 진정, 재발 방지형 사후 보고서 작성 같은 40개 스킬을 만들었다고 하자. 그 파일이 Maya의 저장소에 있으면 이직할 때 함께 이동하고, 새 회사에서도 축적된 판단을 사용할 수 있다.
반대로 파일이 회사 저장소에만 있으면 Maya가 떠나도 회사는 그녀의 판단을 계속 실행하고, Maya에게는 아무것도 남지 않는다. 같은 파일과 같은 사람이라도 누가 저장소와 변경 이력을 통제하는지에 따라 축적이 경력이 되거나 인지의 추출이 된다. 발표가 “Own your skills”를 반복하는 이유다.
[32:35] 14. 개인 AGI는 “자기 힘 아래” 머무는 장치다
스피노자가 조건부 교수직을 거절한 이야기를 다시 가져오며, Tan은 그가 지키려 한 것을 “다른 사람의 힘 아래가 아니라 자기 힘 아래 있는 것”으로 해석한다. 1673년의 질문과 2026년의 질문은 다르지 않다. 내 행동 능력과 인지 능력을 누가 지휘하는가다.
그래서 발표의 한 문장 결론은 Personal AGI is how you stay under your own power in the age of agents다. 모델은 계속 바뀌어도 내 저장소의 라이브러리·스킬·절차는 이어질 수 있으므로, 플랫폼이나 인수자가 정책을 정하기 전에 자신이 통제하는 repo에 두라는 권고로 이어진다.
[33:50] 15. 세 가지 반론: 모델, RAG, 프라이버시
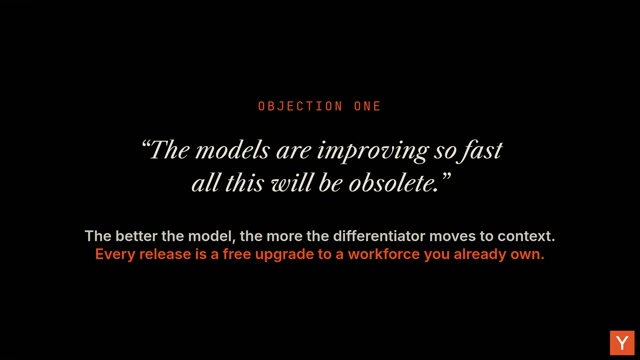
첫 번째 반론은 모델이 빠르게 좋아지니 harness와 스킬이 곧 낡는다는 것이다. Tan의 답은 모델이 좋아질수록 차별화 지점이 모델 가중치에서 맥락과 지도로 이동한다는 주장이다. 모두가 같은 천마력 엔진을 갖게 되면 경쟁은 운전자와 지도에서 벌어지고, 더 나은 모델은 내가 소유한 라이브러리를 더 잘 읽어 주는 무료 업그레이드가 된다.
두 번째로 RAG는 단순한 B-tree 같은 기본 요소일 뿐이며, 제품의 어려운 부분은 무엇을 기록하고 어떻게 보강·연결하며 무엇을 hot memory와 cold reference로 나누고 사실 충돌을 누가 중재하는가에 있다고 말한다. 세 번째로 삶 전체를 한 시스템에 넣었을 때 유출되면 어떡하느냐는 질문에는, 그래서 자기 인프라·자기 repo·자기 키로 custody를 가져야 한다고 답한다. 이는 영상의 설계 철학이지, 로컬 저장이 자동으로 프라이버시를 보장한다는 뜻은 아니다.
[35:36] 16. 강력한 도구를 공개해 격차를 줄이기
Tan은 harness, brain architecture, skills, 개인 운영체제를 오픈소스로 공개한 이유를 “강력한 도구는 주어져야 한다고 믿기 때문”이라고 설명한다. 과거의 사적 레버리지가 문해력, 그다음 자본이었다면 지금은 harness·library·Markdown으로 된 workforce라는 것이다. 이를 소수의 사제 계급만 갖고 있으면 격차가 커지고, 널리 풀면 르네상스가 된다는 대비다.
공개적으로 만들면 처음에는 비판과 조롱을 받지만, 시간이 지나면 비판하는 사람도 같은 도구를 만들고 쓰기 시작한다는 스피노자·라이프니츠 일화를 연결한다. “공개적으로 만들기”는 홍보 전략이라기보다, 개인 시스템을 여러 사람이 복제하고 개선할 수 있게 하는 분산 전략으로 제시된다.
[38:48] 17. 아픈 아이를 위해 만든 8만 개의 파일
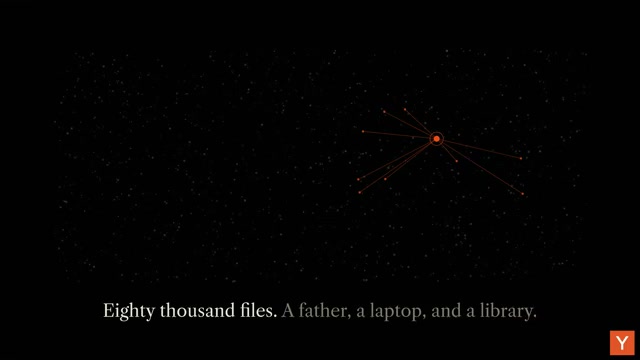
Tan은 희귀한 간질을 가진 아들을 위해 한 아버지가 약 8만 개의 Markdown 파일로 repo를 만들었다는 사례를 소개한다. 전문의 방문 기록, 논문, 발작 로그, 약물 상호작용을 색인·상호 연결해 새 의사가 아이디어를 냈을 때 과거에 이미 시도했는지 몇 분 안에 확인할 수 있게 했다는 설명이다.
그는 이것이 벤치마크나 데모가 아니라 사랑하는 한 사람에게 라이브러리와 사서를 연결한 개인 AGI라고 말한다. 의료 결정을 대신하라는 조언이 아니라, 중요한 개인 맥락을 조직해 전문가와의 판단을 더 잘 준비하는 사례로 읽어야 한다. 질환·치료 관련 내용은 영상의 일화이며 의료적 사실이나 치료 지침으로 검증된 것이 아니다.
[40:35] 18. “다 만들어진 것이라면, 이제 직접 만들 수 있다”
마지막 메시지는 “모든 것은 만들어진 것이고, 이제 당신이 그것을 만들 수 있다”는 문장이다. 과거에는 팀·자금·허가·자격을 모으기 전에는 만들 수 없었지만, 이제는 노트북과 이미 쌓아 둔 몇 년의 기록으로 시작할 수 있다고 말한다. 7,000명의 conatus가 중간 허가 없이 바로 작업으로 이어질 때 무엇이 만들어질지 아직 세상이 이해하지 못했다는 낙관적인 결론이다.
발표는 스피노자의 《윤리학》 마지막 문장으로 닫힌다. “모든 훌륭한 것은 어려운 만큼 드물다.” Tan의 재해석은 어려움 자체가 사라졌다는 뜻이 아니라, 이제 희소성은 도구 접근성이 아니라 실제로 자기 시스템을 만들고 계속 다듬는 사람의 선택에 달려 있다는 것이다.
부록 — 실전 체크리스트
- 내가 통제할 수 있는 로컬 또는 자체 인프라 기반 harness 하나를 고른다.
- 프로젝트·사람·결정·반복 업무를 적는 작은 Markdown 라이브러리부터 만든다.
- 매주 가장 싫어하는 작업 하나를 자연어 스킬 파일로 작성하고, 실패 사례를 규칙으로 되돌린다.
- 산술·조회·대규모 배치처럼 결정론적인 계산은 모델이 아니라 코드·SQL·데이터베이스로 보낸다.
- 하나의 스킬을 예약 작업에 연결하고, 실행 로그와 결과 검증을 남긴다.
- 작업이 끝날 때마다 배운 절차를
skillify해 다음 작업의 출발점으로 만든다. - 스킬·키·민감한 원문·백업의 소유권과 접근 경계를 먼저 정하고, 로컬이라는 이유만으로 안전하다고 가정하지 않는다.
- 영상의 생산성 배수와 스타 수를 성과 목표로 복사하지 말고, 내 업무에서 재현 가능한 개선을 측정한다.
관련 페이지
해석과 검증 범위
- 이 페이지는 Y Combinator 영상 한 편과 영어 원본 자동자막을 요약한 것이다. 한국어 자동자막은 HTTP 429로 확보하지 못했다.
400x,8x, YC 포트폴리오 성장, 약 22만 개의 개인 페이지,gstack의 스타 수·순위, 8만 개의 의료 연구 파일 등은 영상에서 발표자가 제시한 주장이다. 이번 작업에서 GitHub 지표·생산성·의료 사례를 독립 검증하지 않았다.- 자동자막의 명백한 오인식과 문장 경계는 문맥에 맞게 보정했다. 원문 전체는
raw/transcripts/2026-08-13-garry-tan-own-your-intelligence.en-orig.srt에 보존했다. - 영상 원본은 장면 검토 후 위키에 보관하지 않았고, 페이지에는 360p 검토본에서 추출한 캡처만 연결했다.
원문 인용 모음
- [07:45] “owned by you, not rented.” — 개인 지능의 소유권에 대한 결론.
- [16:56] “Fat skills, thin harness.” — 지식·절차와 실행면의 비대칭을 요약한 표현.
- [27:15] “Never do one-off work.” — 일회성 작업을 스킬로 환원하라는 원칙.
- [39:05] “Not a benchmark, not a demo.” — 아들을 위한 시스템 사례를 정의하는 표현.
- [40:22] 마지막 문장의 요지 — 이미 만들어진 제도에 따르기보다 직접 만들 수 있다는 행동 촉구.