출처: https://youtu.be/eAm9kuLmGDA · 길이: 19:38 · 채널: Tech Bridge 발표자: Frank P. Coyle, PhD — UC Berkeley 컴퓨터과학 강사 자막: 영상에 삽입된 한영 자막과 오디오를 로컬 Whisper large-v3-turbo로 전사한 영어 SRT를 대조해 정리했다.
개요
이 강연은 Anthropic의 Claude Certified Architect(CCA) 시험을 에이전틱 AI 시스템을 공부하는 실전 지도처럼 소개한다. 시험의 세부 조건을 외우는 것보다, 고객지원·코드 생성·멀티 에이전트·개발 생산성·CI/CD에서 반복되는 실패 패턴을 먼저 이해해야 한다는 것이 발표자의 관점이다.
핵심 메시지는 “에이전트를 더 많이 붙이면 된다”가 아니다. 모델 호출을 실행 루프로 감싸고, stop_reason을 해석하며, 역할별 도구와 컨텍스트를 격리하고, 긴 세션은 요약·압축해야 안정적인 시스템이 된다. 마지막 시나리오에서는 이 원칙을 헤드리스 CI/CD와 배치 실행으로 확장한다.
한눈에 보는 요약
- 컴퓨터과학이 더 이상 취업을 보장하는 “마법의 경로”가 아닌 상황에서, Coyle은 CCA 시험을 에이전틱 AI의 실제 설계 문제를 익히는 학습 지도처럼 제시한다.
- 안티패턴은 단순한 실패 목록이 아니라, 무엇을 설계해야 하는지 역으로 알려 주는 경계선이다. 만들고 실패하면서 지형을 파악하라는 학습 철학과 연결된다.
- 시험 영역은 에이전트 아키텍처·오케스트레이션(27%), Claude Code 설정·워크플로(20%), 프롬프트·구조화 출력(20%), 도구 설계·MCP 통합(18%), 컨텍스트 관리·신뢰성(15%)으로 제시된다.
- 여섯 생산 시나리오의 공통 해법은 반복 가능한 루프, 명시적인 종료 이유, 전문화된 에이전트, 제한된 컨텍스트, 검증 단계다.
- CI/CD에서는 사람에게 묻는 대화형 모드를 파이프라인에 넣지 말고, JSON으로 결과를 파싱하며, 기다릴 수 있는 작업은 배치로 보내 비용과 운영 부담을 낮춘다.
핵심 한 줄: 에이전트 시스템의 실력은 무엇을 할 수 있는지보다, 어디서 멈추고 무엇을 넘기지 않을지를 설계하는 데서 드러난다.
장면별 상세 설명
[00:00] 1. CCA 시험을 에이전틱 AI의 학습 지도로 보기
Coyle은 컴퓨터과학을 30년 넘게 가르쳤고 현재 Berkeley에서 학생들을 가르친다고 소개한다. 학생들이 AI 때문에 컴퓨터과학을 취업으로 가는 “마법의 경로”로 보기 어려워진 상황에서, 에이전틱 AI 시대에 필요한 학습법을 찾다가 Claude Certified Architect 시험을 접했다고 말한다.
발표 당시 설명에 따르면 이 시험은 시나리오 기반이며 시간 제한과 감독이 있고, Claude·Anthropic 생태계의 기업뿐 아니라 개인도 응시할 수 있다. 개인 응시료 99달러와 6개월마다 한 번이라는 조건은 영상 속 시점의 발표 내용이므로 현재 시험 정책으로 그대로 재사용하기보다 최신 공지를 다시 확인해야 한다.
[01:19] 2. 만들면서 배우고 안티패턴을 먼저 찾기
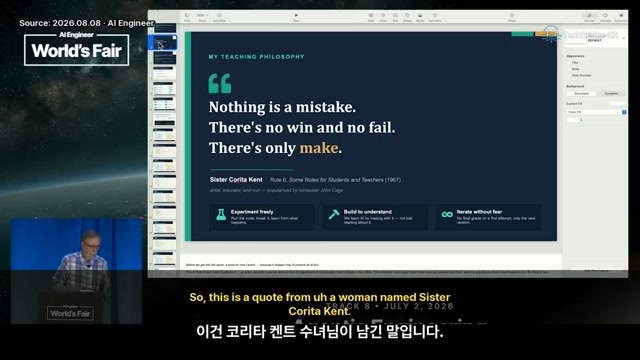
발표자는 Sister Corita Kent의 문장, “Nothing is a mistake. There’s no win and no fail. There’s only make.”를 자신의 교육 철학으로 소개한다. 읽는 데서 멈추지 말고 직접 만들며, 작동하지 않는 결과도 다음 실험을 위한 데이터로 삼으라는 뜻이다.
1990년대 객체지향 프로그래밍의 디자인 패턴처럼 이제는 에이전트에도 패턴이 생겼지만, 안티패턴을 아는 일이 무엇을 해야 하는지 알아내는 지름길이라고 강조한다. 이 강연이 정답 구현 하나보다 “하지 말아야 할 것”을 반복해서 보여 주는 이유다.
[02:25] 3. 막혔다는 것은 지형을 배웠다는 뜻
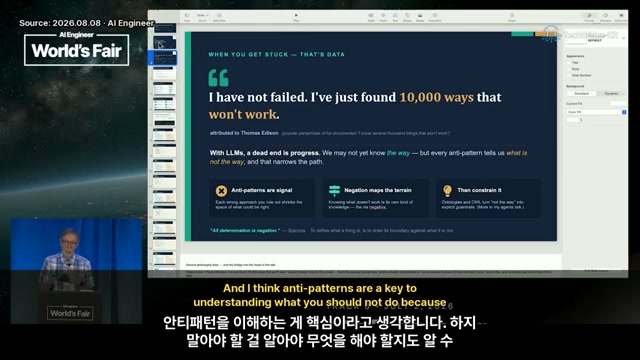
슬라이드는 에디슨의 “작동하지 않는 10,000가지 방법을 찾았다”는 말을 빌려, 막힌 상태를 실패가 아니라 탐색 데이터로 해석한다. LLM 시스템에서도 안티패턴은 단순히 금지할 목록이 아니라, 시스템이 어디에서 흔들리는지 보여 주는 navigation map이다.
CCA 시험은 단순 암기형 객관식이 아니라 현실적인 제약과 생산 환경 시나리오를 중심으로 구성된다고 설명한다. 따라서 문제를 풀 때도 “가능한 방법”을 전부 나열하기보다, 먼저 위험한 설계를 제거하는 방식이 유리하다는 메시지다.
[03:25] 4. CCA 시험의 다섯 영역
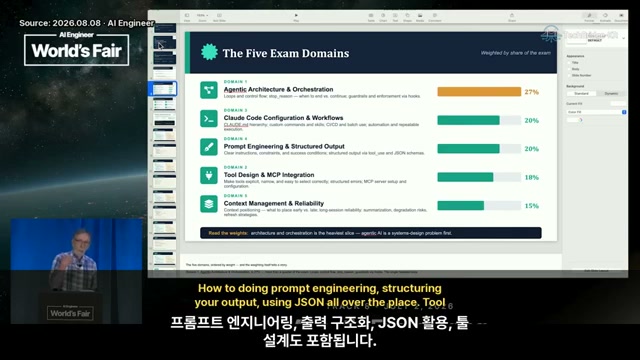
발표 슬라이드가 제시한 영역과 비중은 다음과 같다.
| 영역 | 비중 | 다루는 문제 |
|---|---|---|
| Agentic Architecture & Orchestration | 27% | 에이전트 루프, 위임, 오케스트레이션 |
| Claude Code Configuration & Workflows | 20% | CLAUDE.md, 설정 계층, 개발 워크플로 |
| Prompt Engineering & Structured Output | 20% | 프롬프트 구조, JSON 등 구조화 출력 |
| Tool Design & MCP Integration | 18% | 도구 인터페이스와 MCP 연결 |
| Context Management & Reliability | 15% | 컨텍스트 경계, 토큰, 실패·신뢰성 관리 |
이 비중은 시험의 현재 공식 명세라기보다 영상 발표 자료의 캡처다. 하지만 이후에 나오는 여섯 시나리오를 보면 아키텍처·도구·컨텍스트·신뢰성이 서로 분리된 과목이 아니라 하나의 실행 루프 안에서 함께 다뤄진다는 점이 드러난다.
[04:25] 5. 여섯 생산 시나리오와 공통된 질문
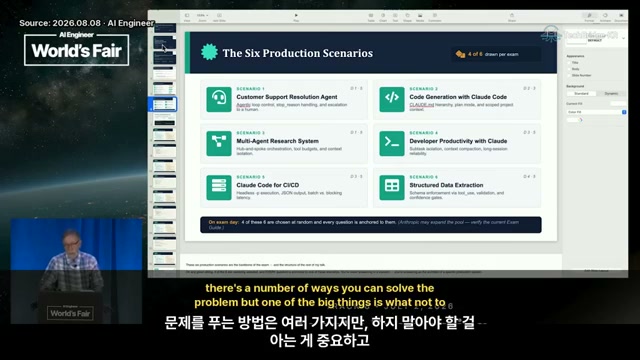
시험은 여섯 시나리오 중 네 개를 무작위로 골라 질문을 구성한다고 소개된다.
- Customer Support Resolution Agent
- Code Generation with Claude Code
- Multi-Agent Research System
- Developer Productivity with Claude
- Claude Code for CI/CD
- Structured Data Extraction
발표자는 각 문제를 해결하는 방법이 여러 개일 수 있지만, 큰 차이를 만드는 것은 “무엇을 하지 말아야 하는가”라고 말한다. 이 노트는 영상에서 실제로 설명한 첫 다섯 시나리오와 그 설계 원칙을 중심으로 정리한다.
[06:25] 6. 에이전트의 새 힘은 루프에서 나온다
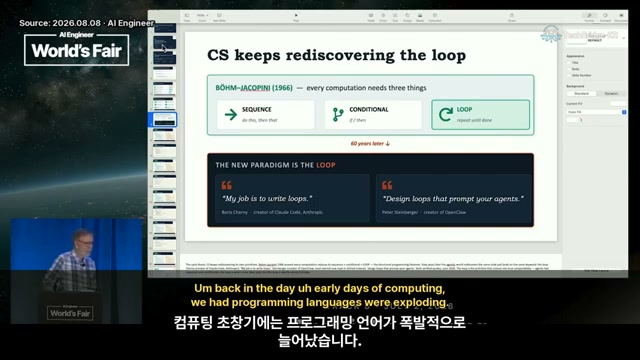
컴퓨터과학의 계산 모델은 순차 실행(sequence), 조건문(conditional), 반복(loop)이라는 세 요소만으로 충분하다는 Böhm–Jacopini 정리를 끌어온다. 오늘날 에이전트가 새로워 보이는 이유는 프롬프트를 한 번 생성하는 데 있지 않고, 모델 호출 → 도구 실행 → 결과 관찰 → 다음 호출을 반복하는 루프가 생겼기 때문이다.
이 관점은 loop-engineering과 맞닿아 있다. 모델을 “답을 내는 챗봇”으로만 보지 않고, 종료 조건·재시도·검증·비용 상한을 갖춘 작은 실행 시스템으로 설계해야 한다는 뜻이다.
[07:38] 7. 고객지원 에이전트: stop_reason을 해석하는 루프
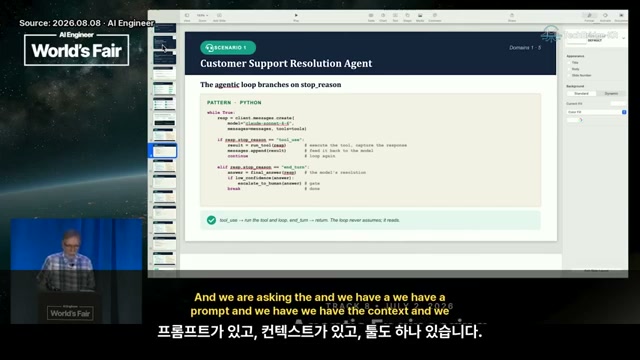
첫 시나리오의 안티패턴은 모델이 낸 응답을 곧바로 최종 답변처럼 사용하는 것이다. LLM은 도구를 직접 실행하지 않고, 현재 메시지·프롬프트·컨텍스트·도구 정의를 바탕으로 어떤 도구를 어떤 인자로 호출할지를 말할 뿐이다. 실행은 호스트 프로그램의 책임이다.
따라서 제어 루프는 대략 다음처럼 stop_reason을 분기해야 한다.
while True:
    response = call_model(messages, tools=tools)
    if response.stop_reason == "tool_use":
        messages += [response, run_requested_tools(response)]
        continue
breaktool_use면 도구 결과를 다시 컨텍스트에 넣고 반복하고, 정상 종료면 신뢰도 검사를 거친다. 신뢰도가 낮으면 사람에게 에스컬레이션하며, max_tokens처럼 불완전한 종료 이유도 정상 답변으로 오인하지 말고 별도 복구 경로를 둬야 한다.
[11:02] 8. Claude Code: 규칙은 올바른 계층에 둔다
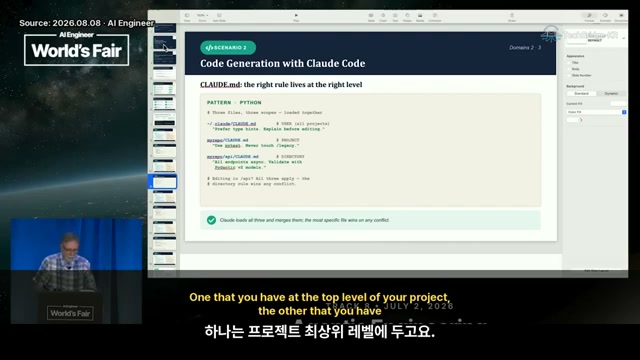
코드 생성 시나리오에서는 CLAUDE.md를 프로젝트의 규칙과 작업 지침을 담는 Markdown 파일로 소개한다. 발표자가 강조한 패턴은 모든 규칙을 한 파일에 몰아넣는 것이 아니라 프로젝트 최상위, 프로젝트 폴더, 더 깊은 디렉터리에 각각 해당 범위의 규칙을 두는 것이다.
범위가 좁은 디렉터리의 규칙은 그 코드에만 필요한 맥락을 제공하고, 상위 규칙은 공통 원칙을 담당한다. 이렇게 하면 에이전트가 매번 거대한 전역 지침을 읽지 않아도 되고, 변경하는 코드와 가까운 곳에서 규칙을 함께 유지할 수 있다. 구체적인 현재 Claude Code 동작은 moc-claude-code의 관련 문서와 최신 공식 문서를 함께 확인할 대상이다.
[12:01] 9. 멀티 에이전트: 한 명에게 모든 도구를 주지 않기
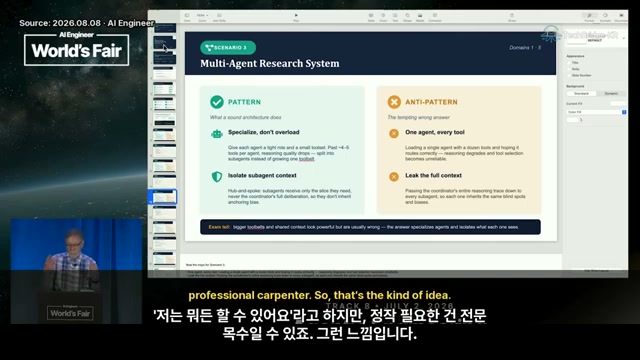
멀티 에이전트 연구 시스템의 대표 안티패턴은 한 에이전트에게 검색·코딩·파일·분석 등 모든 도구를 주고 “뭐든 해 보라”고 하는 것이다. 발표자는 배관·목공·전기 공구를 모두 들고 온 목수의 비유로 이를 설명한다. 기능이 많아지는 것이 전문성이나 안정성을 보장하지 않는다.
대신 각 에이전트에 한 가지 역할과 한두 개의 필요한 도구만 준다. 전문화된 에이전트는 입력과 출력이 단순해지고, 오케스트레이터는 각 결과를 비교·조합하는 일에 집중할 수 있다. 또한 서브에이전트의 전체 컨텍스트를 주 컨텍스트로 흘려보내지 않아야 한다. 토큰 비용이 늘고 모델이 관련 없는 정보에 끌려가기 때문이다.
[13:27] 10. 서브에이전트에는 ‘한 조각’만 전달하기
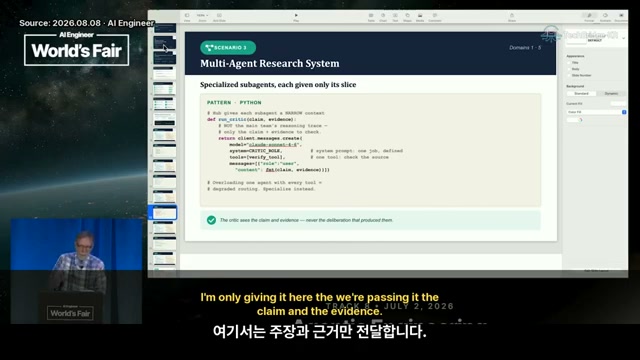
발표자는 연구 결과를 검증하는 critic 에이전트에 주장(claim)과 근거(evidence) 만 전달하는 예를 보여 준다. 그 주장을 만든 에이전트의 장황한 사고 과정이나 다른 작업의 기록까지 넘기지 않는 것이다. 컨텍스트를 필요한 만큼만 자르면 비용과 혼란을 동시에 줄일 수 있다.
각 에이전트는 자기 몫의 “피자 한 조각”을 독립적으로 처리해야 한다. 모든 에이전트가 서로의 결론을 그대로 읽고 대화하게 하면 집단사고처럼 하나의 결론으로 수렴할 수 있으므로, 독립적인 검토 결과를 모은 뒤 상위 에이전트가 비교·종합하는 구조가 더 낫다는 주장이다. 이 원칙은 moc-ai-agents의 오케스트레이션·하네스 노트와 연결된다.
[15:01] 11. 개발 생산성: 서브태스크 출력과 메인 세션을 격리하기
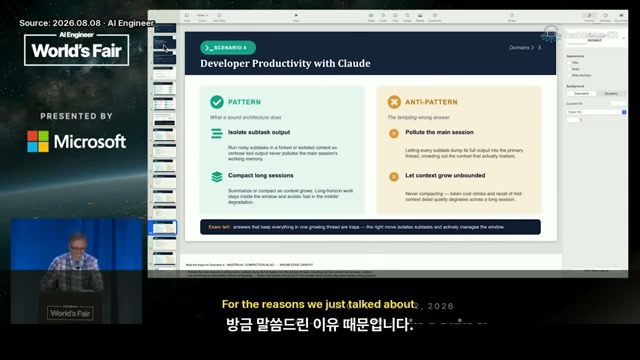
개발 생산성 시나리오의 안티패턴은 모든 서브태스크의 전체 출력을 주 스레드에 붙여 넣어 메인 컨텍스트를 계속 부풀리는 것이다. 화면은 이를 Pollute the main session, Let context grow unbounded로 표시한다.
권장 패턴은 서브태스크를 격리하고, 긴 세션은 압축하며, 메인 에이전트에는 필요한 결과만 돌려주는 것이다. 컨텍스트 크기는 단순한 저장 공간이 아니라 비용과 주의력의 예산이므로, “컨텍스트 창이 크니 다 넣어도 된다”는 생각 자체가 안티패턴이 될 수 있다.
[16:13] 12. context fork로 로그를 읽고 요약만 되돌리기
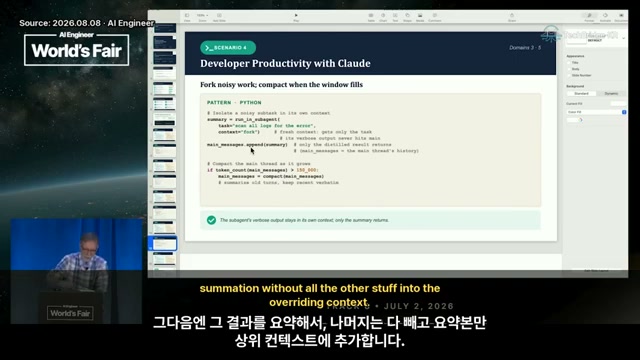
화면의 패턴은 “모든 로그에서 오류를 찾아라”는 작업을 별도의 context fork에서 수행한 뒤, 원래 세션에는 긴 탐색 과정이 아닌 요약만 추가하는 흐름이다. 포크 안에서 에이전트가 읽고 생각하며 만든 토큰은 메인 컨텍스트를 오염시키지 않는다.
발표자는 토큰 수를 관찰하다가 예시로 150,000토큰 이상이면 compact를 실행하는 기준을 언급한다. 이는 보편적인 임계값이 아니라 강연자의 예시다. Anthropic과 Claude에 컨텍스트 압축 기능이 있다는 설명도 구체적인 내부 구현을 확인한 것은 아니므로, 실제 적용에서는 작업별 요약 품질과 정보 손실을 평가해야 한다.
[17:54] 13. Claude Code CI/CD: 헤드리스·JSON·배치
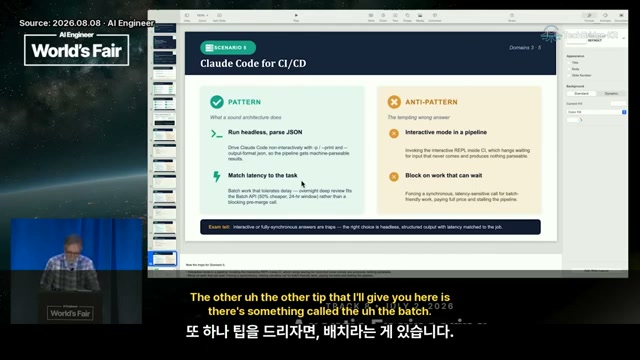
CI/CD 파이프라인에서 대화형 모드를 항상 켜 두는 것은 위험하다. 에이전트가 “이 작업을 해도 되나요?”라고 사람의 응답을 기다리면 파이프라인이 멈추기 때문이다. 발표자가 제시한 패턴은 헤드리스 실행과 JSON 파싱, 그리고 작업 성격에 맞춘 지연시간 선택이다. 즉 파이프라인이 해석할 수 있는 구조화 결과를 내고, 사람의 즉시 승인을 요구하지 않는 경로를 만든다.
지금 당장 결과가 필요하지 않은 작업은 배치로 보낼 수도 있다. 발표자는 영상에서 배치가 토큰 비용을 50% 낮추고 24시간 이내 결과를 약속한다고 설명했지만, 이는 영상 속 상품 조건에 대한 주장이다. 실제 비용·지연시간·지원 옵션은 현재 API 문서를 확인해야 한다.
[19:05] 14. 결론: 시험보다 중요한 것은 만들고 검증하는 습관
마지막 슬라이드는 처음의 문장을 다시 가져온다. 에이전트 설계에서 정답을 한 번에 맞히는 것보다, 작은 시스템을 만들고 실패 이유를 읽고, 루프의 종료 조건과 컨텍스트 경계를 고치는 반복이 중요하다는 결론이다. CCA 시험을 준비한다면 시나리오별 안티패턴을 외우는 데 그치지 말고, 실제로 작은 도구 호출 루프·전문화된 서브에이전트·헤드리스 파이프라인을 만들어 보는 편이 강연의 취지에 가깝다.
부록 — 실전 체크리스트
- 모든 모델 응답에서
tool_use, 정상 종료, 토큰 한도 초과를 구분하고 각각의 복구 경로를 정의했는가? - 에이전트마다 단일 역할과 최소한의 도구를 부여하고, 서브에이전트 컨텍스트를 메인 세션과 격리했는가?
- 프로젝트·디렉터리별 규칙을 적절한
CLAUDE.md계층에 두고, 거대한 전역 지침을 피했는가? - 긴 작업은
context fork와 요약을 사용하고, 토큰 수·압축 시점·요약 손실을 관찰하는가? - CI/CD는 헤드리스·구조화 출력으로 실행하며, 즉시성이 필요 없는 작업은 배치 경로로 분리했는가?
해석과 검증 범위
- 이 페이지는 Tech Bridge의 19분 38초 강연 한 편을 요약한 것이다. CCA 시험의 가격·주기·영역 비중, Claude의 배치·압축 기능과 비용 절감 수치는 영상 발표와 슬라이드의 주장으로 기록했으며 독립 검증하지 않았다.
- YouTube 자동 자막 엔드포인트가 작업 환경에서 429를 반환해, 오디오를 캐시된 Whisper large-v3-turbo로 전사한 영어 SRT를 raw에 보존했다. 장면별 캡처는 360p 영상을 직접 추출하고, 영상에 삽입된 영어·한국어 자막과 화면 슬라이드를 대조해 통과시켰다.
150,000토큰 임계값과 배치50%절감·24시간조건은 모든 환경의 권장값이 아니라 발표자가 든 예시·상품 주장이다. 실제 운영에서는 현재 공식 문서와 자신의 비용·지연시간 측정으로 다시 판단해야 한다.
관련 페이지
원문 인용 모음
- [01:27] “Nothing is a mistake. There’s no win and no fail. There’s only make.”
- [02:16] “Understanding what you should not do is the key to leading you to what you should do.”
- [07:49] “What you want to do is you want to loop with something called the stop reason.”
- [09:03] “The LLM is not executing these tools.”
- [12:48] “Specialize. Don’t overload.”
- [14:44] “Every agent gets its own slice.”
- [15:06] “Let every subtask dump its full output into the primary thread.”
- [18:03] “Always have interactive modes in a pipeline. No, no, no.”