출처: https://youtu.be/Z6sltgRAkWU · 길이: 1:24:53 · 채널: AI Frontier Korea (노정석) 출연: 박준우(미시간대학교 박사과정), 김태환(MIT 박사과정 예정), 이진원(HyperAccel CTO) 자막: YouTube 자동 생성 한국어 자막. 고유명사와 명백한 음성인식 오류는 문맥에 맞게 보정했다.
개요
이 영상은 AI 데이터센터의 병목이 계산(compute)에서 메모리, 다시 칩과 칩 사이의 데이터 이동(inter-communication)으로 확장되는 과정을 설명한다. 해법으로는 구리선이 담당하던 링크를 칩 가까이까지 광학으로 옮기는 실리콘 포토닉스, 여러 파장을 한 광섬유에 싣는 WDM, 그리고 사람이 직관으로 설계하기 어려운 포토닉스 구조를 AI가 탐색하는 inverse design이 제시된다.
발표의 중요한 결론은 “좋은 시뮬레이션 결과를 뽑는 것”만으로는 부족하다는 데 있다. 제조 가능한 구조를 만들고, fabrication·측정 결과를 다시 모델의 학습 데이터로 넣어 성능·제조성·해석가능성이 함께 좋아지는 폐쇄 루프를 만들어야 한다. 영상 속 기업 사례와 시장 수치는 출연자·슬라이드가 제시한 설명으로, 별도 검증하지 않았다.
한눈에 보는 요약
- AI 모델이 커질수록 병목은 연산량 자체에서 메모리 접근, 그리고 가속기·칩·랙 사이의 데이터 이동으로 이동한다.
scale-up은 칩↔칩/패키지·랙 내부,scale-out은 랙↔랙,scale-across는 데이터센터↔데이터센터를 뜻하며, 현재 광학의 장점은 주로 긴 링크에서 살아난다.- 구리선은 주파수를 높일수록 손실과 보상 회로 전력이 커진다. 광학을 ASIC 가까이 옮기면 energy per bit와 shoreline 제약을 줄일 수 있지만 열·수율·서비스성·생태계 문제가 따라온다.
- 실리콘 포토닉스는 켜진 레이저의 빛에 모듈레이터로 비트를 싣고, 수신단의 디텍터가 다시 전기 신호로 바꾸는 구조다. 실리콘은 직접 빛을 만들기 어려워 III-V 통합이나 외부 레이저가 필요하다.
- WDM은 하나의 waveguide·fiber에 여러 파장을 동시에 보내는 “추가 축”이다. MUX/DEMUX와 wavelength locking을 통해 채널 수를 늘리고 shoreline density를 개선한다.
- inverse design은 목표 광학 기능만 지정하고 기하 구조를 최적화하므로 사람이 직관적으로 만들기 어려운, 작고 고성능인 구조를 찾을 수 있다. 대신 자유형 구조의 제조 오차와 원인 분석이 어렵다.
- 좋은 설계와 나쁜 설계를 모두 archive하고, cVAE prior·물리 시뮬레이션·fabrication·측정을 연결하면 더 빠르고 제조 가능한 차세대 설계 루프가 된다.
핵심 한 줄: AI 시대의 다음 반도체 경쟁은 더 빠른 계산만이 아니라, 데이터를 칩 가까이에서 더 싸고 촘촘하게 옮기고 그 광학 회로를 스스로 개선하는 제조 루프를 갖추는 데 있다.
장면별 상세 설명
[00:58] 1. From Memory to Photonics — 문제의 무대
오프닝 슬라이드는 “AI scaling의 다음 병목을 data movement 관점에서 살펴본다”고 선언한다. 진행자는 이전 에피소드에서 다룬 compute-bound와 memory-bound를 다시 꺼내며, 랙 안은 구리선, 랙과 랙·데이터센터·인터넷은 광학으로 연결한다는 기존의 구분을 소개한다.
이번 대화의 질문은 그 경계를 chip-to-chip까지 당길 수 있는가다. 광학을 칩 사이의 짧은 링크에 적용하면 지금보다 높은 bandwidth를 얻을 수 있고, 이것이 silicon photonics가 주목받는 이유다.
[05:20] 2. 세 가지 병목: Compute, Memory, Inter-Communication
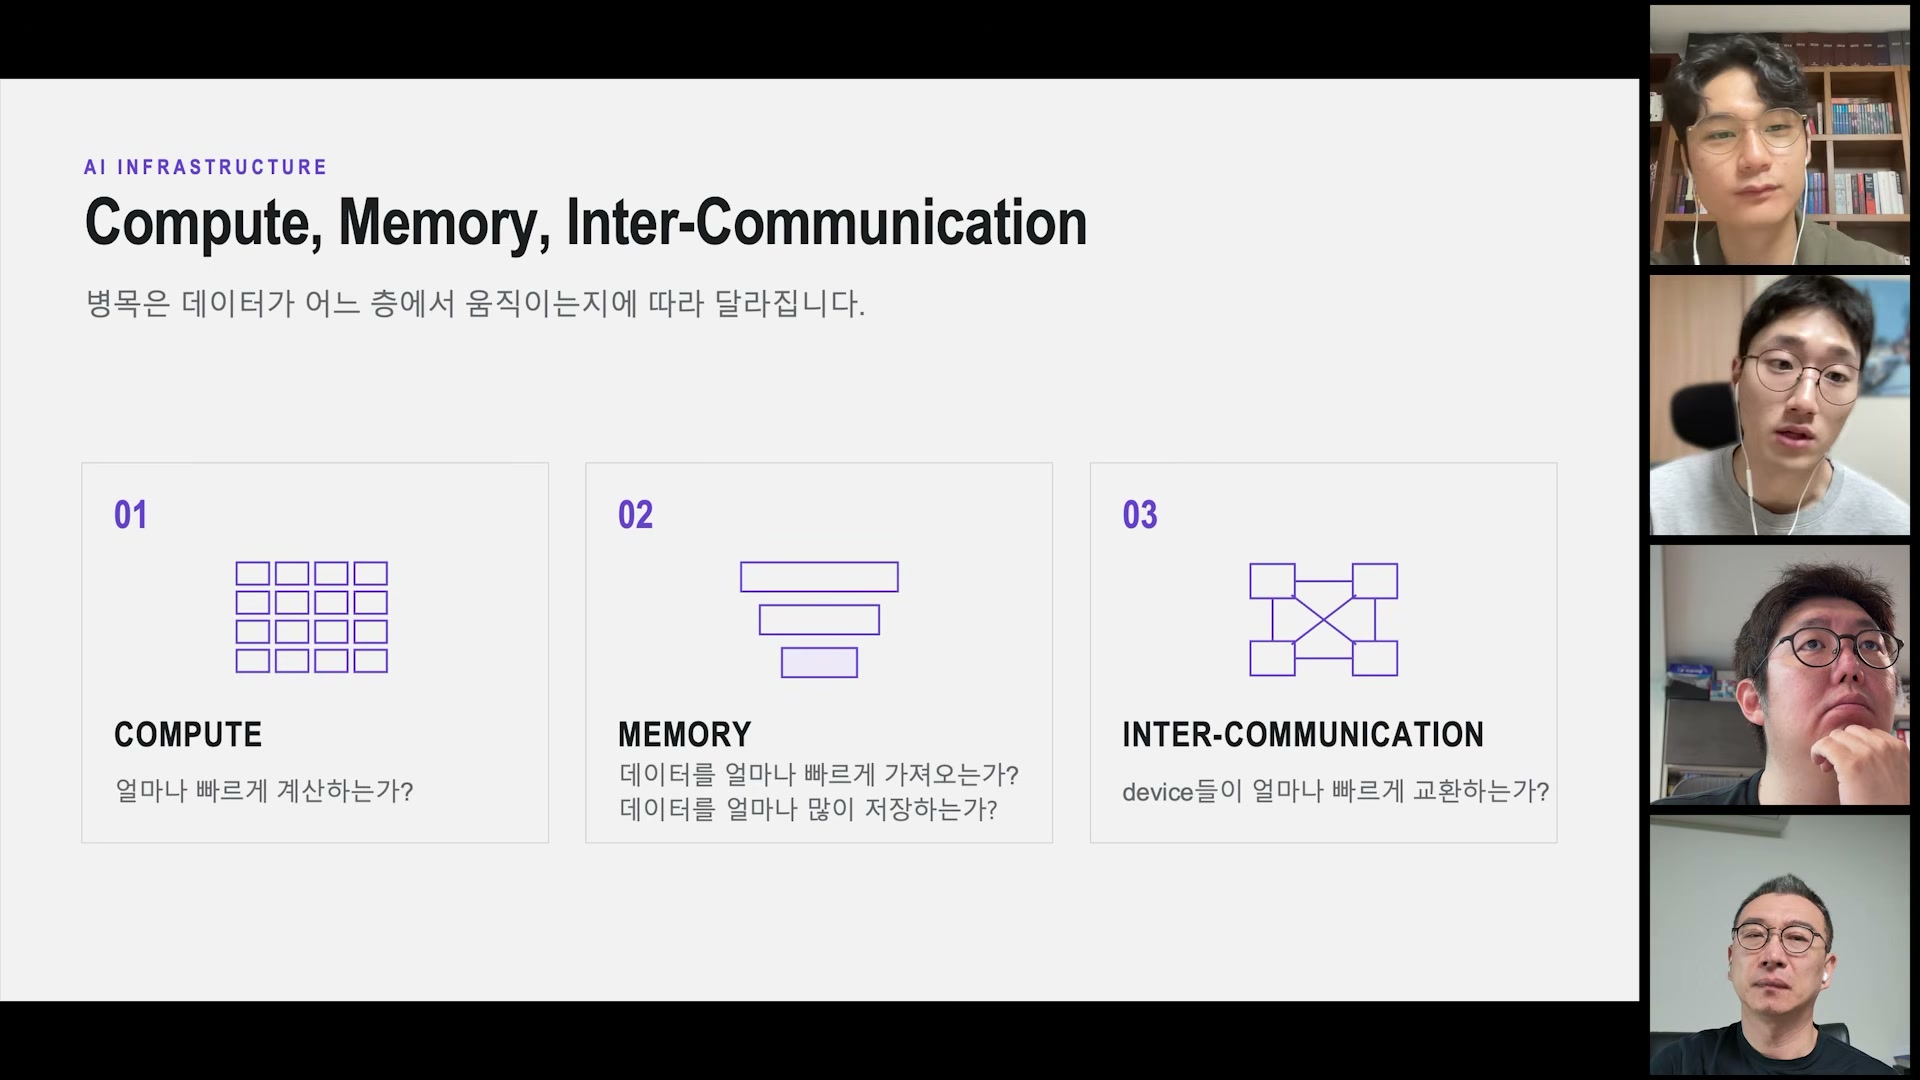
화면은 병목을 compute, memory, inter-communication 세 층으로 나눈다. 하나의 가속기 안에서도 matrix unit에서 registers, on-chip SRAM, L2 cache, HBM으로 갈수록 데이터는 멀어지고 접근 에너지와 지연이 커진다. Naive attention은 중간 tensor를 HBM에 쓰고 다시 읽어 데이터 이동이 runtime을 지배할 수 있지만, FlashAttention은 tile을 SRAM에 유지해 HBM 접근을 입출력으로 제한한다.
모델이 하나의 가속기를 넘어 서버·랙·데이터센터로 커지면 이 문제는 단순한 메모리 접근이 아니라 분산된 장치 사이의 통신 문제가 된다. 즉 빠른 계산 장치만 추가하는 scale-out은 데이터 이동 비용을 함께 키울 수 있다.
[07:25] 3. Scale-up, Scale-out, Scale-across
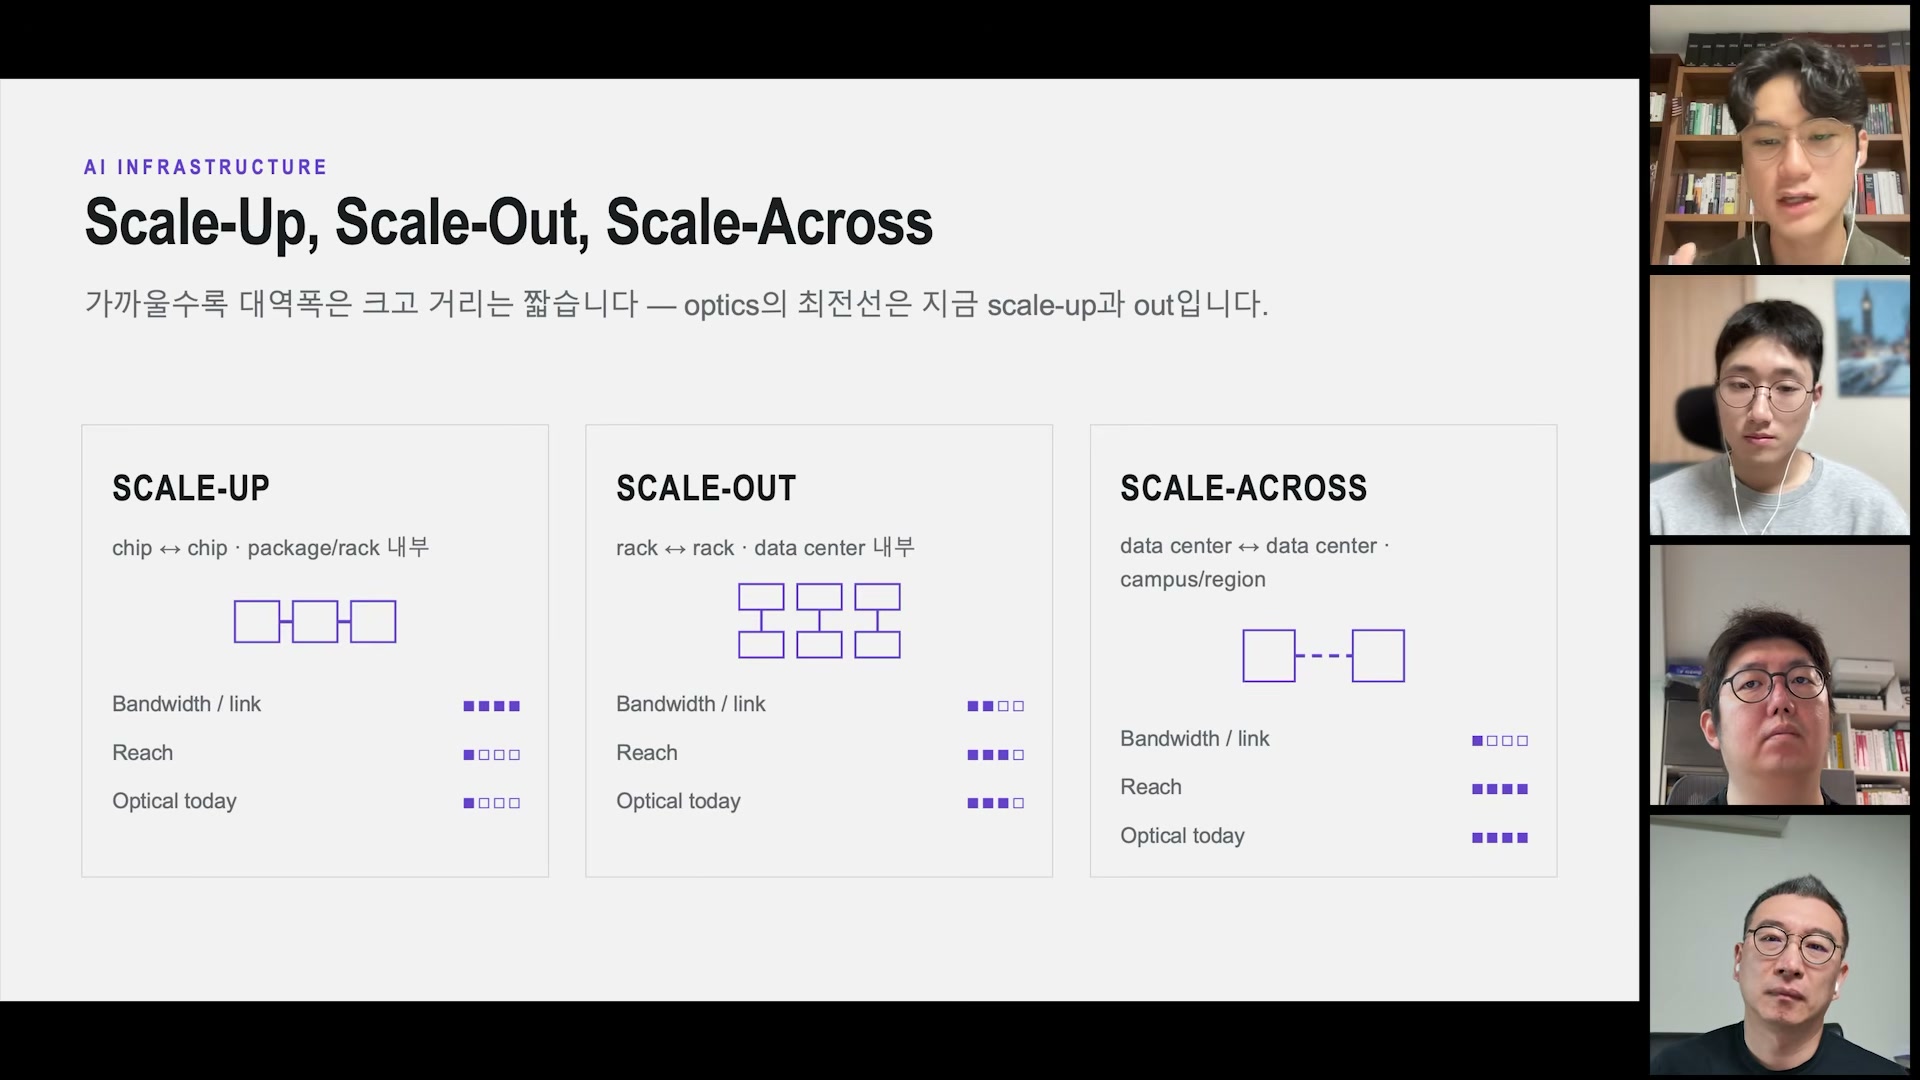
Scale-up은 chip↔chip, package/rack 내부의 짧고 높은 bandwidth 링크다. Scale-out은 rack↔rack, 데이터센터 내부의 확장이고, scale-across는 데이터센터↔데이터센터처럼 campus·region 단위의 연결이다. 가까운 링크일수록 높은 bandwidth가 필요하고, 먼 링크일수록 reach가 중요해진다.
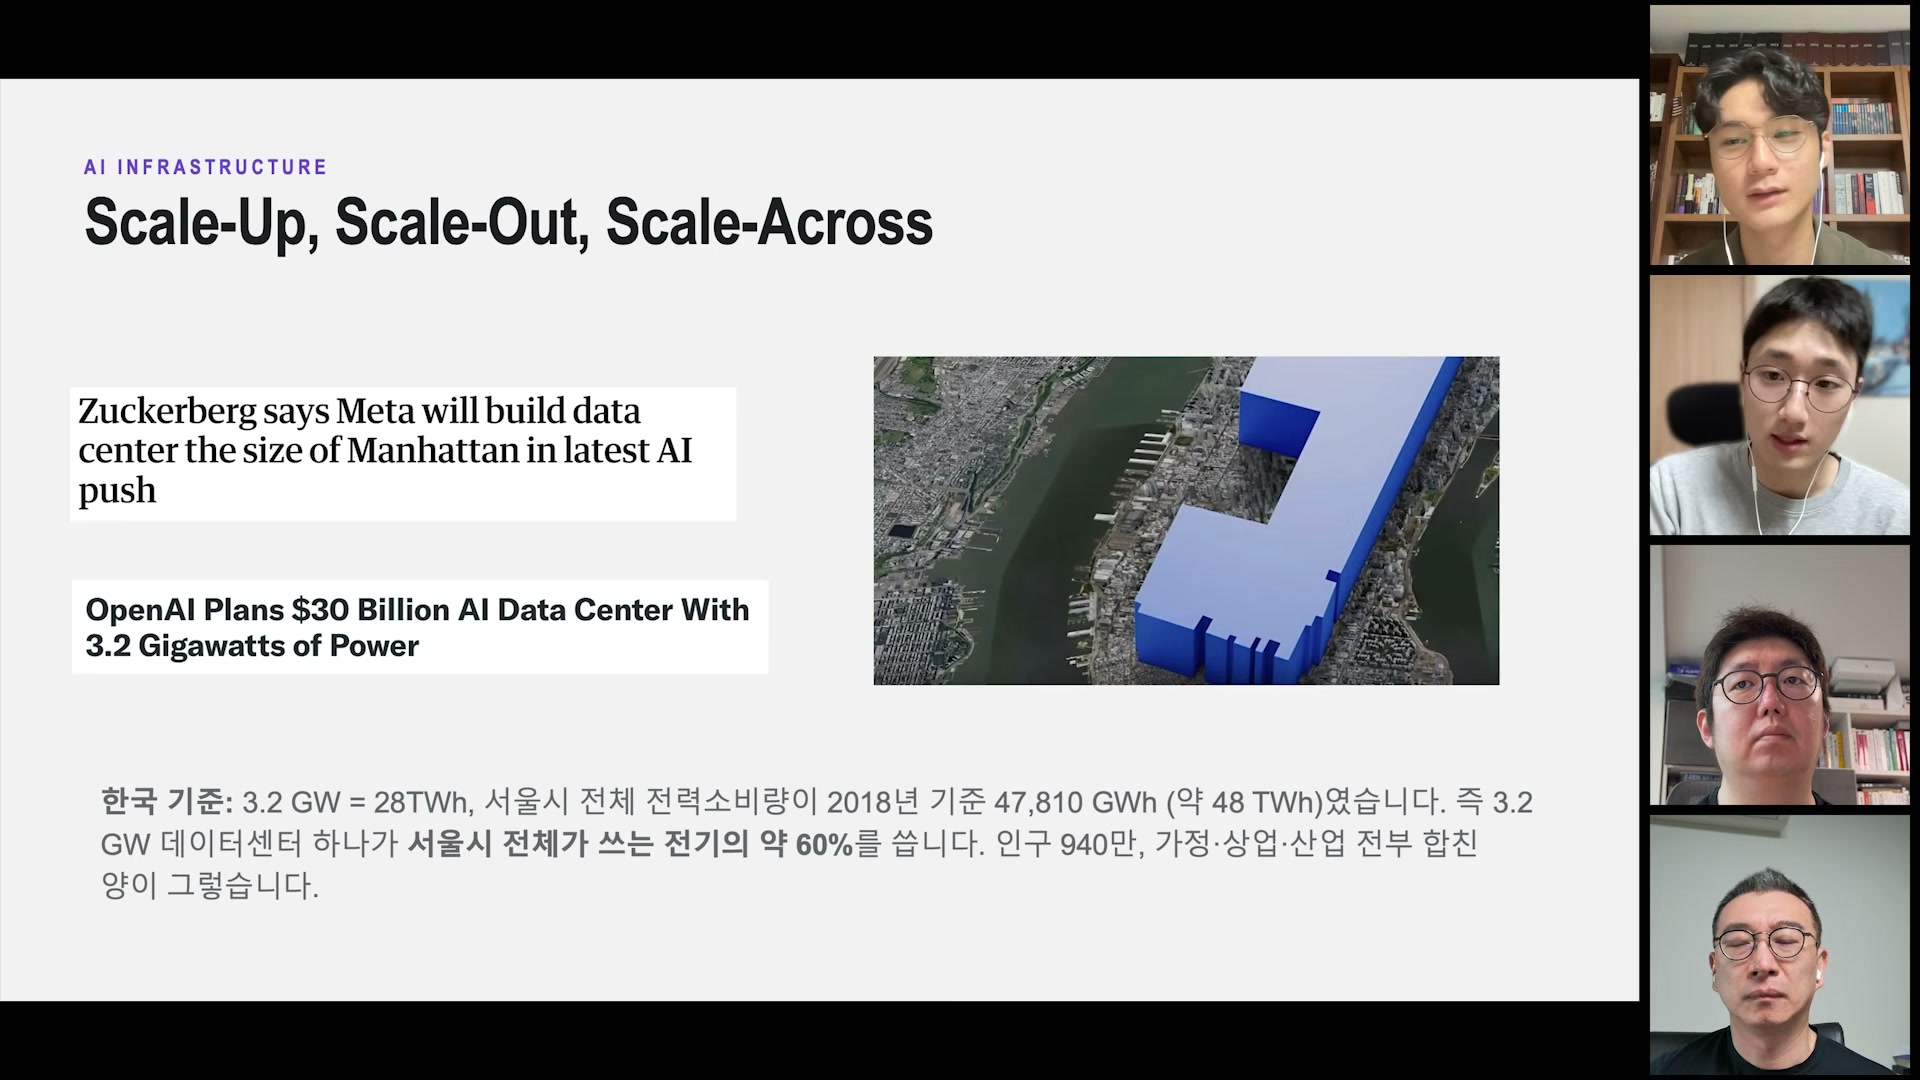
화면의 사례처럼 데이터센터가 도시 규모로 커지면 “가속기 하나를 빠르게 만드는 문제”가 “수많은 가속기가 데이터를 얼마나 빨리 교환하는가”로 바뀐다. 발표자들은 이 세 범위를 분리해서 봐야 어느 지점에 구리선과 광학을 배치할지 판단할 수 있다고 설명한다.
[10:34] 4. 구리선의 한계는 거리와 전력에서 온다
구리선은 짧은 거리에서는 저렴하고 익숙하지만, 주파수를 올려 bandwidth를 높이면 skin effect와 dielectric loss 때문에 signal loss가 빠르게 커진다. 일정 지점을 넘으면 retimer, equalization, FEC, DSP 같은 보상 회로가 필요해지고, 신호를 살리는 전력이 다시 열과 reliability 문제로 돌아온다.
광학 링크는 일정 거리 이상에서 신호 손실과 energy per bit가 더 유리해진다. 다만 광학 엔진과 전기·광 변환 회로가 추가되므로 “항상 광학이 더 낫다”가 아니라, 링크 길이·필요 bandwidth·패키지 위치에 따라 경제성이 달라진다.
[13:55] 5. Where Copper Runs Out — 손실을 고치는 비용
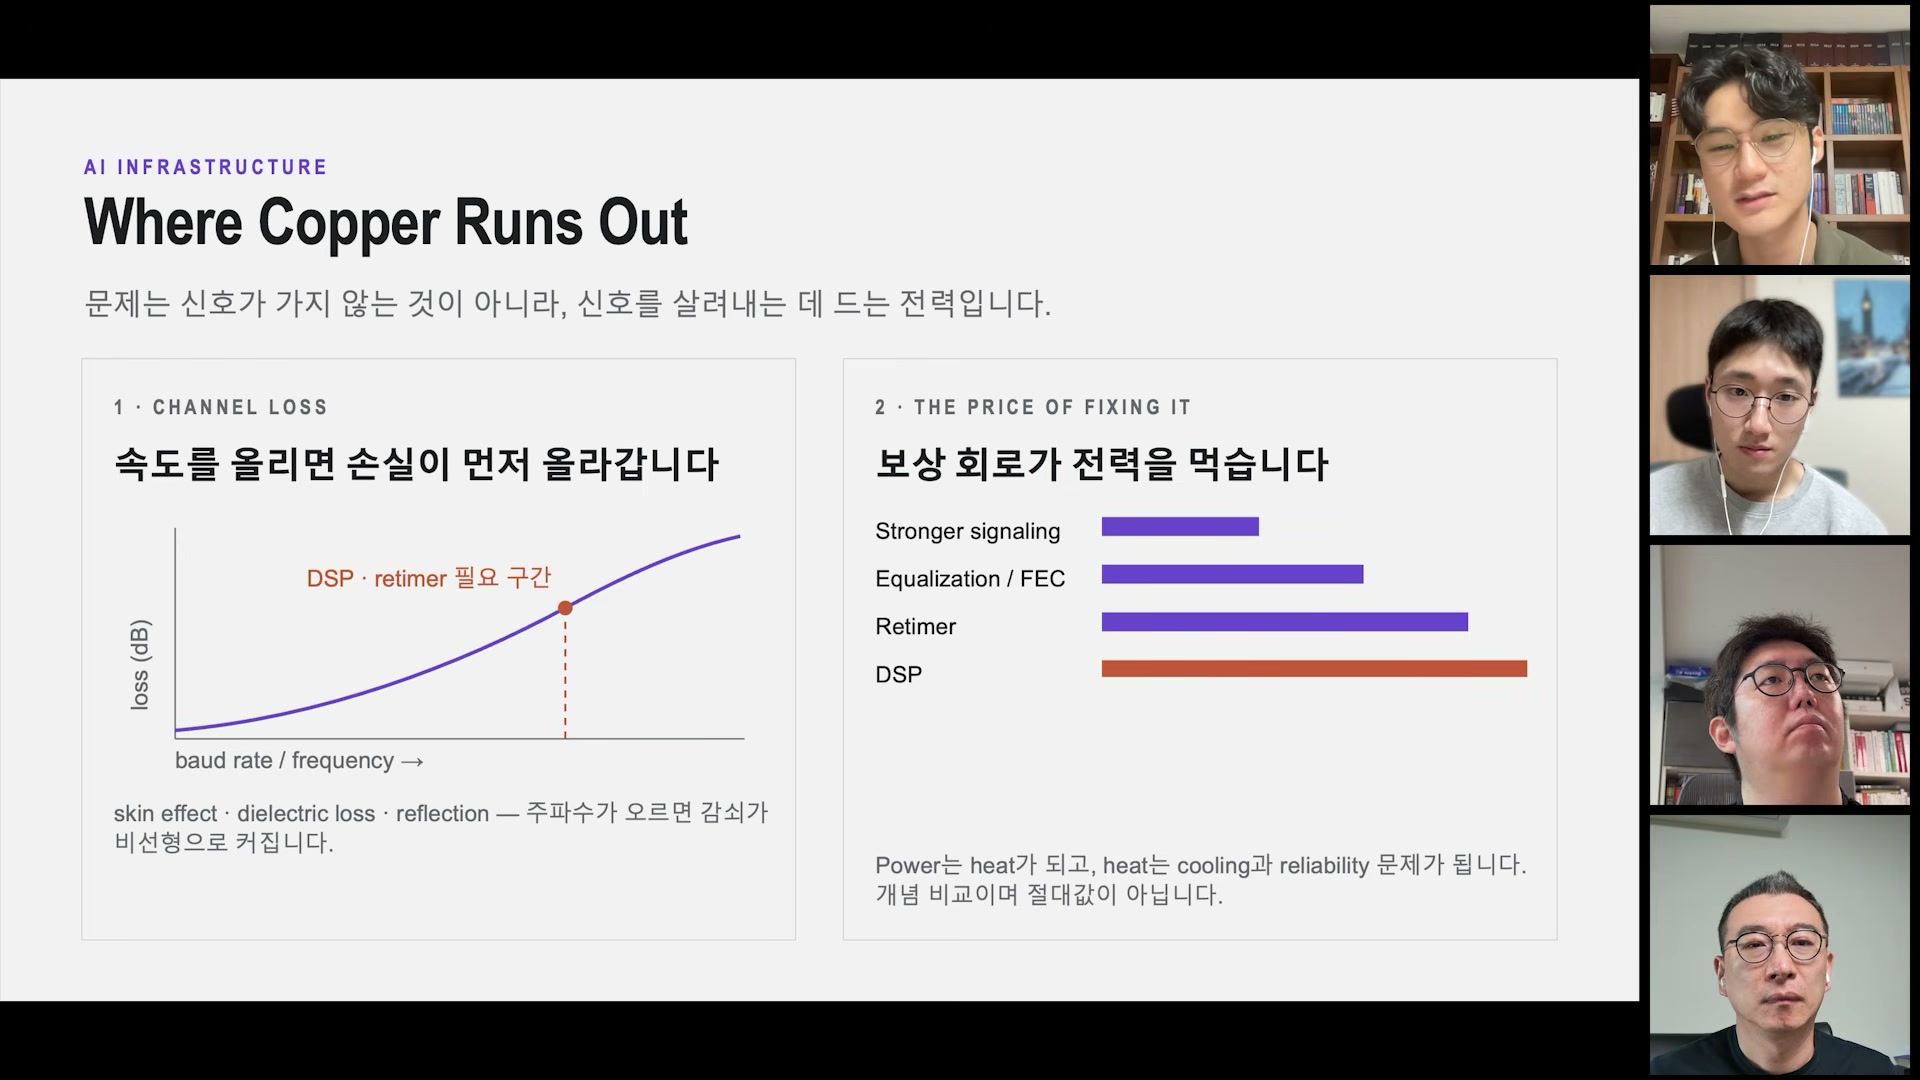
슬라이드는 “문제는 신호가 가지 않는 것이 아니라, 신호를 살려내는 데 드는 전력”이라고 요약한다. 왼쪽 그래프처럼 baud rate/frequency가 높아질수록 loss가 증가하고, DSP·retimer가 필요한 구간에 들어선다. 오른쪽에는 stronger signaling, equalization/FEC, retimer, DSP가 점점 큰 전력 비용을 요구하는 모습이 표시된다.
따라서 copper의 한계는 단순한 물리적 도달거리만이 아니다. 신호를 복구하기 위한 회로, 냉각, 전력 공급, reliability까지 합친 시스템 비용이 병목이 된다.
[16:50] 6. 전기에서 빛으로 바뀌는 경계가 칩 쪽으로 이동한다
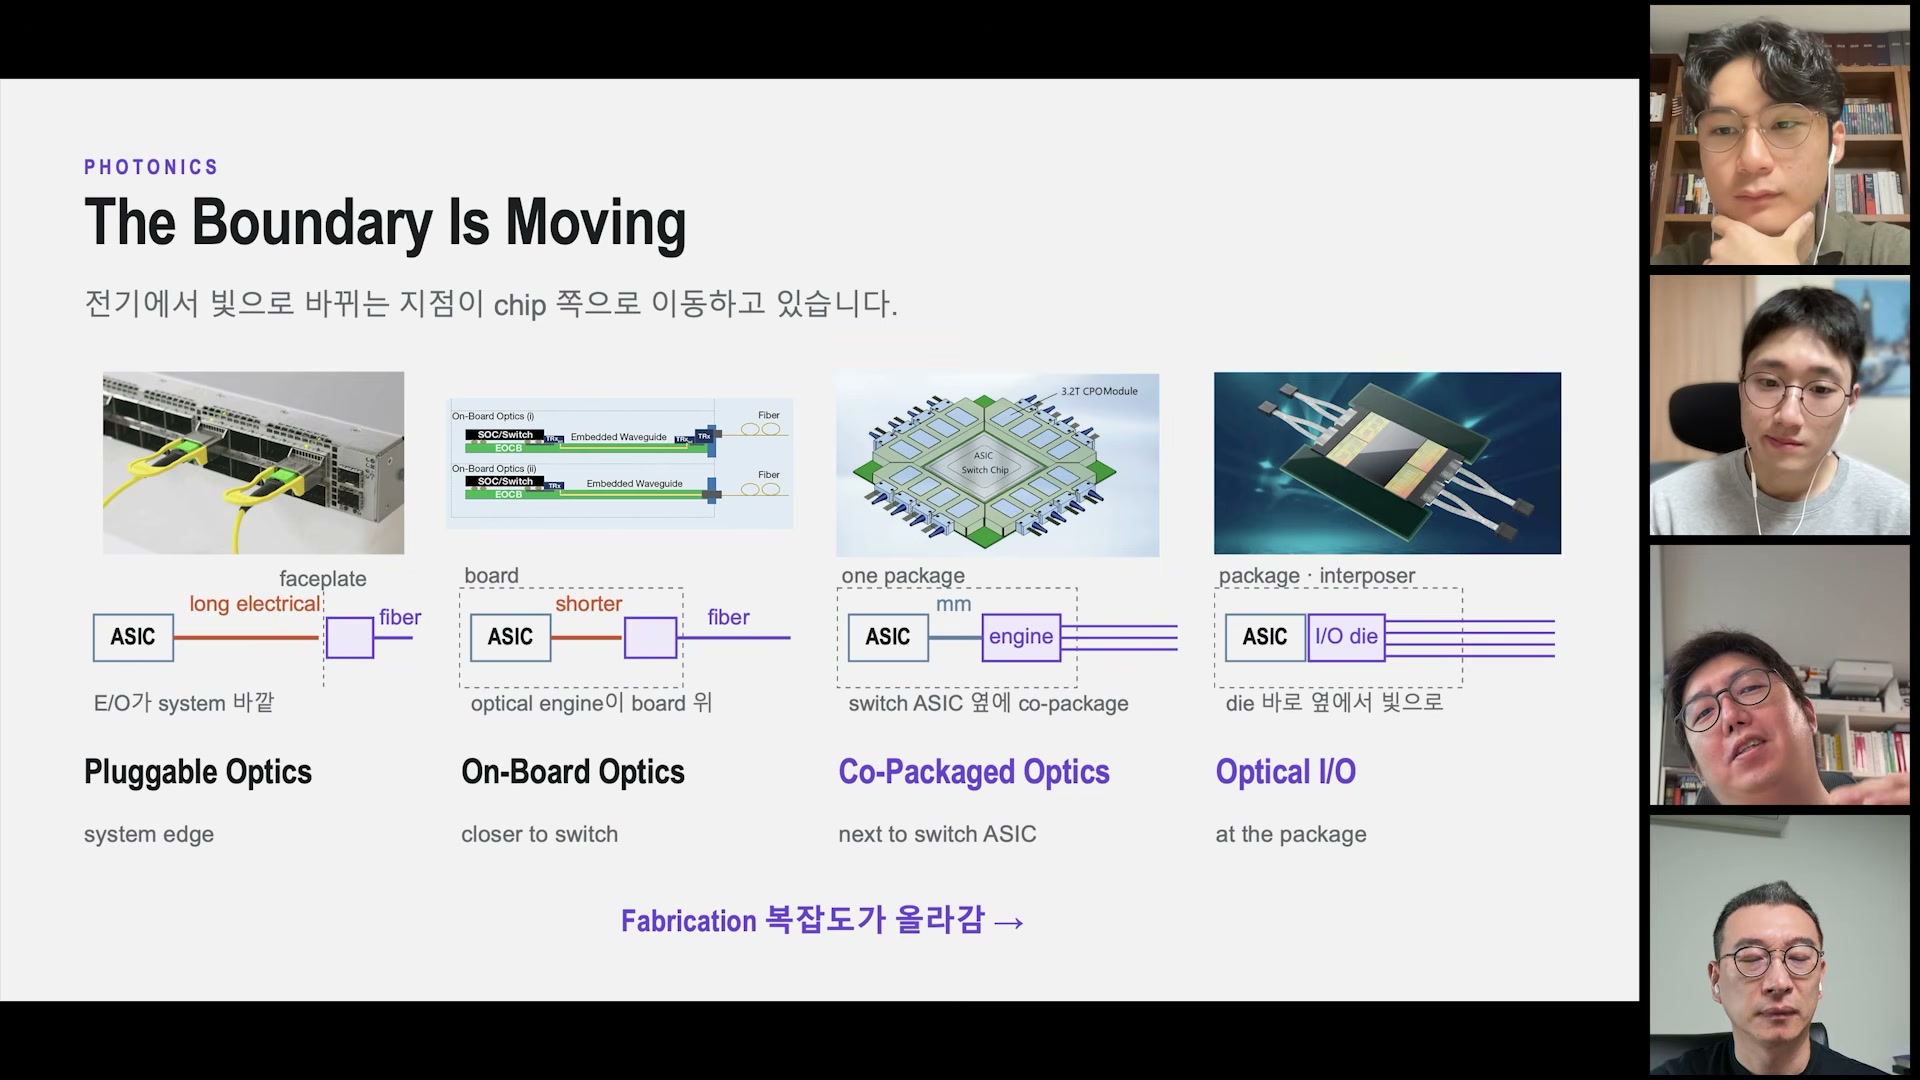
광학의 위치는 시스템 가장자리의 pluggable optics에서 보드 위 on-board optics, 스위치 ASIC 옆 co-packaged optics(CPO), 패키지 안의 optical I/O로 점점 칩에 가까워지고 있다. 구리선이 짧아질수록 전기 손실과 보상 전력은 줄지만, fabrication 복잡도는 올라간다.
이 이동은 한 번에 모든 링크를 바꾸는 로드맵이 아니다. 어느 링크부터 광학으로 옮겼을 때 bandwidth·전력 절감이 packaging·열·수율의 추가 비용을 상쇄하는지 선택하는 문제다.
[19:25] 7. 산업도 CPO와 optical I/O 쪽으로 움직인다
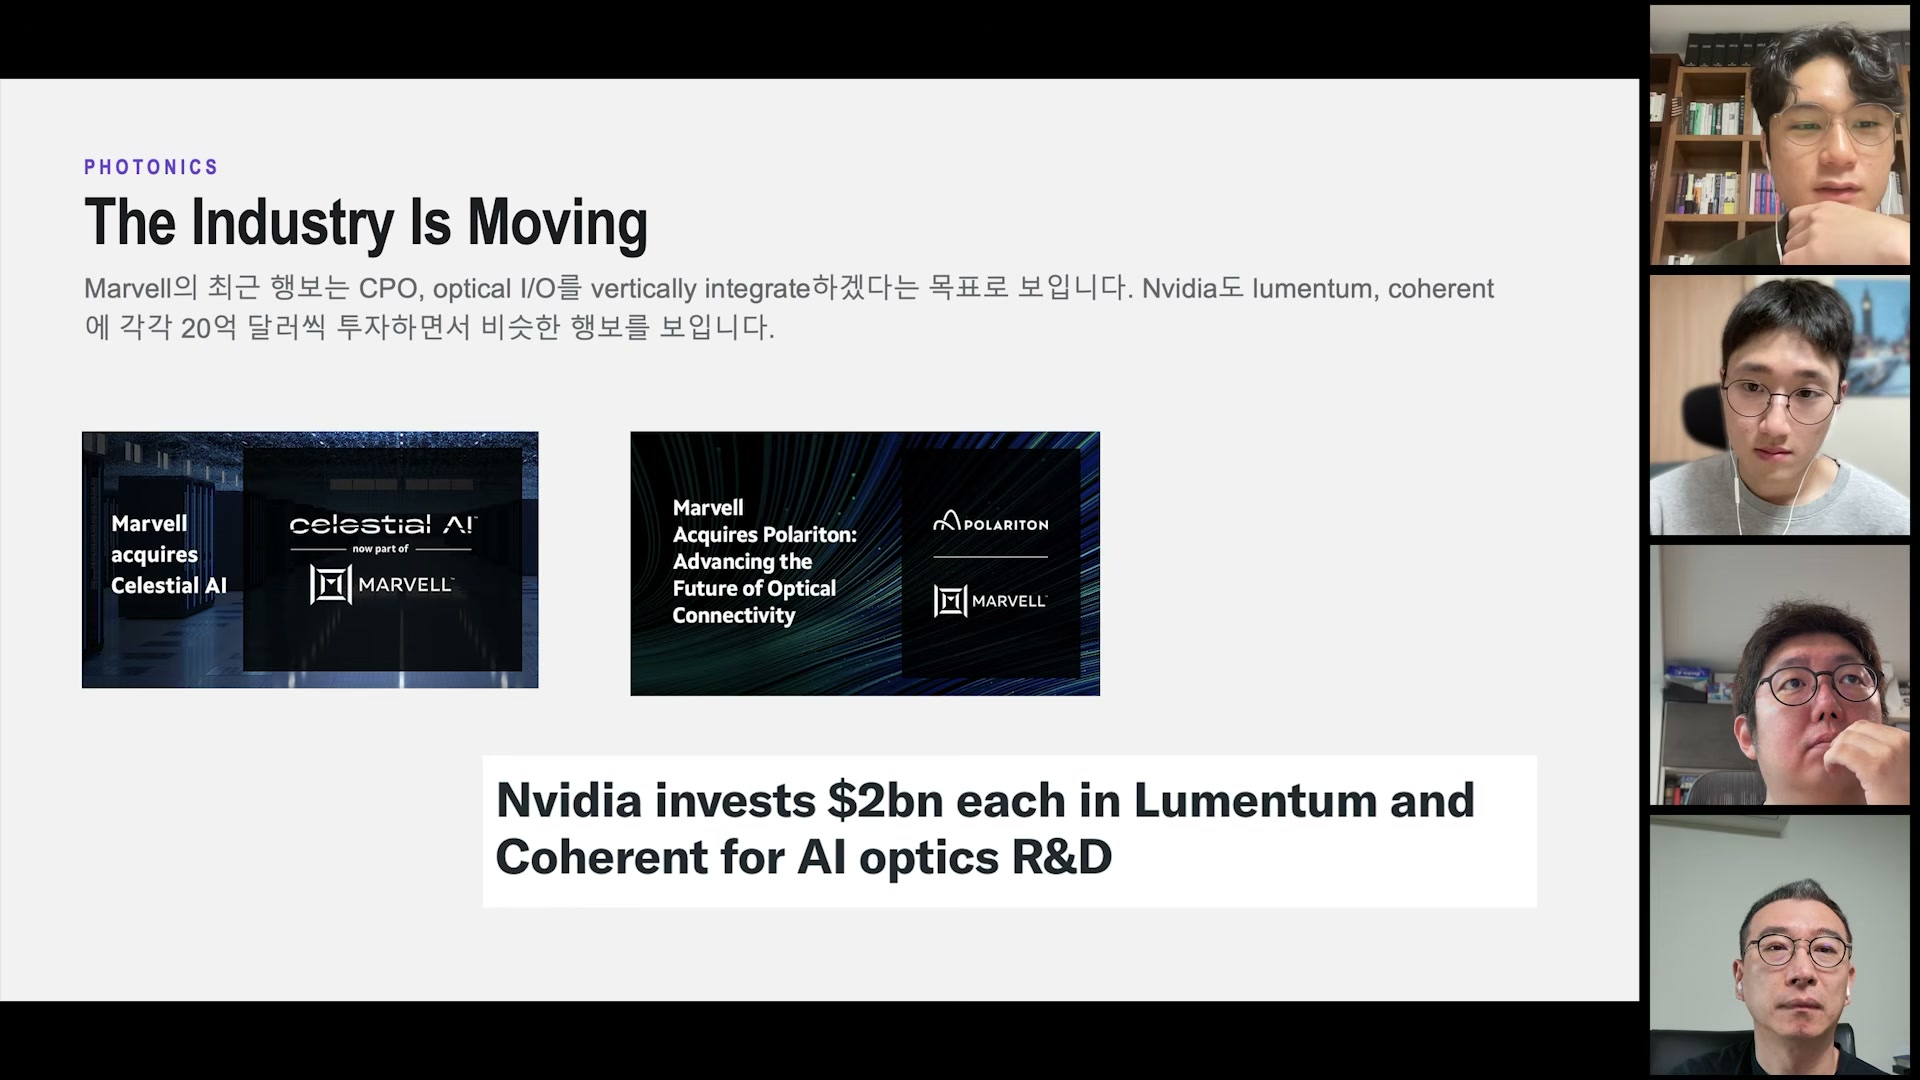
화면은 Marvell의 Celestial AI 인수와 Polariton 관련 발표, NVIDIA의 Lumentum·Coherent 투자 사례를 통해 산업이 CPO와 optical I/O를 수직 통합하려는 흐름을 보여준다. 이는 광학이 단순한 케이블 부품에서 ASIC·패키지·레이저·파이버 결합을 함께 설계하는 시스템 영역으로 이동한다는 신호로 해석된다.
다만 이 장면의 기업명·투자액은 영상의 슬라이드와 대화에서 제시된 사례다. 본 노트는 이를 최신 시장 사실로 재검증하지 않고, 발표자가 설명한 산업 방향을 기록한다.
[22:38] 8. CPO가 가져오는 비용: 서비스성·열·수율·생태계
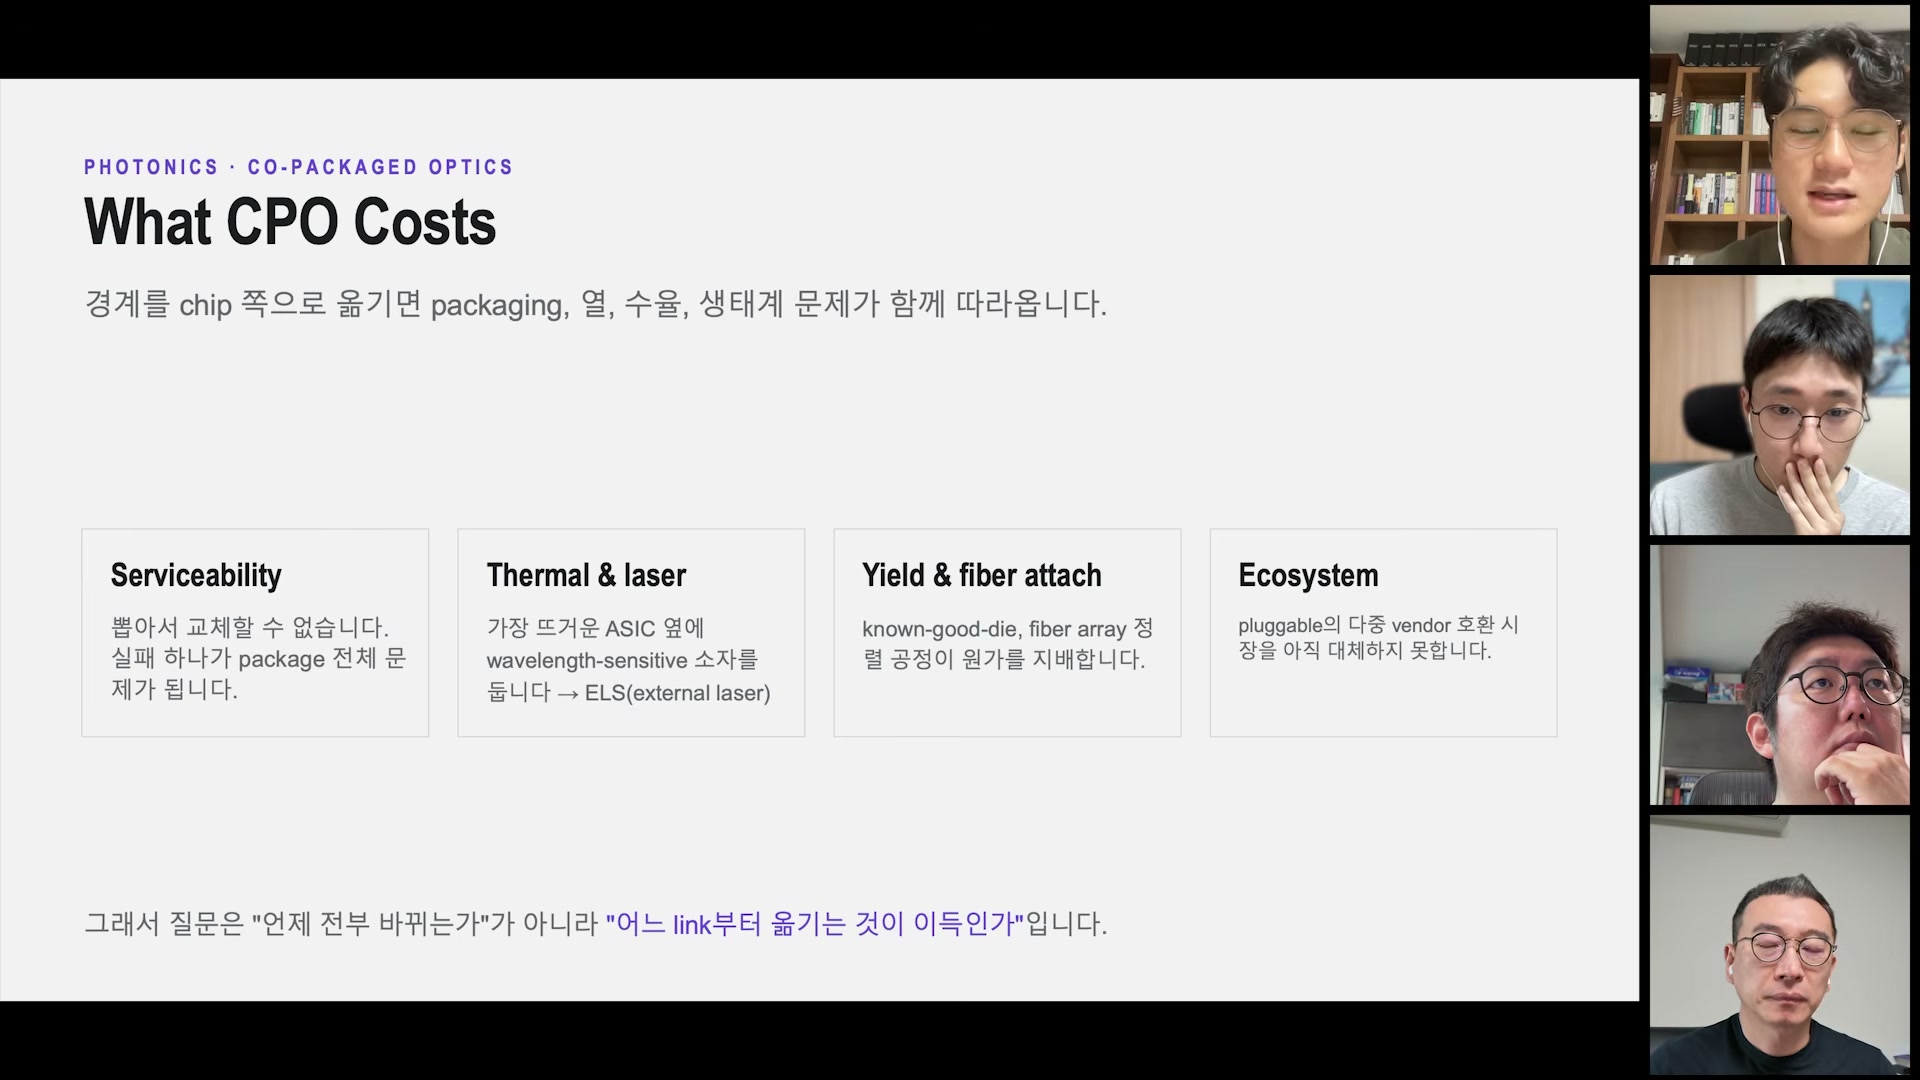
CPO는 serviceability, thermal & laser, yield & fiber attach, ecosystem 네 가지 문제를 함께 끌어온다. pluggable 모듈은 고장 난 케이블이나 광학 부품만 뽑아 교체할 수 있지만, 패키지에 통합된 광학 엔진은 한 부품의 실패가 전체 패키지 문제로 번질 수 있다. 가장 뜨거운 ASIC 옆에 wavelength-sensitive device와 레이저를 두는 열 설계도 어렵다.
그래서 질문은 “언제 전부 CPO로 바꾸는가?”가 아니라 어느 link부터 경계를 옮기는 것이 이득인가가 된다. known-good-die, fiber array 정렬, 다중 vendor 호환성 같은 제조·생태계 조건도 성능만큼 중요하다.
[26:25] 9. 빛에 데이터를 싣는 기본 원리
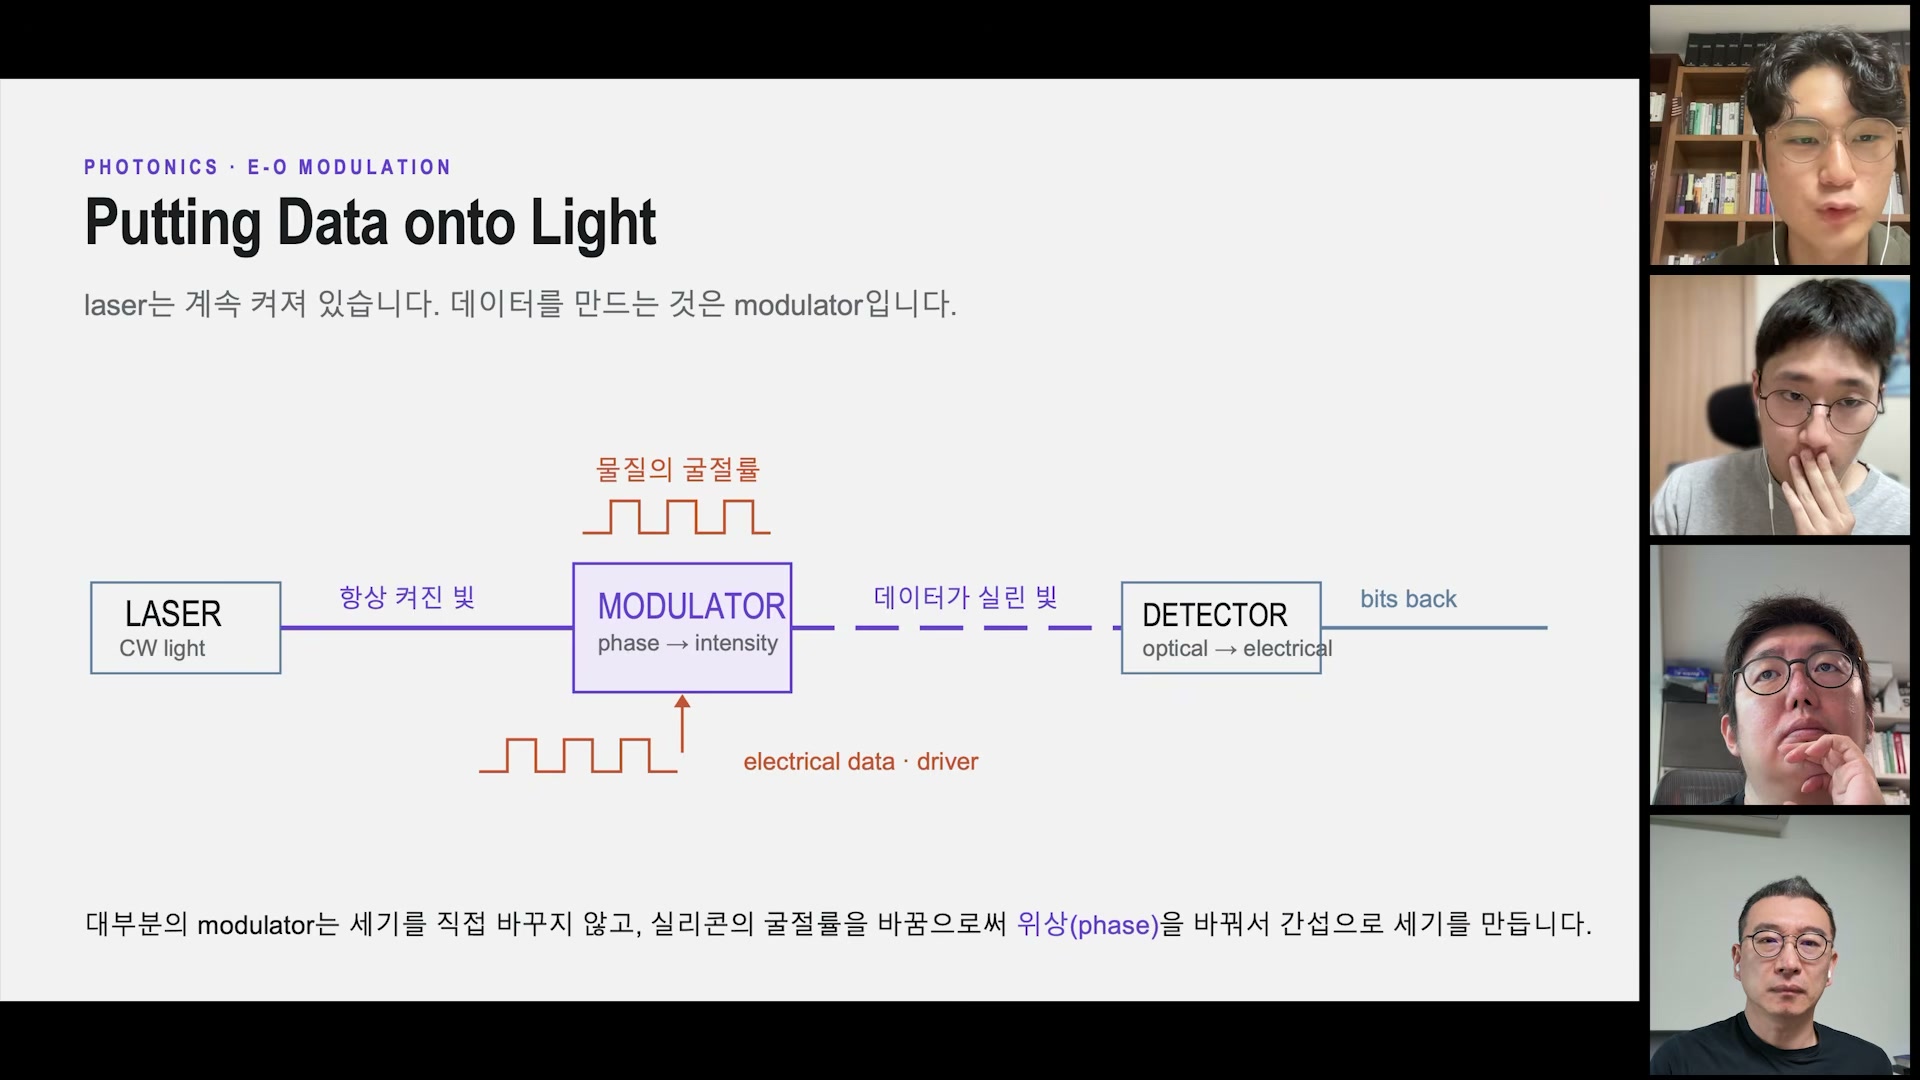
실리콘 포토닉스의 송신단에는 계속 켜져 있는 CW laser가 있고, 전기 데이터는 modulator에 들어간다. 모듈레이터는 빛 자체를 껐다 켜기보다 실리콘의 굴절률을 바꿔 phase를 조절하고, 그 결과를 intensity 차이로 만들어 데이터가 실린 빛을 만든다. 수신단의 detector는 optical 신호를 다시 electrical 신호로 되돌린다.
이 구조는 CPU/ASIC의 비트를 광 신호로 바꾸고 fiber를 통해 보내는 전기-광 변환, 즉 electro-optic modulation의 핵심이다. 결국 광학 링크의 성능은 “빛이 빠르다”만이 아니라 이 변환이 얼마나 작고 빠르고 전력 효율적으로 구현되는지에 달려 있다.
[29:58] 10. Silicon Cannot Make Light — 레이저 통합 문제
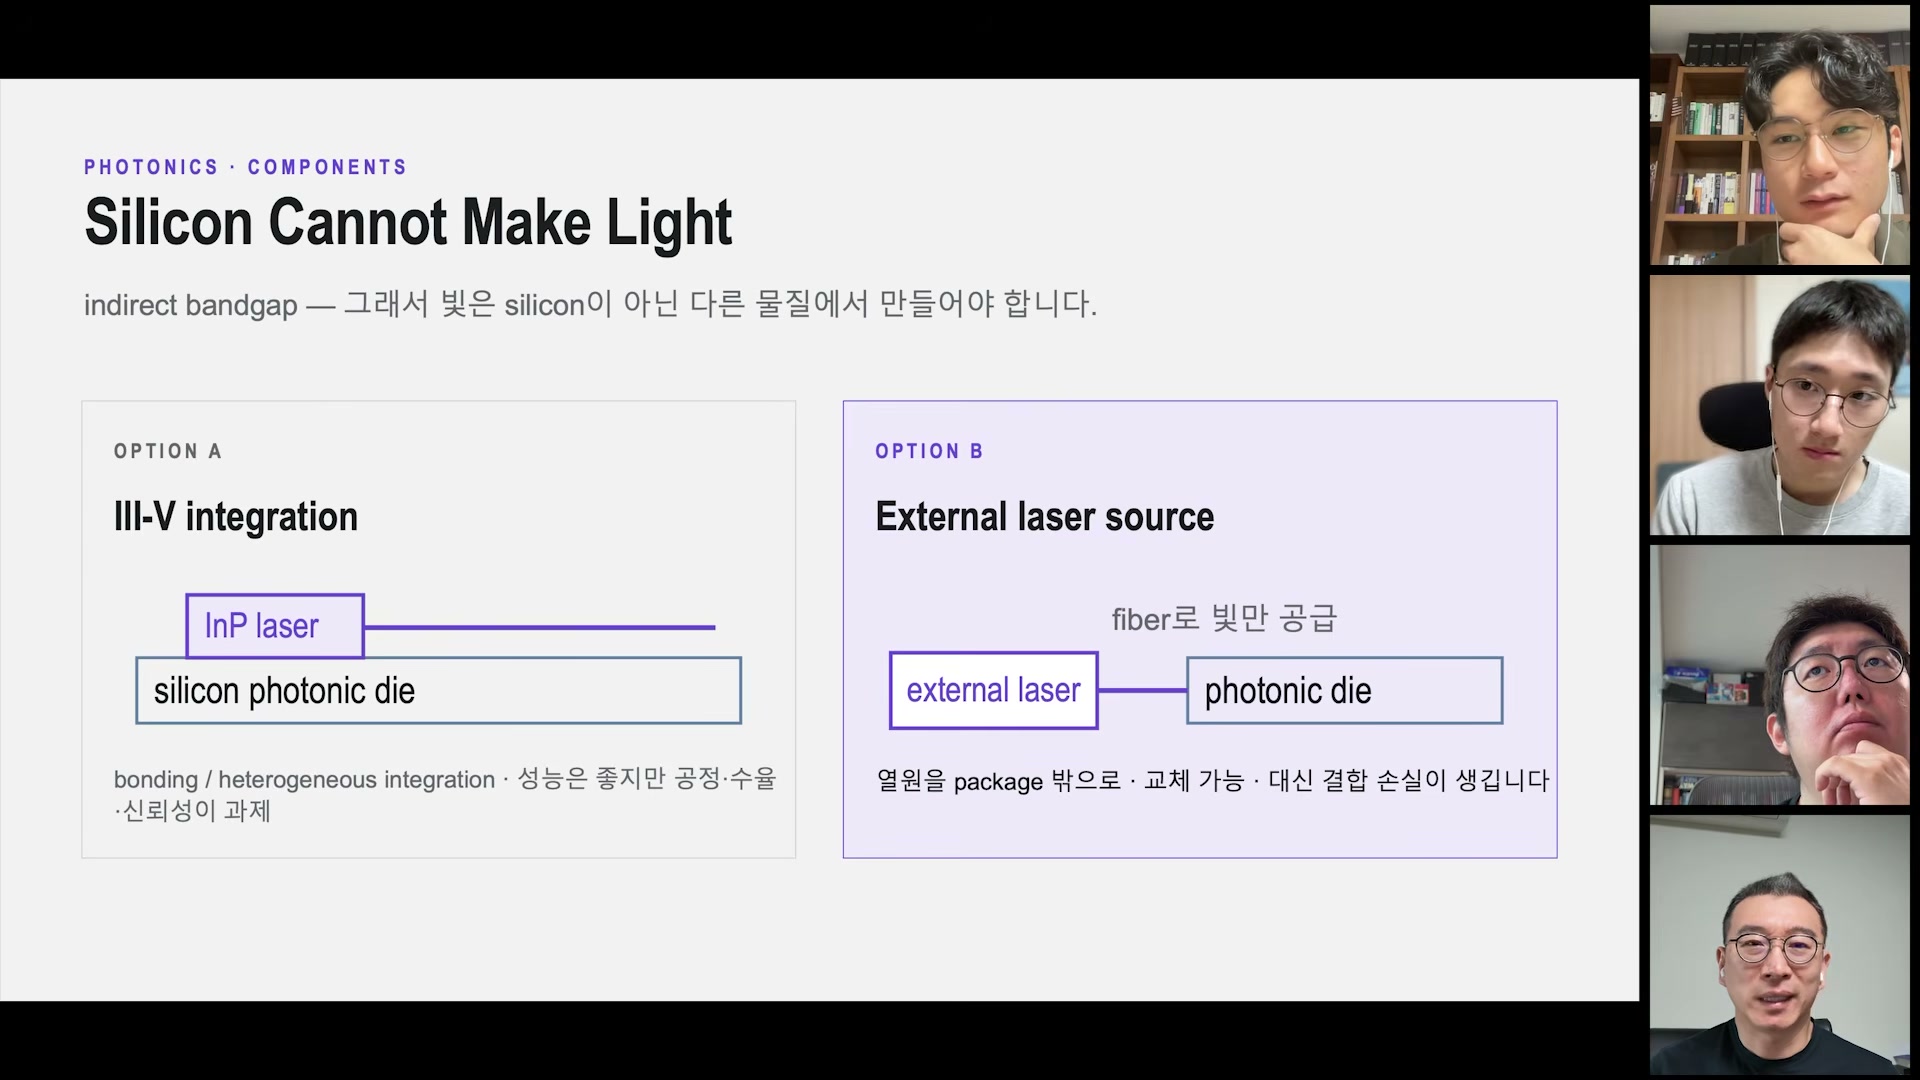
실리콘은 indirect bandgap 물질이라 직접 빛을 만들기 어렵다. 첫 번째 선택지는 InP 같은 III-V 레이저를 실리콘 포토닉 다이에 bonding하는 heterogeneous integration이다. 성능과 집적도는 좋지만 공정·수율·신뢰성이 어려워진다.
두 번째는 패키지 밖의 external laser source가 fiber로 광원만 공급하게 하는 방식이다. 레이저를 교체할 수 있고 패키지 열 부담을 줄일 수 있지만, fiber coupling loss와 별도의 광원·연결 구조가 필요하다. 두 선택지는 “완전 통합”과 “서비스 가능성” 사이의 trade-off를 보여준다.
[34:42] 11. WDM: 파장은 대역폭의 추가 축이다
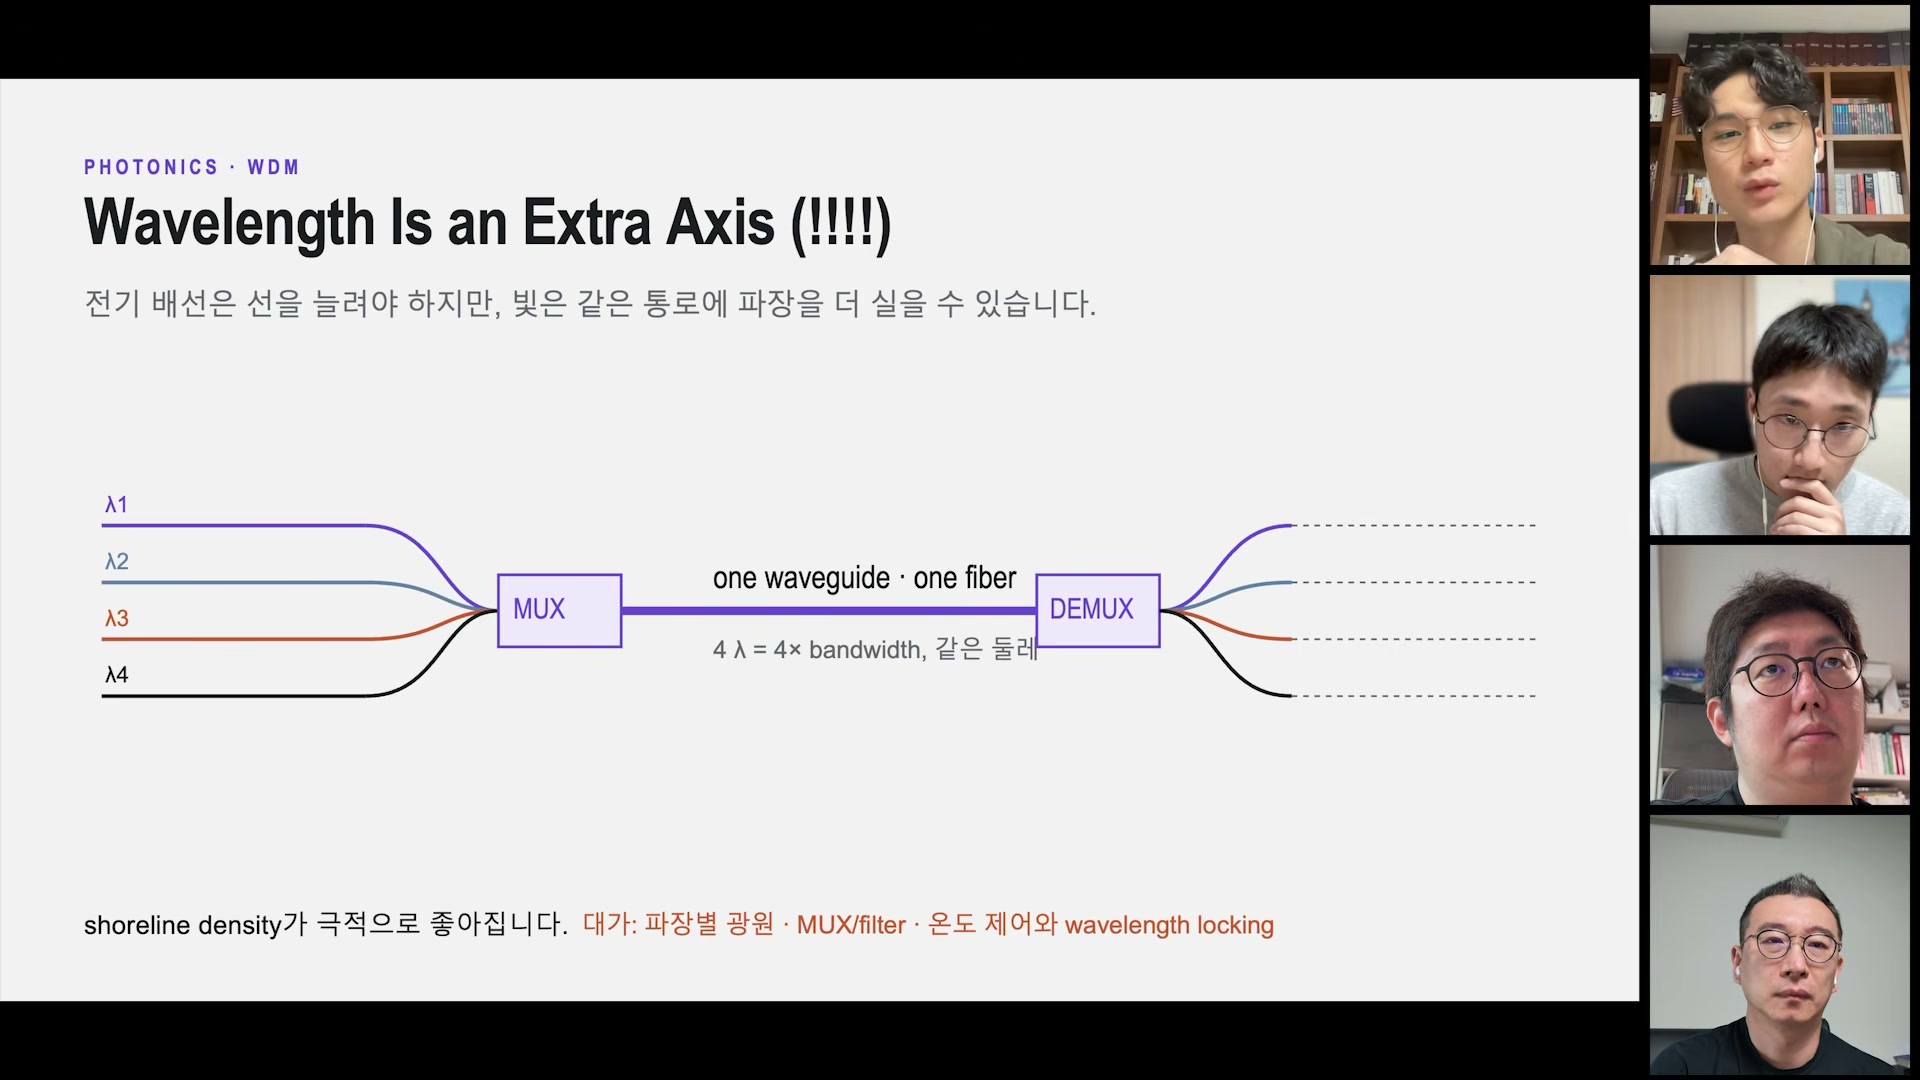
전기 배선으로 네 가지 정보를 보내려면 보통 네 개의 채널이 필요하지만, 포토닉스는 하나의 waveguide·fiber에 서로 다른 파장 λ1, λ2, λ3, λ4를 함께 보낼 수 있다. 송신단의 MUX가 파장을 합치고, 수신단의 DEMUX가 다시 분리한다. 이론적으로 4개의 파장은 같은 물리적 통로에서 4배의 bandwidth 축이 된다.
이 방식은 package shoreline에서 구리 채널을 계속 늘리지 않고도 channel density를 높일 수 있다는 장점이 있다. 대신 demux가 촘촘한 파장을 안정적으로 분리해야 하고, 파장별 광원·filter·온도 제어와 wavelength locking이 필요하다.
[39:32] 12. 왜 더 집적해야 하는가
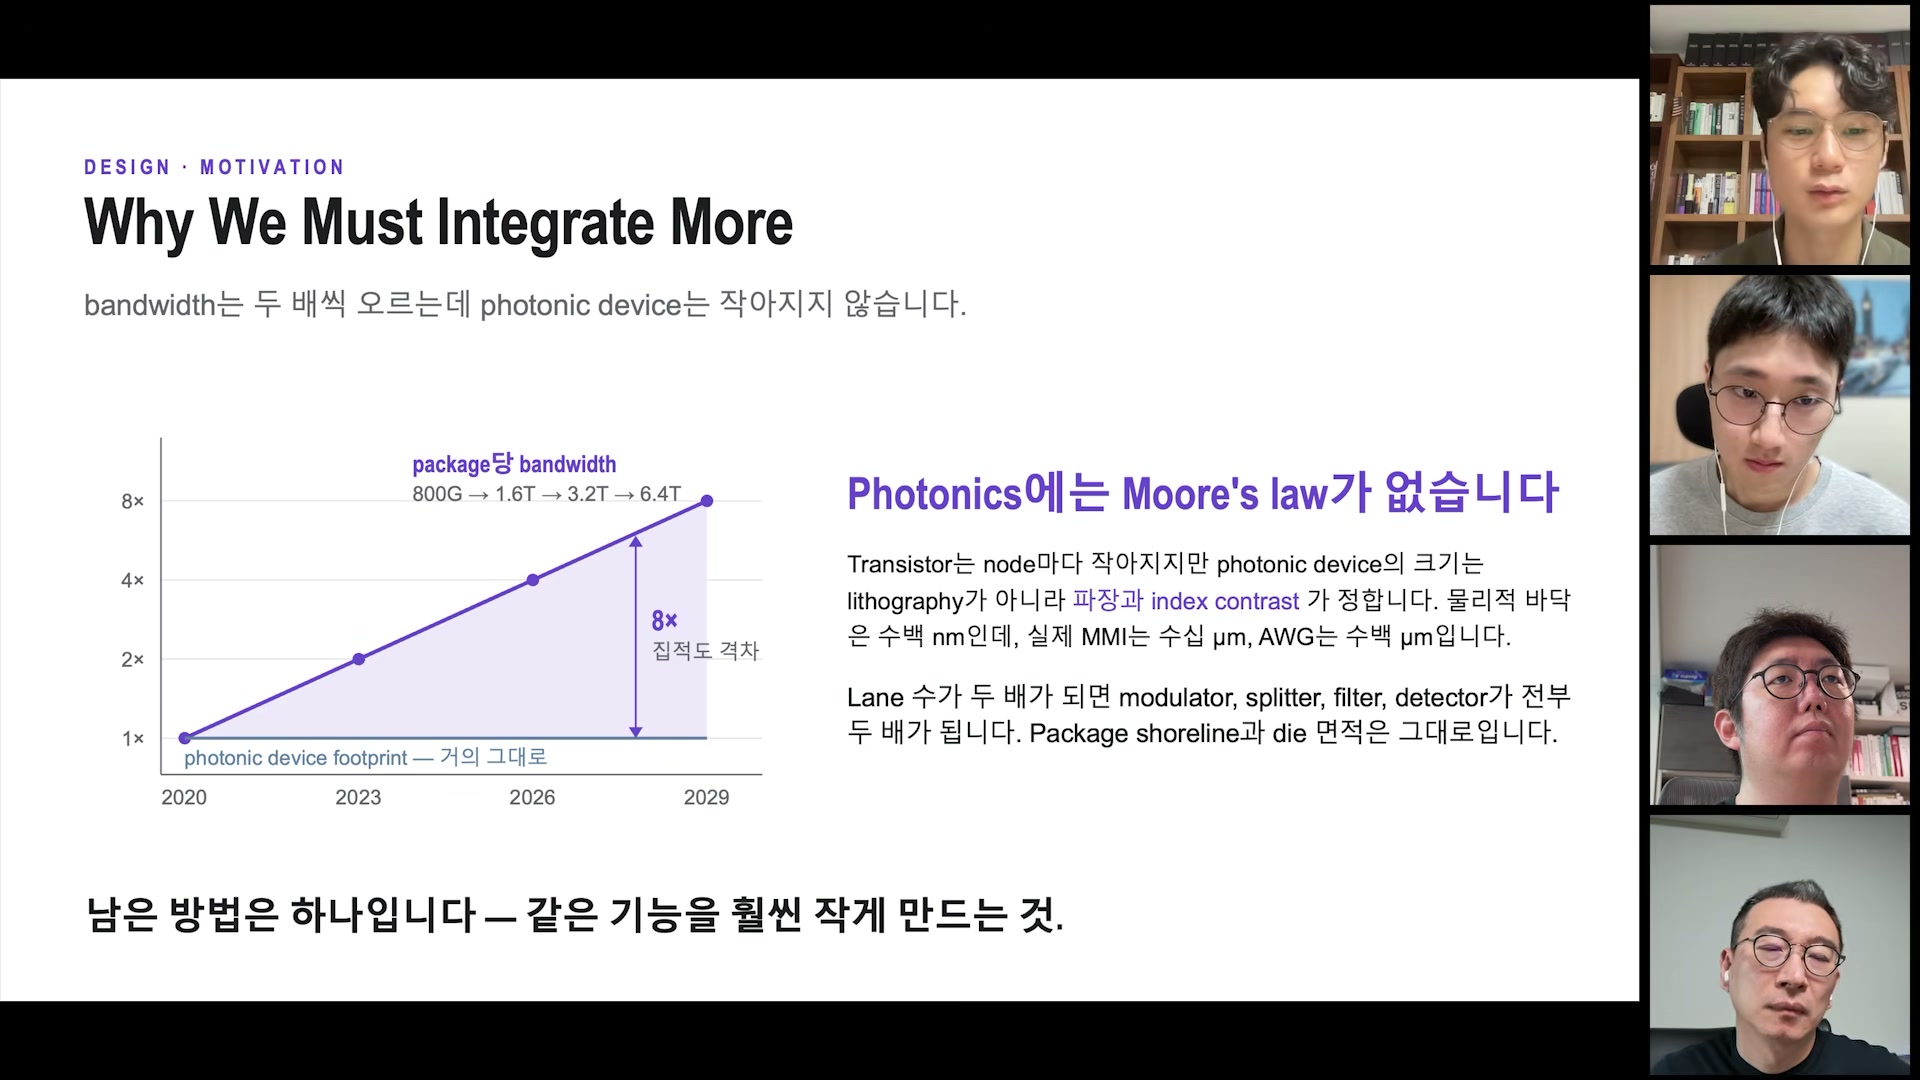
슬라이드는 package당 bandwidth가 800G→1.6T→3.2T→6.4T로 증가하는 동안 photonic device footprint는 거의 그대로이고, “Photonics에는 Moore’s law가 없다”고 설명한다. transistor처럼 node가 작아진다고 photonic device가 자동으로 작아지지 않는다. 파장과 index contrast, waveguide·AWG의 물리 크기가 하한을 만들기 때문이다.
따라서 lane 수가 두 배가 되면 modulator·splitter·filter·detector도 함께 늘어나 package shoreline과 die 면적이 빠르게 부족해진다. 같은 기능을 훨씬 작은 geometry로 만드는 것이 inverse design의 실용적 동기다.
[40:32] 13. 사람이 직관으로 그리기 어려운 inverse design
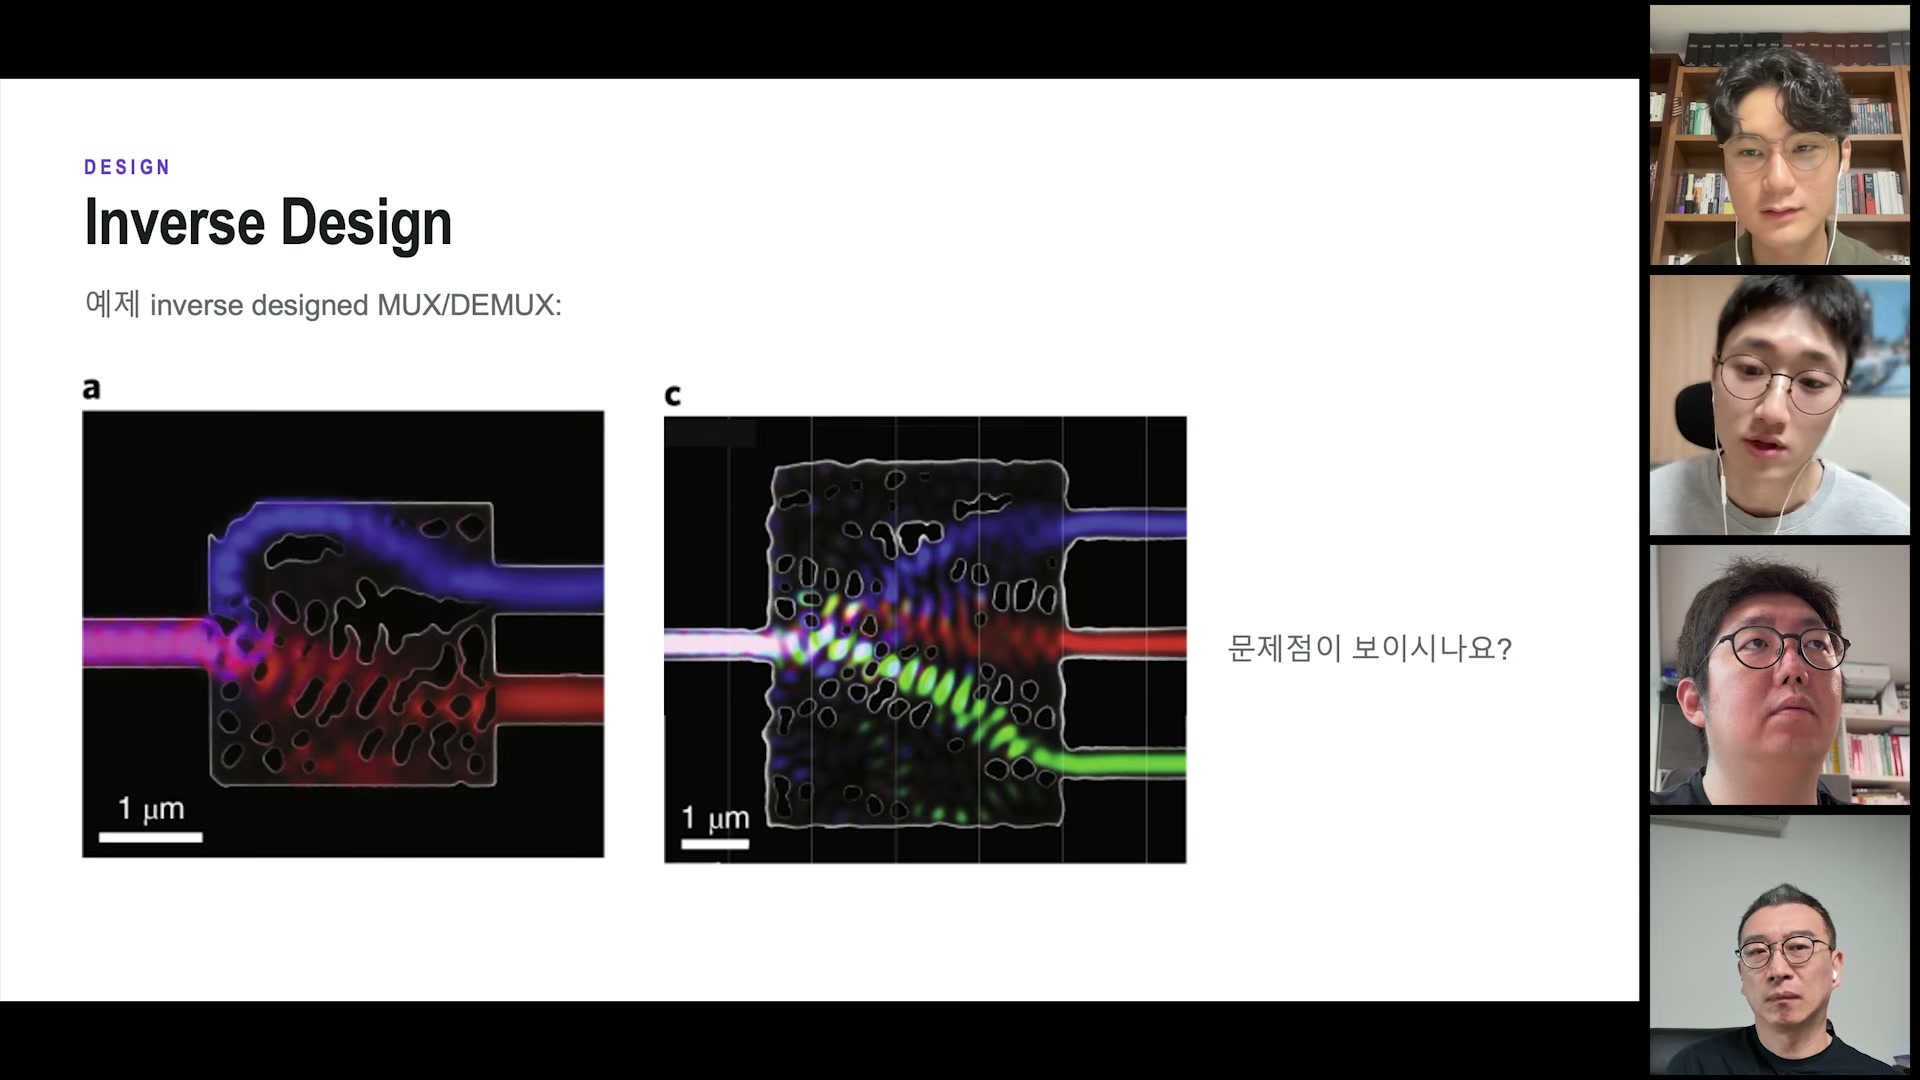
일반적인 설계는 구조를 먼저 정하고 그 결과를 계산하지만, inverse design은 원하는 optical function을 먼저 정하고 그 기능을 내는 geometry를 최적화한다. 화면의 MUX/DEMUX 예처럼 수많은 구멍과 비정형 경계를 가진 구조가 1μm 스케일에 나타나며, 사람이 회로도만 보고는 왜 그런 모양인지 설명하기 어렵다.
이 비직관성은 약점이면서 강점이다. 사람이 선호하는 규칙적인 형태에 갇히지 않고 compact한 고성능 구조를 탐색할 수 있지만, 설계 결과를 제조하고 실패 원인을 진단하는 문제는 더 어려워진다.
[46:04] 14. 출발점이 다르면 optimizer의 종착점도 달라진다
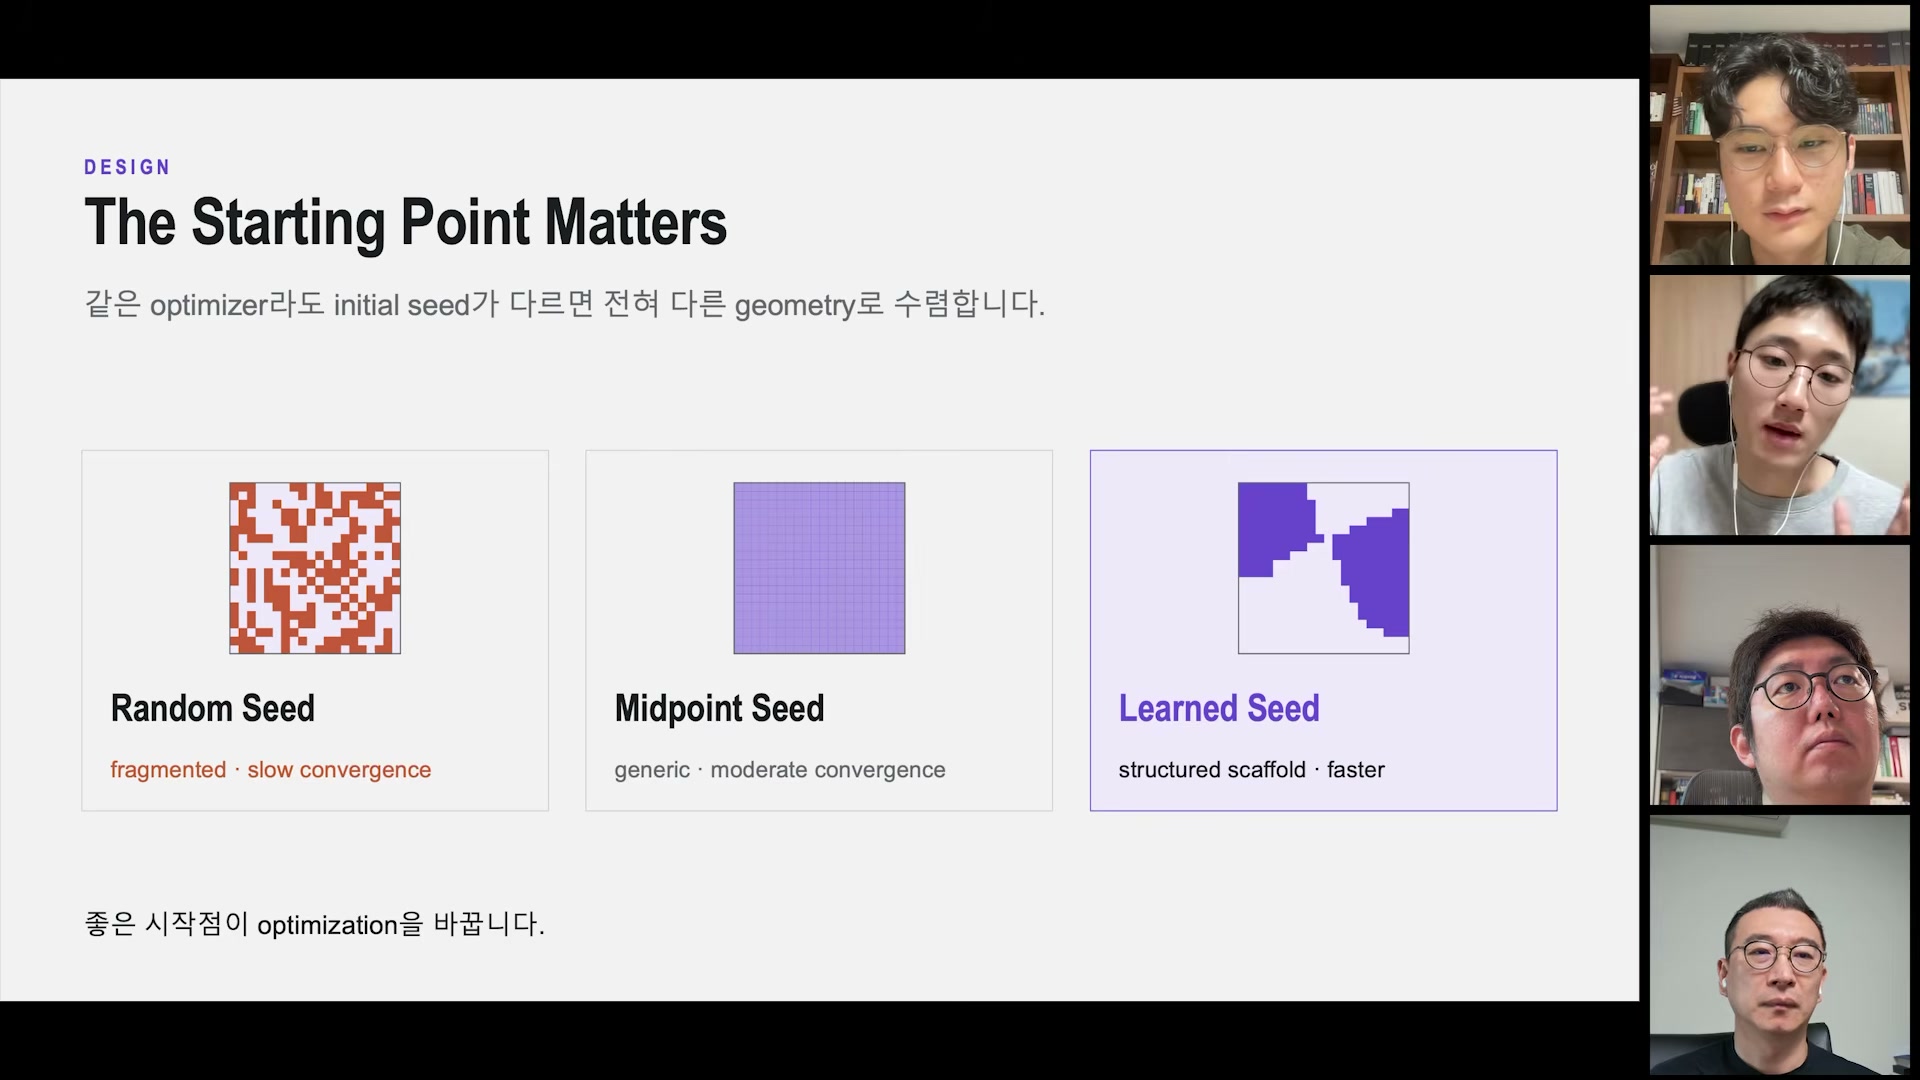
같은 optimizer를 사용해도 초기 seed가 random인지, 단순 midpoint인지, 과거 설계에서 학습한 learned seed인지에 따라 전혀 다른 geometry로 수렴할 수 있다. random seed는 fragmented하고 느리게 수렴하며, learned seed는 구조화된 scaffold에서 시작해 더 빠르게 수렴한다.
이 관찰은 “최적화 알고리즘을 더 세게 돌리자”보다 좋은 설계가 존재하는 분포를 먼저 학습시키자는 방향으로 이어진다. 결과의 품질뿐 아니라 시뮬레이션 횟수와 fabrication으로 넘길 후보의 질도 함께 관리할 수 있다.
[48:33] 15. 단백질 설계에서 가져온 generate–evaluate–refine
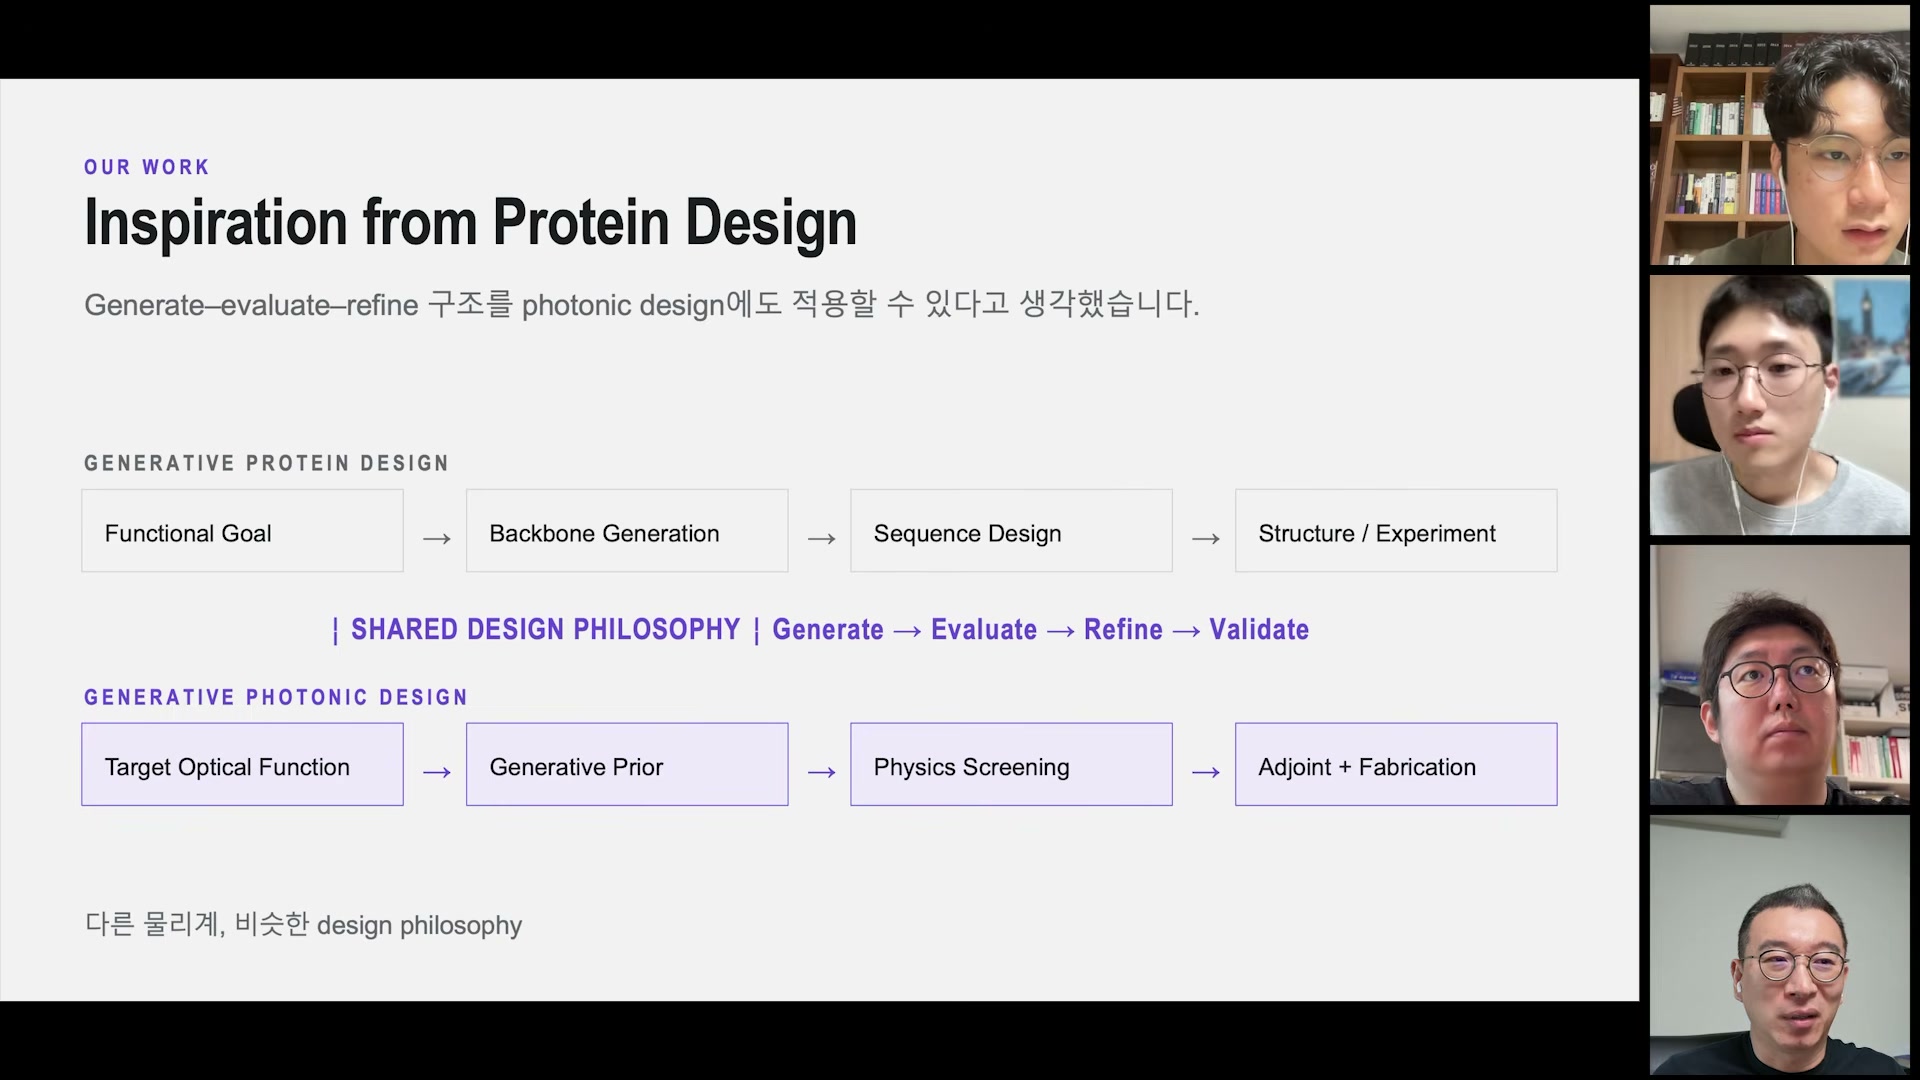
김태환은 단백질 설계의 흐름을 기능 목표→backbone generation→sequence design→structure/experiment로 설명한다. 과거 단백질 연구가 복잡한 전체 구조를 매번 새로 만드는 대신, 쓸 만한 골격을 만들고 중요한 부분을 refinement한 것처럼 포토닉스도 골격과 중요한 영역을 분리할 수 있다는 비유다.
이를 포토닉스에 옮기면 target optical function→generative prior→physics screening→adjoint+fabrication이 된다. 핵심 철학은 generate→evaluate→refine→validate이며, AI가 후보를 만들더라도 물리 시뮬레이션과 실제 제작·측정이 검증 고리로 남는다.
[55:55] 16. 버려지던 설계 결과를 학습 데이터로 바꾸기
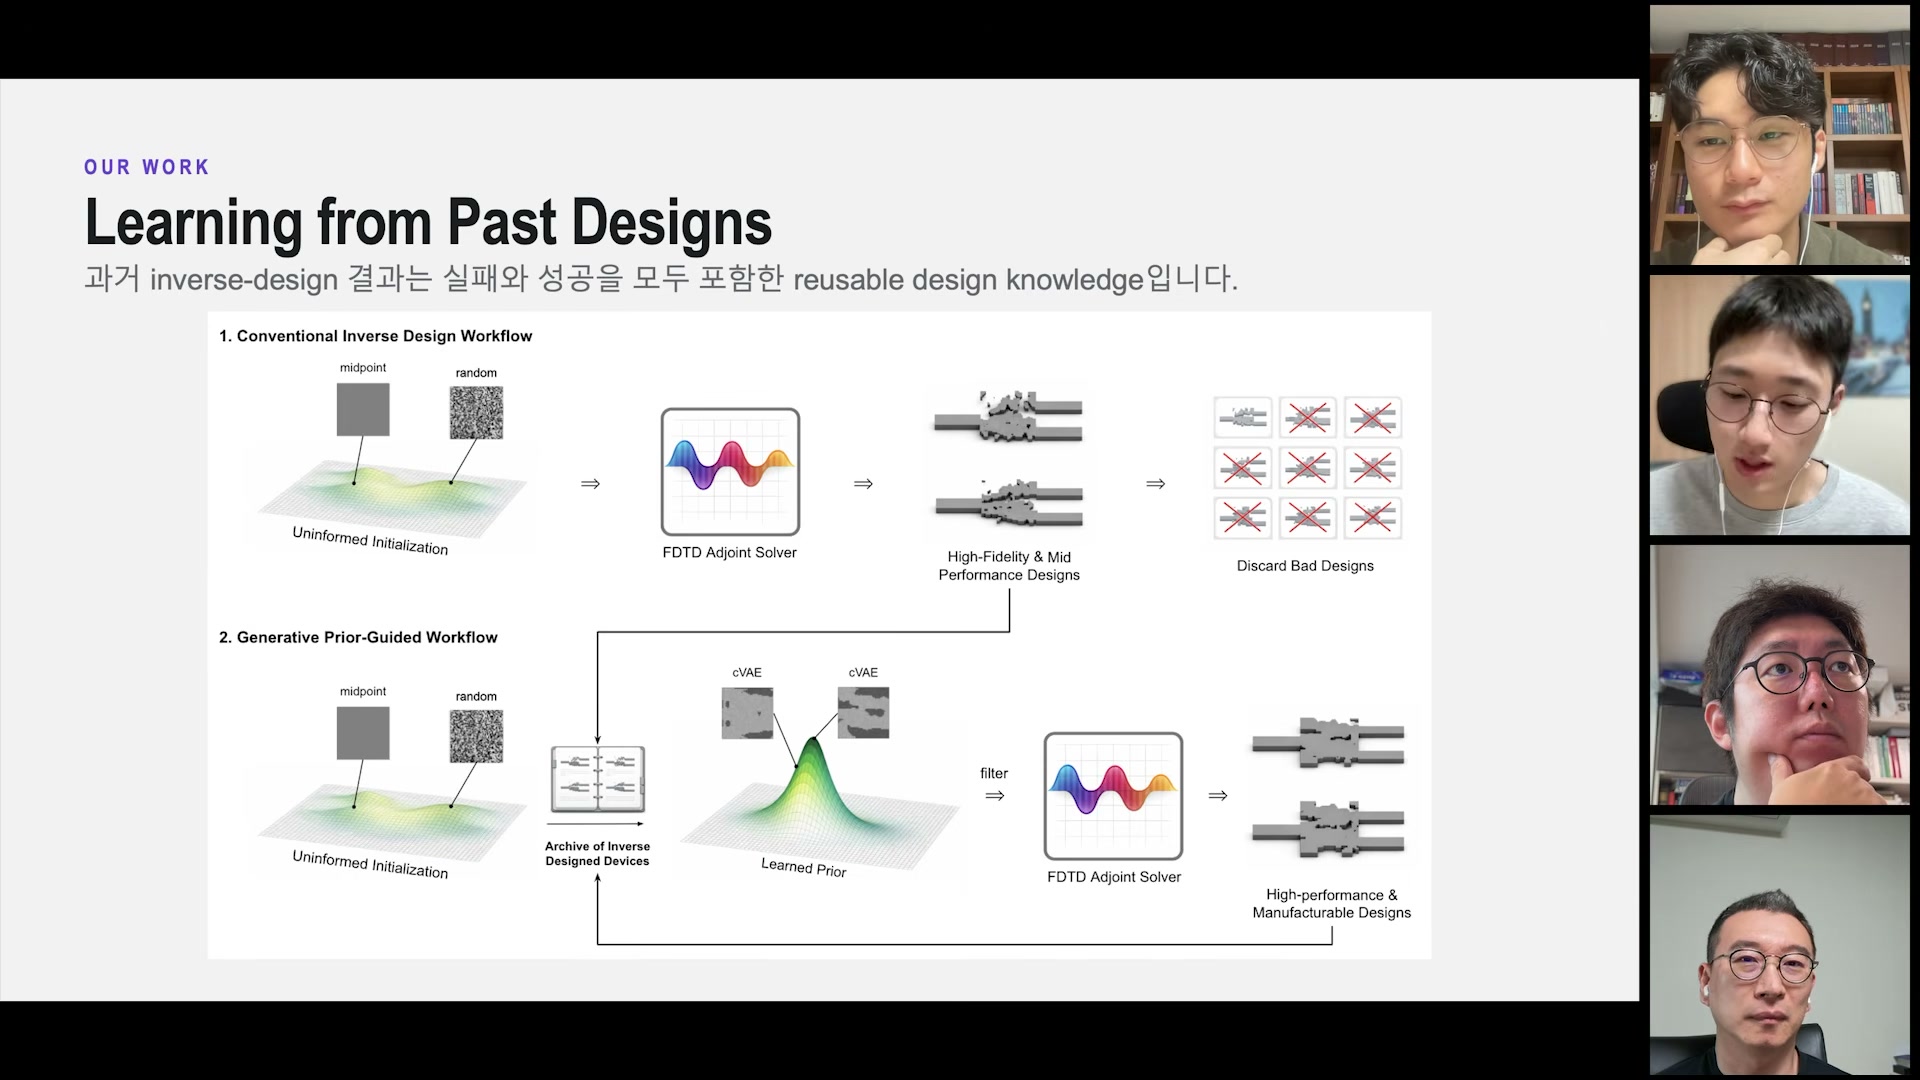
기존 inverse-design pipeline은 random/midpoint에서 시작해 FDTD adjoint solver로 후보를 만들고, high-fidelity 성능을 확인한 뒤 나쁜 디자인을 버리는 흐름이다. 후보 열 개 중 두 개만 좋으면 나머지 여덟 개의 실패 정보와 그때까지의 시뮬레이션 비용이 사라진다.
제안하는 prior-guided workflow는 좋은·나쁜 설계와 측정값을 archive하고, cVAE(conditional variational autoencoder)로 좋은 포토닉스 설계의 분포를 학습한다. 그 prior에서 후보를 생성한 뒤 물리 screen과 adjoint refinement를 통과시키므로, 높은 성능과 제조 가능성을 함께 노릴 수 있다.
[59:45] 17. 성능만이 아니라 manufacturability도 최적화한다
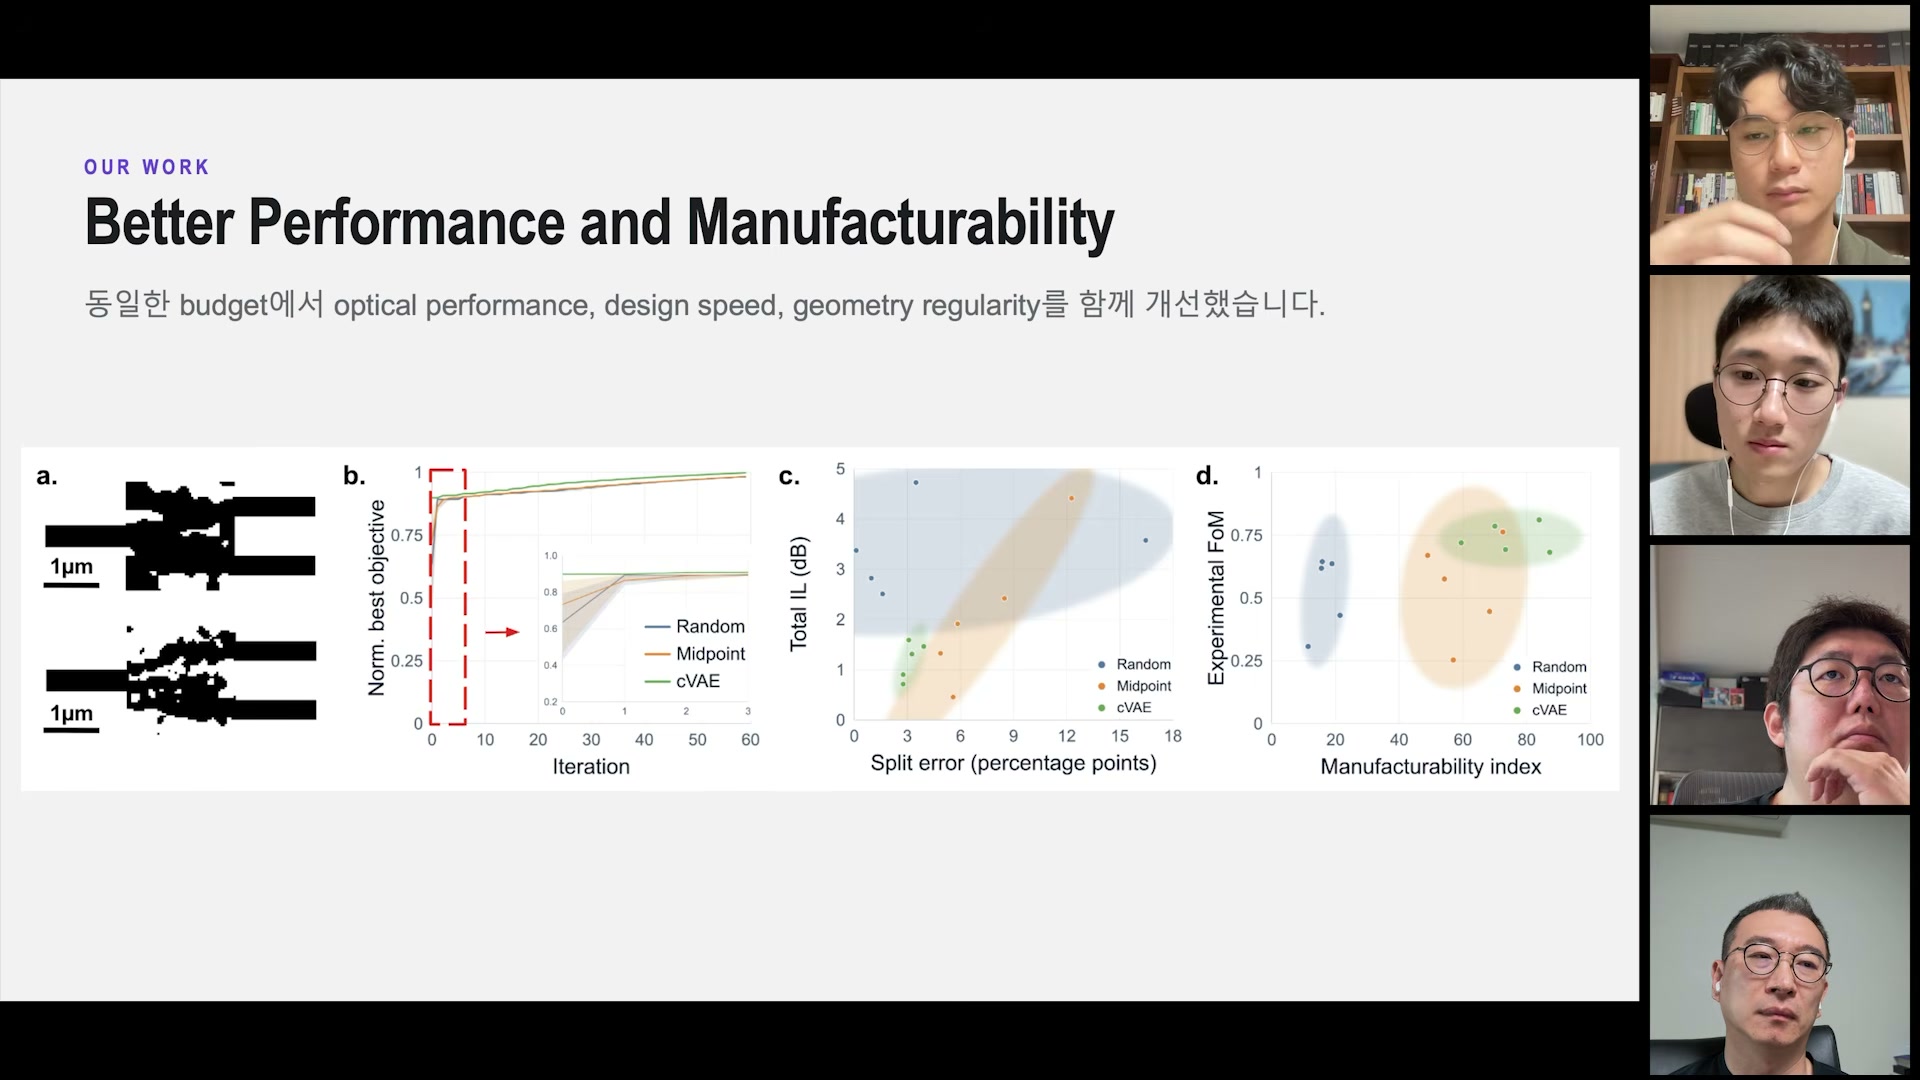
화면의 네 패널은 같은 설계 budget 안에서 objective 수렴 속도, total insertion loss, experimental figure of merit, manufacturability index를 비교한다. 발표자는 복잡한 free-form 구조가 작은 면적에서 좋은 성능을 내더라도, 조각과 island가 많아지면 제작이 어려워진다고 설명한다.
영상에서 소개한 square root of A over P manufacturability index는 실리콘 섬들의 면적과 둘레를 사용해 geometry의 파편화를 반영하도록 임의 설정한 지표다. fragment가 많아져 perimeter P가 커지면 제조성이 낮아지는 상관관계를 설계 목표에 포함한다.
[1:02:35] 18. 시뮬레이션과 fabrication 사이의 간극
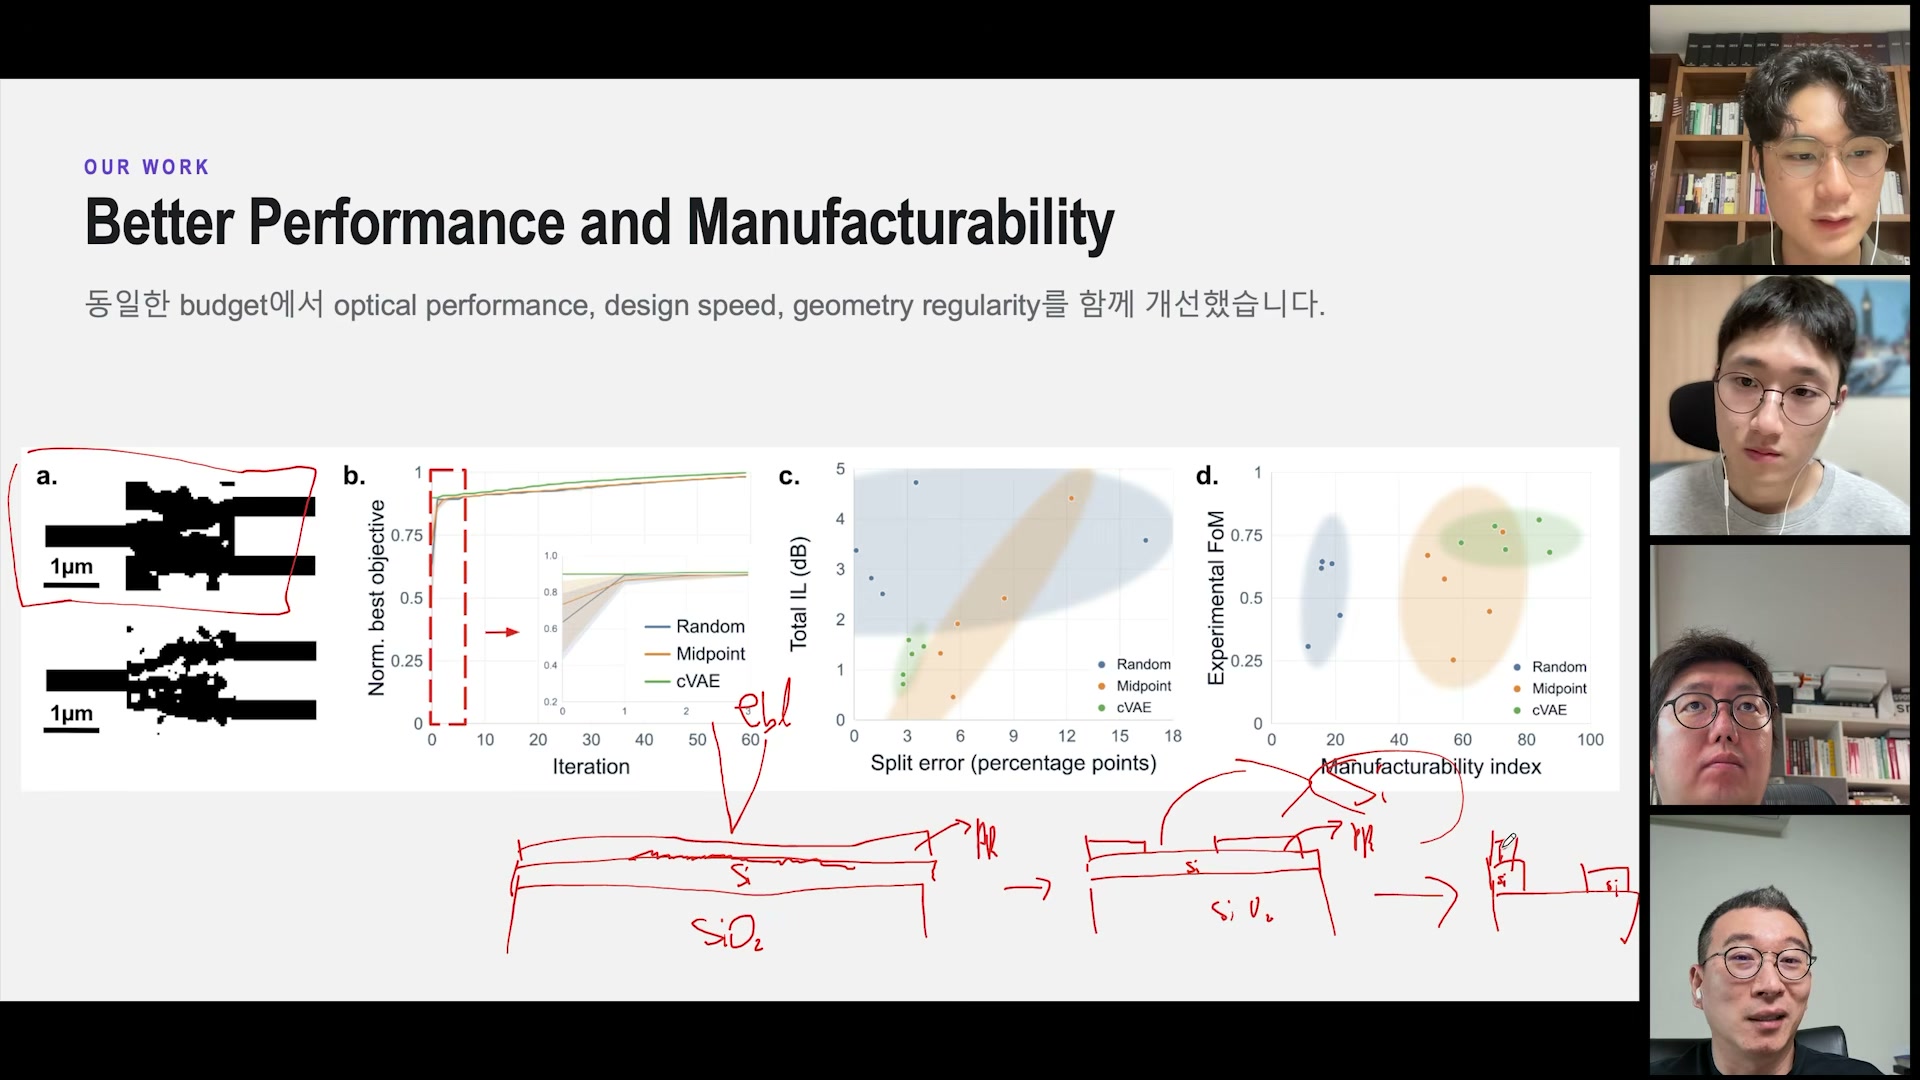
실리콘 포토닉스 구조는 쌓아 올리는 것보다 웨이퍼 위 실리콘을 깎아내는 과정에 가깝다. 산화층 위에 실리콘을 적층하고 EBL로 마스크를 만든 뒤 필요 없는 영역을 식각한다. 화면의 주석은 구조의 작은 구멍과 경계가 실제 공정에서 어떻게 남는지, 어떤 부분이 공정 cycle과 수율을 좌우하는지 보여준다.
inverse design이 만들어낸 30~50nm 수준의 작은 구멍과 복잡한 경계는 시뮬레이션에서 예뻐 보여도 실제 fabrication에서는 다른 결과가 나올 수 있다. 그러므로 제조 공정이 이해할 수 있는 제약을 설계 단계부터 넣고, 실제 측정값을 다시 모델에 공급해야 한다.
[1:06:20] 19. Integrated Gradients로 “어디를 잘 만들어야 하는가” 찾기
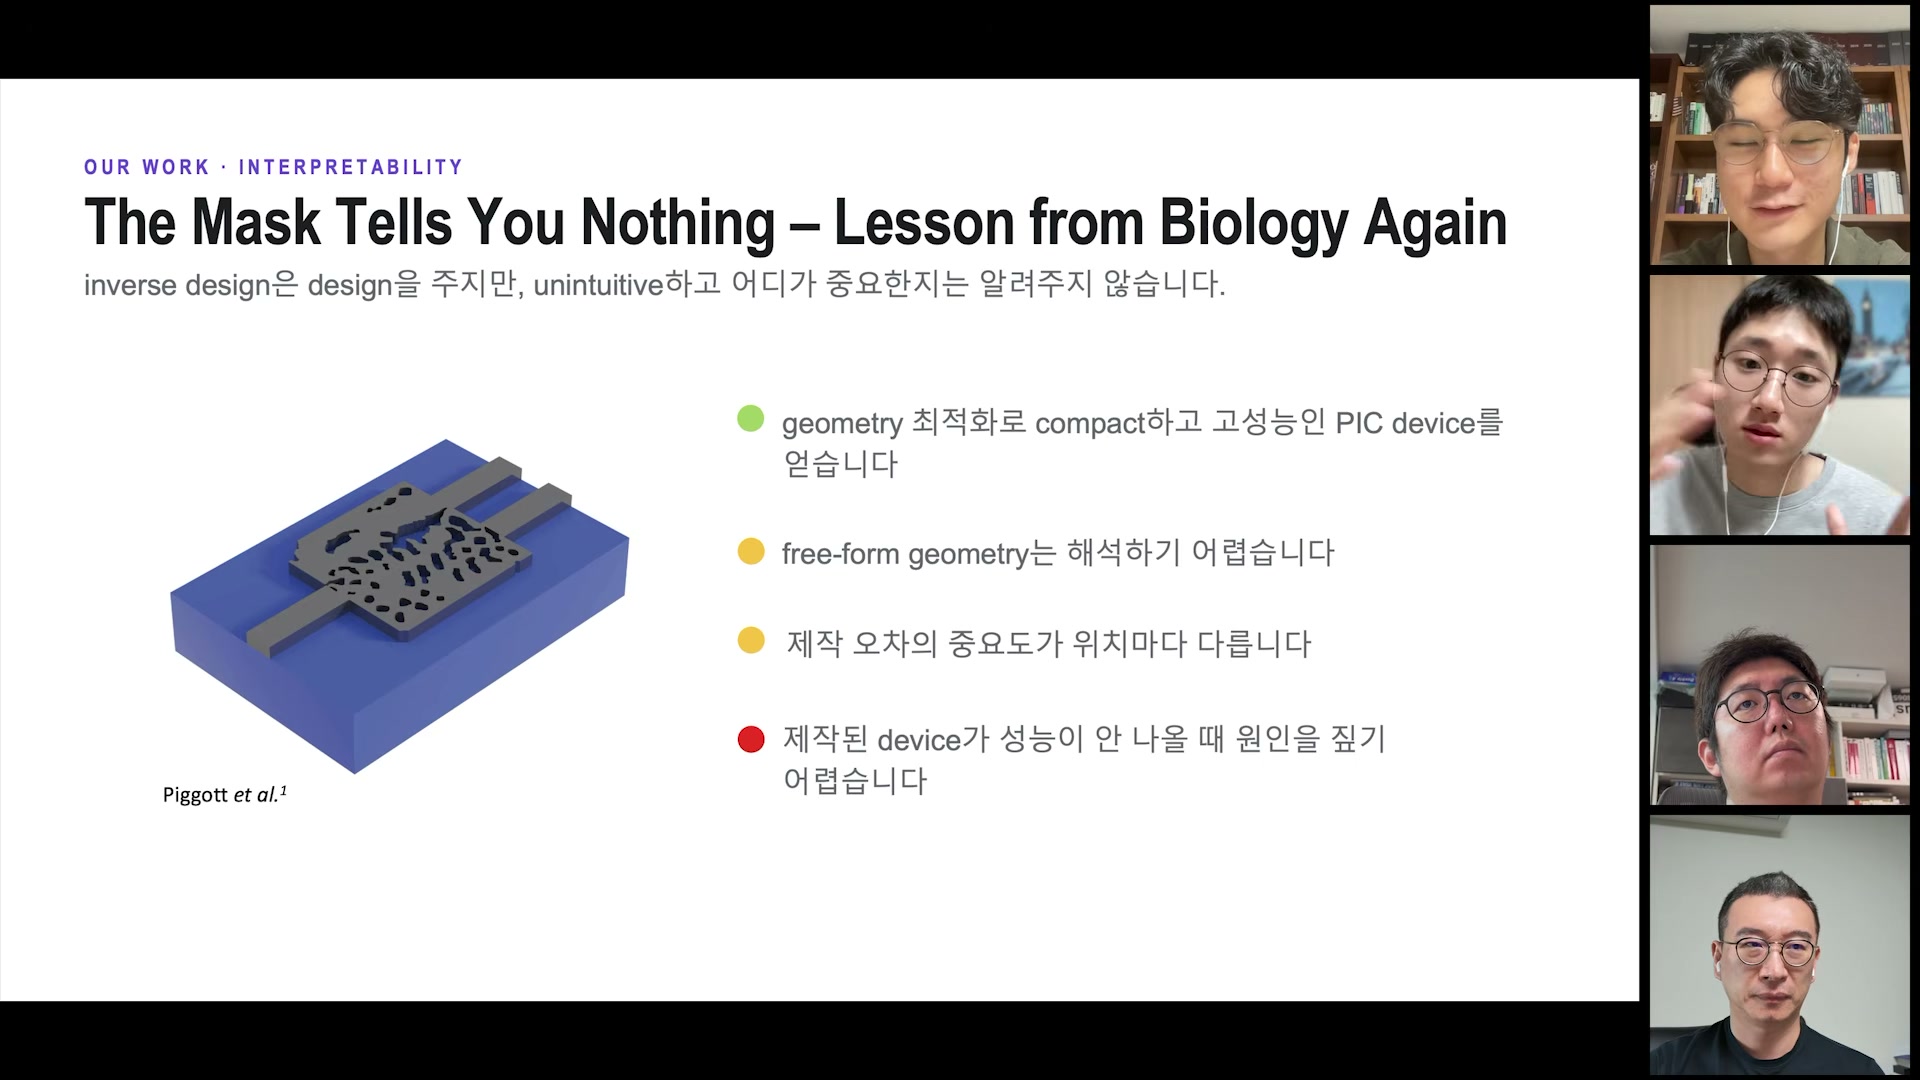
inverse design은 geometry를 주지만, 어떤 위치가 최종 성능에 결정적인지는 알려주지 않는다. Integrated Gradients는 각 region에 작은 perturbation을 주었을 때 simulation metric이 얼마나 변하는지 누적해, fabrication에서 반드시 정밀하게 만들어야 할 영역을 빨간 점으로 표시한다.
이렇게 하면 모든 mask를 똑같이 예쁘게 가공하려는 대신, 공정 시간·SEM 검사·wafer 측정 자원을 민감한 hotspot에 집중할 수 있다. 즉 interpretability는 설명을 위한 장식이 아니라 제조 비용과 reliability를 줄이는 운영 신호가 된다.
[1:09:35] 20. Map to Manufacturing — 자유형 mask를 공정 우선순위로 변환
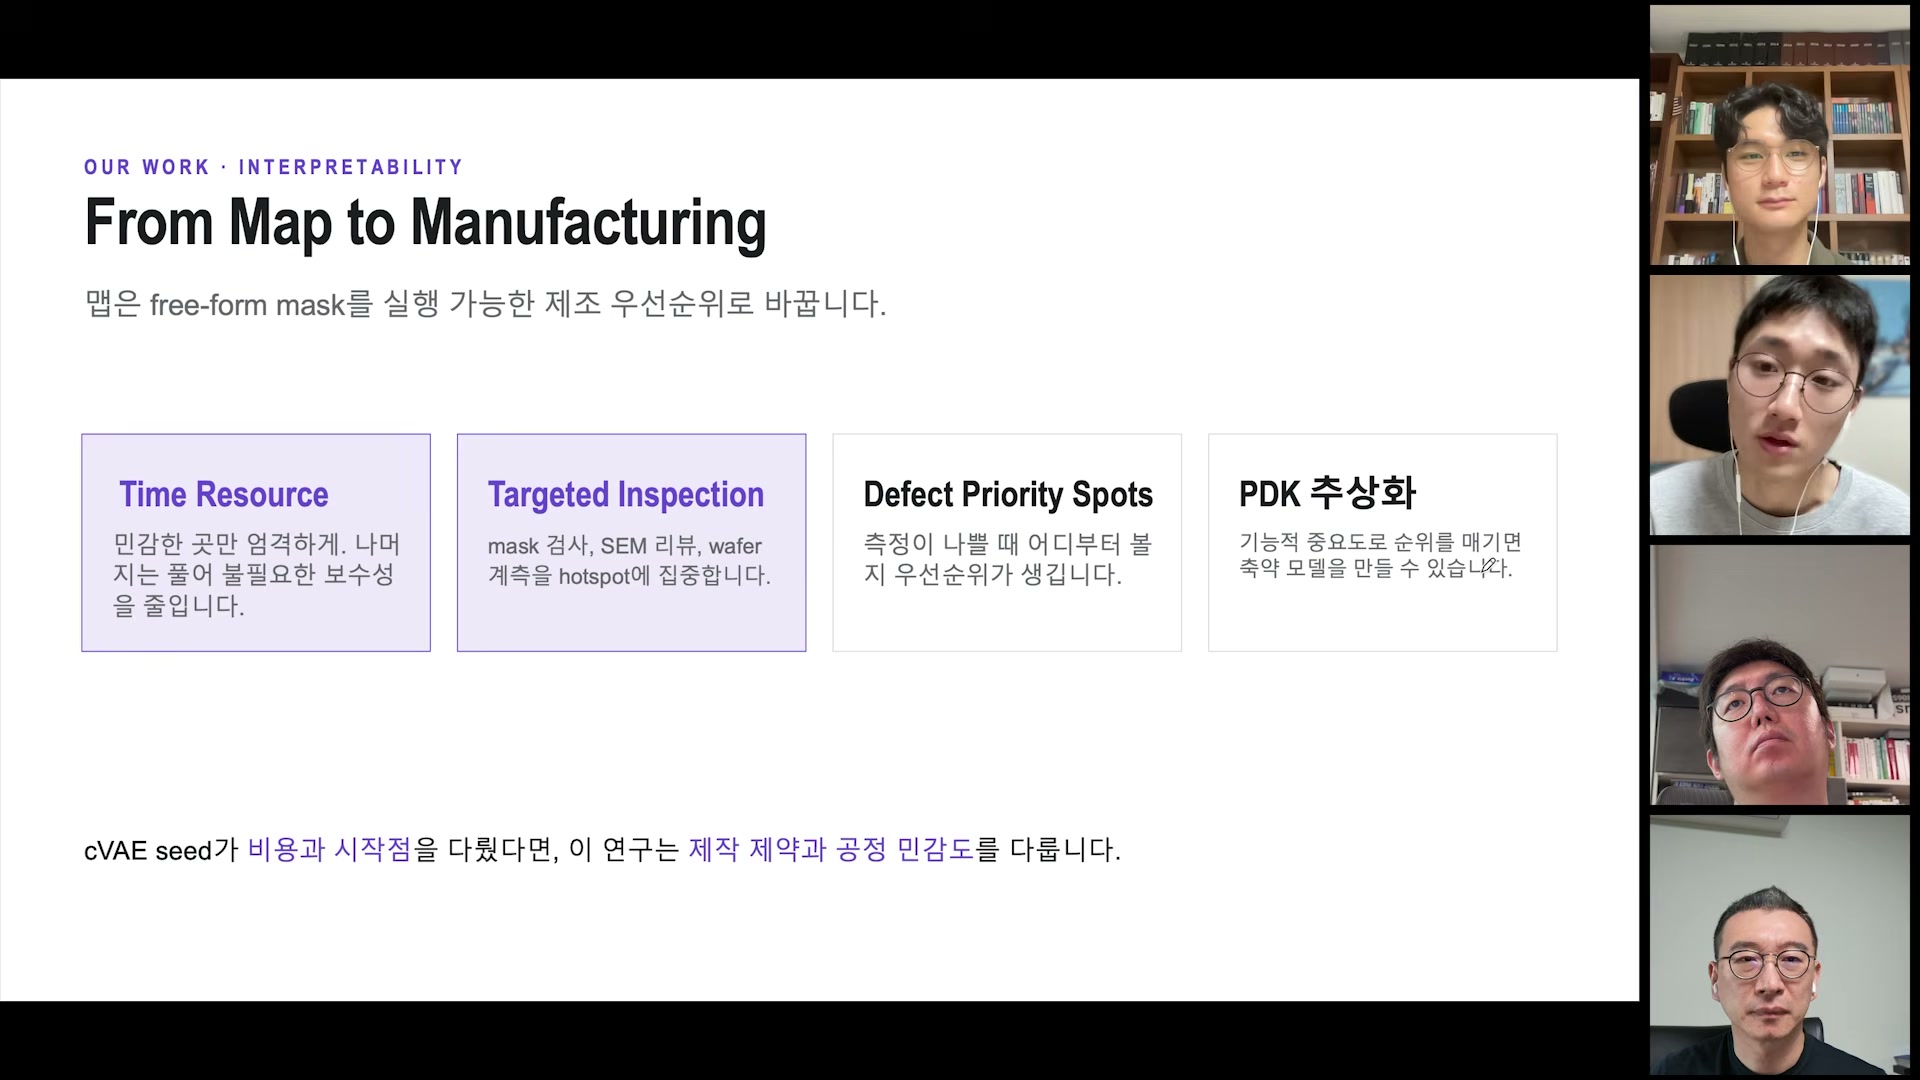
From Map to Manufacturing 슬라이드는 cVAE가 다루는 비용·시작점의 문제와, 제조가 다루는 공정 제약·민감도를 연결한다. Time Resource는 민감한 곳만 엄격하게 검사해 불필요한 보수성을 줄이고, Targeted Inspection은 mask 검사·SEM review·wafer 계측을 hotspot에 집중한다.
여기에 defect priority spots와 PDK 추상화를 더하면, 설계자는 모든 자유형 구조를 동일하게 취급하지 않고 기능적으로 중요한 부분부터 공정팀에 전달할 수 있다. 발표자들은 이런 photonics·fabrication 인력이 아직 많지 않지만 수요는 커지고 있다고 덧붙인다.
[1:12:35] 21. Data + Physics + Experiment의 자기개선 루프
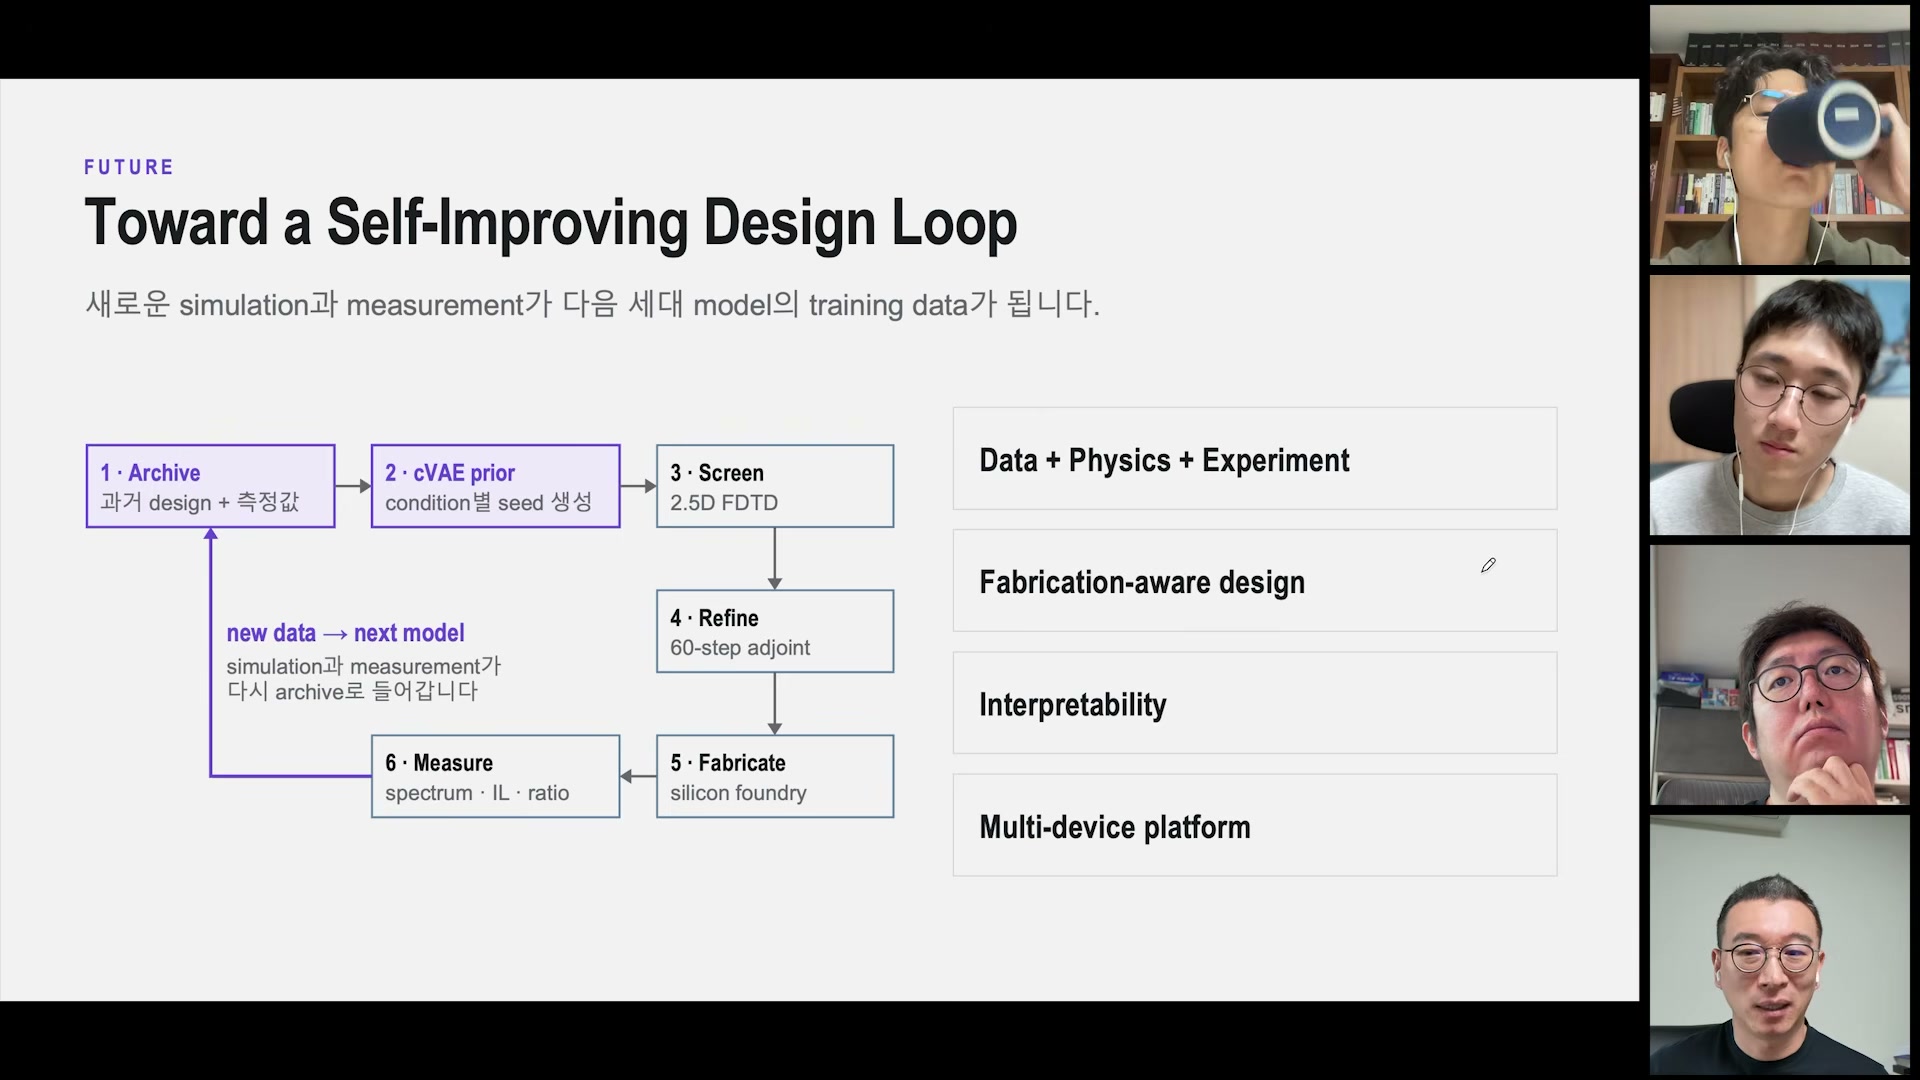
최종 루프는 Archive(과거 design+측정값) → cVAE prior → Screen(2.5D FDTD) → Refine(60-step adjoint) → Fabricate(silicon foundry) → Measure(spectrum·IL·ratio)로 이어진다. 측정값은 다시 archive로 들어가 다음 모델의 학습 데이터가 된다. 오른쪽에 적힌 Data + Physics + Experiment, fabrication-aware design, interpretability, multi-device platform이 이 루프의 설계 원칙이다.
후반부 대화는 이 방법을 AI for Science 전반으로 확장한다. domain expert가 문제의 목적과 제약을 정의하고, 넓은 분야에서 도구와 아이디어를 끌어오며, agent가 Integrated Gradients·cVAE 같은 도구를 사용해 광회로 후보를 탐색하게 하는 방향이다. 결론은 “모델에게 밑바닥부터 전부 맡긴다”가 아니라, 사람이 큰 방향성·insight·intention을 설정하고 compute와 agent로 search 공간을 넓힌다는 것이다.
부록 — 실전 체크리스트
- 내 시스템의 병목이 compute, memory, chip-to-chip inter-communication 중 어디에 있는지 먼저 분리한다.
- 링크별로 bandwidth, reach, channel loss, energy per bit, cooling·reliability를 함께 측정한다.
- pluggable·on-board·CPO·optical I/O 중 어느 경계를 옮기는 것이 이득인지, serviceability·yield·fiber attach까지 포함해 결정한다.
- WDM을 도입한다면 MUX/DEMUX, wavelength locking, 온도 제어, filter 성능을 별도 설계 변수로 둔다.
- inverse design의 objective에 optical performance만 넣지 말고 geometry regularity, fabrication budget, interpretability를 함께 넣는다.
- 좋은 설계뿐 아니라 실패한 설계와 측정값도 archive하고, simulation→fabrication→measurement 결과를 다음 모델에 재사용한다.
관련 페이지
원문 인용 모음
- [13:02] “그래서 구리선으로 밴드위스를 높이는 데는 상한선이 있는 거예요.”
- [20:20] “그다음에 energy per bit는 낮을수록 좋은 거고요.”
- [22:28] “광 신호를 전기 신호로 바꾸는 거예요.”
- [26:48] “constructive interference와 destructive interference를 이용합니다.”
- [34:46] “채널을 굉장히 많이 늘릴 수 있는 거죠.”
- [40:19] “디자인이 굉장히 unintuitive합니다.”
- [46:17] “마찬가지로 이 photonics 쪽에서도 뼈대를 만들고 그 뼈대에서 중요한 부분만 시뮬레이션으로 refinement를 하는 방식으로 가능하지 않을까?”
- [52:53] “그 나쁘고 좋은 디자인에 대한 정보를 재사용하지 않더라고요.”
- [55:57] “실제 fabrication의 갭이 되게 좁더라고요.”
- [57:05] “이제 저희가 1초면 만 개의 디자인을 이론상 뽑아낼 수 있는 거죠.”
- [1:00:01] “square root of A over P라는 manufacturability index를 저희가 임의로 설정한 겁니다.”
- [1:07:01] “패브리케이션 단계에서 저쪽 부분을 무조건 신경 써달라는 인사이트가 나오는 거죠.”
- [1:22:36] “이런 포토닉스 회로를 설계시키면 어떨까라는 연구도 굉장히 재미있을 것 같아서 agent 쪽으로도 요즘 보고 있습니다.”