출처 https://youtu.be/tgCoPeWsTU8 · 채널 AI Frontier Korea (노정석) · 길이 1:55:37 · 공개 2026-08-02 포맷 노정석·박종현·최승준이 2026년 8월 1일에 녹화한 팟캐스트 대담. Kimi K3가 오픈웨이트로 풀린(7월 27일) 닷새 뒤다. 두 개의 결이 섞여 있다 — [14:21]~[70:22]는 Kimi K3 테크니컬 리포트를 화면에 띄우고 함께 읽는 페이퍼 리뷰(도표·표를 텍스트로 옮길 값이 있다), [70:42] 이후는 오픈웨이트 기사와 최승준의 RSI 노션 문서를 배경에 둔 토론이다. 오프닝 14분은 화면 없이 주식 이야기로 시작한다. 원본 자막: raw source:
2026-08-02-ai-frontier-ep107-unpredictable-future(raw/transcripts) 직전 회차: 2026-07-26-ai-frontier-ep106-intelligence-supply-war
한눈에 보는 요약
- 미래를 가장 잘 예측했다는 사람이 시장에서 청산당했다 —
Situational Awareness를 쓴 Leopold Aschenbrenner가 인프라 롱·소프트웨어 숏 포지션에 레버리지를 걸었다가 상장 포트폴리오 대부분을 잃었다. 방향이 아니라 날짜가 틀렸다. - 그 변동성의 출발점은 Fable 차단이었다 — 미국 정부가 모델을 막는 걸 본 순간 “미국의 프론티어에 기대면 된다”는 전제가 깨졌고, 거기에 기름을 부은 게 Kimi K3다. 노정석의 표현으로 **“우리도 우리 Claude가 있어야겠다”**는 각성.
- Kimi K3 페이퍼는 모델 설명서가 아니라 프론티어 랩의 workflow 설계 요약본이다 — 2.8T 파라미터·104B activated·1M context, KDA·Attention Residual·Stable LatentMoE로 K2 대비 스케일링 효율 2.5×.
- KDA는 KV 캐시를 없애려고 LSTM과 Mamba를 다시 불러온 구조다 — positional encoding조차 없다(NoPE). 노정석의 어림으로 전통적 attention 대비 메모리 약 75% 절감. 목적은 성능이 아니라 inference 비용.
- 박종현의 반론이 이 회차의 좋은 대목 — inductive bias를 다시 집어넣는 건 Transformer가 걸어온 길의 역행이고, compute가 제한된 중국 랩이 그 제약 아래서 낸 최적해로 읽어야 한다.
- 아키텍처는 중요도의 10%, 나머지 90%는 데이터와 compute다 — 그런데 페이퍼는 정확히 그 90%를 가려 놓았다. 노정석은 이걸 **“논문이 Instagram 숏폼이 되고 있다”**고 표현했다. 자극적인 앞부분을 보여주고 진짜는 숨긴다.
- 그래서 세 사람은 아키텍처 딥다이브를 접기로 했다 — “이제 모터 안이 어떻게 돼 있는지는 덮고 다음 layer로 가겠다.”
- 오픈웨이트가 정치가 됐다 — Jensen Huang이 생애 첫 X 포스트로 낸 성명에 일주일 만에 235개사가 서명했고, 미국 주요 랩 중 Anthropic만 끝까지 서명하지 않았다.
- 모델 회사의 value capture가 무너지고 있다 — Anthropic 1T급 밸류에이션 대 Kimi 약 $35B. 노정석의 판정은 “Kimi가 나쁜 게 아니라 Anthropic이 과대평가된 것”. Google과 달리 프론티어 랩은 독점을 굳힐 시간을 부여받지 못했다.
- 에이전트를 다 깔아도 사람이 없어지지 않는다 — 능력이 부족해서가 아니라 제어가 안 되기 때문이다. 노정석의 처방은 복식부기 원장에서 착안한 control plane, 그리고 메모리를 후행이 아니라 선행에 두는 것.
- RSI는 이미 초입이다 — Pacing the Frontier 공개 서한에 프론티어 랩 직원 1,324명이 서명했지만 세 사람의 판정은 “다 외교적 제스처”. 2023년 FLI 서한도, 2022년 AlphaCode 논문의 경고도 똑같았고 아무도 멈추지 않았다.
- 그래서 결론은 겸허함이다 — Terence Tao조차 “1년 너머는 신뢰할 만하게 예측할 수 없다”고 했고, 최승준은 Yuk Hui의 Contingency(우발성)를 꺼내 “계산 밖에서 오는 것을 제거하지 말고 관계 맺기의 대상으로 삼자”고 제안한다.
핵심 한 줄: 지능을 만드는 레시피는 이제 누구의 것도 아니고, 그래서 가치는 모델 층에서 아래(칩)와 위(애플리케이션)로 흩어진다. 남은 문제는 기술이 아니라 비결정적인 에이전트를 무엇으로 가둘 것인가이고, 그 답을 아무도 1년 앞까지 예측하지 못한다.
1부 — 주가 롤러코스터와 Leopold Aschenbrenner
[00:00] 백서를 쓴 사람이 자기 백서에 레버리지를 걸었다
이번 주 가장 재미있는 소식으로 노정석이 꼽은 건 Leopold Aschenbrenner가 크게 손해를 봤다는 것이다. 시가총액 최상위 대형주가 이틀 연속 15%씩 폭락한 뒤 다음 날 30% 가까이 반등해, 주간 전체로는 1~2%밖에 안 빠진 롤러코스터가 벌어졌다.
Aschenbrenner는 Situational Awareness라는 백서로 전력 계통부터 칩, 그 위 레이어까지 무슨 일이 일어날지를 정리했던 인물이다. 그런데 말만 한 게 아니라 몇십 조 단위의 펀드를 직접 굴렸다. Anthropic 같은 비상장 주식을 담고, 자신감이 붙자 레버리지를 얹었다. 논리는 백서 그대로였다 — AI·인프라·전력 회사는 오르고, 기존 소프트웨어 회사는 모델 발전에 밀려 사라진다. 그래서 Adobe와 Figma 같은 회사에 숏을 걸었다.
지난 짧은 기간 동안 포트폴리오는 정확히 반대로 움직였다. 인프라가 폭락하고 소프트웨어가 올랐다. 상장 주식 포트폴리오 대부분을 잃었고, 그 주식들은 Citadel이 싼값에 잘 주워 갔다는 이야기가 돌았다. 그럼에도 Anthropic 같은 비상장 지분의 평가액 덕에 펀드 전체는 여전히 +80% 수준이라고 한다.
[04:02] 마진 콜은 방향이 아니라 날짜를 본다
최승준이 실무적인 질문을 던졌다. 장기 방향이 맞는데도 왜 청산당하나?
노정석의 설명은 간단하다. 숏을 치려면 주식을 빌리고 증거금을 낸다. 그 가치가 증권사가 요구하는 선 아래로 떨어지거나 떨어질 것 같으면 증권사는 원금 회수를 위해 자동으로 반대매매를 건다. 최승준이 정리한다 — “방향성을 본 게 아니라 그냥 기계적으로 반응했다는 거네요.”
그래서 몇 년 주기로 설계된 포트폴리오가 하루 단위 변동성에 노출되면 그 구간 어딘가에서 반대매매를 당할 위험이 상시로 존재한다.
[05:24] 인프라 다음에 오는 것 — 닷컴·모바일의 데자뷔
박종현이 “그래서 뭘 사야 하나요”라고 묻자 노정석은 사견을 전제로 인프라 주식은 아직 한참 더 간다고 답한다. 다만 단서를 단다. 주가는 현실이 아니라 기대를 반영하고, 진실이 오면 기대가 빠지면서 떨어지는 성향이 있다.
역사가 두 번 같은 모양이었다.
- 닷컴 — 처음 뜨거웠던 건 Cisco 같은 네트워킹 하드웨어였고, 그다음이 Yahoo·Google·Meta 같은 애플리케이션이었다.
- 모바일 — 처음엔 칩 주식, 그다음이 지금 아는 애플리케이션 레이어 회사들.
지금 AI는 첫 단계다. 모든 사람이 에이전트를 굴리게 되면 필요한 computation은 지구상에 존재하는 것보다 훨씬 많으므로 데이터센터·칩·전력에는 수요가 한참 남아 있다는 게 시장의 전반적 관점이다. 반대편은 “몇몇 지식노동 회사만 잘 쓸 뿐이고 모델이 효율화되면 compute 수요는 그만큼 안 는다, 저건 거품이다”라고 싸운다. 아직 승부가 나지 않았다.
노정석이 강조하는 건 그다음이다 — 모바일 시대의 Uber나 Airbnb에 해당하는 애플리케이션 레벨 회사가 아직 출현하지 않았다.
박종현은 Aschenbrenner의 포트폴리오에서 Nebius의 비중이 컸다는 데 놀랐다고 한다. NVIDIA에서 GPU를 사서 클라우드로 꾸려 임대하는 네오클라우드 회사다. ICML에서 Nebius 부스를 보고 “학회인데 신기하다” 싶었는데, 공급망 사슬에서 NVIDIA와 메모리 회사 바로 다음 칸이라 변동성이 가장 크게 실리는 자리라는 걸 이번에 확인했다는 것이다.
[09:31] 20대 미래 전략가도 헛발질은 한다
최승준이 인물을 다시 살폈다. Aschenbrenner는 2024년 6월 Dwarkesh Podcast에 출연했고, 그 전에는 OpenAI superalignment 팀에서 미래 전략가로 일하다 유출 논란으로 자기 변론도 못 한 채 밀려났다. 이후 Situational Awareness를 냈다. 같은 계보로 Daniel Kokotajlo(역시 OpenAI 출신)가 AI 2027을 냈고 얼마 전 AI 2040을 발표했다.
최승준의 요지는 **“20대 초반의 패기 있는 미래 전략가도 헛발질은 얼마든지 할 수 있는 판”**이며, 그 신호와 장기 방향성은 상관이 없다는 것이다.
노정석은 반쯤 동의하고 반쯤 반박한다. 전 재산을 잃어보고 그 고통에 몸부림쳐 본 사람만이 그 위에 자산을 쌓는다는 것. 그리고 사람들이 놓치는 통계 이야기를 덧붙인다 — 다들 자기가 옳았던 것만 말하고, 우리는 “얘가 얼마 벌었대”까지만 보지 일주일 뒤 그에게 무슨 일이 일어났는지는 추적하지 않는다. 그러니 누가 주식으로 얼마 벌었다는 이야기에 FOMO를 느낄 이유가 전혀 없다.
[12:10] 시총 1·2위가 하루에 15%씩 움직이는 시장
노정석이 정말 이상하다고 본 건 대형주의 변동성 자체다. 코스닥의 몇백억짜리 회사가 하루 15~30%를 오르내리는 건 말이 되지만, 하이닉스·삼성전자급 시가총액 1·2위 회사가 그러는 건 거의 모든 시장 참여자가 그 한두 종목으로 코인 거래를 하고 있다는 뜻이다.
주가는 미래에 기대되는 현금 흐름을 오늘로 할인한 기댓값이다. 내일이나 1년 후의 펀더멘털과는 상관관계가 없는, 기대에 도박하는 시장이라는 본질을 이해해야 한다는 것. 이런 시장에서 변동성을 견디는 답은 결국 가치를 미리 알아보고 싸게 사서 오래 들고 있는 것인데, 최승준이 받는다 — “그게 쉽지 않으니까 이 난리가 나는 거죠.”
[13:41] Fable 차단이 촉발한 sovereign AI 각성
노정석은 이 모든 내러티브의 출발점을 Anthropic이 Fable을 낸 시점으로 잡는다. → claude-fable-5
Fable이 어마어마한 능력과 보안 문제를 동시에 갖고 있다는 호들갑이 이어졌고, 결국 미국 정부가 모델을 막아버렸다. 여기에 GPT-6로 추정되는 모델의 Hugging Face 침입 사고까지 겹쳤다. 노정석은 Anthropic의 행보를 계속 보다 보면 “이건 잘 짜인 마케팅일 가능성도 높겠다”는 음모론 쪽으로 조금 기울었다고 솔직히 밝힌다.
중요한 건 그 결과다. 미국은 자유 세계를 수호하는 아이콘이고, 그 동맹의 프론티어 모델에 기대면 잘 살 수 있다는 전제가 깨졌다. 그때부터 sovereign AI를 포함한 생각들이 바뀌기 시작했고, 오픈웨이트 움직임이 생겼다. 노정석 본인도 **“우리도 우리 Claude가 있어야겠다”**고 생각하고 있다고 한다.
그 불에 기름을 부은 게 Kimi K3다. Claude Opus급 능력을 오픈웨이트로 풀었고, 돈을 아주 많이 벌면 그때부터 내라는 라이선스 조항이 있을 뿐 대부분의 회사에는 무료다. Nebius를 포함한 클라우드 사업자들이 이미 K3를 올려 서비스하고 있다. → kimi-k3
2부 — Kimi K3 페이퍼: 프론티어 랩의 설계 요약본
[15:16] 이 페이퍼를 한 줄로 요약하면
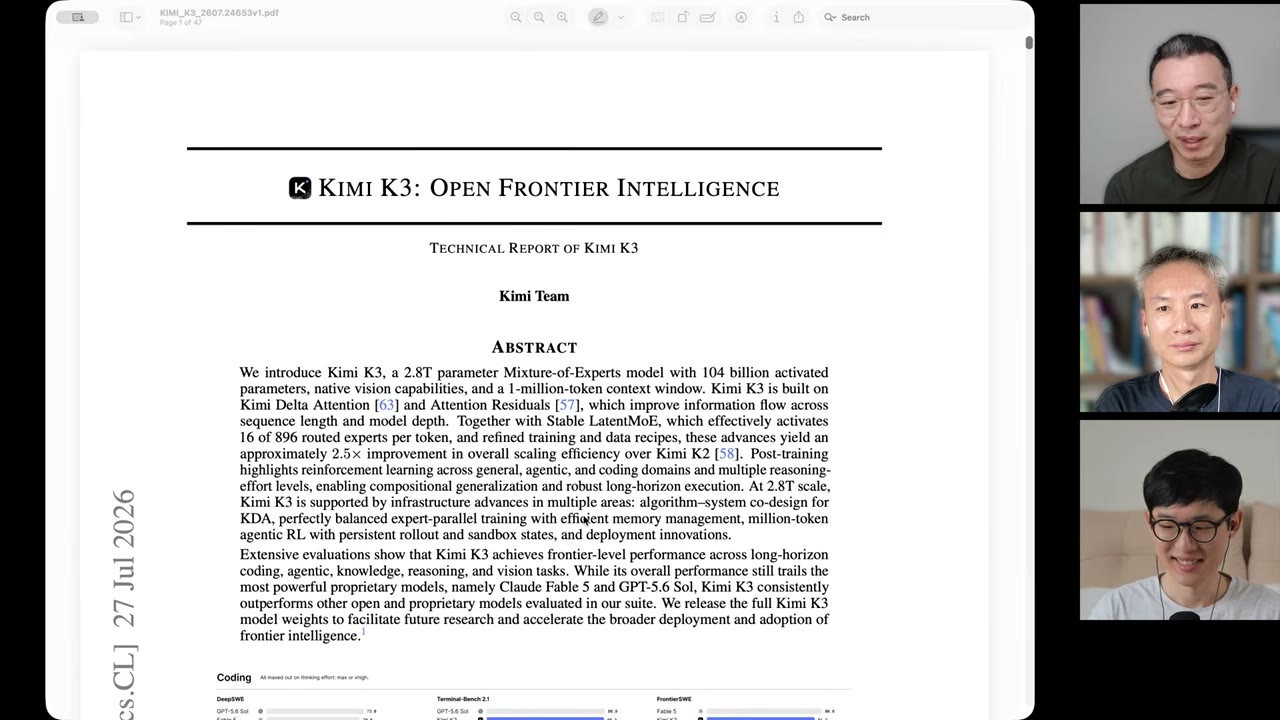
Kimi K3: Open Frontier Intelligence, Technical Report of Kimi K3, arXiv 27 Jul 2026, 47쪽. 초록이 스펙을 그대로 담고 있다.
2.8T 파라미터 MoE, 104B activated, native vision, 1M 토큰 context. Kimi Delta Attention과 Attention Residuals 위에 세워졌고, Stable LatentMoE는 896개 routed expert 중 토큰당 16개를 활성화한다. 여기에 정제된 학습·데이터 레시피를 더해 Kimi K2 대비 전체 스케일링 효율 약 2.5× 개선.
초록의 마지막 문장도 정확히 옮길 값이 있다. “가장 강력한 독점 모델인 Claude Fable 5와 GPT-5.6 Sol에는 여전히 못 미치지만, 평가 스위트의 다른 오픈·독점 모델들은 일관되게 앞선다.”
노정석이 이 페이퍼를 한 문장으로 요약한다 — “요새 프론티어 모델과 프론티어 랩의 workflow가 어떤 식으로 구성되어 있는지에 대한 전체 설계 요약본이다.” K2 때는 아키텍처를 DeepSeek 것에서 optimizer만 Muon으로 바꾼 정도였는데, 올해 초 DeepSeek이 sliding attention·attention compression으로 KV 캐시 용량 문제를 건드리면서 알고리즘적 진화가 일어났고, K3는 그 위에 올라섰다. → kimi-k2
박종현이 페이퍼의 내용을 두 갈래로 분류한다 — ① 모델이 어떻게 생겼는가(아키텍처), ② 그 weight를 어떻게 똑똑하게 만들 것인가(학습 방법·데이터 생성·RL 환경). K2 페이퍼는 후자에 지면을 많이 썼다.
K3에서 눈에 띄는 변화가 있다. pre-training dataset 이야기가 거의 사라졌고, compute 총량과 토큰 수는 아예 언급이 없다. 대신 post-training에 지면이 몰려 있다. 노정석의 평 — 각 단락이 하나의 논문이 돼도 될 만큼 굵직한 것들의 융합체라, Kimi나 DeepSeek을 따라 하기만 하려 해도 어마어마한 노력이 든다.
[20:17] 벤치마크를 믿을 수 있나
K3는 자체 평가에서 Claude Opus나 GPT-5.6 Pro보다는 좋고 GPT-5.6 Sol이나 Fable보다는 살짝 못하다고 밝혔다. 다만 요즘 small model이 large model을 벤치에서 넘어서는 일이 잦아 노정석은 벤치마크 자체를 의심한다.
박종현의 경험칙이 유용하다 — 상용 서비스를 하지 않고 사용자가 적은 모델일수록 벤치 overfit 경향이 심하다. 벤치 점수는 올랐는데 general한 실사용에서는 안 좋다. 그런 관점에서 Kimi는 실제로 상용 서비스를 크게 하려는 목적이 있으므로 벤치와 실사용의 상관성이 그나마 높은 편이라고 본다.
최승준은 다른 각도를 댄다. DeepSeek V4 Flash도 벤치가 상당히 좋았고, Claude Opus 5가 일부 Fable을 넘는 벤치를 낸 걸 보면서 **“Fable 5.12가 나오겠구나”**라고 느꼈다는 것이다. 상위 모델을 넘어서는 벤치가 나온다는 건 그 상위 모델의 다음 버전이 임박했다는 징후로 읽힌다. → deepseek-v4
노정석이 받는다 — “그 간격이 너무 줄어들고 있죠. 지금 소위 특이점을 지나고 있는 단계라 그런 게 아닌가. 분명 사람의 속도는 아니라고 미루어 짐작할 수 있잖아요.” 최승준이 여기에 이름을 붙인다 — “그게 RSI인 거죠. RSI의 진입점에 있는 상황으로 보이는 징후들.”
[22:13] 핵심 스펙과 네 개의 기여
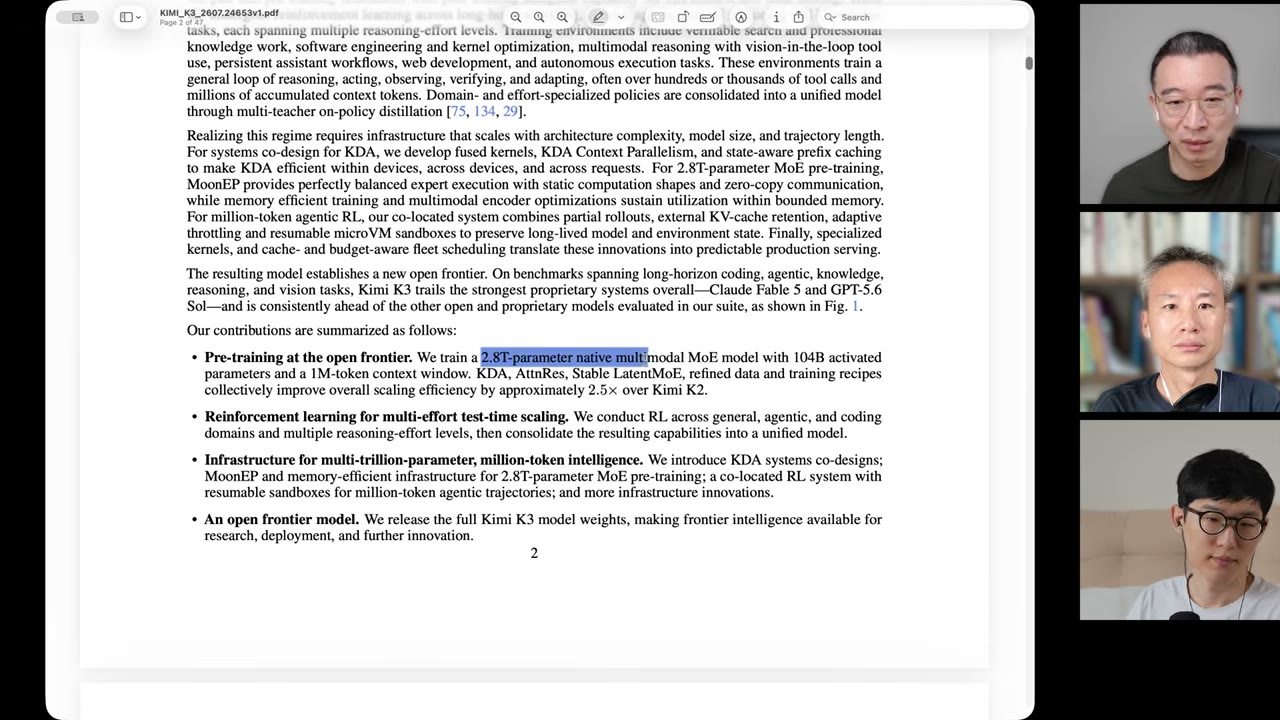
페이퍼가 스스로 정리한 기여는 넷이다.
| 기여 | 내용 |
|---|---|
| Pre-training at the open frontier | 2.8T 파라미터 native multimodal MoE, 104B activated, 1M context. KDA·AttnRes·Stable LatentMoE와 정제된 데이터·학습 레시피로 K2 대비 스케일링 효율 약 2.5× |
| RL for multi-effort test-time scaling | general·agentic·coding 도메인 × 복수의 reasoning effort 레벨로 RL을 돌린 뒤 하나의 모델로 통합 |
| Infrastructure | KDA 시스템 co-design, MoonEP(expert-parallel), 2.8T MoE 프리트레이닝용 메모리 효율 인프라, 재개 가능한 샌드박스를 갖춘 co-located RL 시스템 |
| An open frontier model | 전체 가중치 공개 |
같은 페이지의 본문이 학습 환경을 이렇게 묘사한다 — 검증 가능한 검색과 전문 지식 작업, 소프트웨어 엔지니어링과 커널 최적화, vision-in-the-loop 툴 사용, 지속적 어시스턴트 워크플로, 웹 개발, 자율 실행 태스크. 그리고 이 환경들은 수백~수천 회의 tool call과 수백만 토큰의 누적 컨텍스트에 걸친 reasoning–acting–observing–verifying–adapting 루프를 훈련시킨다.
[25:46] 아키텍처 한 장 — KDA 3× + Gated MLA 1×
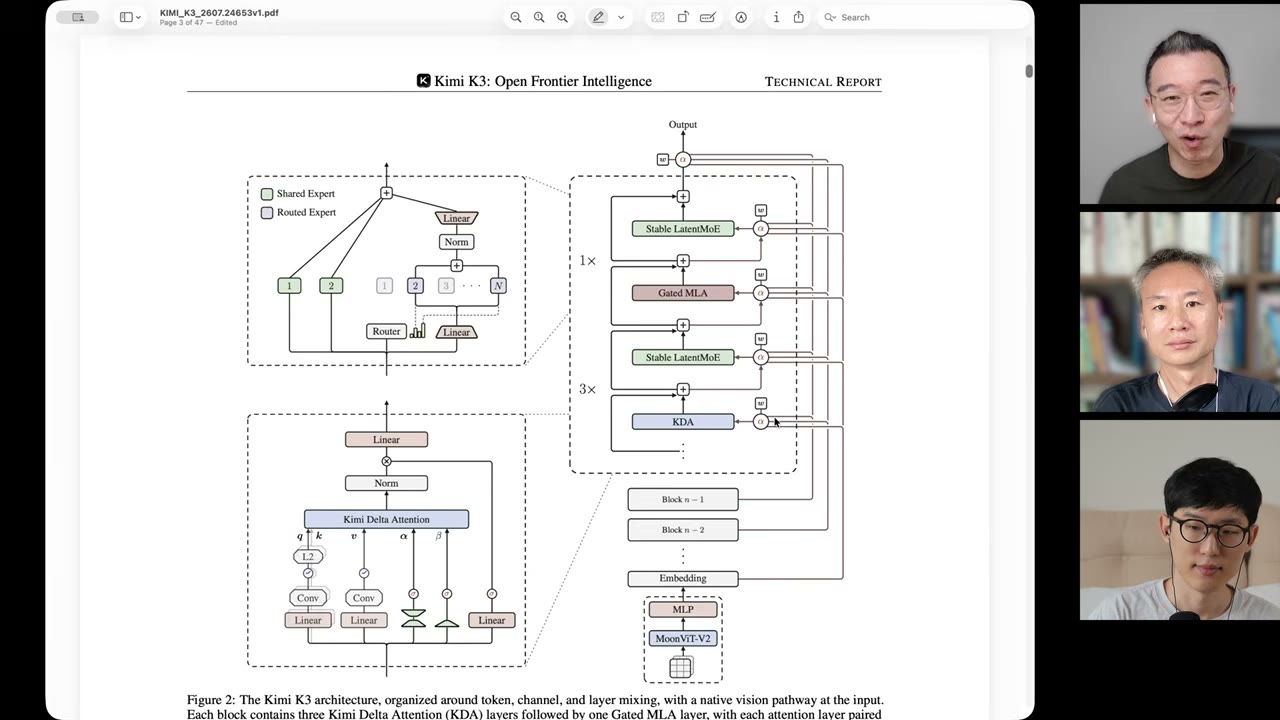
이 회차의 아키텍처 딥다이브 40분은 사실상 이 그림 한 장 위에서 이루어진다. 구조를 텍스트로 옮기면 이렇다.
- 입력단에 MoonViT-V2 + MLP로 native vision 경로가 붙어 있다. 별도 vision encoder를 나중에 접붙인 게 아니라 처음부터 end-to-end 안에 들어 있다.
- 반복 단위는 KDA + Stable LatentMoE를 3회, 그 위에 Gated MLA + Stable LatentMoE를 1회. 이
3× + 1×가 하나의 그룹이다. - 오른쪽 아래에
Block n−1,Block n−2…Embedding이 늘어서 있고, 각 그룹의 출력이 아래쪽 모든 블록으로 가는 굵은 선을 갖는다. 이게 Attention Residual이다. - 왼쪽 위는 MoE 확대도(Shared Expert 2개 + Routed Expert 다수, Router와 Linear), 왼쪽 아래는 KDA 확대도(q·k·v·α·β 입력, L2, Conv, Linear, Norm).
전체 layer 수는 Table 1 기준 93개다. 한 그룹이 4개 layer이므로 그룹은 스물 몇 개가 된다. 방송 중 노정석은 97로 말했고 최승준이 “전체 93개 layer인가”라고 되묻는데, 대화는 숫자 대신 블록 단위의 혼동을 푸는 쪽으로 넘어간다. 표 기준은 93이다.
[26:33] KDA — LSTM과 Mamba를 다시 불러와 KV 캐시를 없앴다
노정석이 KDA 그림을 보고 처음 느낀 건 **“이거 그냥 옛날 LSTM 느낌”**이었다. 최승준이 받는다 — “RNN 시절에 그거죠.”
인튜이션은 Mamba(State Space Model)의 그것과 같다. 학습할 때는 Transformer처럼 전체 sequence를 병렬로 넣고, inference할 때는 recurrent model처럼 하나씩 내놓는다. 그러면 Transformer의 비효율이 크게 사라진다. KDA는 여기에 Transformer와 LSTM을 섞었다 — 전통적인 KV 캐시 블록을 갖고 있지 않고, Mamba처럼 하나의 블록이 memory 블록이며, 그 안에 attention스럽게 QKV를 구현해 두고, input gate와 forget gate로 과거에서 미래로 쌓아 나간다.
그 결과 positional encoding이 하나도 없다. KDA 블록 자체가 sequence를 처리하므로 위치 정보를 따로 넣을 필요가 없다. 페이퍼가 이걸 NoPE(No Positional Embedding)라고 부른다. 노정석은 이 구조가 Mamba 블록과 attention 블록을 중첩시킨 Nemotron과 매우 흡사하다고 짚으며, 아이디어라는 유전자가 서로 이종 교배되고 있는 것과 비슷하다고 봤다. → nemotron
세 사람이 정리한 KDA의 작동 방식이 좋다.
- 전통적 attention — 과거의 K와 V를 다 들고 있다가 Q를 적용해 전부 계산해 보고, 어떤 과거가 나와 관련 있는지 찾아낸다.
- KDA — 쌓여온 delta에 query를 적용하면 “네가 찾는 value는 이거”라고 그냥 내준다. 박종현의 정리 — “과거 정보를 다 갖고 있는 게 아니라 더 작은 vector latent space에 압축해 넣고, 넣는 법마저 학습시키겠다.” 최승준은 이걸 연상 기억 장치나 fast weights로 표현하는 사례가 있다고 덧붙인다.
왜 이렇게까지 하나. 목적은 언제나 같다 — 메모리와 compute를 줄이는 것. 노정석의 어림으로 KDA는 전통적 attention 대비 **memory-wise 약 75%**가 줄어든다. K3가 큰 파라미터를 갖고도 quantization이 잘 안 든다는 이야기가 도는 것도 이미 안에서 줄일 대로 줄여 놨기 때문이다.
다만 KV 캐시가 완전히 사라진 건 아니다. 최승준이 짚은 대로 Gated MLA에는 전통적 KV 캐시가 여전히 있어, KDA 블록에서 과도하게 소실됐을 수 있는 구조를 트래킹하는 역할을 한다. MLA 자체가 DeepSeek에서 본 것으로, hidden dimension 의존성을 한 번 더 latent로 내려 attention까지 압축한 구조다.
노정석의 총평은 냉소적이면서 정확하다 — 이건 이론이 있어서 만드는 게 아니라 “이렇게 하면 정보가 더 효율적으로 흐르겠네” 하고 해봐서 되면 되는 것이고, 그래서 발명이 아니라 발견의 단계에 들어간 것 같다는 것. 그가 붙인 단어는 연금술이다.
[32:13] 반론 — inductive bias를 다시 넣는 건 역행 아닌가
박종현이 이 회차에서 가장 좋은 반론을 낸다.
Transformer의 큰 골자는 RNN·LSTM 대비 규모는 크지만 알고리즘은 훨씬 간단하다는 것이다. 정형원 박사의 발표를 빌리면, “기억은 이렇게 하는 것”이라는 가이드 매뉴얼(inductive bias)을 싹 철폐하고 데이터를 때려 박아 알아서 배우게 하면 결국 배워낸다는 인튜이션에서 출발한 구조다. 그 관점에서 보면 KDA가 LSTM스럽다는 건 “과거를 어떻게 해라, 어디를 봐라”를 알고리즘으로 다시 다 집어넣은 것이라 역행으로 볼 수 있다.
그가 사람으로 비유한다. 신입에게 “이렇게 해야 돼”라고 강제하는 건 자유도와 잠재력을 제한하지만 상당히 효율적인 교육을 가능하게 한다. 그러니 이건 compute가 제한된 상황, 게다가 중국이라는 자원 제약 아래서 가장 효율적으로 큰 모델을 학습시키려는 고민의 결과물로 읽어야 한다는 것이다. 그리고 시간이 지나면 효율을 쌓다가 한계를 만나고 다시 풀어내는, 역사의 반복을 또 마주하게 될 거라고 본다.
노정석이 보완한다. 이 아키텍처에는 반드시 plateau가 있고 그걸 넘으려면 완전한 architectural change가 필요하다. 그런 연구를 하겠다는 회사들이 요즘 Bay Area에서 몇 billion 단위로 투자를 받고 있다. 그리고 inductive bias를 강제하는 진짜 이유는 하나다 — inference. training time의 비효율은 감내할 수 있지만 inference workload가 훨씬 크고, 그 최대 병목이 KV 캐시다. DeepSeek도 Kimi도 “KV 캐시를 어떻게든 없애버리자”에 가장 큰 모순이 숨어 있다고 본 것 같다.
박종현의 마무리가 이 장을 압축한다 — “Transformer라는 골자가 나온 지 거의 10년이 다 돼가는데, 그걸 끝까지 쥐어짜고 엔지니어링해서 최대한 끌어올리고 있는 과정.”
[36:06] Attention Residual과 Stable Latent MoE
기존 Transformer의 residual은 아래 input에서 위 output까지 한 칸씩 정직하게 쌓여 올라간다. DeepSeek이 여기에 학습 가능한 weight를 줘서 어떤 정보가 올라갈지를 학습시켰지만, 단계별 sequence를 건너뛰지는 않았다.
K3의 Attention Residual은 여기서 한 발 더 나간다. 저 아래 블록까지 건너뛸 수 있는 residual 파이프라인을 만들었다. 그림의 Block n−1, Block n−2 … Embedding이 그것이고, 최상위 블록이라면 아래 스물 몇 개 블록 전부(embedding 포함)에서 어떤 residual을 얼마의 비중으로 꺼낼지 weighting할 수 있다. 학습되는 건 W이고, α는 그 W에서 각 하위 layer의 비중을 softmax로 뽑는 계수다.
여기서 용어 혼동을 정리해야 한다. 그림의 Block n은 전통적 Transformer 블록이 아니라 KDA×3 + Gated MLA×1을 묶은 Attention Residual 단위다.
박종현이 시스템 관점의 질문을 던졌다 — 이러면 파이프라인 패럴리즘(앞 블록은 이쪽 GPU, 뒤 블록은 저쪽 GPU)에 개선이 필요하지 않나? 노정석이 정정한다. 이건 compute가 아니라 이미 끝난 결과를 캐시에서 꺼내오는 것이라 엄밀히는 memory problem이고 parallelism과는 별개다. 최승준이 “페이퍼에서는 PP와 관련이 있긴 있었어요”라고 하자 노정석이 웃으며 받는다 — “이런 경우를 다 방어하는 마법의 방어 용어가 있더라고요. 만약 그러시다면 여러분 말이 맞습니다.”
Stable Latent MoE의 특징은 압축이다. hidden dimension이 큰 상태로 MoE 블록에 올라오는데, shared expert 2개는 그대로 쓰고, routed expert를 고르는 과정에서 MLA처럼 차원을 절반으로 축소했다가 다시 펼쳐 원래 스트림과 더한다. Table 1의 Latent MoE Dimension: 3584 (0.5×)가 그 숫자다. 이 안에 numerical stability를 위한 알고리즘이 잔뜩 들어 있는데, 노정석의 표현으로는 “보는 순간 잠이 너무 몰려와서 덮었다.”
[42:44] “이제 이건 그만 보려고요”
이 지점에서 노정석이 선언을 한다. 페이퍼가 나올 때마다 아키텍처 리뷰를 해왔지만 이제 그만하겠다는 것이다.
이유는 이렇다. 커버만 살짝 봐도 인튜이션의 방향은 잡힌다 — inference workload가 커지고 있으니 KV 캐시를 줄여 메모리·compute 효율을 높이자는 큰 방향성이 저 안에 계속 구현되고 있을 뿐이다. 그리고 “이 안에 있는 내용들은 이제 사람이 할 것 같지도 않다.” 박종현도 동의한다 — 너무 복잡하고 새로운 것들이 계속 나와서, 다음에 innovation이라 부를 만한 큰 변화가 오면 그때나 관심 있게 볼 것 같다는 것.
최승준의 관찰이 이 대목을 잘 요약한다 — “공통적으로 나타나는 건 다 뭔가 가중합이에요. 예전엔 그냥 흘려보냈다면 이젠 그걸 선별하는 느낌.”
그럼에도 큰 제목들의 배치는 알고 있어야 한다는 게 노정석의 단서다. 이게 프론티어 랩들의 process 설계도이고, 어디가 병목이고 어디가 제일 중요한지에 대한 심상을 갖는 것이 — Aschenbrenner 이야기로 돌아가면 — 앞으로 나올 수많은 회사에 대한 판단의 기본 가정이 되기 때문이다.
[49:39] 프리트레이닝 데이터와 2.5× 스케일링
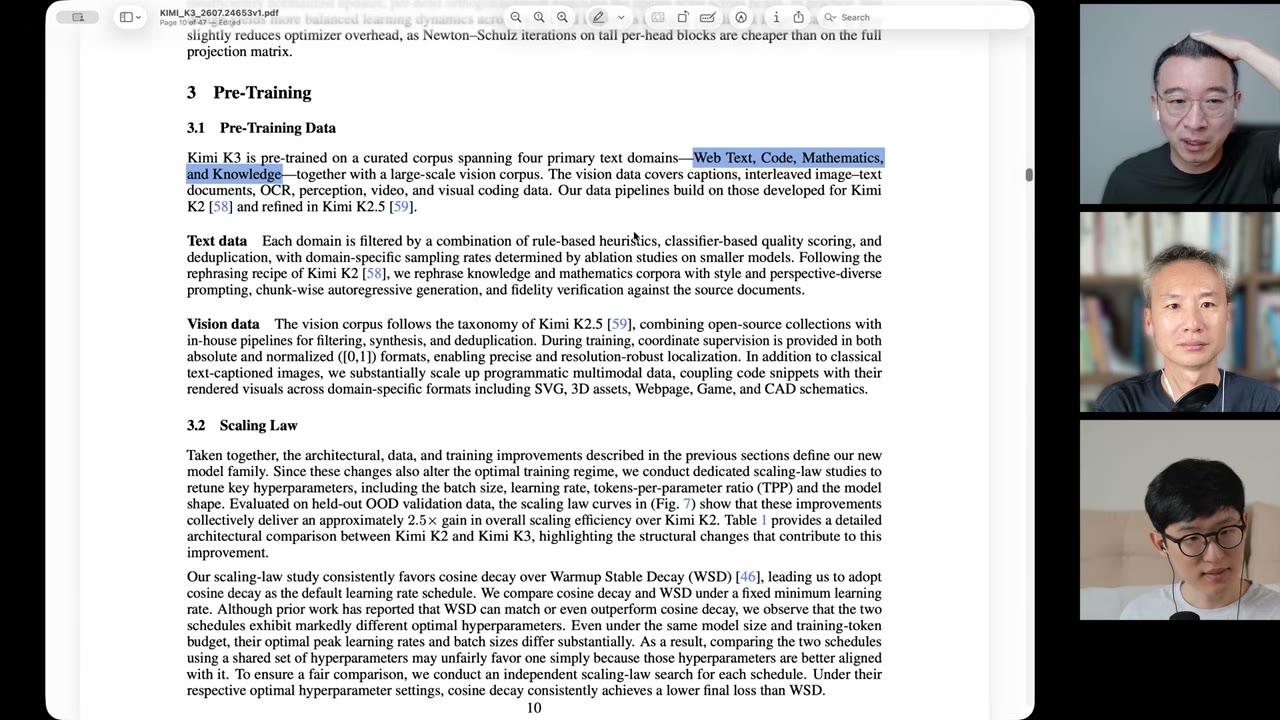
프리트레이닝 코퍼스는 네 개의 텍스트 도메인 — Web Text, Code, Mathematics, Knowledge — 에 대규모 vision 코퍼스를 더한 것이다. vision 쪽에는 캡션, interleaved image–text 문서, OCR, perception, video, visual coding 데이터가 들어간다. 파이프라인은 K2에서 만들고 K2.5에서 정제한 것을 그대로 쓴다.
텍스트는 규칙 기반 휴리스틱 + 분류기 기반 품질 점수 + 중복 제거로 필터링하고, 도메인별 샘플링 비율은 작은 모델에서의 ablation으로 정한다. K2의 rephrasing 레시피를 따라 knowledge와 mathematics 코퍼스를 문체·관점을 다양화해 재작성하고, 청크 단위 autoregressive 생성과 원문 대조 검증을 붙인다.
노정석이 짚는 건 없는 것이다. dataset 자체에 대한 언급이 없다. 랩마다 갖고 있는 프리트레이닝 코퍼스의 품질과 그 품질을 끊임없이 올리는 파이프라인이 core asset이기 때문이다.
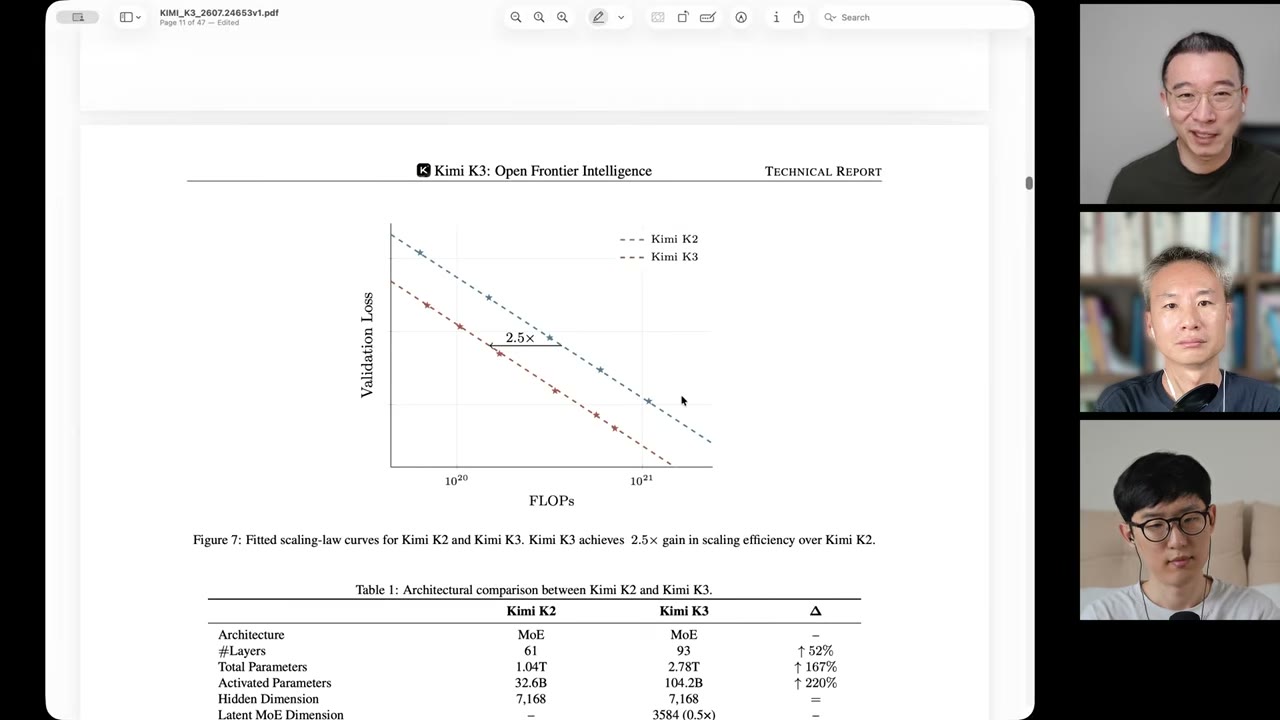
Figure 7이 K2와 K3의 fitted scaling-law 곡선을 겹쳐 놓고 2.5× 간격을 표시한다. 동일 compute에서 2.5배 빠르게 더 낮은 validation loss에 도달한다는 뜻이다. Table 1이 그 차이를 항목별로 보여준다.
| 항목 | Kimi K2 | Kimi K3 | Δ |
|---|---|---|---|
| Architecture | MoE | MoE | – |
| layers | 61 | 93 | ↑52% |
| Total Parameters | 1.04T | 2.78T | ↑167% |
| Activated Parameters | 32.6B | 104.2B | ↑220% |
| Hidden Dimension | 7,168 | 7,168 | = |
| Latent MoE Dimension | – | 3584 (0.5×) | – |
같은 페이지의 각주 하나가 실무적으로 유용하다. 스케일링 법칙 연구 결과 cosine decay가 WSD(Warmup Stable Decay)보다 일관되게 낮은 최종 loss를 냈는데, 두 스케줄은 최적 하이퍼파라미터가 크게 다르므로 같은 하이퍼파라미터로 비교하면 한쪽에 유리하게 기울어진다는 것이다. Kimi는 각 스케줄별로 독립적인 스케일링 법칙 탐색을 돌려 공정 비교를 했다.
[50:44] 학습 레시피와 1M 확장
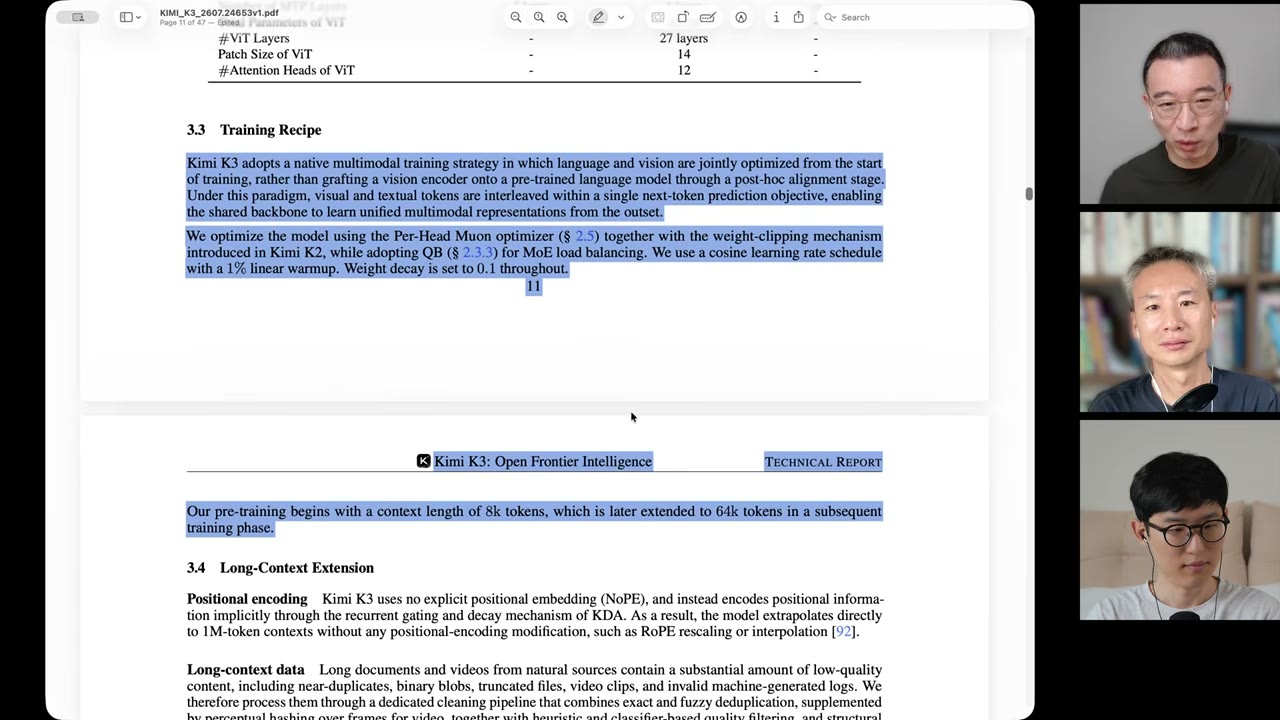
노정석이 “training recipe가 이 정도밖에 안 돼요”라며 짧은 분량을 지적한다. 최승준이 “중요해서 짧게 넣나요?”라고 묻자 답한다 — “완전히 거꾸로 말씀하신 거네요. 이게 자기네 노하우겠죠.”
그래도 화면에 남은 것들은 옮길 값이 있다.
- native multimodal 학습 — vision encoder를 사후에 접붙이는(post-hoc alignment) 대신 처음부터 language와 vision을 함께 최적화한다. 시각·텍스트 토큰이 하나의 next-token prediction 목적함수 안에서 섞인다.
- optimizer — K2에서 도입한 weight-clipping을 얹은 Per-Head Muon, MoE 로드 밸런싱에는 QB. cosine LR + 1% linear warmup, weight decay 0.1.
- context 확장 — 프리트레이닝은 8K로 시작해 64K로 확장하고, cooldown 단계에서 256K → 1M으로 늘리는 4단계 커리큘럼. 비싼 long-sequence 계산을 전체 예산의 작은 비율에 몰아넣는 방식이다.
- NoPE — 명시적 positional embedding을 쓰지 않고 KDA의 recurrent gating·decay로 위치를 암묵적으로 인코딩한다. 그 결과 RoPE rescaling이나 interpolation 없이 1M 컨텍스트로 그대로 외삽된다.
- long-context data — 자연 상태의 긴 문서와 영상에는 근중복, 바이너리 blob, 잘린 파일, 기계 생성 로그 같은 저품질이 많아 전용 클리닝 파이프라인을 돌린다.
[51:02] Post-Training 3단계와 1M long-horizon SFT
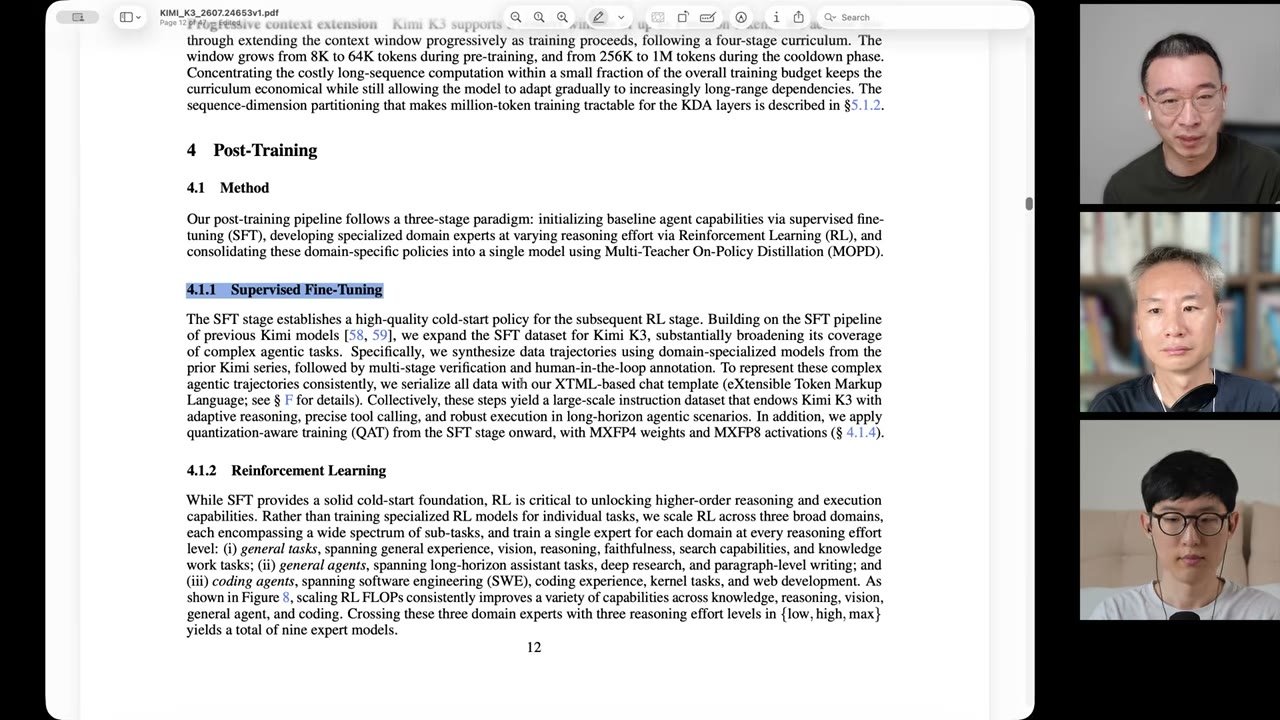
포스트트레이닝은 3단계다.
- SFT — 베이스라인 에이전트 능력을 초기화한다.
- RL — reasoning effort를 달리해 도메인별 전문가 모델을 만든다.
- MOPD(Multi-Teacher On-Policy Distillation) — 그 도메인별 정책들을 하나의 모델로 통합한다.
SFT 단계의 디테일이 중요하다. 이전 Kimi 시리즈의 도메인 특화 모델로 데이터 궤적을 합성하고, 다단계 검증과 human-in-the-loop 주석을 거친다. 이 복잡한 agentic 궤적을 일관되게 표현하려고 XTML(eXtensible Token Markup Language)이라는 자체 챗 템플릿으로 전부 직렬화한다. 그리고 SFT 단계부터 QAT(Quantization-Aware Training)를 적용한다 — MXFP4 가중치, MXFP8 활성값.
QAT에 대한 박종현의 설명이 명료하다. 지금까지는 학습은 높은 precision으로 하고 inference할 때 quantization해 bit 수를 낮췄는데, 실제 서빙은 보통 MXFP4다. 그러니 애초에 FP4로 학습된다고 가정하고, 반올림에 잘려 나갈 미세한 delta를 인지한 상태로 학습하면 나중에 할 quantization에 맞춰진 모델이 나온다. 인지의 주체는 모델이 아니라 training 코드다. LLM 이전 시대에도 쓰던 방법이 그대로 적용된 것이다.
노정석이 여기서 중요한 관점을 던진다. 1M context가 강조되는 진짜 이유는 long-running work — 1M을 가득 채울 만큼 왔다 갔다 하는 복잡한 agent workflow를 끊기지 않고 끝까지 마무리하는 것 — 때문이다. 과거에는 모델이 이 능력이 떨어져서 밖에서 하네스로 강제 프롬프트와 체크 로직을 잔뜩 넣었는데, 그 부분들이 계속 모델 안으로 들어가고 있다. → harness
그리고 증거 없는 의심을 하나 붙인다 — “이 SFT 부분이, Anthropic 같은 데서 ‘쟤들이 우리 모델을 엄청나게 distill했네’라고 하는 그 부분이 아닐까.” 최승준이 받는다. “잘 작동하는 궤적을 다 distill했다는 거죠.”
[54:07] tool call trail은 숨길 수 없다
박종현이 개연성을 보탠다. 1M짜리 long-horizon 궤적은 사람이 만들 수 있는 규모의 데이터셋이 아니고, 웹에 존재하지도 않는다. 사람들이 Claude Code 같은 것을 쓰면서 누적돼 나온, 전에는 존재하지 않던 종류의 데이터셋이다. 무에서 만든다고 생각하면 축적이 쉽지 않았을 테니 의심할 만하다는 것.
노정석의 구조적 설명이 이 장의 핵심이다. 현재 Anthropic과 OpenAI 모델은 reasoning trail은 가린다. 그런데 tool call trail은 숨길 수가 없다. 로컬에 와서 tool call을 다 하고 그 trail을 모델에 다시 넣어주는 구조라 없앨 수가 없기 때문이다. 게다가 프론티어 랩 입장에서도 distillation 트래픽과 real user 트래픽을 구분할 수 없다. 막고 싶어도 막을 수 없는 영역이니 **“바보가 아닌 이상 당연히 할 것이고, 해야 한다”**는 게 그의 판단이다.
그리고 원칙 문제로 확장한다. Anthropic이 distillation을 막아 달라고 하는 것에 대해 — 그들이 쌓아 올린 기저도 다 남의 책과 남의 데이터 위에 세운 것이다.
“제가 승준님이 쓴 책을 샀어요. 그 책을 읽어서 제 지식 체계가 업데이트됐어요. 그래서 제가 비슷한 글을 썼어요. 그럼 이게 제가 distillation을 했기 때문에 불법인가요? 아니잖아요.”
그래서 막을 수 없다고 보고, 서로 distillation되는 이 과정이 모델들이 상향 평준화되는 이유이기도 하다고 본다.
여기서 최승준이 좋은 질문을 던졌다 — “기술이 그렇게 다변화됐는데 왜 성능은 다 비슷해요?” 노정석의 답은 이렇다. 성능이 수렴한다기보다 아키텍처가 조금씩 다른 상태로 Pareto frontier curve가 형성돼 있는 것이고, 모두가 십시일반 알고리즘·데이터셋·인프라 개선을 더하며 인류 전체의 Pareto frontier가 전진하고 있다고 보는 게 맞다는 것. 최승준의 인상은 **“공통분모인 recipe가 있는 데서 조금 다변화되는 것”**이고, 노정석이 한 줄로 정리한다 — “다 따지고 보면 다 Transformer죠.”
[57:13] RL — 진짜 중요한 건 dataset coverage
RL 단계에서 노정석이 가장 중요하다고 본 건 인프라 꼼수가 아니라 dataset의 coverage다.
변호사나 회계사 같은 직무에 post-training을 한다고 하면, 지금은 가장 간단하고 상위 레벨의 업무만 RL할 수도 있다. 그런데 진짜 똑똑해지려면 그 subtask들에 대한 연습 문제, 수많은 edge case를 처리하는 연습 문제를 엄청나게 많이 풀어야 한다. 그래야 robustness가 생긴다.
페이퍼가 밝힌 RL 구조는 이렇다. 개별 태스크마다 특화 모델을 학습시키는 대신 세 개의 넓은 도메인으로 스케일한다.
- general tasks — 일반 경험, vision, reasoning, faithfulness, 검색 능력, 지식 작업
- general agents — long-horizon 어시스턴트 태스크, 딥 리서치, 문단 단위 글쓰기
- coding agents — SWE, 코딩 경험, 커널 태스크, 웹 개발
이 세 도메인 × {low, high, max} 세 개의 effort 레벨 = 총 9개의 expert 모델이 나온다.
[59:08] 인프라 꼼수와 reasoning effort의 제조법
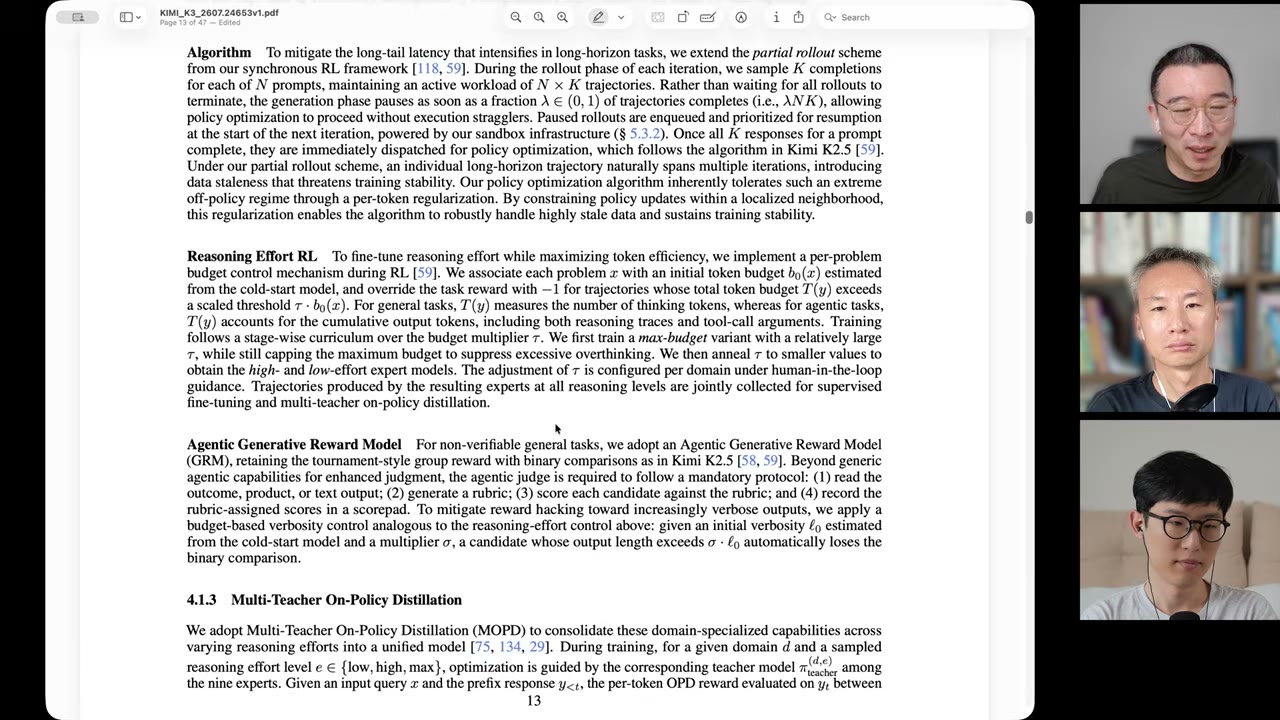
이 페이지에 실무적으로 재미있는 것들이 몰려 있다.
partial rollout — 하나의 문제에 여러 trajectory를 만들면 어떤 건 빨리 끝나고 어떤 건 늦게 끝난다. 원래대로면 다 끝나야 성공·실패를 모아 backprop할 수 있으니 비효율이 생긴다. K3는 N개 프롬프트마다 K개 completion을 샘플링하되, 완료 비율이 λ에 도달하면(λNK) 생성 단계를 일시 정지하고 먼저 정책 최적화를 진행한다. 멈춘 것들은 큐에 넣었다가 다음 이터레이션 시작 때 우선 재개한다. 노정석이 “그럼 다른 문제잖아요라는 질문이 당연히 나오는데, 그냥 그렇게 해도 된다는 이야기를 하고 있는 것”이라고 요약한 부분이다. 페이퍼는 이로 인한 데이터 stale 문제를 per-token regularization으로 흡수한다고 밝힌다.
Reasoning Effort RL — max/medium/low가 서로 다른 모델인지에 대한 답이 여기 있다. 다른 모델이면 코딩 중에 prefill된 KV 캐시를 들고 다른 팜으로 옮겨야 하는 비효율이 생기니 말이 안 된다. K3는 per-problem budget control을 쓴다. 각 문제 x에 콜드스타트 모델이 추정한 초기 토큰 예산 b₀(x)를 붙이고, τ·b₀(x)를 넘긴 trajectory에는 총 보상을 −1로 덮어쓴다. 학습 순서가 재미있다.
- τ를 비교적 크게 잡은 max-budget variant를 먼저 학습한다 → 문제를 최대한 넓히고 여러 군데를 가보며 reasoning trace를 길게 쓰는 성향의 모델이 된다.
- 그 모델에서 τ를 작은 값으로 anneal해 high·low expert를 뽑는다. 예산이 작아지면 모델은 cut corners, 즉 shortcut을 찾는 데 강하게 인센티브를 받는다.
Agentic Generative Reward Model(GRM) — 검증 불가능한 general 태스크에는 rubric 기반 채점을 쓴다. 에이전트 심판이 따라야 하는 프로토콜이 명시돼 있다. ① 결과·산출물·텍스트를 읽고 ② rubric을 생성하고 ③ 각 후보를 rubric으로 채점하고 ④ 그 점수를 scorepad에 기록한다. 그리고 모델이 점점 장황해지는 reward hacking을 막으려고 verbosity control을 건다 — 출력 길이가 σ·ℓ₀를 넘으면 그 후보는 이진 비교에서 자동 패배한다.
MOPD — 9개 teacher가 만들어지면 production 모델은 하나여야 하니, student 모델 옆에 도메인×effort 조합의 teacher를 앉혀 놓고 teacher policy로 student를 학습시킨다. 최승준이 “multi-teacher는 domain-specialized 아니에요? effort 아니고?”라고 묻자 노정석이 답한다 — “동시에 해요. effort와 도메인을 다 동시에.” 그렇게 모든 것을 한 몸에 지닌 student가 밖에 공개되는 production 모델이다.
[63:05] knowledge graph로 연습 문제를 무한 생성
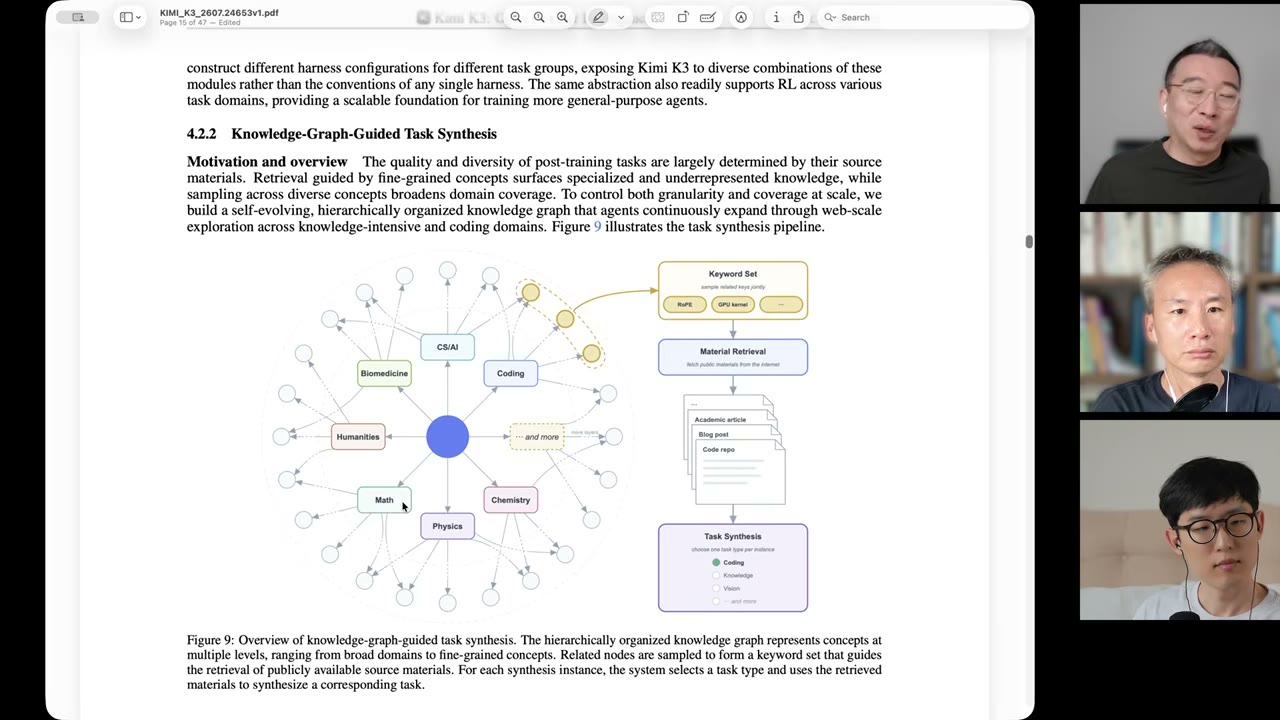
노정석이 **“이 그림이 제일 재미있어요”**라고 한 부분이다.
RL 연습 문제의 커리큘럼은 카테고리가 아니라 graph 형태여야 맞다는 게 페이퍼의 주장이다. 그림 왼쪽에 중심 노드에서 CS/AI, Coding, Biomedicine, Humanities, Math, Physics, Chemistry 등이 뻗어 나가고, 각각 아래로 세분화된 개념 노드들이 달려 있다. 오른쪽이 파이프라인이다.
- Keyword Set — 관련 노드들을 함께 샘플링해 키워드 집합을 만든다(예시로
RoPE,GPU kernel). - Material Retrieval — 그 키워드로 인터넷의 공개 자료를 끌어온다. 학술 논문, 블로그 포스트, 코드 저장소.
- Task Synthesis — 태스크 유형(Coding / Knowledge / Vision …)을 하나 고르고, 검색한 자료로 그에 맞는 문제를 합성한다.
페이퍼의 설명이 중요하다. 이 knowledge graph는 고정된 게 아니라 에이전트가 웹 탐색으로 계속 확장하는 self-evolving·계층 구조다. 노정석이 짚은 대로 출발 노드와 weight만 달리해도 연습 문제를 무한히 뽑을 수 있다. 최승준이 “예전에 가짜 MCP를 만들어 RL 환경으로 쓴 것도 Kimi였죠?”라고 확인하는데, 그 연장선이다.
검증 문제는 이렇게 나뉜다. 수학·코딩은 딱 떨어지지만 인문학 같은 문제는 verifier가 적용되지 않는 게 많아, rubric 기반 verifier로 “이 정도면 0.7, 이 정도면 0.3” 같은 quasi-verification 로직을 만든다. 최승준의 평 — “그 방식으로 해결은 안 되겠지만 hill climbing 정도는 되겠죠.”
노정석이 여기서 사용자 체감과 연결한다. Opus 4.8에서 5.0으로 갈 때 agent behavior가 점진적 진화가 아니라 다르게 온 것처럼 느껴지는 이유다. 프론티어 랩들도 답을 갖고 있는 게 아니라 서로 상호 참조하며 “어떻게 하면 long-running agent가 가능할까”를 향해 굴리고 있고, 1M 토큰 동안 그걸 유지하려면 span이 너무 길어져 품질이 떨어진다고 느끼는 구간이 생긴다. 그의 표현으로는 **“post-training RL 쪽에서 우리를 실험 대상으로 쓰면서 밖에 publish하고 있는 것”**이다.
박종현이 방증을 보탠다. OpenAI가 최근 연구자 십만 명 규모의 프로그램을 운영해 자사 모델을 쓰게 하고 있는데, 결국 그 연구자들이 양질의 research trajectory를 다 만들어 주는 것이다. 최승준이 “crowdsourcing하는 거죠”라고 하자 노정석이 정정한다 — “distill하고 있는 거죠. 최상급 quality의 인간들을.”
[67:39] 논문이 Instagram 숏폼이 되고 있다
페이퍼 41쪽이 통째로 저자 명단이다. 네 열로 빽빽하게 채워져 있고 전부 중국인 이름이다. 최승준이 “200명은 되겠네요”라고 하자 노정석이 “거뜬히 몇백 명 되겠네요”라고 받는다.
최승준이 덧붙인 인프라 소식도 이 국면을 보여준다 — vLLM, SGLang, TokenSpeed가 모두 Day-0 리포트를 냈다. Kimi의 레퍼런스 코드가 아니라 자기네 것을 공개 당일에 낸 것이다.
노정석의 자기반성이 이 장의 알맹이다. dataset·training·infrastructure가 훨씬 중요하다는 걸 알면서도, 앞부분의 알고리즘스러운 것에 현혹돼 그것만 쳐다보고 있는 자신을 발견했다는 것이다.
“이게 논문이 약간 Instagram 숏폼처럼 되는 거예요. 앞에 자극적인 걸 배치해서 사람들이 많이 열어보게 하는. 중요한 것들은 다 숨겨놓고, 중요하지 않은 것들만 앞에 잔뜩 뒀는데 그게 자극적이어서 사람들을 보게 만드는.”
그리고 게임의 규칙이 바뀌었다고 정리한다. 예전에는 **“우리가 얼마나 더 똑똑해졌어요”**가 지상 최대의 목표였다면, 지금 그건 다 된 문제로 취급된다. 이제 보는 건 inference가 얼마나 효율화됐는지, 얼마나 낮은 가격에 예전 성능을 내는지, 얼마나 작은 모델로 그 정도를 내는지다. 그래서 모델 품질을 하나의 관점에서 바라보는 건 불가능한 시절이 됐고, 그는 이걸 모터에 비유하며 그 안을 덮고 다음 layer로 가겠다고 선언한다.
3부 — 오픈웨이트 성명과 가치의 이동
[70:42] Jensen Huang의 첫 X 포스트
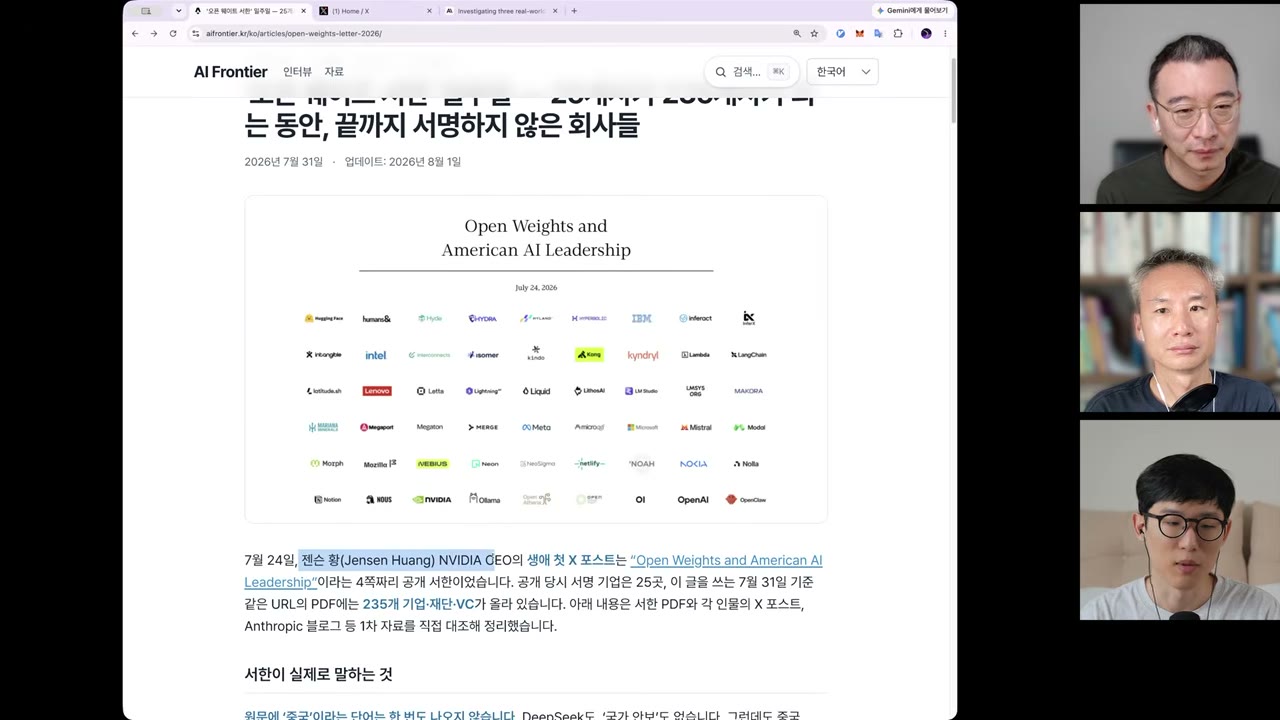
화면은 AI Frontier가 1차 자료를 대조해 정리한 기사다. 7월 24일, Jensen Huang이 생애 첫 X 포스트로 Open Weights and American AI Leadership이라는 4쪽짜리 공개 서한을 올렸다. Microsoft의 Satya Nadella를 비롯한 여러 인물이 함께 냈다.
논지는 단순하다. 오픈웨이트 모델과 closed frontier 모델이 둘 다 있어야 한다. 오픈 소스처럼 해야 생태계가 확보되고, 미국의 AI 리더십을 빼앗기지 않고, 보안 문제도 해결할 수 있다는 것.
숫자가 이 국면을 보여준다. 공개 당시 서명 기업은 25곳이었는데, 7월 31일 기준 같은 URL의 PDF에는 235개 기업·재단·VC가 올라 있다. 로고 판을 보면 Hugging Face, IBM, Intel, Lenovo, Meta, Microsoft, Mistral, Mozilla, Nebius, NVIDIA, Notion, NOUS, Ollama, OpenAI, OpenClaw 등이 있다.
박종현이 짚는 건 구성이다. 대부분 인프라 회사이고, 오픈웨이트 생태계가 발달하면 유리한 쪽이다. 많은 회사가 NVIDIA GPU를 사서 training도 inference도 할 테니 Jensen Huang에게는 아주 유리한 서명이다. OpenAI가 서명한 건 살짝 놀라운 대목인데, 정작 가장 프론티어인 GPT는 공개하지 않고 있기 때문이다.
실제 수요 신호도 있다. Coinbase는 closed frontier 모델을 쓰다가 점점 더 많은 비율의 토큰을 오픈웨이트로 옮기고 있다고 한다. 이유가 명확하다 — 우리가 하는 작업 중 정말 최고의 모델을 써야 하는 게 100%는 아니고, on-prem에서 가성비 있게 돌아가는 작업과 데이터가 밖으로 나가지 않아야 하는 작업이 많다.
기사가 전하는 결정적 숫자는 이것이다. Hugging Face 다운로드에서 중국계 오픈웨이트 모델 비중이 올봄 41%로 미국계를 추월했다. 창립 멤버 Clem Delangue의 증류 논쟁에 대한 코멘트도 실려 있다 — “증류는 좋은 모델을 만드는 능력에서 아주 작은 요인이고, 미국 기업을 포함해 모두가 하는 관행.”
노정석은 이 판을 냉정하게 본다. “물론 젠슨이 이걸 제일 강하게 밀고 있죠. 나쁜 사람이에요.” 자기들이 먹을 건 철저히 챙기면서, 선량한 사람들을 다 끌어들여 앞에 깔고 있다는 것 — 오픈웨이트가 많아지면 결국 NVIDIA만 좋다는 얘기다.
[74:56] 서명하지 않은 Anthropic
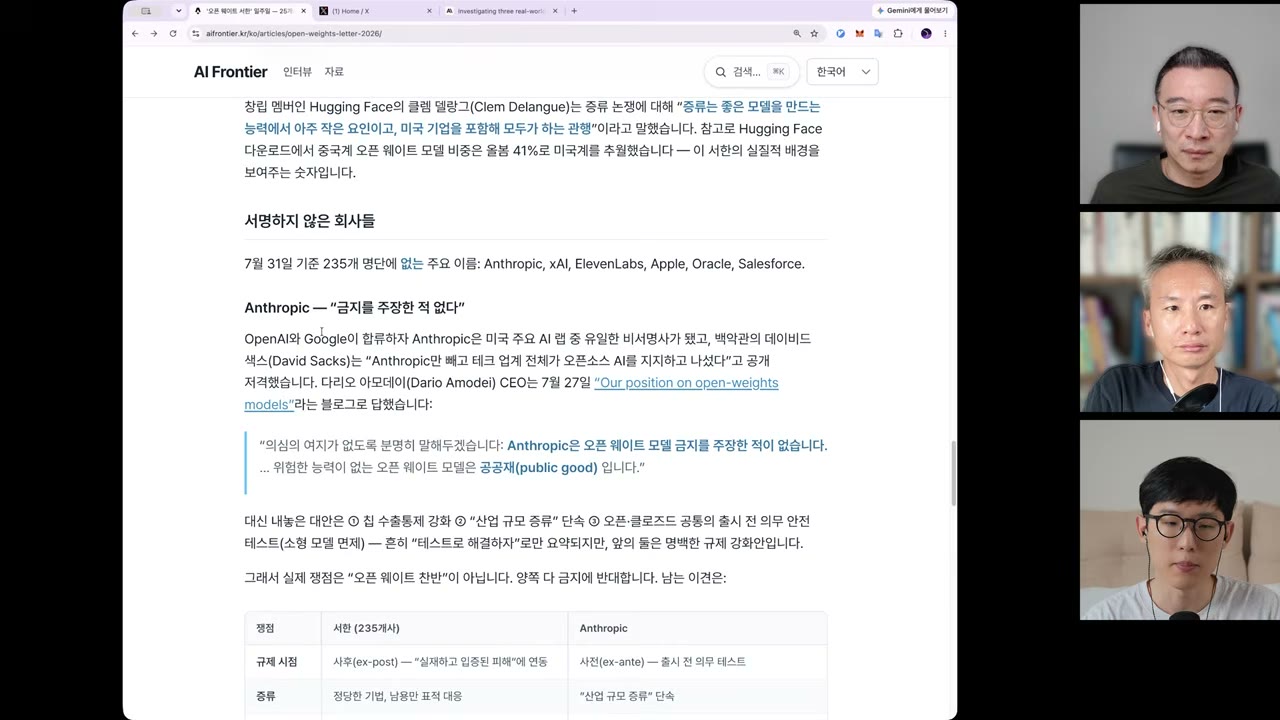
7월 31일 기준 235개 명단에 없는 주요 이름은 Anthropic, xAI, ElevenLabs, Apple, Oracle, Salesforce다.
OpenAI와 Google이 합류하면서 Anthropic은 미국 주요 AI 랩 중 유일한 비서명사가 됐다. 백악관의 David Sacks가 공개 저격했다 — “Anthropic만 빼고 테크 업계 전체가 오픈소스 AI를 지지하고 나섰다.”
원성이 커지자 Dario Amodei가 **7월 27일 Our position on open-weights models**라는 블로그로 답했다.
“의심의 여지가 없도록 분명히 말하겠습니다: Anthropic은 오픈 웨이트 모델 금지를 주장한 적 없습니다. … 위험한 능력이 없는 오픈 웨이트 모델은 공공재(public good)입니다.”
대신 내놓은 대안이 셋이다. ① 칩 수출통제 강화 ② “산업 규모 증류” 단속 ③ 오픈·클로즈드 공통의 출시 전 의무 안전 테스트(소형 모델 면제). 기사의 평가가 날카롭다 — 흔히 “테스트로 해결하자”로만 요약되지만 앞의 둘은 명백한 규제 강화안이다.
그래서 실제 쟁점은 “오픈 웨이트 찬반”이 아니다. 양쪽 다 금지에는 반대한다. 남는 이견은 이렇다.
| 쟁점 | 서한 (235개사) | Anthropic |
|---|---|---|
| 규제 시점 | 사후(ex-post) — “실제하고 입증된 피해”에 연동 | 사전(ex-ante) — 출시 전 의무 테스트 |
| 증류 | 정당한 기법, 남용만 표적 대응 | ”산업 규모 증류” 단속 |
| 사이버 방어 | 방어자에게도 동급 오픈 모델 필요 | 오픈 웨이트가 공격자보다 방어자를 더 돕는지 회의적 |
기사는 리스크 논거조차 서로 어긋난다고 짚는다 — 서한은 사이버 방어와 단일 실패점을 말하고, Amodei는 팬데믹급 바이오 리스크를 말한다. 서로 다른 위험을 이야기하고 있는 셈이다.
박종현은 여론을 전한다. Anthropic이 책 학습에 도서관을 활용했던 저작권 소송에서 패소해 몇 조 단위로 합의한 이력이 있어(노정석의 전언) 여론이 좋지 않고, 오픈웨이트 대세와 반대되는 **“더 규제하고 더 숨기겠다”**는 입장으로 읽힌다는 것이다. → anthropic
[77:00] 몇 달 만에 뒤집힌 입장, 그리고 commodity화
노정석의 비판이 여기서 가장 날카롭다.
**“정부의 규정 준수 요구에 응하지 않겠다”**며 국방부와 미국 정부에 납품하지 않겠다고 해 칭찬받았던 게 불과 3~4개월 전이다. 그런데 지금 하는 얘기는 **“중국이 우리 거 다 가져가니까 걔네한테 칩 주지 마, distillation 막아 줘”**다. 몇 개월 만에 완전히 모순된 입장으로 바뀌었다는 것.
그런데 그는 이걸 개인의 위선이 아니라 프론티어 랩이 겪고 있는 구조적 변화로 읽는다.
원래 청사진은 이랬다. superintelligence급 모델은 자기네와 OpenAI, 합쳐서 Google 정도만 가진 특급 기술이 되고, 그 우위로 엔터프라이즈 서비스를 다 끝장내 차세대 Google이 된다. Anthropic이 1T 단위 밸류에이션으로 투자받은 근거가 그것이다.
그런데 Kimi가 엊그저께 받은 밸류에이션이 약 $35B이다. 거의 30분의 1이다. 노정석의 판정은 명확하다 — “Anthropic이 과대평가된 회사라는 평가를 내리는 거죠.”
그가 정리한 논리 연쇄가 이 회차의 축이다.
- 모델 회사가 쌓는 가치가 급속히 낮아지고 있다. 차별재가 아니라 범용재(commodity)가 되어 간다.
- commodity 포지션이 되면 효율밖에 안 남고, 그 레이어의 value capture가 작아진다. 고객이 “Anthropic 모델 말고 우리 on-prem에 기계 사서 Kimi 올릴게”로 갈 수 있기 때문이다.
- 지능을 만들어낸 산업 자체가 따지고 보니 데이터와 compute에 종속된 함수였다는 게 드러나고 있고, 그 레시피와 아이디어는 어느 누구의 것도 아니라는 게 증명되고 있다.
[81:08] Google은 시간을 부여받았고, 프론티어 랩은 받지 못했다
박종현이 좋은 대조를 던졌다. 닷컴 때 Google은 검색 엔진 능력으로 전 세계 인터넷을 장악했다. 그 능력을 지금의 LLM 지능으로 치환하면, 하나의 LLM이 너무 뛰어나서 다 이길 수 있는 상황이었던 건가?
노정석의 답이 이 장의 알맹이다. Google이 점유율을 가져갈 수 있었던 건 압도적 품질을 한참 동안 유지할 수 있었고, 그 기간에 경쟁사가 없었다는 데 있다. 경쟁이 일어나지 않아 시대의 흐름을 온전히 포착할 시간을 충분히 부여받았다.
“그런데 OpenAI나 Anthropic은 시장을 창출하고 리더십 포지션을 구축하고 고객을 어떤 형태로든 묶어 둘 시간을 부여받아야 되는데, 그 시간을 부여받지 못하고 있는 거라고 저는 생각해요.”
박종현이 정리한다 — “Google과 비슷한 검색 엔진 능력을 가진 회사가 N개 있어서 독점적 포지션을 갖지 못하는 상황이라고 볼 수 있겠네요.” 노정석이 확인한다. ChatGPT나 Claude Opus, Fable이 독점적 우위 기술일 줄 알았는데 commodity가 될 개연성이 제일 높다는 걸 올해 다 확인하고 있다는 것이다.
그 앞으로 나가는 사람들 사이에서는 Anthropic의 IPO가 매우 낮은 밸류로 가거나 아예 실패할 수도 있다는 이야기까지 나온다고 한다.
[85:04] 가치는 위아래로 흩어진다
지금까지 모두의 머릿속 그림은 아래에 인프라, 가운데 모델, 위에 애플리케이션이었고, 가운데가 가장 큰 value capture를 한다고 믿어 밸류에이션과 매출이 거기 쏠렸다. 알고 보니 그게 commodity라면 가치는 위아래로 펼쳐져 이동한다.
- 아래(칩) — 당장의 승자다. compute 총량이 계속 늘고 공급자가 몇 안 되며, 위에서 경쟁하는 애들 때문에 가격이 올라 있다. 다만 노정석은 이 혜택이 곧 줄어들 것으로 본다. 지금은 ASML 노광 장비의 물리적 한계 덕에 누리는 시간차 혜택인데, 중국이 EUV·DUV 양산에 성공하거나 Elon Musk의 Terafab이 생산 능력을 배가하면 풀린다. 그리고 그는 그게 될 거라고 본다.
- 위(애플리케이션) — “아직 시작도 안 했다.” 그사이에 ASI는 분명히, 우리 생각보다 훨씬 빨리 올 거라고 본다.
수요가 영원히 증가할 것인가에 대해서는 Vinod Khosla의 논리도 소개한다 — “이건 지능이니까, 똑똑한 애가 있으면 하루 8시간만 쓸 거야? 100시간 쓰고 싶잖아.” 노정석은 그럴듯하지만 거기에도 한계는 있을 것 같다고 본다.
그래서 진짜 질문은 이것이다. 가치가 위로 간다면, 그 위에서 가치를 담는 틀은 무엇이 될 것인가. 아직 정해지지 않았다.
4부 — 에이전트를 다 깔아도 사람이 없어지지 않는 이유
[87:05] 능력이 부족해서가 아니라 제어가 안 돼서
노정석이 자기 회사 얘기를 꺼낸다. 모든 프로세스를 agentic flow로 밀어 넣고 여러 개를 동시에 돌리고 있는데, 사람이 없어지질 않는다.
박종현이 묻는다. 어디가 문제죠?
“믿고 맡길 수가 없어요. 능력이 부족해서가 아니라 제어가 안 되기 때문에 그래요.”
에이전트 시스템은 기본적으로 non-deterministic하다. 그의 비유가 정확하다 — 면접만 보고 대리급 직원을 뽑아 중요한 function에 넣고 **“똑똑하니까 업무 교본 보고 알아서 일해”**라고 해서는 안 되는 것과 같다.
그런데 지금 다들 그렇게 하고 있다. 긴 대화 안에 회사의 프로세스와 암묵지가 들어 있다고 말하고, 그걸 LLM 위키 형태로 추출·압축해 최상위 constitutional prompt로 잘 쌓으면 그게 회사가 될 거라고 운영한다. “저도 왜 안 될까가 요새 제 최대의 질문이거든요.”
박종현이 사람 쪽에서 대칭을 찾는다. 너무 똑똑한 직원이 와도 회사 목표와 완전히 align된 게 아니라 자기 이득을 위해 시스템의 허점을 이용하거나 뭔가를 들고 나가고 싶어 할 수 있다. 문제의 성격이 같다는 것이다.
[89:01] 복식부기 원장에서 착안한 control plane
노정석은 요즘 매일 밤을 새우며 다시 token maxxing 상태가 됐는데, 실험하고 있는 게 정확히 이 영역이다. “task가 앞서 가고 뒤에서 LLM 위키 형태로 꺼낸 정제된 지식이 다시 상위 policy로 동작할 거라는 전제가 잘못됐다.”
그가 집착하는 단어는 control plane이다.
논리는 이렇게 전개된다. 회사도 사람이라는 non-deterministic 에이전트로 굴러가는 시스템이다. 박종현이 받는다 — “사람의 하네스라고 볼 수도 있겠죠.” 그런데 지금 우리가 에이전트 하네스라고 부르는 건 업무 단위 task에서 tool을 쓰는 아주 낮은 개념의 것이고, 그 위에 한 번 더 하네스가 필요하다.
회사에는 조직도가 있고 권한과 접근 데이터가 나뉘어 있다. 거기에 goal(비전·사업 목표)이 들어오면 각 조직 안에서 action이 일어나고, 결과가 생기고, 기록으로 남고, 거기서 다시 graph가 바뀐다.
그런데 그것 자체도 non-deterministic 아닌가? 여기서 노정석의 전구가 켜진다. 회사 안에 완벽하게 틀이 잡혀 있는 부서가 하나 있다 — 재무다.
재무 장부에 남는 “돈을 벌었다, 나갔다, 누가 얼마 썼다”는 사실상 다른 모든 function의 원장이다. 박종현이 즉시 알아본다 — “최종 goal이네요. 마지막 evaluation metric.” 재무의 틀이 그렇게 명확한 이유는 아래에 복식부기라는 하나의 명확한 원장 시스템이 있기 때문이다.
그래서 아이디어는 간단하다.
- 에이전트가 하는 non-deterministic한 것들을 복식부기의 ledger처럼 기록되게 한다.
- 기록 방식은 graph가 맞다. 다만 비트코인처럼 원장은 계속 row로 쌓고, graph는 그 log에서 reproduce하는 형태여도 된다.
- 그 graph 안에 policy와 행동을 다 가둔다.
지금 문제는 에이전트에게 일을 시킬 때 깔끔한 context와 깔끔한 권한 범위 안에 밀어 넣어지지 않는다는 것이다. 사람이 위키 사이의 권한과 데이터를 명확히 제어해 주지 않으면 그냥 error가 난다. **“왜 에이전트를 다 붙여놨는데 결국 최종 action과 decision은 다 사람이 하고 있는가”**가 출발점이었다.
최승준이 묻는다 — “그럼 답은 자동화 지향이 아니라 반자동화예요?” 노정석은 아니라고 답한다. 사람이 들어가야 하는 지점은 있지만, 에이전트가 job을 받았을 때 명확한 권한과 데이터 안에서 활동할 수 있게 되면 된다는 것. 문제는 그 agentic flow들을 어떤 control plane 안에 가둘 것이냐다.
그의 요약이 이 회차에서 가장 실무적으로 유용한 문장이다.
“memory의 위치가 무언가 action을 하고 뒤에서 LLM 위키 형태로 정리하는 후행하는 단계가 되면 안 되겠다. 얘가 앞에 있어야 된다. 이 memory network가 사실상 하네스를 제어하는 구조로 돼야 된다.”
[93:53] 회사는 사람의 하네스다 — 논의를 하나로 묶기
박종현이 오픈웨이트 논의부터 여기까지를 하나의 틀에 넣는다.
- 회사 = 인간의 하네스, 그리고 여기서 인간에 해당하는 게 LLM이다.
- closed model을 밖에서 불러 쓰는 것 = 외주 용역사를 부르는 것.
- on-prem에 오픈웨이트를 올리는 것 = 내부 직원.
- 그 하네스의 가장 바깥에는 deterministic한 검사 로직이 있어야 한다. 회사에서 그건 “돈이라는 숫자가 절대 틀어지지 않음”이다.
보안 사고도 같은 틀에 들어간다. “보안 사고도 결국 LLM이 이 하네스를 탈출한 겁니다.” 회사로 치면 직원이 데이터를 들고 나갔거나 회사 이름을 달고 남의 회사에 가서 욕을 한 것인데, 막기가 너무 어렵다. 그래서 on-prem에 가두게 되고, 외주 용역 직원이면 데이터를 들고 나가기 더 쉬우니 더 위험하다. 오픈웨이트를 해야 한다는 주장이 여기서 나온다.
[97:44] 지능이 싸지면 누가 이득을 보나
박종현이 이 사건을 기준으로 정리한다. 지능의 가격이 계속 싸지고, 소비자에게 유리해진다.
- 사업자 — 지능을 만드는 모델 회사 위에서 그 지능을 유통하는 위치가 된다. LLM으로 가치를 만들어 파는 데 유리해진다. 원가가 싸지기 때문이다.
- 개인 — 그가 방송용 자료를 정리하는 방식이 예다. Twitter의 논의를 다 보고 생각을 정리해 전달하는데, 생각은 자기가 하지만 정리는 다 Claude가 한다. 하루 이틀 걸리던 일이 1시간으로 줄었다.
- 사회 — 오픈웨이트가 계속 나올수록 모델 배포가 빨라지고 싸지고 변화가 가속되는 건 중장기로는 거의 무조건 정해진 흐름이다. 보안 사고 같은 것들이 수면 위로 떠오르며 대중의 시선에 각인되고, 정책과 법안에도 영향을 미칠 것이다.
5부 — RSI, Pacing the Frontier, 그리고 예측 불가능성
[99:43] 가격이 두 방향에서 동시에 내려왔다
최승준이 가격 이야기로 이어 붙인다. commodity화 맥락의 데이터 포인트가 같은 주에 둘 나왔다.
- DeepSeek V4 Flash — 새로 나왔는데 가격이 어마어마하게 쌌다. → deepseek-v4
- GPT-5.6 Terra·Luna 인하 — 그 직전에 Luna 출시가가 80% 인하됐다. Terra와 Luna가 함께 할인됐는데 Luna 쪽이 극적으로 내려갔고, 그걸 가능하게 한 근거로 발표된 것이 Sol을 활용한 최적화였다.
Terra·Luna·Sol은 모두 GPT-5.6 계열의 티어다(→ 2026-07-12-artificial-analysis-intelligence-index). 즉 오픈웨이트발 압력과 자사 상위 모델을 이용한 원가 절감이 양쪽에서 동시에 토큰 가격을 끌어내리고 있다는 그림이다.
[100:56] 자기개선 하네스와 adversarial agent
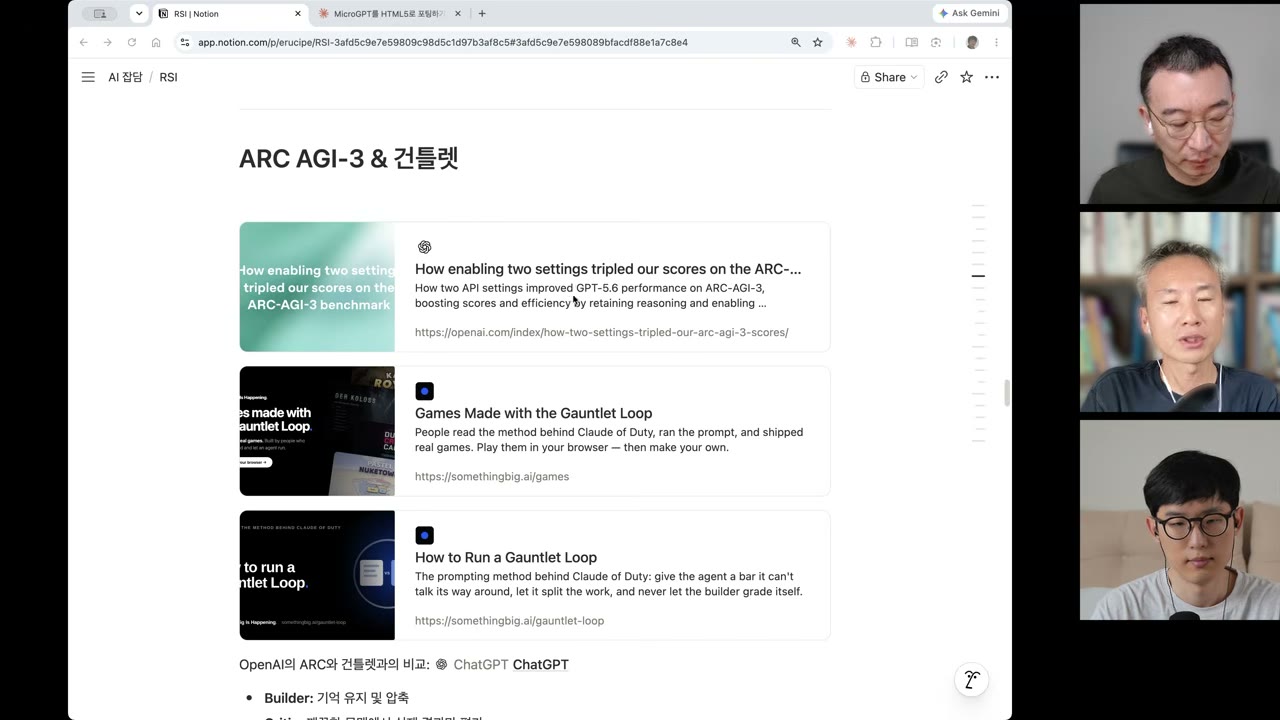
여기서부터 최승준이 준비한 RSI 자료로 넘어간다.
인사 신호 — Thinking Machines Lab 코파운더 Lilian Weng이 OpenAI로 돌아갔다. 건강상의 이유라고 하는데, The Information에서는 RSI 연구를 하러 돌아간 것 아니냐는 추측이 돌고 있다.
성능 신호 — OpenAI가 How enabling two settings tripled our scores on the ARC-AGI-3 benchmark를 냈다. 원래 성적이 좋지 않았는데 기본 하네스가 아니라 자사 하네스, 특히 기억을 강화한 Responses API를 쓰는 방식으로 30점을 넘겼다. 두 개의 API 설정을 켜서 reasoning을 유지하고 점수와 효율을 함께 올린 것이다.
방법론 신호 — Games Made with the Gauntlet Loop와 How to Run a Gauntlet Loop(somethingbig.ai). Claude of Duty 뒤에 있는 프롬프팅 방법으로, 소개문이 방법을 그대로 담고 있다 — “에이전트에게 말로 빠져나갈 수 없는 기준을 주고, 일을 쪼개게 하고, 절대 만든 사람이 스스로 채점하게 하지 마라.” 핵심은 adversarial agent다. 두 에이전트가 서로 경쟁하고 싸우며 검증하게 하니 3D 에셋의 품질이 크게 올라갔다.
박종현이 조직론과 연결한다 — 연구 부서와 품질 부서가 서로 싸우면서 제품을 개선하는 구조와 같다는 것이다.
최승준이 짚은 대조가 실무적으로 중요하다.
- OpenAI(ARC-AGI-3) — 기억을 계승하는 compaction을 계속하는 방식이 점수를 올리는 데 효과가 있었다.
- 건틀렛 루프의 critic — 기억이 없는 서브 에이전트여야 한다. context가 깨끗한 상태로, 맥락 없이 결과만 보고 냉철하게 비평해야 한다.
같은 루프 안에서도 빌더는 기억을 유지하고 심판은 기억을 비워야 한다는 것이다.
[103:17] Pacing the Frontier 공개 서한
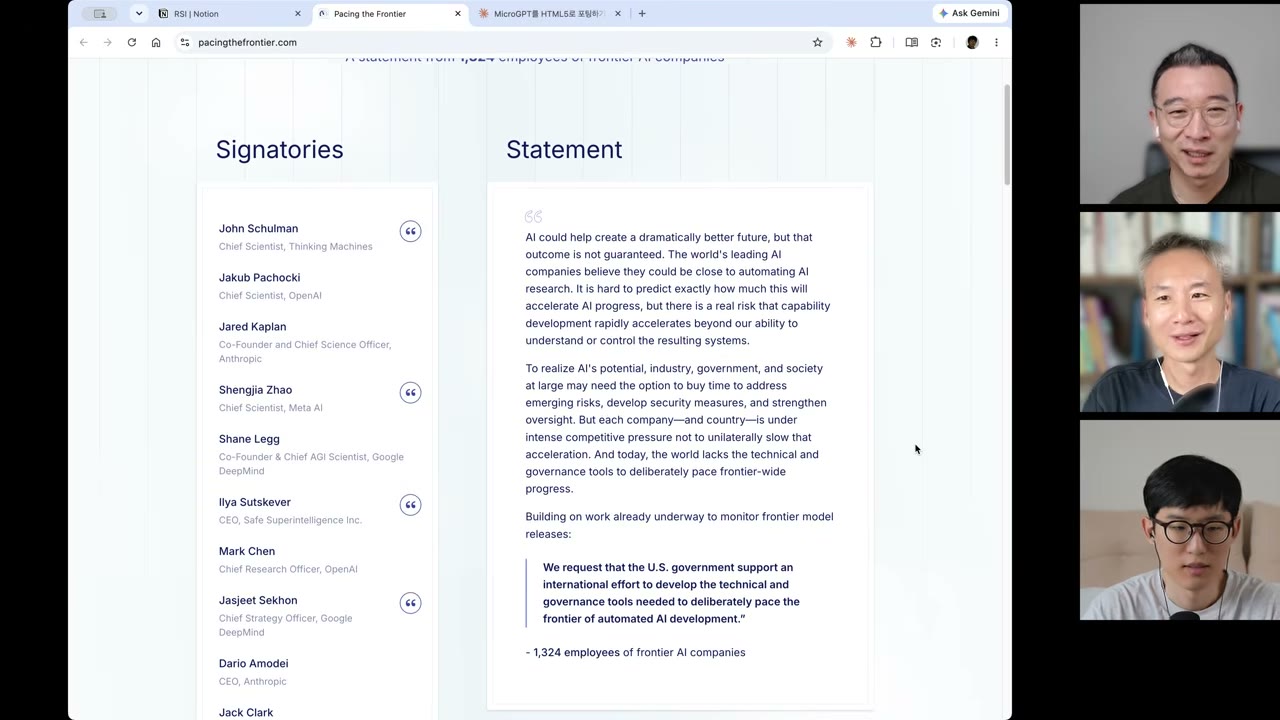
7월 말, **Pacing the Frontier**라는 공개 서한이 나왔다. 프론티어 AI 기업 직원 1,324명의 성명이다.
성명 전문의 논지가 명확하다.
AI는 극적으로 더 나은 미래를 만드는 데 기여할 수 있지만 그 결과가 보장된 것은 아니다. 세계 유수의 AI 기업들은 AI 연구를 자동화하는 데 근접했을 수 있다고 보고 있다. 이것이 AI 진보를 얼마나 가속할지 정확히 예측하기 어렵지만, 역량 개발이 우리가 그 결과를 이해하고 통제할 수 있는 능력을 넘어 급속히 가속될 실질적 위험이 있다.
잠재력을 실현하려면 산업·정부·사회 전반이 신흥 위험에 대응하고 보안 조치를 개발하고 감독을 강화할 시간을 벌 선택지가 필요할 수 있다. 그러나 각 기업과 국가는 일방적으로 그 가속을 늦추지 않을 강한 경쟁 압력에 놓여 있고, 오늘날 세계에는 프론티어 전반의 진보를 의도적으로 조절할 기술적·거버넌스적 수단이 없다.
“미국 정부가 자동화된 AI 개발의 최전선을 의도적으로 속도 조절하는 데 필요한 기술적·거버넌스적 수단을 개발하기 위한 국제적 노력을 지원해 줄 것을 요청합니다.”
서명자 목록이 이 서한의 무게다.
| 이름 | 직함 |
|---|---|
| John Schulman | Chief Scientist, Thinking Machines |
| Jakub Pachocki | Chief Scientist, OpenAI |
| Jared Kaplan | Co-Founder & Chief Science Officer, Anthropic |
| Shengjia Zhao | Chief Scientist, Meta AI |
| Shane Legg | Co-Founder & Chief AGI Scientist, Google DeepMind |
| Ilya Sutskever | CEO, Safe Superintelligence Inc. |
| Mark Chen | Chief Research Officer, OpenAI |
| Jasjeet Sekhon | Chief Strategy Officer, Google DeepMind |
| Dario Amodei | CEO, Anthropic |
| Jack Clark | (Anthropic 공동창업자) |
세 사람의 판정은 냉정하다.
- 노정석 — “이거 다 외교적 제스처 아닐까요?”
- 박종현 — “실제로 페이싱을 할 것 같지는 않은데요.”
- 노정석 — “절대 못 하죠. 한 주 동안 나쁜 짓 잔뜩 하고 주말에 와서 고해성사하는 거예요.”
최승준은 그럼에도 이 서한을 방증으로 읽는다. RSI의 초입이기 때문에 이런 얘기가 나온다는 것이다. 서한은 “가능성이 있다고 보고 있다”고 썼지만, 앞에서 소개한 사례들이 보여주듯 아직 인간이 통제하는 형태이긴 해도 자기 개선은 이미 진행 중이다.
[105:01] 반복되는 경고의 역사
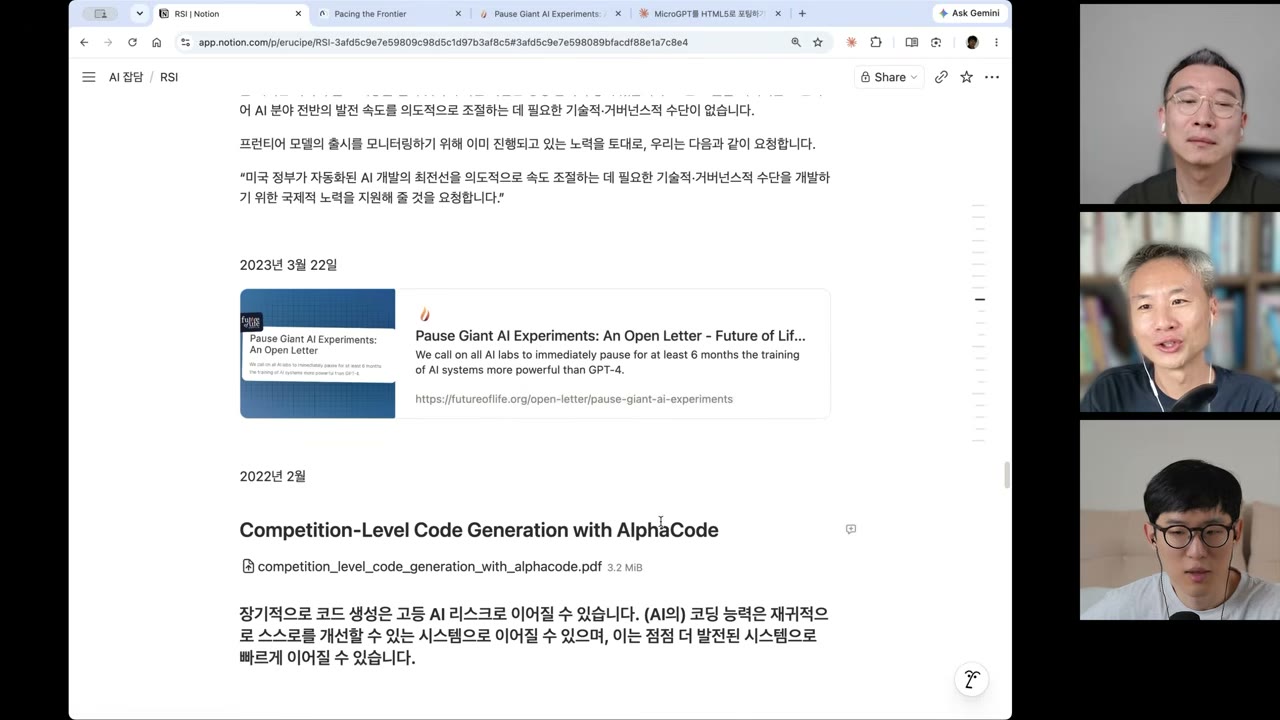
최승준이 기시감의 정체를 자료로 보여준다.
2023년 3월 22일 — Future of Life Institute의 Pause Giant AI Experiments: An Open Letter. GPT-4보다 강력한 AI 시스템의 학습을 최소 6개월 즉시 중단하라는 촉구였고, Geoffrey Hinton과 Yoshua Bengio 같은 대선생급이 서명했다. GPT-4가 나올 즈음이었다. 결론은 안 됐다. 아무도 멈추지 않았다.
그런데 그 프리퀄이 더 있다.
2022년 2월 초, AlphaCode 논문 — Competition-Level Code Generation with AlphaCode.
“장기적으로 코드 생성은 고등 AI 리스크로 이어질 수 있습니다. AI의 코딩 능력은 재귀적으로 스스로를 개선할 수 있는 시스템으로 이어질 수 있으며, 이는 점점 더 발전된 시스템으로 빠르게 이어질 수 있습니다.”
최승준의 한마디 — “그게 됐습니다.”
2022년 2월 말, Anthropic — Predictability and Surprise in Large Generative Models.
“단도직입적으로 말하면, 여기에 요약된 현상은 향후 몇 년 동안 행위자들이 점점 더 큰 모델을 구축하게 되는 것을 보게 될 것이며, 이러한 행위자들은 해로운 사회적 영향의 가능성에도 불구하고 이러한 모델을 배포할 강력한 동기를 갖게 될 것임을 시사합니다.”
둘 다 지금 이 상황을 정확히 그렸다. 노정석이 받는다 — 증기기관부터 인쇄술까지 역사적 틀로 환원해 매핑해 보면 다 동형인 이야기가 반복되고 있고, 일어날 일들은 일어나게 될 것 같다.
[106:39] Hype는 수행적이다 — Critical Hype Studies
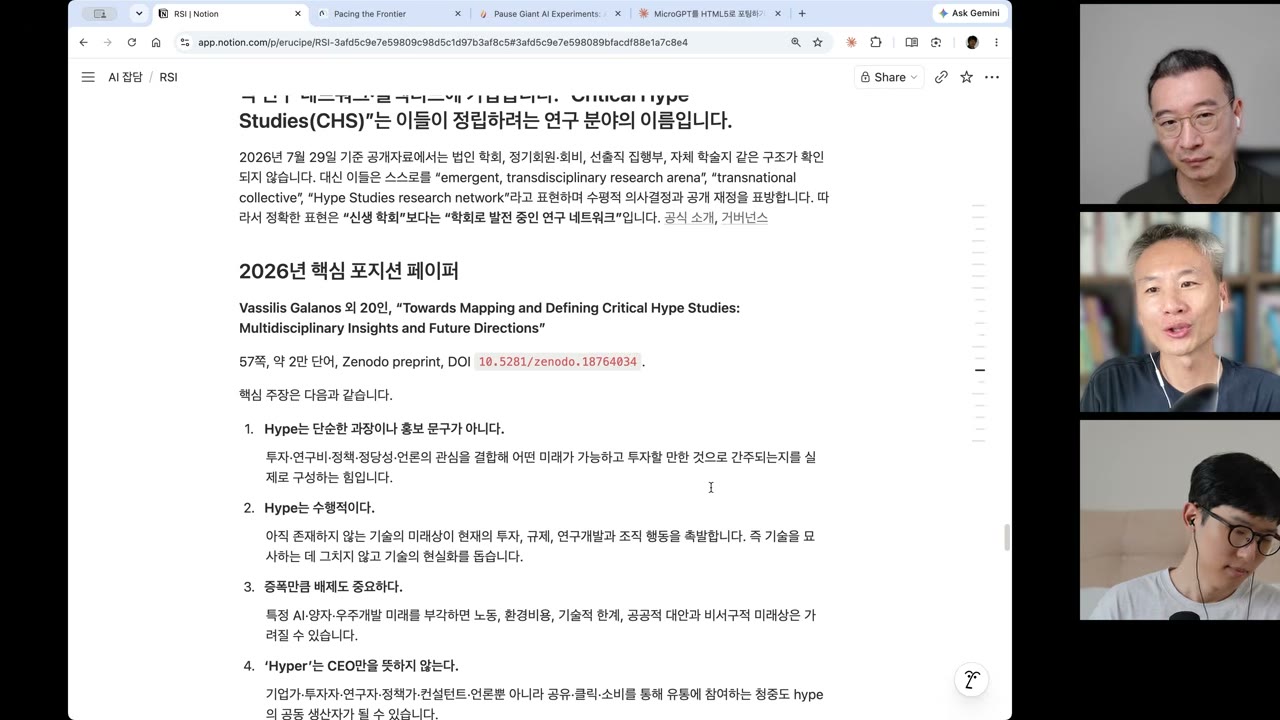
최승준이 소개한 Critical Hype Studies(CHS)는 AI 담론의 Hype 자체를 연구하는 연구 네트워크다.
2026년 7월 29일 기준 공개자료에서는 법인 학회, 정기회원·회비, 선출직 임원부 같은 구조가 확인되지 않는다. 이들은 스스로를 “emergent, transdisciplinary research arena”, “transnational collective”, **“Hype Studies research network”**라 표현하며 수평적 의사결정과 공개 재정을 표방한다. 그래서 정확한 표현은 **“신생 학회”보다는 “학회로 발전 중인 연구 네트워크”**다.
핵심 포지션 페이퍼는 Vassilis Galanos 외 20인, Towards Mapping and Defining Critical Hype Studies: Multidisciplinary Insights and Future Directions, 57쪽 약 2만 단어, Zenodo preprint(DOI 10.5281/zenodo.18764034). 핵심 주장 네 가지가 화면에 있다.
- Hype는 단순한 과장이나 홍보 문구가 아니다. 투자·연구비·정책·정당성·언론의 관심을 결합해 어떤 미래가 가능하고 투자할 만한 것으로 간주되는지를 실제로 구성하는 힘이다.
- Hype는 수행적이다. 아직 존재하지 않는 기술의 미래상이 현재의 투자·규제·연구개발과 조직 행동을 촉발한다. 기술을 묘사하는 데 그치지 않고 기술의 현실화를 돕는다.
- 증폭만큼 배제도 중요하다. 특정 AI·양자·우주개발 미래를 부각하면 노동, 환경비용, 기술적 한계, 공공적 대안과 비서구적 미래상은 가려질 수 있다.
- ‘Hyper’는 CEO만을 뜻하지 않는다. 기업·투자자·연구자·정책가·컨설턴트·언론뿐 아니라 공유·클릭·소비를 통해 유통에 참여하는 청중도 hype의 공동 생산자가 될 수 있다.
최승준이 가장 재미있다고 한 건 마지막이다 — hype researcher’s paradox. Hype를 비판하려고 반복해 언급하면 오히려 그것의 가시성과 권위를 키울 수 있고, 반대로 Hype를 안 따라가면 연구비를 얻지 못한다는 딜레마다.
박종현의 반응이 솔직하다. LLM 이전에는 “잘 안 될 것”이라는 부정적 생각을 많이 했는데 상당히 바뀌었다는 것이다. Hype는 낙관주의의 거의 끝에 있는 행동과 일치하는데, 그런 행동을 하니까 몰랐던 걸 더 알게 되고, 호들갑을 떨었던 것이 실현되지 않더라도 그 옆에 있는 무언가를 배우게 되고, 실현되는 것도 있더라는 것. 그래서 몇 년 전 **“호들갑을 떨면서 살아야겠다”**고 생각했다고 한다.
최승준의 자기 인식이 이 대목을 닫는다 — “저희 채널이 딱 그러고 있거든요. 지금도요. 저희도 Hype에 복무하고 있다는 자기 인식이 있죠.” 박종현이 덧붙인 디테일이 웃프다. YouTube에 Hype 버튼이 생겨서, Hype를 많이 받으면 팟캐스트 카테고리에 “Hype됨” 태그가 붙는다. 채널도 영상도 문자 그대로 hype되고 있는 것이다.
[110:07] 1년 너머는 아무도 예측할 수 없다
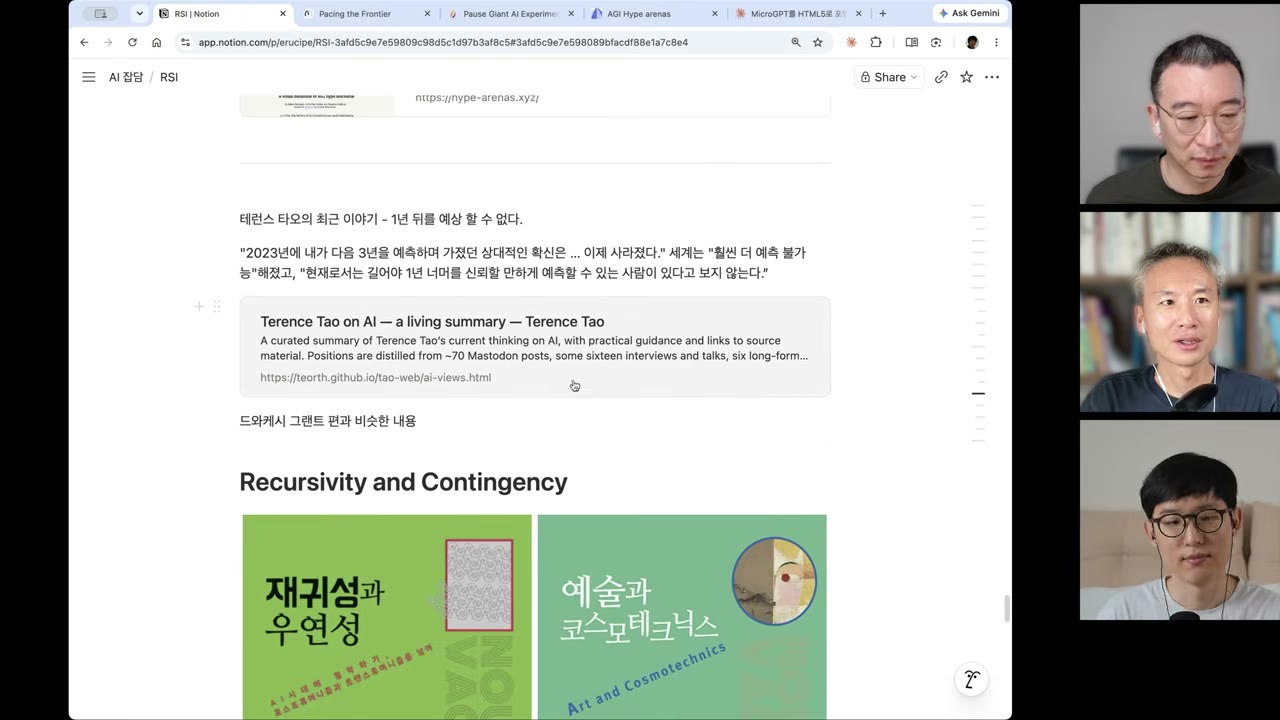
Terence Tao가 Mastodon 게시물과 인터뷰·강연을 모아 유지하는 living summary 페이지에서 최근 이렇게 말했다.
“2023년에 내가 다음 3년을 예측하며 가졌던 상대적인 확신은 … 이제 사라졌다.” 세계는 **“훨씬 더 예측 불가능”**해졌고, “현재로서는 길어야 1년 너머를 신뢰할 만하게 예측할 수 있는 사람이 있다고 보지 않는다.”
최승준의 반응 — “지금 정말 모르겠어요. 한 주 한 주 사는 거지.” 노정석이 받는다. “겨우 살아간다는 말이 지금 맞네요.”
[111:14] Contingency — 자판기가 아니라 요리사가 되기
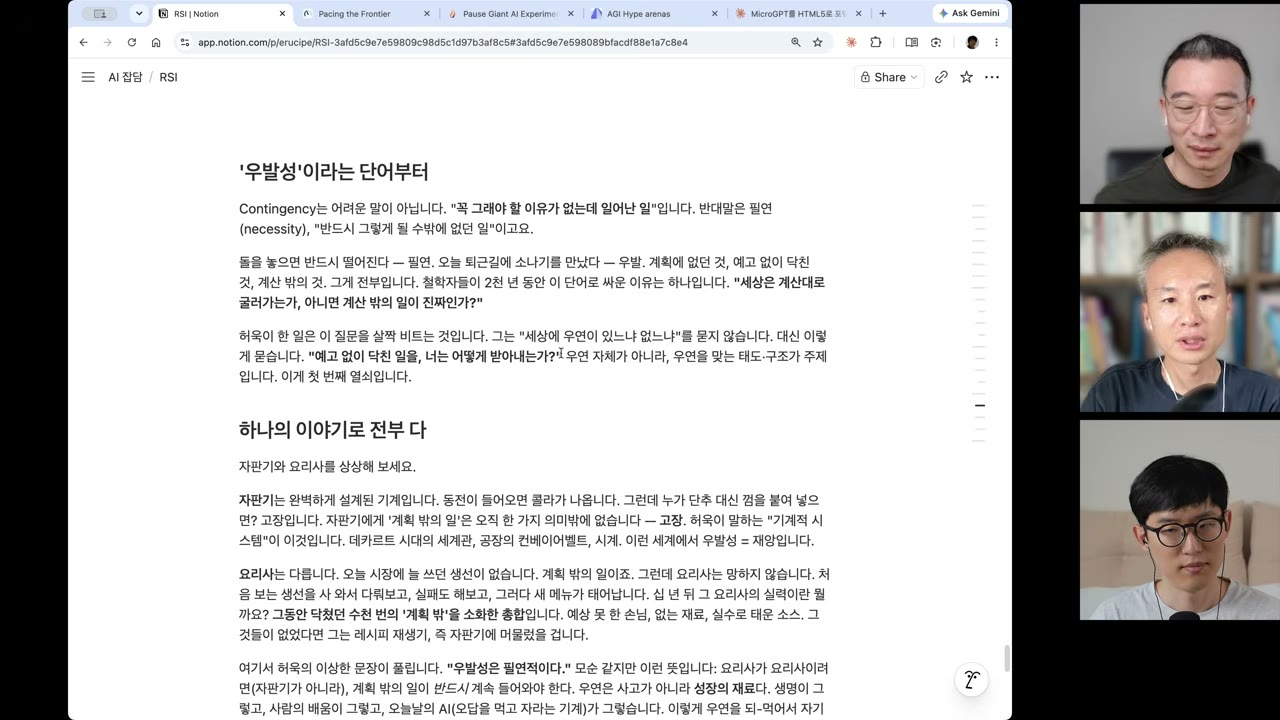
최승준이 마지막으로 가져온 건 홍콩 출신 철학자 Yuk Hui(허욱)의 Contingency(우발성/우연성) 개념이다. 저서 『재귀성과 우연성』과 『예술과 코스모테크닉스』가 화면에 있다.
정의는 어렵지 않다. **Contingency는 “꼭 그래야 할 이유가 없는데 일어난 일”**이다. 반대말은 필연(necessity), **“반드시 그럴 수밖에 없던 일”**이다. 돌을 놓으면 떨어진다 — 필연. 오늘 퇴근길에 소나기를 만났다 — 우발. 계획에 없던 것, 예고 없이 닥친 것, 계산 밖의 것.
Yuk Hui가 한 일은 질문을 살짝 비트는 것이다. 그는 “세상에 우연이 있느냐 없느냐”를 묻지 않는다. 대신 이렇게 묻는다 — “예고 없이 닥친 일을, 너는 어떻게 받아내는가?” 우연 자체가 아니라 우연을 맞는 태도와 구조가 주제다.
자료의 비유가 이 개념을 한 번에 이해시킨다.
- 자판기는 완벽하게 설계된 기계다. 동전이 들어오면 콜라가 나온다. 누가 단추 대신 껌을 붙여 놓으면? 고장이다. 자판기에게 ‘계획 밖의 일’은 오직 한 가지 의미밖에 없다. 데카르트 시대의 세계관, 공장의 컨베이어벨트, 시계 — 이런 세계에서 우발성은 재앙이다.
- 요리사는 다르다. 오늘 시장에 늘 쓰던 생선이 없다. 계획 밖의 일이다. 그런데 요리사는 망하지 않는다. 처음 보는 생선을 사 와서 다뤄보고, 실패도 해보고, 그러다 새 메뉴가 태어난다. 십 년 뒤 그 요리사의 실력이란 무엇일까? 그동안 닥쳤던 수천 번의 ‘계획 밖’을 소화한 총합이다. 예상 못 한 손님, 없는 재료, 실수로 태운 소스. 그것들이 없었다면 그는 레시피 재생기, 즉 자판기에 머물렀을 것이다.
여기서 Yuk Hui의 이상한 문장이 풀린다 — “우발성은 필연적이다.” 요리사가 요리사이려면(자판기가 아니려면), 계획 밖의 일이 반드시 계속 들어와야 한다. 우연은 사고가 아니라 성장의 재료다. 생명이 그렇고, 사람의 배움이 그렇고, 오늘날의 AI(오답을 먹고 자라는 기계)가 그렇다.
최승준이 이걸 가져온 이유가 명확하다. 오늘 Situational Awareness와 변동성 이야기를 하면서 느낀 것 — 우리가 보고 있는 지평 자체가 너무 예측 불가하다. 모든 수단을 강구해 조이고 예측하고 대비하려 하지만 어떤 부분에서는 겸허해져야 한다. Yuk Hui는 계획표 밖을 부르는 용어로 Contingency를 쓰고, 그걸 제거하는 건 불가능하니 관계 맺기의 대상으로 삼자고 제안한다.
박종현이 확인한다 — RSI 때문에 더 불확실해지고 더 우발적인 게 많이 일어날 거라고 보시는 거죠? 최승준이 답한다. “RSI가 어떤 부산물을 만들어내거나 뭔가를 꺼낼지 모르죠. 그렇기 때문에 페이스를 조절하자는 얘기가 나오는 거기도 하고요.”
노정석이 자기 경험으로 이 위험을 구체화한다. 프론티어 랩들이 우리에게 보여주는 하네스는 모델이 만들었을 거라고 추정해야 한다. 그리고 우리 자신도 그렇게 하고 있다 — 정말 중요한 것들은 human-in-the-loop로 하나하나 보며 만들지만, 서브시스템은 목적만 세팅하고 작동하기만 하면 그냥 갖다 쓴다. “에러가 나도 에이전트들이 만드는 커밋 로그를 저희는 안 보잖아요. ‘됐니? 한번 검증해 봐.’ 하면서 그냥 닫아버리니까.”
최승준은 Sutton의 거대 세계 가설(세계는 늘 에이전트보다 크다)과 제한된 합리성으로 마무리한다. 에이전트가 됐든 사람이 됐든 모든 정보를 알 수 없으므로 아는 것 안에서 제한된 합리성을 취할 수밖에 없다.
노정석이 어릴 때 본 만화책을 떠올린다. 신일숙의 『아르미안의 네 딸들』.
“삶은 언제나 예측 불허, 그리하여 생은 그 의미를 갖는다.”
그리고 뒤집는다 — “그러하기 때문에 거꾸로 이렇게 변동성이 높은 세상은 무언가를 해보고 싶어 하는 사람들에게는 기회입니다.”
[113:27] 마무리 — 이 대화 자체가 memory compaction이다
노정석이 이 팟캐스트의 의미를 정의하는 방식이 이 회차의 좋은 마무리다.
셋이 자료를 가져와 티키타카를 하면 배움이 생기고 오늘의 생각의 균형이 잡힌다. 다음 주면 다 없어질 수 있지만. “그래서 저는 거꾸로 이 과정이 요새 memory compaction을 하는 세션이라고 생각하거든요.”
최승준이 받는다 — “일단 compaction해 놓고 그 키워드들만 유지하는 거죠. 시간이 지나면서 디테일은 기억이 안 나기 때문에.”
대화가 끝나면 중요한 키워드 몇 개가 남고, 그 compaction된 키워드를 가지고 조금 덜어낸 상태로 다음 주를 시작한다. 최승준이 용어를 붙인다 — “rollout 과정이었군요.” 노정석이 이어받는다 — “trajectory 하나 마무리하고 저희 모델을 on-policy로 업데이트를…” 최승준 — “이번 주 policy로만 rollout하고 다음 주에는 업데이트된 거고.”
노정석의 마지막 문장이 이 2시간을 압축한다.
“그렇기 때문에 오늘 Kimi K3 페이퍼 안에도 가만히 보고 있으면 우리네 인생의 매뉴얼도 싹 다 들어 있어요.”
부록 — 이 회차에서 건질 실무 포인트
- 아키텍처 논문은 커버만 보고 넘겨라. 세 사람의 결론은 명확하다 — 아키텍처는 중요도의 10%, 데이터와 compute가 90%다. 그리고 페이퍼는 정확히 그 90%를 숨긴다. 큰 제목의 배치만 익히고 딥다이브는 접는 게 시간 대비 효율이 높다.
- 모델 벤치는 상용 서비스 여부로 할인해서 읽어라. 사용자가 적고 상용 서비스를 하지 않는 모델일수록 벤치 overfit 경향이 심하다(박종현).
- 상위 모델을 넘는 벤치가 나오면 그 상위 모델의 다음 버전이 임박했다는 신호로 읽어라(최승준).
- 하네스가 모델 안으로 들어가고 있다. 예전에 밖에서 강제 프롬프트와 체크 로직으로 붙잡던 long-running 제어가 모델의 SFT/RL 안으로 흡수되고 있다. 자기 하네스의 어느 부분이 곧 불필요해질지 점검할 때다.
- 메모리를 후행이 아니라 선행에 놓으라. action → 사후 위키 정리 → 상위 policy라는 전제는 노정석의 실험 기준으로 틀렸다. memory network가 하네스를 제어하는 구조여야 한다.
- 에이전트에게 job을 줄 때 context와 권한 범위를 명시적으로 잘라 넣으라. 사람이 권한·데이터를 제어해 주지 않으면 그냥 error가 난다. 이것이 “에이전트를 다 깔았는데 결정은 사람이 하는” 이유다.
- 에이전트 활동을 복식부기 원장처럼 append-only로 기록하라. graph는 그 로그에서 재구성하면 된다. 재무가 회사에서 유일하게 틀이 잡힌 부서인 이유가 복식부기다.
- 자기개선 루프에는 기억 없는 심판을 두라. 빌더는 compaction으로 기억을 계승하되(ARC-AGI-3), critic은 context가 깨끗한 별도 에이전트여야 냉철한 비평이 나온다(건틀렛 루프). 절대 만든 쪽이 스스로 채점하게 하지 마라.
- 작업의 100%가 최고 모델을 필요로 하지 않는다. Coinbase처럼 토큰 비중을 오픈웨이트로 옮기는 판단은 가성비뿐 아니라 데이터가 밖으로 나가지 않아야 하는 작업 때문에도 정당화된다.
- 오픈웨이트 채택을 하네스 관점으로 보라. closed API = 외주 용역사, on-prem 오픈웨이트 = 내부 직원. 가장 바깥에는 deterministic한 검사 로직이 있어야 한다(박종현).
원문 인용 모음
- [00:33] “Leopold Aschenbrenner라고 굉장히 젊고 유능한 분이죠. … 그런데 그 친구가 말만 하는 게 아니라 자기만의 펀드를 조직해서 자기 신념이 향하는 방향으로 포트폴리오를 만들었단 말이에요.” — 노정석
- [10:41] “20대 초반의 패기 있는 미래 전략가도 헛발질은 얼마든지 할 수 있는 판이다.” — 최승준
- [12:41] “주가는 미래에 기대되는 현금 흐름을 오늘로 할인한 것에 대한 기댓값이기 때문에 … 기대에 도박하는 시장이다.” — 노정석
- [14:10] “저만 해도 우리도 우리 Claude가 있어야 되겠다는 생각을 하고 있거든요.” — 노정석
- [17:06] “이 페이퍼를 하나로 요약하면 요새 frontier model들과 frontier lab들의 workflow는 어떤 식으로 구성되어 있는지에 대한 전체 설계 요약본이에요.” — 노정석
- [21:34] “그게 RSI인 거죠. RSI의 어떤 진입점에 있는 상황으로 보이는 징후들이라고 생각합니다.” — 최승준
- [24:24] “이건 저는 연금술이라고 불러야 할 것 같아요. … loss가 떨어지고 evaluation이 만족되면 그냥 되는, 일종의 발명이 아니라 저는 이제 발견의 단계에 들어간 게 아닌가.” — 노정석
- [29:42] “그게 왜 되냐고 저에게 묻지 마십시오. 되니까 했겠죠.” — 노정석
- [32:43] “이 Kimi Delta Attention이 LSTM스럽다는 건 과거를 어떻게 해라, 어디를 봐라, 이런 것들을 우리가 알고리즘적으로 복잡하게 다 집어넣어 준 거다 보니까 다시 역행했다고 볼 수 있을 것 같아요.” — 박종현
- [35:11] “Transformer라는 골자가 나온 지 거의 10년이 다 돼가는데, 그걸 끝까지 쥐어짜고 최대한 엔지니어링해서 점점 끝까지 최대한 끌어올리고 있는 과정이다.” — 박종현
- [41:04] “이런 경우를 다 방어하는 마법의 방어 용어가 있더라고요. 만약 그러시다면 여러분 말이 맞습니다.” — 노정석
- [42:58] “제가 일종의 선언을 하자면, 이제 이거 그만하려고요.” — 노정석
- [46:53] “저는 중요도 측면에서 저 model architecture는 10%라고 봅니다. 90%는 뒤에서 어떻게 pre-training이 됐고, 어떻게 post-training을 했고, dataset과 compute 문제가 90%라고 보고, dataset과 compute에는 왕도가 없거든요.” — 노정석
- [48:50] “제 인상은, 달라지는 것도 분명히 맞긴 하지만 공통분모인 recipe가 있는 데서 조금 다변화되는 게 아닌가라는 생각을 잠깐 가졌어요.” — 최승준
- [54:07] “reasoning trail은 숨겨버릴 수 있지만, tool call trail은 숨길 수가 없거든요.” — 노정석
- [55:12] “제가 승준님이 쓴 책을 샀어요. 그 책을 읽어서 제 지식 체계가 업데이트됐어요. 그래서 제가 비슷한 글을 썼어요. 그럼 이게 제가 distillation을 했기 때문에 불법인가요? 아니잖아요.” — 노정석
- [67:25] “distill하고 있는 거죠. 최상급 quality의 인간들을 지금 자기들도 distillation하고 있는 거죠.” — 노정석
- [69:53] “이게 논문이 약간 Instagram 숏폼처럼 되는 거예요. 그 앞에 자극적인 걸 배치해서 사람들이 많이 열어보게 하는.” — 노정석
- [70:51] “물론 젠슨이 이걸 제일 강하게 밀고 있죠. 나쁜 사람이에요. … 왜냐하면 이런 오픈웨이트가 많아지면 자기네만 좋거든요.” — 노정석
- [77:09] “그들이 갖고 있는 진실을 얘기하잖아요. ‘이거 얘들 다 개소리였구나.‘라는 생각이 들어요.” — 노정석 (Anthropic의 입장 전환에 대해)
- [79:09] “야, 이게 Anthropic이 과대평가된 회사냐, 아니면 Kimi가 안 좋은 회사냐? 저는 Anthropic이 과대평가된 회사라는 평가를 내리는 거죠.” — 노정석
- [80:06] “모델을 만들어서 지능을 만들어 낸 산업 자체가 따지고 보니 데이터와 compute에 종속된 함수였다는 게 드러나는 거고, 그리고 그 레시피와 아이디어는 어느 누구의 것도 아니라는 게 증명되고 있는 거죠.” — 노정석
- [82:33] “충분히 긴 시간 동안 시장을 창출하고 거기에 리더십 포지션을 구축하고, 고객들을 어떠한 형태로든 묶어 둘 시간을 부여받아야 되는데, 그 시간을 부여받지 못하고 있는 거라고 저는 생각해요.” — 노정석
- [87:00] “사람이 없어지질 않아요. … 능력이 부족해서가 아니라 제어가 안 되기 때문에 그래요.” — 노정석
- [89:30] “회사라는 자체가 사람의 하네스고” — 박종현·노정석
- [91:55] “이 에이전트가 하는 non-deterministic한 이런 것들이 저런 복식부기의 원장, ledger처럼 잘 기록되게 하면 되겠다.” — 노정석
- [95:51] “memory의 위치가 무언가 action을 하고 뒤에서 LLM 위키 형태로 정리하는 후행하는 단계가 되면 안 되겠다. 얘가 앞에 있어야 된다.” — 노정석
- [104:34] “한 주 동안 나쁜 짓 잔뜩 하고 주말에 와서 고해성사하는 거예요. 지금.” — 노정석 (Pacing the Frontier 서한에 대해)
- [105:29] “그게 됐습니다.” — 최승준 (2022년 AlphaCode 논문의 RSI 경고에 대해)
- [109:18] “그때 호들갑을 떨었던 Hype은 실현되지 않을 수 있더라도 그 옆에 있는 무언가를 배우게 되고, 또 실현되는 것들도 있더라고요. 그래서 호들갑을 떨면서 살아야겠다.” — 박종현
- [109:18] “저희도 Hype에 복무하고 있다는 자기 인식이 있죠.” — 최승준
- [110:44] “지금 정말 모르겠어요. 한 주 한 주 사는 거지.” — 최승준
- [112:14] “프런티어 랩들이 우리에게 보여주는 하네스들은 모델이 만들었을 거라고 추정해야 돼요.” — 노정석
- [113:36] “삶은 언제나 예측 불허, 그리하여 생은 그 의미를 갖는다. … 그러하기 때문에 거꾸로 이렇게 변동성이 높은 세상은 무언가를 해보고 싶어 하는 사람들에게는 기회입니다.” — 노정석
- [114:02] “저는 거꾸로 이 과정이 요새 memory compaction을 하는 세션이라고 생각하거든요.” — 노정석
- [115:01] “오늘 Kimi K3 페이퍼 안에도 가만히 보고 있으면 우리네 인생의 매뉴얼도 싹 다 들어 있어요.” — 노정석
관련 노트
- 2026-07-26-ai-frontier-ep106-intelligence-supply-war — 직전 회차. 지능 공급 전쟁, 한도 경쟁, 그리고 에너지 병목
- kimi-k3 · 2026-07-29-pytorchkr-topic-11455-kimi-k3-2-8t — K3 스펙과 공개 경위
- 2026-07-25-kimi-k3-china-us-ai-gap — K3가 촉발한 미중 격차 논쟁
- kimi-k2 — K3가 딛고 선 직전 세대. 데이터 파이프라인과 RL 환경 서술의 원본
- nemotron — Mamba 블록과 attention 블록을 중첩한 선행 사례
- deepseek-v4 — V4 Flash 가격과 벤치, commodity화의 또 다른 데이터 포인트
- anthropic · claude-fable-5 — 오픈웨이트 서한 비서명자와 그 촉발점
- 2026-07-25-claude-opus-5-launch-breakdown — Opus 5 출시와 벤치 역전
- harness — 하네스가 모델 안으로 들어가는 흐름의 배경 개념
- 2026-07-04-harness-engineering-for-self-improvement · 2026-07-16-weco-aide2-first-evidence-recursive-self-improvement — RSI와 자기개선 하네스
- 2026-07-17-inkling-open-weights-model — 오픈웨이트 릴리스 흐름
- open-source · glm-5.2 — 오픈웨이트 생태계