출처 https://youtu.be/ZwjWj6aw2BY · 채널 AI Frontier Korea (노정석) · 길이 1:10:21 · 공개 2026-07-26 포맷 최승준·박종현 두 진행자가 2026년 7월 18일에 녹화한 팟캐스트 대담(노정석은 컨디션 문제로 불참). 두 사람이 각각 준비한 자료를 화면 공유로 띄우고 진행한다 — 전반부는 AI Frontier 아티클 「AI는 좋은 연구를 할 수 있을까 — 재현 챌린지, 랄프톤, 그리고 두 편의 팟캐스트」(2026-07-17), 후반부는 최승준의 Notion 글 「지적 자동화 시대에 남는 것들」. 원본 자막: raw source:
2026-07-26-ai-frontier-ep105-can-ai-do-research(raw/transcripts) 직전 회차: 2026-07-20-ai-frontier-ep104-gpt5-6-icml
한눈에 보는 요약
- 오늘의 화두는 “평가하기 어렵다” — PPO 논문은 NIPS 2017에서 리젝됐다. 리뷰어도, 저자 본인들도 그 가치를 몰랐다. 좋은 연구를 알아보는 일 자체가 원래 어려웠고, LLM은 그 어려움을 물량으로 폭발시켰다.
- 학계의 시스템이 물량에 무너지고 있다 — ICML 2026은 역대 최다 23,918편 투고에 6,352편 수록(26.6%), ICLR 2026은 리뷰 75,800개 중 21%가 완전히 AI 생성으로 추정된다. arXiv는 2025년 10월부터 CS 서베이·포지션 논문을 피어리뷰 통과 후에만 받는다.
- 핵심 질문: 좋은 연구에 reward를 줄 수 있을까 — RLVR은 정답 채점(수학)·유닛테스트(코드)처럼 검증 가능한 보상에서만 작동한다. 그걸로 IMO 금메달까지 갔지만, “좋은 연구”에는 그 검증기가 없다.
- 두 개의 우회로 — Hugging Face 재현 챌린지(에이전트가 논문을 다시 구현해 검증, 재현성을 중간 리워드로 삼음)와 랄프톤(AI로 논문 쓰기 / 그 논문 리뷰하기 두 트랙). 랄프톤 Track 2 우승 기준은 “인간 심사위원 점수와의 상관관계”였다 — 검증할 수 없어 보이던 “좋은 평가”조차 인간과의 정렬로 reward를 만들어냈다.
- Dwarkesh × 그랜트 샌더슨: IMO는 훈련 가능한 10시간짜리 태스크일 뿐이고, AI의 프론티어는 스파이크형이며 그 스파이크가 프랙탈이다(수학 안에서도 기하는 19초에 풀리는데 조합론은 버틴다). 갈루아의 군론이 쿼크 예측까지 이어지는 데 100년 — RLVR의 즉시 채점과 정반대의 시간 스케일.
- Dwarkesh × 애덤 브라운: 실험 없이 사고실험만으로 어디까지 갈 수 있나. 답은 “아인슈타인 여러 명을 병렬로”. LLM의 진짜 무기는 천재성이 아니라 인간이 아까워서 안 하는 낭비(이미 참이라 믿는 것의 재검증)를 기꺼이 한다는 점이다.
- RLVR은 계보가 오래됐고 한계도 구조적이다 — 피셔의 score function(1900년대 초) → REINFORCE/policy gradient(1990년대 초) → RLVR/GRPO. 궤적 전체에 같은 보상을 주는 구조라 어떤 토큰이 기여했는지는 보장되지 않는다. 그래서 코딩은 되고 글쓰기·디자인·개그는 안 된다.
- 결론은 taste — 정리를 증명하는 AI는 왔고 추측을 만드는 AI는 오는 중. 정의(definition)를 만드는 것은 누구의 몫인가. 박종현은 “그것도 결국 탐색 문제이니 AI가 할 수 있다, 다만 2년이 아니라 10~20년”이라고 답했다.
핵심 한 줄: AI가 연구를 할 수 있느냐는 “얼마나 똑똑하냐”가 아니라 “좋은 연구에 어떻게 점수를 매길 것이냐”의 문제이며, 지금 학계와 프론티어 랩이 모두 그 채점기를 만들려 애쓰는 중이다.
1부 — 좋은 연구를 알아보는 일이 원래 어렵다
[00:00] PPO는 NIPS 2017에서 리젝당했다
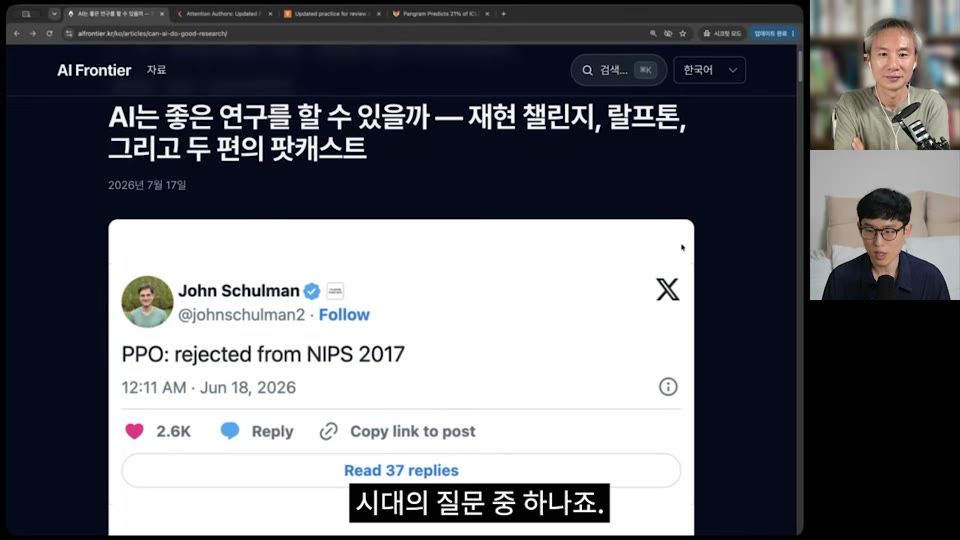
박종현이 첫 자료로 꺼낸 것은 John Schulman(OpenAI 공동창업자, 현 Thinking Machines Lab)이 한 달 전 올린 한 줄짜리 트윗이다 — “PPO: rejected from NIPS 2017”. 좋아요 2.6K에 답글 37개가 달렸다.
PPO(Proximal Policy Optimization)는 ChatGPT를 만든 RLHF의 핵심 알고리즘이다. 사람이 대화에 좋았다/나빴다 평가를 주고 그걸로 모델을 개선하는 방식이고, 나중에는 사람을 흉내 내는 보상 모델을 두는 식으로 발전했다. 그 알고리즘의 원논문이 학회에서 떨어졌다는 것이다. 박종현이 리포스트된 다른 사례로 짚은 Tony Zhao의 논문도 지금은 로보틱스 액션 쪽에서 인기가 많은데 당시 리뷰어들은 좋게 보지 않았다.
정작 중요한 건 리젝 그 자체가 아니다. 아티클의 표현대로 PPO가 LLM 시대에 2차 전성기를 맞은 이유는 “원논문 저자들도 당시엔 몰랐던 것” 이었다. 리뷰어도, 저자 자신도 그 가치를 평가하지 못했다. 최승준이 여기서 “평가하기 어렵다는 게 오늘의 화두가 되겠다”고 정리했고, 실제로 70분 내내 이 주제가 반복된다.
[04:50] arXiv가 문을 닫고, 학회가 물량에 무너진다
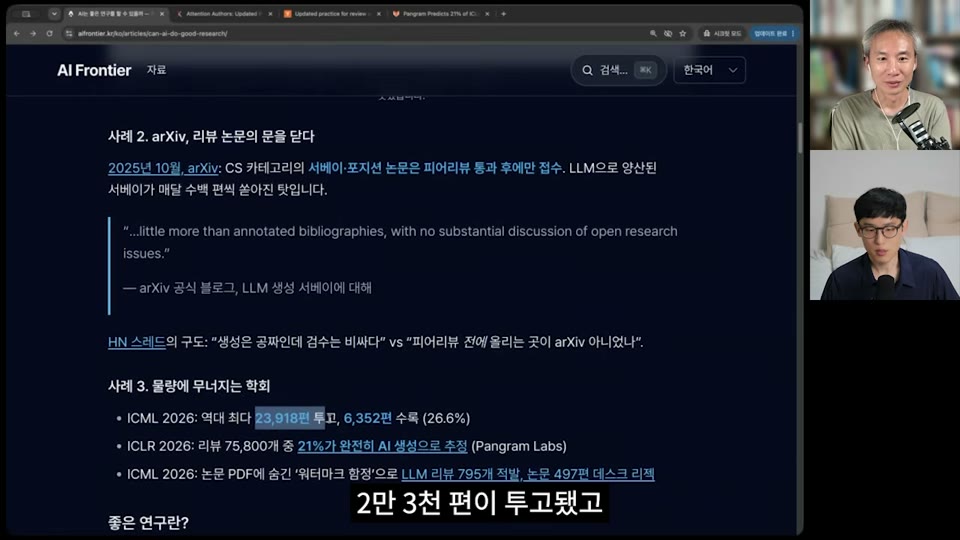
화면의 사례 목록이 그 자체로 현황 브리핑이다.
- arXiv, 리뷰 논문의 문을 닫다 — 2025년 10월부터 CS 카테고리의 서베이·포지션 논문은 피어리뷰를 통과한 뒤에만 접수한다. LLM으로 양산된 서베이가 매달 수백 편씩 쏟아진 탓이다. arXiv 공식 블로그는 그것들을 “little more than annotated bibliographies, with no substantial discussion of open research issues”라고 표현했다.
- ICML 2026 — 역대 최다 23,918편 투고, 6,352편 수록(26.6%). 박종현이 대학원생이던 10년 전엔 “출판 100편이면 많다”고 하던 규모였다.
- ICLR 2026 — 리뷰 75,800개 중 21%가 완전히 AI로 생성된 것으로 추정(Pangram Labs).
- ICML 2026 — 논문 PDF에 숨겨둔 ‘워터마크 함정’으로 LLM 리뷰 795개를 적발하고 논문 497편을 데스크 리젝했다. 사람이 직접 리뷰하겠다고 해놓고 AI를 쓴 사례가 적발돼 리뷰에서 배제된 경우들이다. → 2026-07-07-icml-2026-awards
Hacker News의 논쟁 구도는 아티클의 요약이 정확하다 — “생성은 공짜인데 검수는 비싸다” vs “피어리뷰 전에 올리는 곳이 arXiv 아니었나”. 후자의 논거는 PPO 같은 것을 발굴할 통로가 막힌다는 것이고, 애초에 arXiv가 뜬 이유도 저널·학회가 6개월 이상 느려서 지식 공유를 앞당기려던 것이었다. 최승준의 촌평: “그런데 세상이 다시 롤백됐네요.”
[06:40] 좋은 연구란 무엇이고, 거기에 어떻게 점수를 주나
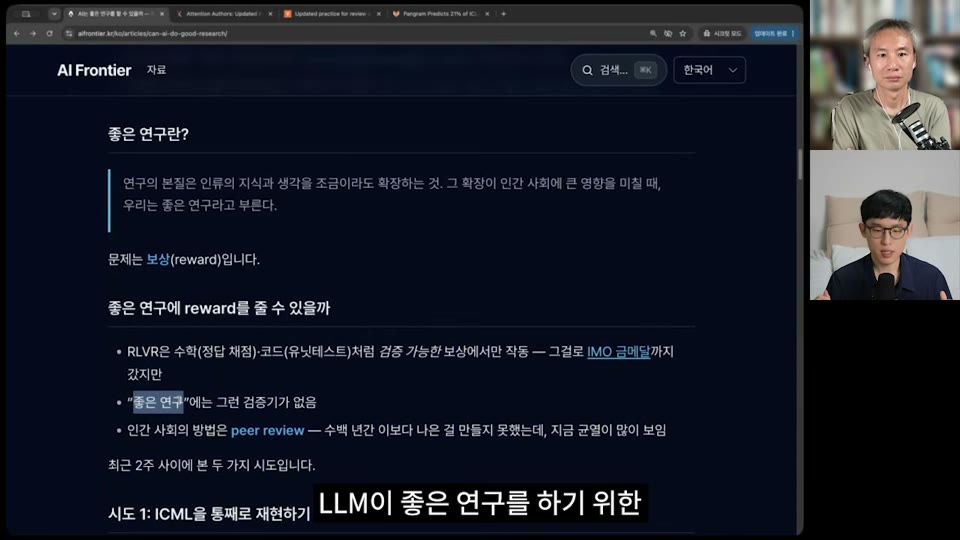
박종현의 정의는 화면의 문장 그대로다 — “연구의 본질은 인류의 지식과 생각을 조금이라도 확장하는 것. 그 확장이 인간 사회에 큰 영향을 미칠 때, 우리는 좋은 연구라고 부른다.” 최승준은 여기에 연구 윤리를 한 줄 덧붙였다. 인류에 미치는 임팩트에는 여러 종류가 있고, 전시(戰時)처럼 윤리를 무시한 연구가 벌어진 시기도 있었다는 것.
그리고 문제는 보상(reward) 이다. 슬라이드의 세 줄이 이 에피소드 전체의 뼈대다.
- RLVR은 수학(정답 채점)·코드(유닛테스트)처럼 검증 가능한 보상에서만 작동한다 — 그걸로 IMO 금메달까지 갔지만
- “좋은 연구”에는 그런 검증기가 없다
- 인간 사회의 방법은 peer review — 수백 년간 이보다 나은 걸 만들지 못했는데, 지금 균열이 많이 보인다
[09:45] 시도 1 — ICML을 통째로 재현하기
허깅페이스가 ICML 재현 챌린지(Reproduce Challenge) 를 진행 중이다. 에이전트가 논문에 나온 방법을 실제로 다시 구현해 결과가 나오는지 검증한다. 논문에 “이렇게 실험했고 이렇게 좋아졌다”고 써 있어도 직접 구현하면 안 되는 경우가 많은데, 오픈소스를 다 내놓으라고 해도 하드웨어 실험이나 비공개 시뮬레이터가 끼면 현실적으로 어렵다. 그래서 논문에 적힌 논리만으로 재현을 시도한다.
녹화 시점 기준 약 800편이 재현됐고(반증 포함), 챌린지는 8월 2일 마감이다. 요점은 개별 결과가 아니라 구조다 — 글만 읽고 피어리뷰하던 것에서 실제로 돌려보고 데이터가 나오는지까지 검증하는 단계가 생겼고, 이것이 좋은 연구를 거르는 중간 단계의 리워드로 작동한다.
[12:32] 시도 2 — 랄프톤: AI로 논문 쓰고, AI로 리뷰하기
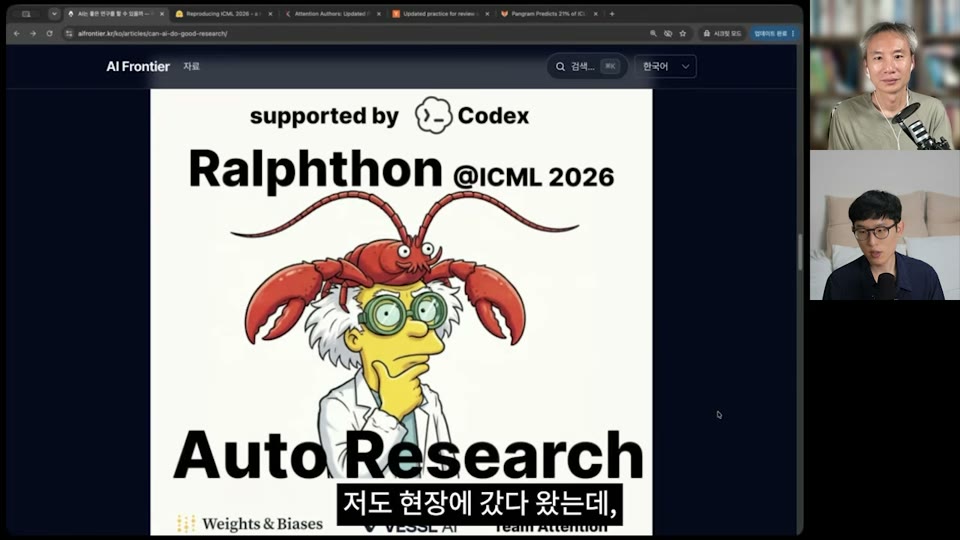
랄프톤(Ralphthon) 은 Ralph 루프를 돌려놓고 진행하는 해커톤으로, 한국에서 밈처럼 유행해 샌프란시스코·싱가포르에서도 열렸다. ICML 기간에 맞춰 열린 이번 회차는 Auto Research를 주제로 두 트랙을 두었다 — Track 1: LLM으로 진짜 연구·실험을 거쳐 논문 쓰기, Track 2: 그 논문들을 리뷰하기. Codex, Weights & Biases, VESSL AI, 팀어텐션이 후원했다.
행사 규칙 자체가 콘셉트를 말해준다: “Once the Ralph Loop starts, you cannot touch your coding agent directly. If you want to touch your laptop, you have to wear the lobster costume first.”
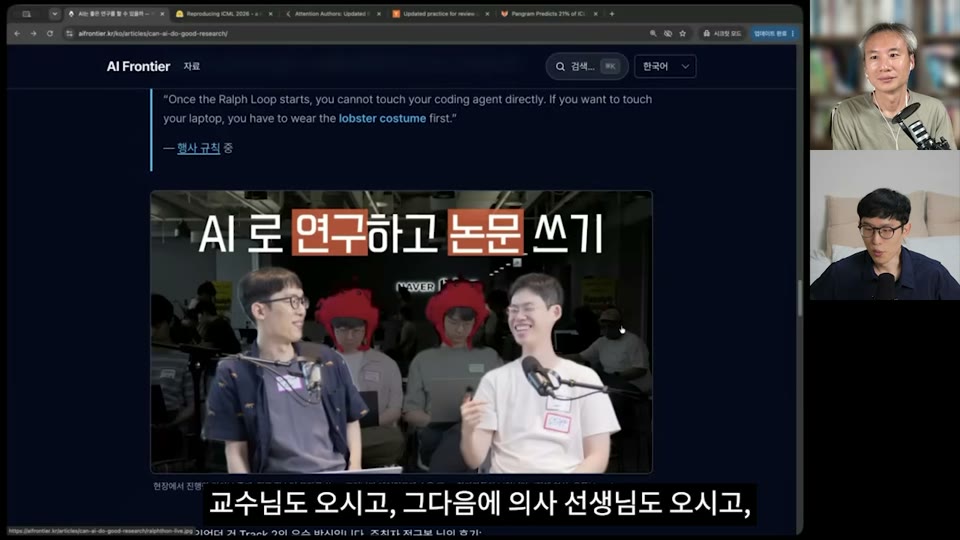
박종현이 현장에서 인터뷰한 참가자 층이 넓었다 — 교수, 의사, 연구자, 그리고 15살 고등학생. 그 학생의 관심사는 이랬다: LLM 컨텍스트를 프롬프트로 채우다 보면 어느 순간부터 성능이 나빠지는 것 같은데, 언제·어떻게 나빠지는지, 그리고 중요한 데이터를 앞에 둬야 하는지 뒤에 둬야 하는지. 학교에서 연구를 배워본 적이 없을 텐데도 질문을 세우고 그걸 풀 방법을 스스로 찾아가는 모습이었다는 게 박종현의 감상이다.
[15:58] 리뷰 에이전트를 어떻게 채점했나 — “인간과의 상관관계”
이 에피소드에서 가장 예리한 장면이다. 좋은 리뷰 에이전트를 어떻게 심사하느냐 — 리뷰의 품질은 직접 채점할 방법이 없다. 주최자 정구봉(팀어텐션)의 후기가 화면에 인용돼 있다:
“리뷰 에이전트는 Track 1 페이퍼들을 필수로 10개씩 리뷰했고, 그 점수가 같은 페이퍼를 심사한 인간 심사위원들의 점수와 상관관계가 가장 높은 팀을 와일드카드로 올렸는데 — 그 와일드카드가 Track 2에서 우승했습니다.”
즉 인간 심사위원과의 정렬(correlation)을 점수로 삼았고, 접근 방법만 보고 서류로 통과시킨 팀들 사이에서 실측으로 올라온 와일드카드가 이겼다. 우승팀 ‘맥 앤 치즈’의 방식은 논문 속 숨은 프롬프트 인젝션과 계산 오류를 탐지하고 복수의 AI 리뷰어를 종합하는 것이었다. 검증할 수 없어 보이던 “좋은 평가”조차 인간과의 정렬로 reward를 만들어낸 셈이다.
이 방향은 학회도 같다. AAAI-26은 논문 22,977편 전부에 AI 리뷰를 제공했고, 저자들은 기술적 정확성 면에서 AI 리뷰를 인간 리뷰보다 선호했다(조작 취약성 경고도 함께 나왔다).
최승준은 여기서 LLM에 루브릭을 주는 계통과 이어진다고 봤고, 박종현은 Kimi K2가 루브릭 기반의 자세한 평가로 에이전트 성능을 끌어올린 사례를 같은 방향으로 꼽았다. RLVR의 원리와도 같다 — 좋은 리워드 하나만 주고 방법은 강제하지 않는 것.
2부 — Dwarkesh 두 편: 수학과 물리에서 AI는 어디까지 가나
[18:04] 두 편의 인터뷰
Dwarkesh 팟캐스트에 최근 올라온 두 편을 두 사람이 같이 보고 왔다 — 그랜트 샌더슨(3Blue1Brown, 6월 30일 공개, ‘Math is where we’ll see superintelligence first’)과 애덤 브라운(구글 딥마인드, 원래 스탠퍼드 물리학자, 슈퍼인텔리전스 연구). 썸네일 카피부터 주제를 압축한다 — “Press go, pour compute at it, and look away for ten years.”
[20:13] IMO 금메달은 훈련 가능한 10시간짜리 태스크다
3년 전 Dwarkesh가 샌더슨에게 물었다 — AI가 IMO 금메달을 따면 그게 AGI 아닌가요? 그때 샌더슨의 답은 “it’ll be another benchmark, like all these other benchmarks that AI are passing”였고, 지금 금메달은 실제로 나왔지만 아무도 그걸 AGI라 부르지 않는다. 선견지명이 있었던 셈이라 두 사람이 이 인터뷰에 더 집중하게 됐다.
샌더슨의 근거는 “The dirty secret with the IMO is that you really can train for a lot of them” — 노벨티가 있어 보여도 결국 훈련 가능한 문제라는 것이다. 수능을 기출로 훈련하는 것과 구조가 다르지 않다. 스케일도 크지 않다: IMO는 이틀에 6문제, 10시간짜리 태스크다. 어느 IMO 금메달리스트 출신 GPU 클라우드 창업자가 Latent Space에서 한 말대로 “IMO 금메달은 수학자의 입문 컷”이고, 진짜 수학 연구는 몇만 시간짜리다.
더 흥미로운 건 뾰족함이 수학 내부에서도 반복된다는 점이다. AGI가 아닌 이유가 “다른 당연한 걸 못 해서”인 것처럼, 수학 안에서도 대수·기하·정수론은 쉽게 풀면서 조합론은 안 풀린다. 아티클의 표현으로 “AI의 프론티어는 스파이크형이고 그 스파이크는 프랙탈이라 — 수학 안에서도 기하는 19초 만에 풀리는데, 조합론은 아직 버티는 중”이다. 2024년 딥마인드가 은메달에 그친 것도 조합 한 문제를 틀려서였다. 사람 중에도 조합 전문가가 따로 있고, 천재들이 잘하는 선천적인 과목이라고들 한다.
[24:21] 갈루아의 군론은 검증에 100년이 걸렸다
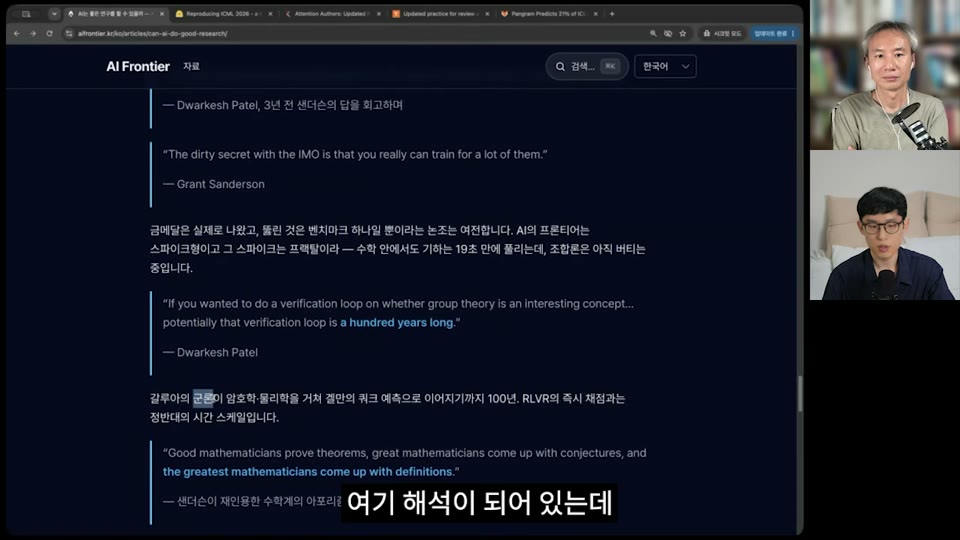
Dwarkesh가 던진 문제 제기가 이 에피소드에서 가장 근본적이다:
“If you wanted to do a verification loop on whether group theory is an interesting concept… potentially that verification loop is a hundred years long.”
갈루아의 군론이 암호학·물리학을 거쳐 겔만의 쿼크 예측으로 이어지기까지 100년이 걸렸다. 어떤 이론이 정말 좋은 연구였는지 검증되는 데 걸리는 시간이 그렇다는 것이고, 그러면 반복이 불가능하다. RLVR은 즉시 채점으로 보상을 주고 그 방향으로 지능을 밀어 올리는 방식이니, 시간 스케일이 정반대라 그대로는 적용되지 않는다.
같은 화면에 샌더슨이 재인용한 수학계 아포리즘이 있다:
“Good mathematicians prove theorems, great mathematicians come up with conjectures, and the greatest mathematicians come up with definitions.”
지금의 벤치마크가 채점하는 것은 첫 번째뿐이다. “이 방향에 뭔가 있다”던 갈루아의 직감을 벤치마크로 만드는 방법은 샌더슨 자신도 모르겠다고 했다.
[27:48] 반론 — 서로 다른 분야를 잇는 건 LLM이 유리하다
박종현은 그럼에도 좋은 연구는 충분히 가능하다고 본다. 근거는 샌더슨 편에 나온 일화다. 수론자 몽고메리와 물리학자 다이슨이 프린스턴 고등연구소의 티타임에서 잡담하다 리만 제타 함수 쪽 이야기와 물리 쪽 이야기가 같은 구조임을 발견했다. 우리가 완전히 다르다고 생각하는 분야들에 사실은 동형(isomorphic) 인 요소가 많다는 것이다.
인간은 자기 도메인만 잘 알지만 LLM은 지식 관점에서 모든 도메인을 순식간에 안다. 이쪽 분야의 요소를 저쪽에 동형으로 적용하는 것만으로 발견이 일어날 수 있다면, 인류가 아직 못 찾은 지식을 늘리는 일은 충분히 가능하다.
최승준의 반론은 실전에 가깝다 — 컨텍스트의 저주. 그냥 시키면 분포가 평균 쪽으로 향해서 그 계열에서 할 법한 이야기만 하고, 다른 분야를 끌어와 달라고 명시해야만 끌어온다. 그래서 아직은 그 부분이 인간의 몫이라는 것. 대응책으로는 프롬프트에 다른 분야를 직접 넣어주기, 엔트로피가 낮은 출력 토큰을 골라 일부러 다른 방향을 탐색시키기, 그리고 작년 Gwern이 제안한 LLM Daydreaming(자는 동안 여러 개념을 연결시키는 개념)처럼 하네스로 우회하는 방법이 거론됐다.
[30:39] 애덤 브라운 편 — 실험 없이 어디까지 갈 수 있나
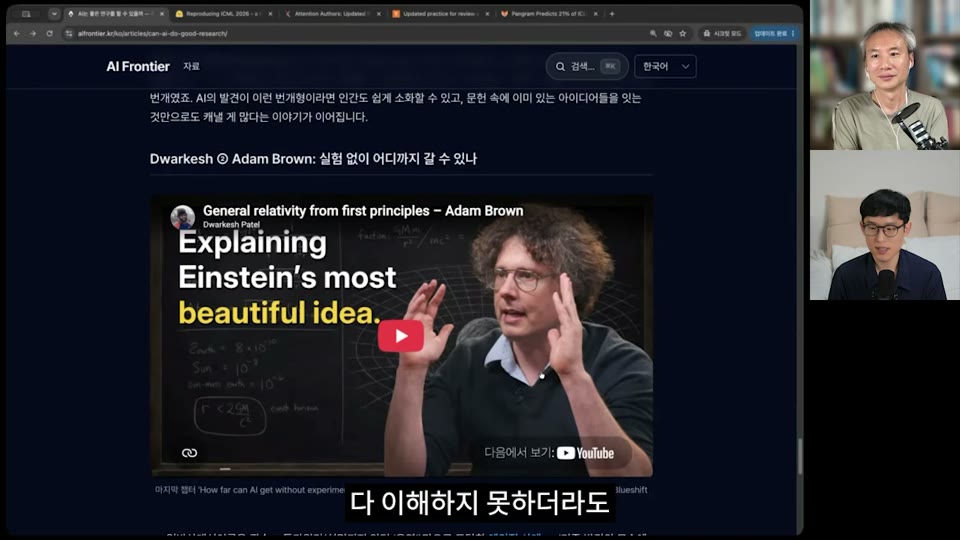
애덤 브라운 편은 1시간 40분 중 1시간 10~20분이 사실상 상대성 이론 강의이고, 마지막 챕터가 ‘How far can AI get without experiments’다. 이론물리가 어려운 이유는 실험이 어렵다는 것 — 입자를 광속에 가깝게 가속해야 가설 하나를 관찰할 수 있으니, 결국 사고실험에 의존하게 된다. 그 사고실험을 AI에 맡기면 어디까지 갈 수 있는가.
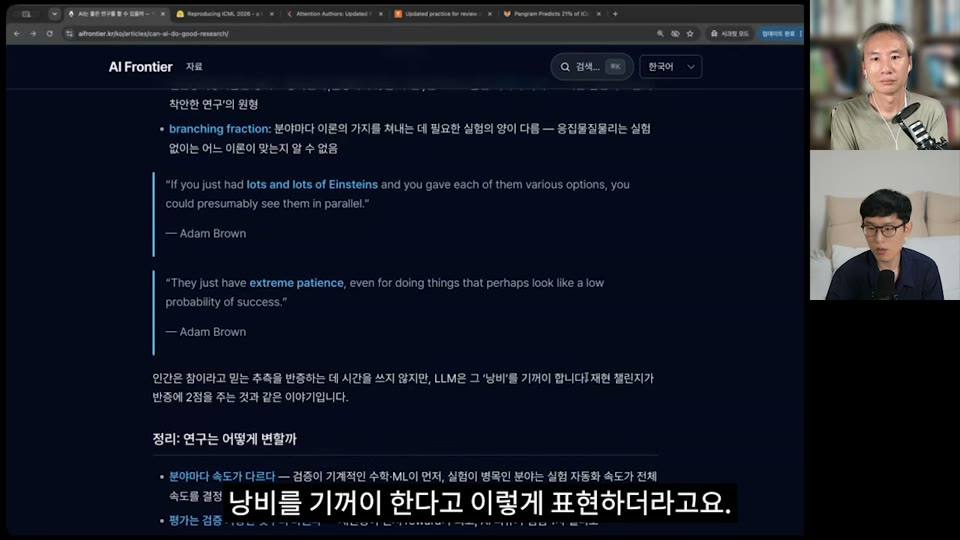
브라운의 답은 병렬화다: “If you just had lots and lots of Einsteins and you gave each of them various options, you could presumably see them in parallel.” 아인슈타인급 지능은 역사상 한 번에 한 명뿐이었지만, LLM은 마구 만들어 머릿속 실험을 동시에 대량으로 돌릴 수 있다. 문제를 탐색(search) 으로 보고 컴퓨테이션을 부으면 찾아낼 게 훨씬 많다는 것이다.
두 번째 답이 더 중요하다: “They just have extreme patience, even for doing things that perhaps look like a low probability of success.” 아티클이 이걸 이렇게 옮겼다 — “인간은 참이라고 믿는 추측을 반증하는 데 시간을 쓰지 않지만, LLM은 그 ‘낭비’를 기꺼이 합니다.” 뉴턴의 만유인력처럼 다들 참이라 믿던 것에 모순이 쌓여 있었고, 그 모순을 찾아내야 새 설명이 나온다. 앞서 나온 재현 챌린지가 반증에 2점을 주는 것과 정확히 같은 이야기다. 이것이 최승준의 표현대로 자료를 정리한 Fable 5가 뽑아낸 문장 중 일부러 남긴 대목이었다.
같은 화면의 branching fraction 개념도 짚어둘 만하다 — 분야마다 이론의 가지를 쳐내는 데 필요한 실험의 양이 다르다. 응집물질물리는 실험 없이는 어느 이론이 맞는지 알 수 없다.
[36:10] 정리 — 연구는 어떻게 변할까
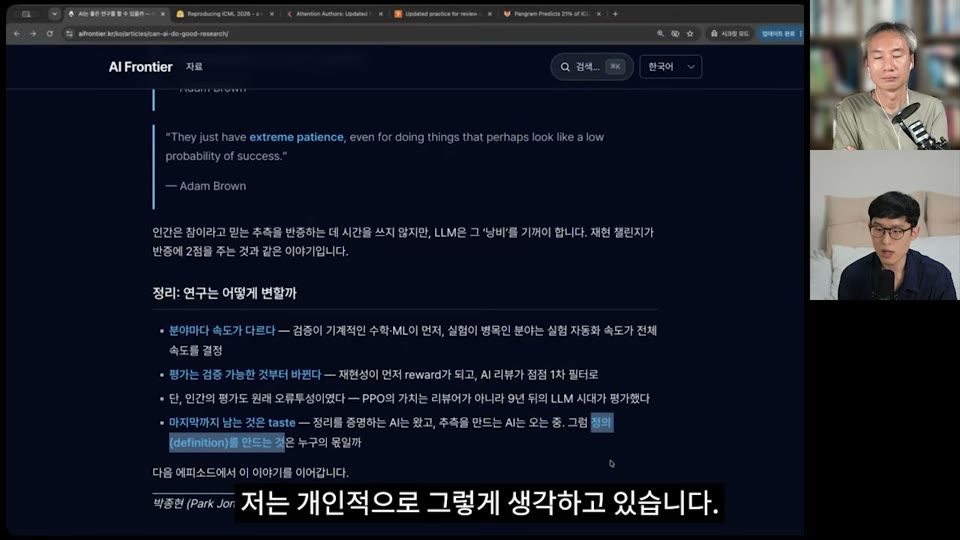
아티클이 네 줄로 정리한 전망이 이 에피소드 전반부의 결론이다.
- 분야마다 속도가 다르다 — 검증이 기계적인 수학·ML이 먼저. 실험이 병목인 분야(바이오·화학처럼 합성하고 반응을 봐야 하는 것)는 실험 자동화 속도가 전체 속도를 결정한다.
- 평가는 검증 가능한 것부터 바뀐다 — 재현성이 먼저 reward가 되고, AI 리뷰가 점점 1차 필터가 된다.
- 단, 인간의 평가도 원래 오류투성이였다 — PPO의 가치는 리뷰어가 아니라 9년 뒤의 LLM 시대가 평가했다.
- 마지막까지 남는 것은 taste — 정리를 증명하는 AI는 왔고, 추측을 만드는 AI는 오는 중. 그럼 정의(definition)를 만드는 것은 누구의 몫일까.
박종현 본인의 답은 낙관 쪽이다. 정의라는 것도 결국 만들면 되는 것이고, 그게 좋은 정의냐는 현실의 물리·자연 현상을 얼마나 잘 설명하느냐로 판정된다. 그렇다면 evaluation·verification이 가능한 탐색 문제와 다르지 않을 수 있다. 다만 타임스케일은 향후 2년이 아니라 10년, 20년 쪽이라고 봤다.
3부 — 지적 자동화 시대에 남는 것들 (최승준)
[38:14] 실험으로 루프를 닫아야 하는 영역
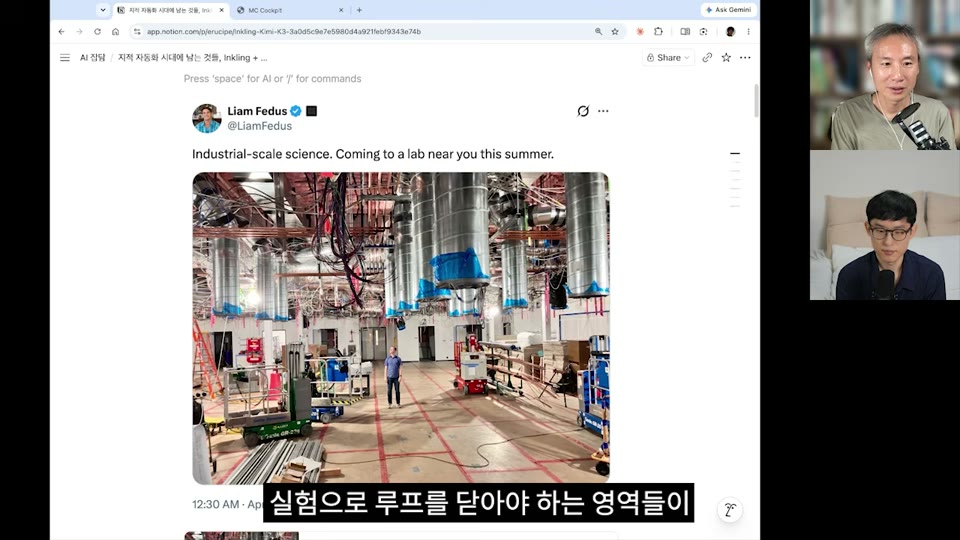
최승준의 첫 자료는 Periodic Labs(OpenAI 출신들이 재료·물리를 하려고 창업)의 공동대표 Liam Fedus가 올린 트윗이다 — “Industrial-scale science. Coming to a lab near you this summer.” 사진은 짓고 있는 공장 내부다. 앞서 나온 “실험이 병목인 분야”가 실제로 어떻게 대응하고 있는지 보여주는 장면이고, 실험으로 루프를 닫아야 하는 영역이 분명히 있다는 뜻이다.
[38:56] 지적 돌파의 세 가지 모습
최승준은 두 인터뷰를 보고 모델과 대화하며 「지적 자동화 시대에 남는 것들 — 답을 넘어서, 이해와 설명과 선택의 문제」라는 글을 만들었다. 여기서 샌더슨이 말한 지적 돌파의 세 가지 모습을 다시 꺼낸다.
- 번개(lightning bolt) — 서로 다른 두 분야를 잇는 것. 요즘 시대엔 비교적 쉽다.
- 새로운 산을 쌓기 — 어렵고 오래 걸리며, 맞는지 틀리는지 일찌감치 알 수 없다. 정말 생산적인 생각이었는지는 수십 년 뒤에야 드러날 수도 있다.
- 새 개념 없이 추론량으로 밀어붙이기 — Mathematica나 Lean 계열의 자동 증명 기계로, 인간이 이해하기 어려운 ‘외계 수학’을 탐색하는 것은 기존에도 가능했다.
핵심은 3번에 붙는 단서다. 그게 참임을 보이는 것과, 그게 정말 우리가 원하고 생각을 바꿀 수 있는 아이디어인지 판정하는 것은 다른 일이다. 그래서 인간이 소화할 수 있게 만드는 일이 여전히 중요한데 — 샌더슨은 그 설명하는 일조차 기계가 잘할 수 있다고 봤다.
그렇다면 남는 것은 무엇을 설명할지, 어떤 아이디어가 씨름할 가치가 있는지, 어떤 순서로 보여줄지, 왜 이게 흥미로운지를 고르는 역할이다. 샌더슨이 자기 존재 가치를 그렇게 설정하는 대목이 최승준에게 인상 깊게 남았다고 한다. Dwarkesh도 어려운 걸 공부할 때 본문을 읽기보다 모델에게 설명하게 하면 난이도가 확 낮아진다고 했다.
[41:39] 글쓰기가 RLVR로 안 되는 이유
그런데 설명하는 글은 잘 쓰면서 창작 글쓰기(소설·개그)는 어느 수준을 못 넘는다. 최승준이 옮긴 Dwarkesh의 설명이 명쾌하다 — RLVR은 최종 결과가 맞냐 틀리냐를 스칼라 보상으로 줄 수 있어야 작동한다. 코딩은 궤적 전체에 보상을 주면 되지만, 글쓰기는 각각의 토큰이 다 최종 결과물이라서 그 방식이 통하지 않는다.
좋은 글은 독자가 어디서 멈칫할지, 어떤 오해를 할지, 어떤 순서로 생각해야 다음 문장을 받아들일 수 있을지 헤아린다. 각 문장과 단어는 단순한 포장이 아니라 바로 내용 그 자체다.
글쓰기는 코드처럼 겉이 지저분해도 결과만 나오면 되는 일이 아니라는 것. 같은 이유로 교사의 위치도 이동한다 — 교육이 본질적으로 사회적·관계적 활동이라서 남는 것이지, 단순한 설명이라서 남는 게 아니다.
[43:41] 남는 것의 목록
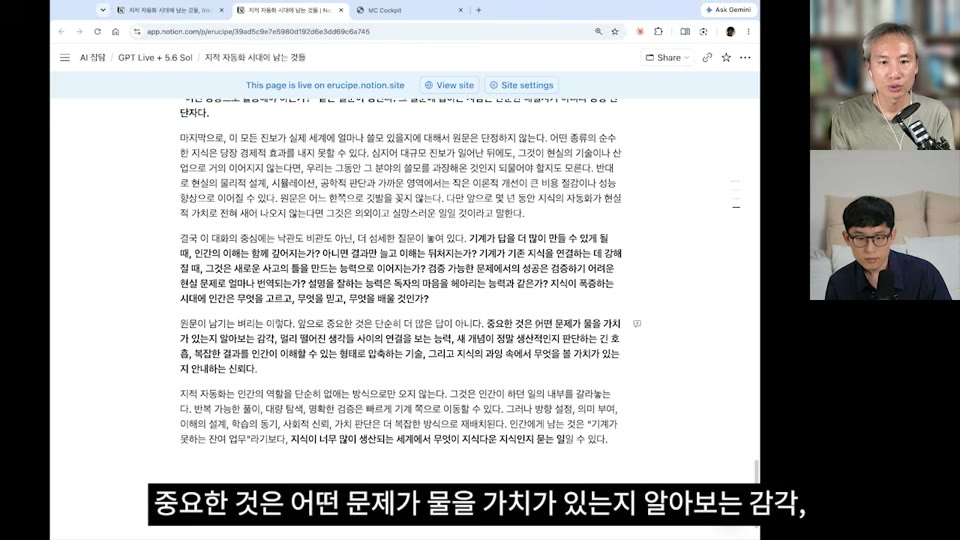
글의 결론부가 이 에피소드 전체의 답에 가깝다.
앞으로 중요한 것은 단순히 더 많은 답이 아니다. 중요한 것은 어떤 문제가 물을 가치가 있는지 알아보는 감각, 멀리 떨어진 생각들 사이의 연결을 보는 능력, 새 개념이 정말 생산적인지 판단하는 긴 호흡, 복잡한 결과를 인간이 이해할 수 있는 형태로 압축하는 기술, 그리고 지식의 과잉 속에서 무엇을 볼 가치가 있는지 안내하는 신뢰다.
지적 자동화는 인간의 역할을 단순히 없애는 방식으로 오지 않는다. 그것은 인간이 하던 일의 내부를 갈라놓는다. 반복 가능한 풀이, 대량 탐색, 명확한 검증은 빠르게 기계 쪽으로 이동할 수 있다. 그러나 방향 설정, 의미 부여, 이해의 설계, 학습의 동기, 사회적 신뢰, 가치 판단은 더 복잡한 방식으로 재배치된다. 인간에게 남는 것은 “기계가 못하는 잔여 업무”라기보다, 지식이 너무 많이 생산되는 세계에서 무엇이 지식다운지 묻는 일일 수 있다.
[44:23] 재미없는 소설과 좋은 소설 — 압축이 곧 지능
박종현이 글쓰기와 수학을 잇는다. Lean은 수식처럼 생겼지만 돌리면 true/false가 판정되는 언어라, 수학을 얼추 verifiable하게 바꿀 수 있다(재작년 딥마인드가 IMO 은메달을 딸 때 Lean으로 작성했고, 올해부터는 안 쓴다).
당시 다들 무서워한 시나리오는 이것이다 — theorem을 증명했는데 아웃풋이 수백만 줄짜리 Lean 코드면 인간은 이해할 수 없다. 설명이 불가능하지만 참이긴 한 것, 말하자면 재미없는 소설이다. 그런데 정작 최근 OpenAI 발표들의 증명은 내용이 이해하기 쉽다고 애덤 브라운이 평했고, Dwarkesh가 “그건 님한테만 쉬운 거 아닐까요?”라고 받았다. 어쨌든 아주 똑똑한 인간 기준으로 설명 불가능한 수준은 아니라는 것.
여기서 3Blue1Brown이 현재 연재 중인 「Compression is Intelligence」(3부작, ‘압축이 곧 지능이다’)와 이어진다. 아인슈타인이 10년, 20년 걸려 만든 것을 우리는 1시간 만에 듣는다. 탐색과 사고실험과 실제 실험으로 쌓인 지식이 모두가 이해할 수 있는 수준으로 압축되는 것 자체가 지능이라는 이야기다. 박종현의 연결: 잘 압축해 설명을 쉽게 만든 글이 똑똑한 글이고, 어떻게 보면 그게 좋은 소설이다(단, 재미있는 소설과 이해하기 쉬운 소설은 또 다른 것 같다는 단서를 달았다).
최승준이 계보를 덧붙인다. AGI라는 말을 널리 유통시킨 딥마인드 공동창립자 Shane Legg의 스승이 Marcus Hutter이고, 후터는 위키피디아 압축 상금을 낸 사람이다. 압축이 두 사람의 연구 화두였고 그 근간에 Solomonoff induction이 있다. Ilya Sutskever가 콜모고로프 복잡도를 설명할 때 한 이야기도 그 근처다 — algorithmic information theory 계통이 지금 AI의 근간을 이룬다.
박종현의 거시적 감상이 여기에 붙는다. 천 년 전 사람과 자기 뇌의 하드웨어는 크게 다르지 않을 텐데 산출물은 전혀 다르다. 그건 인류의 지식이 쌓이고 잘 압축돼서 정규 교육과정으로 머릿속에 빠르게 들어가기 때문이다. 최승준의 말로는 스캐폴딩이 이미 머릿속에 들어차 있어 생각의 도구로 쓸 수 있게 되는 것. 그러니 지식을 압축해서 잘 넣는 게 지능의 본질일 수도 있다.
반대편 인용도 잊지 않는다 — Ted Chiang이 “LLM은 웹의 흐릿한 JPEG”이라 해서 도마에 오른 적이 있고, 같은 작가가 2000년에 쓴 단편 「Catching crumbs from the table」(번역 「인류 과학의 진화」)에는 메타휴먼이 한 연구를 이해하기 위해 인류가 고고학을 하는 웃픈 이야기가 나온다. 최승준은 애덤 브라운 편 트랜스크립트를 넣어 mnemonic book(대화 → 중간에 tinkering 가능한 시뮬레이션 → 뒤에서 앞을 묻는 퀴즈)을 만들어보기도 했다.
[50:36] Dwarkesh의 기획, 그리고 빈티지 LM
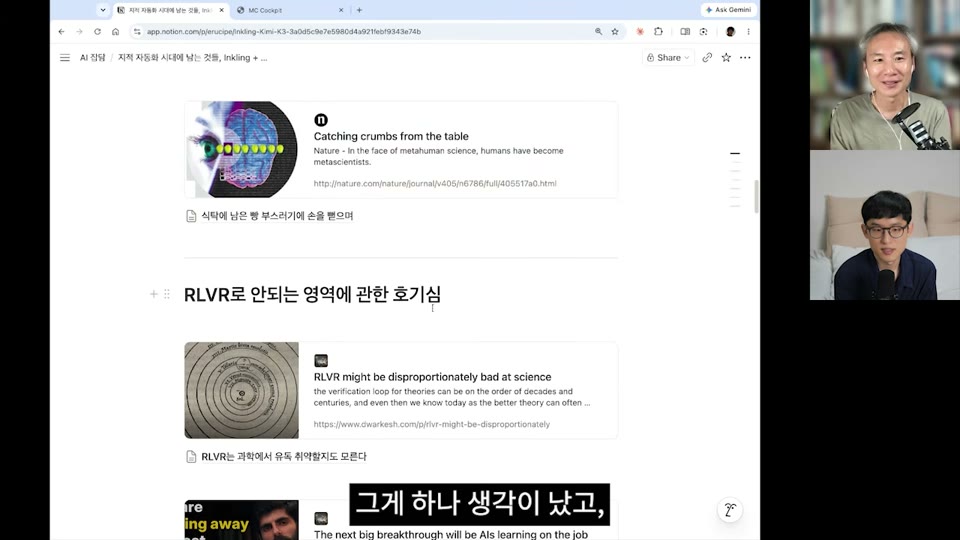
최승준이 보기에 이 두 인터뷰는 우연이 아니라 Dwarkesh의 집요한 기획이다. 5월에 「RLVR might be disproportionately bad at science」(RLVR은 과학에서 유독 취약할지도)라는 블로그 글로 가설을 먼저 던져놓고, 거기에 맞는 인터뷰이 — Michael Nielsen, 샌더슨, 애덤 브라운 — 를 찾아 짜내고 있다는 것. 앞선 시리즈에서는 pretraining의 한계, continual learning이 안 된다는 문제를 같은 방식으로 다뤘다.
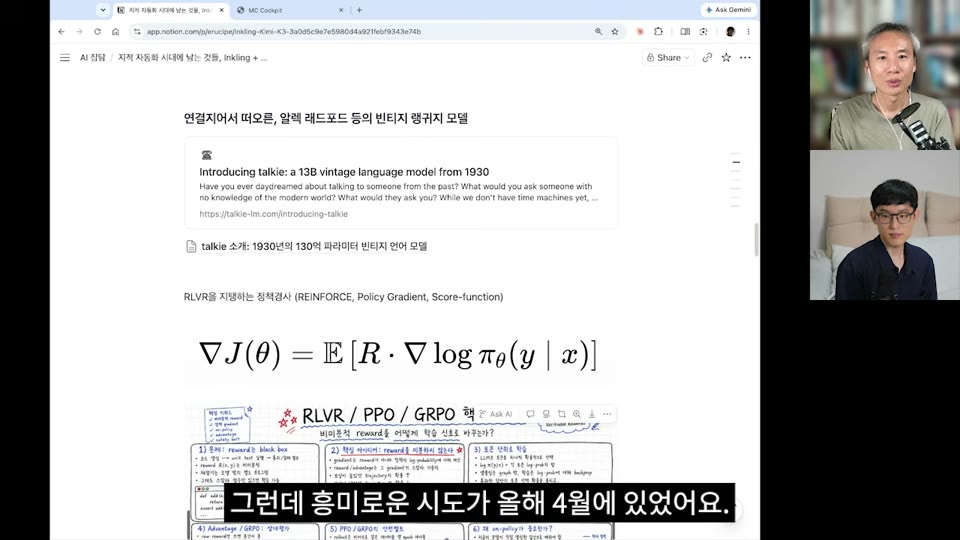
관련해 올해 4월의 흥미로운 시도가 빈티지 LM이다. GPT를 만든 Alec Radford 등이 talkie라는 이름으로 1930년 이전 텍스트만 학습한 130억 파라미터 모델을 만들었다. 이 모델이 pretraining과 RL로 1930년대 이후에 일어날 발전을 상상할 수 있는가를 묻는 실험이다. 박종현의 해석: 데이터만 잘 만들어져 있다면, 이 모델이 2000년대까지의 기술적 발전을 재현해내는지가 앞으로도 해낼 수 있다는 일종의 증명이 된다. 결과에 따라 생각과 행동이 실제로 바뀔 만한 관전 포인트다.
[52:41] RLVR의 계보와 구조적 한계
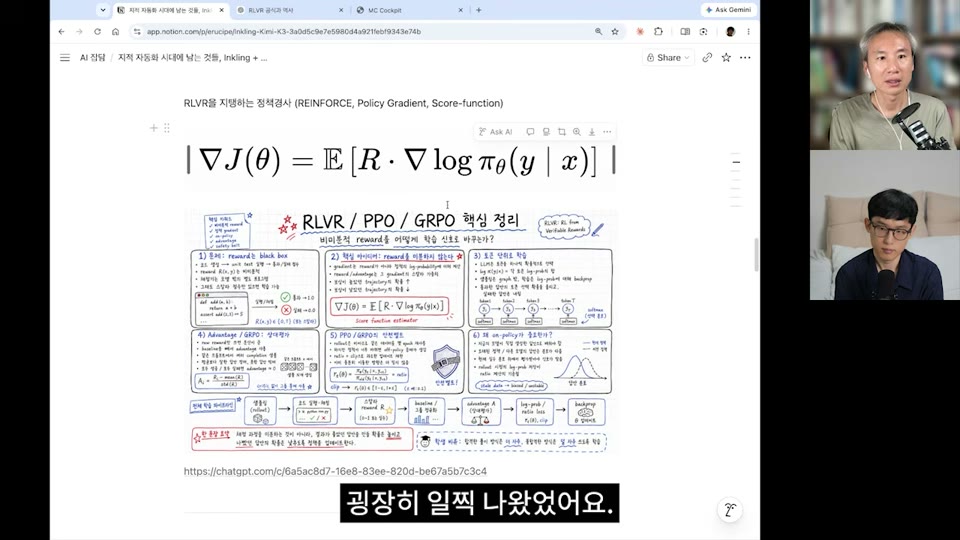
RLVR의 근간 아이디어는 아주 오래됐다. 통계학의 Ronald Fisher score function이 1900년대 초~20년대, Williams 등의 REINFORCE/policy gradient가 1990년대 초반이다. 화면의 수식이 전부를 압축한다:
∇J(θ) = E[ R · ∇log π_θ(y | x) ]
x= 입력 프롬프트,y= 출력 토큰(들),π_θ= LLM,θ= 파라미터- score function은 확률에 로그를 취한 것의 gradient다. 여기에 모델 바깥에서 준 스칼라 보상
R을 곱하기만 하면, 계산 그래프가 연결돼 있지 않아도 분포를 바꿀 수 있다. - LLM에서 이게 작동하는 이유는 LLM이 토큰의 logit → 확률을 뱉기 때문이다. 토큰 vocab이 곧 action space가 된다.
- RLVR에서는 코드를 다 쓴 뒤 검증기가 바깥에서 테스트를 돌려 작동 여부를 알려주면 그게 보상
R이 된다. 궤적 전체에 높은/낮은 확률을 준다. - DeepSeek의 GRPO는 여기에 그룹 평균을 baseline으로 놓고 상대평가를 한다 — 평균보다 잘하면 플러스, 못하면 마이너스로 궤적을 강화한다.
구조에서 한계가 그대로 따라 나온다. 풀이가 맞으면 어떻게 썼든 전체를 올리기 때문에, 얼마나 간결하게·예쁘게 썼는지는 학습되지 않는다. 어떤 토큰이 실제로 기여했는지 보장되지 않는다는 것 — 앞서 나온 100만 줄 Lean 코드 걱정과 정확히 같은 뿌리다. 그래서 답이 하나가 아닌 것들(이것도 맞고 저것도 맞는 것, 함의가 있는 것)은 여전히 RLVR로 안 되고, 그런 문제가 몰려 있는 데가 디자인과 예술이다. 최근 연구들은 풀이 길이를 보상에 넣는 등 regularizer와 각종 기법으로 이를 꼬집어 다루지만, 근본적으로는 아직 같은 regime 안에 있다.
[56:46] 디자인 — taste는 사람이 루프 안에서 찍는다
박종현이 최근 디자인을 직접 해보며 얻은 관찰이 이 한계의 실물 사례다. 요즘 웹사이트나 PPT를 보면 “저거 Claude가 만든 디자인이네”가 한눈에 보이는데, YC가 공개한 AI 디자인 방식의 결과물에서는 그 티가 전혀 안 났다. 따라 해보니 절차가 이랬다 — soul을 만들고, mood board를 만들고, 이것저것 다 하는데, 결국 사람이 taste에 해당하는 selection을 해서 그걸 input으로 넣는다. 그리고 output 디자인이 N개 뽑혀 나오면 거기서 또 사람이 pick한다.
정답이 여러 개일 수 있는 문제는 이렇게 human이 루프 안에 들어가 선택을 찍는 것으로 푼다. 취향은 만든 사람의 취향이라 마법처럼 나오지 않는다. 최승준의 촌평: 극복하는 방법은 있지만 아직 우아하진 않다.
4부 — 여전히 잘 되는 영역, 그리고 자기 개선
[58:50] Bun을 Rust로 다시 쓰다
한계 얘기만 한 건 아니다. 7월 8일 Bun(현재 Anthropic 소유) 블로그가 약 100만 라인 프로젝트를 Zig에서 Rust로 옮긴 성공담을 공개했다. 최승준이 짚은 포인트는 성공 자체가 아니라 조건이다 — 전문가가 3시간 정도 자기가 아는 것을 다 압축해 제대로 스펙을 만들어야 돌아간다. agent swarm을 아무리 써도 그냥 되는 일이 아니다.
[59:31] Inkling과 Kimi K3 — 2026년 7월의 두 오픈웨이트 모델
Inkling은 John Schulman·Lilian Weng 등이 있는 Thinking Machines Lab(TML) 이 낸 1T급에 가까운 오픈웨이트 모델이다. 최승준이 이름 풀이를 해봤는데 그 자체가 발표의 톤을 말해준다 — inkling은 “어렴풋한 낌새, 희미한 짐작”이고, 철자에 ink가 들어 있지만 어원은 잉크가 아니라 중세 영어 inkle(넌지시 말하다)이다. TML 발표문도 “가장 강한 모델은 아니고, 모델 패밀리의 첫 배포판이며 시작에 불과”하다고 밝혔으니 예고편에 해당하는 이름인 셈이다. 기존 제품 Tinker와 소리결이 어울리고, 톨킨·C.S. 루이스가 속했던 옥스퍼드 문학 토론 모임 The Inklings의 울림도 있다.
가장 흥미로운 건 자기 자신을 파인튜닝하는 것이다. Lilian Weng의 「Harness Engineering for Self-Improvement」(2026-07-04)의 실천 버전으로, 자기네 인프라 Tinker에 올려 모델 자체를 파인튜닝한다. 예시가 재미있다 — 알파벳 e를 빼고 쓰기를 파인튜닝한다. 울리포 계열 문학 실험인 리포그램을 학습 목표로 삼은 것이다. Inkling으로 OpenCode를 돌리면서 자기 자신을 파인튜닝하니 출력 토큰이 점점 바뀌어 가는 구조다. → 2026-07-17-inkling-open-weights-model, 2026-07-04-harness-engineering-for-self-improvement
자기 개선 얘기는 TML만 하는 게 아니다. AIDE² 는 「First Evidence of Recursive Self-Improvement」에서 웨이트가 아니라 하네스 쪽을 개선한다 — autoresearch on autoresearch, 즉 바깥 루프가 자기 리서치 에이전트를 100 스텝 동안 무인으로 재작성한다. 최승준의 정리: 지금은 하네스를 자기 개선하는 방식과 그 하네스가 모델 웨이트를 업데이트하는 Autoresearch 계열이 섞여 있어, 양쪽에서 모델이 업데이트되는 일이 다 일어난다. → 2026-07-16-weco-aide2-first-evidence-recursive-self-improvement
Kimi K3는 아직 못 써봤지만 글로만 봐도 대단하다는 평. 기술 블로그가 내용을 제법 잘 다뤘고, 개인이 돌리기는 어려운 크기지만 저 크기가 오픈웨이트로 나왔다는 것 자체가 고무적이다. 네오클라우드들이 서빙하고 OpenRouter로 제공할 것이다. Inkling과 마찬가지로 MoE 계열이고, 특이하게 칩 디자인도 하고 있다는 언급이 보인다(중국은 칩에서 막혀 있다). 하루 전 공개된 티저 영상은 Kimi K3가 직접 편집했다고 밝혔다. → kimi-k3
[01:03:39] 역(逆) 정보 패러독스 — 지능의 시대에 IP를 어떻게 지키나
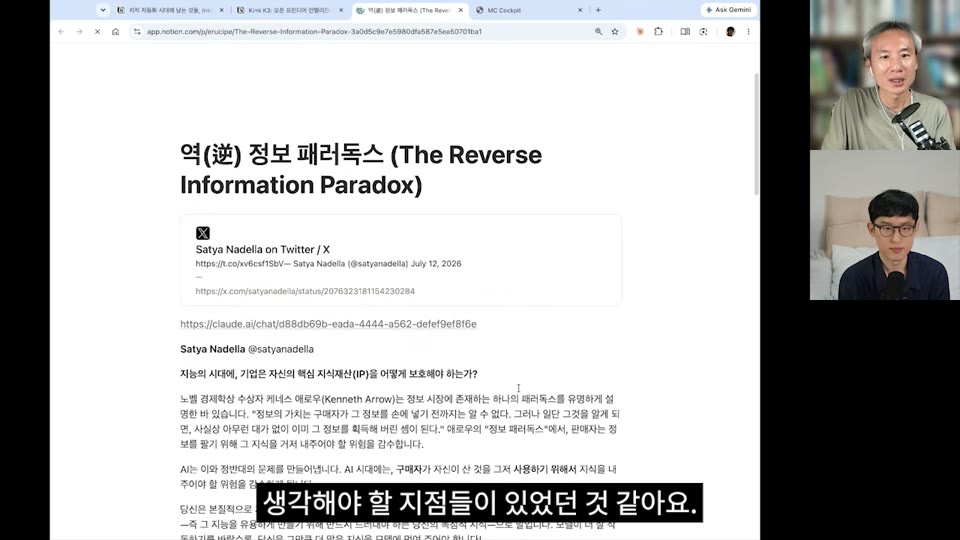
최승준이 “생각해야 할 지점”으로 꼽은 건 Satya Nadella가 7월 12일 던진 질문이다 — 지능의 시대에, 기업은 자신의 핵심 지식재산(IP)을 어떻게 보호해야 하는가?
노벨 경제학상 수상자 케네스 애로우의 정보 패러독스는 이렇다: “정보의 가치는 구매자가 그 정보를 손에 넣기 전까지는 알 수 없다. 그러나 일단 그것을 알게 되면, 사실상 아무런 대가 없이 이미 그 정보를 획득해 버린 셈이 된다.” 그래서 판매자는 정보를 팔기 위해 그 지식을 거저 내주어야 할 위험을 감수한다.
AI는 이를 정반대로 뒤집는다 — 이제는 구매자가 자신이 산 것을 그저 사용하기 위해서 자기 지식을 내주어야 할 위험을 감수한다. 최승준의 부연: 빅테크가 학습에 쓰지 않겠다고 약속해도 사용 양태 자체는 데이터로 들어가고, 그것 자체가 굉장히 강력한 정보다. (직전 회차에서 노정석이 짚었던 온프레미스·오픈소스 모델의 부상과 같은 문제의식이다 → 2026-07-20-ai-frontier-ep104-gpt5-6-icml)
[01:04:21] GPT-5.6 한 주 사용기, 그리고 Sol vs Fable 5
Google 이야기가 잠깐 나왔다. 모델이 여기저기서 빠르게 치고 나오니 일희일비하게 되지만, 시간 프레임을 연 단위로만 늘려도 많은 회사가 다 잘 쫓아오고 있다. 데이터도 하드웨어도 준비된 Google이 못 따라올 거라 상상하긴 어렵다는 게 두 사람의 공통 감상.
박종현의 GPT-5.6 사용기는 짧고 강렬하다 — 어젯밤 돌린 게 10시간이 넘도록 안 끝나서 그냥 멈췄다. test-time compute에 집중한다는 게 이런 식으로도 드러난다.
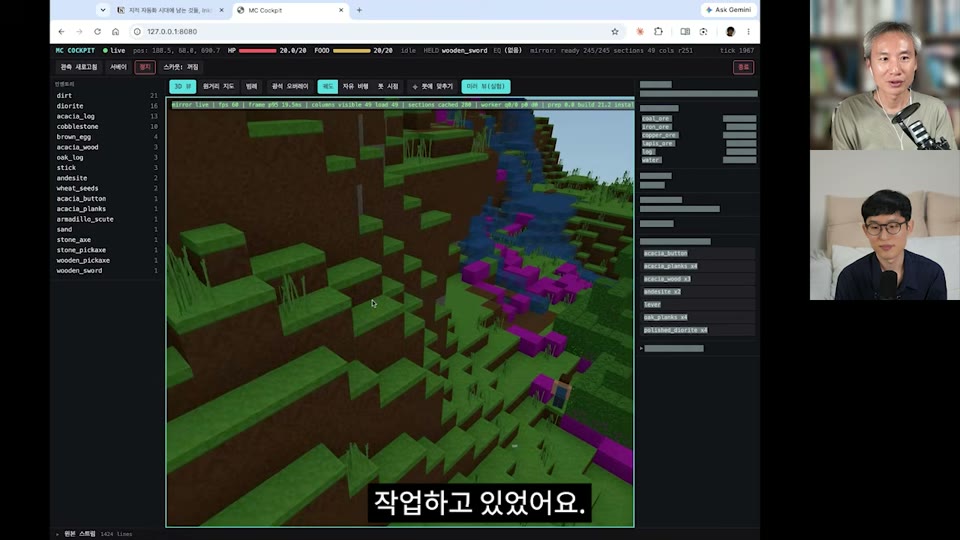
최승준의 사례가 더 흥미롭다. Minecraft 봇을 모델이 만들게 하고, 봇이 막히는 이유를 알고 싶어서 봇이 쓰는 명령어로 사람이 직접 플레이할 수 있는 인터페이스(MC Cockpit) 를 만들었다. 원래 Fable 5가 잘한다는 선입견으로 작업하다가 Sol에게 리뷰를 맡겼더니 Sol이 매우 강하게 지적했고, Fable 5가 거기에 굴복했다. 그래서 드라이버를 Sol로 바꿔봤는데, Fable 5가 리뷰할 때는 Sol만큼 적대적이지 않고 다 수긍하더라는 것. 청크를 대규모로 불러올 때의 스트리밍 문제는 Fable 5가 삑사리를 낸 걸 Sol이 해결했다.
[01:08:30] 루프 밖에 · 루프 안에
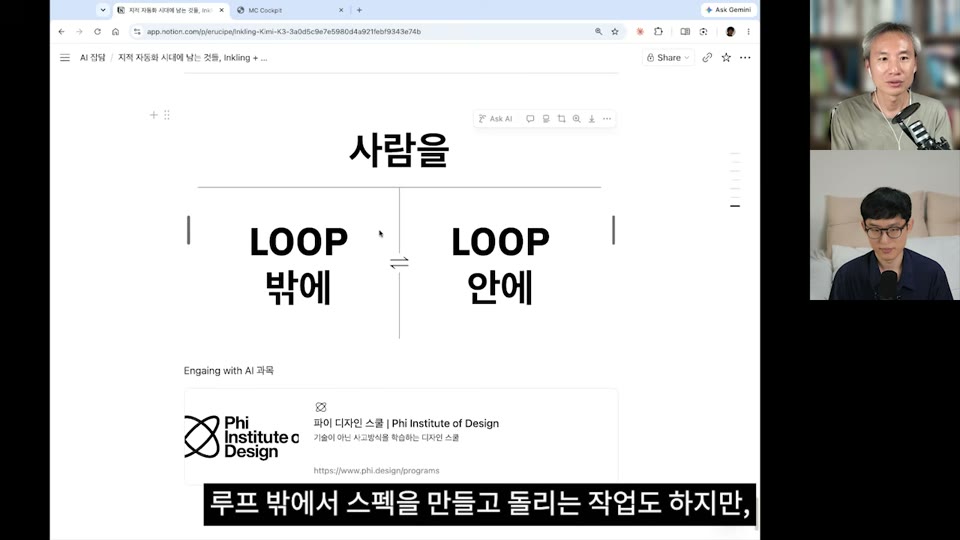
마무리 슬라이드가 이 에피소드의 실천적 요약이다. 최승준은 토스가 만든 파이 디자인 스쿨(Phi Institute of Design) 의 ‘Engaging with AI’ 과목을 맡고 있는데, 거기서 가르치려는 것이 이 두 모드의 왕복이다.
루프 밖에서 스펙을 만들어 돌리는 작업도 하지만, 루프 안에 들어가 — Rust를 몰라도 지금 진행되는 알고리즘의 핵심 부분을 이해하면서 — 임하는 모드도 있다. 양쪽을 다 겪어봐야 한다는 것이 그의 입장이다. 앞서 나온 “compression is intelligence”와 “taste는 사람이 찍는다”가 실무에서 만나는 지점이 여기다.
박종현의 클로징: 오늘은 비즈니스 이야기가 아니라 생각을 저 앞까지 펼쳐 나가는 몽상가적 발상을 공유하는 시간이었다.
부록 — 챙길 키워드·리서치 거리
- 평가/리워드: RLVR, verifiable reward, 루브릭 기반 평가(kimi-k2), 인간 심사위원과의 correlation, Hugging Face ICML 재현 챌린지(~8/2), AAAI-26 전편 AI 리뷰, 프롬프트 인젝션 탐지.
- 인물/인터뷰: Dwarkesh Patel × Grant Sanderson(3Blue1Brown), Dwarkesh × Adam Brown(DeepMind), Michael Nielsen, John Schulman, Lilian Weng, Alec Radford, Liam Fedus, 정구봉(팀어텐션).
- 읽을거리: Dwarkesh 「RLVR might be disproportionately bad at science」(5월), 3Blue1Brown 「Compression is Intelligence」(3부작 연재), Lilian Weng 「Harness Engineering for Self-Improvement」, AIDE² 「First Evidence of Recursive Self-Improvement」, Bun 「Rewriting Bun in Rust」(7/8), Gwern 「LLM Daydreaming」, Ted Chiang 「Catching crumbs from the table」(「인류 과학의 진화」).
- 모델/시스템: Inkling(TML, 1T급 오픈웨이트, Tinker로 자기 파인튜닝), kimi-k3, Sol / Fable 5, talkie(1930 빈티지 LM, 13B), Lean, Mathematica.
- 이론 계보: Fisher score function → REINFORCE/policy gradient(Williams) → PPO → GRPO(DeepSeek) / Solomonoff induction → Marcus Hutter → Shane Legg / Kolmogorov 복잡도(Ilya Sutskever) / algorithmic information theory.
- 관전 포인트: 재현 챌린지 최종 결과(8월 2일 이후) · 빈티지 LM이 이후 발전을 재현하는가 · AI 리뷰가 학회 1차 필터로 제도화되는 속도 · “정의를 만드는 AI”의 타임스케일(박종현 예측 10~20년).
원문 인용 모음
- [02:03] (박종현) “저자들 본인들도 미래에 LLM에서 이 PPO라는 알고리즘이 굉장히 강력하게 쓰여서 임팩트를 낼 줄은 몰랐던 거예요. … 좋은 연구를 평가하는 것 자체가 너무 어렵다.”
- [02:45] (최승준) “평가하기 어렵다는 게 오늘의 화두가 될 것 같네요.”
- [06:55] (박종현) “인류의 지식 전체가 있으면 그것을 조금이라도 늘려 나가는 것, 이게 리서치라고 개인적으로 생각하고요. 그리고 늘려 나간 지점이 실제로 우리 세상에 임팩트를 많이 내고 좋은 방향으로 세상을 바꿔 나가면 그게 좋은 연구다.”
- [12:32] (랄프톤 행사 규칙) “Once the Ralph Loop starts, you cannot touch your coding agent directly. If you want to touch your laptop, you have to wear the lobster costume first.”
- [16:05] (정구봉, 팀어텐션) “리뷰 에이전트는 Track 1 페이퍼들을 필수로 10개씩 리뷰했고, 그 점수가 같은 페이퍼를 심사한 인간 심사위원들의 점수와 상관관계가 가장 높은 팀을 와일드카드로 올렸는데 — 그 와일드카드가 Track 2에서 우승했습니다.”
- [20:53] (Grant Sanderson) “The dirty secret with the IMO is that you really can train for a lot of them.”
- [24:21] (Dwarkesh Patel) “If you wanted to do a verification loop on whether group theory is an interesting concept… potentially that verification loop is a hundred years long.”
- [25:44] (수학계 아포리즘, 샌더슨 재인용) “Good mathematicians prove theorems, great mathematicians come up with conjectures, and the greatest mathematicians come up with definitions.”
- [29:13] (최승준) “그냥 하라고 하면 분포가 평균적인 쪽으로 향하다 보니까 원래 그 계열에서 할 이야기만 하지, 끌어와 주지 않거든요. 끌어와 달라고 해야만 끌어와 주지.”
- [34:08] (Adam Brown) “If you just had lots and lots of Einsteins and you gave each of them various options, you could presumably see them in parallel.” / “They just have extreme patience, even for doing things that perhaps look like a low probability of success.”
- [34:49] (아티클 문구, 최승준이 일부러 남긴 대목) “인간은 참이라고 믿는 추측을 반증하는 데 시간을 쓰지 않지만, LLM은 그 ‘낭비’를 기꺼이 합니다.”
- [42:21] (Dwarkesh 인용) “좋은 글은 독자가 어디서 멈칫할지, 어떤 오해를 할지, 어떤 순서로 생각해야 다음 문장을 받아들일 수 있을지 헤아린다. 각 문장과 단어는 단순한 포장이 아니라 바로 내용 그 자체다.”
- [45:45] (박종현) “말하자면 재미없는 소설인 거죠. 설명이 불가능하지만 참이긴 한 거예요.”
- [48:32] (박종현) “천 년 전의 어떤 사람이 할 수 있는 output이랑 제가 지금 해낼 수 있는 output이 너무나 많이 다른데, 그게 인류의 지식이 쌓여서 그런 거잖아요. 그리고 그게 잘 압축되어 있기 때문에 …”
- [58:09] (박종현, YC의 AI 디자인 방식에 대해) “정답이 여러 가지가 될 수 있는 것들을 어떻게 하냐 하면 human이 그 loop에 들어가서 이렇게 pick을 탁탁탁 하는 거죠.”
- [59:31] (최승준, Bun→Rust 마이그레이션에 대해) “한 3시간 정도는 전문가가 자기가 알고 있는 걸 다 압축해서 제대로 스펙을 만들고 돌려야 돌아가는 거지, 그냥 되는 건 아니다. 아무리 agent swarm을 써도.”
- [01:04:21] (Satya Nadella 역정보 패러독스 정리) “AI 시대에는, 구매자가 자신이 산 것을 그저 사용하기 위해서 지식을 내주어야 할 위험을 감수해야 한다.”
- [01:08:30] (최승준) “루프 밖에서 스펙을 만들고 돌리는 작업도 하지만, 루프 안에 들어가서 … 이해하면서 임하는 모드도 있는데, 저는 이게 왔다 갔다 양쪽을 다 겪어 봐야 한다고 생각하고 있어요.”